
计算机毕业设计之基于Hadoop的微博热搜数据分析系统设计与实现
随着互联网的迅猛发展,微博热搜已成为人们获取信息、表达观点的重要平台。每天,海量的微博热搜数据被产生,这些数据中蕴含着丰富的情感信息,对于企业、政府及研究机构而言,如何有效地挖掘和分析这些情感数据,具有重要的现实意义。
本研究设计并实现了一个微博热搜实时分析平台,旨在高效处理和分析海量微博热搜数据。系统采用Python、Hadoop分布式计算框架,结合自然语言处理技术,实现了数据采集、预处理、情感分析和结果展示等功能。通过情感分析算法,系统能准确识别用户情感倾向,为舆情监控、市场分析等提供数据支持,经测试,系统在处理大规模数据时表现出高效率和高准确性,展现了良好的应用前景。本研究为微博热搜实时分析领域提供了新的技术方案,推动了大数据技术在微博热搜分析中的应用与发展。
系统使用收集微博热搜的基本信息、博主,情感分析结果占比,微博热搜,点赞数,评论数等行为数据的公开数据集,来构建微博热搜的数据分析。用户可以通过查询条件的方式,让系统实现对相关数据的筛选和查询,并将查询结果在前端以图表的可视化方式展示出来,进而帮助用户理解数据。系统通过对用户数据的分析与挖掘,实现了对于微博的解析和分类,系统提供了直观的微博热搜数据展示界面,查看到相应的分析结果。
数据采集功能实现对微博平台公共数据的采集,识别数据来源、区分数据类型,并进行数据完整性的验证,确保数据的准确性以及可靠性。分布式存储功能实现对已经处理过的数据进行分布式存储,采用MySQL、HDFS进行对数据的存储,以及支持异构端存储和具备高容错性,高可用性以及易扩展性。数据分析功能基于Spark分布式计算框架,实现对存储的数据进行了数据分析和挖掘。
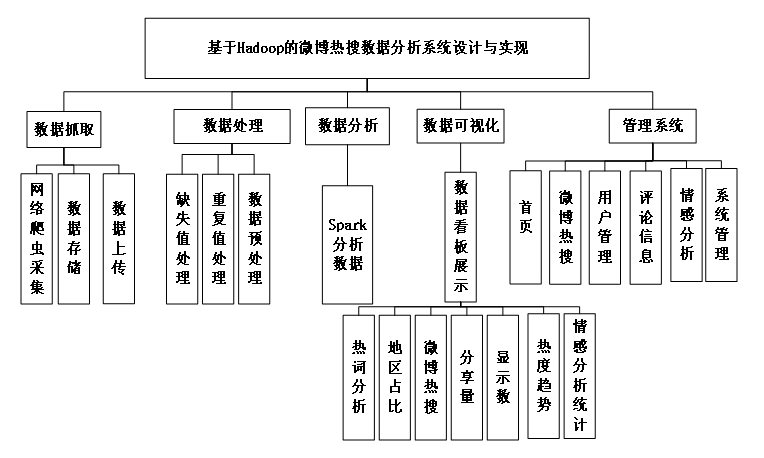
数据可视化功能使用ECharts、Vue、BootStrap等前端技术,对数据分析结果进行了可视化展示,以图表等可视化方式将数据展示,方便了用户分析和观察。系统功能模块图如图3-1所示。
系统数据爬取的实现首先通过分析微博网页结构,确定需爬取的微博热搜类型如话题、点赞数、转发数、评论数等。接着使用Python编程语言结合Requests库发送HTTP请求获取网页内容,并利用xml库解析HTML,定位并提取目标数据。之后对数据进行清洗和格式化,最后存储于数据库或文件系统中,为后续的数据分析和可视化提供基础数据支持。整个爬取过程需遵循法律法规,确保数据获取的合法性和安全性。
Spark分析HDFS中的数据,将分析的数据存放至MySQL数据库,Spark分析HDFS中的数据,将分析的数据进行连接操作得到每一标签表,在Elasticsearch中创建映射,将数据存放至Elasticsearch中,Elasticsearch中创建映射操作如下:
更多推荐
 2
 0
- 0


 已为社区贡献22条内容

所有评论(0)