
AI大模型结构解析自动生成微服务接口Mock测试数据的策略
·
AI大模型结构解析自动生成微服务接口Mock测试数据的策略
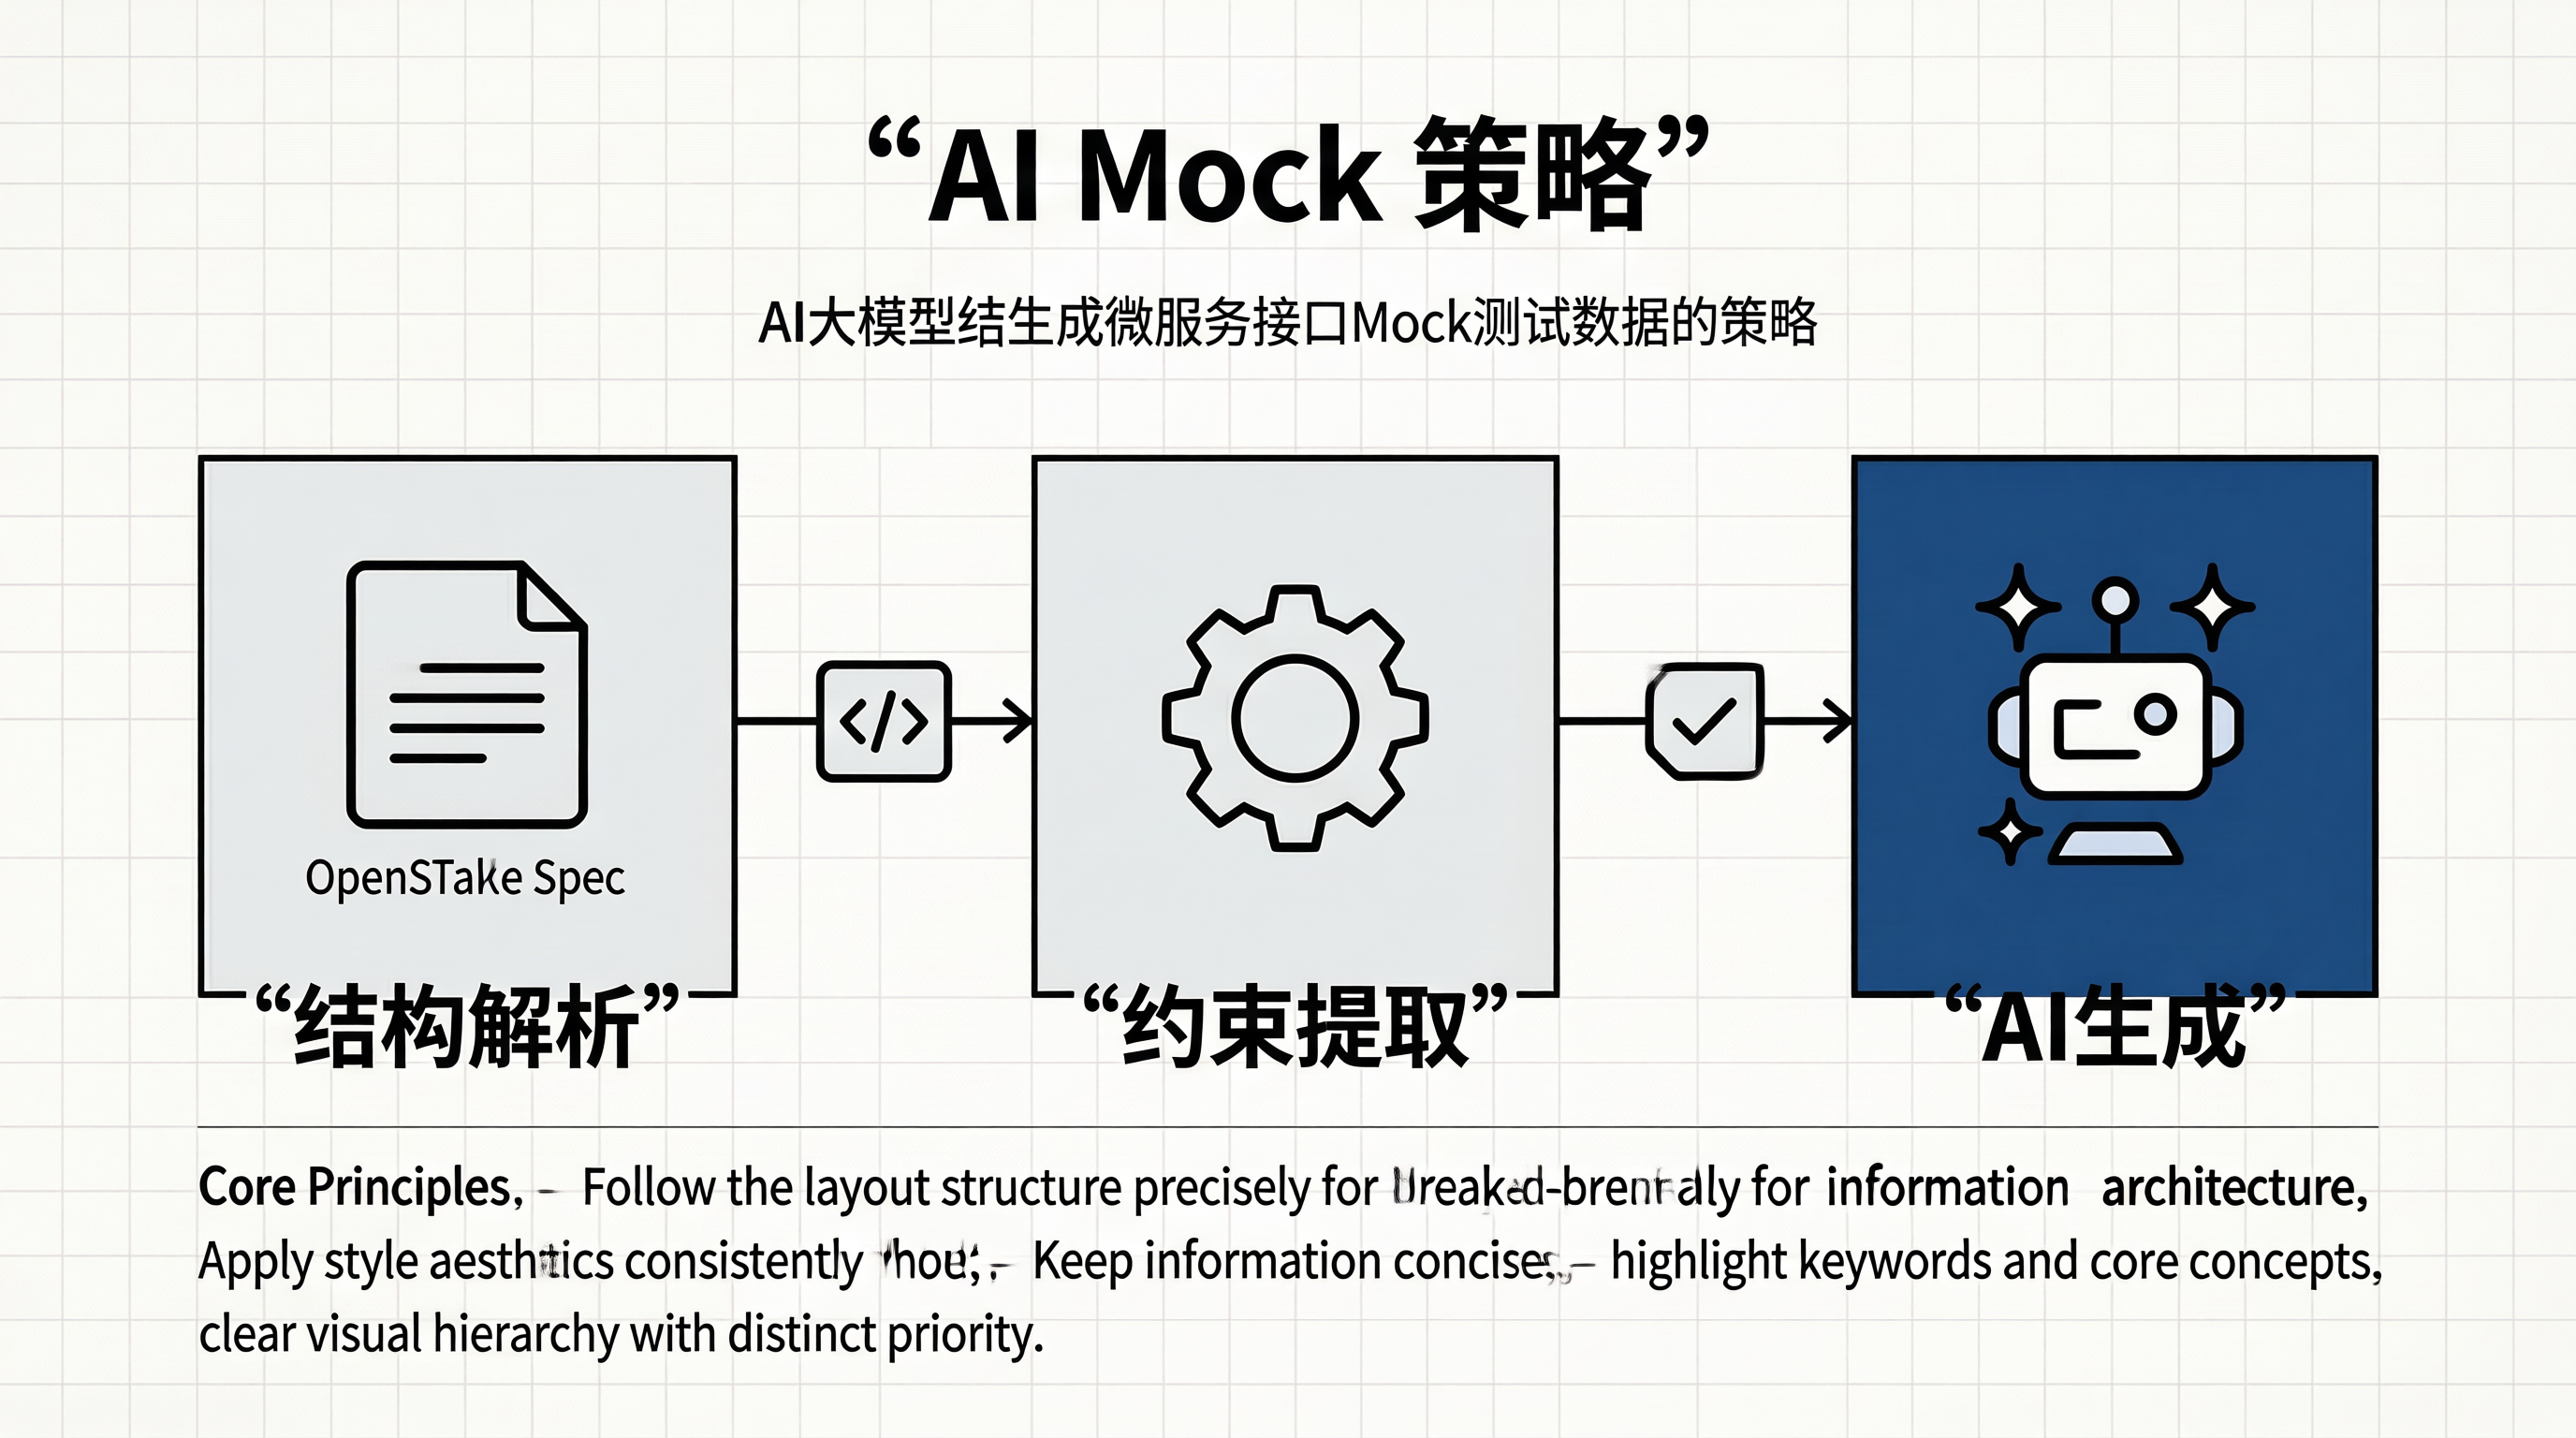
概述
AI大模型自动生成Mock测试数据的核心在于结构解析策略。准确理解接口定义中的Schema结构、约束条件、业务语义,是生成高质量Mock数据的前提。本文从结构解析、约束提取、Prompt注入三个环节,给出完整的策略方案。
一、 核心原理
1.1 结构解析流程
graph LR
    A[OpenAPI Spec] --> B[Schema解析\n($ref展开)]
    B --> C[IR中间表示]
    C --> D[约束提取]
    D --> E[Prompt构建]
    E --> F[AI生成]
    F --> G[校验输出]
1.2 约束分类与处理
| 约束 | Schema字段 | 处理方式 | Mock示例 |
|---|---|---|---|
| 类型约束 | type | 强类型匹配 | string/int/boolean |
| 枚举约束 | enum | 随机选择+边界 | STATUS: [A,B,C]→"B" |
| 长度约束 | min/maxLength | 边界覆盖 | 3-10: "abc", "abcdefghij" |
| 数值范围 | min/maximum | 边界覆盖 | 0-100: 0, 50, 100 |
| 格式约束 | pattern | 正则生成 | email: test@example.com |
| 嵌套约束 | $ref/properties | 递归解析 | 复杂对象完整展开 |
二、 实战配置
2.1 Schema解析与IR转换
class IRSchema:
    def __init__(self, name, type_, required=False):
        self.name = name
        self.type = type_
        self.required = required
        self.constraints = {}
        self.properties = []
        self.items = None

class SchemaToIR:
    def convert(self, schema: dict, spec: dict, name="root") -> IRSchema:
        ir = IRSchema(name, schema.get('type', 'object'))
        self._resolve_ref(schema, spec)
        ir.constraints = self._extract_constraints(schema)
        if ir.type == 'object':
            for prop_name, prop in schema.get('properties', {}).items():
                child = self.convert(prop, spec, prop_name)
                child.required = prop_name in schema.get('required', [])
                ir.properties.append(child)
        elif ir.type == 'array':
            ir.items = self.convert(schema.get('items', {}), spec, 'items')
        return ir

    def _extract_constraints(self, schema: dict) -> dict:
        fields = ['minLength', 'maxLength', 'minimum', 'maximum',
                  'enum', 'pattern', 'format', 'example']
        return {k: schema[k] for k in fields if k in schema}
2.2 Prompt构建
class MockPromptBuilder:
    def build(self, ir: IRSchema, business_context: str = "") -> str:
        return f"""
你是一个Mock数据生成专家。请根据以下Schema定义生成测试数据。

Schema:
{self._format_ir(ir)}

约束要求:
- 类型必须严格匹配
- 枚举值从定义中随机选取
- 字符串字段生成有意义的业务数据
- 数字字段覆盖边界值和正常值

业务上下文: {business_context or '通用微服务接口'}

请生成5组JSON格式的Mock数据,包含_casetype字段标记类型。
"""

    def _format_ir(self, ir: IRSchema, indent=0) -> str:
        p = "  " * indent
        lines = [f"{p}{ir.name}: {ir.type}"]
        if ir.constraints:
            lines.append(f"{p}  约束: {ir.constraints}")
        if ir.properties:
            for prop in ir.properties:
                req = "必填" if prop.required else "可选"
                lines.append(f"{p}  - {prop.name} ({req})")
                lines.append(self._format_ir(prop, indent + 2))
        if ir.items:
            lines.append(f"{p}  items:")
            lines.append(self._format_ir(ir.items, indent + 2))
        return "\n".join(lines)
三、 最佳实践
| 实践要点 | 说明 | 推荐度 |
|---|---|---|
| $ref递归展开 | 深度优先解析所有引用类型 | ⭐⭐⭐⭐⭐ |
| 约束完整提取 | 六类约束全部提取到Prompt | ⭐⭐⭐⭐⭐ |
| 业务上下文 | 在Prompt中加入业务描述语 | ⭐⭐⭐⭐ |
| 循环引用保护 | 设置最大递归深度10层 | ⭐⭐⭐⭐ |
总结
AI大模型自动生成Mock数据的关键在于结构解析的质量。通过SchemaToIR将OpenAPI定义转化为结构化的中间表示,再通过约束提取和Prompt构建将IR完整传递给AI模型,可以生成类型准确、覆盖全面的Mock测试数据。高质量的解析策略是自动化Mock生成的基石。
更多推荐



 11
 0
- 0


 已为社区贡献276条内容

所有评论(0)