
深度学习3-更新参数方法的优化-参数初始化-正则化
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
前言
1. 深度神经网络及其问题
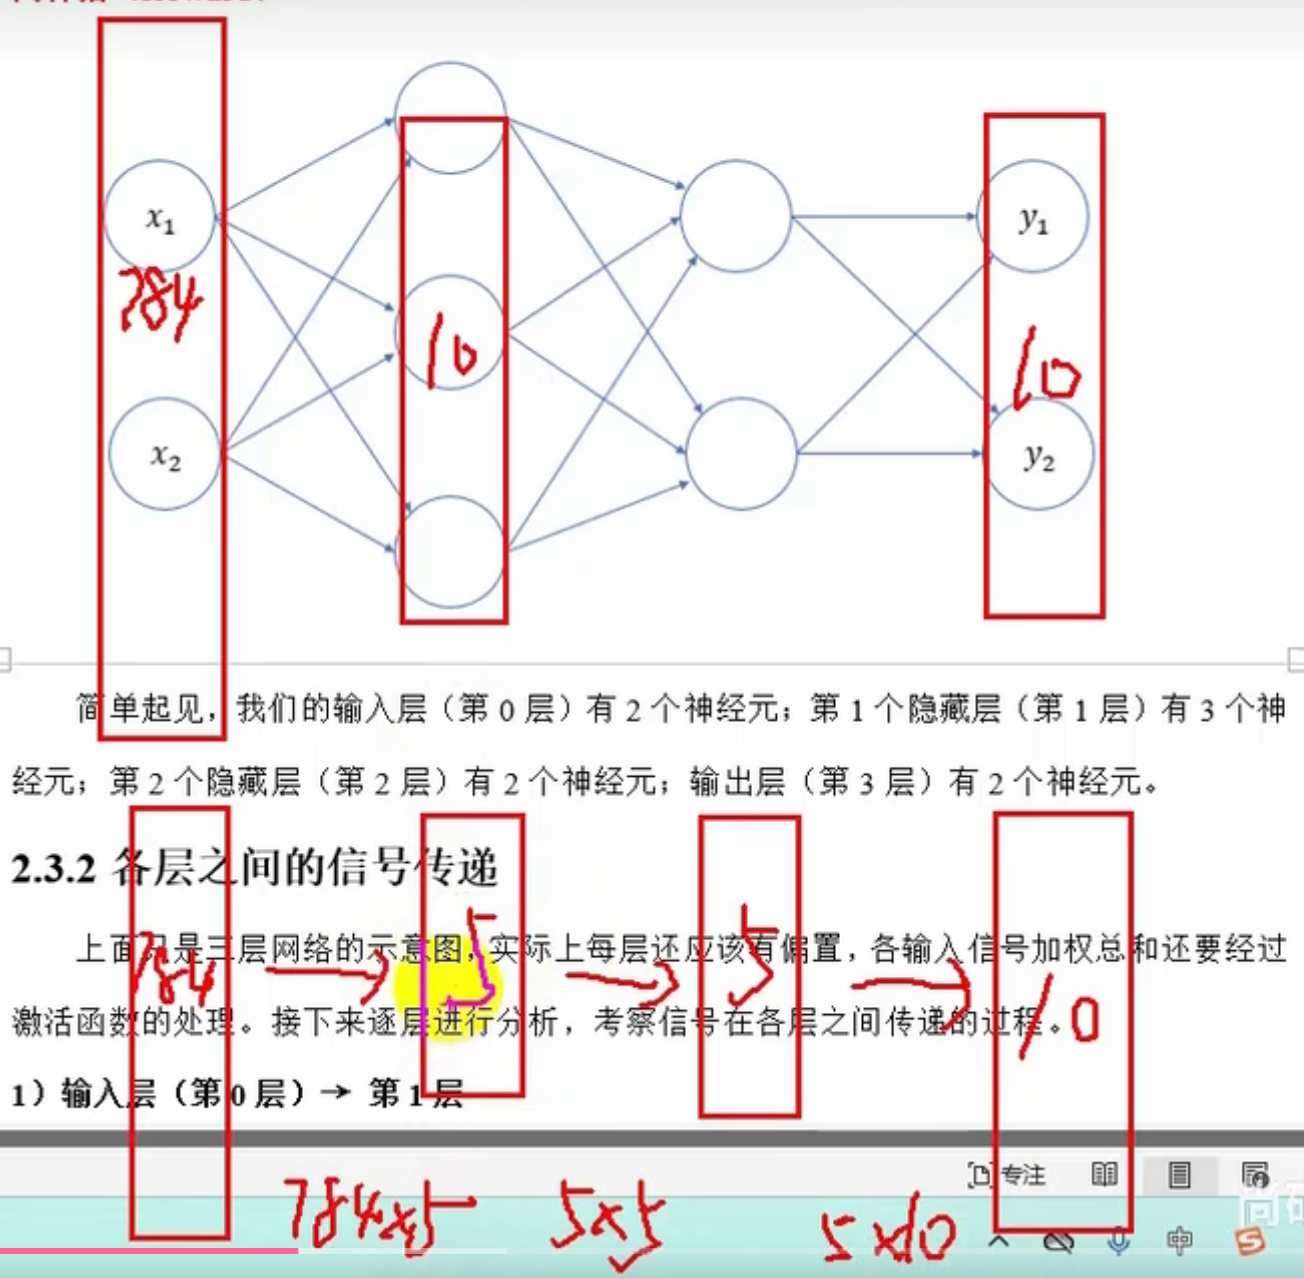
层级多一点,,,比增加神经元更好
当神经网络的层数加深时,往往可以有效地提高识别精度;特别是对于大规模的复杂问题,通常都需要用更多的层来分层次传递信息,而且可以有效减少网络的参数数量,从而使得学习更加高效。使用深度神经网络进行的学习就被称为 深度学习(Deep Learning)。
ILSVRC是近年来机器视觉领域最受追捧且最具权威的学术竞赛之一,代表了图像领域的最高水平。它包含多个测试项目,其中最有名的就是“类别分类”(Classification),该项目会进行 1000 个类别的分类,比试识别精度。自从 2012 年以后的 ILSVRC 比赛,优胜队伍采用的方法基本上都是以深度学习为基础的。
1.1 梯度消失和梯度爆炸
在某些神经网络中,随着网络深度的增加,梯度在隐藏层反向传播时倾向于变小。梯度反向传播变得越来越小,这就意味着,前面隐藏层中的神经元要比后面的学习起来更慢。这种现象被称为“梯度消失”。
与之对应,如果我们进行一些特殊的调整(比如初始权重很大),可以让梯度反向传播时不会明显减小,从而解决梯度消失的问题;然而这样一来,前面层的梯度又会变得非常大,引起网络不稳定,无法再从训练数据中学习。这种现象被称为“梯度爆炸”。
基于梯度学习的深度神经网络中,梯度本身是不稳定的,前面层中的梯度可能“消失”,也可能“爆炸”。
对于梯度消失和梯度爆炸,一个容易理解的解释是:当反向传播进行很多层的时候,每一层都对前一层梯度乘以了一个系数;因此当这个系数比较小(小于1)时,越往前传递,梯度就会越小、训练越慢,导致梯度消失;而如果这个系数比较大,则越往前传递梯度就会越大,导致梯度爆炸。
所以,深度神经网络的训练是比较复杂的,会有一系列的问题。研究表明,激活函数的选择、权重的初始化,甚至学习算法的实现方式都是影响因素;另外,网络的架构和其它一些超参数也有重要影响。
为了让深度神经网络的学习更加稳定、高效,我们需要考虑进一步改进寻找最优参数的方法,以及如何设置参数初始值、如何设定超参数;此外还应该解决过拟合的问题。
2. 更新参数方法的优化
对于深度神经网络的学习,之前更新参数的方法是随机梯度下降法(SGD)。这种方法比较简单,也非常经典,但在很多具体问题中并不是最高效的。
2.1 SGD的缺点
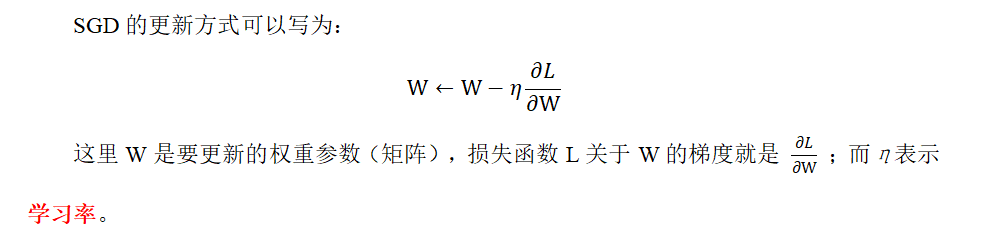
SGD有以下问题:
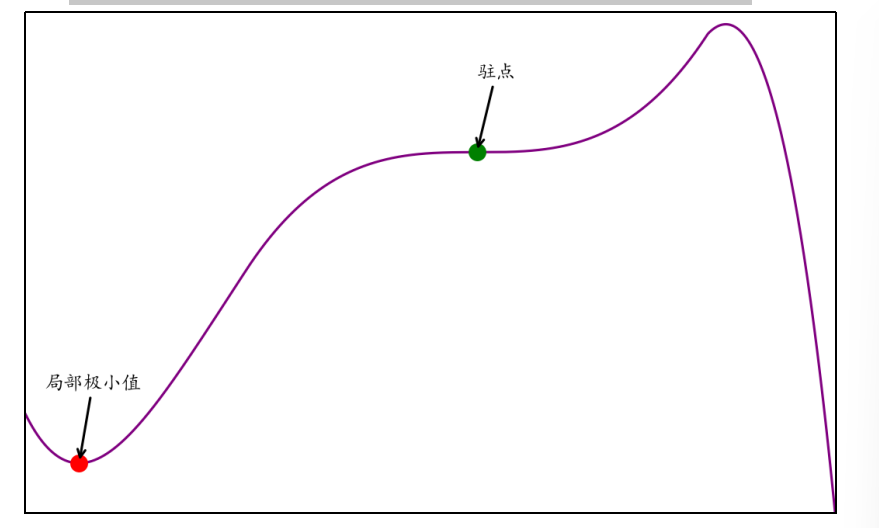
局部最优解:陷入局部最优,尤其在非凸函数中,难以找到全局最优解。就是找到的是极小值,不是最小值
鞍点:陷入鞍点,鞍点意思就是一个平台,梯度为0,导致训练停滞。
收敛速度慢:高维或非凸函数中,收敛速度较慢。
学习率选择:学习率过大导致震荡或不收敛,过小则收敛速度慢。
2.2 Momentum动量法
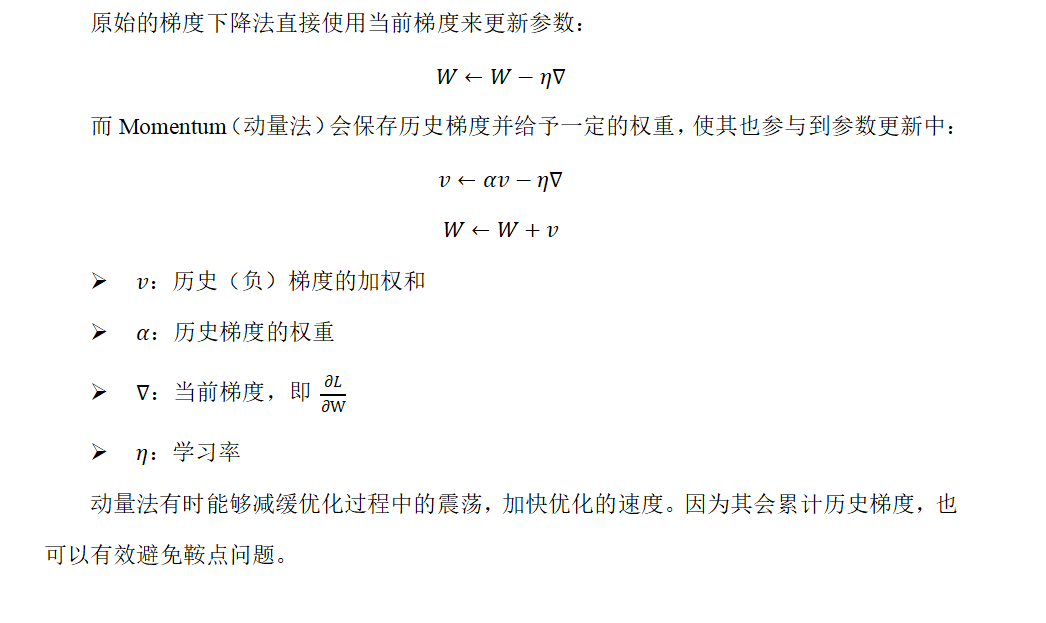
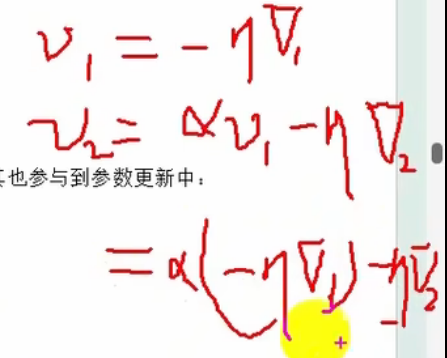
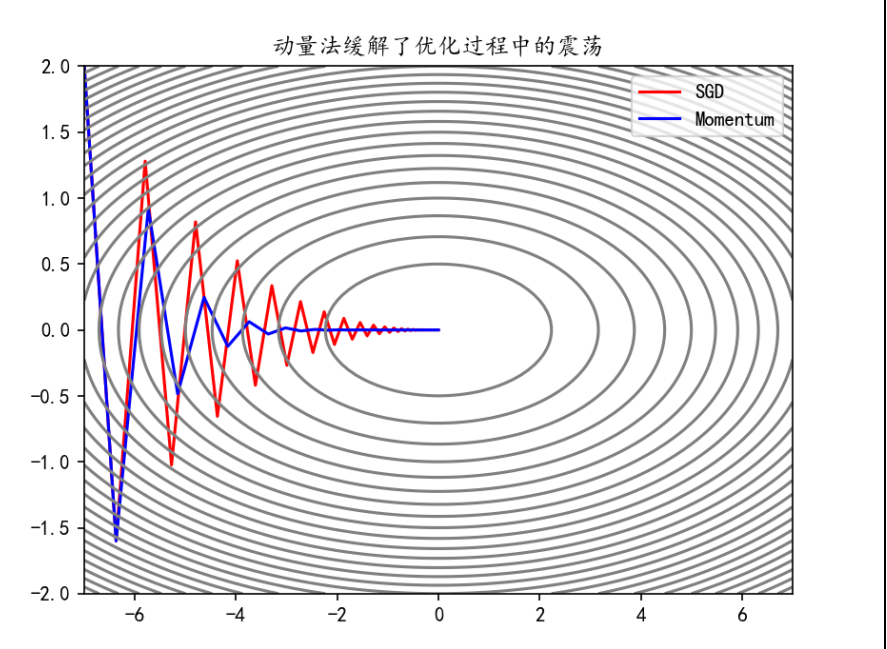
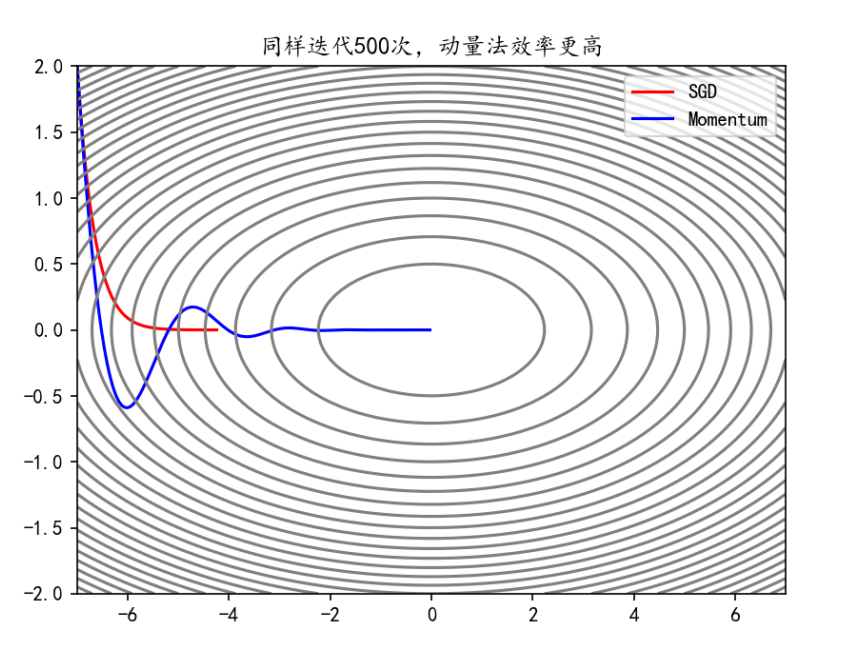
动量法有时能够减缓优化过程中的震荡,加快优化的速度。因为其会累计历史梯度,也可以有效避免鞍点问题。
如果历史梯度方向相同—》累积梯度大----》遇到鞍点,直接冲过去—》变得快
如果历史梯度有正有负----》减缓震荡–》快速收敛
所以意思就是该冲的时候冲得快,不该冲的时候,收的快
class Momentum:

    def __init__(self, lr=0.01, momentum=0.9):
        self.lr = lr
        self.momentum = momentum
        self.v = None

    def update(self, params, grads):
        if self.v is None:
            self.v = {}
            for key, val in params.items():
                self.v[key] = np.zeros_like(val)

        for key in params.keys():
            self.v[key] = self.momentum*self.v[key] - self.lr*grads[key]
            params[key] += self.v[key]
2.3 学习率衰减
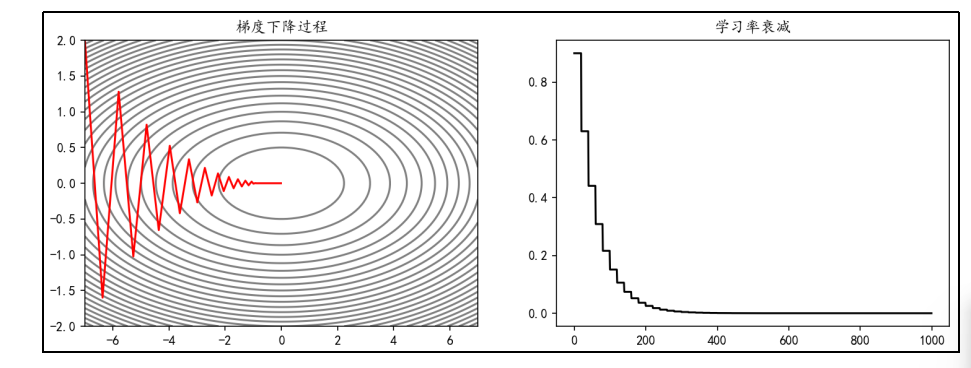
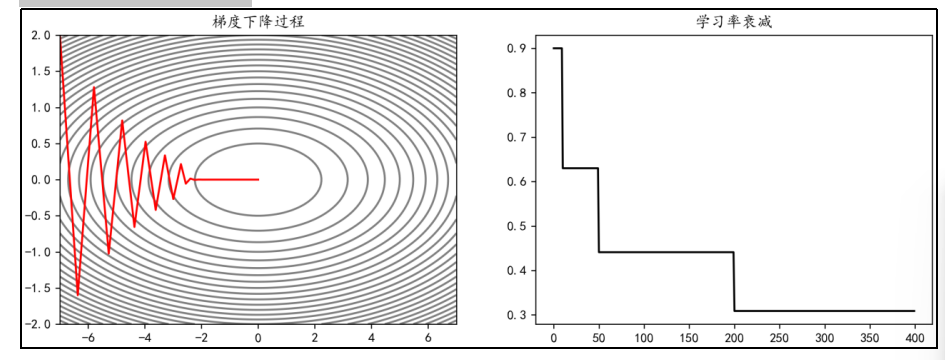
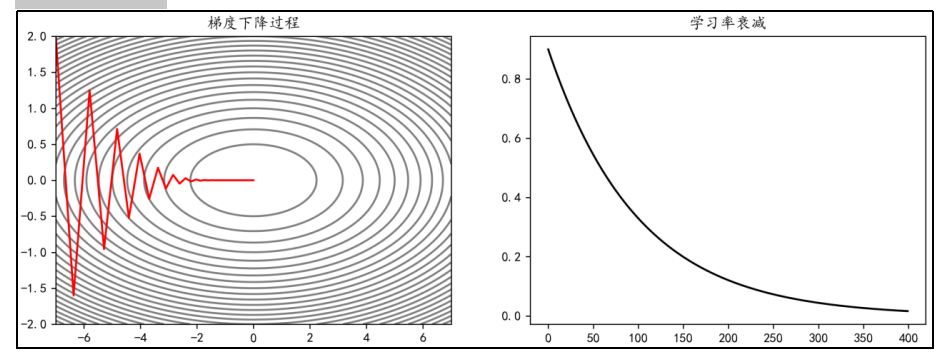
深度学习模型训练中调整最频繁的当属学习率,好的学习率可以使模型逐渐收敛并获得更好的精度。较大的学习率可以加快收敛速度,但可能在最优解附近震荡或不收敛;较小的学习率可以提高收敛的精度,但训练速度慢。学习率衰减是一种平衡策略,初期使用较大学习率快速接近最优解,后期逐渐减小学习率,使参数更稳定地收敛到最优解。
1)等间隔衰减
每隔固定的训练周期(epoch),学习率按一定的比例下降,也称为“步长衰减”。例如,使学习率每隔20 epoch衰减为之前的0.7:
2)指定间隔衰减
在指定的epoch,让学习率按照一定的系数衰减。例如,使学习率在epoch达到[10,50,200]时衰减为之前的0.7:
3)指数衰减
学习率按照指数函数 进行衰减。例如,使学习率以0.99为底数,epoch为指数衰减:
2.4 AdaGrad自适应梯度
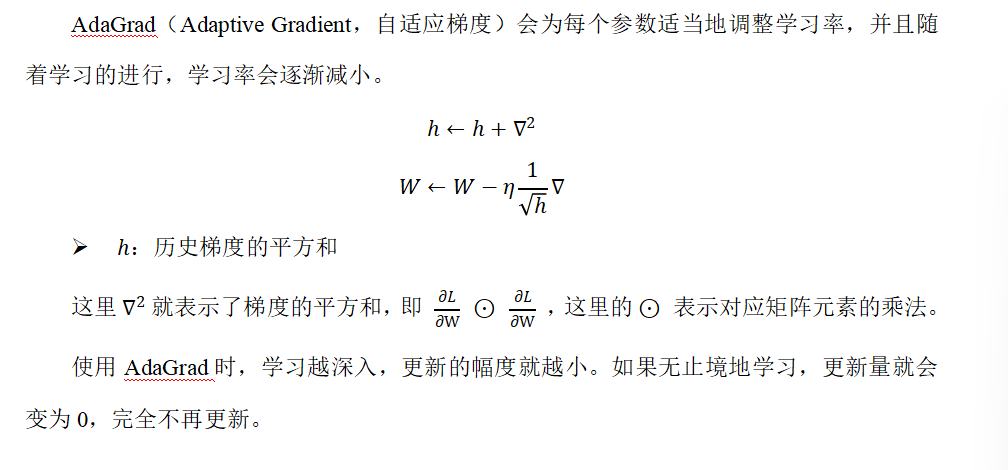
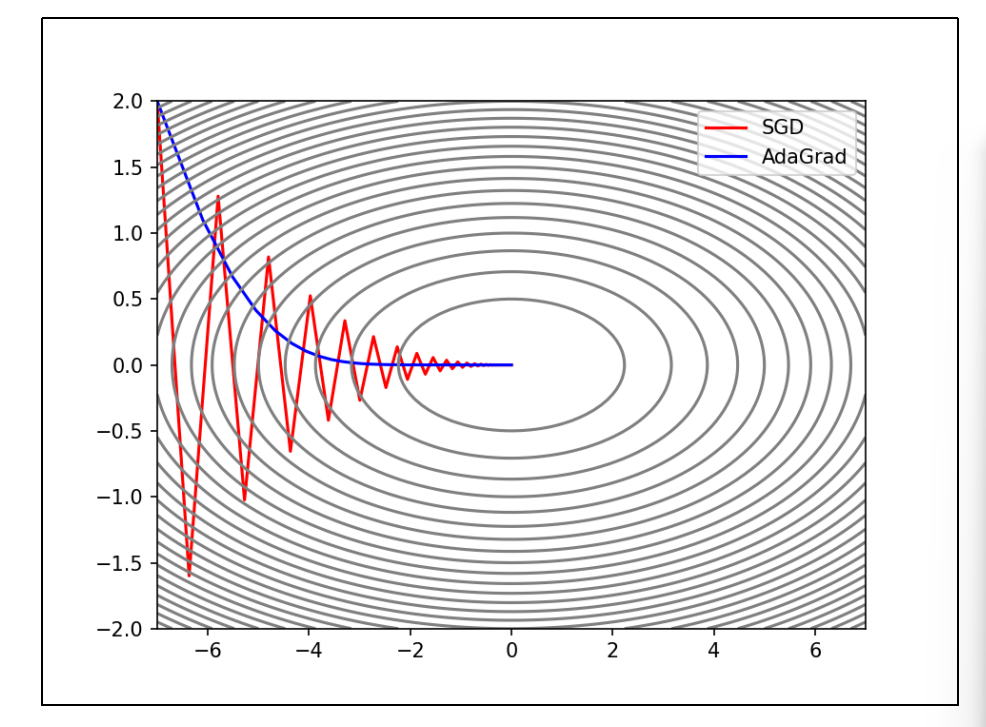
就是自主调整学习率
每次都降低一点学习率,降低的比例不是我们认为规定的了,而是根据梯度平方和的大小决定
class AdaGrad:

    def __init__(self, lr=0.01):
        self.lr = lr
        self.h = None

    def update(self, params, grads):
        if self.h is None:
            self.h = {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)

        for key in params.keys():
            self.h[key] += grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-7)
2.5 RMSProp
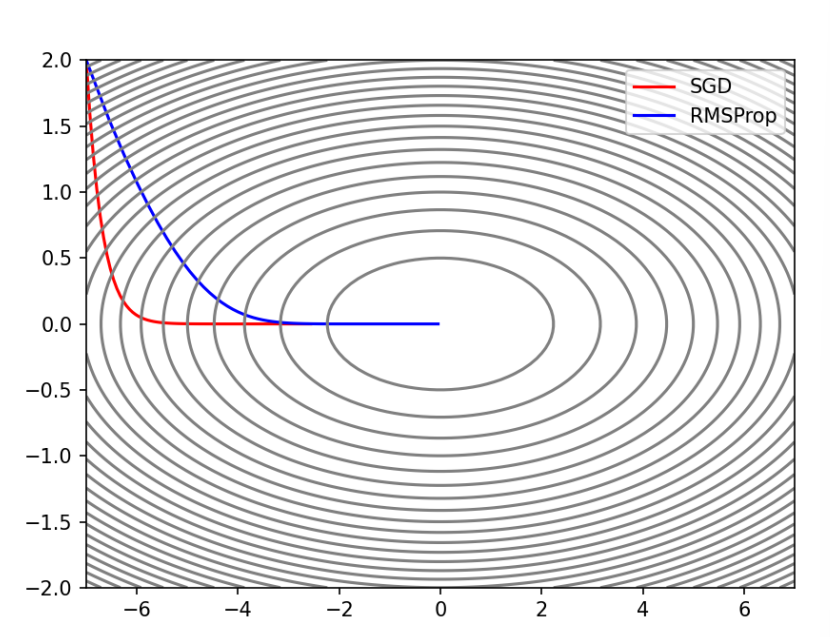
RMSProp(Root Mean Square Propagation,均方根传播)是在AdaGrad基础上的改进,它并非将过去所有梯度一视同仁的相加,而是逐渐遗忘过去的梯度,采用指数移动加权平均,呈指数地减小过去梯度的尺度。
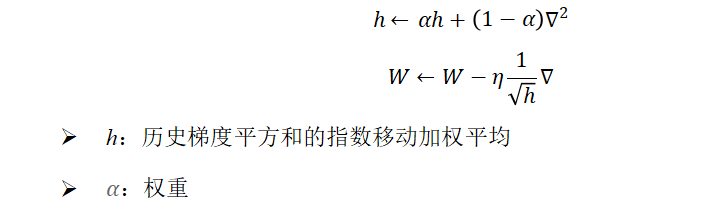
就是离得越远得到平方和—》遗忘掉,或者占的比重越小
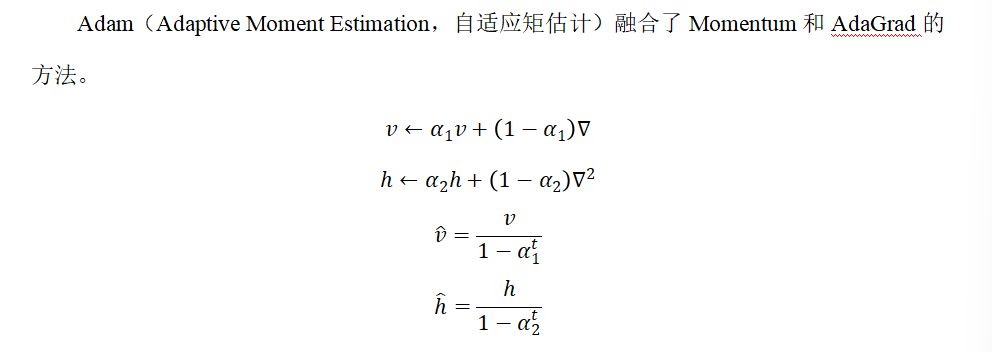
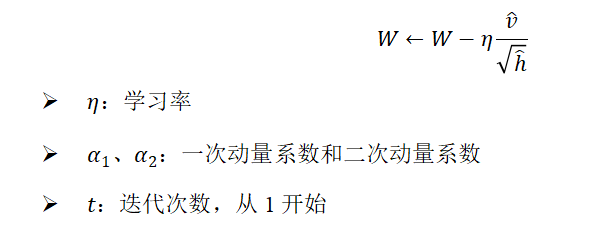
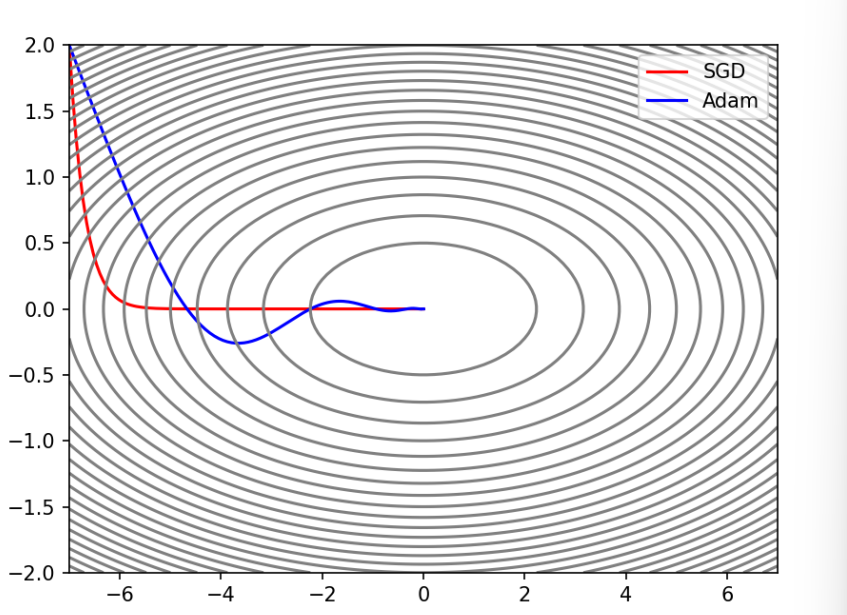
2.6 Adam
AdaGrad和RMSProp都是学习率衰减
就是结合了动量法和学习率衰减
2.7 综合对比
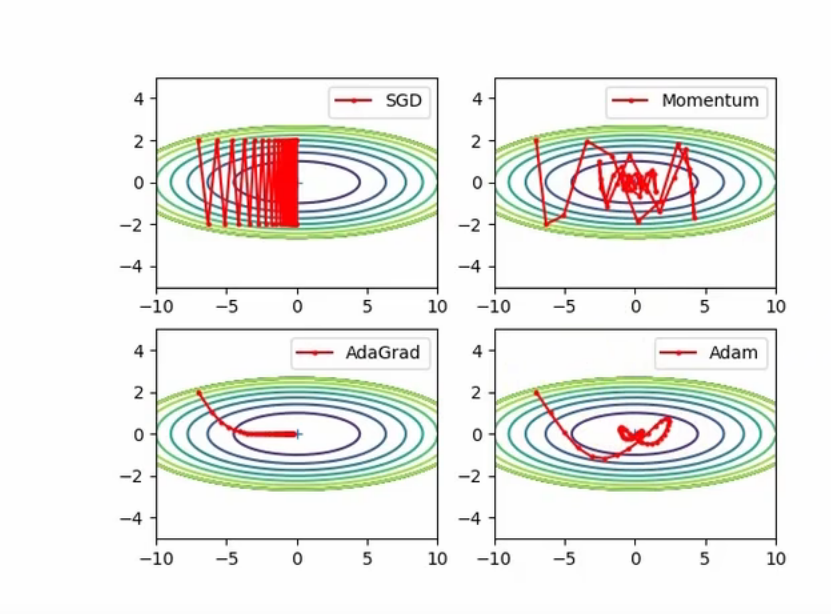
这个是学习率大的时候
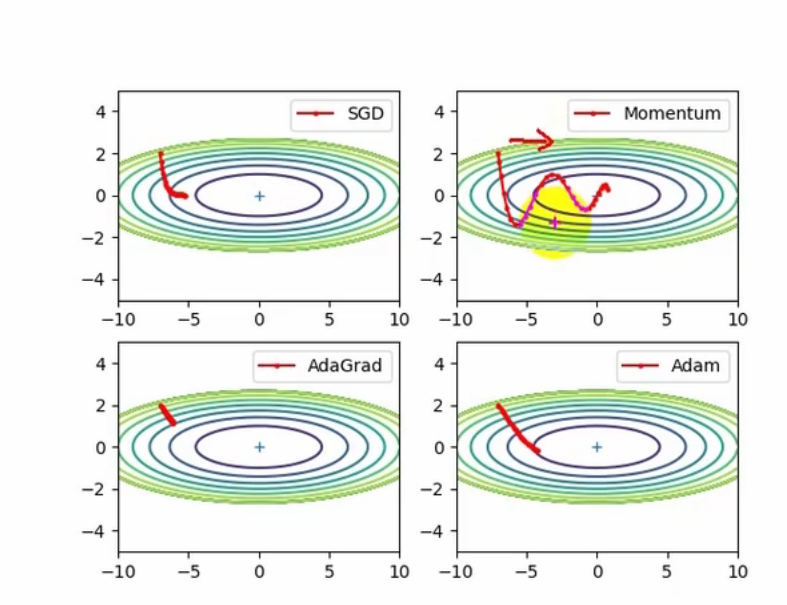
这个是学习率小的时候
动量法肯定是冲的最快的----》学习率可以给低点
因为Adam也有动量法加成,所以也冲得快
因为AdaGrad有学习率衰减,所以走的最慢—》学习率可以给高点
3. 参数初始化
参数初始化方案的选择在神经网络学习中起着举足轻重的作用,它对保持数值稳定性至关重要。此外,这些初始化方案的选择可以与激活函数的选择有趣的结合在一起。我们选择哪个激活函数以及如何初始化参数,可以决定优化算法收敛的速度有多快;糟糕选择可能会导致我们在训练时遇到梯度爆炸或梯度消失。
参数初始化,其实就是起始点选择的问题
3.1 常数初始化
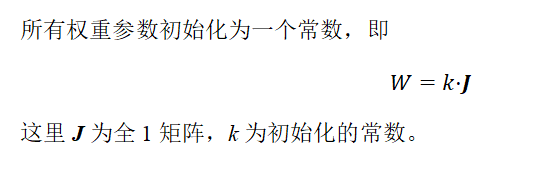
注意:将权重初始值设为0将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神经网络拥有许多不同的权重的意义丧失了。为了防止“权重均一化”(瓦解权重的对称结构),必须随机生成初始值。
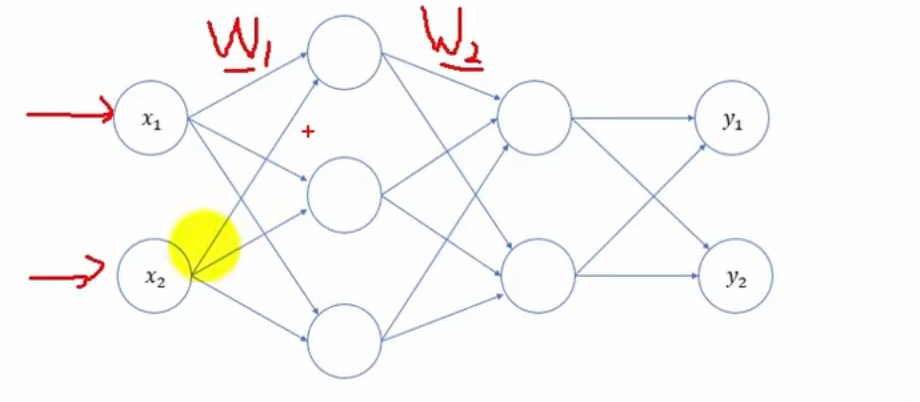
W1和W2都给0,就没有什么意义了
而且反向传播----》梯度没有变化
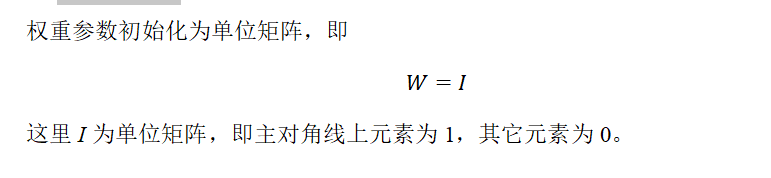
3.2 秩初始化
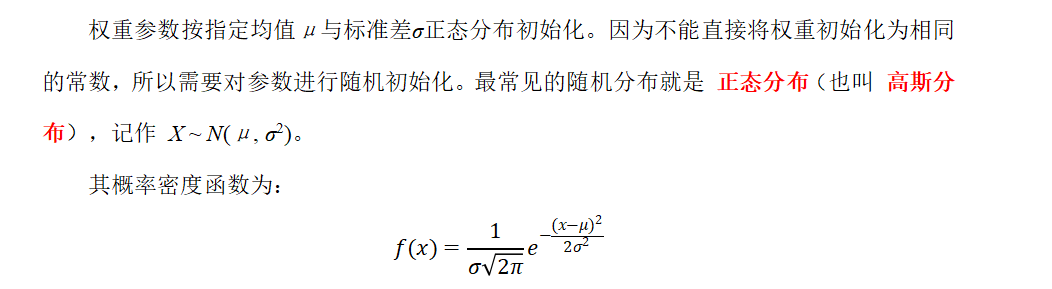
3.3 正态分布初始化
3.4 均匀分布初始化
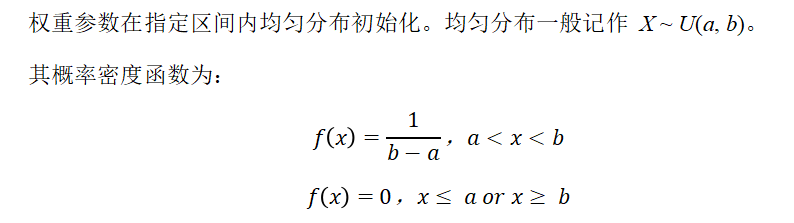
3.5 Xavier初始化(Glorot初始化)
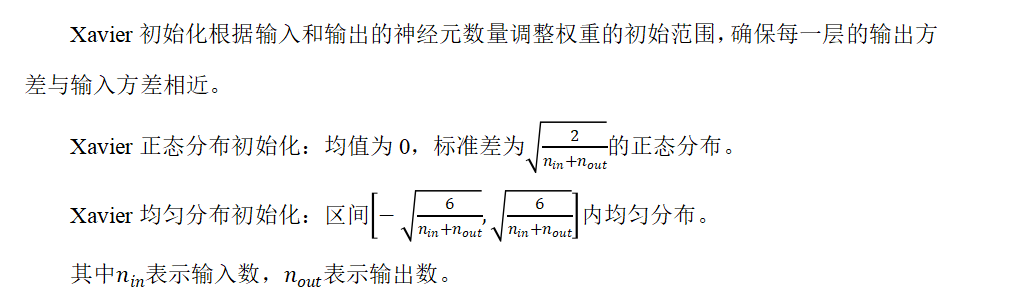
Xavier初始化参数适用于Sigmoid和Tanh等激活函数,能有效缓解梯度消失或爆炸问题。
3.6 He初始化(Kaiming初始化)
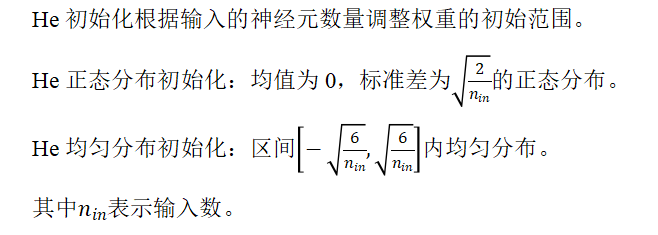
He初始化参数主要适用于ReLU及其变体(如Leaky ReLU)激活函数。
4. 正则化
机器学习的问题中,过拟合 是一个很常见的问题。
过拟合指的是能较好拟合训练数据,但不能很好地拟合不包含在训练数据中的其他数据。机器学习的目标是提高泛化能力,希望即便是不包含在训练数据里的未观测数据,模型也可以进行正确的预测。因此可以通过 正则化 方法来抑制过拟合。
常用的正则化方法有Batch Normalization、权值衰减、Dropout、早停法等。
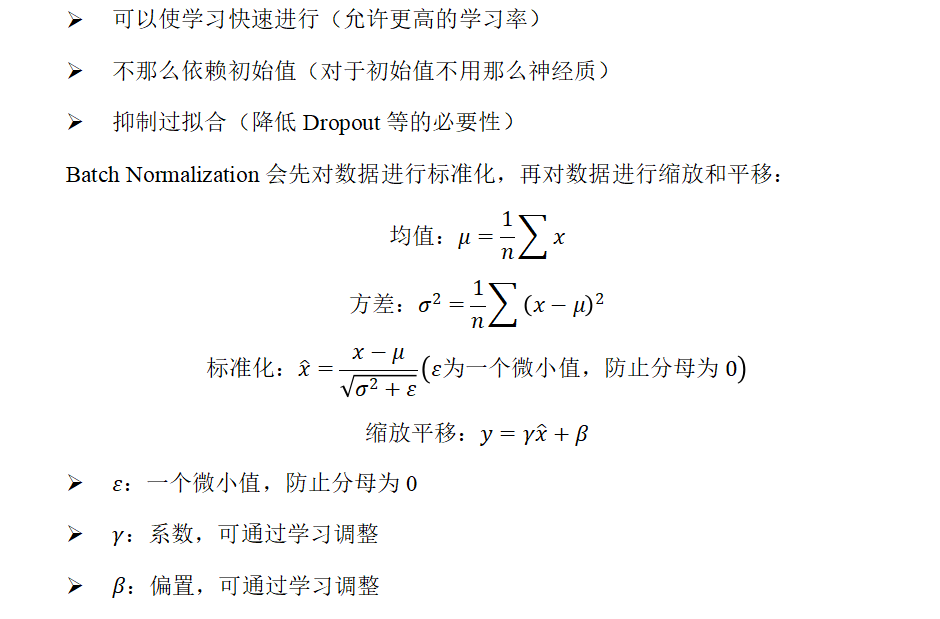
4.1 Batch Normalization批量标准化
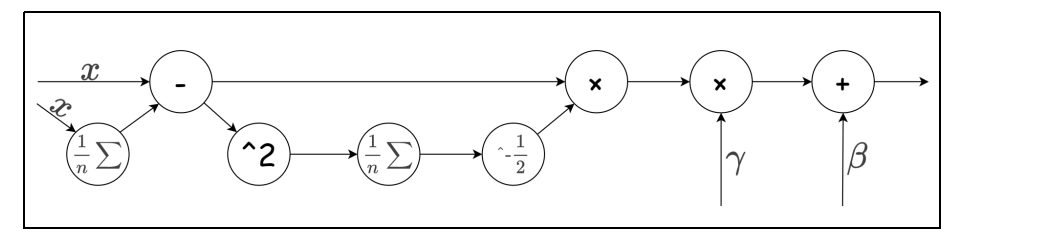
atch Normalization最重要的目的,其实是调整各层的激活值分布使其拥有适当的广度,BN层通常放在线性层(全连接层/卷积层)之后,激活函数之前。就是标准化处理
4.2 权值衰减
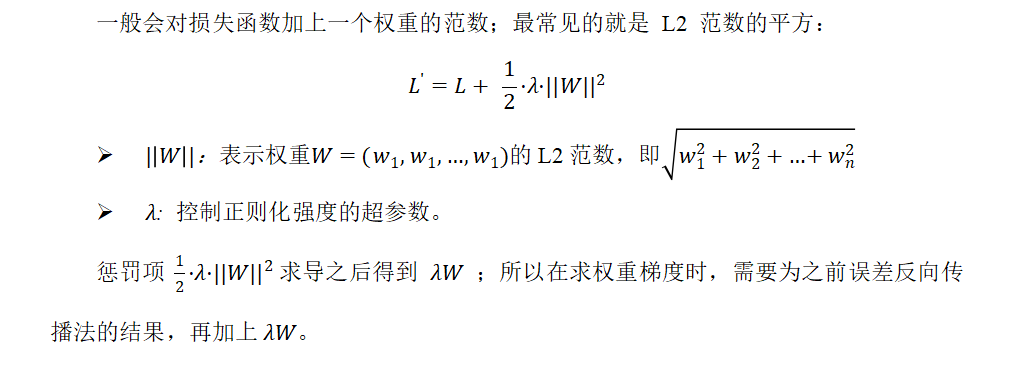
通过在学习的过程中对大的权重进行“惩罚”,可以有效地抑制过拟合,这种方法被称为 权值衰减。因为很多过拟合产生的原因,就是权重参数取值过大。
—》惩罚–》泛化
4.3 Dropout随机失活
Dropout(随机失活,暂退法)是一种在学习的过程中随机关闭神经元的方法。
训练时以概率随机关闭神经元,迫使网络不依赖特定神经元,增强鲁棒性,同时未被关闭的神经元的输出值以的比例进行缩放,以保持期望值不变;而测试时通常不使用Dropout,即所有神经元保持激活状态并且不进行缩放。
Dropout会有隐式集成的效果(每次迭代训练不同的子网络,测试时近似集成效果)。
Dropout在全连接层和卷积层均适用,尤其对大规模网络效果显著。Dropout通常放在激活函数之后,线性层(全连接层/卷积层)之前。
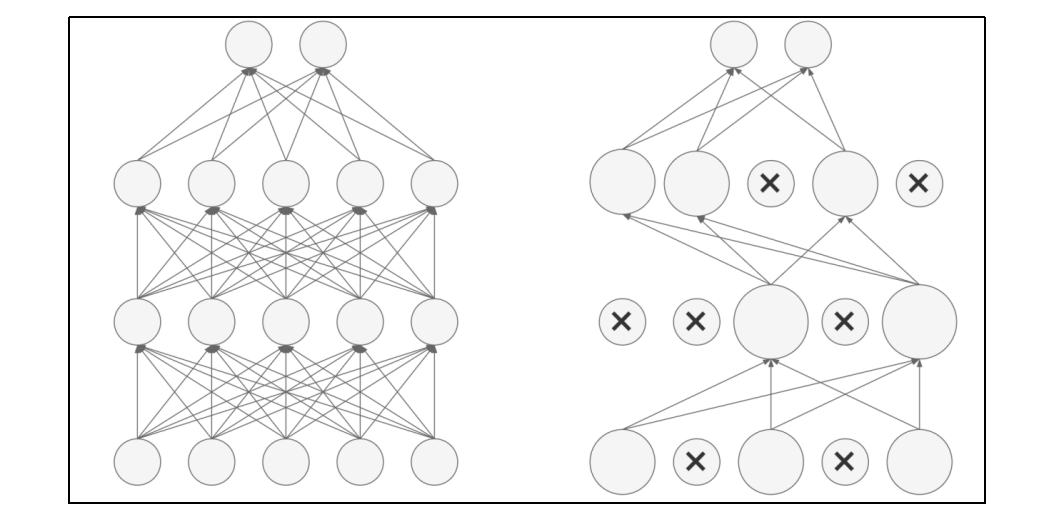
每次都随机关闭一些神经元—》泛化强
总结
更多推荐


 28
 0
- 0


 已为社区贡献11条内容

所有评论(0)