
安装高可用3.4.2版apache hadoop集群
·
生产安装apache hadoop集群(3.4.2版高可用三台机器)
0、准备好jdk、免密登录、zk等前提环境
1、规划
| hadoop101 | hadoop102 | hadoop103 |
|---|---|---|
| jn | jn | jn |
| nm | nm | nm |
| nn | nn | |
| zkfc | zkfc | |
| rm | rm | |
| dn | dn | dn |
2、下载并安装hadoop 官网
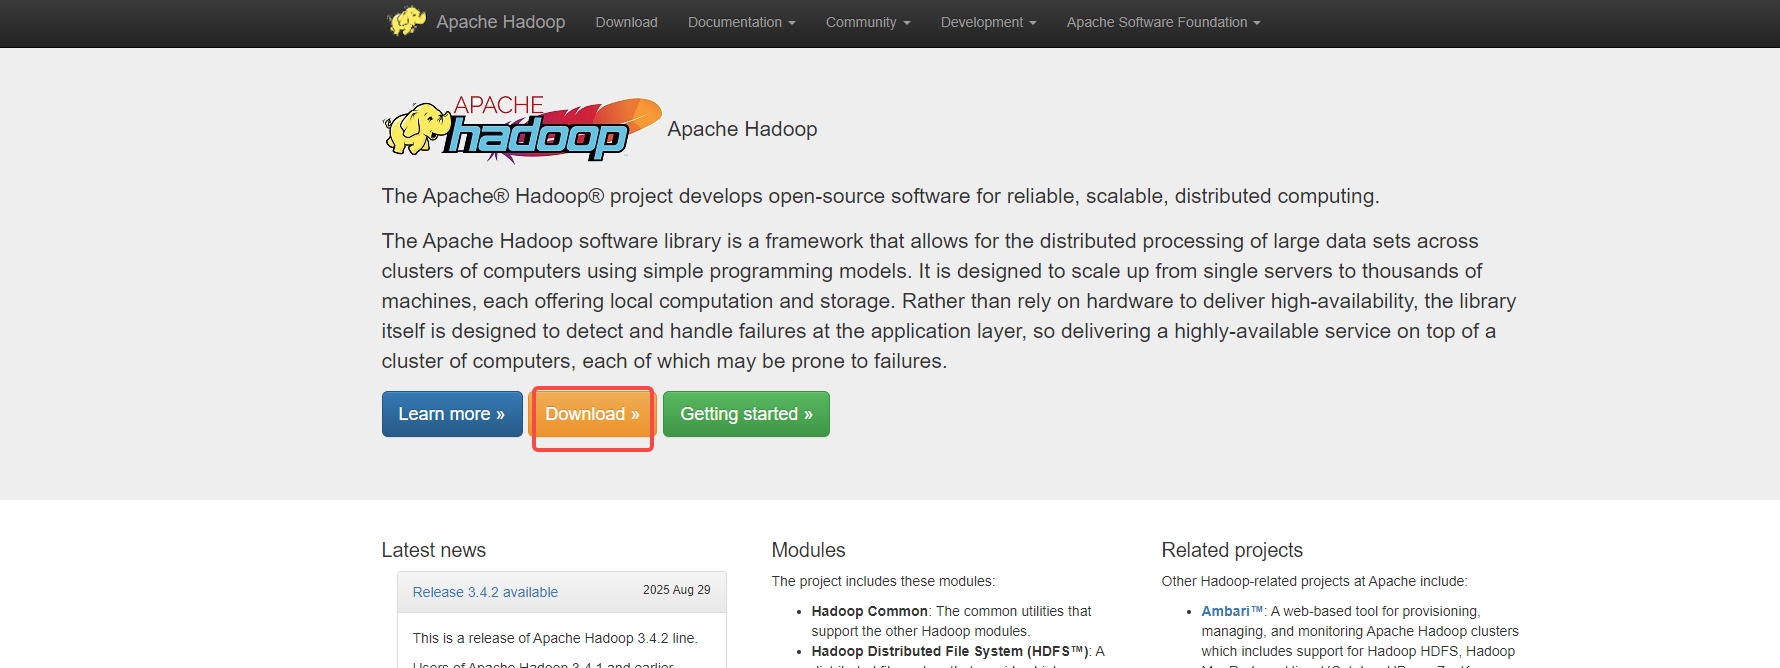
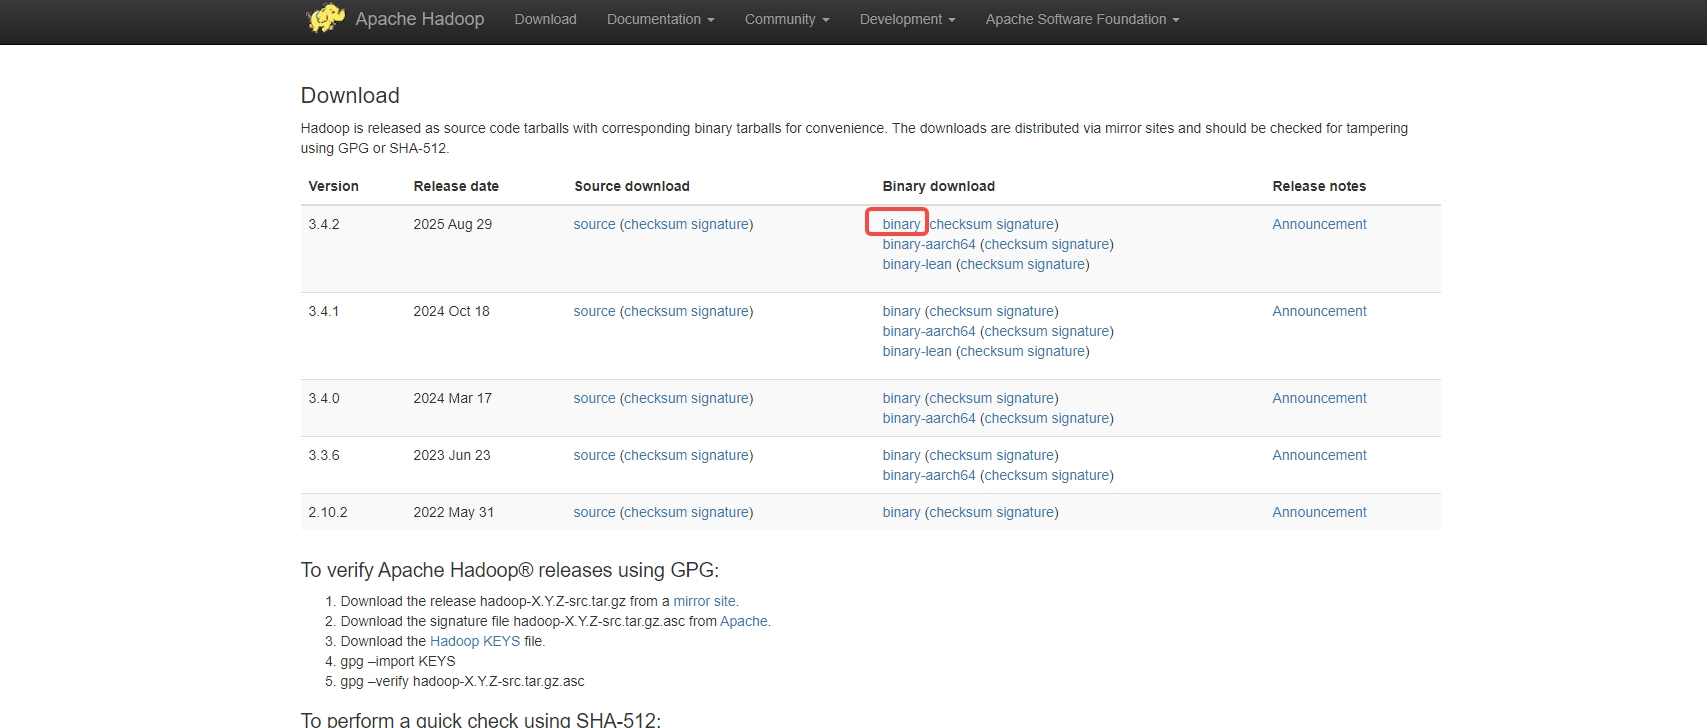
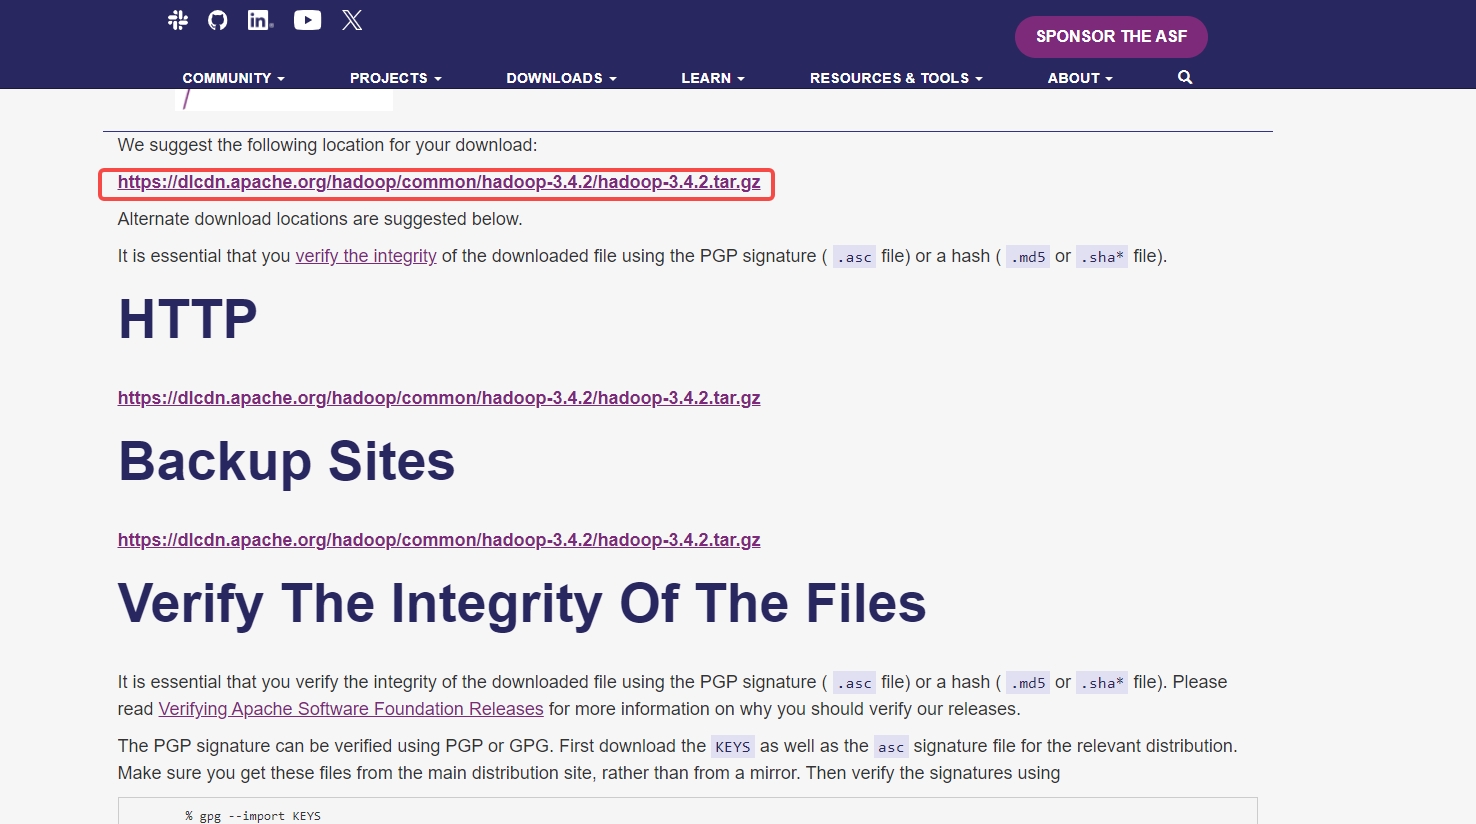
[root@hadoop101 software]# wget https://dlcdn.apache.org/hadoop/common/hadoop-3.4.2/hadoop-3.4.2.tar.gz
[root@hadoop101 software]# tar -zxvf hadoop-3.4.2.tar.gz -C ../module/
3、配置文件
[root@hadoop101 hadoop-3.4.2]# mkdir data
[root@hadoop101 hadoop-3.4.2]# vim /etc/profile
export HADOOP_HOME=/opt/module/hadoop-3.4.2
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
export HADOOP_CONF_DIR=${HADOOP_HOME}/etc/hadoop
export HADOOP_CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath)
[root@hadoop101 hadoop-3.4.2]# source /etc/profile
另外两台机器同样配置/etc/profile
配置./etc/hadoop下的core-site.xml、hdfs-site.xml、yarn-site.xml、mapred-site.xml、workers、hadoop-env.sh
core-site.xml内容如下
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定NameNode的地址 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://nameservice1</value>
    </property>

    <!-- 指定hadoop数据的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/module/hadoop-3.4.2/data</value>
    </property>
    <property>
        <name>ha.zookeeper.quorum</name>
        <value>hadoop101:2181,hadoop102:2181,hadoop103:2181</value>
    </property>
    <!-- 配置Hadoop HTTP静态用户 -->
    <property>
        <name>hadoop.http.staticuser.user</name>
        <value>root</value>
    </property>
</configuration>
hdfs-site.xml内容如下
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 完全分布式集群名称 -->
    <property>
        <name>dfs.nameservices</name>
        <value>nameservice1</value>
    </property>
    <!-- 集群中NameNode节点都有哪些 -->
    <property>
        <name>dfs.ha.namenodes.nameservice1</name>
        <value>nn1,nn2</value>
    </property>
    <!-- nn1的RPC通信地址 -->
    <property>
        <name>dfs.namenode.rpc-address.nameservice1.nn1</name>
        <value>hadoop102:8020</value>
    </property>
    <!-- nn2的RPC通信地址 -->
    <property>
        <name>dfs.namenode.rpc-address.nameservice1.nn2</name>
        <value>hadoop103:8020</value>
    </property>
    <!-- nn1的http通信地址 -->
    <property>
        <name>dfs.namenode.http-address.nameservice1.nn1</name>
        <value>hadoop102:9870</value>
    </property>
    <!-- nn2的http通信地址 -->
    <property>
        <name>dfs.namenode.http-address.nameservice1.nn2</name>
        <value>hadoop103:9870</value>
    </property>
    <!-- 指定NameNode元数据在JournalNode上的存放位置 -->
    <property>
        <name>dfs.namenode.shared.edits.dir</name>
    <value>qjournal://hadoop101:8485;hadoop102:8485;hadoop103:8485/nameservice1</value>
    </property>
    <!-- 配置隔离机制,即同一时刻只能有一台服务器对外响应 -->
    <property>
        <name>dfs.ha.fencing.methods</name>
        <value>sshfence</value>
    </property>
    <!-- 使用隔离机制时需要ssh无秘钥登录-->
    <property>
        <name>dfs.ha.fencing.ssh.private-key-files</name>
        <value>/root/.ssh/id_rsa</value>
    </property>
    <!-- 声明journalnode服务器存储目录-->
    <property>
        <name>dfs.journalnode.edits.dir</name>
        <value>/opt/module/hadoop-3.4.2/data/jn</value>
    </property>
    <!-- 关闭权限检查-->
    <property>
        <name>dfs.permissions.enable</name>
        <value>false</value>
    </property>
    <!-- 访问代理类:client,nameservice1,active配置失败自动切换实现方式-->
    <property>
        <name>dfs.client.failover.proxy.provider.nameservice1</name>
        <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>
    <property>
        <name>dfs.ha.automatic-failover.enabled</name>
        <value>true</value>
    </property>
</configuration>
yarn-site.xml内容如下
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
    <!-- 指定MR走shuffle -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
    <!-- 开启日志聚集功能 -->
    <property>
        <name>yarn.log-aggregation-enable</name>
        <value>true</value>
    </property>
    <!-- 设置日志聚集服务器地址 -->
    <property>
        <name>yarn.log.server.url</name>
        <value>http://hadoop103:19888/jobhistory/logs</value>
    </property>
    <!-- 设置日志保留时间为7天 -->
    <property>
        <name>yarn.log-aggregation.retain-seconds</name>
        <value>604800</value>
    </property>


    <!--启用resourcemanager ha-->
    <property>
        <name>yarn.resourcemanager.ha.enabled</name>
        <value>true</value>
    </property>
    <!--声明两台resourcemanager的地址-->
    <property>
        <name>yarn.resourcemanager.cluster-id</name>
        <value>cluster-yarn1</value>
    </property>
    <property>
        <name>yarn.resourcemanager.ha.rm-ids</name>
        <value>rm1,rm2</value>
    </property>
    <property>
        <name>yarn.resourcemanager.hostname.rm1</name>
        <value>hadoop101</value>
    </property>
    <property>
        <name>yarn.resourcemanager.hostname.rm2</name>
        <value>hadoop103</value>
    </property>
    <!--指定zookeeper集群的地址-->
    <property>
        <name>yarn.resourcemanager.zk-address</name>
        <value>hadoop101:2181,hadoop102:2181,hadoop103:2181</value>
    </property>
    <!--启用自动恢复-->
    <property>
        <name>yarn.resourcemanager.recovery.enabled</name>
        <value>true</value>
    </property>
    <!--指定resourcemanager的状态信息存储在zookeeper集群-->
    <property>
        <name>yarn.resourcemanager.store.class</name>
        <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
    </property>

<!-- ResourceManager配置 -->
    <property>
        <name>yarn.resourcemanager.address.rm1</name>
        <value>hadoop101:8032</value>
    </property>

    <property>
        <name>yarn.resourcemanager.scheduler.address.rm1</name>
        <value>hadoop101:8030</value>
    </property>

    <property>
        <name>yarn.resourcemanager.resource-tracker.address.rm1</name>
        <value>hadoop101:8031</value>
    </property>

    <property>
        <name>yarn.resourcemanager.admin.address.rm1</name>
        <value>hadoop101:8033</value>
    </property>

    <property>
        <name>yarn.resourcemanager.webapp.address.rm1</name>
        <value>hadoop101:8088</value>
    </property>

    <property>
        <name>yarn.resourcemanager.address.rm2</name>
        <value>hadoop103:8032</value>
    </property>

    <property>
        <name>yarn.resourcemanager.scheduler.address.rm2</name>
        <value>hadoop103:8030</value>
    </property>

    <property>
        <name>yarn.resourcemanager.resource-tracker.address.rm2</name>
        <value>hadoop103:8031</value>
    </property>

    <property>
        <name>yarn.resourcemanager.admin.address.rm2</name>
        <value>hadoop103:8033</value>
    </property>

    <property>
        <name>yarn.resourcemanager.webapp.address.rm2</name>
        <value>hadoop103:8088</value>
    </property>
    <!--以下参数可以不配-->
    <property>
        <name>yarn.nodemanager.resource.memory-mb</name>
        <value>30720</value>
    </property>

    <property>
        <name>yarn.scheduler.maximum-allocation-mb</name>
        <value>20480</value>
    </property>
    <property>
        <name>yarn.scheduler.maximum-allocation-vcores</name>
        <value>8</value>
    </property>

</configuration>
mapred-site.xml内容如下
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定MapReduce程序运行在Yarn上 -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
    <!-- 历史服务器端地址 -->
    <property>
        <name>mapreduce.jobhistory.address</name>
        <value>hadoop103:10020</value>
    </property>

    <!-- 历史服务器web端地址 -->
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>hadoop103:19888</value>
    </property>
</configuration>
worksers内容如下
hadoop101
hadoop102
hadoop103
hadoop-env.sh内容如下
export HADOOP_HOME=/opt/module/hadoop-3.4.2
分发到其它节点
[root@hadoop101 module]# xsycn hadoop-3.4.2/
4、启动
# 在所有 JournalNode 节点上执行
./bin/hdfs --daemon start journalnode

# 在任意一个NameNode上执行
./bin/hdfs namenode -format

# 启动第一个 NameNode
./bin/hdfs --daemon start namenode

# 在第二个 NameNode上同步数据
./bin/hdfs namenode -bootstrapStandby

# 启动第二个 NameNode
./bin/hdfs --daemon start namenode


# 在任意一个 NameNode 上执行
./bin/hdfs zkfc -formatZK

# 启动 ZKFC(在两个 NameNode 上都执行)
./bin/hdfs --daemon start zkfc

# 在所有 DataNode 上执行
./bin/hdfs --daemon start datanode

# 在两个 ResourceManager 上执行
./bin/yarn --daemon start resourcemanager

# 在所有 NodeManager 上执行
./bin/yarn --daemon start nodemanager

或者直接用 hdfs --daemon start namenode         yarn --daemon start nodemanager
集群遇到故障需要重新格式化的时候 停止集群、删除 ./logs ./data下的内容 再格式化
编写启动脚本
[root@hadoop101 hadoop-3.4.2]# cd /usr/local/bin/
[root@hadoop101 bin]# vim hdp
#!/bin/bash

if [ $# -lt 1 ]
then
    echo "No Args Input..."
    exit ;
fi

case $1 in
"start")
        echo " =================== 启动 hadoop集群 ==================="
        echo " --------------- 启动 zk ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh start"
        ssh hadoop102 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh start"
        ssh hadoop103 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh start"
        sleep 5
        echo " --------------- 启动 hdfs ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start journalnode"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start journalnode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start journalnode"
        sleep 5
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start namenode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start namenode"
        sleep 5
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start zkfc"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start zkfc"
        sleep 5
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start datanode"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start datanode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon start datanode"
        sleep 5
        echo " --------------- 启动 yarn ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon start resourcemanager"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon start resourcemanager"
        sleep 5
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon start nodemanager"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon start nodemanager"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon start nodemanager"
        echo " --------------- 启动 historyserver ---------------"
        sleep 5
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/mapred --daemon start historyserver"
;;
"stop")
        echo " =================== 关闭 hadoop集群 ==================="
        echo " --------------- 关闭 historyserver ---------------"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/mapred --daemon stop historyserver"
        echo " --------------- 关闭 yarn ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon stop nodemanager"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon stop nodemanager"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon stop nodemanager"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon stop resourcemanager"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/yarn --daemon stop resourcemanager"
        echo " --------------- 关闭 hdfs ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop datanode"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop datanode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop datanode"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop zkfc"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop zkfc"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop namenode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop namenode"
        ssh hadoop101 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop journalnode"
        ssh hadoop102 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop journalnode"
        ssh hadoop103 "source /etc/profile;/opt/module/hadoop-3.4.2/bin/hdfs --daemon stop journalnode"
        echo " --------------- 关闭 zk ---------------"
        ssh hadoop101 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh stop"
        ssh hadoop102 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh stop"
        ssh hadoop103 "source /etc/profile;/opt/module/apache-zookeeper-3.8.5-bin/bin/zkServer.sh stop"
;;
*)
    echo "Input Args Error..."
;;
esac
[root@hadoop101 bin]# chmod +x hdp
[root@hadoop101 bin]# xsync hdp
更多推荐

 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)