
Python机器学习---4.特征工程
特征⼯程:特征是⽤于描述数据中的各种属性、变量或维度的信息,它们是模型⽤来做出预测或分类的输⼊。特征⼯程是使⽤专业背景知识和技巧处理数据,使得特征能在机器学习算法上发挥更好的作⽤的过程。良好的特征⼯程可以显著提⾼模型的性能,⽽糟糕的特征选择或构建可能导致模型性能下降。特征工程会直接影响机器学习的效果
特征⼯程的主要⽬标包括:
-
特征选择:选择最相关的特征,以减少维度和噪声,提⾼模型的泛化能⼒。这可以通过统计⽅法、领域知识、特征重要性评估等⽅式来完成。
-
特征构建:创建新的特征,以提供更多的信息或改善模型的性能。这可能包括将原始特征组合、进⾏数学变换、提取时间序列特征等操作。
-
特征缩放:确保特征具有相似的尺度,以避免某些特征对模型的权重产⽣不适当的影响。常⻅的缩放⽅法包括标准化和归⼀化。
-
处理缺失数据:处理缺失值,可以使⽤插补⽅法来填充缺失值,或者考虑是否删除包含缺失值的样本。
-
处理分类特征:将分类特征进⾏编码,例如独热编码(One-Hot Encoding)或标签编码(Label Encoding),以使其适⽤于机器学习模型。
-
特征交叉:将不同特征之间的关联性考虑在内,通过创建特征交叉来提供更多信息。
-
特征选择和降维:使⽤降维技术(如主成分分析PCA)来减少特征的数量,以提⾼模型的效率和可解释性。
基本预处理:
-
缺失值处理:
-
删除属性或者删除样本:如果⼤部分样本该属性都缺失,这个属性能提供的信息有限,可以选择放弃使⽤该属性
-
统计填充:对于缺失值的属性,尤其是数值类型的属性,根据所有样本关于这维属性的统计值对其进⾏填充,如使⽤平均数、中位数、众数、最⼤值、最⼩值等,具体选择哪种统计值需要具体问题具体分析。
-
统⼀填充:常⽤的统⼀填充值有:“空”、“0”、“正⽆穷”、“负⽆穷”等。
-
预测/模型填充:可以通过预测模型利⽤不存在缺失值的属性来预测缺失值,也就是先⽤预测模型把数据填充后再做进⼀步的⼯作,如统计、学习等。虽然这种⽅法⽐较复杂,但是最后得到的结果⽐较好。
-
下面我们使用的泰坦尼克号数据,train.csv文件。
import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

# 读取数据
data = pd.read_csv("train.csv")
# print(data.head())
# print(data.shape)

# 查看数据的基本信息
# print(data.info())

# 查看极值情况
# print(data.describe())

# 查看重复数据
# print(data.duplicated().sum())

# 查看缺失值占比和数量
# print(data.isnull().mean())
# print(data.isnull().sum())

# 缺失值处理Age列,使用fillna()平均数填充
data['Age'] = data['Age'].fillna(value=data['Age'].mean())
# print(data.isnull().sum())

# 缺失值处理Cabin列,方法二用scikit SimpleImputer,这个模块是专门处理缺失值数据的类
imp = SimpleImputer(strategy='constant', fill_value=0)
data[['Cabin']] = imp.fit(data[['Cabin']].values)
# print(data.isnull().sum())

# 缺失值处理Embarked列,使用fillna()众数填充
data['Embarked'] = data['Embarked'].fillna(value=data['Embarked'].mode()[0])
# print(data.isnull().sum())
数值型特征:
-
数值型的幅度变换:
-
log变换、多项式变换:大于0的数据
下面是针对前面使用的泰坦尼克号数据内的Age列进行的log对数变换处理# 对数变换 data['log_age'] = data['Age'].apply(lambda x: np.log(x)) # print(data.head()) -
幅度缩放(数据预处理):MinMaxScaler、StandardScaler
-
MinMaxScaler:最大最小化处理,容易收到极值的影响
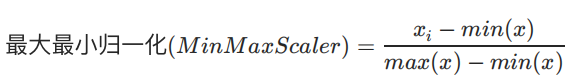
- StandardScaler:标准化处理,性能稳定
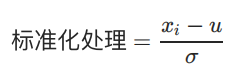
# 最大最小化处理
mm_scaler = MinMaxScaler()
fare_train = mm_scaler.fit_transform(data[['Fare']])
# print(fare_train)

# 标准化处理
std_scaler = StandardScaler()
std_scaler_train = std_scaler.fit_transform(data[['Fare']])
# print(std_scaler_train)
-
-
统计数值:Max、Min、 AVG...
-
四则运算:+ - * /
-
-
⾼次特征与交叉特征:preprocessing.PolynomialFeatures
是什么:PolynomialFeatures 变换⽤于在机器学习中创建多项式特征,它的主要⽬的是扩展特征空间,使模型能够更好地拟合⾮线性关系。这种变换通常⽤于线性回归、逻辑回归、⽀持向量机(SVM)等模型,特别是当原始特征与⽬标之间存在复杂的⾮线性关系时,多项式特征变换可以提⾼模型的性能。
怎么⽤:对于给定的输⼊特征,例如⼀个特征向量 [x1, x2, x3],PolynomialFeatures 将其转换为多项式的形式,包括原始特征的各种幂和交叉项。例如,对于⼆次多项式,它会⽣成 [x1, x2, x3, x1^2, x2^2, x3^2, x1x2, x1x3, x2x3]。
什么时候⽤:-
⾮线性关系: 当你有理由相信⽬标变量与特征之间存在⾮线性关系时,多项式特征变换可以⽤来更好地捕捉这些⾮线性关系。
-
特定特征之间的交互效应: 如果你怀疑某些特征之间的交互效应对⽬标变量有影响,你可以使⽤多项式特征变换来引⼊这些交互项,以改善模型性能。
-
特征⼯程: 在⼀些情况下,多项式特征变换是特征⼯程的⼀部分,⽤于改进模型的性能。
-
⾼次特征: 如果你认为某些特征具有⾼次项的影响,例如 x^2, x^3, 等等,你可以使⽤多项式特征变换来引⼊这些⾼次项,以更好地描述数据的复杂性。
-
⽤于⽀持向量机 (SVM): 在⽀持向量机中,多项式特征变换可以将数据映射到⾼维空间,从⽽使⽀持向量机能够更好地分隔不同类别的数据。
# 高次特征
ploy = PolynomialFeatures(degree=2)
# print(data[['SibSp', 'Parch']].head())
poly_fea = ploy.fit_transform(data[['SibSp', 'Parch']])
# print(poly_fea)

# 获取特征
feature_names = ploy.get_feature_names_out(input_features=['SibSp', 'Parch'])
# print(feature_names)
-
-
字符型特征:
类别型-
pandas get_dummies/哑变量
-
OneHotEncoder()/独热向量编码
-
标签编码LabelEncoder()
# pandas get_dummies/哑变量
# print(pd.get_dummies(data[['Embarked']]))

# OneHotEncoder()/独热向量编码
X_train = data[['Embarked']]
# 初始化OneHotEncoder
ohe = OneHotEncoder(handle_unknown='ignore')
# 拟合
ohe.fit(X_train)
X_train_ohe = ohe.transform(X_train)
# print(X_train_ohe.toarray())
-
更多推荐

 40
 0
- 0


 已为社区贡献14条内容

所有评论(0)