
推理模型集体翻车!康奈尔大学:数学推理中越强的大模型,协作时越容易被“带偏”?
一、导读
 https://mp.weixin.qq.com/s/GVkEjA7EVnKFxHqnpltD8Q
本文研究大型语言模型在协作推理场景中的核心能力缺陷。当前,具备思维链能力的LLMs(如DeepSeek-R1、Qwen3等)在独立推理任务上表现出色,但其训练范式主要针对独立生成完整推理过程。当多个推理者需要在共享轨迹上进行实时协作时,LLMs能否有效处理来自其他模型的“偏离轨迹”推理片段成为关键问题。
论文揭示了现有独立推理LLMs在协作场景中的根本局限性:即使是最强的模型也无法有效抵抗错误推理的干扰或利用正确推理的引导。这一发现挑战了传统基准测试对模型推理能力的评价标准,为构建真正具备协作能力的多智能体推理系统提供了重要理论基础和方法论创新。
二、论文基本信息
论文标题:Off-Trajectory Reasoning: Can LLMs Collaborate on Reasoning Trajectory?作者:Aochong Oliver Li, Tanya Goyal单位:Department of Computer Science, Cornell University来源:arXiv preprint arXiv:2510.06410v1链接:https://arxiv.org/abs/2510.06410v1
三、摘要精炼
本文系统研究了LLMs在“偏离轨迹推理”中的表现,即模型能否在与其他推理者共享的推理轨迹上有效协作。论文提出双测试框架——可恢复性测试模型从误导性推理干扰中回溯到原有正确轨迹的能力,可引导性测试模型利用更强协作方提供的正确但部分推理来解决超越自身能力问题的能力。
通过对15个开源LLMs(1.5B-32B参数)在5个数学基准上的评估,发现反直觉结果:基准测试更强的模型在干扰下更加脆弱,所有模型在可引导性测试中成功率均低于9.2%。控制实验进一步揭示了蒸馏教师选择、RL训练和数据筛选策略对偏离轨迹推理能力的直接影响。
四、研究背景与相关工作
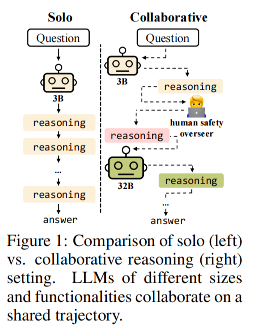
近年来,思维链LLMs通过强化学习验证奖励或知识蒸馏训练,在数学和编程等复杂推理任务上取得显著进展。这些模型学习用语言表达中间推理过程,并展现出自我反思行为,如验证答案或寻求替代方法。这种透明性开启了多模型协作的新方向:更强的LLM协作方或人类监督者可以直接干预正在进行的推理过程,实现对模型思维的直接控制。
现有LLMs主要针对独立推理进行训练和评估,而在实时协作环境中处理来自其他协作方的部分推理轨迹时,面临着分布偏移的挑战。理想情况下,LLMs应该能够整合来自协作方的有用见解,并可靠地从错误或无用的输入中回溯,即使这些轨迹不在其自然分布中。最近的工作探索了动态将推理子部分卸载到较弱/较强模型、工具使用或在训练和推理期间聚合并行样本等协作策略,但独立推理LLMs是否能有效利用其他协作方的部分推理轨迹仍不清楚。
五、主要贡献与创新
-
系统性评估框架:提出可恢复性和可引导性双测试,构建了评估偏离轨迹推理能力的标准化协议,填补了协作推理评估的空白。
-
反直觉发现:实证证明模型在独立推理基准上的性能与偏离轨迹推理能力正交,最强独立推理模型AM-Thinking-32B在可恢复性测试中表现第二差,性能下降达25.1%。
-
关键机制分析:发现模型推理开始阶段的问题重述对可恢复性至关重要,保留第一段推理可将平均可恢复性从74.9%提升至83.5%。
-
训练方法影响:首次通过控制实验证明蒸馏教师的可恢复性行为会传递给学生模型,RL训练能显著改善可恢复性(提升15.3%-28.9%),而激进的数据过滤会导致检查点间可恢复性的高方差。
六、研究方法与原理
6.1 问题形式化
设 为推理模型,为训练或测试数据点。在标准独立推理中,为输入问题生成推理轨迹和最终答案,即。
在协作设置中,多个模型或同一模型的不同实例共同贡献推理轨迹 的不同部分。本文实例化简化的双模型协作设置来探索前沿开源LLMs的偏离轨迹推理能力。
6.2 双模型设置
模拟两个推理系统之间的协作,主模型 和协作方 共同贡献偏离轨迹推理 。通过连接这两个不完整轨迹构建共享的偏离分布轨迹,最后从 中采样推理完成和最终答案:
对于可验证奖励的领域,通过计算最终答案的准确率来测量这种偏离轨迹完成的成功率:。
6.3 双测试设计
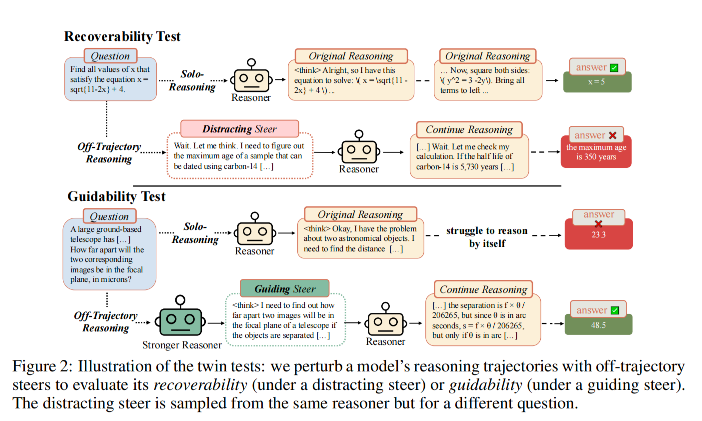
可恢复性测试:选择 在独立推理中能正确回答的测试问题子集。通过截断独立推理轨迹的前个token获得,通过从自身但针对不同问题采样获得干扰轨迹。
可引导性测试:选择 在独立推理中解决率极低(8个样本中0或1个正确)的测试问题子集。不包含 自身的推理轨迹,使用更强推理器 作为引导方构建 。
七、实验设计与结果分析
7.1 实验设置
模型与数据集:评估15个开源LLMs,分为DeepSeek-R1、Qwen3、QwQ和Community四个家族,在1,507个数学问题上进行测试,来源包括AIME-2024、AIME-2025、MATH-500、Minerva和OlympiadBench。
超参数:所有LLMs在相同设置下评估:最大token 32K,温度0.6,top- 0.95,无系统提示。每个问题采样8个补全,报告样本的平均Pass@1。
7.2 关键结果
发现1:基准性能与协作能力脱节表1显示,可恢复性和可引导性与LLMs的独立推理性能基本正交。低基准层模型如OpenThinker3-1.5B和Qwen3-1.7B展现出比中高基准层模型更好的可恢复性。性能最好的独立推理模型AM-Thinking-32B报告了第二差的可恢复性性能。
发现2:推理开始阶段对恢复至关重要图4显示,在轨迹最开始(0%)处引入干扰导致最大的性能下降。消融实验表明,保留原始轨迹的第一段可将大多数LLMs的可恢复性显著提升至83.5%以上。
发现3:LLMs无法有效利用正确引导如表1所示,所有模型在可引导性测试中表现均低于10%。进一步分析发现,即使引导轨迹中已包含正确答案推导,LLMs也经常无法识别这些正确推理,拒绝给定答案并转向错误路径。
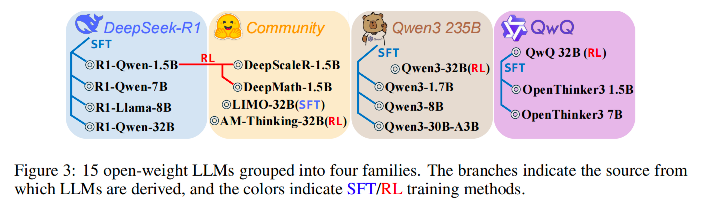
图3:15个开源权重大语言模型按四个家族分组。分支表示LLMs的来源,颜色表示SFT/RL训练方法。
7.3 控制研究结果
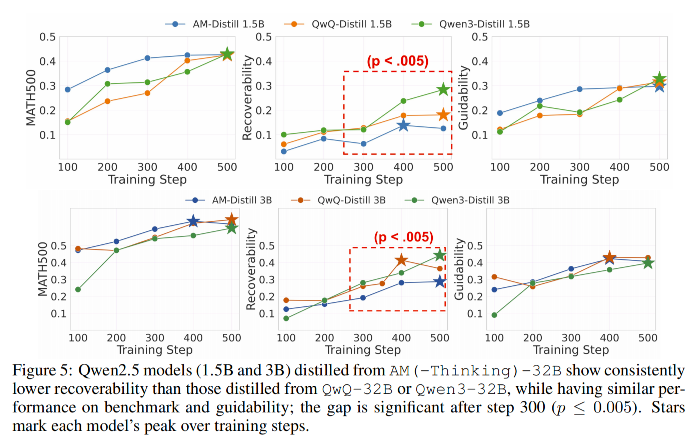
教师模型影响:图5显示,从AM-Thinking-32B蒸馏的学生模型相比从QwQ-32B或Qwen3-32B蒸馏的模型,即使基准性能相似,也表现出显著较低的可恢复性。
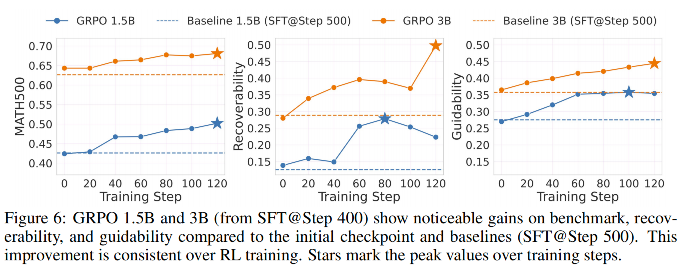
RL训练效果:图6表明,在SFT饱和后,RL训练报告了可恢复性的巨大改善(15.3%-28.9%),同时基准分数略有增加(5.4%-7.6%),可引导性改善8.3%-8.7%。
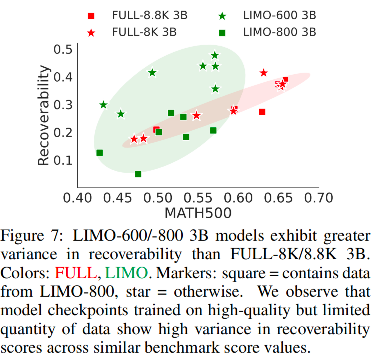
数据量影响:图7显示,在较少数据上训练的模型在可恢复性上不一定更差,但在检查点间表现出极高的方差,而基于较大数据集训练的模型在相同基准分数下具有最小方差。
八、论文结论与启示
本文通过系统评估揭示了独立推理LLMs在偏离轨迹推理中的根本局限性:现有模型既不能有效抵抗干扰,也无法充分利用有用的偏离轨迹输入。研究结果表明,当前为基准性能过度优化的实践未能考虑更广泛的推理能力,其中偏离轨迹推理是内在组成部分。
控制研究提供了可操作的训练见解:蒸馏教师的选择直接影响学生的偏离轨迹推理能力,RL训练能显著改善这些行为,而基于质量启发式的激进数据减少可能导致检查点间可恢复性的高方差。这些发现为训练本质上强大的推理协作模型指明了方向,强调了在标准独立推理评估之外考虑协作能力的重要性。
九、整体评价与讨论
主要优势:
-
提出了系统化的偏离轨迹推理评估框架,填补了协作推理评估的空白。
-
通过大规模控制实验揭示了训练决策对模型协作能力的直接影响。
-
发现了基准性能与协作能力脱节的重要现象,对现有评估体系提出挑战。
局限性:
-
实验主要集中在数学推理领域,在其他领域(如代码生成、常识推理)的泛化性需进一步验证。
-
双模型协作设置相对简化,真实世界协作可能涉及更复杂的多轮交互。
-
对RL改善可恢复性的机制分析不够深入,需要更细致的理论解释。
未来方向:
-
开发专门针对协作推理的训练范式,而不仅仅是优化独立推理性能。
-
探索更复杂的多智能体协作场景,包括动态角色分配和协商机制。
-
研究人类与LLMs在共享推理轨迹上的协作能力。
-
将偏离轨迹推理评估扩展到安全性、伦理对齐等更广泛维度。
本文为理解和发展协作推理系统奠定了重要基础,其提出的评估框架和发现对未来LLMs的训练和评估具有深远影响。
往期推荐
杀疯了!2025 最新Agent Memory顶会论文,拿捏发文密码!
ICCV 2025|FrDiff:频域魔法+扩散模型暴力去雾,无监督性能刷爆榜单!
NeurIPS 2025 | 港科大&上交大HoloV:多模态大模型“瘦身”新突破,剪枝88.9%视觉Token,性能几乎无损
更多推荐


 17
 0
- 0


 已为社区贡献3条内容

所有评论(0)