
Docker+K8s+Helm实战vLLM灰度发布以及请求流程解读
·
🎉 基于 Docker + Kubernetes + Helm 的 vLLM 推理服务部署与灰度发布(Canary)实战
从零开始,使用现代云原生技术栈完成 AI 推理服务的 容器化 → 声明式部署 → 自动扩缩 → Istio 灰度发布 的全流程。
✅ 一、整体目标以及技术栈总览
| 序号 | 目标 |
|---|---|
| 1 | 将 vLLM 模型推理服务容器化 |
| 2 | 使用 Helm Chart 封装部署 |
| 3 | 配置 HPA 自动扩缩容 |
| 4 | 实现 Istio 流量治理与 10% 流量灰度发布(Canary) |
| 5 | 验证流量按权重分发 |
| 技术 | 安装方式 | 作用 |
|---|---|---|
| Docker | sudo yum install docker 或 brew install docker | 构建 & 运行容器,将 vLLM 服务打包成镜像 |
| Minikube | curl -LO https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64 | 本地单节点 Kubernetes 集群,用于开发测试 |
| kubectl | curl -LO "https://dl.k8s.io/release/$(curl -s https://dl.k8s.io/release/stable.txt)/bin/linux/amd64/kubectl" | K8s 命令行工具,管理所有资源 |
| Helm | `curl https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash` |
| Istio | istioctl install --set profile=demo -y | 服务网格,流量治理、灰度发布、可观测性 |
| vLLM | pip install vllm + 自定义 Flask | 高性能大模型推理引擎,暴露 /v1/completions |
🚀 二、完整操作流程(Step by Step)
🔹 第一步:构建 Docker 镜像(本地)
1. 编写 Dockerfile
# Dockerfile.vllm
FROM nvcr.io/nvidia/pytorch:23.10-py3  # 官方 NVIDIA 镜像,支持 GPU

# 安装 vLLM
RUN pip install vllm==0.4.0  # 建议固定版本

# 暴露端口
EXPOSE 8000

# 启动命令(根据你的模型调整)
CMD ["python", "-m", "vllm.entrypoints.openai.api_server", \
     "--host", "0.0.0.0", \
     "--port", "8000", \
     "--model", "meta-llama/Llama-3-8b-instruct" ]
2. 构建 & 推送
docker build -f Dockerfile.vllm -t your-registry/vllm:latest .
docker tag mock-vllm:latest your-registry/mock-vllm:v0.1-mock
docker push your-registry/mock-vllm:v0.1-mock
💡 学到:如何为大模型推理服务定制轻量级镜像
🔹 第二步:编写 Helm Chart 结构
helm create vllm-chart
目录结构
vllm-chart/
├── charts/
├── templates/
│   ├── deployment-v1.yaml
│   ├── deployment-v2.yaml
│   ├── service.yaml
│   ├── hpa.yaml
│   ├── destinationrule.yaml
│   ├── virtualservice.yaml
│   └── gateway.yaml
├── values.yaml
└── Chart.yaml
💡 学到:Helm 是声明式部署的利器,适合管理复杂应用
🔹 第三步:定义资源对象
1. Deployment(v1 & v2)
- v1:稳定版本,
version: v1 - v2:新版本,
version: v2
2. Service(必须命名端口为 http)
selector:
  app: vllm
ports:
  - port: 80
    targetPort: 8000
    name: http   # 必须命名 http 才能被 Istio 路由
3. HPA(自动扩缩容)
helm的values.yaml需要配置一下内容
autoscaling:
  enabled: true
  minReplicas: 1
  maxReplicas: 10
  targetCPUUtilizationPercentage: 50  # CPU >50% 就扩容
  targetMemoryUtilizationPercentage: 80

image:
  repository: your-registry/mock-vllm        # ← 改成你的镜像名
  tag: v0.1-mock                  # ← 镜像标签
  pullPolicy: IfNotPresent     # ← 本地镜像用这个
💡 学到:HPA 可根据 CPU/内存/自定义指标自动伸缩 Pod 数量
🔹 第四步:使用 Istio 实现灰度发布
1. DestinationRule:定义 subset
# destination-rule.yaml
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: vllm-destination-rule
spec:
  host: vllm-service
  subsets:
  - name: v1
    labels:
      version: v1
  - name: v2
    labels:
      version: v2
2. VirtualService:90/10 流量切分
# virtual-service-canary.yaml
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: vllm-virtual-service
spec:
  hosts:
  - vllm-service
  gateways:
  - vllm-gateway
  http:
  - route:
    - destination:
        host: vllm-service
        subset: v1
      weight: 90
    - destination:
        host: vllm-service
        subset: v2
      weight: 10
3. Gateway:入口网关(关键!)
apiVersion: networking.istio.io/v1
kind: Gateway
metadata:
  name: vllm-gateway
spec:
  selector:
    istio: ingressgateway
  servers:
  - port:
      number: 80
      name: http
      protocol: HTTP
    hosts:
    - vllm-service.default.svc.cluster.local   # 必须是 FQDN!
⚠️ 重点:
- short names(如
vllm-service)会被 Istio 拒绝- 必须使用 FQDN:
<svc>.<ns>.svc.cluster.localname: http是 Istio 路由的前提
🔹 第五步:部署并验证
1. 一键安装
helm install vllm-release ./vllm-chart
2. 获取网关地址
export GATEWAY_URL=$(minikube ip):$(kubectl get svc istio-ingressgateway -n istio-system -o jsonpath='{.spec.ports[?(@.name=="http2")].nodePort}')
3. 发送测试请求(带 Host 头)
for i in {1..20}; do
  curl -s -X POST "http://$GATEWAY_URL/v1/completions" \
    -H "Host: vllm-service.default.svc.cluster.local" \
    -H "Content-Type: application/json" \
    -d '{"prompt": "hello", "max_tokens": 1}' -w "\n"
done
🔹 第六步:观察结果
查看网关日志
kubectl logs -n istio-system -l app=istio-ingressgateway -c istio-proxy --tail=20
✅ 成功看到:
- 200 响应
outbound 80 v1 ...和outbound 80 v2 ...- v1 接收 ~90%,v2 接收 ~10%
📚 三、核心知识点总结
| 技术 | 学到的关键点 |
|---|---|
| Docker | 如何为 Python AI 服务构建高效镜像,注意基础镜像选择与依赖管理 |
| Kubernetes | Pod、Service、Deployment、HPA 的协同工作机制 |
| Helm | 使用模板化方式管理复杂应用部署,提升可复用性 |
| Istio | 流量路由、subset、gateway、virtualservice 协同机制 |
| 灰度发布 | 通过 weight 实现 Canary 发布,降低上线风险 |
| FQDN | Istio 安全策略要求必须使用全限定域名,否则报 short names not allowed |
| Service 端口命名 | 必须为 name: http,否则 Istio 不做 HTTP 路由 |
📸 四、推荐截图命令
| 目的 | 命令 | 截图说明 |
|---|---|---|
| 查看所有资源状态 | kubectl get all -l app=vllm | 展示 v1 和 v2 的 Pod 正常运行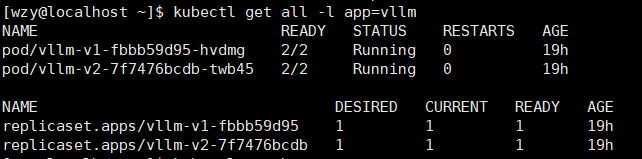 |
| 查看 HPA 状态 | kubectl get hpa | 展示 CPU 使用率和副本数变化 |
| 查看 Service & Endpoint | kubectl get svc vllm-service -o widekubectl get endpoints vllm-service | 确认服务发现正常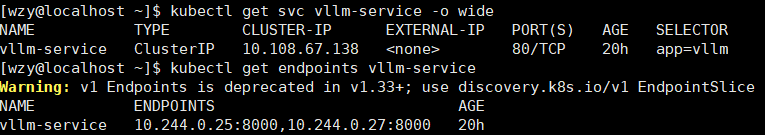 |
| 查看 Istio 资源 | kubectl get gateway,virtualservice,destinationrule -o wide | 确认 hosts 和 weights 正确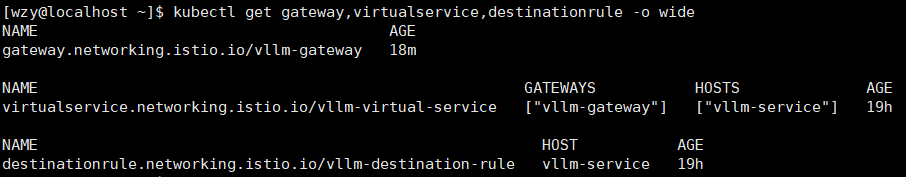 |
| 查看网关日志 | kubectl logs -n istio-system -l app=istio-ingressgateway -c istio-proxy --tail=20 | v1 10.244.0.27/v2 10.244.0.25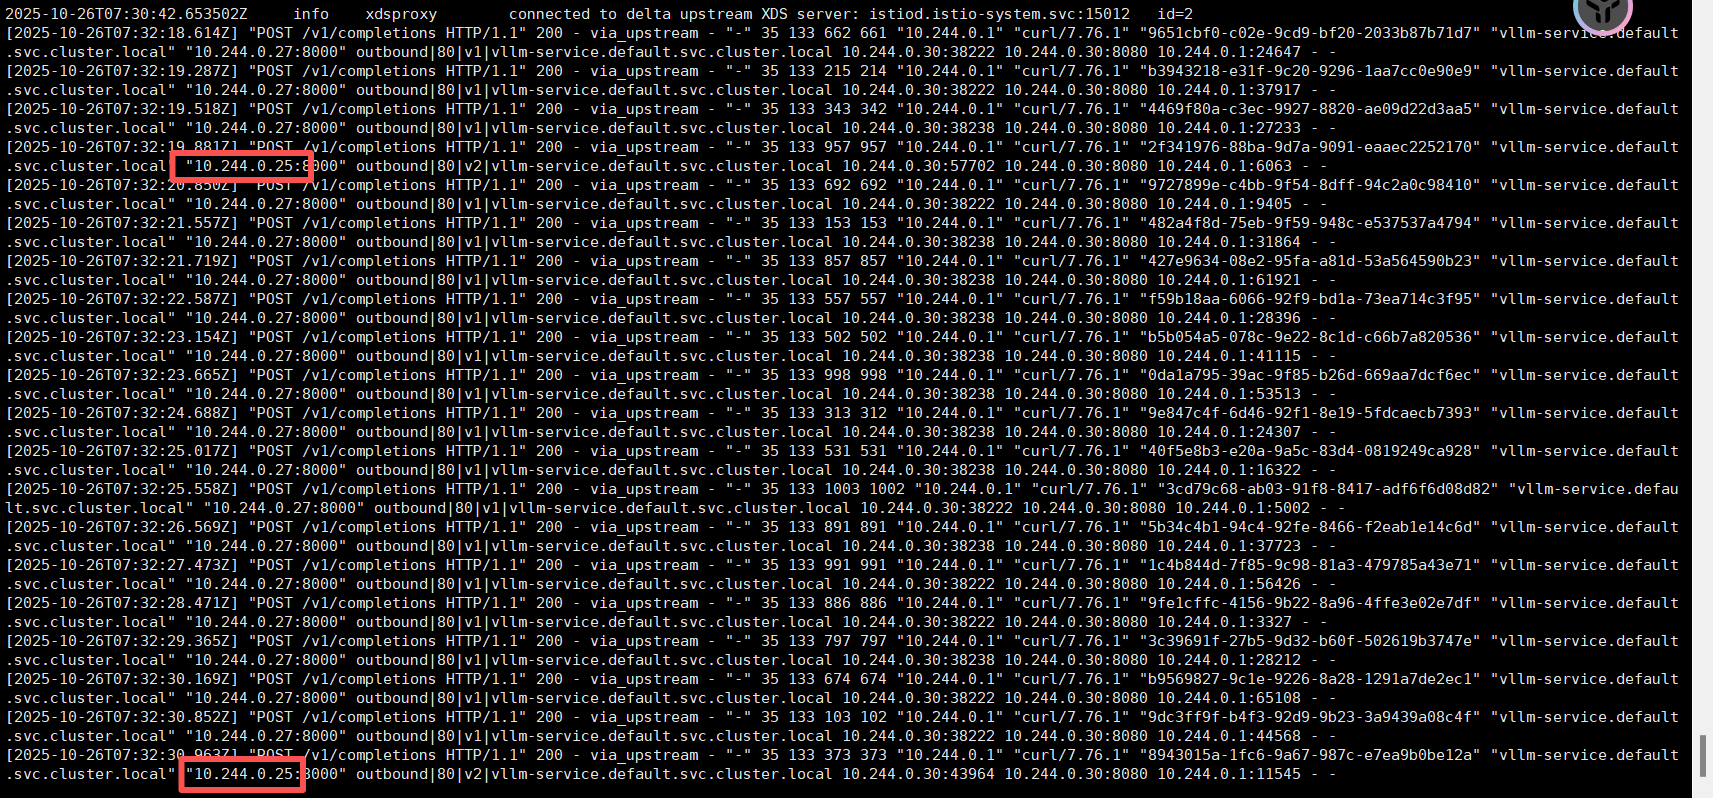 |
🛣️ 五、完整请求路径(从外部到 Pod)
[你的终端]
curl -H "Host: vllm-service.default.svc.cluster.local" \
     http://192.168.49.2:31502/v1/completions
↓
Minikube NodePort (31502 → 80)
↓
Istio Ingress Gateway (istio-ingressgateway Pod)
↓
Gateway 允许该 Host
↓
VirtualService 按权重路由:
  90% → subset: v1
  10% → subset: v2
↓
DestinationRule 找到对应标签的 Pod
↓
Service (vllm-service) 做负载均衡
↓
Pod v1 或 v2 (Flask+vLLM)
↓
返回推理结果
🔍 关键点
- Host 头必须是 FQDN
- Gateway 放行该 Host
- VirtualService 定义权重
- DestinationRule 定义 subset
- Service 负责 Pod 负载均衡
🖼️ 六、系统架构图(文字版)
+---------------------------+
|      你的终端             |
|  curl -H "Host: ..."      |
+-----------+---------------+
            |
            | HTTP
            v
+-----------+---------------+
|   Minikube NodePort       |
|   31502 → 80 (Gateway)    |
+-----------+---------------+
            |
            v
+-----------+---------------+
| Istio Ingress Gateway     |
|  (istio-proxy sidecar)    |
+-----------+---------------+
            |
            | 路由决策
            v
+-----------+---------------+     +----------------------+
|      VirtualService       |---->| DestinationRule      |
|  hosts: vllm-service      |     |  subsets: v1, v2     |
|  weight: 90/10            |     +----------------------+
+-----------+---------------+
            |
            v
+-----------+---------------+
|   Service: vllm-service   |
|   selector: app=vllm      |
+-----------+---------------+
            |
    +-------+-------+
    |               |
    v               v
+---+-----+   +-----+---+
| Pod v1  |   | Pod v2  |
| vllm:v1 |   | vllm:v2 |
+---------+   +---------+
🎯 七、经验教训 & 最佳实践
- Istio 的
Host必须是 FQDN,否则 admission webhook denied - Service 端口必须命名为 http,否则不走 HTTP 路由
- Gateway 必须放行 VirtualService 的
hosts - VirtualService 的
gateways:必须引用存在的 Gateway - 测试时
Host头必须匹配 Gateway 的hosts - 使用 Helm 可大幅减少 YAML 管理成本
🌟 总结一句话
使用现代云原生技术栈(Docker+K8s+Helm+Istio)部署、扩缩、灰度发布一个 AI 推理服务的全流程,具备生产级交付能力!
🌐 终极总结:云原生 AI 推理服务技术栈与请求路径全解析
一份涵盖 技术栈 → 安装方式 → 组件作用 → 请求路径 → 架构图 的终极速查表,用于写文档、做汇报、画架构图。
更多推荐

 39
 0
- 0


 已为社区贡献2条内容

所有评论(0)