
深度学习Step4
提示:莫愁少年不知愁,只怕只愁非少年
这里若是你要写论文用到这篇文章,你使用的技术主要包括深度学习框架PyTorch ,Web框架:Flask,图像处理:PIL,Numpy,机器学习算法:KNN,前端:HTML,CSS,JavaScript。
六 相似图片检索
上面已经实现了图片去噪,图片分类,这里主要是实现图片相似性检索
说起来相似检索也简单,就是获得每一个图片的特征,对这些特征使用KNN找到图片特征的相似性,所以主要是如何得到这个本质特征,一个通用的方式是加载一个图片之后,通过卷积得到低纬特征,这个低纬特征相对于原来来说一定是有所损失的,使用这个低维特征来构建原图,通过训练这个低纬特征就可以认为是本质特征,所以说当你遇到多个女神难以抉择的时候,使用这个相似度检索,看看谁和你更加相似,所以这里甚至不需要划分训练集测试集,直接将所有数据集都用于模型的训练,训练完成之后,再将所有的数据只通过编码器,便可得到所有图片的本质特征,将这些特征进行存储便可。这里模型框架可以直接使用之前的,
6.1 构建文件
config.py 项目配置
data.py 数据处理
model.py 模型定义模块
train.py 数据加载,预处理,
6.2 配置文件模块
配置文件这里几乎是不需要改变的,直接复用便可,其实很多变量都可以放入到配置文件中,这样修改数值就方便很多
import os

import torch

from common.utils import seed_everything

current_dir = os.getcwd()
parent_dir = os.path.dirname(current_dir)# 上一级目录
IMG_HEIGHT = 256
IMG_WIDTH = 256 # 图片尺寸
SEED = 42 # 随机种子
seed_everything(SEED)
BATCH_SIZE = 128
Train_ratio = 0.7 # 训练集比例
VAL_ratio = 0.8
Noise_level = 0.1 # 噪声等级
Epochs = 1
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

Learning_rate = 1e-3 # 学习率
6.3 数据处理模块
这里我们使用深度学习Step2中的数据处理部分,不需要修改
import os

from PIL import Image
from torchvision import transforms
from torch.utils.data import Dataset
import re
from image_denoising.config import parent_dir
# 定义数据集类型
class MyDataset(Dataset):
    def __init__(self, img_dir, transform=None):
        # img_dir:指定图像文件所在的目录路径,用于定位和读取图像数据。
        # transform:图像变换操作,用于对图像进行预处理(如缩放、裁剪、转换为张量等)。当值为 None 时,表示不进行任何变换处理,读取图片因为要进行维度的转化所以需要这个参数
        self.img_dir = img_dir
        self.transform = transform
        self.img_name_list = sorted(os.listdir(img_dir), key=lambda x: int(re.search(r'\d+', x).group()))
        #print(self.img_name_list)


    def __len__(self):
        return len(self.img_name_list)

    def __getitem__(self, idx):
        # 先找文件的完整路径
        img_name = self.img_name_list[idx]
        img_path = os.path.join(self.img_dir, img_name)
        # 读取图片,但是要注意图片的格式,使用Image读取图片的时候默认是RGBA
        # 这里我使用的是RGB格式的图片,所以这里需要转化为RGB格式
        img = Image.open(img_path).convert('RGB')
        if self.transform:
            img = self.transform(img)
        else:
            raise ValueError('transform is None')
        return img  # 返回原始图片


if __name__ == '__main__':
    # 测试数据集排序是否正确
    img_dir = '../common/dataset'
    #print(os.listdir(img_dir))
    img_name_list = sorted(os.listdir(img_dir), key=lambda x: int(re.search(r'\d+', x).group()))
    #print(img_name_list)

    #测试此模块的代码是否正确
    dataset = MyDataset(img_dir)
    # 接下来依然是和上一篇文章一样,定义transform
    transform = transforms.Compose([
        transforms.Resize((256, 256)),
        transforms.ToTensor(),
    ])
    # 创建数据集对象
    dataset = MyDataset(img_dir=parent_dir + '/common/dataset/',
                        transform=transform)  # 注意这里需要多一个斜杠,因为是直接将这个地址和文件的名字直接进行拼接得到特征
    print(len(dataset))
6.4 模型定义
模型定义依然是使用这里我们使用深度学习Step2中的模型定义部分,不需要修改,这里若是你想修改模型,直接修改这个模块便可,这里做一个示范,所以也不进行修改了
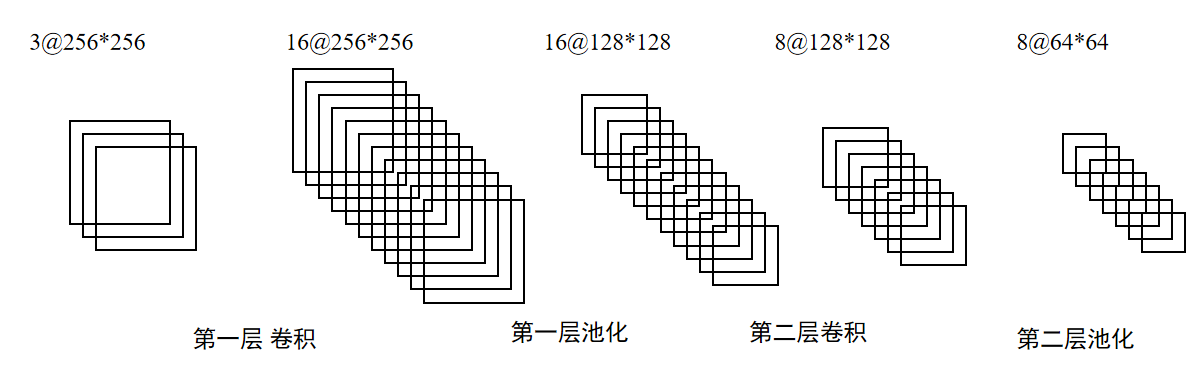
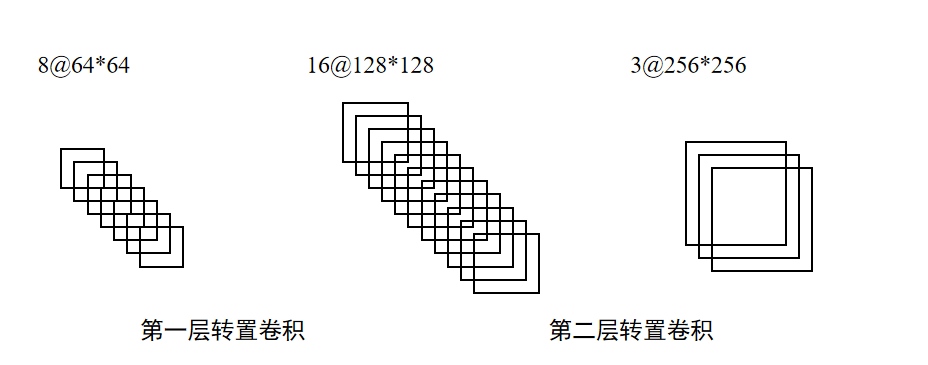
# 创建模型,这里依然是直接使用上一个步骤的模型
import torch
import torch.nn as nn


class MyModel(nn.Module):
    def __init__(self):
        super(MyModel, self).__init__()
        self.encoder = nn.Sequential(
            # 第一层卷积池化层
            nn.Conv2d(3, 16, kernel_size=3, stride=1, padding=1),  # 第一层卷积层
            nn.ReLU(),  # 激活函数(激活函数的作用简单来说从A'到A的过程肯定是一个函数存在的,而激活函数的作用就是让这个函数更加多样化)
            nn.MaxPool2d(kernel_size=2, stride=2, padding=0),
            nn.ReLU(),
            # 第二层卷积池化层
            nn.Conv2d(16, 8, kernel_size=3, stride=1, padding=1),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2, padding=0),
            nn.ReLU()
        )
        self.decoder = nn.Sequential(
            # 第一层转置卷积层
            nn.ConvTranspose2d(8, 16, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.ReLU(),
            # 第二层转置卷积层
            nn.ConvTranspose2d(16, 3, kernel_size=3, stride=2, padding=1, output_padding=1),
            nn.Sigmoid(),  # 这里因为输入是0~1的数,所以输出也是0~1的数,这里因为是最后一层,所以使用Sigmoid激活函数
        )

    def forward(self, x):  # 前向传播,也就相当于是完整的走一遍这个模型的流程
        x = self.encoder(x)
        x = self.decoder(x)
        return x

if __name__ == '__main__':
    # 测试模型是否正确
    input=torch.randn(1, 3, 256, 256)
    model = MyModel()
    output = model(input)
    print(output.shape)
训练模块
模型定义完成之后,接下来自然是模型的训练,训练过程和去噪几乎一样,不过这里的输入不是去噪模块的A’,这里选择的输入是A,将A通过编码器之后自然是维度减低,使用这个降低的维度来通过解码器来构建图片,若是模型训练的足够好的话,那么这个编码器就是能提取图片的本质特征,最后测试部分,再将所有的图片都通过这个编码器便可得到所有图片的本质特征,对于这个本质特征使用KNN便可,和之前的区别不同的地方在于,之前是图片通过整个模型,而这里则是只通过编码器部分,最后得到模型的嵌入之后,这里做了一个小小的测试,先找出三个图片,并且找出这三个图片特征最相似的五个图片,每一次数据加载器中是有一个批次的数据,所以需要拼接得到每一个图片的张量,对于这一个张量再重新塑性,相当于扁平化处理,
from torch import nn
# 创建训练集,测试集
from torch.utils.data import random_split, Subset  # 这个包的作用是划分数据集
from torchvision import transforms
from tqdm import tqdm
import numpy as np

from image_denoising.data import MyDataset
from image_denoising.model import MyModel
from image_denoising.config import device, Epochs, BATCH_SIZE
import matplotlib
matplotlib.use('Agg')  # 添加这一行在导入 pyplot 之前
import matplotlib.pyplot as plt  # 引入这个模块的作用是为了看到这个图片
# 创建数据加载器
import torch
from torch.utils.data import DataLoader
from image_denoising.config import parent_dir

transform = transforms.Compose([
    transforms.Resize((64, 64)),
    transforms.ToTensor(),
])
dataset = MyDataset(img_dir=parent_dir + '/common/dataset/',
                    transform=transform)  # 注意这里需要多一个斜杠,因为是直接将这个地址和文件的名字直接进行拼接得到特征
# train_set, val_set = random_split(dataset, [0.7, 0.3])  # 将数据集进行划分
all_loader = DataLoader(  # 分批次加载训练数据
    dataset,
    batch_size=BATCH_SIZE,
    #shuffle=True,
    drop_last=True  # 如果数据集大小不能被batch_size整除,则最后一个batch将被丢弃
)

model = MyModel()
# 定义损失函数和优化器
loss = nn.MSELoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
# 训练模型
min_loss = float('inf')
model.to(device)
for epoch in tqdm(range(1, Epochs + 1)):
    model.train()
    train_loss = 999
    for data in all_loader:
        data = data.to(device)
        outputs = model(data)
        loss_value = loss(outputs, data)
        loss_value.backward()
        optimizer.step()
        optimizer.zero_grad()
        train_loss += loss_value.item()
    if train_loss < min_loss:
        min_loss = train_loss
        torch.save(model.state_dict(), 'model.pth')
        print(f'Save model with loss: {min_loss:.4f}')

# 测试
# 加载最优模型
model = MyModel()
model.load_state_dict(torch.load('model.pth'))
#只使用模型的编码器部分,并且将每一个图片的编码结果保存到一个新的字典中
model.encoder.eval()
model.encoder.to(device)
embedding = torch.empty(0)
with torch.no_grad():
    for data in all_loader:
        data = data.to(device)
        encoding = model.encoder(data).cpu()
        #将这一批次的特征结果添加到embedding进行拼接
        embedding = torch.cat((embedding, encoding), dim=0)

#将这个张量转化为一个ndarry,并且将一个维度为8*64*64的张量展开为一个向量
embedding = embedding.detach().numpy().reshape(embedding.shape[0], -1)
#保存到文件,方便后续使用
np.save('embedding.npy', embedding)

# 取出特征中的前三个图片,并且计算这三张图片在整个embedding中最相似的五个图片
# 加载之前保存的embedding
embedding = np.load('embedding.npy')

# 提取前三行特征(前三个图片)
top_3_embeddings = embedding[:3]

# 计算余弦相似度并找出最相似的图片
from sklearn.metrics.pairwise import cosine_similarity

for i, img_embedding in enumerate(top_3_embeddings):
    # 计算当前图片与所有图片的相似度
    # img_embedding是1D数组,需要reshape为2D
    similarities = cosine_similarity(img_embedding.reshape(1, -1), embedding)[0]

    # 找出相似度最高的前5张图片(包括自己)
    top_5_indices = np.argsort(similarities)[::-1][:5]

    print(f"图片 {i} 的最相似图片索引: {top_5_indices}")
    print(f"对应的相似度: {similarities[top_5_indices]}")

    # 画出这5张图片
    fig, axs = plt.subplots(1, 5, figsize=(15, 3))
    for j, sim_idx in enumerate(top_5_indices):
        # 从dataset中获取对应索引的图片
        img_tensor = dataset[sim_idx]  # 获取图片张量
        # 转换维度顺序用于显示 (C, H, W) -> (H, W, C)
        img_display = img_tensor.permute(1, 2, 0)
        axs[j].imshow(img_display)
        axs[j].axis('off')
        axs[j].set_title(f'Sim: {similarities[sim_idx]:.3f}')
    plt.savefig(f'similar_images_for_img_{i}.png')
    plt.close()
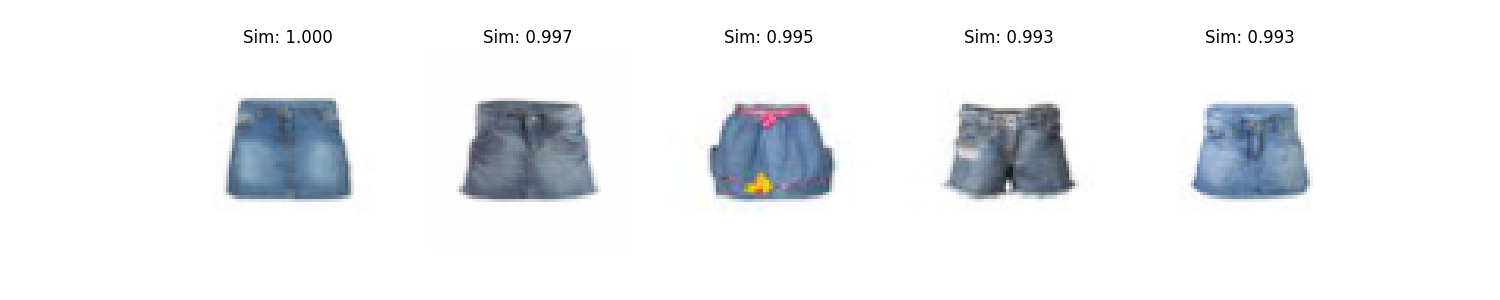
总的来看其实模型差不多,只是稍微做了一些修改,改动不多,最后打印观看效果,第一个是我们本来的图片,后面四个是通过这个本来的图片在数据库中进行查找的四个相似图片,最后今天的全部代码请关注公众号“Sun小明同学获取”
更多推荐
 12
 0
- 0


 已为社区贡献7条内容

所有评论(0)