
人工智能通识与实践 - 机器学习概述
机器学习概述
1 机器学习的概念
1.1 机器学习定义与核心逻辑
定义
机器学习(Machine Learning, ML)是使用数据和算法模仿人类学习方式,通过迭代优化模型以提升预测准确性的研究领域,作为人工智能与计算机科学的分支,是人工智能的核心与技术基础。
核心逻辑
机器学习的“训练-预测”流程与人类从经验中学习的逻辑高度一致:
- 人类学习:积累经验→归纳规律→应对新问题(推测);
- 机器学习:输入训练数据(对应“经验”)→通过算法训练模型(对应“归纳规律”)→用模型处理测试数据(对应“推测新问题”)。
简单来说,机器学习通过数据让模型“学会”规律,再用规律预测未知属性。
1.2 机器学习算法框架
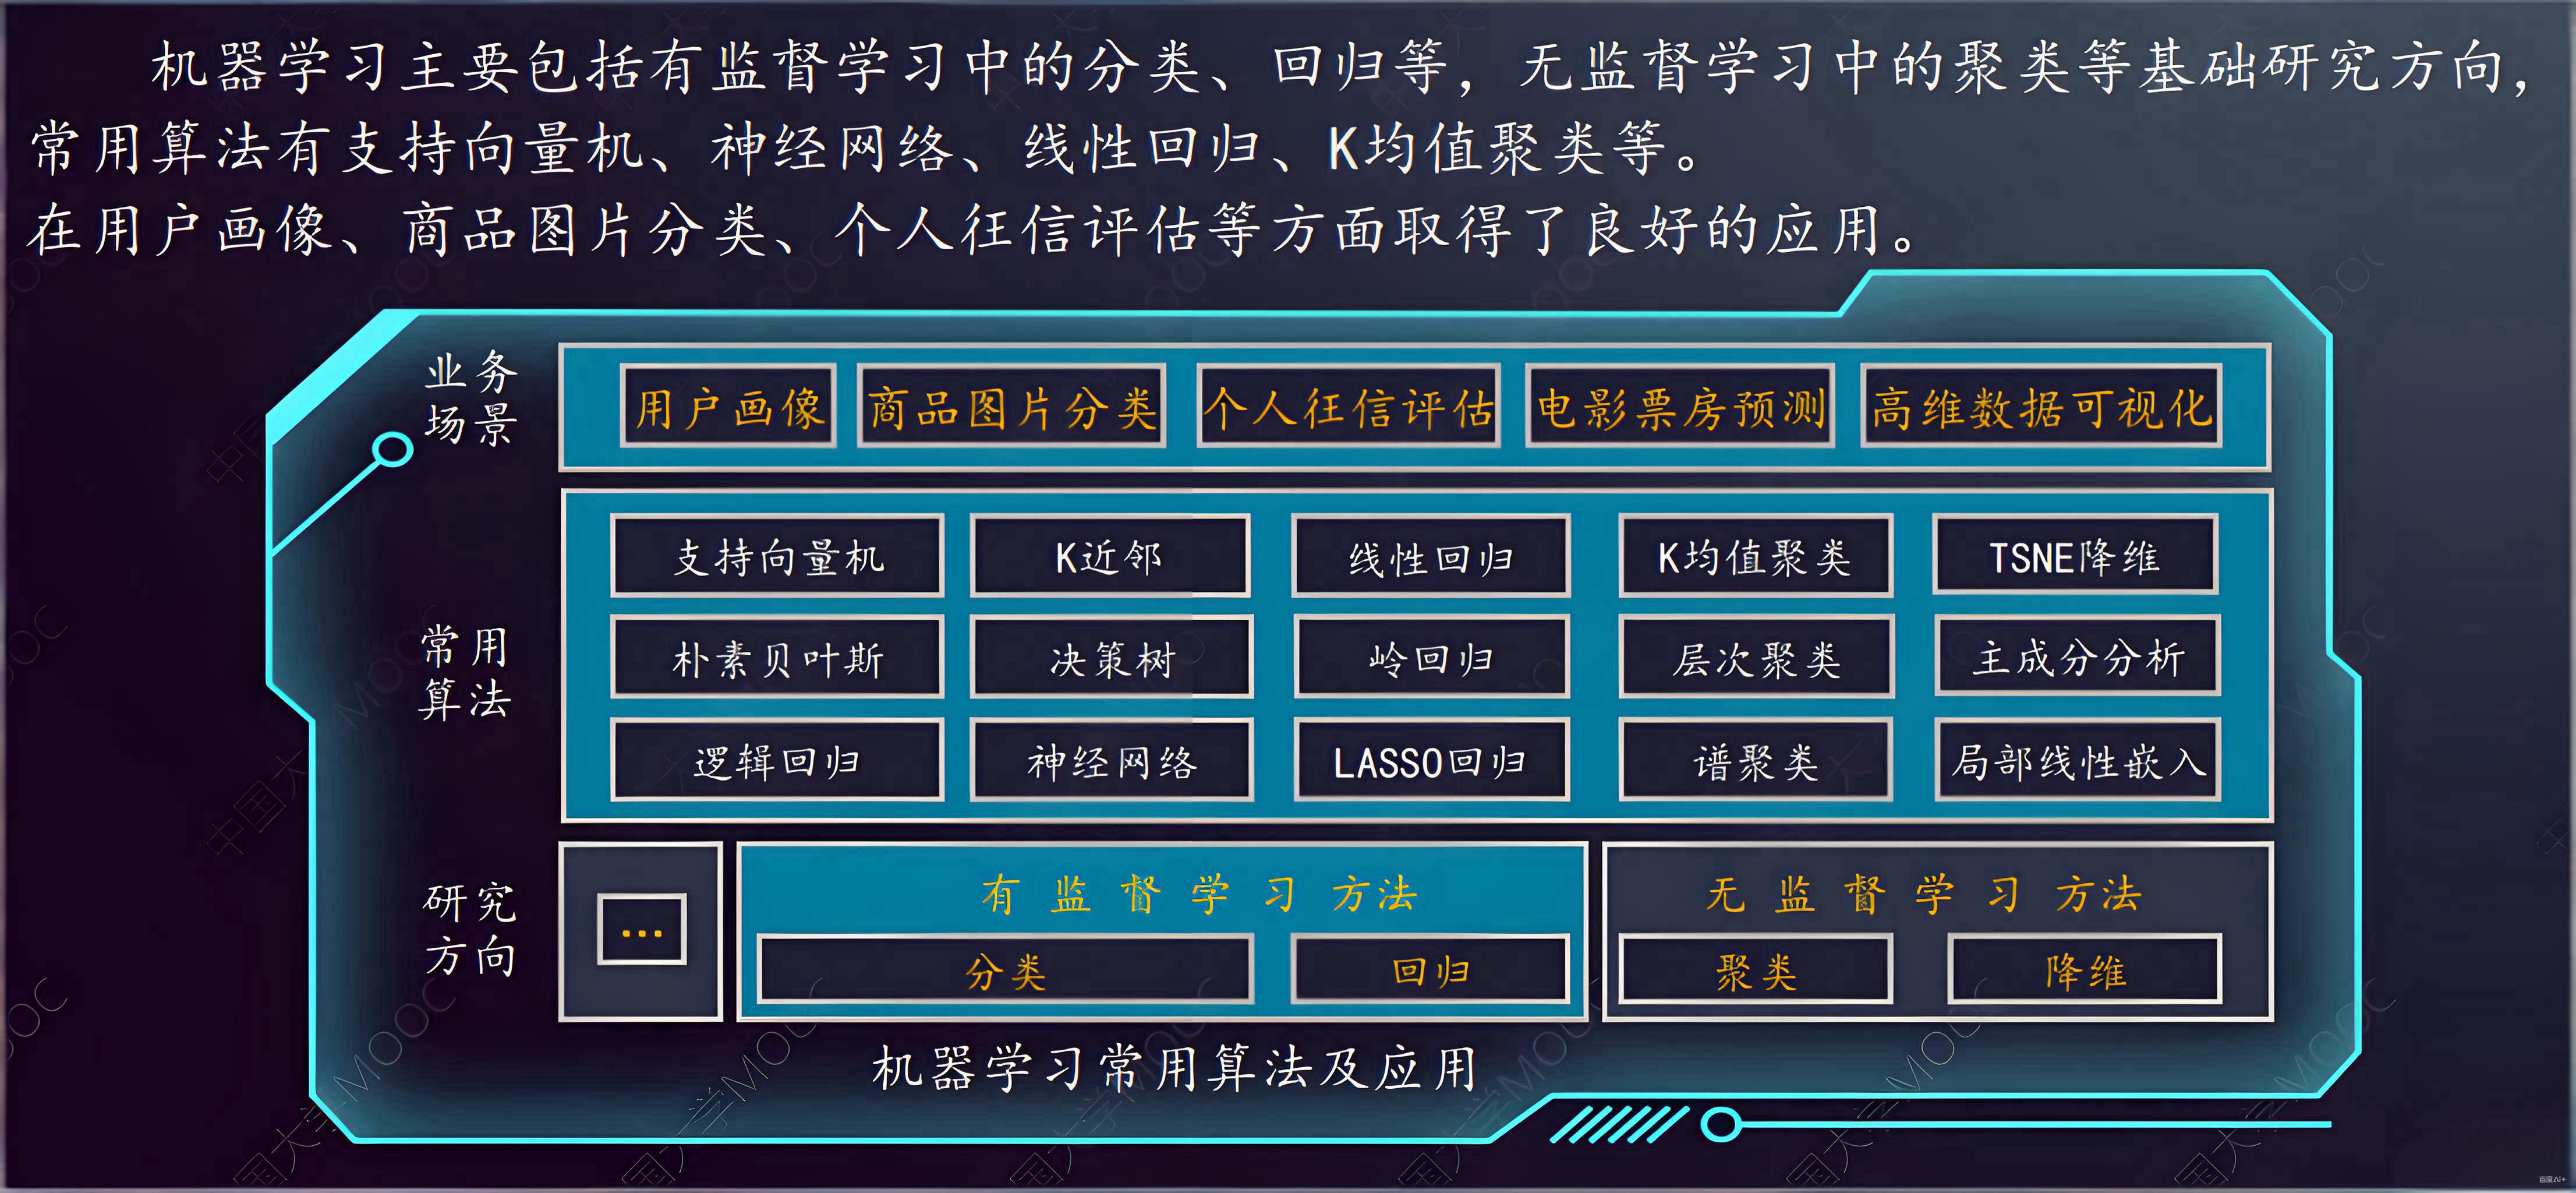
机器学习的技术体系围绕“研究方向-常用算法-业务场景”构建,形成从技术到应用的完整链路:
- 研究方向:
- 有监督学习:含分类(输出离散值)、回归(输出连续值);
- 无监督学习:含聚类(数据分组)、降维(高维数据简化);
- 常用算法:
- 有监督学习:支持向量机、线性回归、逻辑回归、决策树、K近邻(KNN)、朴素贝叶斯、神经网络、岭回归、LASSO回归;
- 无监督学习:K均值聚类、层次聚类、谱聚类、主成分分析(PCA)、TSNE降维、局部线性嵌入;
- 业务场景:用户画像构建、商品图片分类、个人信用评估、电影票房预测、高维数据可视化。
1.3 机器学习一般流程
机器学习需遵循标准化流程,确保模型训练的有效性与可复用性,核心步骤如下:
- 源数据准备:收集原始数据(如用户行为数据、商品属性数据),需保证数据的完整性与相关性;
- 特征工程:对源数据进行预处理(清洗、缺失值填充、异常值处理),并生成符合算法要求的特征(如将“颜色”“形状”等 categorical 特征编码为数值特征);
- 数据集划分:将处理后的数据拆分为训练集(用于模型训练,占比通常60%-80%)与测试集(用于模型评估,占比20%-40%);
- 模型训练:选择适配任务的算法(如分类任务选决策树,回归任务选线性回归),用训练集迭代优化模型参数;
- 模型评估:用测试集验证模型性能(如分类任务看准确率,回归任务看误差),若不达标则返回特征工程或算法选择环节调整;
- 应用落地:将评估通过的模型部署,用于处理新数据并输出预测结果。
2 机器学习的数学基础
数学是机器学习算法设计与优化的核心工具,核心基础包括数据的向量表示与距离度量。
2.1 数据的向量表示
机器学习中,样本数据需转化为向量形式才能被算法处理,单个样本的所有属性构成一个向量,多个样本向量组成数据集(DataSet)。
2.2 常用距离与相似度度量
在聚类、分类(如KNN)等任务中,需通过“距离”判断样本间的相似性,常用度量方式包括:
- 欧氏距离:源自欧氏空间中两点间的直线距离,是最常用的距离度量;
- 曼哈顿距离:又称“街区距离”“出租汽车距离”,模拟城市中两点间沿街道行驶的最短路径;
- 闵可夫斯基距离:欧氏距离与曼哈顿距离的通用形式;
- 汉明距离:用于衡量两个等长字符串的差异,即不同字符的个数;
- 余弦相似度:通过向量夹角余弦值判断相似性,值越接近1表示方向越一致(相似性越高),常用于文本分类、推荐系统。
3 机器学习的分类
根据“是否有标注数据”“学习方式”等维度,机器学习可分为四大核心类型,适用场景差异显著。
3.1 有监督学习
定义
有监督学习(Supervised Learning)是 在已知输入(特征)和输出(标签)的情况下,训练模型建立输入 x x x 到输出 y y y 的映射 f f f ,是机器学习中最成熟、应用最广的类型。
核心分类
| 任务类型 | 输出 y y y 特性 | 核心目标 | 典型示例 |
|---|---|---|---|
| 分类 | 离散变量 | 判断样本属于哪个类别 | 预测明天天气(阴/晴/雨)、期末评定(A/B/C) |
| 回归 | 连续变量 | 预测样本的具体数值 | 预测明天气温(25℃)、期末分数(85分) |
3.2 无监督学习
定义
无监督学习(Unsupervised Learning)是在输出标签未知的情况下,从无标注输入数据中挖掘潜在结构,无需人工标注,适合探索数据内在规律。
核心方法
- 聚类:将相似样本自动归为一类,如根据用户购物行为划分客群;
- 关联规则分析:挖掘数据间的关联关系,经典案例为“啤酒与尿布”(超市数据分析发现购买尿布的顾客常同时购买啤酒,用于商品摆放优化)。
与有监督学习的关键差异
| 对比维度 | 有监督学习 | 无监督学习 |
|---|---|---|
| 目标清晰度 | 目标明确(预测已知标签) | 目标不明确(探索数据结构) |
| 训练数据标注 | 训练数据已标记(含标签) | 训练数据未标记(无标签) |
| 效果评估难度 | 易评估(对比预测标签与真实标签) | 难评估(无统一客观标准) |
3.3 迁移学习
定义
迁移学习(Transfer Learning)是将源领域(已积累知识的领域)的知识迁移到目标领域(新领域),提升目标领域的学习效果,类比人类“举一反三”的学习能力。
价值
当目标领域数据量少、标注成本高时,迁移学习可复用源领域的模型参数(如用ImageNet数据集训练的图像识别模型,微调后用于医疗影像分类),大幅降低训练成本。
3.4 强化学习
定义
强化学习(Reinforcement Learning, RL)又称“增强学习”,是智能体(Agent)通过与环境(Environment)交互,学习最优策略以最大化回报或实现特定目标的学习范式。
核心机制
- 交互循环:智能体在环境中处于某一状态 s s s → 执行动作 a a a → 环境反馈奖赏 r r r(正奖赏鼓励该动作,负奖赏惩罚该动作)→ 智能体根据奖赏调整策略,迭代优化;
- 典型案例:“贪吃蛇游戏”——小蛇(智能体)在环境中收集绿球(获正奖赏)、避开红球(获负奖赏),通过“好奇心”驱动不断学习最优移动策略。
分类场景辨析
以“学生成绩分析”为例,不同数据条件对应不同机器学习类型:
- 无成绩信息,仅挖掘学生兴趣爱好(如根据学习时长、朋友活动次数分组)→ 无监督学习(聚类);
- 有部分成绩信息,预测其余成绩:
- 成绩以等级制描述(A/B/C)→ 有监督学习(分类);
- 成绩以数值描述(80分/90分)→ 有监督学习(回归)。
4 机器学习的常用算法
不同算法适配不同任务场景,以下为五大核心算法的原理与特点。
4.1 线性回归
核心原理
线性回归是通过构建线性函数 y = k x + b y=kx+b y=kx+b(单变量)或 y = k 1 x 1 + k 2 x 2 + . . . + k n x n + b y=k_1x_1+k_2x_2+...+k_nx_n+b y=k1x1+k2x2+...+knxn+b(多变量),拟合输入特征 x x x 与输出 y y y 之间的线性关系,核心目标是最小化预测值与真实值的误差(常用均方误差MSE)。
应用示例
- 单变量场景:根据“每分钟虫鸣声次数”( x x x)预测“温度”( y y y),通过线性函数拟合两者关系;
- 多变量场景:根据“房屋面积”“卧室数量”“地段”等特征预测“房价”。
4.2 支持向量机
核心原理
支持向量机(Support Vector Machine, SVM)是通过寻找最优超平面,最大化不同类别样本间的间隔(Margin) 的分类算法,“支持向量”指距离超平面最近的样本点,决定超平面的位置。
核心优势
- 适用于高维数据(如文本分类),可通过核函数(如RBF核)处理非线性分类问题;
- 泛化能力强,对小样本数据集表现优异。
4.3 决策树
核心原理
决策树是以树状结构表示决策规则的算法,从根节点(初始特征)开始,通过特征判断(如“大小是否为大”“颜色是否为红”)分裂为子节点,最终到达叶节点(分类结果),直观易懂且可解释性强。
应用示例
- 水果分类决策树:根节点“大小”→ 大:分支“形状”(圆→颜色:红=苹果、黄=桔子;弯月=香蕉);小:直接判定为樱桃;
- 西瓜质量判断决策树:根节点“纹理”→ 清晰:分支“根蒂”(蜷缩=好瓜、稍蜷=坏瓜、硬挺=坏瓜);模糊:分支“触感”(硬滑=坏瓜、软粘=坏瓜)。
4.4 K近邻算法(KNN)
核心原理
K近邻算法(K-Nearest Neighbors, KNN)是基于“物以类聚”思想,通过计算测试样本与训练样本的距离,选取距离最近的K个邻居,以邻居的多数类别作为测试样本类别的分类算法(也可用于回归,取K个邻居的均值)。
优缺点
- 优点:逻辑简单、无需训练建模、易实现;适合稀有事件分类、多分类问题(如基因功能分类);
- 缺点:属于“惰性算法”,存储所有训练样本导致内存开销大;测试时计算量大,性能较低;可解释性差,无法输出决策规则。
4.5 K均值聚类算法
核心原理
K均值聚类(K-Means)是无监督学习中最常用的聚类算法,通过以下步骤将数据分为K个簇:
- 随机选取K个样本作为初始聚类质心;
- 计算所有样本到各质心的距离,将样本分配到距离最近的簇;
- 计算每个簇的样本均值,更新为新的质心;
- 重复步骤2-3,直到样本所属簇不再变化或达到迭代次数上限。
关键注意事项
- K值需提前指定(可通过肘部法则、轮廓系数选择最优K);
- 初始质心的选择会影响聚类结果,通常通过多次随机初始化取最优解。
5 机器学习的典型应用
机器学习已渗透到生活、交通、社交等多领域,以下为六大典型应用场景:
5.1 虚拟个人助理
- 核心功能:语音交互、日程管理、信息查询、任务提醒;
- 典型案例:百度度秘、苹果Siri、微软小冰;
- 应用示例:“查询今天的日程安排”“设置明天早上6点的闹钟”“提醒后天访问签证办事处”。
5.2 交通预测
- 核心功能:道路拥堵状况预测、交通流量分析、交通信号灯配时优化、公共交通线路调整;
- 典型案例:打车软件(如滴滴)通过预测乘客需求与交通状况,动态调整车费价格(高峰时段溢价)。
5.3 社交媒体服务
- 核心功能:基于用户社交行为(朋友列表、访问记录、兴趣标签、工作信息、群组分享),推荐潜在好友;
- 应用目标:提升用户社交活跃度,拓展社交关系链。
5.4 视频监控
- 核心功能:实时跟踪人体行为,识别异常动作(如长时间静止、绊倒、长椅打盹);
- 应用目标:提前预警安全风险,在犯罪或意外事件发生前干预,提升公共安全水平。
5.5 智能客服
- 核心功能:通过自然语言处理理解用户查询,以人性化交互提供解答;
- 应用目标:替代部分人工客服,降低企业服务成本,同时提升用户咨询响应速度与满意度。
5.6 商品推荐
- 核心功能:分析用户行为(购买历史、浏览记录、品牌偏好),构建用户画像,推送个性化商品;
- 应用目标:提升用户购物体验,增加商品点击率与购买转化率,如电商平台(淘宝、京东)的“猜你喜欢”模块。
更多推荐


 13
 0
- 0


 已为社区贡献6条内容

所有评论(0)