
本地部署Ollama大模型并实现WebAPI调用的实践指南
·
快速体验
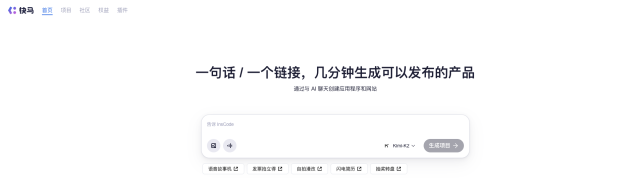
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个本地大模型API调用系统,用于通过Web接口调用Ollama大模型服务。系统交互细节:1.部署Ollama容器 2.下载qwen2.5模型 3.实现文本生成/对话/嵌入功能API 4.提供模型管理接口。注意事项:需预先安装Docker环境。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
1. 环境准备与部署
- Docker是运行Ollama的基础环境,需要先到官网下载适合自己操作系统的Docker Desktop版本
- 安装完成后通过命令行验证docker是否正常工作
- 使用官方提供的docker run命令快速部署Ollama服务,注意保持11434端口的开放
- 进入容器内部下载所需的大模型,例如qwen2.5这种轻量级中文模型
2. API接口开发要点
- 文本生成接口是最基础的功能,需要设置model参数指定使用的模型
- 流式接口适合生成长文本内容,可以实时看到生成过程
- 对话接口支持多轮交互,需要维护messages历史消息列表
- 嵌入接口可以将文本转换为向量表示,便于后续的语义分析
3. 模型管理功能
- 通过tags接口可以查看本地已下载的模型列表
- show接口可以获取模型的详细信息,包括版本和配置参数
- create接口支持基于现有模型创建自定义版本
- pull和delete接口分别用于模型的下载和删除操作
4. 开发注意事项
- 所有API请求都需要设置正确的Content-Type头部
- 流式接口返回的是分块数据,需要特殊处理
- 模型下载可能耗时较长,建议在后台运行
- 不同模型对硬件要求不同,需要根据实际情况选择
平台体验
在InsCode(快马)平台上,可以直接生成完整的API调用项目,无需手动编写代码。我实际测试发现,通过简单描述就能自动生成可运行的Python项目,特别适合快速验证想法。
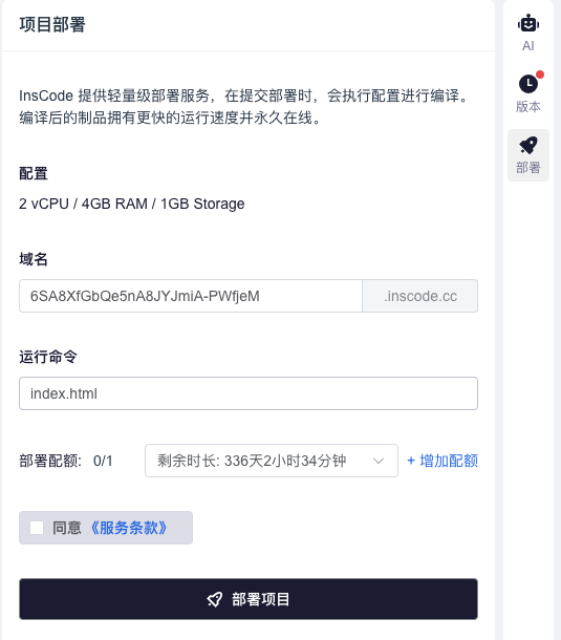
对于需要持续提供API服务的场景,推荐使用平台的一键部署功能,直接将项目发布到线上环境。整个过程无需配置服务器,特别适合个人开发者和小型团队快速搭建AI服务。
更多推荐


 4
 0
- 0


 已为社区贡献65条内容

所有评论(0)