
RAG技术:大模型如何精准获取外部知识
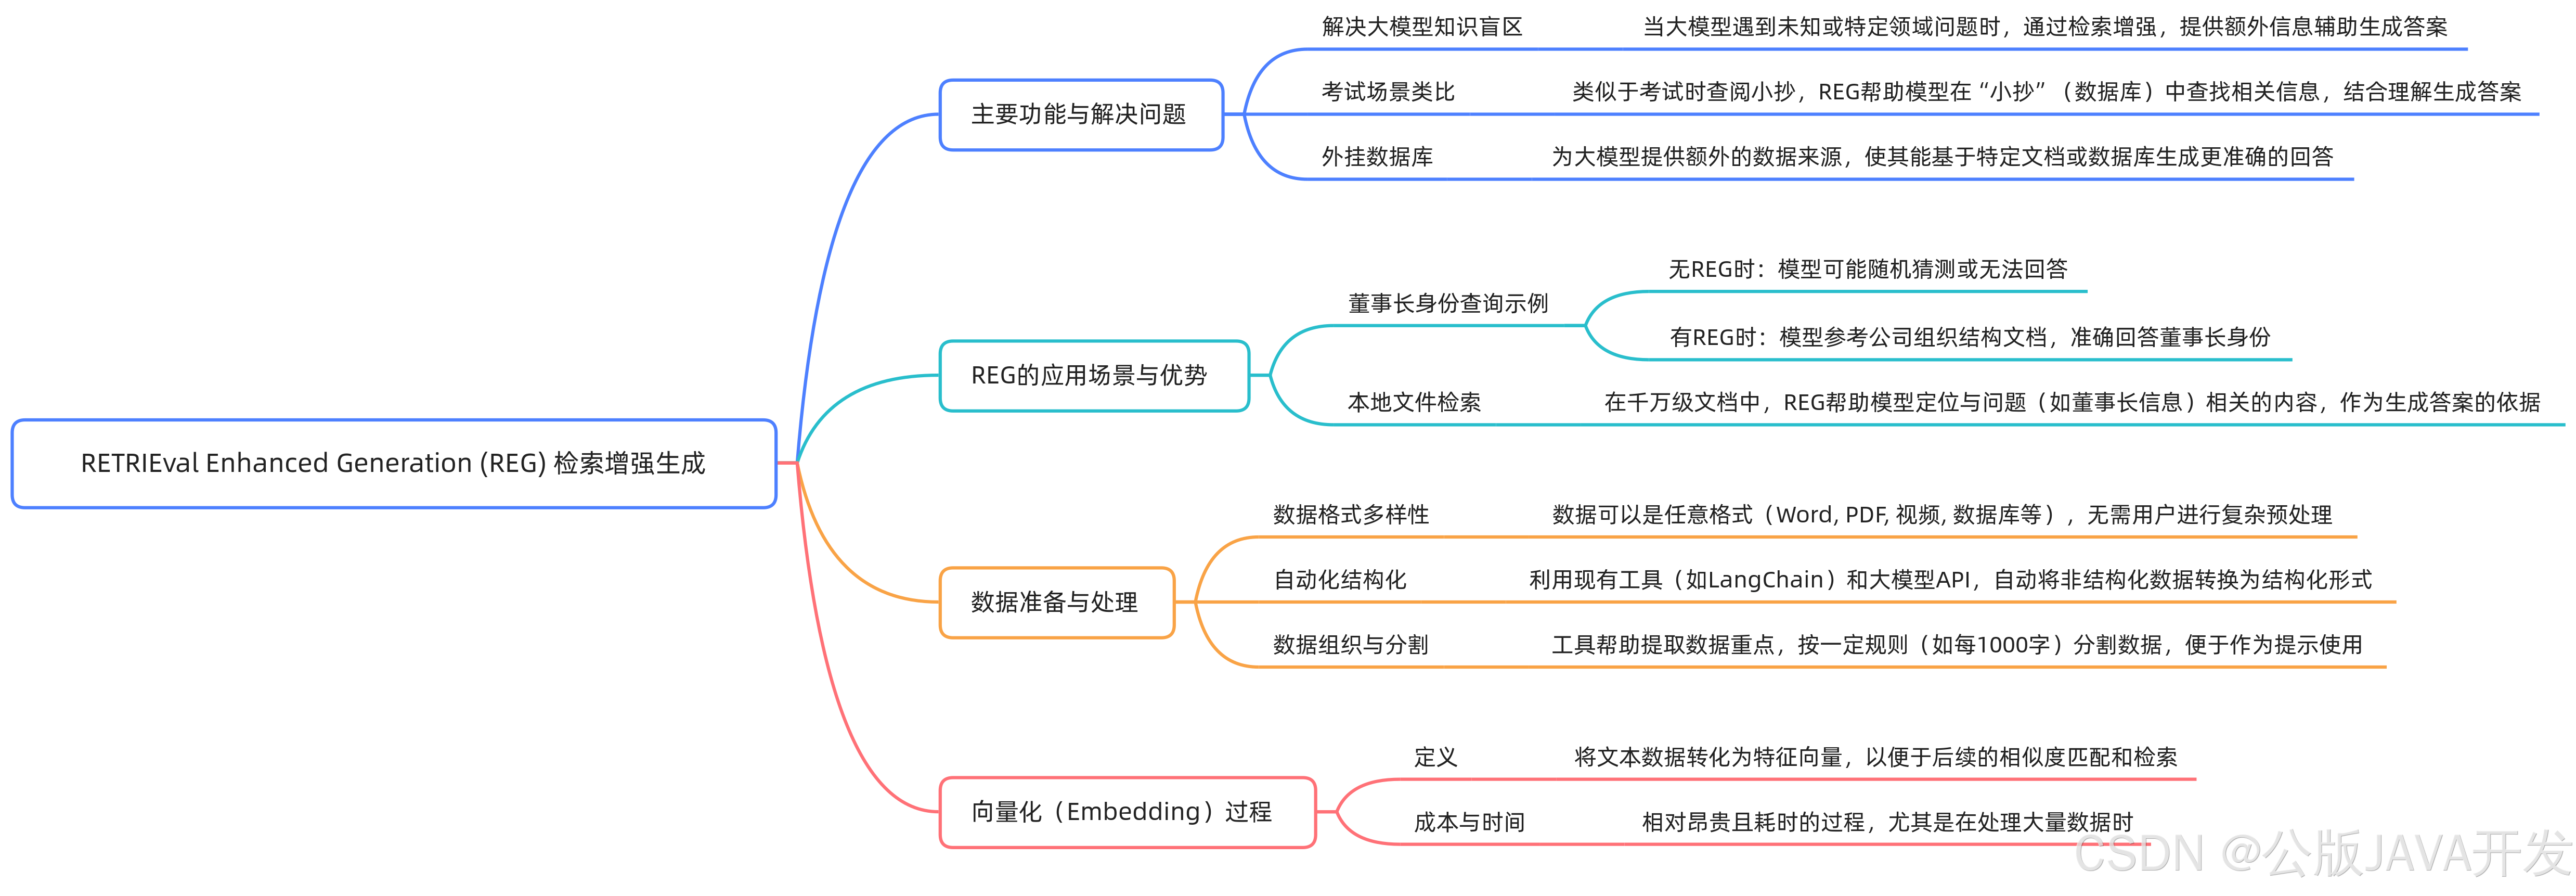
检索增强生成(RAG)技术解析一、什么是RAG?
定义: 检索增强生成(Retrieval-Augmented Generation, RAG)是一种结合外部知识库与大模型生成能力的技术。其核心思想是:当大模型遇到未知问题时,通过检索本地或私有数据库中的相关内容,将检索到的信息作为“上下文提示”输入给模型,从而辅助生成更准确、更可靠的答案。核心功能:提升准确性:避免模型“凭空编造”答案,确保回答基于真实数据。支持私有知识:允许模型访问特定领域或企业的私有信息(如内部文档、数据库等)。动态更新:知识库可实时更新,模型答案随数据变化而调整。
二、RAG的应用场景
类比理解: 类似考生在考试时遇到难题,通过查阅“小抄”(外部资料)来辅助答题。
实际案例:企业问答系统:问题:“公司董事长是谁?” → 无RAG可能回答错误姓名;有RAG可检索公司内部文档,准确返回“张某某”。问题:“工厂某历史事件的时间?” → 基于历史档案数据提供精确回答。个人助手:整合用户个人文档(如邮件、笔记),回答个性化问题(如“我的会议记录中提到过哪些关键点?”)。垂直领域应用:医疗(基于病历回答病情)、金融(基于财报分析风险)等,需依赖专业数据源的场景。
三、RAG vs 无RAG:回答效果对比无RAG模型:问题:缺乏上下文,可能生成不准确、甚至虚构的答案(如“董事长爱谁谁”)。局限:依赖模型预训练知识,无法访问实时或私有数据。有RAG模型:流程:检索:在本地文档中搜索与问题相关的数据(如文档3提到董事长信息)。增强提示:将检索到的内容附加到原始问题提示中,形成更完整的输入。生成:模型基于“问题 + 上下文”生成准确答案。优势:答案基于真实数据,可靠性大幅提升,减少幻觉(hallucination)。
四、RAG的实现流程(关键步骤)第一步:数据准备(Data Preparation)数据来源多样化:支持PDF、Word、CSV、JSON、视频文本、数据库等格式。无需手动结构化:使用自动化工具处理数据。工具与流程:数据整理(Organization):提取重点信息(如标题、关键词、段落摘要)。数据分割(Segmentation):将长文档拆分为小片段(如每1000字一个单元),提升检索效率。自动化工具:使用开源框架如LangChain,调用API接口完成数据清洗、格式转换和分割。第二步:Embedding(向量化)核心目标:将文本转化为高维向量(特征向量),用于相似度计算和快速检索。流程:使用预训练的嵌入模型(如BERT、GPT编码器、专用向量化模型)将每个文本片段转换为向量。向量存储在向量数据库(如Chroma、FAISS、Milvus)中,支持高效近似最近邻搜索(ANN)。挑战:耗时与成本高:向量化过程需要大量计算资源,尤其是处理大规模数据时。模型选择:不同嵌入模型的效果差异大,需根据数据特性调优。
五、总结与关键洞察优势:准确性提升:通过外部知识库补充模型知识盲区。私有化支持:适用于企业保护敏感数据场景。可扩展性:知识库可动态扩展,模型能力随数据增长而增强。挑战与瓶颈:向量化成本:时间和资源消耗大,需优化向量模型或采用分布式计算。数据质量:检索效果依赖数据准备的充分性和准确性(如分割粒度、关键词提取)。实时性:若数据更新频繁,需设计高效的数据同步和向量更新机制。实践建议:使用成熟工具(如LangChain)简化数据预处理流程。选择合适的向量数据库平衡检索速度和精度。定期评估和优化嵌入模型,提升相关性匹配效果。
六、未来方向多模态RAG:结合图像、音频等非文本数据,扩展检索范围。实时RAG:优化数据流处理,支持毫秒级响应。联邦学习集成:在保护隐私的前提下,聚合多方知识库进行联合检索。核心要点回顾:RAG本质:检索 + 增强生成,用外部数据纠正模型偏差。关键步骤:数据准备(整理、分割)→ 向量化(嵌入模型 + 向量数据库)。成功要素:高质量数据预处理、高效的向量化与检索架构。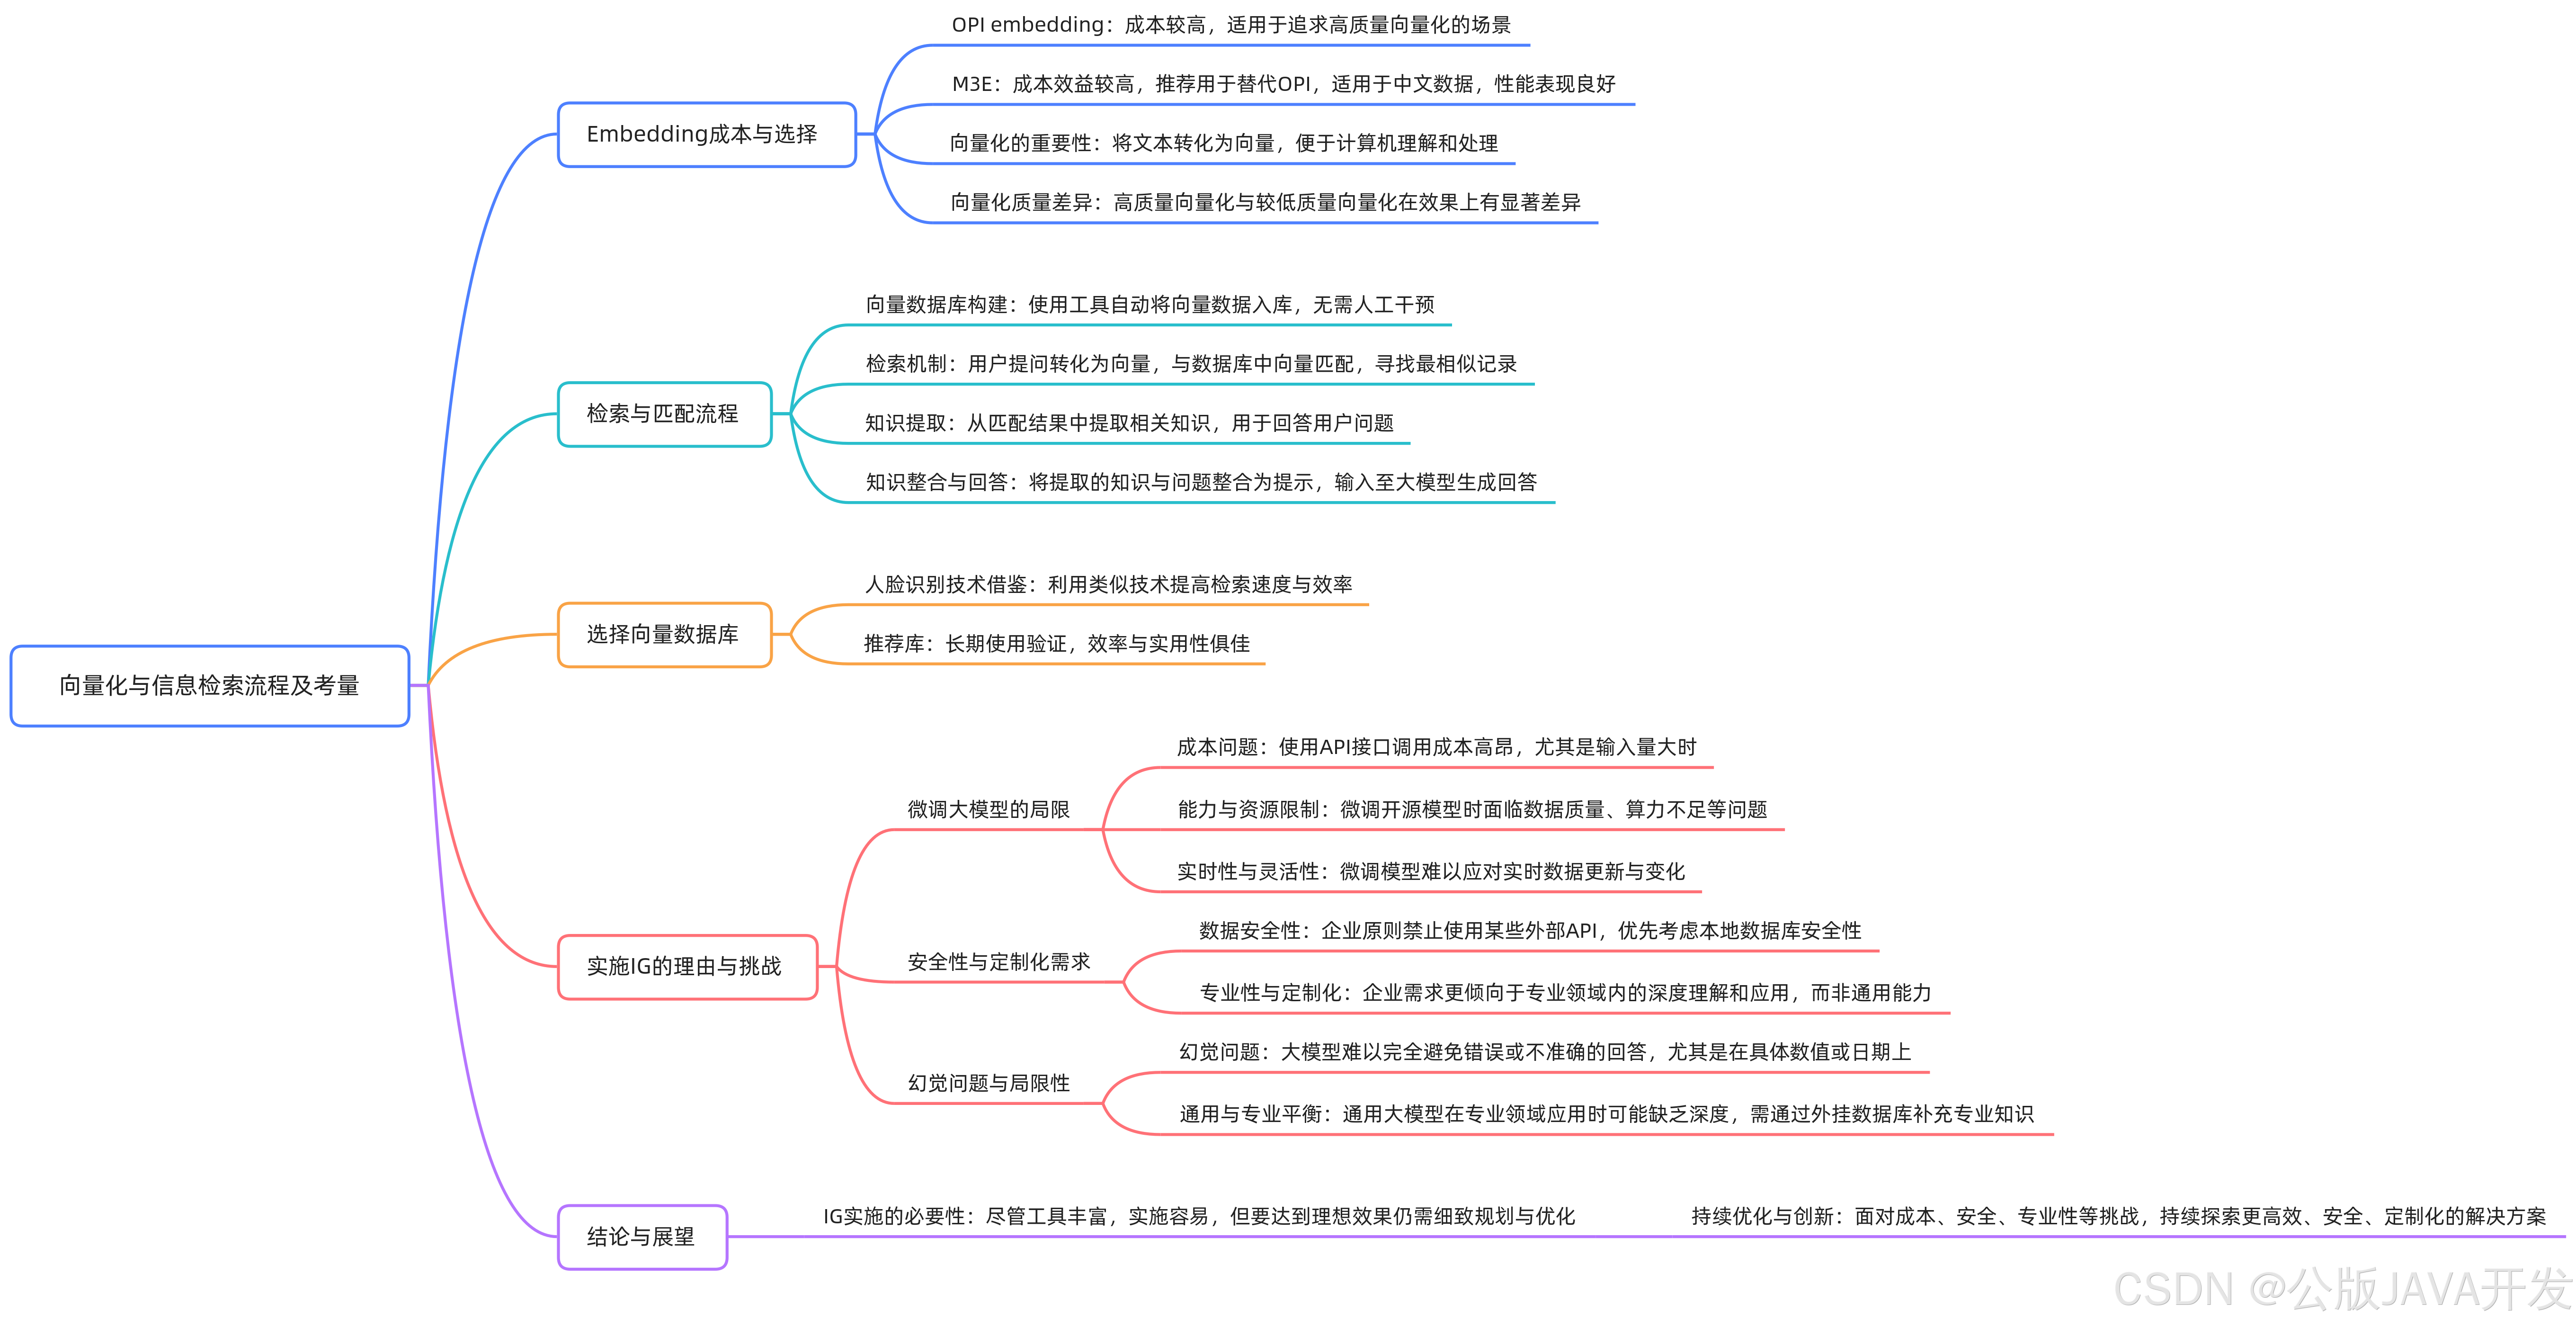
一、Embedding 成本与选择高质量Embedding需投入资源:训练和优化成本高。常见选择:OpenAI Embedding:效果佳但需付费,存在成本压力。推荐M3E模型:优势:针对中文数据优化,效果媲美OpenAI。适用场景:中文语境下的企业应用,降低经济成本。
二、向量化入库与检索机制流程步骤:向量化处理:使用工具将文本转化为向量(高维空间中的点)。入库存储:将向量存入向量数据库(如Milvus、Chroma等)。用户提问转化:将问题转化为Embedding向量。检索相似度:在数据库中查找与问题向量相似度最高的Top 10记录。应用场景示例:用户提问“董事长是谁”,系统检索相关文档并返回信息。核心逻辑:通过向量相似度匹配快速定位知识来源。
三、结合大模型生成答案Prompt构建:将检索到的Top 10知识与用户问题整合为结构化Prompt。示例Prompt:“请根据以下知识回答问题:[知识内容1][知识内容2]...”。生成答案:大模型(如LLM)基于整合后的Prompt生成最终回答,返回用户。关键作用:确保回答基于可靠数据,减少模型“幻觉”。
四、向量数据库的选择与应用场景技术类比:类似人脸识别技术,通过向量特征高效检索。实际案例:宠物识别项目(快速匹配宠物特征信息)。应用场景扩展:企业知识库检索、客户问题解答、文档智能推荐等。
五、为何选择RAG而非微调模型微调模型痛点:成本问题:提示内容过长导致Token收费高(尤其长文本场景)。数据与资源限制:数据质量不足影响微调效果。算力要求高,中小企业难以负担。模型能力有限,泛化性差。更新困难:实时数据变化(如公司董事长更换)需重新微调,耗时且成本高。无法动态适应数据变更。合规风险:企业内部可能禁止使用OpenAI等外部服务,需本地化部署。RAG优势:实时检索最新数据,无需频繁微调。降低训练成本与算力依赖。符合数据安全与合规要求。
六、RAG的优势与适用场景核心优势:数据可控:本地数据库存储,避免数据上传风险。准确性提升:通过检索提供可靠信息,减少大模型虚构(AI幻觉)。垂直领域专业性:针对企业特定知识库,回答更精准(如法律、医疗等)。适用场景:企业客服机器人、内部知识管理系统、合规敏感领域(金融、政务等)。
七、RAG的局限与未来思考当前局限:效果依赖数据质量:若原始数据杂乱或标注不足,检索精度受影响。模型适配挑战:需匹配高性能Embedding模型与向量数据库。响应速度优化:大规模数据下,检索效率可能成为瓶颈。未来方向:提升检索算法精度(如语义理解增强)。优化向量数据库性能,支持毫秒级响应。结合多模态数据(文本+图像+音频)扩展RAG能力。
总结核心观点:企业必要性:RAG通过低成本、高可控性、实时更新能力,解决了微调模型在成本、合规、数据动态性上的痛点,成为企业构建安全、精准知识应用的关键路径。技术核心:Embedding向量化+向量数据库检索+大模型生成的三层架构,实现了数据与模型的协同增效。
更多推荐


 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)