
生物信息学机器学习应用 - 模型 - 工具全景速查表
生物信息学的核心挑战是将海量生物数据(基因组、转录组、蛋白质组等)转化为生物学洞察,而机器学习是实现这一转化的核心工具。本速查表系统梳理生物信息学各核心场景的应用目标、推荐模型、典型工具、数据需求及实战建议,为研究者提供从问题定义到工具选型的全流程参考。
一、基因序列分析:解码 DNA/RNA 的功能密码
基因序列(DNA/RNA)的核心是 4 种核苷酸的排列,机器学习通过挖掘序列模式揭示其功能(如编码能力、调控作用)。
| 应用场景 | 核心任务 | 推荐模型 | 典型工具 | 数据需求 | 核心优势 | 主要局限性 |
|---|---|---|---|---|---|---|
| 基因功能预测 | 区分编码 RNA(mRNA)与非编码 RNA(lncRNA/miRNA);预测基因功能(如代谢 / 信号通路) | ・深度学习:CNN(捕捉局部保守位点)、LSTM/GRU(建模序列依赖)、Transformer(如 DNABERT,长程依赖)・传统:SVM(k-mer 特征)、随机森林(融合 GC 含量 / 长度特征) | • PLEKv2:lncRNA 识别专用工具,基于 SVM,跨物种准确率达 98.7%,支持自定义特征• DNABERT:基于 Transformer 的预训练模型,无需人工特征,微调后可预测多种功能(如 lncRNA 亚细胞定位)• CPAT:传统工具,结合 ORF 长度 / 密码子使用频率,编码潜能预测 AUC>0.95 | 训练集:≥1 万条标注序列(编码 / 非编码);测试集:FASTA 格式序列 | 深度学习自动提取特征,适合长序列;传统模型轻量,小数据即可用 | 深度学习需大量数据,小样本易过拟合;传统模型依赖人工特征(如 k-mer 选择影响结果) |
| 遗传变异检测与注释 | 识别 SNP/InDel;判断变异致病性(如癌症驱动突变) | ・深度学习:CNN+Transformer(上下文建模)、图神经网络(GNN,融合变异网络)・传统:随机森林(保守性 / 氨基酸改变特征)、逻辑回归(测序质量特征) | • DeepVariant:Google 开发的 CNN 模型,将变异检测转化为图像识别,低覆盖度数据(5×)准确率超 GATK(传统工具)15%• SnpEff:传统注释工具,整合保守性评分(PhyloP)、氨基酸改变类型,输出致病性概率• ClinVarNet:基于 Transformer,直接处理原始测序数据,罕见变异识别率提升 30% | 检测:≥100 个基因组(BAM/CRAM 格式);注释:≥1 万条已知致病性变异 | 深度学习捕捉序列上下文,提升稀有变异检测率;传统工具可解释性强,适合临床验证 | 深度学习需 GPU,计算成本高;传统工具依赖数据库(如 ClinVar),新变异注释不准 |
| 调控元件识别 | 预测启动子、增强子、剪切位点、转录因子结合位点(TFBS) | ・深度学习:CNN(局部 motif)、Transformer(长程互作)、U-Net(基因组区间注释)・传统:HMM(隐马尔可夫模型,如剪切位点 GU-AG 模式)、随机森林(表观特征) | • DeepSEA:CNN 模型,从 DNA 序列预测染色质状态(如启动子 / 增强子),AUC>0.9• HMMER:基于 HMM 的 motif 搜索工具,适合已知 TF 结合基序(如 JASPAR 数据库)• Basset:CNN + 残差网络,整合表观修饰数据(如 DNase-seq),增强子预测准确率提升 20% | 训练集:≥5 千条标注调控区域(如 ENCODE 数据);输入:FASTA 格式基因组片段 | 深度学习直接处理原始序列,发现未知调控模式;传统工具适合已知 motif 分析 | 增强子 / 启动子边界模糊,模型定位精度有限;HMM 依赖先验 motif,新元件识别能力弱 |
| 转录因子结合预测 | 预测 TF 与 DNA 的结合位置及强度 | ・深度学习:CNN + 注意力机制(聚焦核心 motif)、Transformer(多 TF 协同)・传统:朴素贝叶斯(motif 特征)、SVM(融合染色质开放性) | • DeepBind:CNN 模型,输入 DNA 序列 + TF 信息,结合强度预测 Pearson 相关系数 > 0.8• MEME Suite:传统工具,从 ChIP-seq 数据挖掘 TF motif,适合单一 TF 分析• TF-MoDISco:整合 CNN 与 motif 解释,输出结合位点的核心序列模式 | 训练集:≥1 万条 ChIP-seq 峰值序列;输入:FASTA 格式 DNA 片段 | 深度学习可预测多 TF 协同作用;传统工具适合 motif 发现,解释性强 | 多 TF 互作数据稀缺,模型泛化性差;MEME 对短序列(<20bp)敏感 |
二、基因表达与转录组分析:解析基因激活的动态规律
转录组数据(基因表达量)反映基因活性,机器学习用于挖掘表达模式与表型的关联(如疾病、细胞状态)。
| 应用场景 | 核心任务 | 推荐模型 | 典型工具 | 数据需求 | 核心优势 | 主要局限性 |
|---|---|---|---|---|---|---|
| 差异表达基因筛选 | 识别处理组 vs 对照组中表达显著变化的基因(如癌症 vs 正常组织) | ・深度学习:自编码器(降噪筛选)、对比学习(差异特征)・传统:DESeq2/edgeR(统计检验)、SVM-RFE(特征选择) | • DESeq2:传统统计工具,基于负二项分布,适合 RNA-seq 差异分析,输出 padj 值• SCANPY:单细胞分析工具,集成自编码器,从高稀疏数据中筛选差异基因• MAST:针对单细胞 RNA-seq 的统计模型,处理零膨胀数据 | 样本量:≥3 个生物学重复;数据格式:表达矩阵(TPM/RPKM) | 传统工具适合简单实验设计(两组对比);深度学习处理高噪声 / 高稀疏数据(如单细胞) | 自编码器需大量样本(≥100),小数据过拟合;DESeq2 对批次效应敏感 |
| 基因调控网络构建 | 推断基因间调控关系(如 A 激活 B,B 抑制 C) | ・深度学习:图神经网络(GNN,建模网络拓扑)、Transformer(时序依赖)・传统:贝叶斯网络(因果推断)、GENIE3(随机森林) | • GENIE3:基于随机森林的调控网络工具,输入表达矩阵,输出基因间调控分数• PyTorch Geometric(PyG):GNN 库,构建基因共表达网络,捕捉间接调控关系• GRNBoost2:梯度提升树模型,处理时间序列表达数据 | 样本量:≥100(静态网络);≥5 个时间点(动态网络);数据:表达矩阵 | GNN 建模复杂网络拓扑,适合间接调控分析;贝叶斯网络支持因果解释 | 调控网络动态性难捕捉(需时间序列数据);高维数据(>1 万基因)计算耗时 |
| 单细胞转录组分析 | 细胞分群、轨迹推断(分化路径)、细胞通讯预测 | ・深度学习:自编码器 / VAE(降维聚类)、深度轨迹模型(如 Monocle3)・传统:t-SNE/UMAP(降维)、K-means(聚类) | • Seurat:综合工具,支持 PCA+UMAP 降维、Louvain 聚类,单细胞分群准确率 > 90%• scVI:基于 VAE 的单细胞模型,同时实现降维、去批次、聚类,整合多平台数据• Monocle3:轨迹推断工具,拟合细胞分化的连续路径 | 细胞数:≥1 千(分群);≥1 万(轨迹推断);数据:单细胞表达矩阵(.h5ad) | 深度学习处理高稀疏性(>50% 零值),保留细胞异质性;传统工具轻量,易上手 | 轨迹推断依赖假设(如树状结构),复杂分化路径(如分支融合)预测不准 |
| 基因表达量预测 | 预测基因在不同条件下的表达水平(如药物处理 / 疾病) | ・深度学习:LSTM(时序预测)、Transformer(多条件)、多模态模型(融合基因组 + 环境)・传统:XGBoost(特征组合)、PLS(共线性处理) | • XGBoost:结合遗传变异 + 临床特征(如年龄 / 药物),预测基因表达,R²>0.7• DeepExpression:LSTM 模型,处理时间序列表达数据(如昼夜节律基因),RMSE<0.1• sPLS-DA:传统偏最小二乘模型,适合多组学输入 | 训练集:≥1 千样本;输入:遗传变异 + 临床 / 环境特征;输出:表达量 | 深度学习捕捉非线性交互(如基因 - 环境互作);传统模型可解释性强,适合小数据 | 多条件数据(如 10 种药物浓度)稀缺,模型泛化性受限;LSTM 对短时序(<5 个点)效果差 |
三、蛋白质分析:从序列到结构再到功能的全链条解析
蛋白质是生命活动的执行者,机器学习实现 “序列→结构→功能” 的快速预测,突破实验方法局限。
| 应用场景 | 核心任务 | 推荐模型 | 典型工具 | 数据需求 | 核心优势 | 主要局限性 |
|---|---|---|---|---|---|---|
| 蛋白质结构预测 | 从氨基酸序列预测三维结构(原子坐标) | ・深度学习:Transformer(如 AlphaFold 系列)、扩散模型(如 RoseTTAFold)、GNN(距离约束)・传统:同源建模(如 SWISS-MODEL)、Threading(如 I-TASSER) | • AlphaFold3:DeepMind 最新模型,支持蛋白质 + 核酸 + 小分子复合物预测,CASP15 中 RNA 结构预测超专用模型• RoseTTAFold:开源模型,计算成本仅为 AlphaFold2 的 1/10,适合资源有限场景• SWISS-MODEL:传统同源建模工具,依赖已知模板,覆盖 85% UniProt 序列 | 输入:FASTA 格式氨基酸序列;训练需百万级 PDB 结构数据 | AlphaFold3 达原子级精度(RMSD<1Å);RoseTTAFold 支持长链(>2000aa) | AlphaFold3 部分闭源,需 API 调用;同源建模依赖模板,新折叠类型预测差 |
| 蛋白质功能注释 | 预测酶活性、亚细胞定位、参与通路(如 GO/KEGG) | ・深度学习:CNN+LSTM(序列 + 结构)、ESM-2(Transformer 预训练)・传统:随机森林(结构域特征)、BLAST(序列相似性) | • DeepGOPlus:基于 BERT 的 GO 注释工具,覆盖 3 万 + 功能术语,准确率超传统方法 25%• iLearnPlus:集成 19 种序列编码 + 21 种模型,支持酶 EC 编号 / 亚定位预测• BLAST2GO:传统工具,基于序列相似性注释,适合已知家族 | 训练集:≥1 万条标注功能的蛋白质;输入:FASTA 序列 | 深度学习整合多源特征(序列 + 结构);传统工具适合已知家族,解释性强 | 功能注释数据不平衡(部分 GO 术语样本少);跨物种泛化性差(如原核→真核) |
| 蛋白质 - 配体结合预测 | 预测药物分子与靶蛋白的结合亲和力(KD);筛选候选药物 | ・深度学习:GNN(分子图)、3D CNN(空间结构)、Transformer(多模态融合)・传统:分子对接(如 AutoDock)、随机森林(分子指纹) | • SchNet:GNN 模型,基于原子间距离预测结合能,Pearson 相关系数 > 0.85• AutoDock Vina:传统分子对接工具,适合刚性对接,计算成本低• EquiBind:几何深度学习模型,处理分子旋转不变性,柔性对接准确率提升 30% | 训练集:≥10 万药物 - 靶点对(如 PDBbind 数据库);输入:蛋白结构(PDB)+ 配体 SMILES | GNN 建模分子间动态互作;传统对接工具适合初筛,易部署 | 柔性对接(蛋白构象变化)处理困难;需大量高质量亲和力数据(实验测量成本高) |
| 蛋白质相互作用(PPI)预测 | 判断两个蛋白质是否互作(如形成复合物) | ・深度学习:Siamese 网络(双序列映射)、Transformer(序列对)、GNN(结构互作)・传统:贝叶斯网络(共表达)、SVM(结构域重叠) | • DeepPPI:Siamese-CNN 模型,输入蛋白质序列,PPI 预测准确率 > 90%• STRING:传统数据库 + 工具,整合共表达 / 文献证据,输出互作置信度• Pafnucy:基于 3D CNN,从结构预测互作位点,F1 分数 > 0.8 | 训练集:≥5 万已知 PPI 对(如 STRING 数据库);输入:序列或结构 | 深度学习直接用序列预测,无需结构;传统工具整合多源证据,可靠性高 | 互作数据存在偏倚(已知互作多来自模式生物);结构 - based 模型依赖高质量 PDB 结构 |
四、疾病与临床分析:从基因组到精准医疗的桥梁
机器学习将生物数据转化为临床工具,如疾病预测、诊断分型、个性化治疗推荐。
| 应用场景 | 核心任务 | 推荐模型 | 典型工具 | 数据需求 | 核心优势 | 主要局限性 |
|---|---|---|---|---|---|---|
| 疾病风险预测 | 基于基因组 / 临床数据预测患病概率(如乳腺癌 / 糖尿病) | ・深度学习:MLP(多因素交互)、注意力机制(聚焦高贡献特征)・传统:随机森林(特征组合)、逻辑回归(可解释性) | • XGBoost:乳腺癌风险预测,结合 BRCA 突变 + 年龄 + 家族史,AUC=0.85• PRSice-2:传统多基因风险评分工具,整合全基因组 SNP,输出风险值• DeepRisk:MLP 模型,融合基因组 + 影像 + 临床,冠心病风险预测 AUC 提升 10% | 训练集:≥1 万样本(病例 + 对照);输入:SNP + 临床指标 | 传统模型可解释性强(如特征重要性);深度学习捕捉非线性交互(如基因 - 环境) | 深度学习 “黑箱” 难临床信任;稀有病数据少(<1 千样本),模型泛化差 |
| 疾病诊断与分型 | 基于多组学数据区分疾病亚型(如癌症分子分型) | ・深度学习:CNN(图像 + 基因组融合)、自编码器(无监督分型)・传统:SVM(表达谱)、K-means(聚类) | • CNN + 病理图像:肺癌 EGFR 突变分型,结合 HE 染色切片 + 基因表达,准确率 = 0.88• TCGAbiolinks:传统工具,整合多组学数据,支持癌症亚型聚类• VAE 分型模型:无监督学习,胶质母细胞瘤 IDH 突变亚型识别率 > 90% | 样本量:≥500 例(多组学数据:表达 + 甲基化 + 临床) | 多模态模型综合影像 / 基因信息,提升分型精度;传统工具适合单一组学,易复现 | 数据异质性大(不同医院测序平台);亚型边界模糊(如癌症混合型) |
| 生物标志物发现 | 筛选诊断 / 预后的核心分子(基因 / 蛋白 / 代谢物) | ・深度学习:自编码器(瓶颈层特征)、注意力权重分析・传统:LASSO(稀疏特征)、随机森林(特征重要性) | • LASSO 回归:肝癌预后标志物筛选,从 2 万基因中缩至 10 个,C-index=0.78• Autoencoder+SHAP:通过自编码器瓶颈层 + 可解释性分析,发现结直肠癌新标志物• SAM(Significance Analysis of Microarrays):传统工具,基于 t 检验筛选差异基因 | 样本量:≥100 例;输入:多组学特征矩阵 | 深度学习发现非线性关联标志物;传统方法统计显著性明确,易验证 | 标志物泛化性受人群 / 实验影响;多组学整合易引入冗余特征 |
| 药物响应预测 | 预测患者对药物的疗效 / 副作用(如化疗敏感性) | ・深度学习:Transformer(多组学 + 药物)、GNN(分子 - 基因互作)・传统:XGBoost(突变 + 药物特征)、PLS(共线性) | • GraphDRP:GNN 模型,输入患者基因组图 + 药物分子图,预测响应率,AUC=0.82• pRRophetic:传统工具,基于表达谱预测化疗敏感性,与临床吻合率 > 70%• DeepTox:多任务模型,同时预测药物毒性与疗效 | 训练集:≥5 千患者(药物 + 响应 + 多组学);输入:突变 + 药物 SMILES | 深度学习整合多模态数据(基因 + 药物 + 临床);传统工具适合小样本,计算快 | 药物 - 患者匹配数据稀缺(如罕见癌种药物数据);个体差异(如肠道菌群)难建模 |
五、宏基因组与微生物组分析:解析 “隐形器官” 的生态功能
微生物组(如肠道菌群)与健康、环境密切相关,机器学习用于物种注释、功能预测及与疾病关联分析。
| 应用场景 | 核心任务 | 推荐模型 | 典型工具 | 数据需求 | 核心优势 | 主要局限性 |
|---|---|---|---|---|---|---|
| 微生物物种分类 | 从宏基因组测序片段注释物种(属 / 种水平) | ・深度学习:CNN(序列模式)、Transformer(长片段)・传统:朴素贝叶斯(16S 特征)、k-mer 比对(如 Kraken2) | • MetaPhlAn4:整合深度学习模块,16S / 宏基因组物种注释,低丰度物种(<0.1%)识别率提升 20%• Kraken2:传统 k-mer 比对工具,速度快(100GB 数据 / 小时),适合大规模样本• DeepMicrobes:CNN 模型,直接处理原始 reads,物种分类准确率 = 0.92 | 训练集:≥1 万参考基因组;输入:宏基因组 reads(FASTQ) | 深度学习处理未知物种(无参考基因组);传统工具速度快,适合初筛 | 新物种注释依赖数据库覆盖度;长读长测序(如 ONT)数据处理工具少 |
| 微生物功能预测 | 预测群落代谢通路(如短链脂肪酸合成)、酶活性 | ・深度学习:自编码器(功能模块)、GNN(物种 - 功能网络)・传统:随机森林(物种丰度)、PICRUSt2(参考基因组) | • PICRUSt2:传统工具,基于物种丰度预测功能通路,覆盖 4 万 + KO 术语• LorBin:三代宏基因组分箱工具,重构 MAGs(宏基因组组装基因组)比传统工具多 15-189%,提升功能预测基础• DeepFunctional:自编码器模型,整合基因丰度与代谢物数据,功能预测 R² 提升 15% | 样本量:≥100 例;输入:物种丰度表 / 基因丰度表 | LorBin 处理长读长数据,提升稀有物种功能解析;传统工具依赖参考基因组,易部署 | 功能预测受数据库限制(如未知基因功能无法注释);长读长测序成本高 |
| 微生物 - 疾病关联分析 | 识别与疾病相关的微生物(如肠炎中的促炎菌群) | ・深度学习:GNN(菌群互作网络)、对比学习(病例 vs 对照)・传统:逻辑回归(丰度差异)、关联规则挖掘 | • MaAsLin2:传统工具,基于多变量统计,识别与疾病相关的物种 / 功能,控制混杂因素(如年龄)• MicrobiomeGNN:GNN 模型,构建 “物种 - 物种 - 疾病” 网络,预测潜在关联,AUC=0.85• LEfSe:用于发现生物标志物,结合 LDA 与 Wilcoxon 检验 | 样本量:≥50 例(病例 + 对照);输入:物种丰度表 + 临床表型 | GNN 捕捉菌群互作(如 A 菌抑制 B 菌),关联更全面;传统工具统计显著性明确,易解释 | 菌群数据高变异性(个体 / 时间波动大);关联多为相关性,难证明因果 |
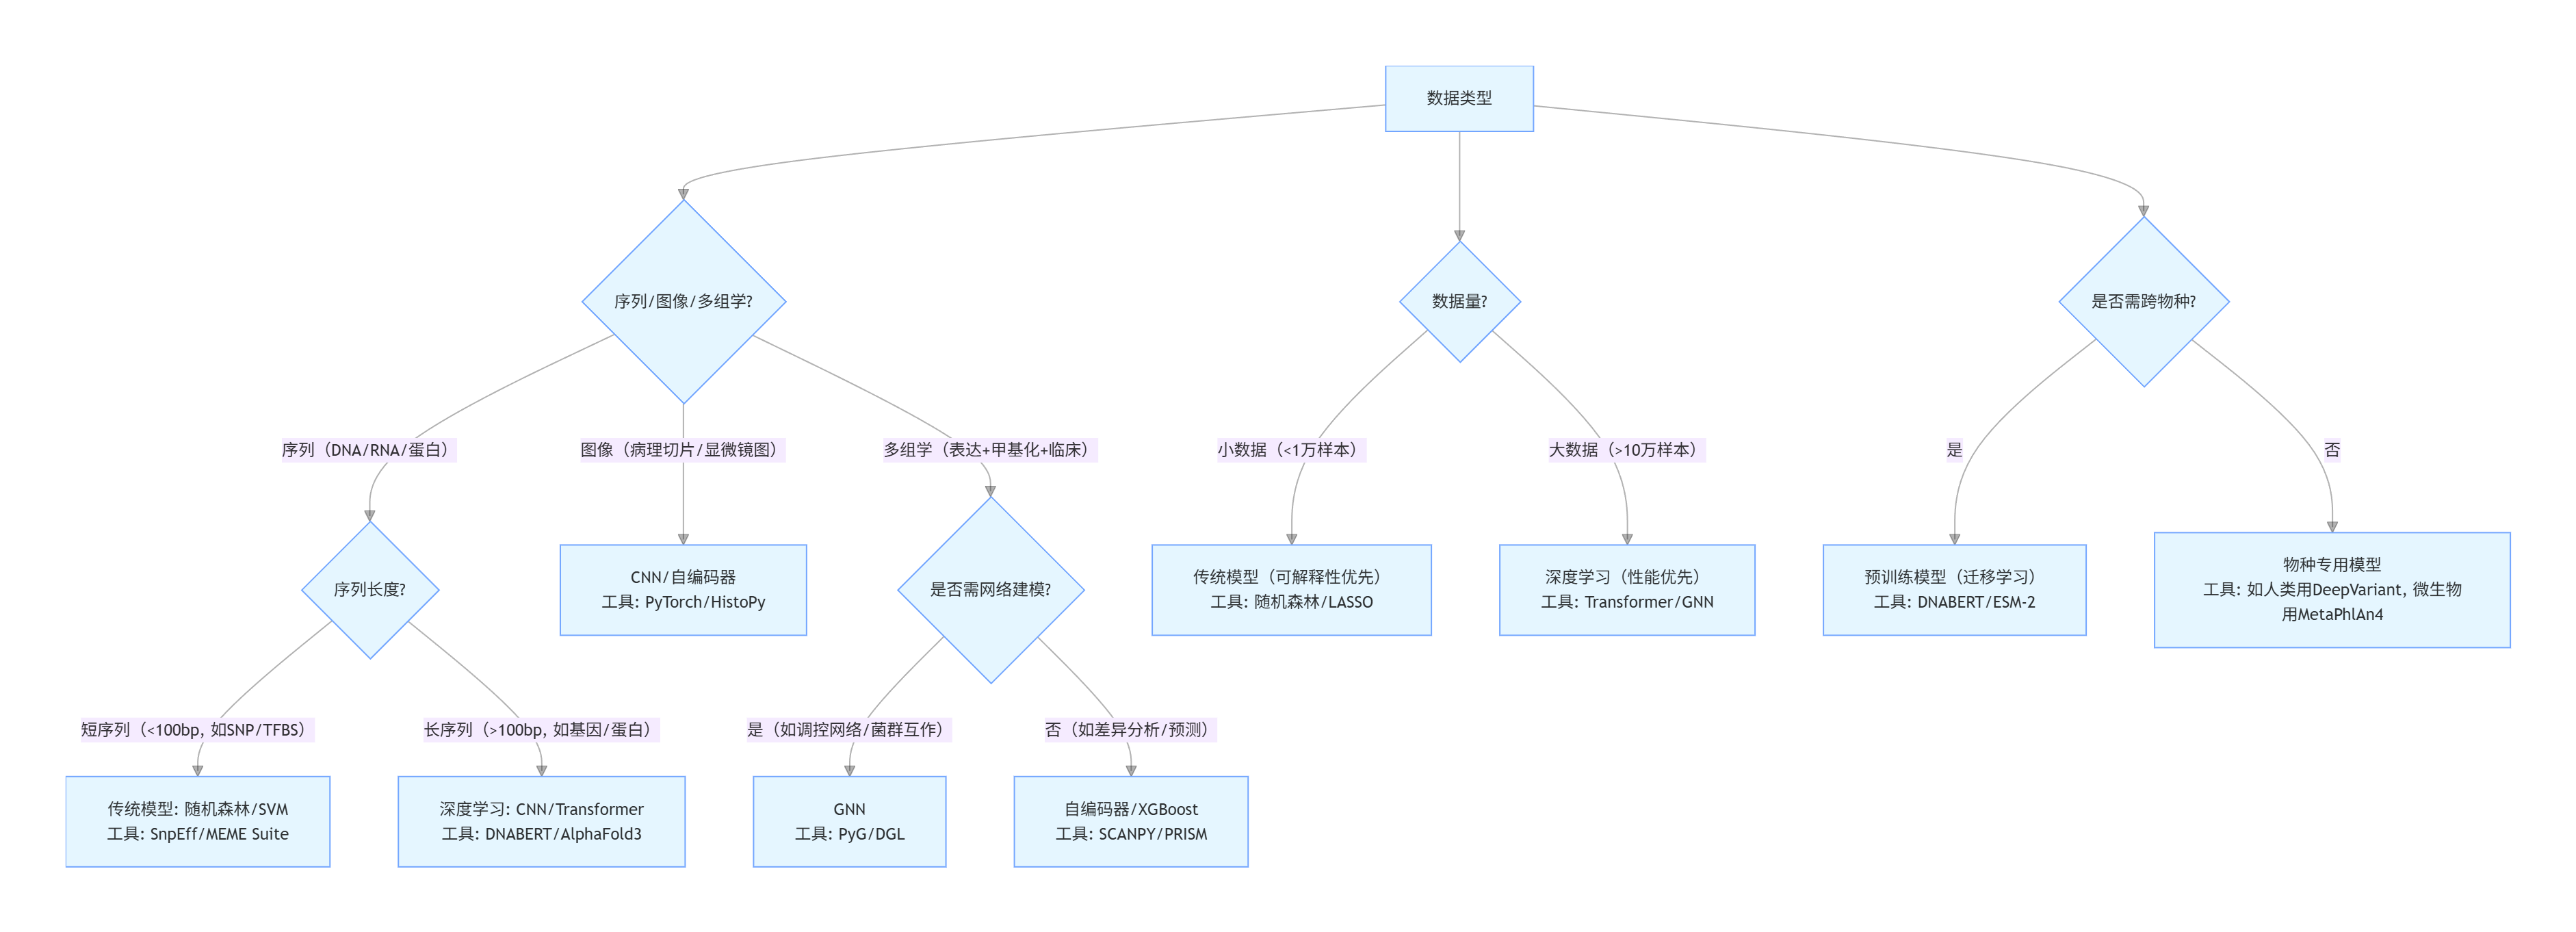
六、工具选择决策树:从问题到工具的快速匹配
七、核心模型对比:传统机器学习 vs 深度学习
| 对比维度 | 传统机器学习(如随机森林、SVM) | 深度学习(如 CNN、Transformer) | 混合模型(如 GNN + 随机森林) |
|---|---|---|---|
| 数据量需求 | 小(数百 - 数万样本),适合稀有疾病、新物种等小数据场景 | 大(数十万 - 百万样本),依赖大规模标注数据(如 UniProt、TCGA) | 中等(数万样本),结合传统模型的小数据优势与深度学习的特征提取能力 |
| 特征工程 | 需人工设计(如 k-mer、GC 含量、结构域),依赖生物学知识,特征质量直接影响结果 | 自动提取特征,适合复杂数据(长序列、图像、多组学),无需手动干预 | 部分人工特征(如已知标志物)+ 自动特征(如深度学习嵌入),平衡领域知识与自动化 |
| 计算成本 | 低(普通 CPU 即可运行,如 SVM 处理 1 万样本需分钟级) | 高(需 GPU/TPU,如 AlphaFold3 训练需数周,单次预测需 GPU) | 中(训练需 GPU,推理可 CPU,如 GNN + 随机森林混合模型) |
| 可解释性 | 强(如随机森林的特征重要性、逻辑回归系数),易与生物学机制关联,适合临床报告 | 弱(黑箱模型),需辅助工具(如 SHAP、注意力权重可视化)解释,临床信任度低 | 中等(传统模型部分可解释,深度学习部分需辅助工具) |
| 适用场景 | 特征明确、数据量小(如 SNP 致病性注释、小样本差异分析) | 特征复杂、数据量大(如蛋白质结构预测、长基因组序列分析、单细胞分群) | 多源数据整合(如临床 + 基因 + 影像)、中等数据量的复杂任务(如药物响应预测) |
| 典型工具 | SnpEff、DESeq2、PRSice-2、PICRUSt2 | AlphaFold3、DNABERT、scVI、DeepVariant | PyG(GNN)+ XGBoost、自编码器 + LASSO |
八、常用工具开源性与实战配置
| 工具 | 开源协议 | 核心功能 | 依赖环境 | 安装方式 | 学习资源 | 适用场景 |
|---|---|---|---|---|---|---|
| AlphaFold3 | 部分开源(模型权重闭源) | 蛋白质 / 核酸 / 小分子复合物结构预测 | Python 3.8+、PyTorch、CUDA 11.7+、16GB+ GPU | 官方 Docker 镜像:docker pull deepmind/alphafold或 API 调用:DeepMind Studio | 官方文档:https://www.deepmind.com/blog/alphafold-3GitHub 示例:https://github.com/deepmind/alphafold | 蛋白质结构预测(高精度需求) |
| DNABERT | Apache 2.0 | DNA 序列预训练模型(功能预测、变异分析) | Python 3.7+、Hugging Face Transformers、PyTorch | pip install transformers datasets模型下载:Hugging Face Hub | 论文:https://doi.org/10.1093/bioinformatics/btab083教程:Hugging Face 模型卡片 | 基因功能预测、调控元件识别 |
| SCANPY | BSD 3-Clause | 单细胞转录组分析(降维、聚类、轨迹推断) | Python 3.8+、NumPy、Pandas、PyTorch(可选) | conda install -c conda-forge scanpy | 官方教程:https://scanpy.readthedocs.io案例库:https://scanpy-tutorials.readthedocs.io | 单细胞分群、差异基因筛选 |
| MetaPhlAn4 | MIT | 宏基因组物种注释与定量 | Python 3.6+、Bowtie2 | conda install -c bioconda metaphlan | 官方文档:https://huttenhower.sph.harvard.edu/metaphlan教程:Nature Protocols 论文 | 微生物物种分类、群落组成分析 |
| PyTorch Geometric | MIT | 图神经网络库(调控网络、PPI、菌群互作) | Python 3.8+、PyTorch、CUDA(可选) | pip install torch_geometric依赖:PyTorch Scatter | 官方教程:https://pytorch-geometric.readthedocs.io案例:https://github.com/pyg-team/pytorch_geometric/tree/master/examples | 基因调控网络、蛋白质互作预测 |
| XGBoost | Apache 2.0 | 梯度提升树(疾病风险预测、特征重要性) | Python 3.6+、NumPy | pip install xgboost 或 conda install -c conda-forge xgboost | 官方文档:https://xgboost.readthedocs.io生物信息案例:TCGA 风险模型教程 | 疾病风险预测、生物标志物筛选 |
九、扩展资源:数据、社区与学习路径
1. 核心数据库(训练数据来源)
- 基因序列:NCBI GenBank(https://www.ncbi.nlm.nih.gov/genbank/)、Ensembl(https://www.ensembl.org/)
- 蛋白质结构:PDB(https://www.rcsb.org/)、AlphaFold DB(https://alphafold.ebi.ac.uk/)
- 多组学与临床:TCGA(https://portal.gdc.cancer.gov/)、GTEx(https://gtexportal.org/)、UK Biobank(https://www.ukbiobank.ac.uk/)
- 微生物组:MGnify(https://www.ebi.ac.uk/metagenomics/)、HMP(https://hmpdacc.org/)
2. 在线工具与平台(无需本地部署)
- 蛋白质结构:ColabFold(https://colab.research.google.com/github/sokrypton/ColabFold/blob/main/AlphaFold2.ipynb)→ 浏览器运行 AlphaFold
- 单细胞分析:cellxgene(https://cellxgene.cziscience.com/)→ 交互式单细胞数据可视化与分析
- 机器学习建模:Kaggle(https://www.kaggle.com/)→ 生物信息竞赛与数据集,支持在线训练
3. 学习社区与教程
- 问答社区:Bioinformatics Stack Exchange(https://bioinformatics.stackexchange.com/)→ 解决工具使用问题
- 技术博客:DeepMind Bio Blog(https://www.deepmind.com/blog/category/bioinformatics)→ 前沿模型解读
- 实战课程:Coursera《Bioinformatics Specialization》(约翰霍普金斯大学)、edX《Machine Learning for Bioinformatics》
十、实战建议:从新手到进阶的工具选型策略
-
新手入门:优先使用开箱即用的传统工具(如 DESeq2 做差异分析、SnpEff 做变异注释),熟悉数据格式与生物学背景;避免直接上手深度学习(学习成本高)。
-
小数据场景(样本 < 1 万):用传统模型 + 人工特征(如随机森林 + k-mer 特征),结合交叉验证(5 折 CV)避免过拟合;例如用 LASSO 从表达数据中筛选标志物。
-
复杂任务(如蛋白质结构预测、长序列分析):直接调用预训练模型(如 AlphaFold3 API、DNABERT 微调),无需重复训练;关注模型输出的可解释性(如用 SHAP 分析特征贡献)。
-
多组学整合:先用工具预处理单一组学(如 SCANPY 处理单细胞、MetaPhlAn4 处理微生物组),再用 GNN 或自编码器融合(如 PyTorch Geometric 构建多组学图)。
-
结果验证:无论用何种模型,均需生物学验证 —— 通过 GO/KEGG 富集分析(工具:clusterProfiler)确认功能相关性,或结合文献 / 湿实验(如 qPCR 验证差异基因)。
更多推荐


 24
 0
- 0


 已为社区贡献12条内容

所有评论(0)