
DSen2-CR:利用深度残差神经网络和SAR光学数据融合技术实现Sentinel-2影像的云层消除-k学长深度学习专栏
本文来源:k学长的深度学习宝库,点击查看源码&详细教程。深度学习,从入门到进阶,你想要的,都在这里。包含学习专栏、视频课程、论文源码、实战项目、云盘资源等。
1、研究背景和动机
为什么要做 DSen2-CR?
-
云遮挡太常见,光学遥感“看不清”。
光学卫星图像广泛用于农情、气候、灾害评估等,但云层会严重破坏可用性,云去除一直是长期难题。深度学习时代到来,让这件事有了新机会。 -
仅靠光学图像不够,厚云下几乎没有地物信息。
遇到“光学上不透明”的厚云,单看光学多谱段很难“猜”出云下真实地表;作者因此引入 SAR(雷达)先验——雷达能穿云,提供几何/纹理线索,用来指导光学重建。 -
要一个稳健、可训练的大模型,而不是易崩的对抗式生成。
早前不少工作用 cGAN 做去云,但在大云量/劣质输入时容易不稳定;作者转而采用深度残差网络(ResNet),在大遮挡场景下更稳、更易优化。 -
跨时相训练会引入“地表真实变化”,需要损失函数管住伪影。
去云训练常用“不同日期”的无云图作监督,地物会有季节/作物等真实变化;如果只用常规 L1/L2,网络容易把不该改的地方也改了,于是作者提出云自适应正则化损失(CARL):
在云/云影区域,督促模型向目标无云图学习;在晴空区域,督促模型“别乱改”,贴近输入,降低伪影。 -
需要一个大而真实的数据集来验证泛化。
很多早期方法用“模拟云”或小规模数据;作者基于 SEN12MS-CR 做了大规模、全球采样的数据划分,用真实云与对应无云影像训练/测试,确保方法在不同地表类型上可泛化。
这套动机串起来就是:
- 云多 → 光学受阻 → 引入能穿云的 SAR 提供结构先验;
- cGAN 易不稳 → 用 ResNet 残差学习 提高训练稳定与重建质量;
- 跨时相监督会带来“误改” → 设计 CARL 损失,在云区学目标,在晴空区守住输入;
- 想证明可用、可泛化 → 用全球大数据集 系统验证。
这些动机也被实验支撑:和“无 SAR”相比,SAR+光学融合能显著提升厚云场景结构可辨性与定量指标(但也提示了在无云区可能引入少量伪影,需要损失设计去抑制)。
一句话:DSen2-CR 的初心,是把“看得见云、看不见地”的光学成像,和“能穿云”的 SAR 拼起来,再配合“别乱改晴空区”的损失设计,让去云既可靠又稳健。
2、模型的核心创新点总结
🚀 一、总体概念回顾
DSen2-CR 是“Deep Sentinel-2 Cloud Removal”的缩写,
它是第一个系统性地把 SAR(雷达)+ 光学多谱段数据融合 用于云去除(Cloud Removal) 的深度学习模型。
之前的模型(如 SpA-GAN、STGAN)几乎都是基于光学数据的图像到图像翻译,而 DSen2-CR 提出了一个跨传感器的思路:
🌈 “当眼睛(光学)看不见时,耳朵(雷达)能告诉我们下面是什么。”
🌟 二、模型的四大核心创新点
🧩 1️⃣ 异构数据融合架构(SAR + 光学)
✨ 创新点:
DSen2-CR 是第一个明确地把 SAR(Sentinel-1)和光学(Sentinel-2) 结合起来用于云去除的深度神经网络。
🧠 原理:
- 光学图像提供颜色、光谱信息;
- SAR 图像能穿透云层,提供地表几何和纹理结构;
- 网络通过多通道输入,将两者融合,获得“云下地物”的完整特征。
🎯 效果: - 解决厚云遮挡下信息缺失问题;
- 避免模型凭空“猜测”;
- 提升地物边界和结构的恢复精度。
💬 类比:
光学图像像“彩色照片”,SAR 像“摸轮廓的盲文”,
模型学会把两种感觉合并成“既有颜色又有形状”的感知。
🧠 2️⃣ 深度残差网络 DSen2 架构(ResNet-based Cloud Removal)
✨ 创新点:
作者基于 Deep Sentinel-2 网络(DSen2) 构建残差学习架构。
该网络原本是为多光谱超分辨率设计的,他们重新设计卷积层以适配“去云任务”。
💡 原理:
- 输入是带云的多时相影像 + SAR;
- 输出是目标时刻的无云图像;
- 中间通过多个 残差模块(Residual Blocks) 提取多尺度特征;
- 模型学习残差(即“云造成的偏差”),从而更容易训练、收敛稳定。
🎯 效果: - 比 GAN 稳定(不需判别器);
- 保持光谱一致性;
- 减少训练噪声和伪影。
🧩 类比:
模型不是“从零画图”,而是“在原图上擦掉云、补细节”,残差结构就像“精修师的橡皮擦”。
⚙️ 3️⃣ 云自适应正则化损失(Cloud-Adaptive Regularization Loss, CARL)
✨ 创新点:
首次提出根据“云区”与“非云区”差异设计的分区损失函数。
💡 原理:
- 云区:用 L1/L2 强约束模型输出与无云目标一致;
- 晴空区:用弱约束或 identity loss,避免模型误修改;
- 全图:再用感知一致性损失保证全局视觉协调。
数学上:
LCARL=λcLcloud+λsLclear+λpLperceptual
🎯 效果: - 模型“重点修云,不乱动晴空”;
- 避免传统网络那种“云没去干净,晴空却变色”的问题。
🧠 类比:
就像 AI 修图师有指令:“只修云区,不许动蓝天”,
这让结果自然且可信。
🌍 4️⃣ 大规模真实云数据集 SEN12MS-CR
✨ 创新点:
构建并公开了一个大规模、全球采样的云去除数据集 —— SEN12MS-CR,
每个样本包含:
- SAR 图像;
- 云覆盖光学图像;
- 对应的目标无云图像。
🎯 意义: - 提供训练与验证标准;
- 弥补了以往“模拟云数据集”的局限;
- 为后续模型(如 SARFusionNet、CloudDiffusion)提供了 benchmark。
💬 类比:
以前大家都用“人造假云”做实验,
DSen2-CR 提供了“全球真实云”的训练教材。
📊 三、创新点总结对比表
暂时无法在飞书文档外展示此内容
🧠 四、一句话总结
🌤️ DSen2-CR 的核心创新是:
“把能穿云的雷达眼睛(SAR)与彩色光学眼睛(S2)结合,
用残差网络学习‘只修云区’的规律,
并用云自适应损失教模型区分哪里该修、哪里不该动。”
这套机制让它成为“多源数据融合去云”的开山之作,
并直接影响了后续的 SARFusionFormer(2023)、CR-TransSAR(2024)等系列模型。
3、模型的网络结构
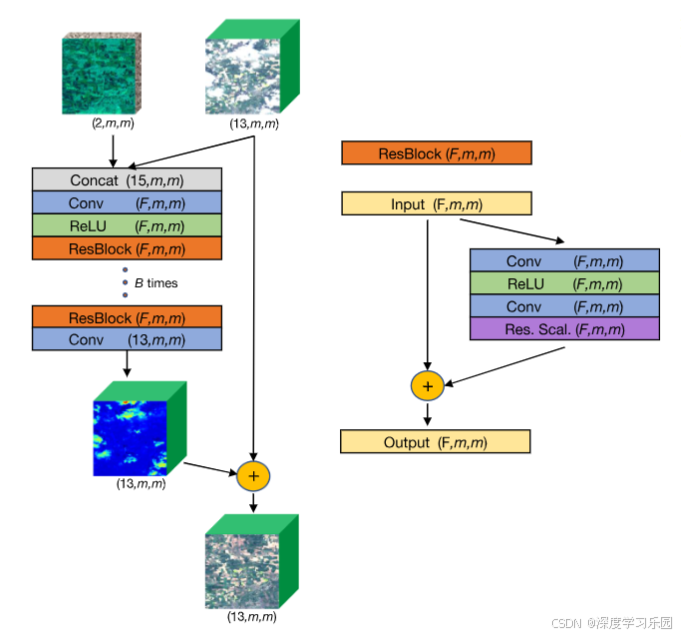
🌈 一、整体思路:
把“看得见云”的光学图像 和 “能穿云”的SAR雷达图像 合起来,
教神经网络学会“在云下复原地表”。
🧠 换个形象的比喻:
你可以把 DSen2-CR 想象成一个 双通道的“盲人修图师”:
- 一只“眼睛”是光学相机(Sentinel-2),能看见颜色,但看不穿云;
- 另一只“眼睛”是雷达(Sentinel-1),能穿云,却只有黑白的纹理轮廓;
- 模型的任务,就是把这两种感知合成一张清晰的无云图像。
🧩 二、输入数据
在图的最上方可以看到两种输入:
暂时无法在飞书文档外展示此内容
其中:
- “2”表示 SAR 的两个极化通道(VV、VH);
- “13”表示光学的13个光谱波段(从可见光到近红外)。
🧠 可以理解为:
SAR 像是“描线稿”,光学像是“上色参考”。
⚙️ 三、特征融合与编码部分(左侧灰蓝区域)
1️⃣ Concat(拼接层)
- 把两个输入直接拼在一起,形成一个“15通道”的输入块。
- 这一步实现了 光学+SAR 的早期融合(early fusion)。
- 输出尺寸:(15, m, m)。
类比:
就像把彩色图和雷达图摞在一起,交给模型统一处理。
2️⃣ Conv + ReLU 层
- 用一个卷积层(Conv)提取融合特征;
- 激活函数 ReLU 引入非线性,使模型能识别复杂纹理。
🎨 类比:
就像修图师先观察颜色层与轮廓层的关系,找出云下可能的边界。
3️⃣ 多个 ResBlock(Residual Block)
- 这里堆叠了 B 个残差块(通常 8 个);
- 每个块都包含:
- 两个卷积(Conv)层;
- 一个 ReLU;
- 以及残差跳连(shortcut)。
👉 功能:
通过残差结构,模型可以:
- 学习“云区和无云区的差异”;
- 保持输入输出的整体一致;
- 减少梯度消失问题,让网络更深也能稳定训练。
💬 类比:
模型不是重新画图,而是“在原图上擦掉云、补上纹理”。
🧱 四、残差块内部结构(右侧橙紫模块)
放大来看,每个 ResBlock 的工作流程是:
输入特征 → 卷积 → ReLU → 卷积 → 残差缩放 → 加回输入 → 输出
也就是“学一点点修正,然后加回原来的特征”:
Output=Input+α⋅f(Input)
其中 α 是缩放系数,用于防止过度修正。
🔧 类比:
修图师每次轻轻修一点,再与原图叠加,避免“修过头”。
🧩 五、输出层与重建部分
1️⃣ 最后的 ResBlock + Conv
- 再经过一个残差块提炼特征;
- 最后一层卷积输出 13 个光谱通道;
- 对应无云的光学图像预测结果。
2️⃣ 残差相加(黄圈“+”部分) - 网络输出的是预测残差(即“云的差异”);
- 与原始带云图像相加,得到最终的无云图像。
Iclean=Icloudy+ΔIpred
🌤️ 类比:
网络输出的“修补层”叠加回原图,就像 PS 的“修复图层”。
📊 六、网络的三大特征总结
暂时无法在飞书文档外展示此内容
🌍 七、整体工作流程(总结版)
1️⃣ 输入光学带云图像和对应的 SAR;
2️⃣ 拼接后卷积融合;
3️⃣ 通过多个 ResBlock 逐层提取并修复;
4️⃣ 输出残差特征;
5️⃣ 与原图相加,得到最终的“去云”影像。
💡 八、一句话总结
🧠 DSen2-CR 网络结构 就像一个“懂雷达的图像修复师”:
它一边用雷达摸出云下的地物轮廓,
一边用光学颜色填补细节,
通过残差学习轻柔地修正每一片云,
最终输出一张色彩真实、结构准确、云雾消失的地表图像。
4、模型的核心不足与后续改进方向
🧩 一、DSen2-CR 的核心不足与缺陷
虽然 DSen2-CR 是“第一代SAR-光学融合去云模型”,
但从模型结构和实验结果来看,它仍有以下几方面的局限。
⚠️ 1️⃣ 异构特征融合方式过于“简单粗暴”
问题:
- DSen2-CR 只是直接把 SAR 与光学影像“拼接(Concatenate)”后送进卷积网络。
- 这种“早期融合”虽然简单,却忽略了两种数据的本质差异:
- SAR:几何结构强,但噪声多、非线性高;
- 光学:光谱信息丰富,但受云干扰大。
后果:
- 模型难以充分对齐和理解两种模态之间的对应关系;
- 有时甚至出现“纹理错位”或“光谱不匹配”。
🧠 类比:
就像直接把“声波图”和“彩色照片”叠在一起训练,
模型能学到点规律,但始终“听不懂”SAR的语法。
⚠️ 2️⃣ 缺乏显式的空间配准与几何对齐机制
问题:
SAR 和光学图像在拍摄时间、视角、轨道等方面常常不完全对齐。
DSen2-CR 默认输入是像素级对齐的,这在实际遥感中很难保证。
后果:
- 一旦两者存在位移或形变,融合卷积层会误配位置特征;
- 导致输出图像边缘模糊、建筑物错位。
💬 换句话说:
模型“假设”两张图重合,但现实中往往不是。
⚠️ 3️⃣ 仅使用卷积建模,感受野有限
问题:
- 网络核心仍是纯卷积(CNN)结构;
- 缺乏全局依赖建模能力;
- 对长距离空间关系或大范围云区处理效果差。
后果: - 在大片厚云区域,模型容易“平均化”预测,输出模糊块;
- 无法像 Transformer 那样捕捉远处地物的上下文信息。
🌥️ 类比:
CNN 只能看到局部的“局部图块”,
看不到“整张地图”的全貌。
⚠️ 4️⃣ 光谱一致性仍存在偏差
问题:
- 虽然使用残差学习稳定了训练,但不同波段间仍可能出现“色偏”;
- 尤其在近红外和短波红外通道,输出亮度与真实无云图存在差异。
原因:
SAR 与光学波段的物理特性差异太大,网络未显式建模其光谱映射。
🔍 结果:
地表结构对了,但颜色“不自然”或“不连贯”。
⚠️ 5️⃣ 时序信息完全缺失
问题:
- 模型只使用一张带云光学图和对应时刻的 SAR;
- 没有利用多时相(时间序列)的光学信息。
后果: - 对临时云遮挡可以恢复;
- 但对“持续云覆盖”或“云下动态变化”无能为力。
🧠 类比:
模型只能“凭当前这一帧修图”,
没有时间维度的“前后参考帧”。
⚠️ 6️⃣ 数据驱动强,但物理约束弱
问题:
- 模型完全依赖学习数据映射;
- 没有融入物理散射规律或大气辐射模型。
后果: - 生成结果虽逼真,但缺乏物理一致性;
- 在不同地区、季节、传感器组合下泛化能力有限。
🌍 这也是后续物理-引导模型(如 PhysCloudNet, 2023)改进的重点。
🔧 二、论文作者提出的改进方向
在原论文的 Discussion 和 Conclusion 部分,作者提出了几点后续研究建议:
- 探索更高级的融合机制 —— 如基于注意力的跨模态特征交互;
- 引入时序信息 —— 结合多时相观测提高时空一致性;
- 物理与学习融合 —— 加入大气、雷达散射等物理约束;
- 优化配准与几何校正 —— 让网络自动对齐异源特征。
🌈 三、后续基于 DSen2-CR 改进的模型
暂时无法在飞书文档外展示此内容
🧭 四、演化总结:从 DSen2-CR 到新一代模型
暂时无法在飞书文档外展示此内容
🧠 五、一句话总结
🌍 DSen2-CR 的意义在于“开了头”:
它首次让“光学 + SAR”协作解决云去除问题,
但仍是一个“早期融合 + 卷积修复”的方案。
后续研究逐步在它的基础上:
- 加入注意力机制 → 让两种模态真正对话;
- 加入时序信息 → 让模型理解时间变化;
- 加入物理约束 → 让输出更符合大气与辐射规律。
最终形成了从 DSen2-CR → CR-TransSAR → CloudFusionFormer → TempSAR-CR 的技术演进路线,
让去云从“像素修复”走向“时空物理重建”。
本文来源:k学长的深度学习宝库,点击查看源码&详细教程。深度学习,从入门到进阶,你想要的,都在这里。包含学习专栏、视频课程、论文源码、实战项目、云盘资源等。
更多推荐


 8
 0
- 0


 已为社区贡献34条内容

所有评论(0)