
深度学习-卷积神经网络LeNet
1 背景
LeNet 由AT&T贝尔实验室的研究员Yann LeCun在1989年提出,是最早发布的卷积神经网络之一。当时主要是为了应用于识别手写数字,并且取得了与支持向量机媲美的结果。这项工作代表了十多年来神经网络研究开发的成果。
2 原理
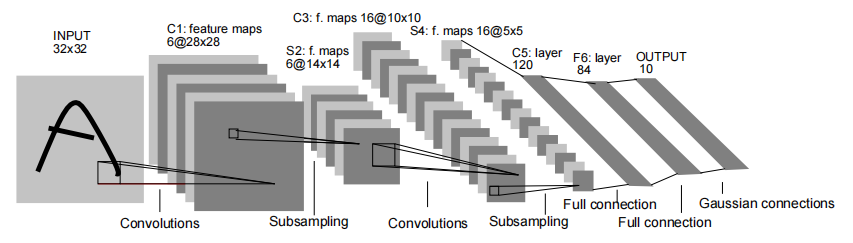
LeNet的结构如上图所示,输入一张32*32大小的单通道图像,首先经过一次卷积得到6通道28*28大小的特征图,经过下采样(即汇聚层)得到6通道14*14的特征图,然后经过第二次卷积得到16通道10*10的特征图,经过第二次下采样得到16通道5*5的特征图。接下来将所有特征图展平得到长度为16*5*5=400的张量,将这个张量作为全连接层的输入,经过两个全连接层和一个高斯连接层得到长度为10的输出。
这个模型中几乎所有的部分我们已经在前面的章节学过,只有最后一层需要补充介绍一下。高斯连接层(Gaussian Connection Layer)是一种在神经网络中使用的连接方式,其主要特点是使用固定参数的欧式径向基函数(Euclidean Radial Basis Function)进行计算。与常规的全连接层不同,高斯连接层的输出不经过激活函数,而是直接作为输出结果。这种设计使得高斯连接层在某些特定任务中能够更有效地处理数据。说白了就是最后一层不再像常规的全连接层那样训练,而是作者手工标注出了数字0~9的特征,然后通过计算输入的值与这10种特征向量的欧氏距离得到10个输出。
为了让模型更加通用,书中没有实现最后特制的高斯连接层,而是用一个无激活函数的全连接层代替。如下图所示:

3 实现
3.1 模型定义
下面的定义代码展示了模型各层具体结构:
import torch
from torch import nn
from d2l import torch as d2l

net = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5), nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Flatten(),
    nn.Linear(16 * 5 * 5, 120), nn.Sigmoid(),
    nn.Linear(120, 84), nn.Sigmoid(),
    nn.Linear(84, 10))
下面展示了每一层输出的形状(B,C,H,W):
X = torch.rand(size=(1, 1, 28, 28), dtype=torch.float32)
for layer in net:
    X = layer(X)
    print(layer.__class__.__name__,'output shape: \t',X.shape)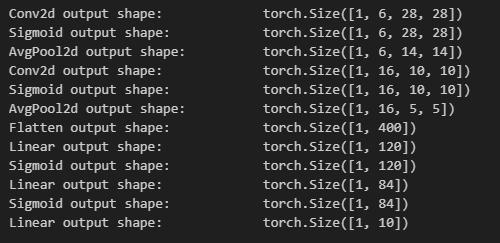
3.2 模型训练
这里数据集选用Fashion-MNIST数据集。
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
为了使用GPU加速训练,书中重写了精度计算函数和训练函数,其主要修改的地方在于需要在GPU中参与计算的数据全部用to(device)函数复制到了显存中。
def evaluate_accuracy_gpu(net, data_iter, device=None): #@save
    """使用GPU计算模型在数据集上的精度"""
    if isinstance(net, nn.Module):
        net.eval()  # 设置为评估模式
        if not device:
            device = next(iter(net.parameters())).device
    # 正确预测的数量,总预测的数量
    metric = d2l.Accumulator(2)
    with torch.no_grad():
        for X, y in data_iter:
            if isinstance(X, list):
                # BERT微调所需的(之后将介绍)
                X = [x.to(device) for x in X]
            else:
                X = X.to(device)
            y = y.to(device)
            metric.add(d2l.accuracy(net(X), y), y.numel())
    return metric[0] / metric[1]
#@save
def train_ch6(net, train_iter, test_iter, num_epochs, lr, device):
    """用GPU训练模型(在第六章定义)"""
    def init_weights(m):
        if type(m) == nn.Linear or type(m) == nn.Conv2d:
            nn.init.xavier_uniform_(m.weight)
    net.apply(init_weights)
    print('training on', device)
    net.to(device)
    optimizer = torch.optim.SGD(net.parameters(), lr=lr)
    loss = nn.CrossEntropyLoss()
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=['train loss', 'train acc', 'test acc'])
    timer, num_batches = d2l.Timer(), len(train_iter)
    for epoch in range(num_epochs):
        # 训练损失之和,训练准确率之和,样本数
        metric = d2l.Accumulator(3)
        net.train()
        for i, (X, y) in enumerate(train_iter):
            timer.start()
            optimizer.zero_grad()
            X, y = X.to(device), y.to(device)
            y_hat = net(X)
            l = loss(y_hat, y)
            l.backward()
            optimizer.step()
            with torch.no_grad():
                metric.add(l * X.shape[0], d2l.accuracy(y_hat, y), X.shape[0])
            timer.stop()
            train_l = metric[0] / metric[2]
            train_acc = metric[1] / metric[2]
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (train_l, train_acc, None))
        test_acc = evaluate_accuracy_gpu(net, test_iter)
        animator.add(epoch + 1, (None, None, test_acc))
    print(f'loss {train_l:.3f}, train acc {train_acc:.3f}, '
          f'test acc {test_acc:.3f}')
    print(f'{metric[2] * num_epochs / timer.sum():.1f} examples/sec '
          f'on {str(device)}')
lr, num_epochs = 0.9, 10
train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
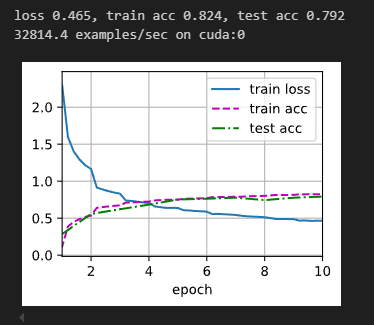
训练结果如下:
参考文献
[1]《动手学深度学习》,https://zh-v2.d2l.ai/
[2] LeCun, Y., Bottou, L., Bengio, Y., Haffner, P., & others. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324.
更多推荐

 10
 0
- 0


 已为社区贡献6条内容

所有评论(0)