
Kubernetes脉络:从基础概念到核心架构的认知框架
引言
在云计算和容器化技术飞速发展的今天,Kubernetes 作为容器编排领域的佼佼者,已经成为众多企业和开发者构建和管理应用的得力工具。它从最初的容器编排解决方案,摇身一变成为如今集自动化部署、扩缩容、服务发现等多种功能于一体的云原生平台。本文将避开繁杂的技术细节,专注于厘清K8s的基础概念、架构设计和核心资源模型,为初学者构建一个清晰的认知框架。
一、基础概念
1.1 Kubernetes 简介
Kubernetes(通常简称为K8s)是一个开源的容器编排平台,用于自动化部署、扩展和管理容器化应用程序。
| 功能类别 | 核心能力 | 应用场景与价值 |
| 容器编排 | 自动化部署、管理容器化应用 | 统一管理微服务架构,简化复杂应用的部署和维护 |
| 弹性伸缩 | 基于 CPU/内存或自定义指标自动扩缩容 | 应对流量高峰(如电商大促),空闲时自动缩减资源降低成本 |
| 服务发现与负载均衡 | 为 Pod 提供稳定 IP/DNS,自动分发流量 | 微服务间通信无需手动配置 IP,服务中断时自动切换流量 |
| 存储管理 | 动态挂载本地/云存储(如 NFS, AWS EBS) | 数据库持久化存储、配置文件共享 |
| 配置与密钥管理 | 集中管理 ConfigMap 和 Secret | 安全存储数据库密码,动态更新应用配置无需重启容器 |
| 自我修复 | 自动重启容器、替换故障节点 | 节点宕机时自动迁移服务,保障业务连续性 |
| 滚动更新与回滚 | 分批次更新应用,支持版本回退 | 实现零停机的应用升级,故障时秒级回滚到稳定版本 |
| 批处理任务 | 管理 CronJob 和一次性任务 | 定时执行日志清理、批量数据处理等离线任务 |
| 多环境一致性 | 统一管理开发、测试、生产环境 | 解决“在我机器上能运行”问题,提升交付效率 |
| 多云/混合云支持 | 跨公有云、私有云统一部署应用 | 避免云厂商锁定,实现灾备和多云负载均衡 |
1.2 核心架构与组件
Kubernetes 采用主从架构,分为控制平面(Control Plane)和工作节点(Worker Nodes)。
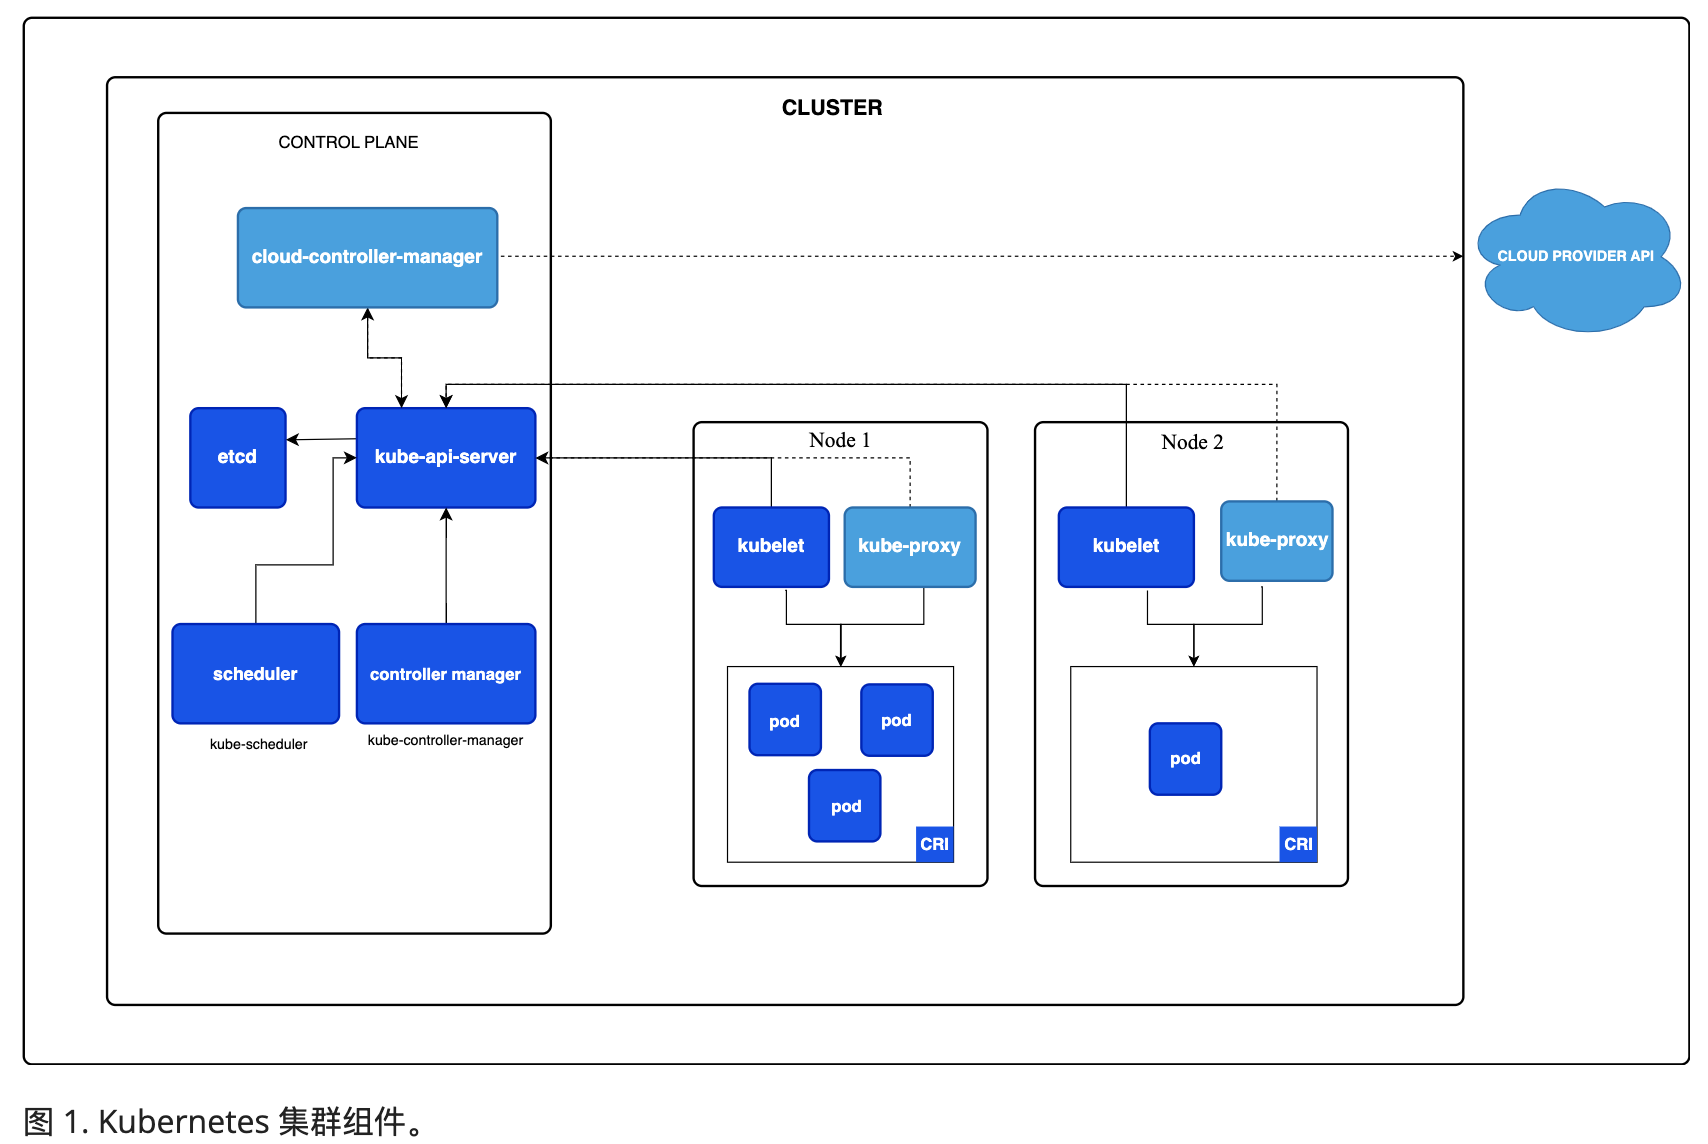
上图来源:https://kubernetes.io/zh-cn/docs/concepts/architecture/
1.2.1 控制平面(Control Plane)
负责集群的全局决策和状态管理,通常部署在独立的 Master 节点上。
| 组件 | 核心功能 | 关键特性 |
| kube-apiserver | 集群的 API 入口,接收并验证所有请求(如 kubectl 命令) | RESTful 接口,唯一与 etcd 通信的组件 |
| etcd | 分布式键值数据库,存储集群所有配置、状态和元数据 | 高可用、强一致性,集群的“唯一数据源” |
| kube-scheduler | 监听未调度的 Pod,根据资源需求、策略等将其分配到合适的工作节点 | 支持自定义调度策略(如节点亲和性) |
| kube-controller-manager | 运行核心控制循环,确保集群状态与预期一致: • 节点控制器(监控节点状态) • 副本控制器(维持 Pod 副本数) • 端点控制器(关联 Service 与 Pod) | 自动化修复(如节点故障时重建 Pod) |
| cloud-controller-manager | 集成云服务商功能(如 AWS/GCP),管理节点、负载均衡器、存储卷等 | 解耦 Kubernetes 与底层云平台 |
1.2.2 工作节点(Worker Nodes)
运行容器化应用,每个节点包含以下组件:
| 组件 | 核心功能 | 关键特性 |
| kubelet | 节点上的“代理”,管理 Pod 生命周期: • 启动/停止容器 • 监控容器健康状态 • 报告节点状态到控制平面 | 仅管理 Kubernetes 创建的容器 |
| kube-proxy (可选) | 实现 Service 的网络代理: • 维护网络规则(iptables/IPVS) • 提供负载均衡和流量转发 | 支持 ClusterIP、NodePort 等 Service 类型 |
| 容器运行时 | 运行容器的引擎(如 containerd、CRI-O) | 遵循 CRI(容器运行时接口)标准 |
1.2.3 核心抽象对象
Kubernetes 通过抽象对象管理应用:
| 对象 | 作用 | 示例场景 |
| Pod | 最小部署单元,包含 1 个或多个共享网络/存储的容器 | Web 应用容器 + 日志收集 Sidecar 容器 |
| Service | 为一组 Pod 提供固定访问入口(IP/DNS)和负载均衡 | 前端应用通过 Service 访问后端数据库集群 |
| Deployment | 管理 Pod 副本集,支持滚动更新、回滚 | 无状态应用(如 Nginx)的版本升级 |
| ConfigMap | 存储非敏感配置数据(如环境变量) | 应用配置文件(数据库地址、日志级别) |
| Secret | 存储敏感数据(密码、密钥),Base64 编码 | 数据库密码、TLS 证书 |
| Volume | 为 Pod 提供持久化存储 | 数据库数据存储(如挂载 AWS EBS 卷) |
二、核心资源与控制器
2.1 工作负载资源
工作负载资源是 Kubernetes 中管理 Pod 部署和生命周期的抽象对象。
核心资源:
| 资源分组 | 核心资源 | 设计目标与核心能力 | 典型应用场景 |
| 无状态应用 | Deployment, ReplicaSet | • Deployment滚动更新/回滚、副本扩缩容、声明式管理 • ReplicaSet确保指定数量Pod运行,通常不直接操作 | Deployment:Web服务、API、无状态计算服务等 ReplicaSet:Pod副本管理(Deployment底层) |
| 有状态应用 | StatefulSet | • 稳定的唯一身份标识 • 有序优雅的部署与扩缩容 • 持久化存储绑定 | 数据库集群、消息队列、注册中心等有状态应用 |
| 节点代理服务 | DaemonSet | • 节点级守护进程 • 自动供应 • 确保所有匹配节点运行Pod副本 | 日志收集器、监控代理、网络插件等系统服务 |
| 批处理任务 | Job, CronJob | • Job一次性任务(批处理) • CronJob定时任务(备份、清理) | 数据处理、备份任务、镜像构建等(Job) 每日报表、定时清理等(CronJob) |
2.2 网络与通信
2.2.1 网络模型的核心功能
Kubernetes 网络模型是一个复合体,其核心功能可以概括为以下四点,它们共同协作,缺一不可:
- 基础网络互通:确保集群内所有Pod之间能够直接通信,无论它们是否在同一个节点上,这是所有高级功能的基础。
- 服务发现与负载均衡:为动态变化的Pod集合提供一个稳定的访问地址,并将流量合理地分发到后端健康的Pod上。
- 访问入口网关:管理从集群外部到内部服务的访问流量。
- 网络访问控制:对Pod之间的流量进行限制,实现网络分段和安全隔离。
2.2.2 核心资源详解
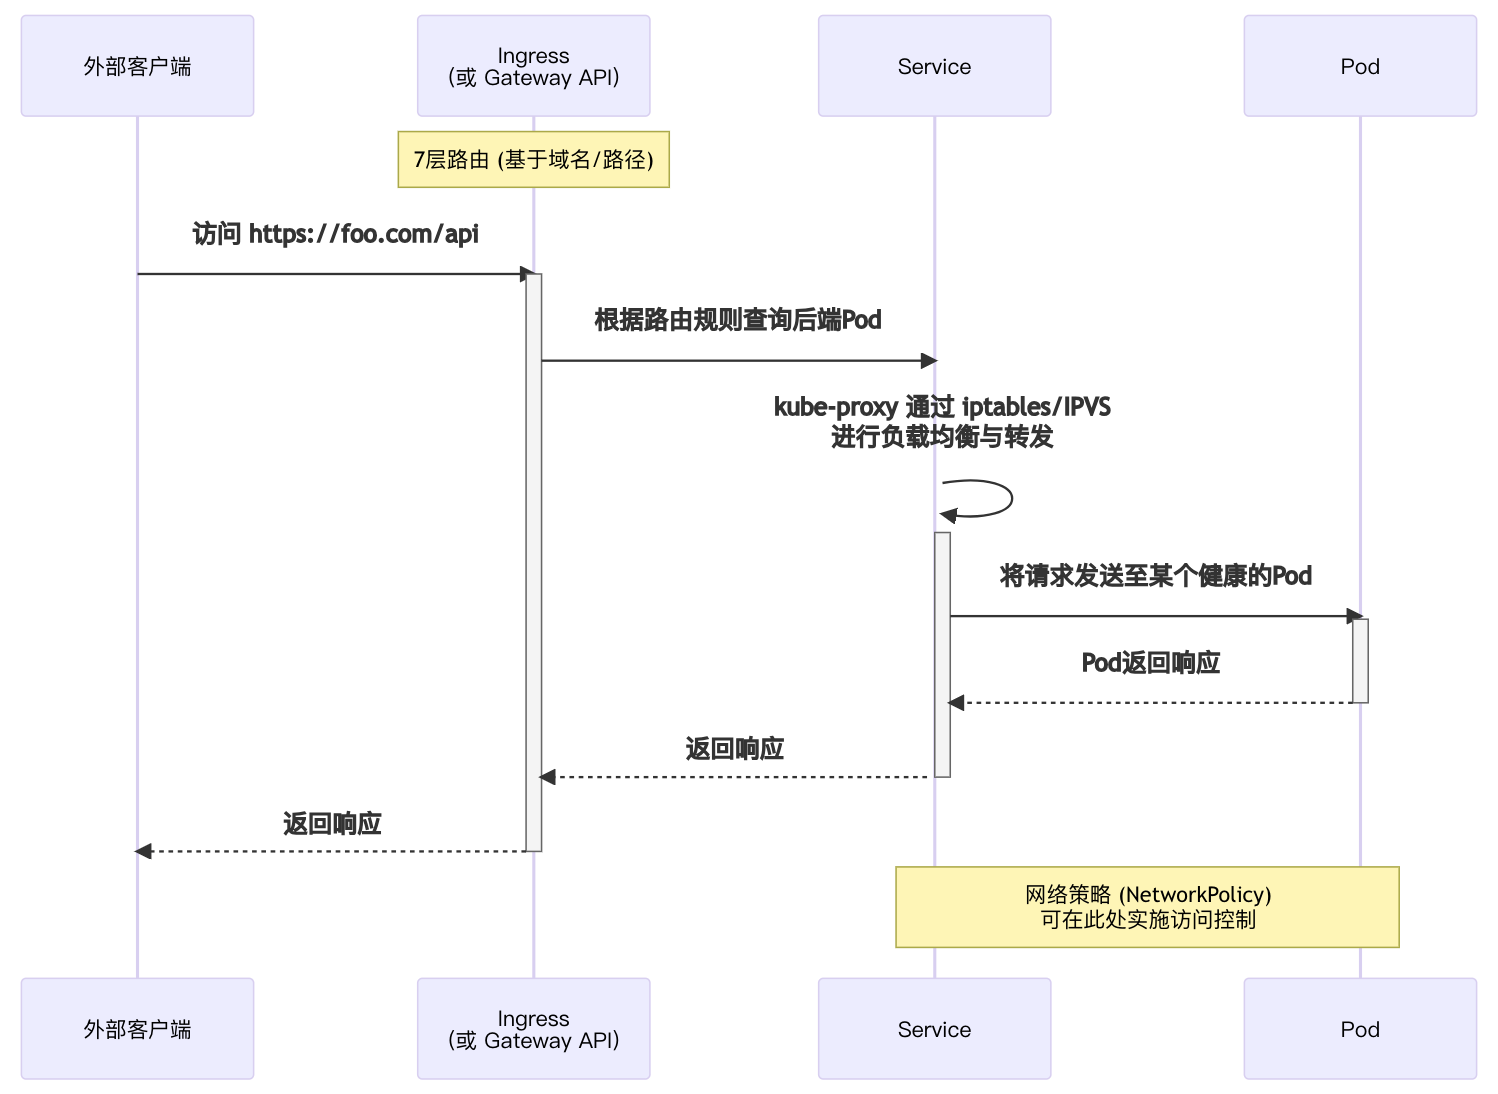
上述流程中涉及的核心组件,其机制、场景和必要性如下表所示:
| 资源/组件 | 核心机制 | 应用场景 | 是否必须/可被替代 |
| Pod 网络 | 通过 CNI (容器网络接口) 插件实现, 为每个Pod分配唯一的集群IP,并负责Pod与Pod之间的直接通信。 | 微服务间内部通信、数据同步。 | 是基础,必须由CNI插件实现,但插件本身(如Calico, Flannel)可替换。 |
| Service | kube-proxy 监视 Service 和 EndpointSlice,并通过配置 iptables 或 IPVS 规则, 实现虚拟IP到实际Pod IP的负载均衡与转发。 | 为一组Pod(如微服务实例)提供内部服务发现和稳定的访问端点。 | 几乎是必需的。虽然极端情况下可以直接用Pod IP,但鉴于Pod的动态性,Service 提供的稳定性对于服务间调用至关重要。 |
| Ingress / Gateway API | Ingress Controller(如Nginx, Traefik)监听Ingress资源,并作为反向代理根据规则(如域名、路径)将外部HTTP/HTTPS流量路由到后端Service。Gateway API 是其演进版本,功能更强大。 | 作为集群的边缘网关,处理外部访问、SSL终止、基于域名的虚拟主机等。 | 功能上必要,实现可替代。您需要一个机制将外部流量引入集群。您可以使用K8s的Ingress/Gateway API,也可以自建Nginx,或将Service类型设为LoadBalancer直接暴露。 |
| NetworkPolicy | 由网络插件(如Calico, Cilium)实施,本质上是作用于Pod的防火墙规则。 | 实现网络微隔离,例如: • 禁止数据库Pod被非指定服务访问。 • 实现微服务间按需通信。 | 非必需,但强烈推荐。可以选择不使用,但这会牺牲安全性。其实现依赖于支持该功能的CNI插件。 |
2.2.3 云原生时代下的微服务Spring Cloud Gateway和Eureka的定位思考
核心结论:从“必需品”变为“可选项”
Spring Cloud Gateway 和 Eureka 已从微服务架构的核心组件,转变为需要根据具体需求权衡的技术选型。
技术对比:原生方案 vs. Spring Cloud
| 特性 | Kubernetes 原生方案 | Spring Cloud 方案 |
| 服务发现 | Service + EndpointSlice(自动、无需编码) | Eureka(需客户端集成与心跳维护) |
| API 网关 | Ingress / Gateway API(基础设施层) | Spring Cloud Gateway(应用层,编程控制) |
| 技术绑定 | 语言无关,通用标准 | 深度绑定 Java/Spring 技术栈 |
| 治理能力 | 提供基础路由与负载均衡 | 提供丰富的编程式过滤器、限流、熔断等能力 |
行业趋势与混合模式
使用 Kubernetes Service 进行基础的服务发现,同时继续使用 Spring Cloud Gateway 来处理需要精细控制的业务层路由和过滤逻。
选型决策建议
1. Spring Cloud Gateway
- ✅ 保留价值:处理业务层流量治理(复杂路由、API聚合、自定义过滤)
- ❌ 避免场景:简单路由/TLS终止等基础功能(使用Ingress替代)
- ⚡ 最佳实践:作为独立Pod部署,通过K8s Service暴露
2. Eureka
- ⚠️ 定位:技术债务处理器而非新架构选择
- 🔄 迁移路径:

- 🚫 新项目:严格使用K8s Service+DNS发现
2.3 存储管理
Kubernetes 存储管理的本质是为容器化应用提供持久化、可靠且可扩展的数据存储解决方案的体系。它通过抽象底层存储基础设施,实现了:

2.3.1 存储工作流模式
Kubernetes存储工作流提供了灵活的资源供应模式:
- 静态供应:完全掌控存储资源配置,适合固定环境
- 动态供应:自动化按需分配,适合云原生环境
- 混合模式:结合两者优势,满足多样化需求
静态供应与动态供应对比总览:
| 特性 | 静态供应 | 动态供应 |
| 核心流程 | 管理员先创建PV → 用户创建PVC | 用户创建PVC → 系统自动创建PV |
| 资源准备 | 手动预先配置存储资源 | 按需即时创建存储资源 |
| 适用场景 | 特定存储需求、固定配置环境 | 弹性环境、云原生应用 |
| 管理开销 | 高(需手动管理PV) | 低(自动化管理) |
| 灵活性 | 低 | 高 |
| 扩展性 | 有限 | 优秀 |
2.3.2 动态供应
定义:
动态供应是Kubernetes存储管理的核心机制,它允许用户按需自动创建存储资源,无需管理员预先手动配置。这种机制解决了传统存储管理中资源预分配的痛点,实现了"申请即用"的存储消费模式。
核心价值:
- 自动化:从申请到创建完全自动化
- 按需分配:需要时才创建,避免资源浪费
- 简化操作:开发者只需关心"要什么",不用知道"怎么实现"
动态供应时序图如下:
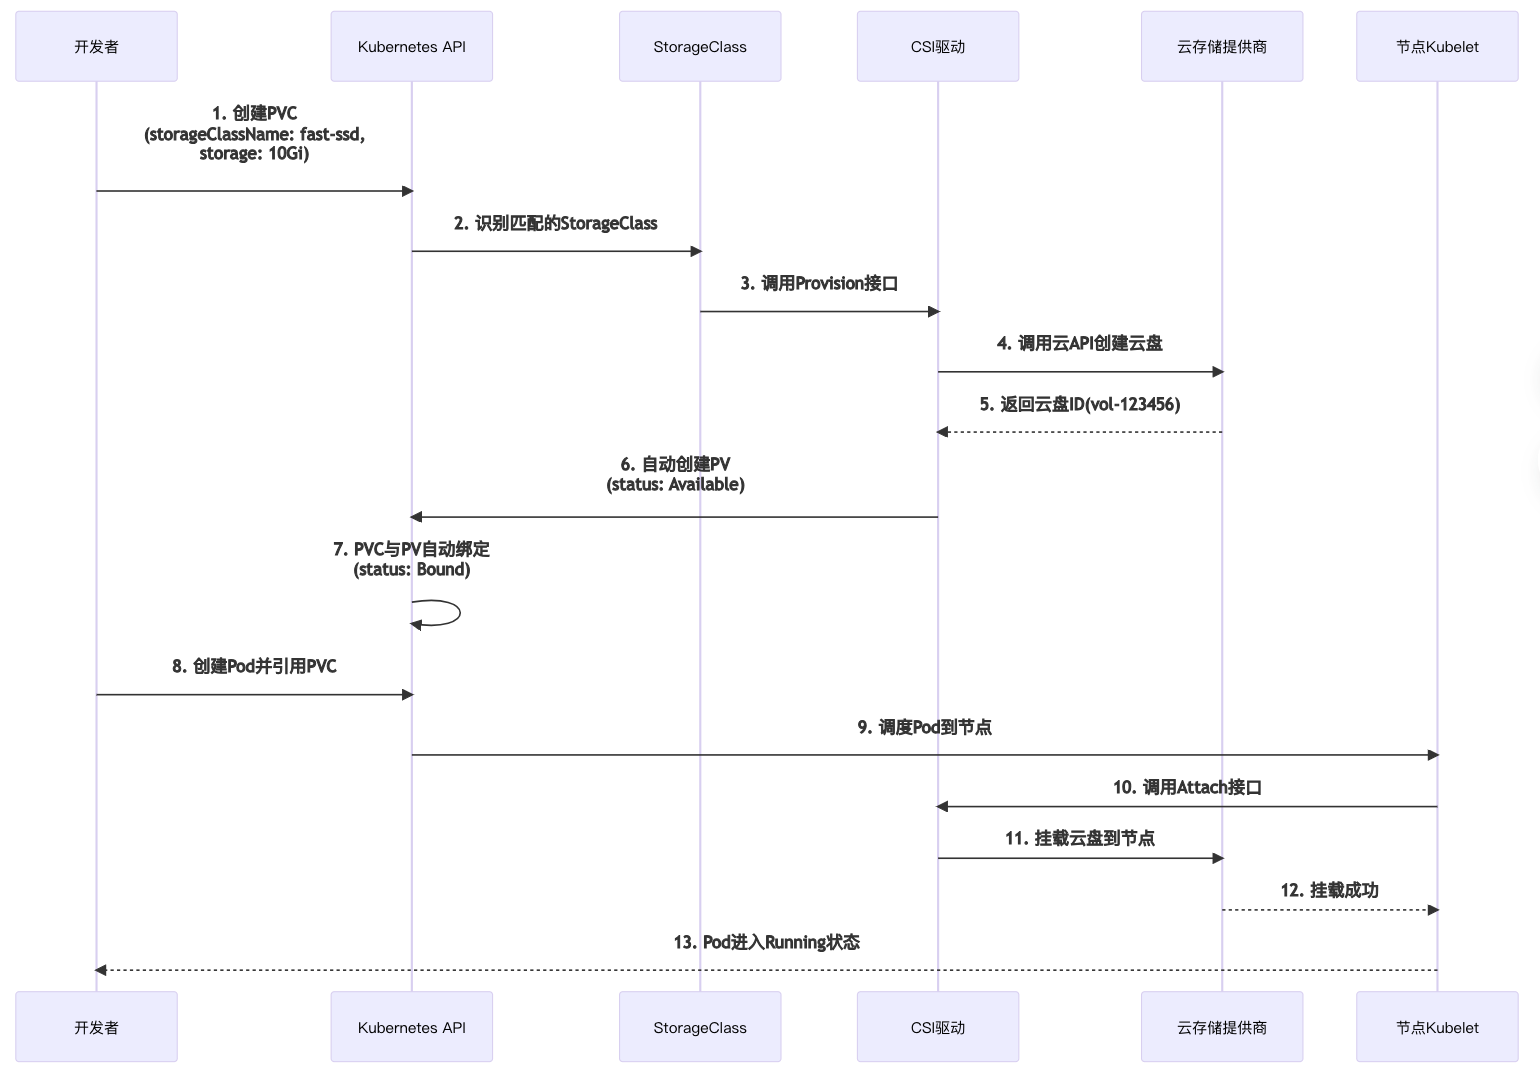
详细步骤解说:
1、步骤1-3:存储需求传递
- 步骤1:开发者创建PVC,就像在餐厅点菜一样,只需要说"我要10GB的高速SSD存储"
- 步骤2:Kubernetes找到对应的"菜单"——StorageClass配置
- 步骤3:系统根据菜单找到对应的"厨师"——CSI驱动
2、步骤4-5:云平台资源创建
- 步骤4:CSI驱动调用云厂商的API,就像厨师联系食材供应商
- 步骤5:云厂商创建真实的云硬盘并返回ID,就像供应商送来食材
3、步骤6-7:K8s内部资源抽象
- 步骤6:CSI驱动在K8s中创建PV对象,代表"这道菜已经准备好了"
4、步骤8-10:应用部署准备
- 步骤8:开发者创建Pod并指定使用前面申请的存储
- 步骤9:调度器选择合适的节点运行Pod
- 步骤10:节点上的Kubelet请求挂载存储
5、步骤11-13:最终挂载完成
- 步骤11-12:CSI驱动与云平台协作,将云盘实际挂载到节点
动态供应核心组件详解:
| 组件 | 角色 | 关键功能 | 生命周期 |
| PersistentVolumeClaim (PVC) | 存储需求声明 | 定义所需存储特性(大小、性能等) | 与应用生命周期相关 |
| StorageClass | 存储模板 | 定义动态供应的行为和参数 | 长期存在,集群级资源 |
| CSI驱动 | 存储插件 | 对接底层存储系统实现具体操作 | 集群部署,长期运行 |
| PersistentVolume (PV) | 存储资源实例 | 代表实际的存储资源 | 动态创建,与PVC绑定 |
| 云存储提供商 | 基础设施 | 提供物理/虚拟存储资源 | 独立于Kubernetes集群 |
流程总结:
开发者提交PVC后,Kubernetes通过CSI接口调用云厂商的API,在云平台上创建真实的存储资源,然后自动完成挂载流程。这套机制让复杂的存储基础设施对开发者变得透明,实现了真正的"基础设施即代码"。
这个流程完美体现了云原生的核心理念:声明式API + 可扩展架构 + 自动化运维。
2.3.3 Kubernetes存储机制与传统Docker挂载NFS的对比分析
这两种存储挂载方式高度相关,但实现机制处于不同的抽象层次。传统Docker挂载NFS是基础操作,而Kubernetes PV/PVC机制是在此基础上构建的高级抽象。
核心区别对比
| 特性 | Docker直接挂载 | Kubernetes PV/PVC |
| 配置方式 | 命令行/Compose文件 | 声明式YAML配置 |
| 存储抽象 | 无抽象,直接路径 | PV/PVC抽象层 |
| 生命周期 | 与容器/主机绑定 | 独立于Pod生命周期 |
| 多节点支持 | 每节点单独配置 | 集群统一管理 |
| 动态供应 | 不支持 | 支持(需Provisioner) |
| 存储类型 | 仅NFS | 支持多种存储后端 |
| 权限管理 | 手动配置 | 通过StorageClass控制 |
2.3.4 常用卷类型对比
卷(Volume) 是 Kubernetes 中用于为 Pod 提供持久化或临时存储的抽象概念。它是 Pod 中的一个目录,可供容器访问,其生命周期由卷类型决定。
| 类型 | 特点 | 适用场景 | 生命周期 |
| emptyDir | 临时存储,随Pod删除而销毁 | 缓存文件、临时数据处理 | 与 Pod 相同 |
| hostPath | 挂载节点本地目录(慎用) | 监控代理访问节点文件系统 | 独立于 Pod (节点重启后保留) |
| nfs | 网络文件系统 | 多Pod共享读/写(如媒体库) | 独立于集群 需手动管理 |
| awsEBS/gcePD | 云厂商块存储 | 数据库持久化数据 | 独立于集群 需手动删除 |
| configMap/secret | 将配置/密钥作为文件挂载 | 应用配置文件、TLS证书 | 与 ConfigMap/Secret 对象相同 |
2.3.5 实际应用场景
数据库存储场景:
- 使用:StatefulSet + PVC
- 存储:动态申请云盘(如MySQL数据目录)
- 特点:数据持久化、有序部署
配置管理场景:
- 使用:ConfigMap挂载为卷
- 效果:配置修改后自动同步到Pod
三、高级特性
3.1 工作负载与调度进阶
3.1.1 高级调度策略
Kubernetes高级调度策略通过精细控制Pod的部署位置和分布方式,优化集群资源利用并满足各类业务需求。
| 调度策略 | 控制对象 | 主要作用 | 解决的问题 | 应用场景 | 优先级(强制执行力度) |
| 节点亲和性 | Pod与节点 | 控制Pod在特定节点上的部署 | 硬件资源匹配问题 (如GPU节点、高内存节点) | 硬件优化 | 高 |
| Pod亲和性 | Pod与Pod | 控制Pod之间的协同部署位置 | 服务拓扑优化问题 (如缓存与计算服务就近部署) | 服务拓扑 | 中 |
| Pod反亲和性 | Pod与Pod | 防止Pod过度集中 | 高可用性问题 (避免单点故障影响多个副本) | 高可用部署 | 中 |
| 污点与容忍 | 节点与Pod | 创建专用节点区域 | 节点隔离问题 (如专用GPU节点、预留测试节点) | 专用节点 | 最高 |
| 拓扑分布约束 | Pod分布域 | 跨拓扑域均匀分布Pod | 容灾部署问题 (跨机架/可用区/区域部署) | 容灾部署 | 中 |
| 自定义调度器 | 调度逻辑 | 实现特殊调度逻辑 | 特殊业务需求问题 (如批处理作业调度) | 特殊需求 | 自定义 |
3.1.2 资源管理与服务质量 (QoS)
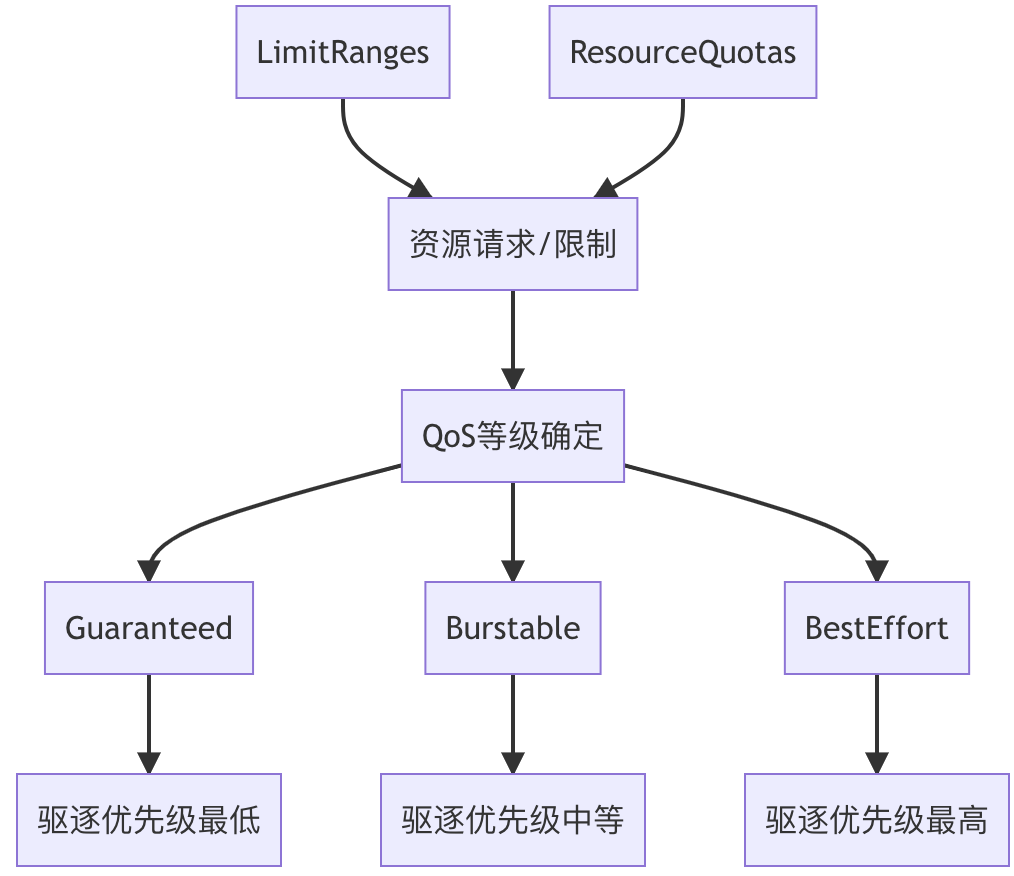
核心机制解析:
1. QoS作用
根据Pod的资源请求(requests)和限制(limits)分配服务质量等级,决定资源竞争时的优先级和驱逐顺序。分为:
- Guaranteed:严格资源保障(requests=limits),资源不足时最后被驱逐
- Burstable:弹性资源分配(部分设置requests),中等驱逐优先级
- BestEffort:无资源保证(未设requests/limits),资源紧张时优先被驱逐
2. 资源管理组件
- LimitRanges:强制约束Pod/容器的资源请求与限制范围
- ResourceQuotas:限制命名空间级别的总资源用量
两者共同确保资源声明符合QoS分级前提。
3.2 网络、安全与策略
3.2.1 核心安全领域与架构总览
下图架构展示了Kubernetes安全防护的层次化设计理念,通过身份认证与授权作为安全基础,网络隔离与控制作为防护边界,机密信息管理作为数据保障,共同构建了深度防御的安全体系。
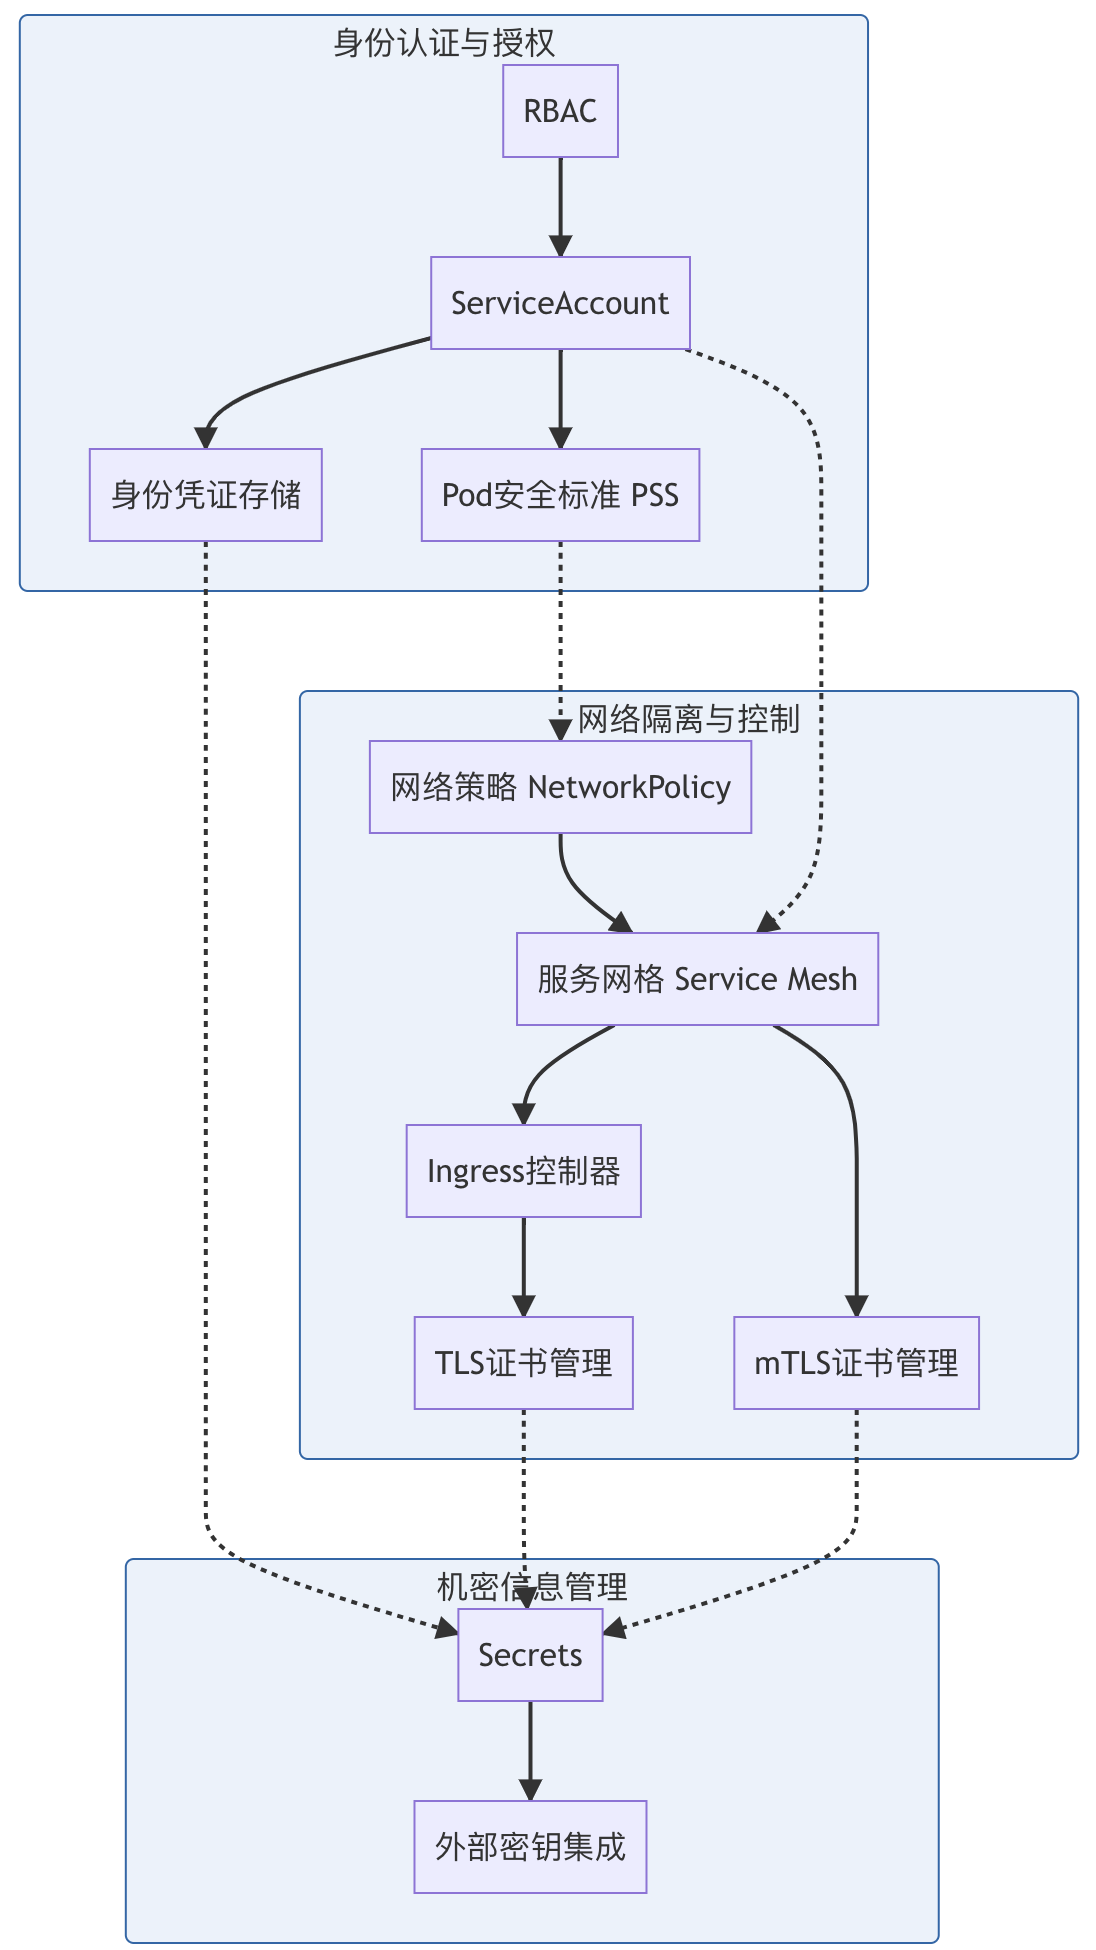
关键组件介绍见下面3个小节
3.2.2 身份认证与授权
此领域确保用户和工作负载具有明确的、最小化的身份与权限,是访问控制的基石。
| 安全组件 | 安全角色 | 核心功能 | 控制粒度 | 关键依赖/关联 |
| RBAC | 访问控制 | Kubernetes核心权限模型,定义谁可以在集群中执行什么操作。控制对API资源(如Pod、Service)的操作权限(如get, list, create)。 | 用户/服务账号 | API Server |
| ServiceAccount | 工作负载身份 | 为在Pod中运行的进程提供身份标识,是工作负载访问API Server的凭证。 | Pod级别 | RBAC (通过RoleBinding授权) |
| Pod安全标准 (PSS) | 运行时安全 | 通过准入控制器定义Pod必须遵守的安全约束(特权、能力等),提供基线、限制等策略级别。 | Pod级别 | 准入控制器 (如PodSecurity) |
3.2.3 网络隔离与控制
此领域控制集群内外的网络流量,实现微服务间的安全通信与隔离。
| 安全组件 | 安全角色 | 核心功能 | 控制粒度 | 关键依赖/关联 |
| 网络策略 (NetworkPolicy) | 微隔离 | 定义Pod组之间允许的入站(Ingress)和出站(Egress)规则,充当集群内防火墙。 | Pod级别 | CNI网络插件 |
| 服务网格 (Service Mesh) | 服务安全 | 提供自动mTLS加密、基于身份的细粒度策略、可观测性等高级安全与控制。 | 服务/工作负载级别 | 控制平面 (如Istio),ServiceAccount |
| Ingress控制器 | 边界安全 | 在集群入口层面提供TLS终止、路由、以及与外部的OAuth/OpenID Connect认证服务集成。 | HTTP/HTTPS路由级别 | Ingress资源 |
3.2.4 机密信息管理
此领域确保密码、令牌、证书等敏感信息的安全存储、分发和使用。
| 安全组件 | 安全角色 | 核心功能 | 控制粒度 | 关键依赖/关联 |
| Secrets | 机密存储 | Kubernetes内建资源,用于以加密形式存储少量敏感数据,是机密管理的基础。 | 命名空间级别 | etcd (加密存储) |
| 外部Secrets集成 | 密钥扩展 | 将专业外部密钥管理系统(如HashiCorp Vault, AWS Secrets Manager)与Kubernetes无缝集成。 | 集群/应用级别 | 外部密钥库,Operator (如ESO) |
3.3 自动化与弹性
此领域涵盖Kubernetes保障应用高可用性与资源高效利用的核心机制。
3.3.1 自动扩缩容体系
自动扩缩容通过不同维度动态调整资源,以应对负载变化,实现弹性与成本控制。
| 扩缩类型 | 控制维度 | 核心原理与触发指标 | 适用场景与说明 |
| HPA (Horizontal Pod Autoscaler) | 水平扩缩 | 基于CPU/内存使用率、自定义指标(如QPS)等,动态调整Pod的副本数量。 | 无状态服务弹性。最常用的扩缩容方式,适用于几乎所有可水平扩展的工作负载。 |
| VPA (Vertical Pod Autoscaler) | 垂直扩缩 | 基于历史资源使用分析,自动优化Pod的requests和limits配置。 | 资源优化。用于解决资源配置不当问题。注意:由于需要重建Pod,在生产环境中需谨慎使用。 |
| Cluster Autoscaler (集群自动扩缩) | 集群扩缩 | 监测因资源不足而无法调度的Pod,自动调整节点池的节点数量。 | 集群成本控制。与HPA联动,确保在应用需要更多Pod时,集群有足够的节点资源。 |
3.3.2 发布策略与自愈机制
此部分保障应用的可控发布与运行期间的高可用性。
1. 发布策略
通过Deployment等控制器实现平滑的应用升级与流量控制。
- 蓝绿发布:同时部署新旧两个完整环境,通过切换流量实现瞬间发布与回滚。
- 金丝雀发布:将部分用户流量引入新版本,验证无误后逐步扩大范围,实现渐进式发布。
2. 自愈机制
Kubernetes核心功能,确保应用实例始终处于预期状态。
- 工作负载自愈:当Pod因故障退出时,Deployment、StatefulSet等控制器会自动重新创建Pod,恢复预期副本数。
- Pod中断预算(PDB):保障自愿中断期间的应用可用性。通过设置最小可用Pod实例数或最大不可用Pod实例数,在对节点进行维护/驱逐时,防止过多Pod同时中断,确保服务不失衡。
四、总结:从容器编排到云原生操作系统的演进
Kubernetes已经超越了其"容器编排器"的初始定位,逐步演进为云原生时代的分布式操作系统内核。它通过一系列精妙的设计,实现了从基础设施抽象到应用生命周期管理的范式变革。
4.1 标准化抽象层
Pod、Service、Ingress、ConfigMap等资源定义了一套通用的"语言",用于描述应用及其依赖。这实现了开发与运维责任的清晰分离,开发者关注业务逻辑,运维者关注平台稳定性。
4.2 自动化运维引擎
无论是故障自愈、负载均衡,还是滚动更新,其内在驱动力都是控制循环。这些永不疲倦的控制器是自动化的核心引擎,将运维人员从重复性劳动中解放出来。
4.3 多层次弹性体系
从Pod级别的HPA,到节点级别的Cluster Autoscaler,Kubernetes构建了一个多层次、自动响应的弹性体系。
4.4 可扩展生态基石
CRD和Operator模式赋予了Kubernetes无限的生命力,使得任何有状态应用、中间件都能以"云原生"的方式被管理和运维。
Kubernetes不仅仅是一项技术,它更代表了一种构建和运维应用的先进思想。它正在也必将持续地重塑整个软件生命周期,成为未来十年数字化基础设施的坚实底座。
扩展阅读:
博客:https://blog.csdn.net/2301_78183285/article/details/138656873
B站视频:https://www.bilibili.com/video/BV13Q4y1C7hS
官网中文文档:https://kubernetes.io/zh-cn/docs/concepts/
思考题
结合你在实际项目中的经验,思考以下问题:
在构建现代微服务架构时,我们面临着一个三层网络技术栈的选择:
- Kubernetes Service + Ingress:提供基础的服务发现和入口管理
- Spring Cloud Gateway + Eureka:处理复杂的业务层路由和过滤逻辑1
- Service Mesh(如Istio):提供统一的服务间通信治理
思考方向:
- 这三层技术栈是竞争关系还是互补关系?
- 在什么场景下应该选择混合架构(如K8s Service + Spring Cloud Gateway)?
- Service Mesh是否真的会完全取代Spring Cloud生态中的网关和服务发现组件?
- 从运维复杂度、性能开销、功能丰富度等多个维度,如何做出理性的技术选型?
在云原生架构不断演进的今天,没有放之四海而皆准的技术方案,唯有持续思辨才能找到最适合自身场景的路径。期待你在评论区分享独到见解!
📚 我的技术博客导航:[点击进入一站式查看所有干货]
更多推荐

 22
 0
- 0


 已为社区贡献18条内容

所有评论(0)