
【无线电控制与数据链探测系统】第10章 基于机器学习/深度学习的系统工程实践
·
10.1 数据管线:采集、标注、清洗、平衡
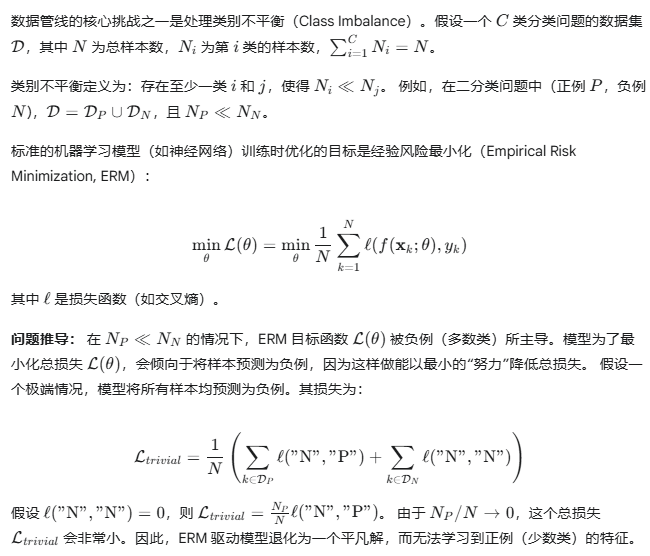
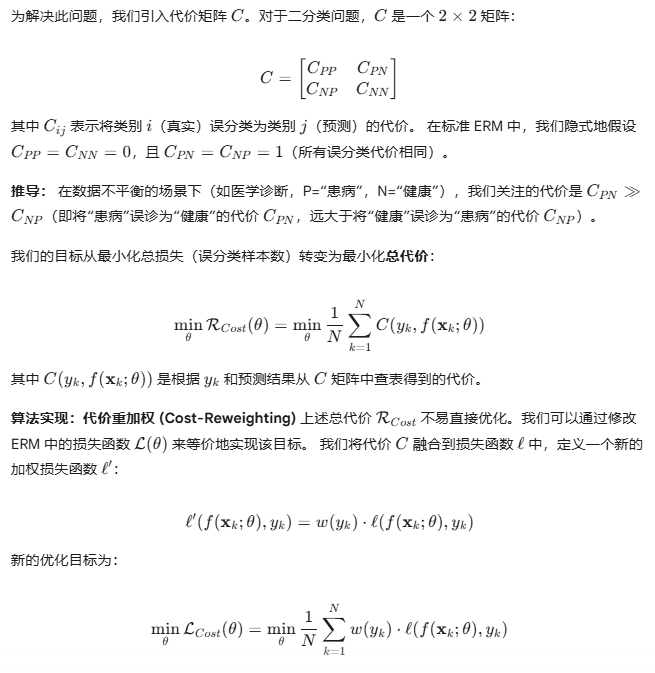
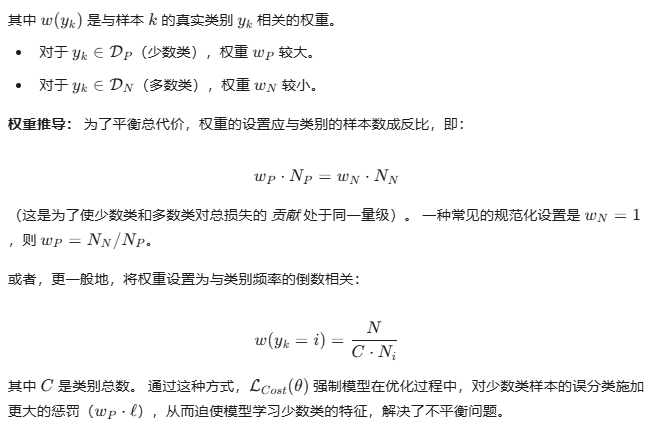
在机器学习系统工程中,数据管线(Data Pipeline)是决定模型性能上限的基础设施。其目标是为模型训练提供持续、高质量、无偏的数据流。本节将重点推导数据平衡(Data Balancing)中的核心理论:代价敏感学习(Cost-Sensitive Learning)。
10.1.1 数据不平衡的数学表述
10.1.2 代价敏感学习 (Cost-Sensitive Learning)
10.2 模型选择与资源/延迟权衡
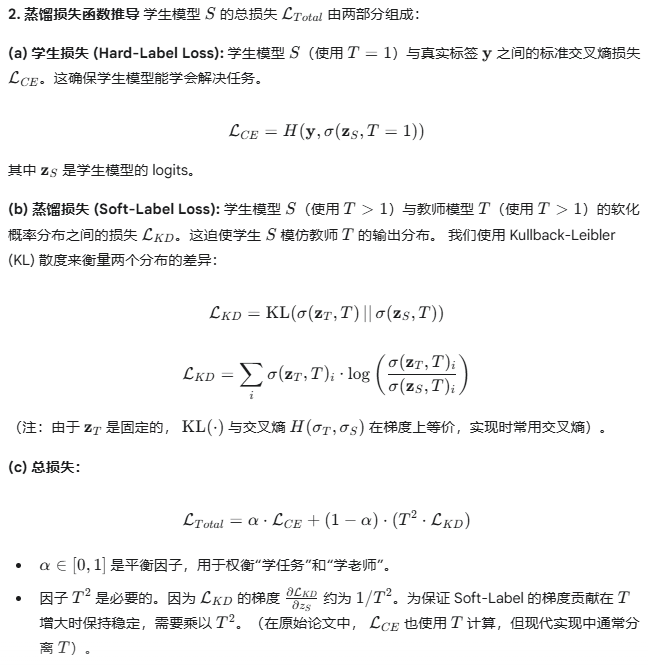
模型选择不仅要考虑精度(Accuracy),还必须权衡推理延迟(Latency)、计算资源(FLOPs)和内存占用(Memory)。本节推导两种实现高效推理的核心技术:模型量化和知识蒸馏。
10.2.1 模型量化 (Quantization)
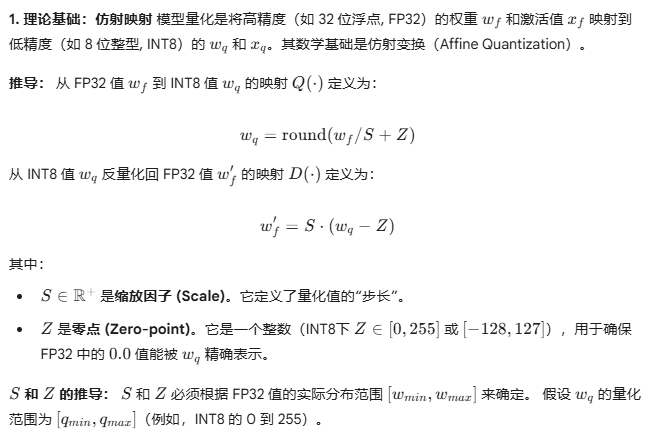
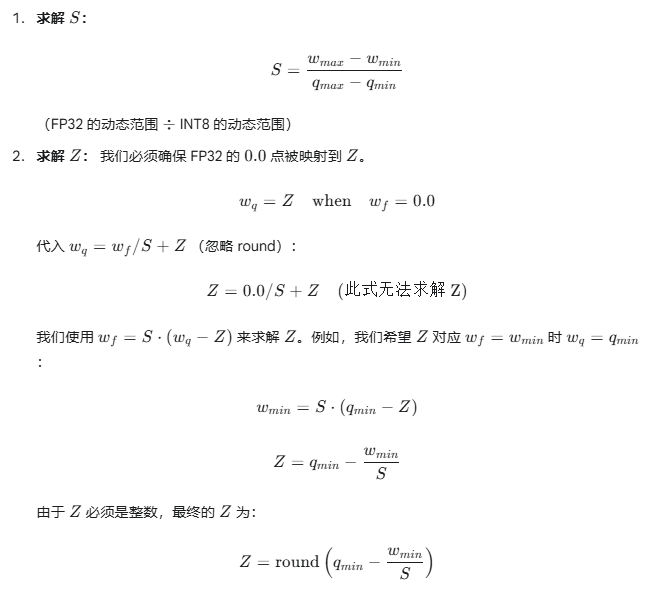
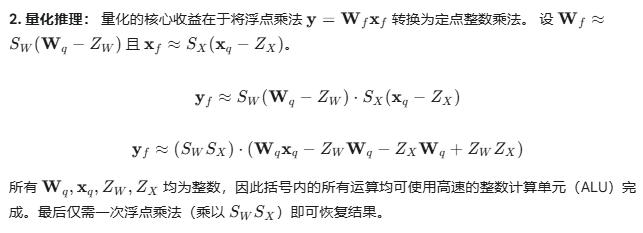
10.2.2 知识蒸馏 (Knowledge Distillation)
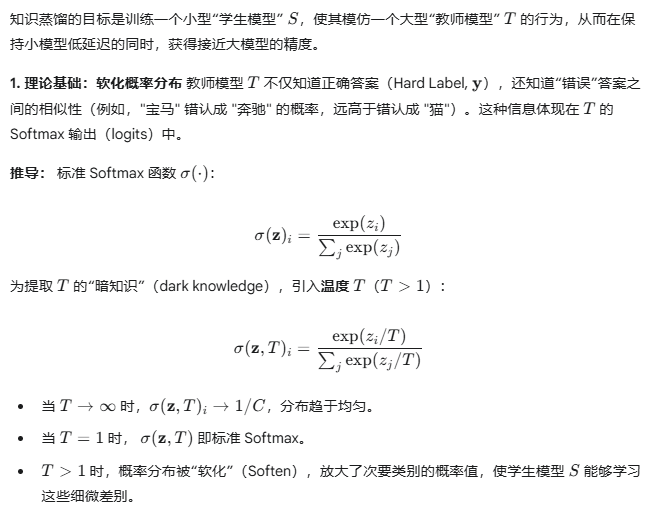
10.3 域适配与迁移学习
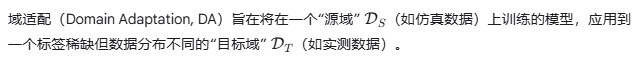
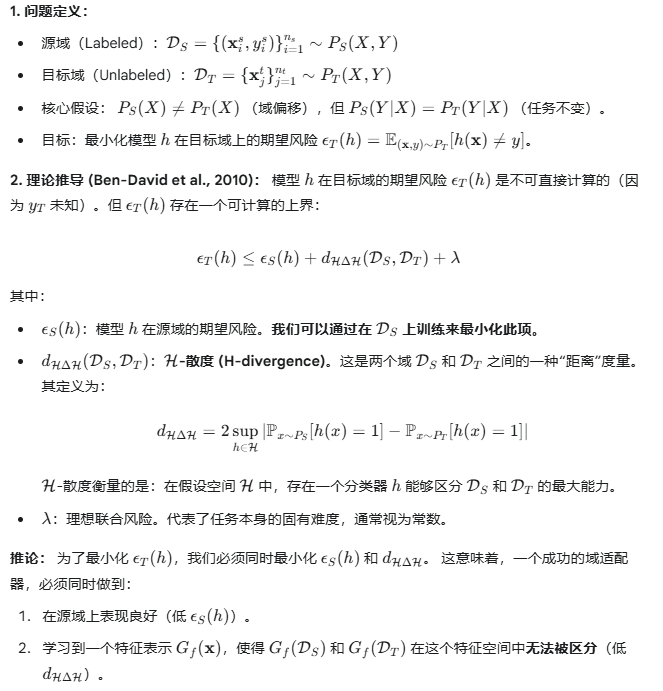
10.3.1 域适配的理论边界
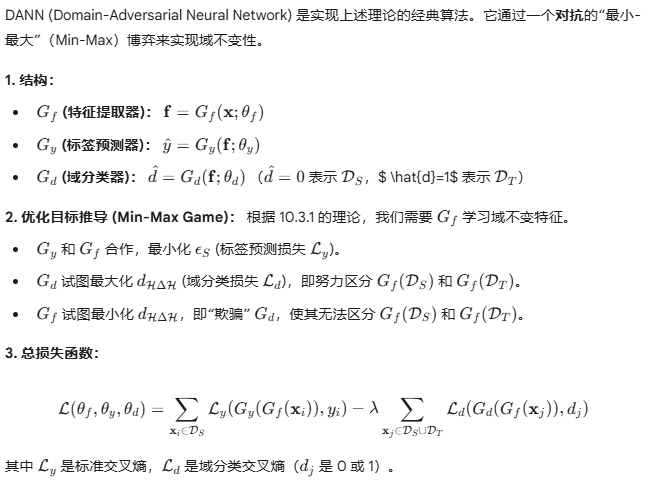
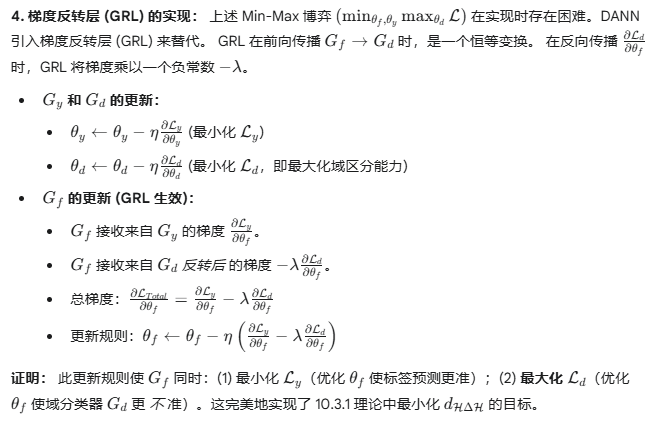
10.3.2 域对抗神经网络 (DANN)
10.4 联邦学习与隐私保护实践
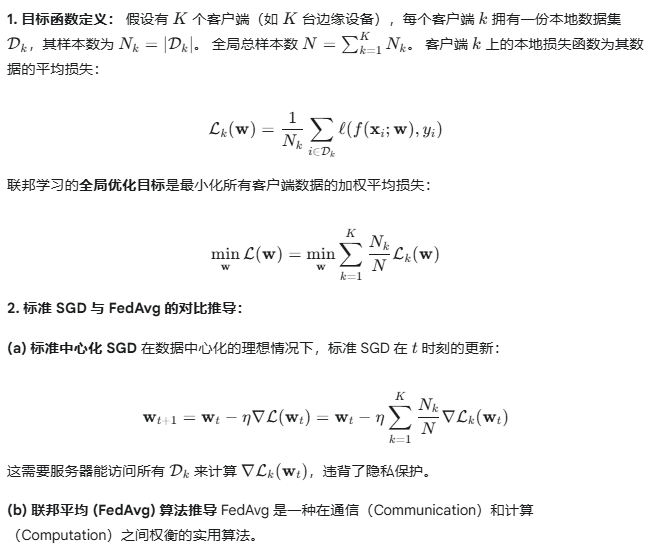
联邦学习 (Federated Learning, FL) 是一种分布式机器学习范式,其核心是“数据不动,模型动”,以在保护数据隐私(数据不出本地)的前提下,协同训练全局模型。
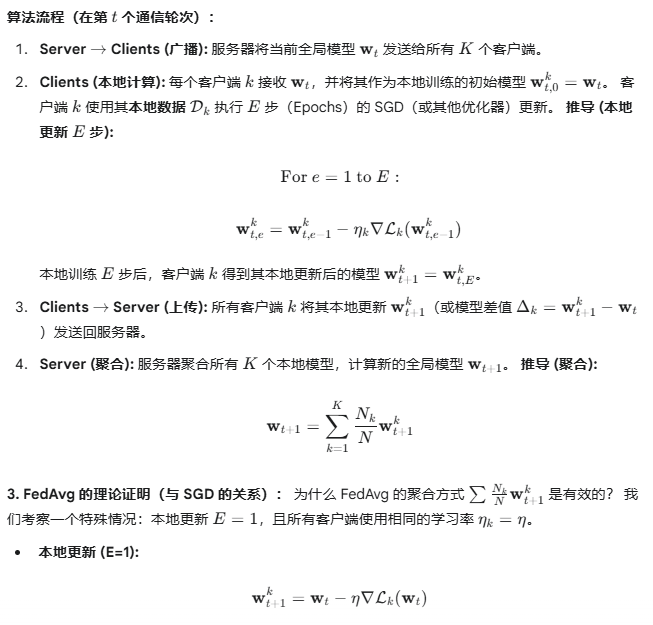
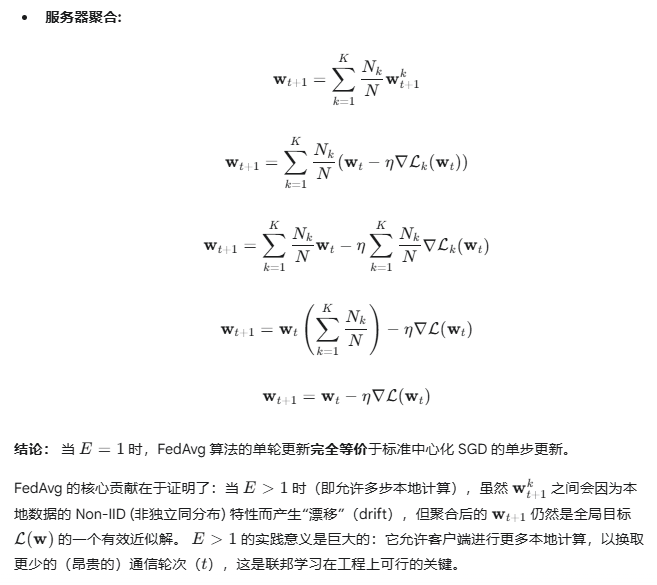
10.4.1 联邦平均 (Federated Averaging, FedAvg) 算法
更多推荐



 9
 0
- 0


 已为社区贡献12条内容

所有评论(0)