
0005机器学习线性回归问题的深入学习与理解
0005机器学习线性回归问题的深入学习与理解
一、线性回归问题
1.1 一元线性回归问题
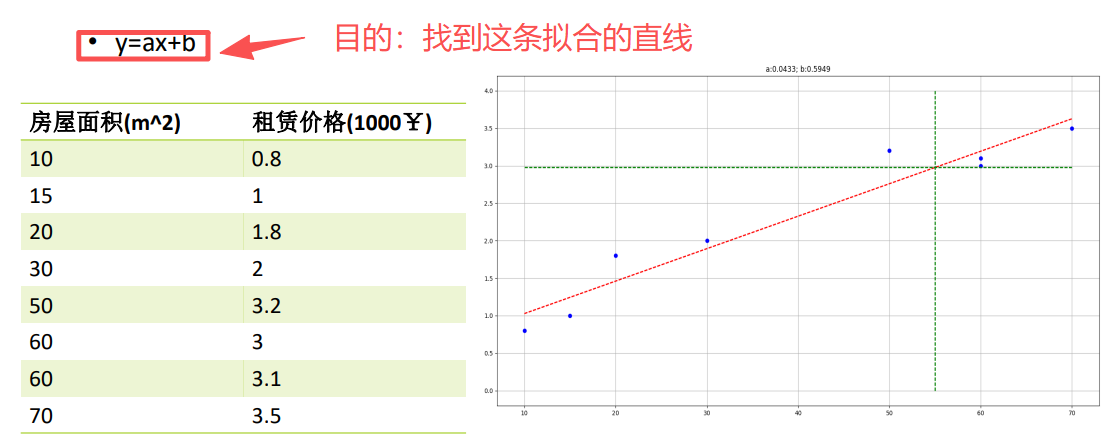
- 一元线性回归是分析两个变量之间线性关系的统计方法,核心是找到一条能最好拟合数据的直线。一元线性回归研究的是一个自变量(X)和一个因变量(Y) 之间的线性依存关系。
- 数学公式为 Y = a + bX
- a 是截距,代表当 X=0 时,Y 的预测值。
- b 是斜率,代表 X 每增加 1 个单位,Y 平均变化的单位数。
目的:找这根拟合的直线
2.2 二元线性回归问题
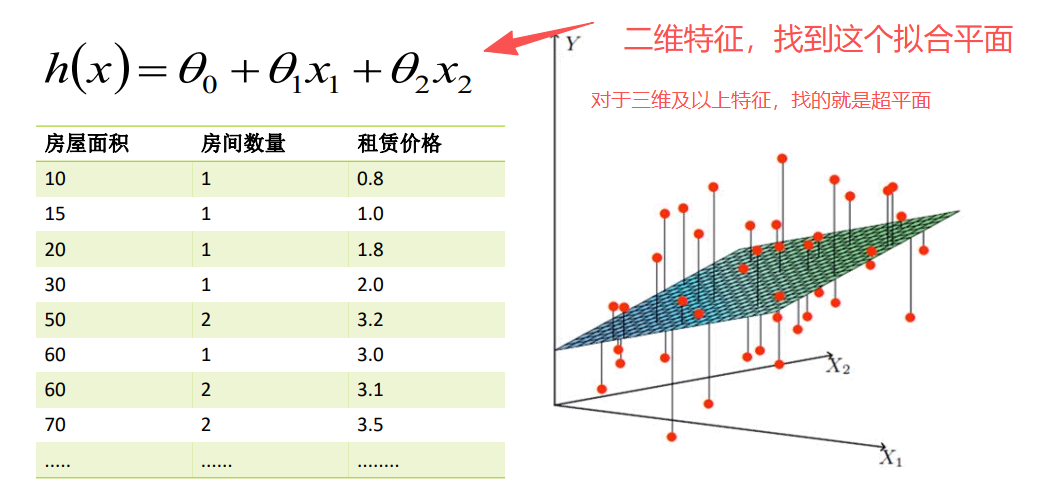
- 二元线性回归研究的是两个自变量(X₁、X₂) 与一个因变量(Y) 之间的线性依存关系。
- 线性关系:三个变量的关系可通过线性方程描述,数学公式为 Y = a + b₁X₁ + b₂X₂。
- a 是截距,代表 X₁和 X₂都为 0 时,Y 的预测值。
- b₁ 是 X₁的斜率,代表 X₂固定时,X₁每增加 1 单位,Y 平均变化的单位数。
- b₂ 是 X₂的斜率,代表 X₁固定时,X₂每增加 1 单位,Y 平均变化的单位数。
目的:找这个拟合的平面
3.3 多元线性回归问题
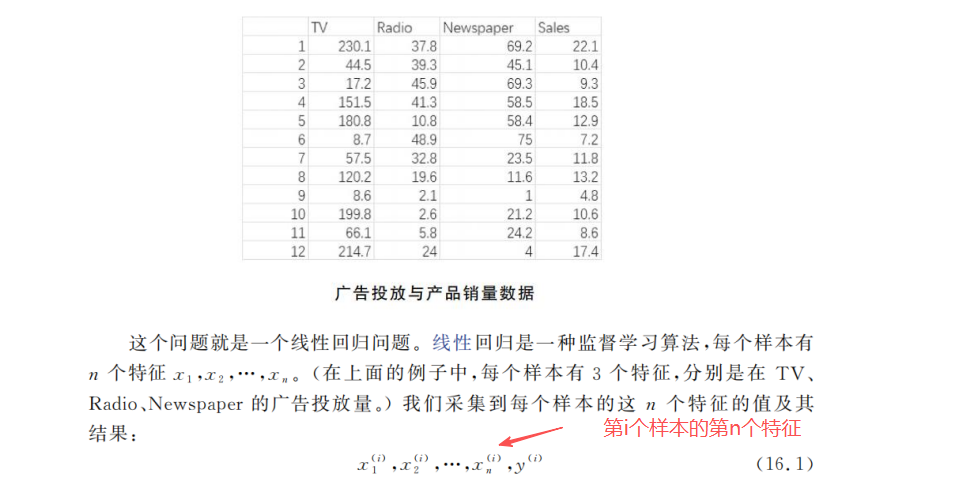
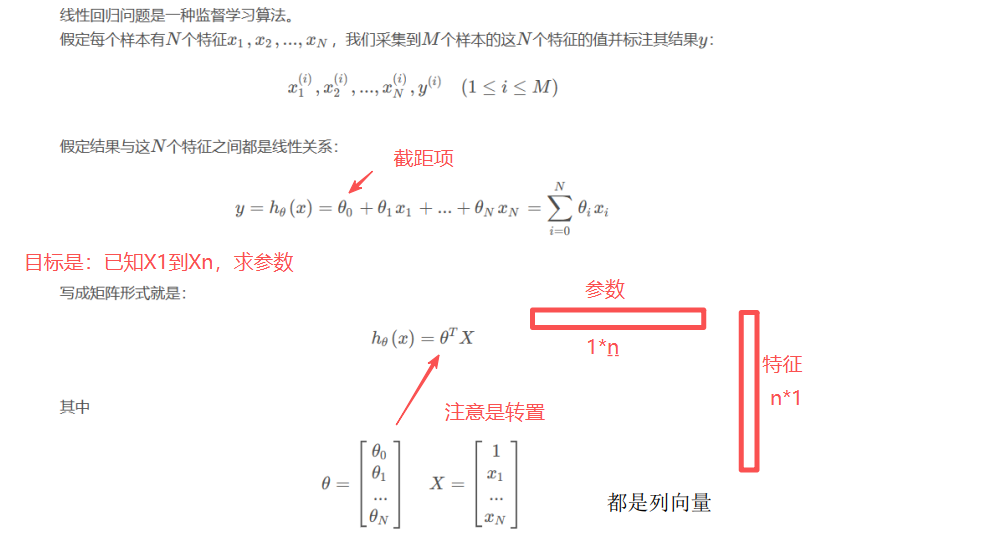
- 多元线性回归研究的是两个及以上自变量(X₁、X₂、…、Xₙ) 与一个因变量(Y) 之间的线性依存关系。
- 线性关系:变量间的关系通过线性方程描述,数学公式为 Y = a + b₁X₁ + b₂X₂ + … + bₙXₙ。
- a 是截距,代表所有自变量都为 0 时,Y 的预测值。
- b₁、b₂、…、bₙ 是各自变量的斜率(也称回归系数),分别代表其他自变量固定时,对应自变量每增加 1 单位,Y 平均变化的单位数。
目的:找拟合的超平面
二、线性回归问题的解析解法
1.1 解析解法的数学推导
以下是一个三元线性回归的举例,每条样本有3个特征值,目的是通过收集到的样本特征值找到拟合的参数
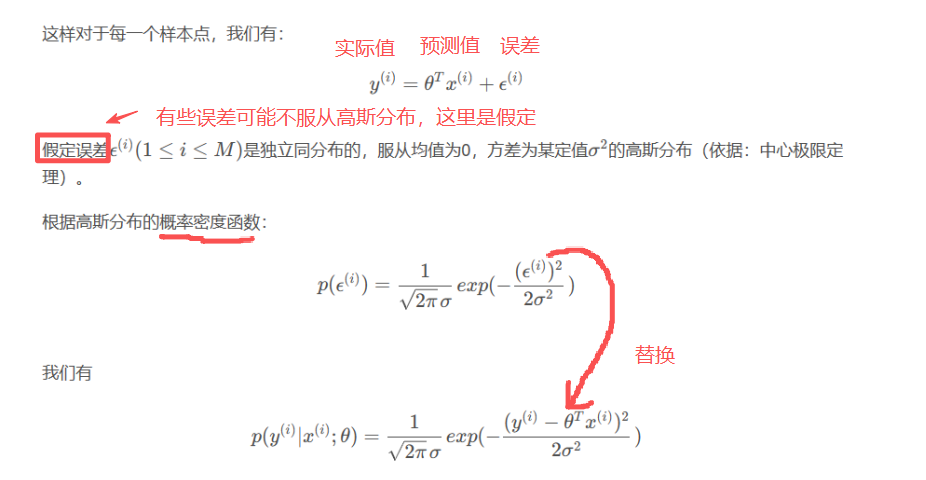
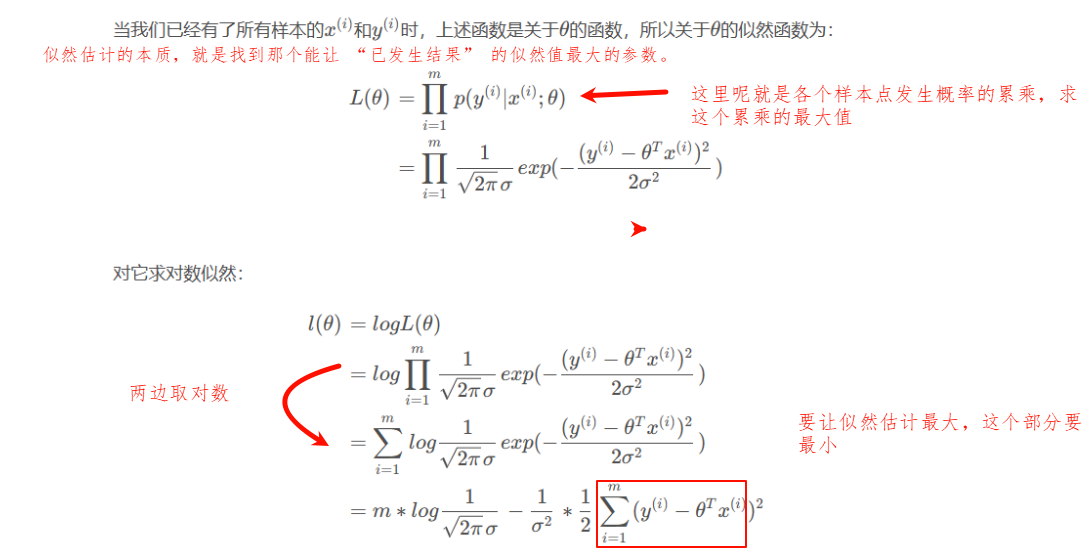
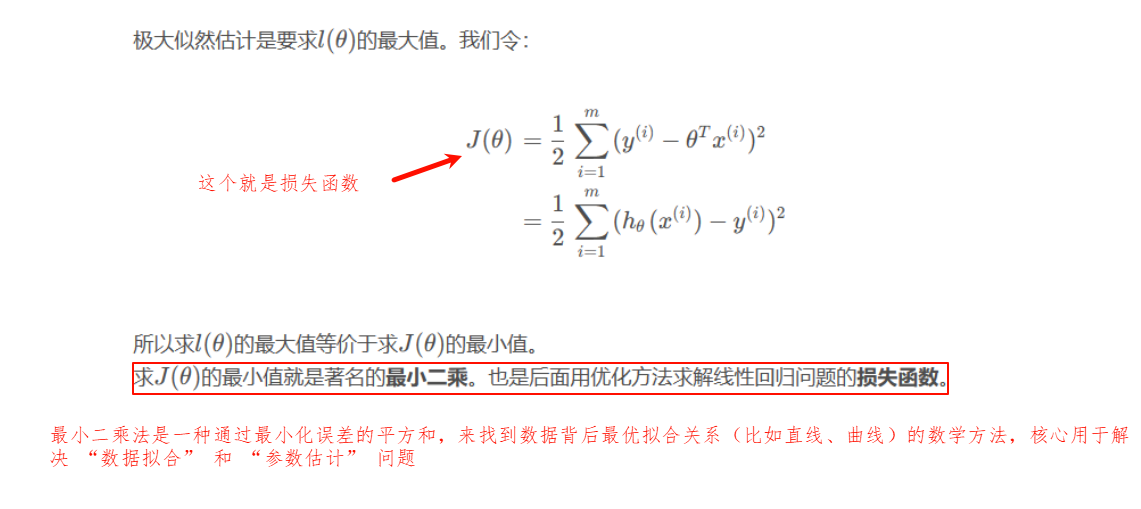
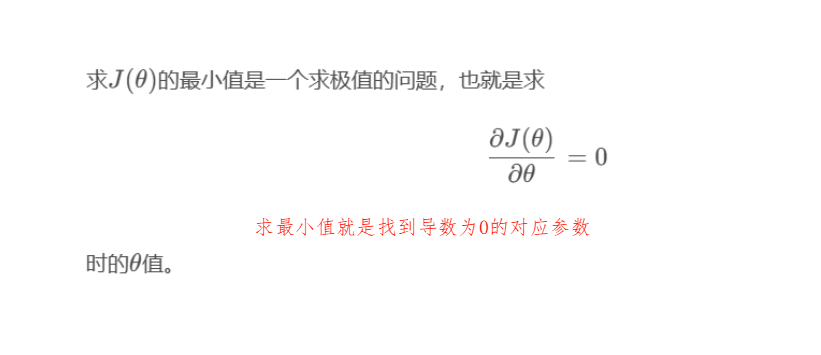
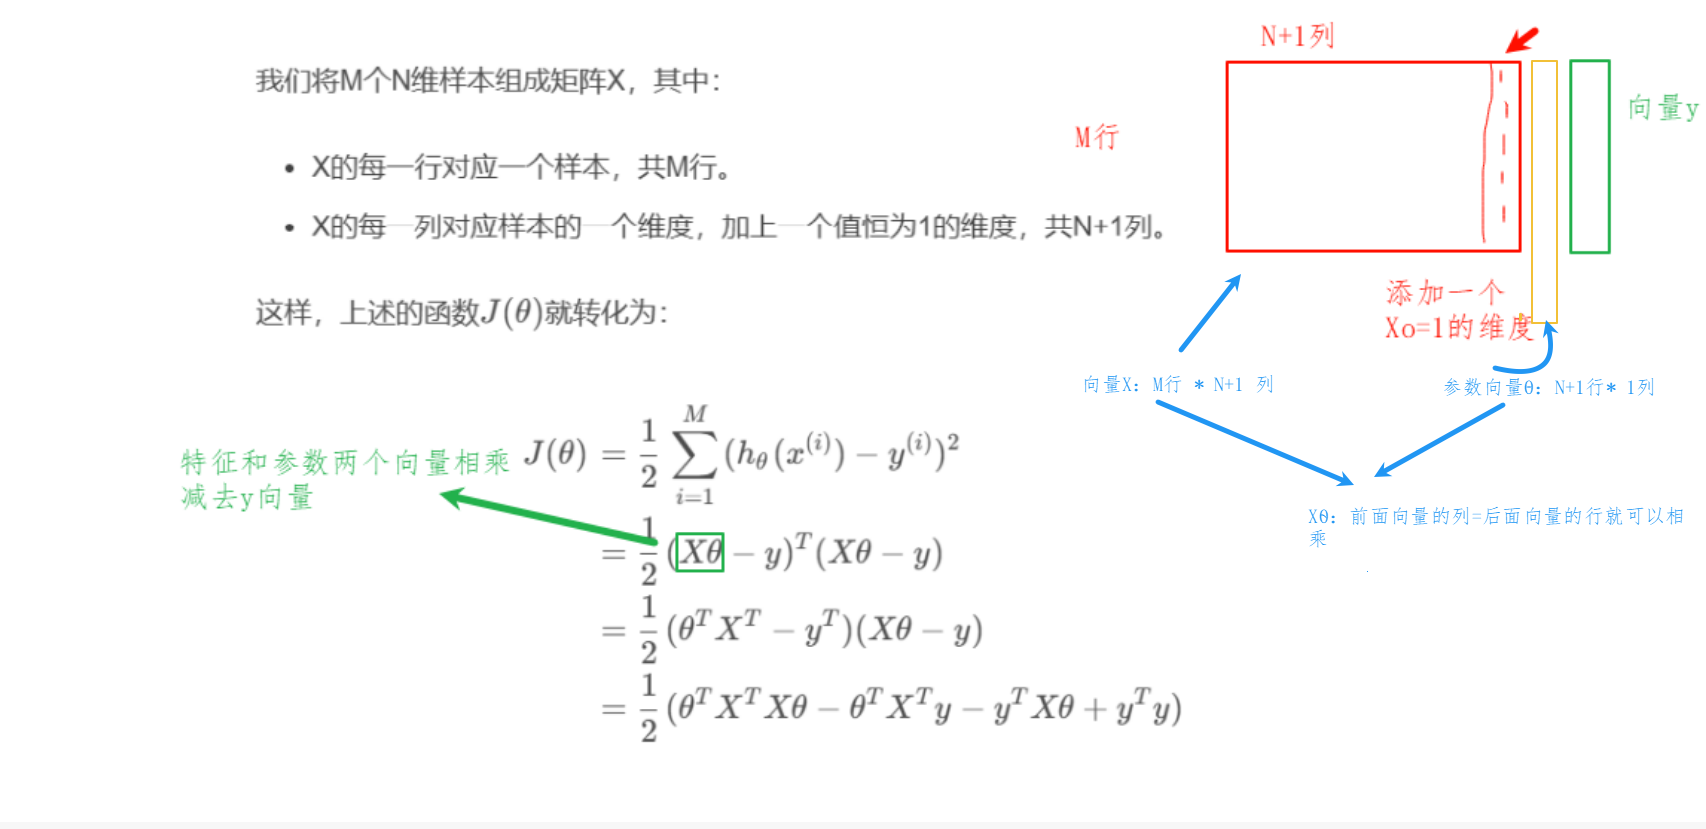
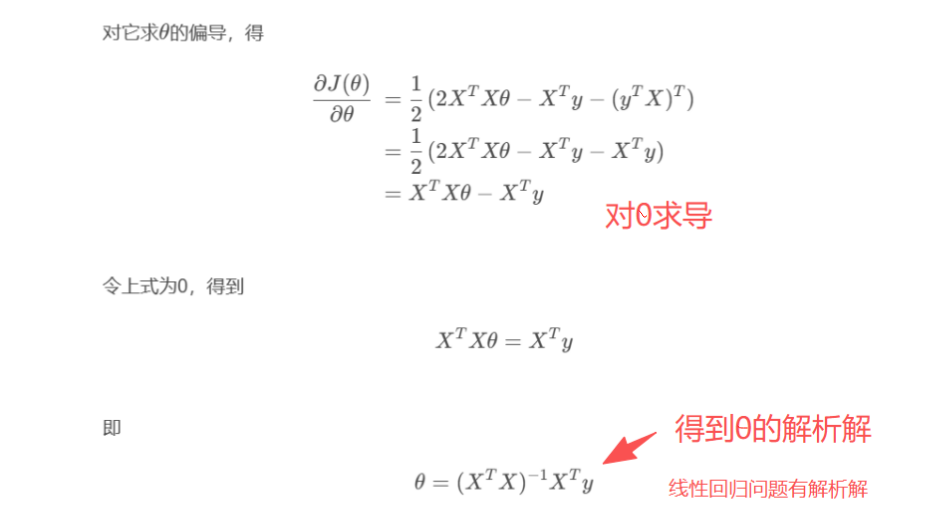
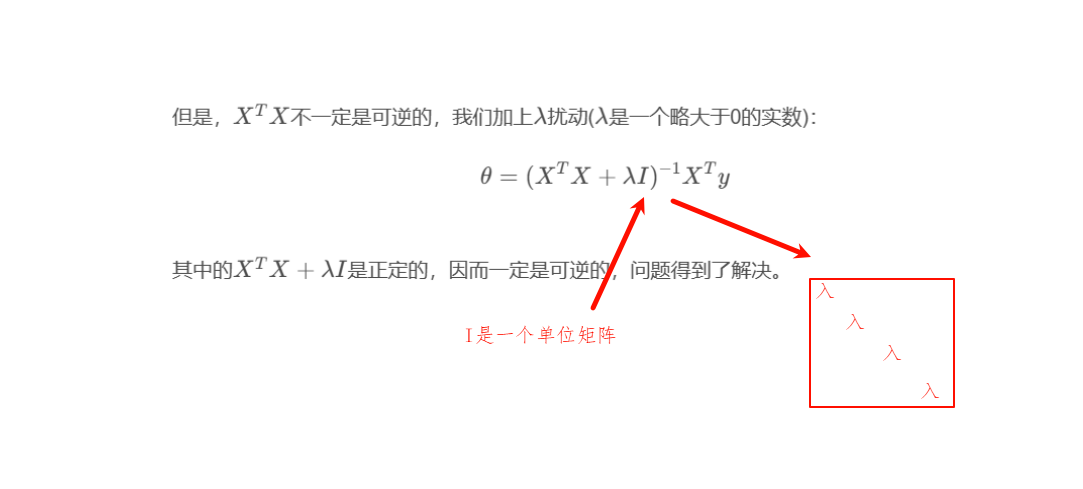
2.2 机器学习的开发流程
1、数据收集
2、数据进行清洗
3、获取我们的数据的特征属性X和目标属性Y
4、数据分割【指的是把数据划分为训练集和测试集】
5、特征工程 正则化、标准化,文本的处理
6、构建模型
7、训练模型
8、模型效果的评估 (效果不好,返回第二步进行优化,达到要求)
9、模型保存/模型的持久化
10、模型的部署
3.3 解析解法的代码实现
import numpy as np
import matplotlib.pyplot as plt
import os  # 用于文件路径处理


class Linear:
    def __init__(self, use_b=True):
        self.use_b = use_b  # 是否使用截距项(偏置),默认使用
        self.theta = None  # 特征权重向量(N矩阵,N为特征数)
        self.theta0 = 0  # 截距项(标量)

    def train(self, X, Y):
        """
        训练线性回归模型:使用最小二乘法解析式求解参数
        核心公式:θ = (X^T·X)^(-1) · X^T·Y (含截距项时X已添加全1列)
        :param X: 训练特征矩阵,形状为 (M×N),M=样本数,N=特征数
        :param Y: 训练标签向量,形状为 (M×1)
        """
        if self.use_b:
            # np.ones((X.shape[0], 1)): 生成M×1的全1矩阵
            X = np.column_stack((np.ones((X.shape[0], 1)), X))

        # 转换为矩阵类型,方便进行转置、求逆等线性代数运算
        X = np.asmatrix(X)
        Y = np.asmatrix(Y)

        # 最小二乘法解析式求解参数:(X^T X)的逆 × X^T × Y
        theta = (X.T * X).I * X.T * Y

        if self.use_b:
            self.theta0 = theta[0, 0]  # 截距项(第一行第一列,取标量)
            self.theta = theta[1:]  # 特征权重(去掉第一行的截距项)
        else:
            self.theta0 = 0  # 无截距项时,偏置为0
            self.theta = theta  # 权重直接等于求解结果

    def predict(self, X):
        """
        预测函数:根据训练好的参数计算预测值
        预测公式:y_hat = X·θ + θ0
        :param X: 预测特征矩阵/向量,形状为 (K×N),K=预测样本数
        :return: 预测结果向量,形状为 (K×1)
        """
        # 确保输入为矩阵类型,避免维度不匹配
        X = np.asmatrix(X)
        predict_y = X * self.theta + self.theta0  # 矩阵乘法+标量加法
        return predict_y

    def score(self, X, Y, metric='r2'):
        """
        模型评估函数:支持MSE、R²、MAE三种指标
        :param X: 评估特征矩阵,(M×N)
        :param Y: 真实标签向量,(M×1)
        :param metric: 评估指标,可选 'mse'(均方误差)、'r2'(决定系数)、'mae'(平均绝对误差)
        :return: 对应的评估分数
        """
        X = np.asmatrix(X)
        Y = np.asmatrix(Y)
        y_hat = self.predict(X)  # 计算预测值
        residuals = Y - y_hat  # 残差(真实值-预测值)

        if metric == 'mse':
            # 均方误差:MSE = (1/M) × Σ(residuals²)
            return np.mean(np.square(residuals))
        elif metric == 'r2':
            # 决定系数:R² = 1 - (Σ残差² / Σ总偏差²),越接近1越好
            ss_res = np.sum(np.square(residuals))  # 残差平方和
            ss_tot = np.sum(np.square(Y - np.mean(Y)))  # 总偏差平方和
            return 1 - (ss_res / ss_tot) if ss_tot != 0 else 1.0
        elif metric == 'mae':
            # 平均绝对误差:MAE = (1/M) × Σ(|residuals|)
            return np.mean(np.abs(residuals))
        else:
            raise ValueError("metric仅支持 'mse'、'r2'、'mae'")

    def save(self, model_path='linear_model.npz'):
        """
        保存模型参数到硬盘:将theta(权重)和theta0(截距)保存为npz文件
        :param model_path: 模型保存路径,默认当前目录下的 linear_model.npz
        """
        # 确保theta是数组类型(矩阵转数组,方便保存)
        theta_arr = np.array(self.theta).flatten()  # 展平为1维数组
        np.savez(model_path, theta=theta_arr, theta0=self.theta0, use_b=self.use_b)
        print(f"模型已保存到:{os.path.abspath(model_path)}")

    def load(self, model_path='linear_model.npz'):
        """
        从硬盘加载模型参数
        :param model_path: 模型文件路径
        """
        if not os.path.exists(model_path):
            raise FileNotFoundError(f"模型文件不存在:{model_path}")

        # 加载npz文件中的参数
        data = np.load(model_path)
        self.theta = np.asmatrix(data['theta']).reshape(-1, 1)  # 恢复为N×1矩阵
        self.theta0 = data['theta0']
        self.use_b = data['use_b']
        print(f"模型已从 {os.path.abspath(model_path)} 加载")


def plot_fitting_line(X, Y, model):
    """
    绘制数据散点图和拟合直线
    :param X: 特征向量(M×1),此处仅支持单特征(方便绘图)
    :param Y: 标签向量(M×1)
    :param model: 训练好的Linear模型
    """
    # 设置中文显示(避免中文标签乱码)
    plt.rcParams['font.sans-serif'] = ['SimHei']  # Windows系统
    # plt.rcParams['font.sans-serif'] = ['Arial Unicode MS']  # Mac系统
    plt.rcParams['axes.unicode_minus'] = False  # 正常显示负号

    # 生成拟合直线的x轴数据(覆盖原始数据的x范围,使直线更完整)
    x_min = X.min() - 5
    x_max = X.max() + 5
    x_line = np.linspace(x_min, x_max, 100).reshape(-1, 1)  # 100个点,确保直线平滑
    y_line = model.predict(x_line)  # 计算拟合直线的y值

    # 绘制散点图(原始数据)
    plt.scatter(X, Y, color='orange', s=50, alpha=0.7, label='原始数据')
    # 绘制拟合直线
    plt.plot(x_line, y_line, color='blue', linewidth=2,
             label=f'拟合直线:y = {model.theta[0, 0]:.4f}x + {model.theta0:.4f}')

    # 设置图表标签和标题
    plt.xlabel('特征X(如广告投入)', fontsize=12)
    plt.ylabel('标签Y(如销售额)', fontsize=12)
    plt.title('线性回归拟合结果', fontsize=14)
    plt.legend(fontsize=10)  # 显示图例
    plt.grid(True, alpha=0.3)  # 显示网格
    plt.show()  # 显示图像


if __name__ == '__main__':
    # 1. 准备数据(单特征示例)
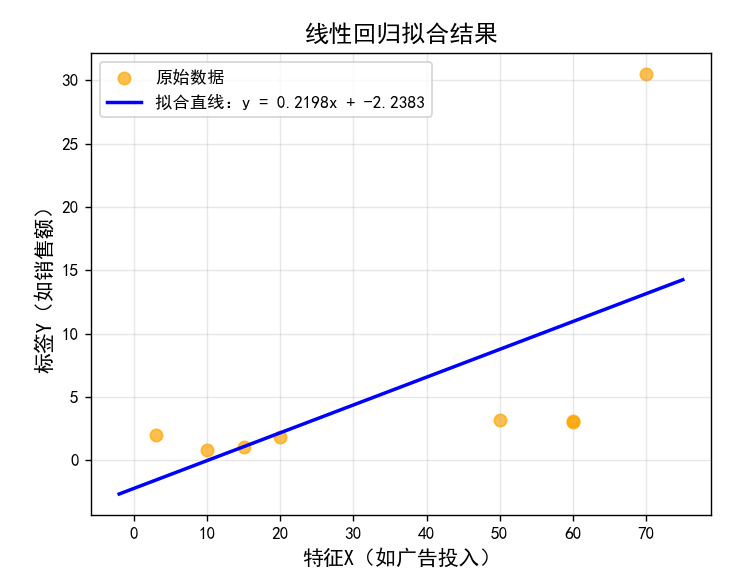
    X1 = np.array([10, 15, 20, 3, 50, 60, 60, 70]).reshape((-1, 1))  # 8个样本,1个特征
    Y = np.array([0.8, 1.0, 1.8, 2.0, 3.2, 3.0, 3.1, 30.5]).reshape((-1, 1))  # 标签(注意:30.5是异常值)

    # 2. 初始化并训练模型
    linear = Linear(use_b=True)  # 使用截距项
    linear.train(X1, Y)

    # 3. 预测示例
    x_test = [[55]]  # 测试样本:特征值=55
    y_test_hat = linear.predict(x_test)
    print(f"测试样本x={x_test[0][0]}的预测值:{y_test_hat[0, 0]:.4f}")
    print(f"模型权重theta:{linear.theta[0, 0]:.4f}")
    print(f"模型截距theta0:{linear.theta0:.4f}")

    # 4. 模型评估
    mse = linear.score(X1, Y, metric='mse')
    r2 = linear.score(X1, Y, metric='r2')
    mae = linear.score(X1, Y, metric='mae')
    print(f"\n模型评估:")
    print(f"均方误差(MSE):{mse:.4f}")
    print(f"决定系数(R²):{r2:.4f}")  # 因存在异常值30.5,R²可能偏低
    print(f"平均绝对误差(MAE):{mae:.4f}")

    # 5. 保存和加载模型(可选)
    linear.save('my_linear_model.npz')
    linear2 = Linear()
    linear2.load('my_linear_model.npz')
    print(f"\n加载后的模型预测x=55:{linear2.predict([[55]])[0, 0]:.4f}")  # 验证加载是否成功

    # 6. 绘制散点图和拟合直线
    plot_fitting_line(X1, Y, linear)
运行结果:
测试样本x=55的预测值:9.8515
模型权重theta:0.2198
模型截距theta0:-2.2383
模型评估:
均方误差(MSE):58.7982
决定系数(R²):0.3378
平均绝对误差(MAE):5.4426
模型已保存到:my_linear_model.npz
模型已从my_linear_model.npz 加载
加载后的模型预测x=55:9.8515
三、线性回归问题的一般解法:梯度下降法
1.1 梯度下降简要说明
解析解法只有在样本少特征少才能用,特征大,矩阵解法运行量非常大,并不是线性回归的一般解法,梯度下降法才是一般解法。
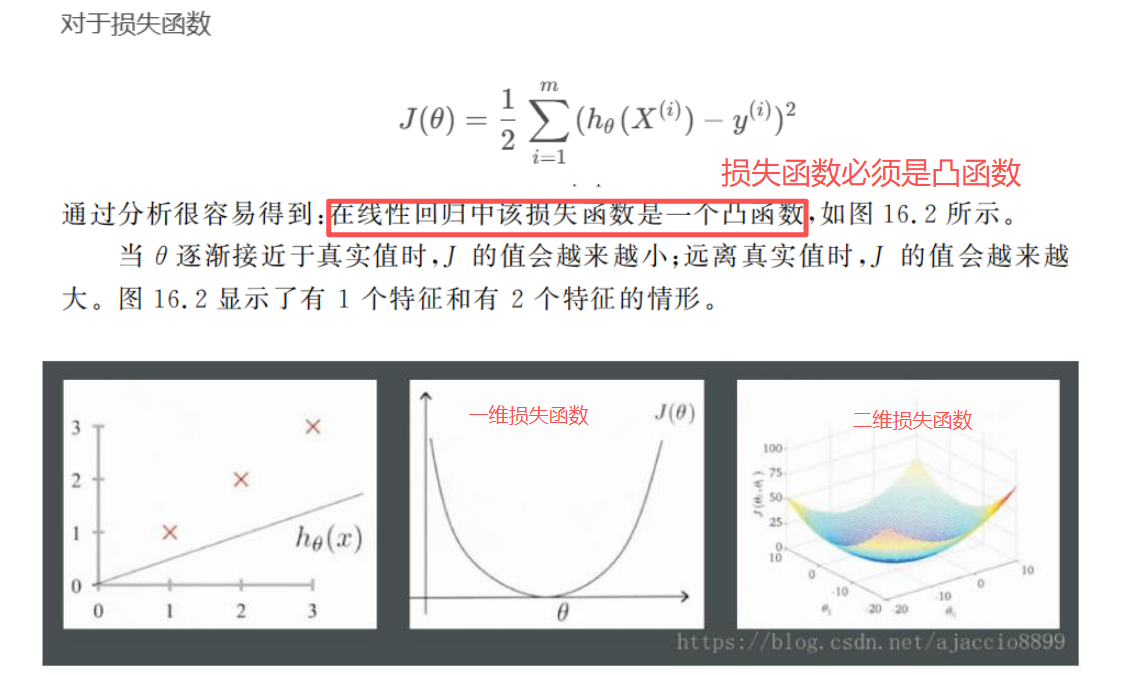
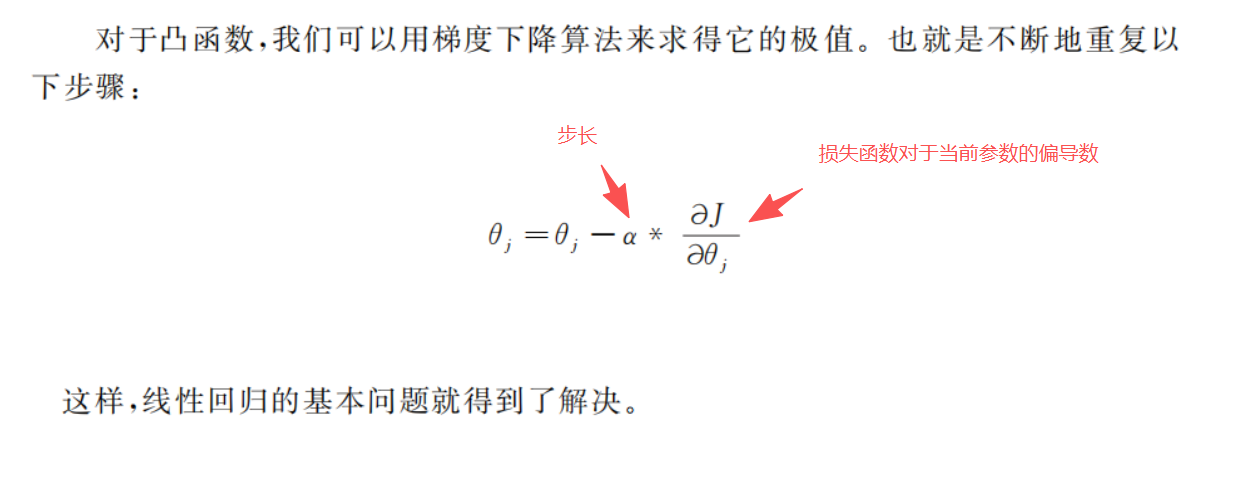
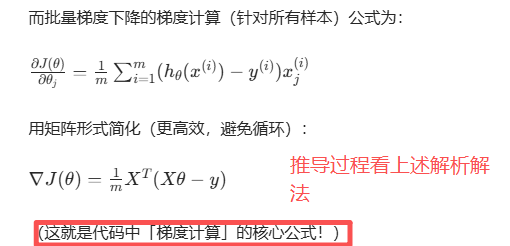
注意:代码中梯度的使用公式
2.2 梯度下降算法的代码实现
import sys
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings("ignore")

# 设置中文字体支持
plt.rcParams['font.sans-serif'] = ['SimHei']  # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False  # 用来正常显示负号


def main():
    """
    主函数:实现线性回归的梯度下降优化
    """
    # 1. 数据准备
    # 原始温度数据
    X0 = np.array([25, 28, 31, 35, 38, 40])
    # 添加偏置项(截距项),构造设计矩阵X
    X = np.column_stack((np.ones((X0.shape[0], 1)), X0))

    # 目标变量(销售额)
    y = np.array([[106], [145], [167], [208], [233], [258]])

    print("数据信息:")
    print(f"温度数据: {X0}") # [25 28 31 35 38 40]
    print(f"销售额数据: {y.ravel()}") # [106 145 167 208 233 258]
    print(f"设计矩阵X的形状: {X.shape}") # (6, 2)
    print(f"目标变量y的形状: {y.shape}") #  (6, 1)

    # 2. 初始化参数
    theta = np.zeros((2, 1))  # [theta0, theta1]^T 2行1列的二维数组(shape=(2,1))
    print(f"\n初始参数theta: {theta.ravel()}") # ravel() 扁平化 方便查看[0. 0.]

    # 3. 计算初始损失
    initial_cost = cost_function(X, y, theta)
    print(f"初始损失值: {initial_cost:.4f}")

    # 4. 执行批量梯度下降
    print("\n开始批量梯度下降...")
    theta_bgd, costs_bgd = gradient_descent_bgd(
        X, y,
        theta=theta.copy(),  # 使用副本避免修改原theta
        alpha=0.001,  # 学习率
        iters=500000  # 迭代次数
    )

    # 5. 输出结果
    print("\n=== 训练结果 ===")
    print(f"最优参数theta: {theta_bgd.ravel()}")
    print(f"最终损失值: {cost_function(X, y, theta_bgd):.4f}")
    print(f"回归方程: y = {theta_bgd[0, 0]:.2f} + {theta_bgd[1, 0]:.2f} * x")

    # 6. 可视化结果
    visualize_results(X, y, theta_bgd, costs_bgd)


def cost_function(X, y, theta):
    """
    计算线性回归的均方误差损失函数

    参数:
        X: 设计矩阵 (m x n)
        y: 目标变量 (m x 1)
        theta: 参数向量 (n x 1)

    返回:
        J: 均方误差损失值
    """
    m = y.size  # 样本数量
    y_pred = X.dot(theta)  # 预测值 矩阵点积(必须满足「X 的列数 = theta 的行数」
    J = 1.0 / (2 * m) * np.square(y_pred - y).sum()
    # 均方误差 1.0 / (2*m) 用 1.0 而非 1是为了保证结果是浮点数 1/m求平均平方误差(避免样本数量 m 影响损失值大小)
    return J

def gradient_descent_bgd(X, y, theta, alpha=0.01, iters=1500):
    """
    批量梯度下降算法 (Batch Gradient Descent)

    参数:
        X: 设计矩阵
        y: 目标变量
        theta: 初始参数
        alpha: 学习率
        iters: 迭代次数

    返回:
        theta: 优化后的参数
        costs: 每次迭代的损失值列表
    """
    m = y.size  # 样本数量
    costs = []  # 记录损失值 空列表,用于存储迭代过程中的损失值(后续可画图看收敛趋势)
    print(f"梯度下降配置: 学习率={alpha}, 迭代次数={iters}")
    for i in range(iters):
        y_pred = X.dot(theta) # 计算预测值
        gradient = (1.0 / m) * (X.T.dot(y_pred - y)) # 计算梯度(1/m)* X.T(Xθ−y) 矩阵形式简化(更高效,避免循环)
        theta -= alpha * gradient # 更新参数 等价于 theta = theta - alpha * gradient
        # 记录损失值(每1000次迭代记录一次,避免列表过大)
        if i % 1000 == 0:
            current_cost = cost_function(X, y, theta)
            costs.append(current_cost)
            # 每10000次迭代打印进度
            if i % 10000 == 0:
                print(f"迭代次数 {i:6d}, 当前损失: {current_cost:.4f}")
    return theta, costs


def normal_equation(X, y):
    """
    使用正规方程求解线性回归参数

    参数:
        X: 设计矩阵
        y: 目标变量

    返回:
        theta: 最优参数
    """
    X_mat = np.asmatrix(X) # 转换为 NumPy 的矩阵
    Y_mat = np.asmatrix(y)
    # 正规方程: theta = (X^T * X)^(-1) * X^T * y
    theta = (X_mat.T * X_mat).I * X_mat.T * Y_mat
    return theta.A


def visualize_results(X, y, theta, costs):
    """
    可视化训练结果:损失曲线和回归直线

    参数:
        X: 设计矩阵
        y: 目标变量
        theta: 训练得到的参数
        costs: 损失值列表
    """
    fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5)) # 创建子图:1行2列,总尺寸12x5英寸(宽x高)
    # 1. 绘制损失曲线:蓝色实线,线宽2
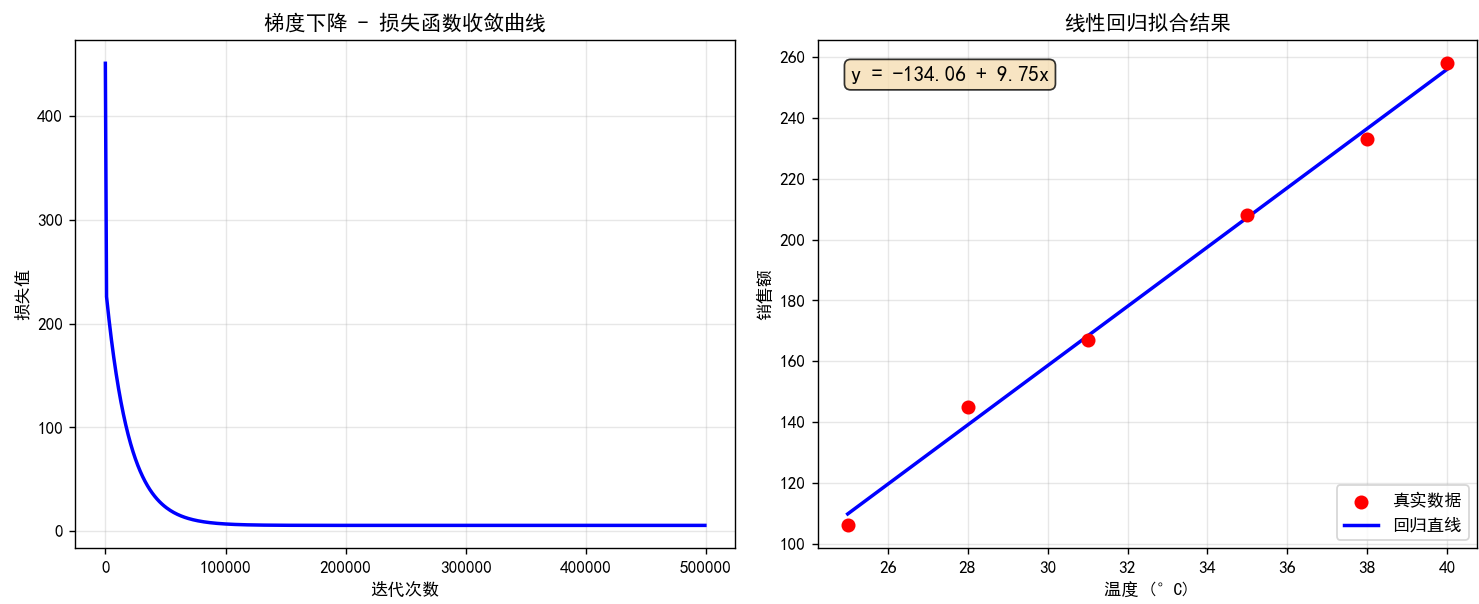
    ax1.plot(range(0, len(costs) * 1000, 1000), costs, 'b-', linewidth=2)
    ax1.set_xlabel('迭代次数')
    ax1.set_ylabel('损失值')
    ax1.set_title('梯度下降 - 损失函数收敛曲线')
    ax1.grid(True, alpha=0.3) # 添加网格(透明度0.3,不遮挡曲线)

    # 2. 绘制数据点和回归直线
    x1 = X[:, 1]  # 温度数据:取设计矩阵X的第2列(索引1),因为第0列是全1的常数项
    y_pred = X.dot(theta)  # 所有样本的预测值:设计矩阵X × 参数theta(矩阵点积)
    # 散点图:真实数据点
    ax2.scatter(x1.ravel(), y.ravel(), color='red', s=50, label='真实数据', zorder=5)
    # 直线:回归结果
    ax2.plot(x1.ravel(), y_pred.ravel(), 'b-', linewidth=2, label='回归直线')
    ax2.set_xlabel('温度 (°C)')
    ax2.set_ylabel('销售额')
    ax2.set_title('线性回归拟合结果')
    ax2.legend()
    ax2.grid(True, alpha=0.3)

    # 在图上标注回归方程
    equation_text = f'y = {theta[0, 0]:.2f} + {theta[1, 0]:.2f}x'
    ax2.text(0.05, 0.95, equation_text, transform=ax2.transAxes,
             fontsize=12, verticalalignment='top',
             bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.8))

    plt.tight_layout()
    plt.show()

    # 3. 预测新数据
    print("\n=== 预测示例 ===")
    test_temperatures = [30, 36, 42]
    for temp in test_temperatures:
        prediction = theta[0, 0] + theta[1, 0] * temp
        print(f"温度 {temp}°C 时,预测销售额: {prediction:.2f}")


def compare_methods(X, y):
    """
    比较不同求解方法的结果
    """
    print("\n" + "=" * 50)
    print("方法比较: 梯度下降 vs 正规方程")
    print("=" * 50)
    # 梯度下降结果
    theta_gd, _ = gradient_descent_bgd(X, y, theta=np.zeros((2, 1)),alpha=0.001, iters=500000)
    # 正规方程结果
    theta_ne = normal_equation(X, y)

    print(f"\n梯度下降结果: theta = [{theta_gd[0, 0]:.6f}, {theta_gd[1, 0]:.6f}]")
    print(f"正规方程结果: theta = [{theta_ne[0, 0]:.6f}, {theta_ne[1, 0]:.6f}]")
    print(f"参数差异: [{theta_gd[0, 0] - theta_ne[0, 0]:.6f}, {theta_gd[1, 0] - theta_ne[1, 0]:.6f}]")

    cost_gd = cost_function(X, y, theta_gd)
    cost_ne = cost_function(X, y, theta_ne)
    print(f"梯度下降损失: {cost_gd:.6f}")
    print(f"正规方程损失: {cost_ne:.6f}")


if __name__ == '__main__':
    # 执行主程序
    main()

    # 重新加载数据进行比较
    X0 = np.array([25, 28, 31, 35, 38, 40])
    X = np.column_stack((np.ones((X0.shape[0], 1)), X0))
    y = np.array([[106], [145], [167], [208], [233], [258]])

    # 比较不同方法
    compare_methods(X, y)
运行结果:
3.3 机器学习库LinearRegression代码实现波士顿房价预测
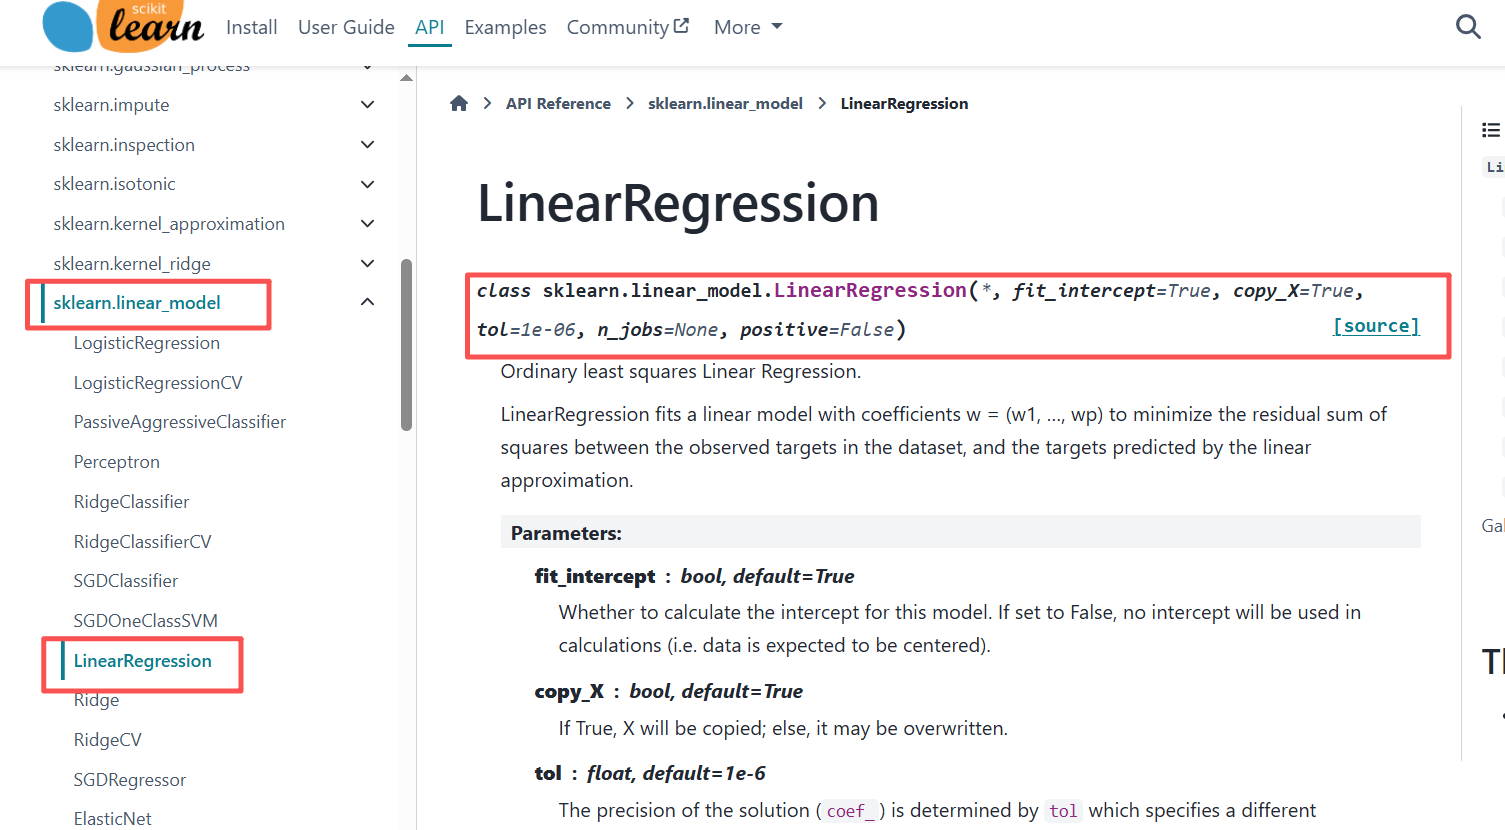
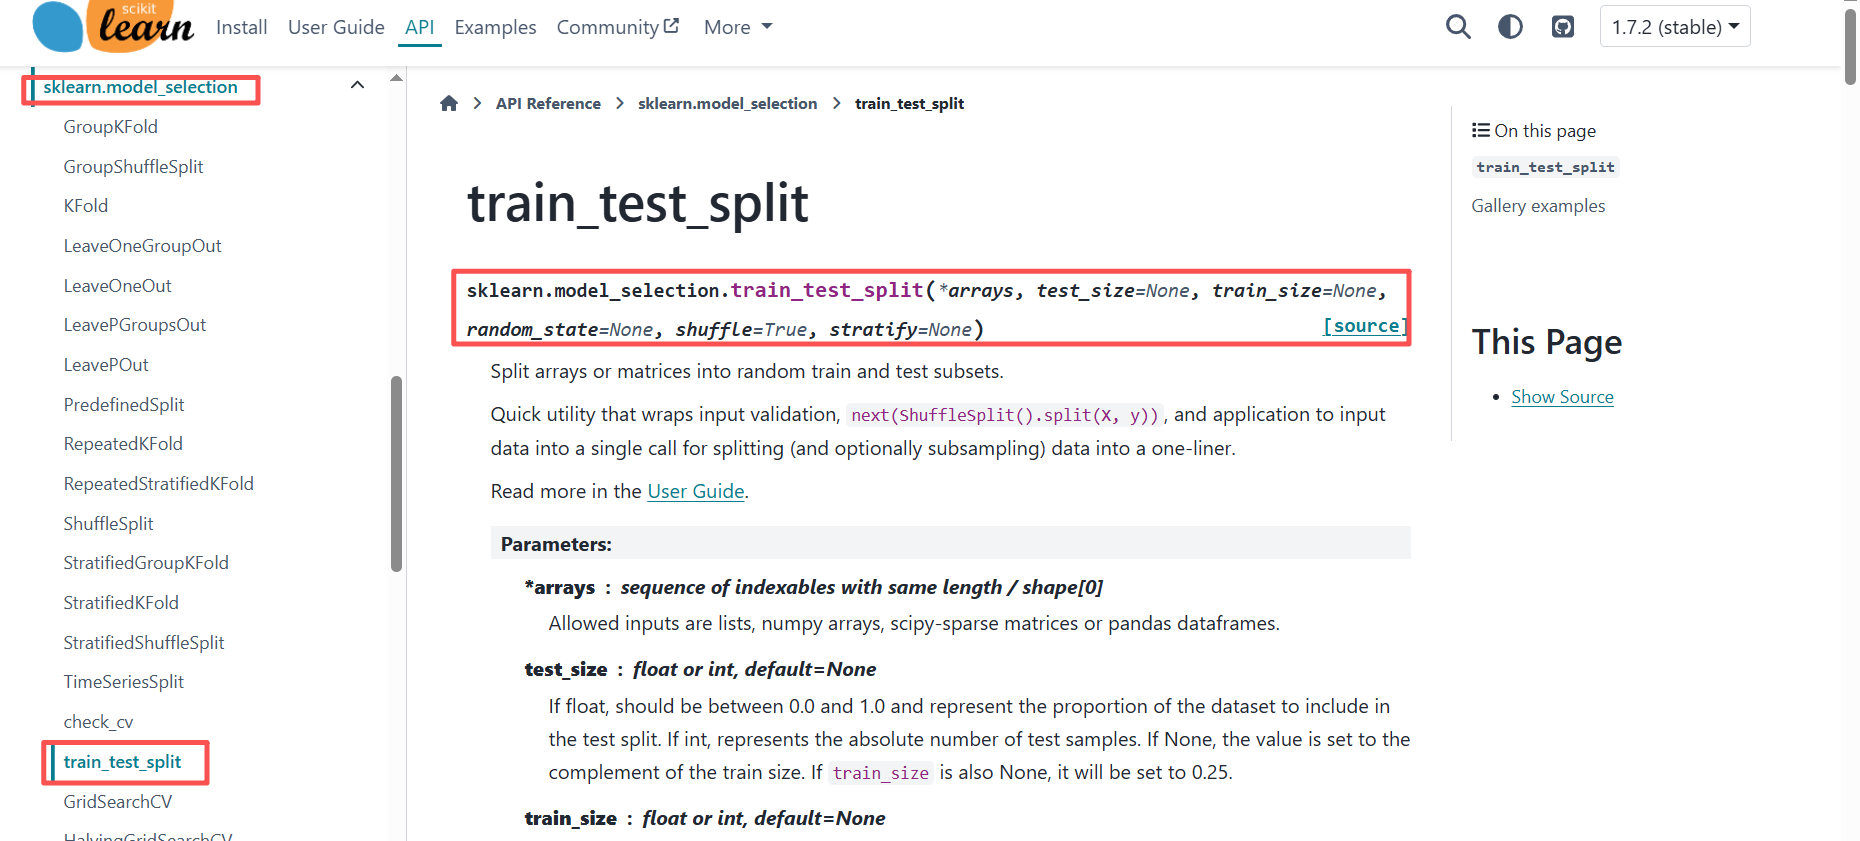
3.3.1 机器学习库API资料查看
查看网址:https://scikit-learn.org/stable/modules/classes.html
3.3.2 波士顿数据集
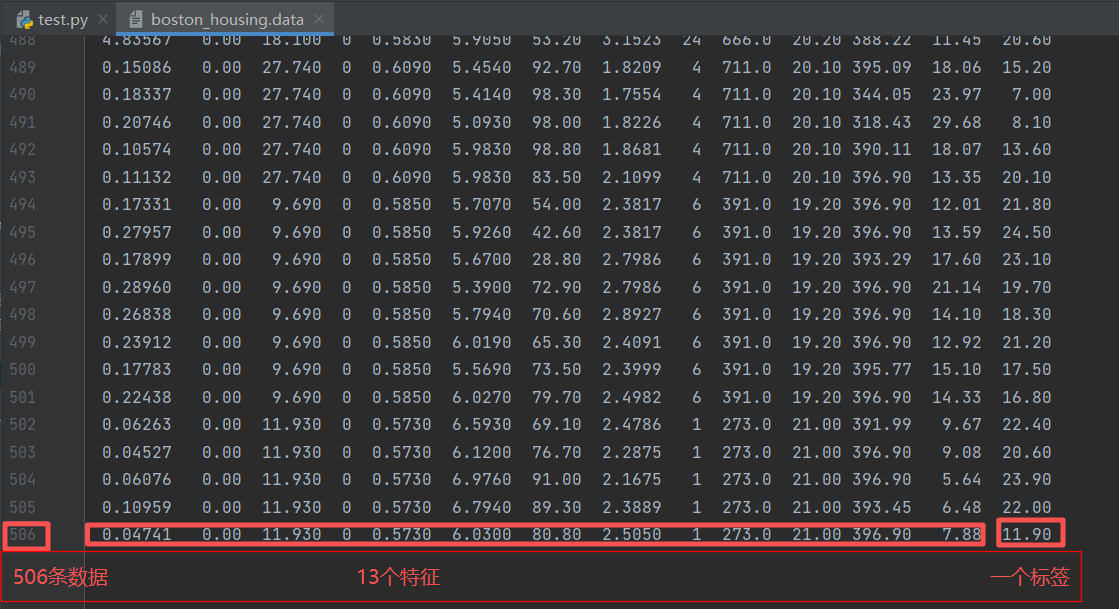
可从绑定资源下载数据集(代码较长,占用篇幅)
3.3.3 代码实现
可从绑定资源下载代码:波士顿房价预测.py
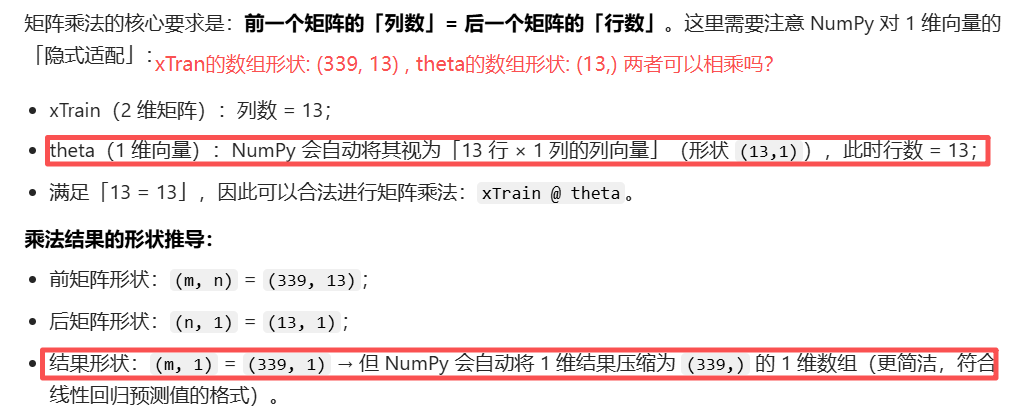
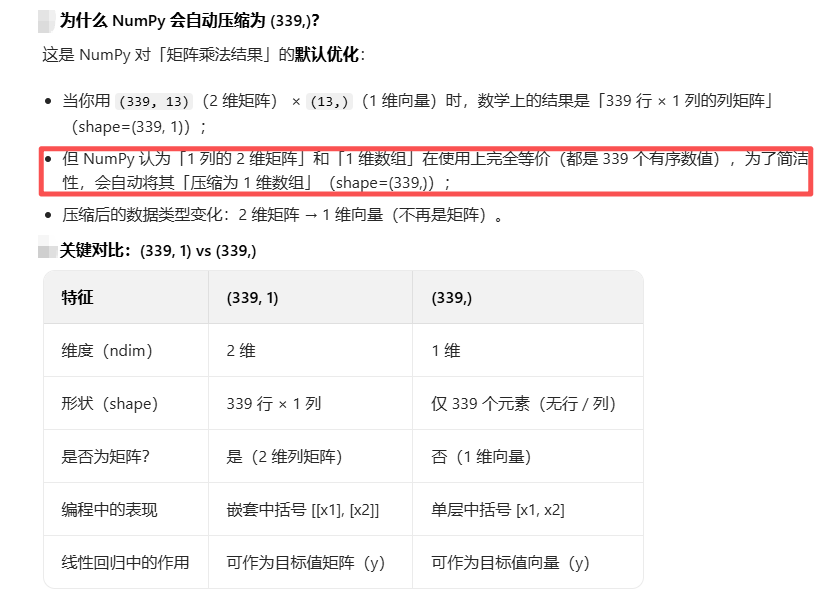
1、理解Numpy自动把1列的二维矩阵压缩成一维数组(一维向量)
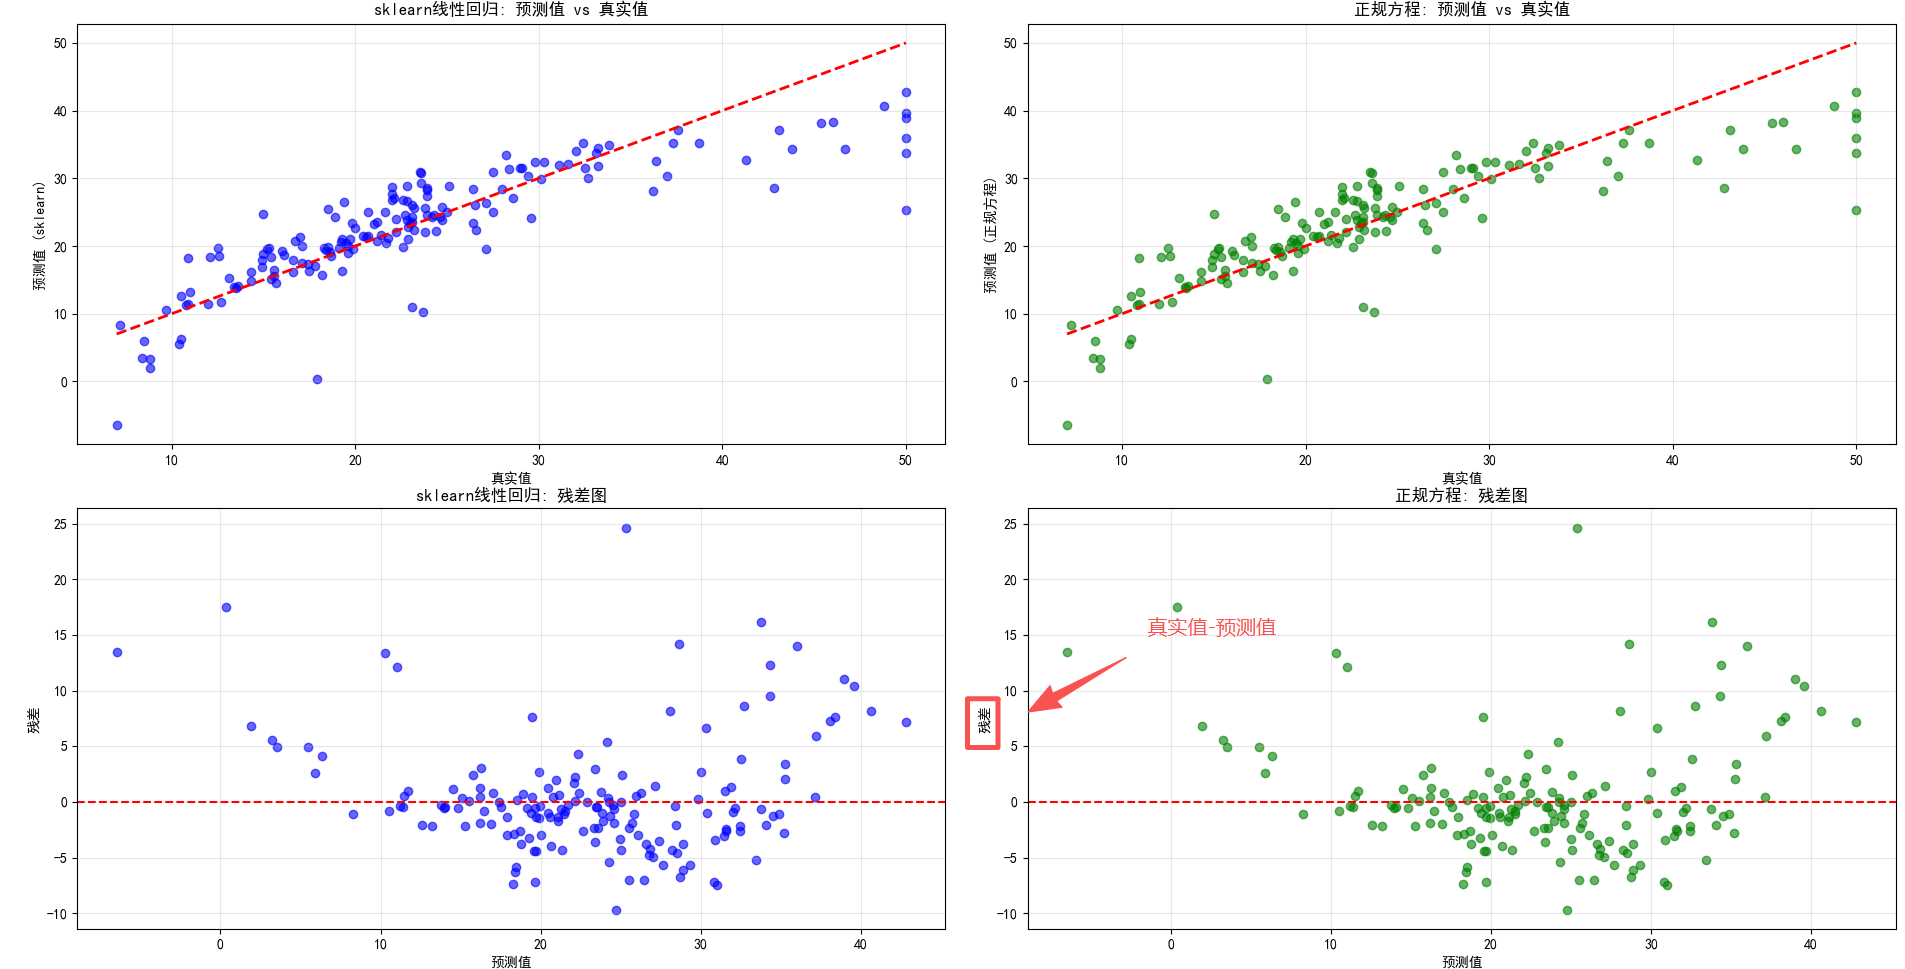
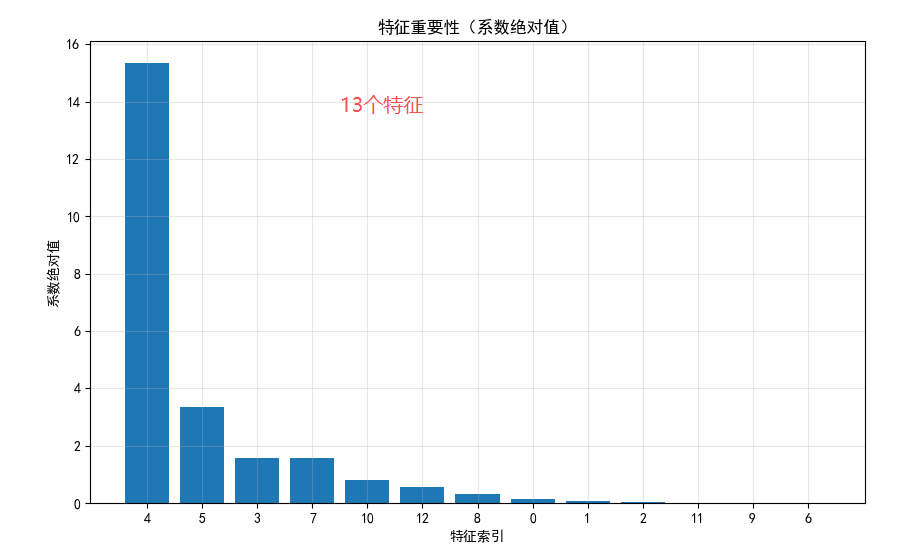
2、代码运行结果
四、线性回归问题的多项式扩展
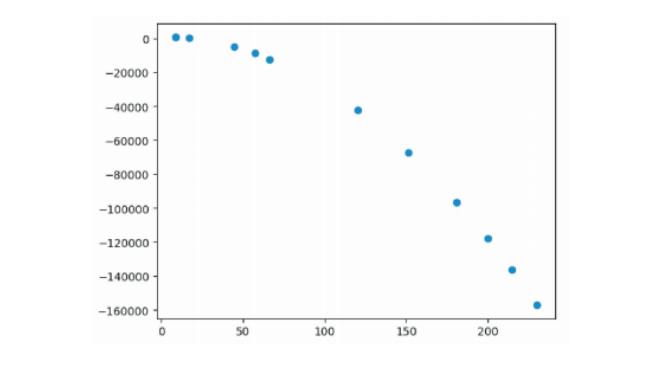
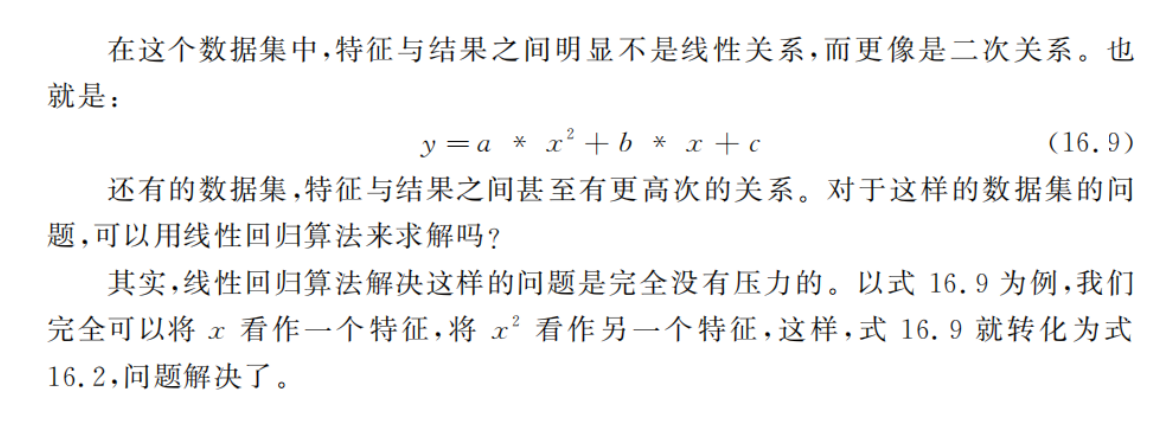
1、如果出现以下图形,一条直线是无法拟合的,所以引入了x的二次方或者更高次方来拟合样本
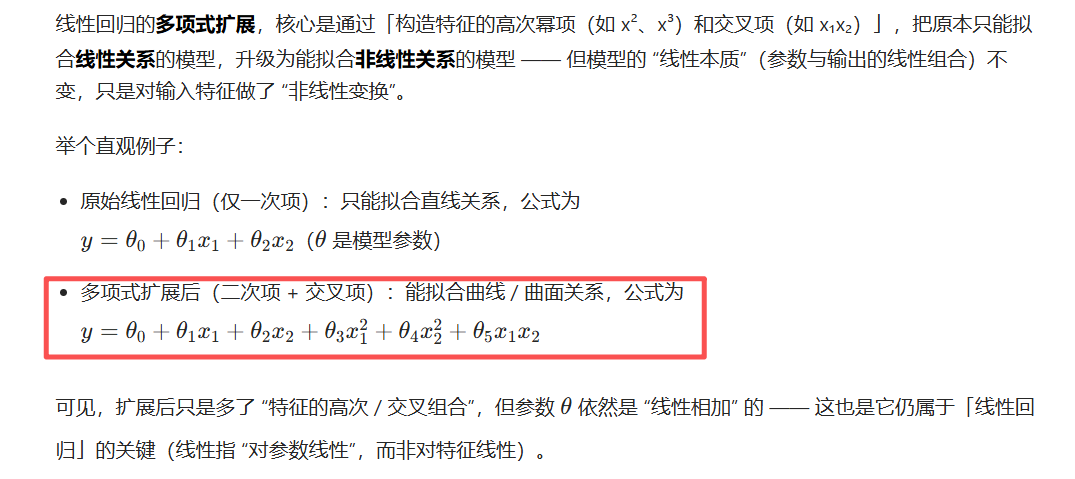
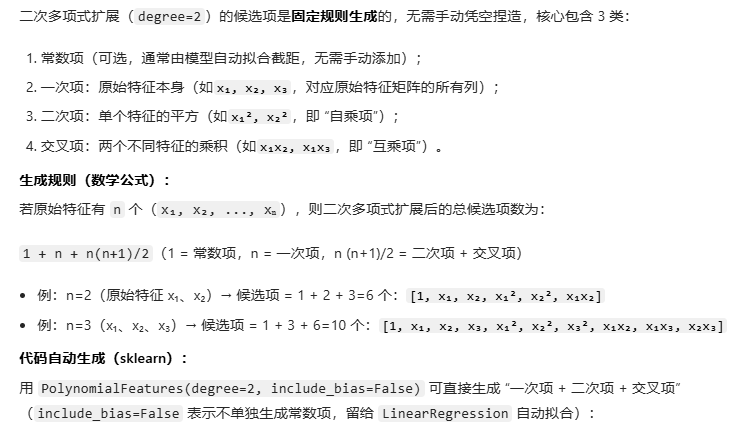
2、多项式扩展的方式
五、过拟合和欠拟合问题
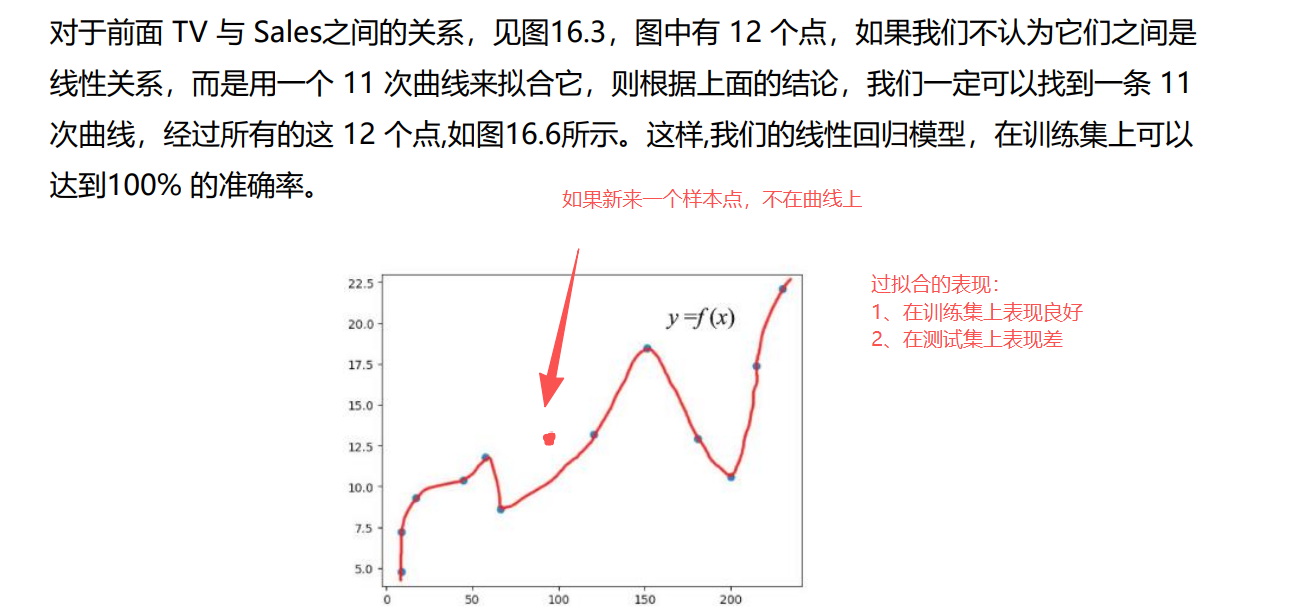
1.1 过拟合
2.2 欠拟合
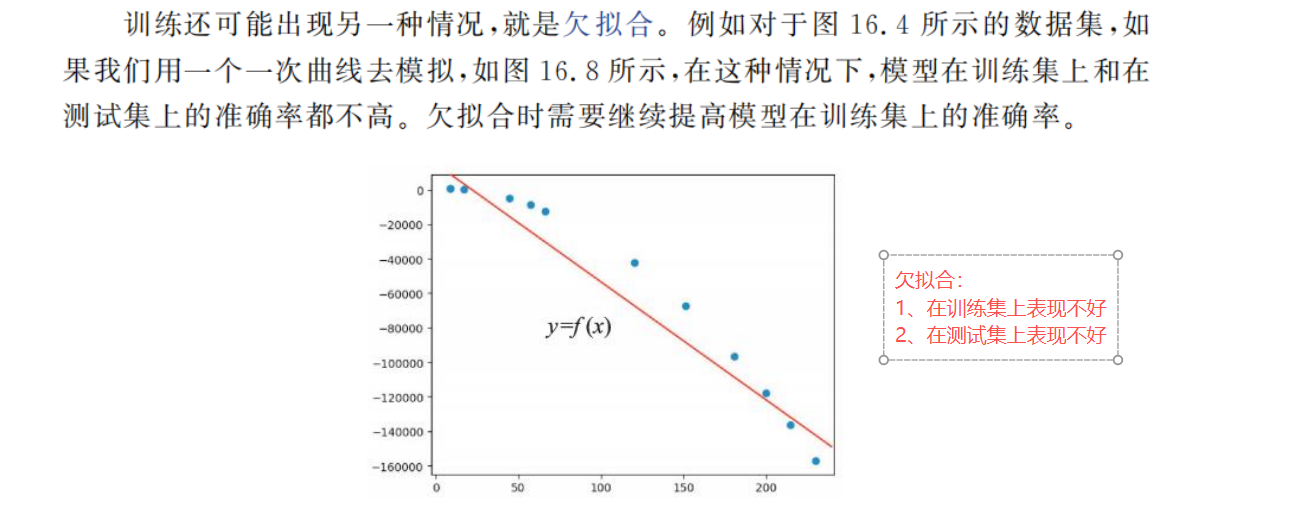
3.3 线性回归过拟合的解决办法
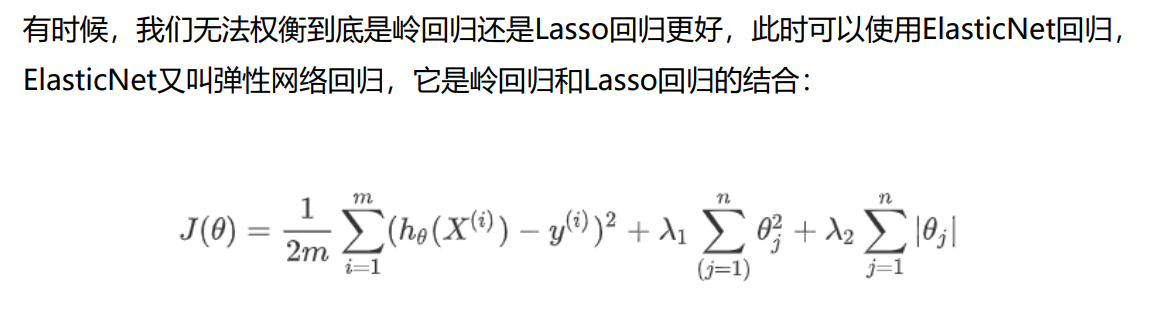
增加一个正则化项:
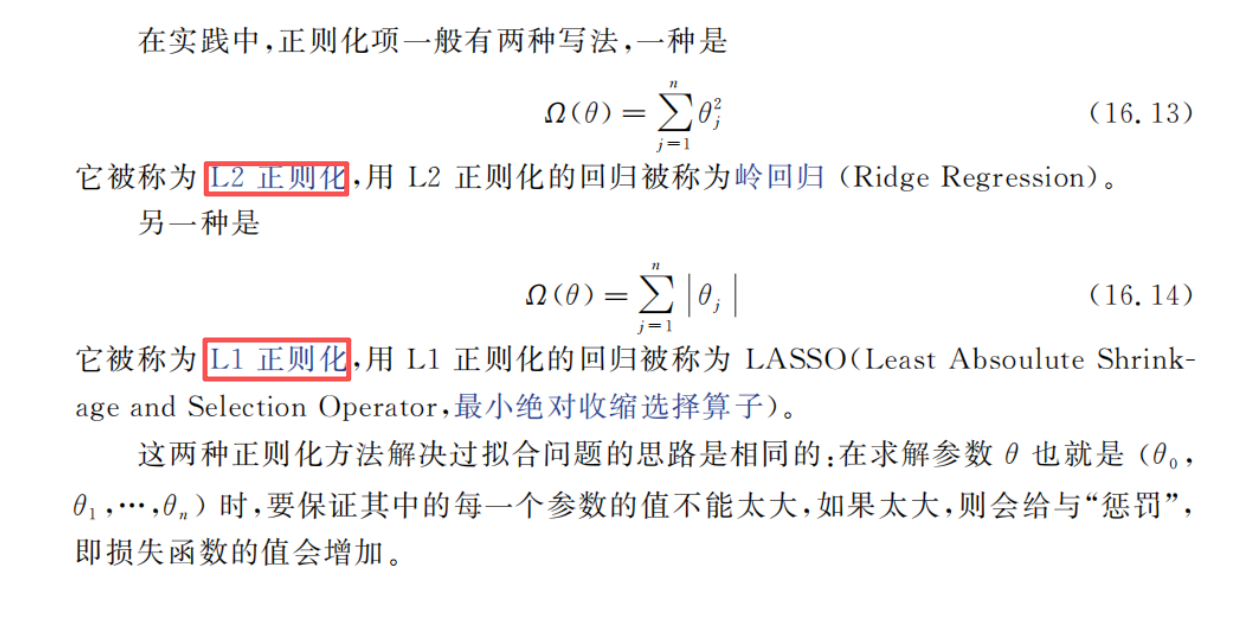
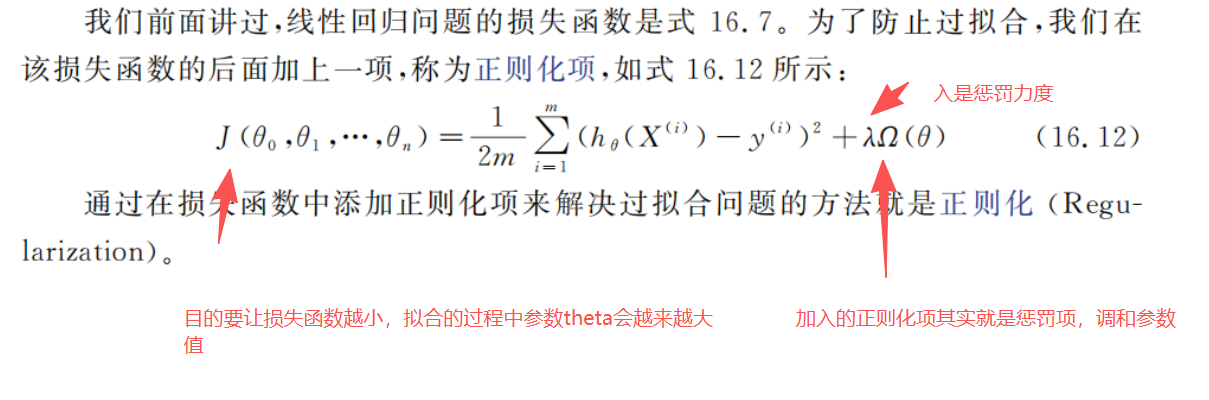
线性回归问题中,如果没有做多项式扩展,就不需要引入正则项
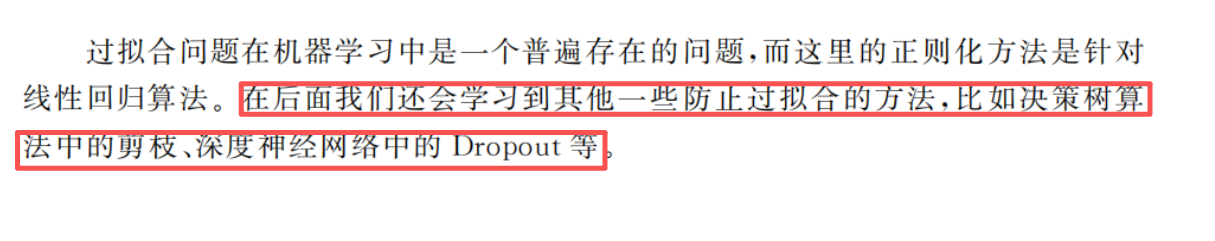
线性回归算法出现的问题在很多其他算法中也会出现,学会举一反三。
4.4 线性回归欠拟合的解决办法
线性回归做多项式扩展,增加其拟合程度
六、超参数和交叉验证
1.1 什么是超参数
- 超参数是机器学习算法中需要在训练开始前手动设置的参数,而非通过训练过程自动学习得到的参数。
- 具体来说:
- 它是算法的 “配置项”,比如文中提到的步长 α(常见于梯度下降等优化算法,控制参数更新的幅度)、正则化项参数λ(用于平衡模型拟合与复杂度,避免过拟合)都属于超参数。
- 超参数的设置非常关键,直接影响模型的性能(如准确率、泛化能力)。通常需要通过交叉验证等方法对超参数进行优化,从而选择最佳取值。
2.2 超参数的确定方法-交叉验证
交叉验证(Cross-Validation, CV)是评估机器学习模型泛化能力的核心方法,核心思想是将数据集拆分为「训练集」和「验证集」,通过多次重复训练与验证,减少单次拆分的随机性对模型评估的影响,得到更可靠的性能指标(如准确率、MSE 等)。
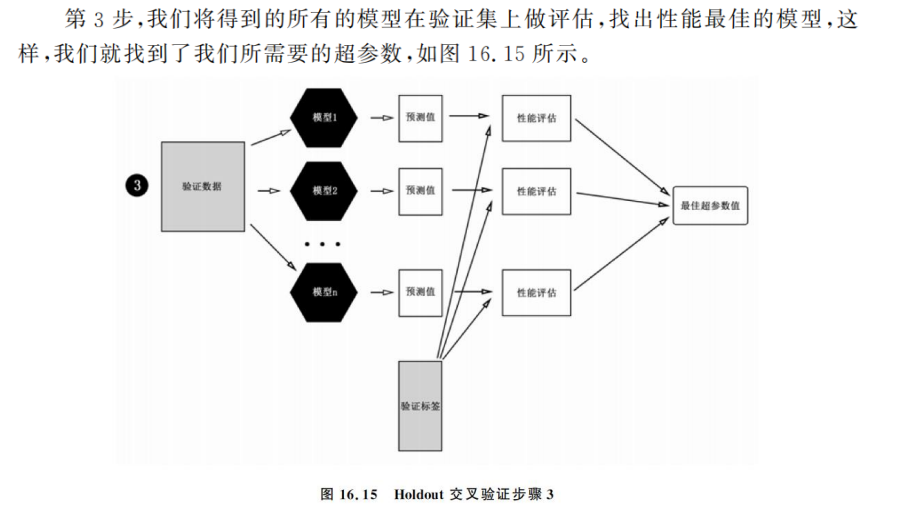
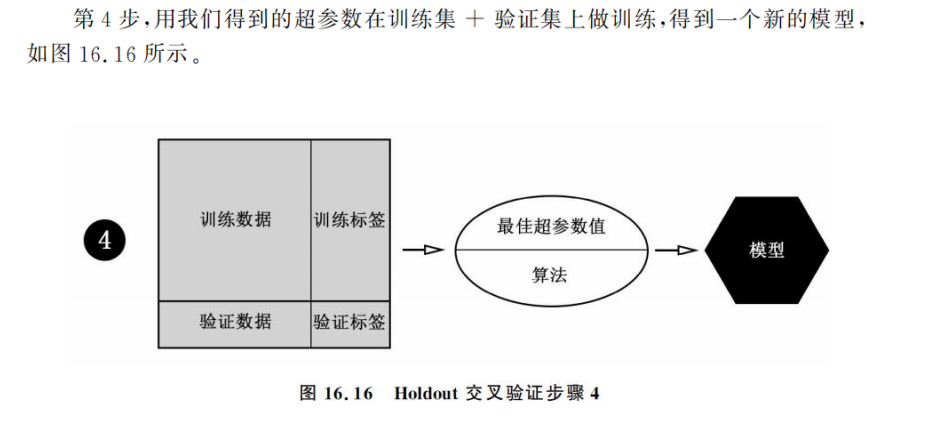
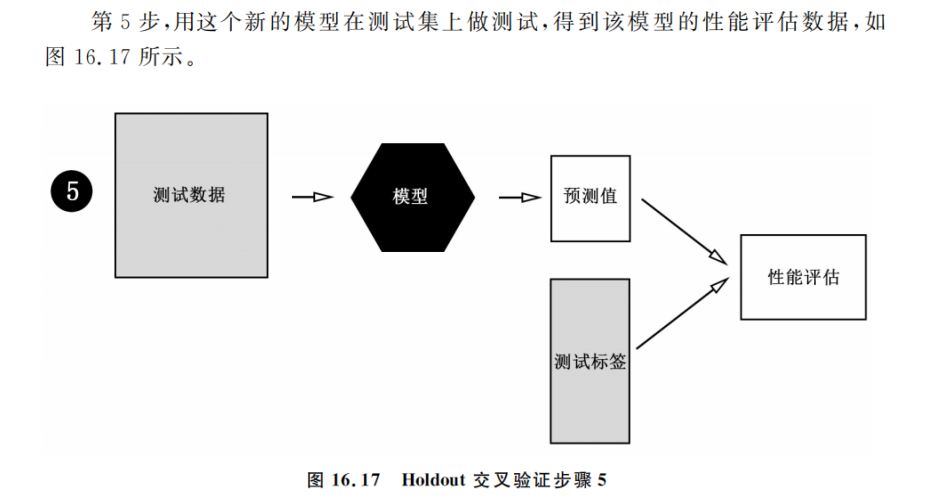
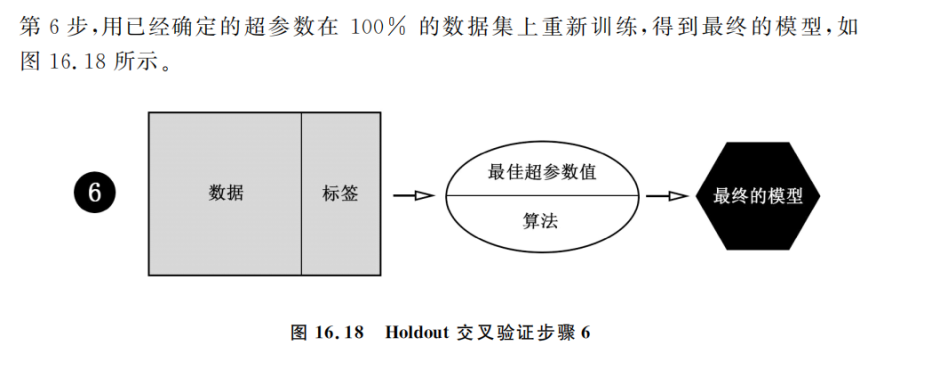
- Holdout交叉验证
- 严格意义上说,Holdout 验证并非一种交叉验证,因为数据并没有交叉使用。Holdout方法的好处是处理简单只需随机把原始数据分为两组即可,适用于样本数量较多的情况。
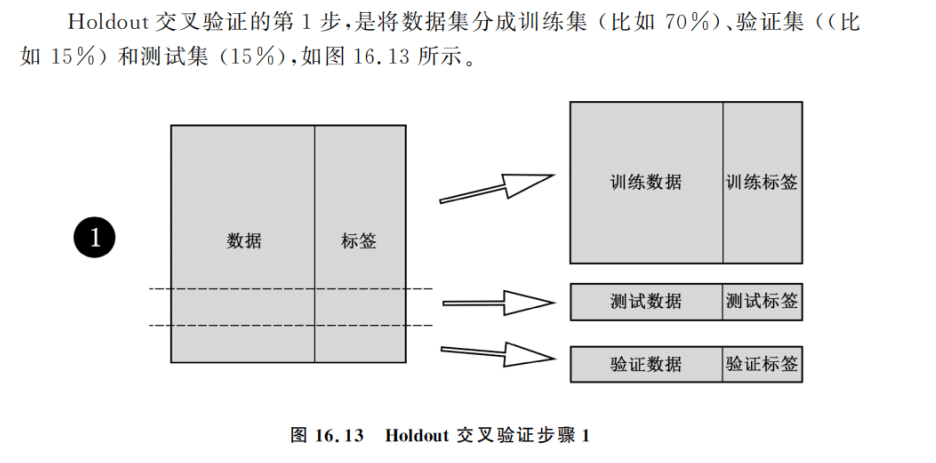
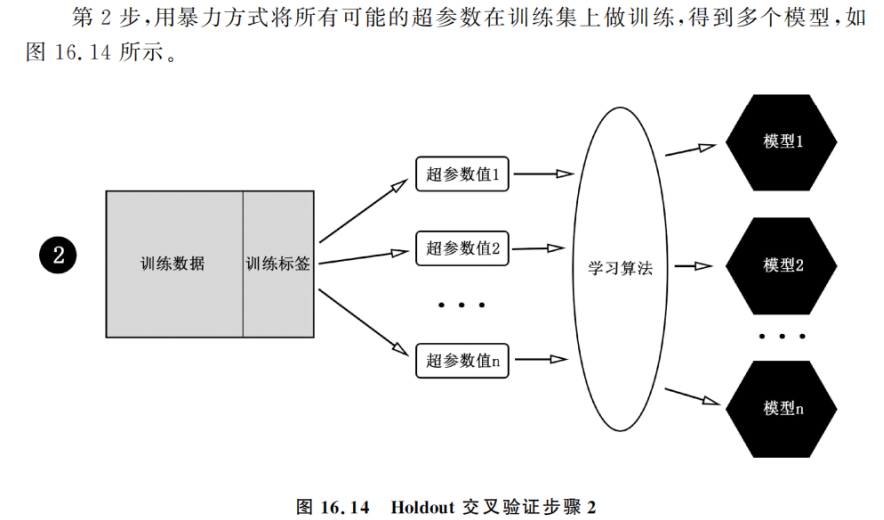
- 严格意义上说,Holdout 验证并非一种交叉验证,因为数据并没有交叉使用。Holdout方法的好处是处理简单只需随机把原始数据分为两组即可,适用于样本数量较多的情况。
-
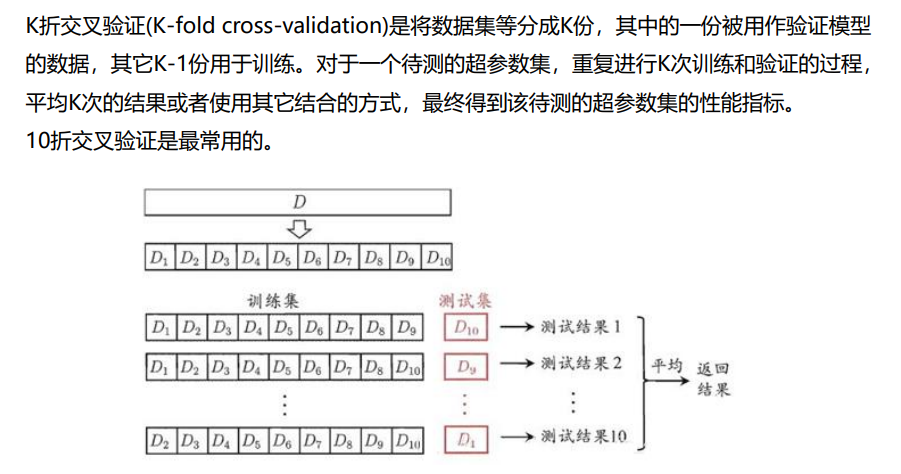
K 折交叉验证
-
留一验证
- 留一验证(LOOCV)相当于K折交叉验证中的K的值等于样本的数量,这样,每次训练都使用K-1个样本,而用剩下的那1个样本进行验证。这样的过程一直持续直至每一个样本都被作为验证样本。留一验证通常用于样本量非常少的情况。
七、带多项式扩展、交叉验证、正则化项的波士顿房价预测代码理解
1、相关API查看
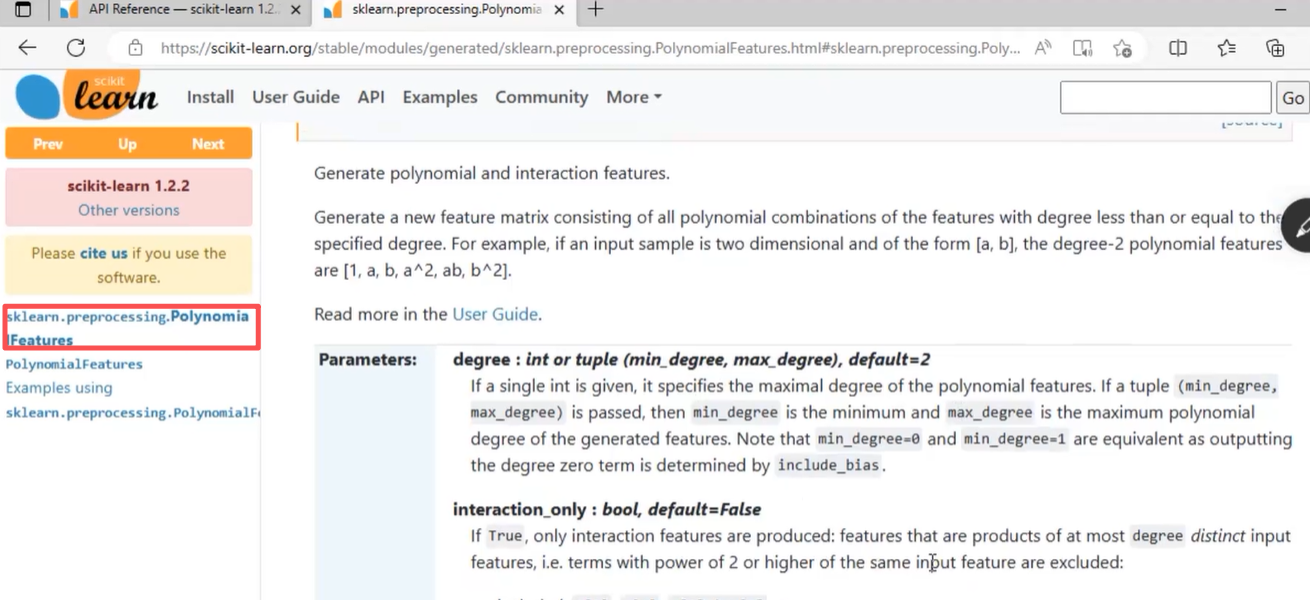
2、理解PolynomialFeatures类中成员interaction_only=True和LinearRegression类中成员fit_intercept=True(默认就是True)的意思及配合使用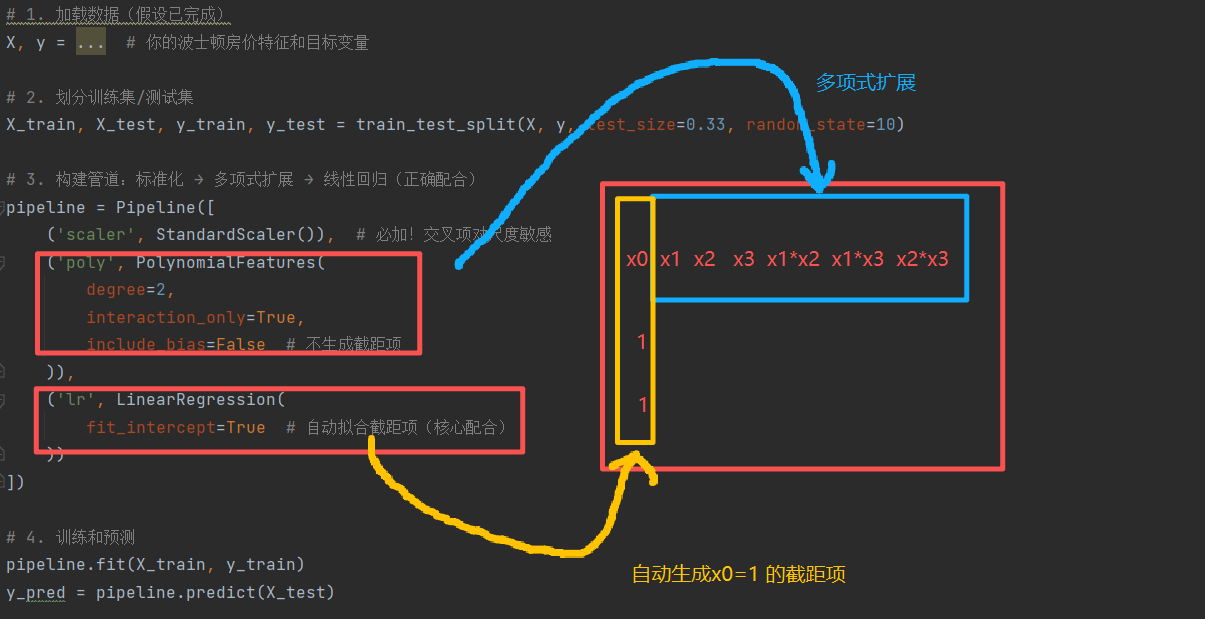
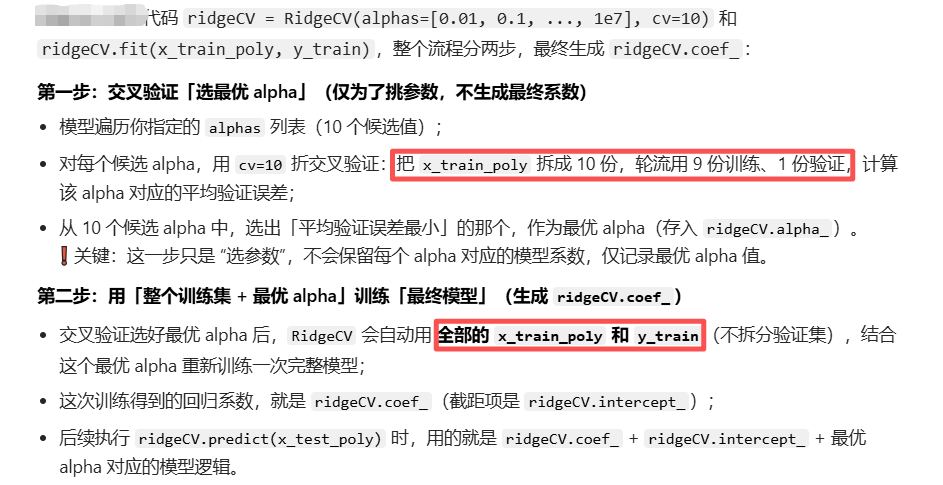
3、理解K 折交叉验证确定超参数alpha(正则化项的参数 λ)的过程
- 公式简化理解:系数 = (X^T X + αI)^(-1) X^T y(其中 α 是正则化参数,I 是单位矩阵),这个公式能直接算出最优系数,不需要 “逐步迭代”,自然也就不需要 “步长” 来控制迭代幅度
- 小 alpha 区间(0.01~1):正则化弱,系数变化敏感,步长可以小一点(比如 0.01→0.05→0.1);
- 大 alpha 区间(100~1e7):正则化强,系数变化平缓,步长可以大一点(比如 100→1000→1e4)
- 发现最优 alpha 落在某个小范围(比如 10→100 之间),再缩小步长补充候选值
- alphas = [10,20,30,40,50,60,70,80,90,100]
ridgeCV = RidgeCV(alphas=alphas, cv=10)
- alphas = [10,20,30,40,50,60,70,80,90,100]
4、API线性回归模型都是直接算出最优解,没有用到梯度下降法所有基于「最小二乘法闭式解」的线性回归模型(LinearRegression、Ridge、Lasso、ElasticNet 及其 CV 版本),都不需要设定步长;只有用「迭代优化算法」实现的模型(如 SGDRegressor、神经网络、XGBoost/LightGBM 等),才需要手动调整步长(或学习率)
- 最小二乘法闭式解是「特殊解法」(低维、无多重共线性),无迭代、无步长,速度快
- 高维数据:特征数 n 很大(如 n>1000);大数据:样本数 m 很大(如 m>1e6),闭式解的矩阵运算会占满内存。需要用 SGDRegressor 实现线性回归,手动设步长
5、代码
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression, Lasso, LassoCV, Ridge, RidgeCV, ElasticNet
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import PolynomialFeatures
import matplotlib.pyplot as plt
import matplotlib as mpt
import sys
import joblib

import warnings

warnings.filterwarnings("ignore")

# 1、加载数据
data = pd.read_csv('./data/boston_housing.data', sep='\s+', header=None)

# 2、获取特征属性X和目标属性Y
X = data.iloc[:, :-1]
Y = data.iloc[:, -1]

# 3、划分训练集和测试集
x_train, x_test, y_train, y_test = train_test_split(X, Y, test_size=0.3, random_state=10) # 随机数种子

# 4、特征工程
'''
PolynomialFeatures 和 LinearRegression 是 sklearn 中完全不同功能的工具,
核心区别可以一句话概括:PolynomialFeatures 是「特征工程工具」(只处理输入特征,不涉及模型训练),
LinearRegression 是「模型训练工具」(只基于特征拟合参数,不改变特征)—— 两者常搭配使用,但职责、原理、作用完全独立

PolynomialFeatures ####多项式扩展
degree=2,扩展的阶数,绝大多数场景下,degree=2 是 “性价比最高” 的选择,degree≥3 需谨慎使用,degree 每增加 1,特征数量会 “爆炸式增长”(组合数计算)
interaction_only=True:一次项(x₁, x₂)+ 二次交叉项(x₁x₂)仅含 “一次项 + 交叉项”,适合拟合特征间的交互效应(如 x₁和 x₂共同影响 y)
include_bias=False:不生成全 1 列(如扩展后特征为 [x₁, x₂, x₁x₂]);建议设为 False——让模型自动学习并拟合线性回归的「截距项」
(也叫常数项,数学上的 θ₀),最终得到的回归公式会包含截距项
'''
# print(type(x_train))
# print(x_train.shape)  # (354, 13)
# print(x_test.shape)   # (152, 13)
# print(x_test.iloc[0, :]) # 测试集第一行的13个特征值
# sys.exit()
poly = PolynomialFeatures(degree=2, interaction_only=True, include_bias=False)  # 多项式扩展

"""
理解这几个函数
fit  # fit决定加几个交叉项特征
fit_transform ==> fit+transform
transform  # 计算具体的交叉项值
"""
# poly.fit(x_train)
# x_train_poly = poly.transform(x_train) # 计算出训练集新的交叉项特征值
x_train_poly = poly.fit_transform(x_train)  # 增加交叉项
x_test_poly = poly.transform(x_test)  # 增加交叉项
# print(type(x_train_poly))
# print(x_train_poly.shape)  # (354, 91) 多项式扩展后特征值从13项目增加到91
# print(x_test_poly.shape)   # (152, 91)
# print(len(x_test_poly[0]))
# joblib.dump(poly,"./poly.m")  # oblib 是 Python 中高效处理大数据 / 模型的序列化工具 后续用 joblib.load("./poly.m") 直接加载
# sys.exit()

# 5、构建模型
# linear = LinearRegression()  # 普通线性回归(OLS)
# lasso =    # L1 正则化线性回归
# lassoCV = LassoCV(alphas=[0.0001, 0.001, 0.01, 0.1, 1, 10, 20, 30, 40], cv=10)  # 带交叉验证的 L1 正则回归
# ridge = Ridge(alpha=100) # L2 正则化线性回归
ridgeCV = RidgeCV(alphas=[0.01, 0.1, 1.0, 10, 100, 1000, 10000, 100000, 1000000, 10000000], cv=10) # 带10则交叉验证的 L2 正则回归

# 6、模型训练
# linear.fit(x_train_poly, y_train)
# lasso.fit(x_train_poly, y_train)
# lassoCV.fit(x_train_poly, y_train)
# ridge.fit(x_train_poly, y_train)
ridgeCV.fit(x_train_poly, y_train)  # 模型训练
print("=" * 50)

# print(linear.coef_)
# print(linear.intercept_)
# print(lasso.coef_)
# print(lasso.intercept_)
# print(lassoCV.alpha_)
# print(ridge.coef_)
# print(ridge.intercept_)
print(ridgeCV.alpha_)  # 通过alpha_属性返回最佳的正则化项的参数 λ
print(ridgeCV.coef_)  # theta参数
print(ridgeCV.intercept_)  # 截距项
# 7、预测测试
# y_test_hat = linear.predict(x_test_poly) # 用x_test_poly 加入交叉项的数据来做预测
# y_test_hat = lasso.predict(x_test_poly)
# y_test_hat = ridge.predict(x_test_poly)
print("-" * 100)
# print(linear.score(x_train_poly, y_train))
# print(linear.score(x_test_poly, y_test))
# print(lasso.score(x_train_poly, y_train))
# print(lasso.score(x_test_poly, y_test))
# print(lassoCV.score(x_train_poly, y_train))
# print(lassoCV.score(x_test_poly, y_test))
# print(ridge.score(x_train_poly, y_train))
# print(ridge.score(x_test_poly, y_test))
print(ridgeCV.score(x_train_poly, y_train))  # 训练集效果
print(ridgeCV.score(x_test_poly, y_test))  # 测试机效果  看是否过拟合
# y_train_hat = linear.predict(x_train_poly)
# y_train_hat = lasso.predict(x_train_poly)
# y_train_hat = ridge.predict(x_train_poly)
y_train_hat = ridgeCV.predict(x_train_poly)
y_test_hat = ridgeCV.predict(x_test_poly)
# 8、图像显示
plt.figure(num="train")  # 一个画布
plt.plot(range(len(x_train)), y_train, 'r', label=u'true')
plt.plot(range(len(x_train)), y_train_hat, 'g', label=u'predict')
plt.legend(loc='upper right')
plt.title("train")
plt.show()
plt.figure(num="test")  # 另一个画布
plt.plot(range(len(x_test)), y_test, 'r', label=u'true')
plt.plot(range(len(x_test)), y_test_hat, 'g', label=u'predict')
plt.legend(loc='upper right')
plt.title("test")
plt.show()
更多推荐

 21
 0
- 0


 已为社区贡献7条内容

所有评论(0)