
基于 kubeadm + keepalived + HAProxy 的 Kubernetes 高可用控制平面(主备 VIP 漂移)
一、背景与目标
本文从上一篇k8s单节点自动一键部署的基础上,延伸到三节点高可用控制平面集群的部署,涵盖相应的原理。
然而在实际操作过程中,我误以为LB和keepalived一样,在每个master节点装Haproxy做成了伪HA,发现后进行了优化。
本文主要内容包括:
1、多master结构与流程说明;
2、kubeadm初始化+扩容control-plane;
3、keepalived+haproxy实现VIP高可用;
4、部署过程中遇到的问题与排查分析;
5、方案的缺陷及优化。
二、环境准备
1、节点规划
三台rockylinux9的vm+两台LB节点
| 节点 | 角色 | IP | 配置 | 说明 |
|---|---|---|---|---|
| rocky | control-plane | 11.0.1.173 | 4C4G | 初期测试阶段在控制节点上同时部署 keepalived 与 haproxy(非推荐生产方式) |
| node01 | control-plane | 11.0.1.174 | 4C4G | 初期测试阶段在控制节点上同时部署 keepalived 与 haproxy(非推荐生产方式) |
| node02 | control-plane | 11.0.1.175 | 4C4G | 初期测试阶段在控制节点上同时部署 keepalived 与 haproxy(非推荐生产方式) |
| lb01 | LoadBalancer | 11.0.1.181 | 1C1G | haproxy + keepalived |
| lb02 | LoadBalancer | 11.0.1.182 | 1C1G | haproxy + keepalived |
| VIP | Virtual IP | 11.0.1.200 | 控制平面入口 |
[root@node01 ~]# cat /etc/hosts
11.0.1.173  rocky
11.0.1.174  node01
11.0.1.175  node02
2、组件说明
为清晰理解后续部署过程中可能遇到的问题,这里有必要先剖析组件的职责与交互关系。
(1)containerd+crictl(容器运行时与调试工具)
containerd:负责容器生命周期管理,包括镜像、容器、存储、网络、shim等,它是真正操作容器的引擎。
crictl:containerd的调试工具,用于排查pod运行状态、镜像拉取、容器日志等。
职责划分:kubelet通过CRI(容器运行时接口)向containerd下发指令,containerd负责执行。
(2)kubeadm/kubectl/kubelet(k8s核心组件)
kubeadm:证书自动下发、配置、Etcd初始化、APIServer配置;
kubectl:集群管理命令行工具,通过与kube-apiserver交互管理集群;
kubelet:运行在每个节点上的节点”代理",负责pod生命周期管理,向APIserver汇报节点状态。
所有组件(kubelet、kubectl、scheduler等)都只与kube-apiserver通信,apiserver是集群唯一入口。
(3)calico网络插件
实现pod网络规划(CNI),确保集群内所有pod可以跨节点通信,并允许网络策略的实施。
(4)keepalived+haproxy+kube-apiserver(高可用)
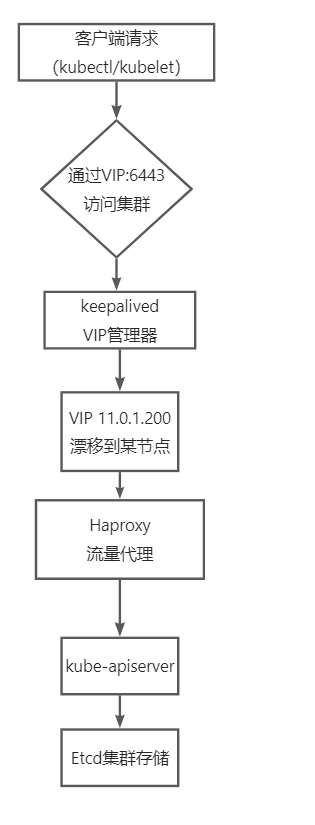
kube-apiserver
集群的通信枢纽和唯一入口,提供API服务,所有请求、节点状态汇报、pod调度指令都必须经过它。
它默认监听6443端口,高可用集群中每个控制节点都要运行一个api-server。
keepalived(VRRP)
通过VRRP协议在多节点间通信,提供VIP,它会在一组master节点间选举将VIP分配给某个节点,如果该节点发生故障,VIP会自动漂移到另一个备节点,避免APIServer单点故障。
同时,它处于网络层(L3/L4),它只处理VIP漂移与可达性保障的问题,不处理具体流量内容。
在本文中,它通过一个固定的VIP(11.0.1.200)让客户端可以一直访问集群,而无需关心后端哪个apiserver实例在提供服务。
HAProxy
它是传输层的流量代理与负载均衡器(LB),在这里提供一个稳定的入口(VIP:6443)进行智能转发功能,它不仅转发,还决定转给谁,并确保服务能被稳定访问。
它可以接收源于VIP的流量并分发到每个控制节点的kube-apiserver实例(11.0.1.173:6443,11.0.1.174:6443,11.0.1.175:6443),对APIServer流量负载均衡,避免将所有流量集中到单个apiserver。
同时它也可以探测master是否存活,如果master挂了就切换(注:当前方案中haproxy主要起代理作用及高可用角色,而非负载均衡)。
#控制平面没有LB时
kubelet————master:6443	#挂了就废

#控制平面有LB时
kubelet————VIP:6443————master01/master02
三、设计分析与方案思路
1、分层设计
| 层级 | 组件 | 职责 | 预期效果 |
|---|---|---|---|
| 接入层 | VIP+keepalived | 入口漂移、故障切换 | IP不失效 |
| 负载层 | HAProxy | 将流量分发到API Server | 避免流量集中 |
| 业务层 | 多实例kube-apiserver | 处理API请求 | 控制平面冗余 |
| 数据层 | Etcd集群 | 存储并同步元数据 | 一致性+容灾 |
Client————VIP————HAProxy————多APIServer————Etcd集群
2、设计思路(初期)
本方案采用:
所有master部署keepalived(节点挂了keepalived实现VIP自动漂移切换到其它节点)
所有master部署HAProxy(希望实现LB层的高可用,避免单点故障)
所有master运行kube-apiserver(多控制面,增强处理能力)
Etcd三副本集群(多副本,单节点挂,ETCD集群保持数据一致性)
该思路是初期思路,文中后续进行了调整,仅供参考。
四、具体实施部署流程
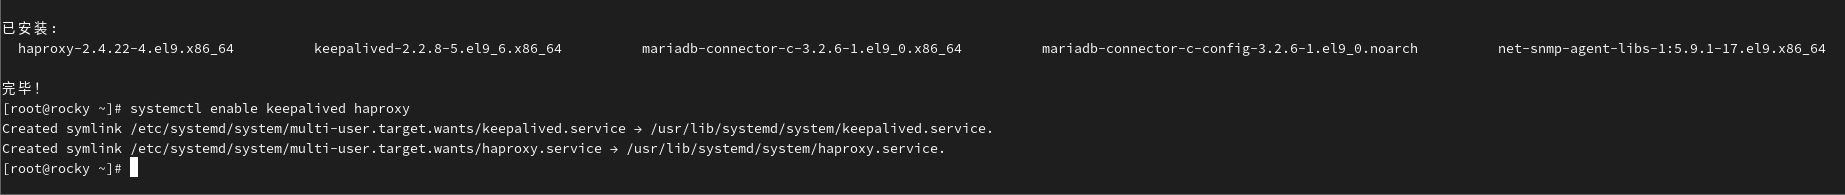
1、安装keepalived与haproxy
yum install -y keepalived haproxy
systemctl enable keepalived haproxy
2、配置keepalived
配置node01/node02与rocky的区别:明确rocky为MASTER,其余为BACKUP,主要修改state和priority,配置优先级,否则可能出现VIP争抢、脑裂、服务不可用。
rocky:
#/etc/keepalived/keepalived.conf
vrrp_instance VI_1 {
    state MASTER	#角色定义
    interface ens160
    virtual_router_id 51
    priority 100		#故障转移优先级
    advert_int 1		#广播间隔
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
	11.0.1.200			#虚拟IP,集群统一入口
    }
}
node01
vrrp_instance VI_1 {
    state BACKUP
    interface ens160
    virtual_router_id 51
    priority 90
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        11.0.1.200
    }
}
node02
vrrp_instance VI_1 {
    state BACKUP
    interface ens160
    virtual_router_id 51
    priority 80
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        11.0.1.200
    }
}
#每个节点都启动keepalived,此时VIP(11.0.1.200)会漂移到优先级最高的rocky节点
systemctl restart keepalived
ip a |grep 11.0.1.200
3、配置haproxy
当前环境每个节点都配置相同haproxy,但实际只有VIP所在节点的haproxy生效。
这是学习部署的简化方案,生产建议使用独立的LB节点。
vim /etc/haproxy/haproxy.cfg
frontend kubernetes_api
    bind 11.0.1.200:6443
    mode tcp
    default_backend kubernetes_api_backend

backend kubernetes_api_backend
    mode tcp
    balance roundrobin
    server rocky 11.0.1.173:6443 check
    server node01 11.0.1.174:6443 check
    server node02 11.0.1.175:6443 check
systemctl enable haproxy
这里先别起haproxy,不然等下初始化会报错(参考下文节点初始化中的端口占用)。
4、节点初始化以及遇到的问题
将rocky先执行k8s-v2.sh脚本,然后再初始化:
#rocky节点初始化需要指定VIP
kubeadm init \
 --control-plane-endpoint "11.0.1.200:6443" \
 --upload-certs \
 --pod-network-cidr=10.244.0.0/16
–control-plane-endpoint的意义:
将VIP写入集群证书和配置,所有master节点共用同一套证书;
为后续节点加入提供统一入口,新节点始终通过VIP加入,而无需关注后端master的具体IP;
如果这个参数仅指向master的IP,那么master单个节点宕机的话可能会引起APIServer服务中断和单点故障。
–upload-certs:将控制平面的证书加密后上传到集群的secret中,后续其它控制平面节点再加入时可自动获取证书,简化集群构建;
–pod-network-cidr:指定IP地址段(CIDR),集群所有pod将从这个地址段获取IP。
另外node01和node02此时仅需完成前置工作(系统配置、k8s组件安装)即可,无需初始化(也可通过运行k8s-v2+clean_cluster.sh实现)。
参考之前的博客:https://editor.csdn.net/md/?articleId=126852511
脚本链接:https://pan.baidu.com/s/1XAW0t0HDMRTnzf4OuCgIDA?pwd=2mbw 提取码: 2mbw
值得一提的是,在执行脚本(k8s-v2.sh)的过程中遇到了几种不同的报错,我们排查下:
(1)EL8 模块冲突+仓库重复配置
现象:
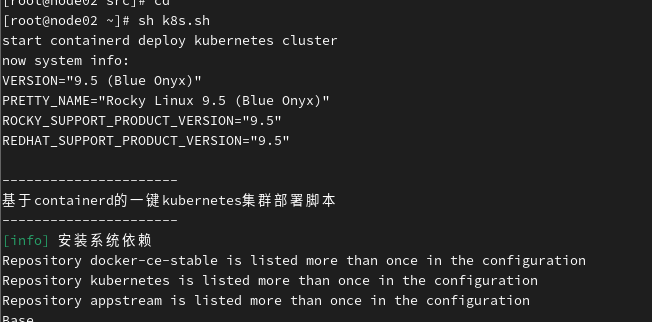
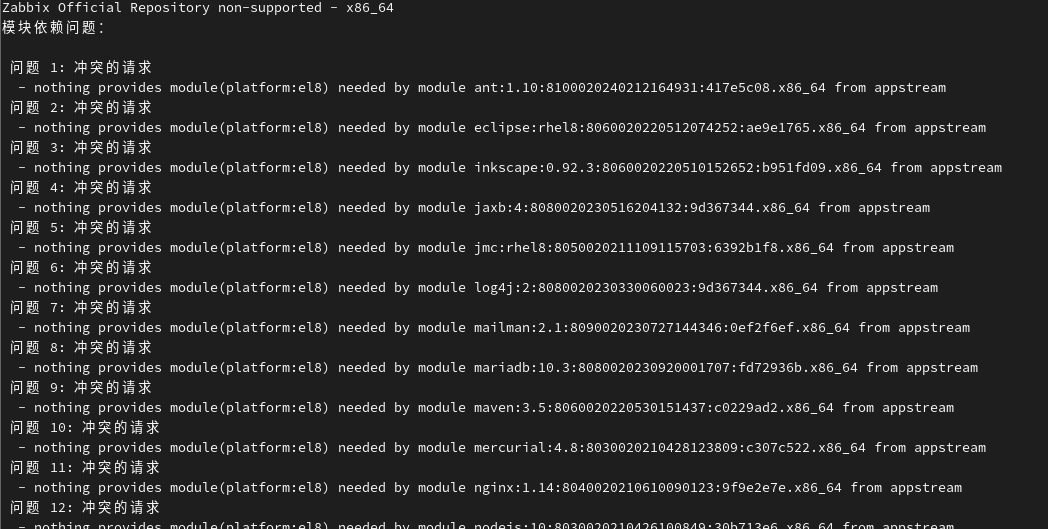
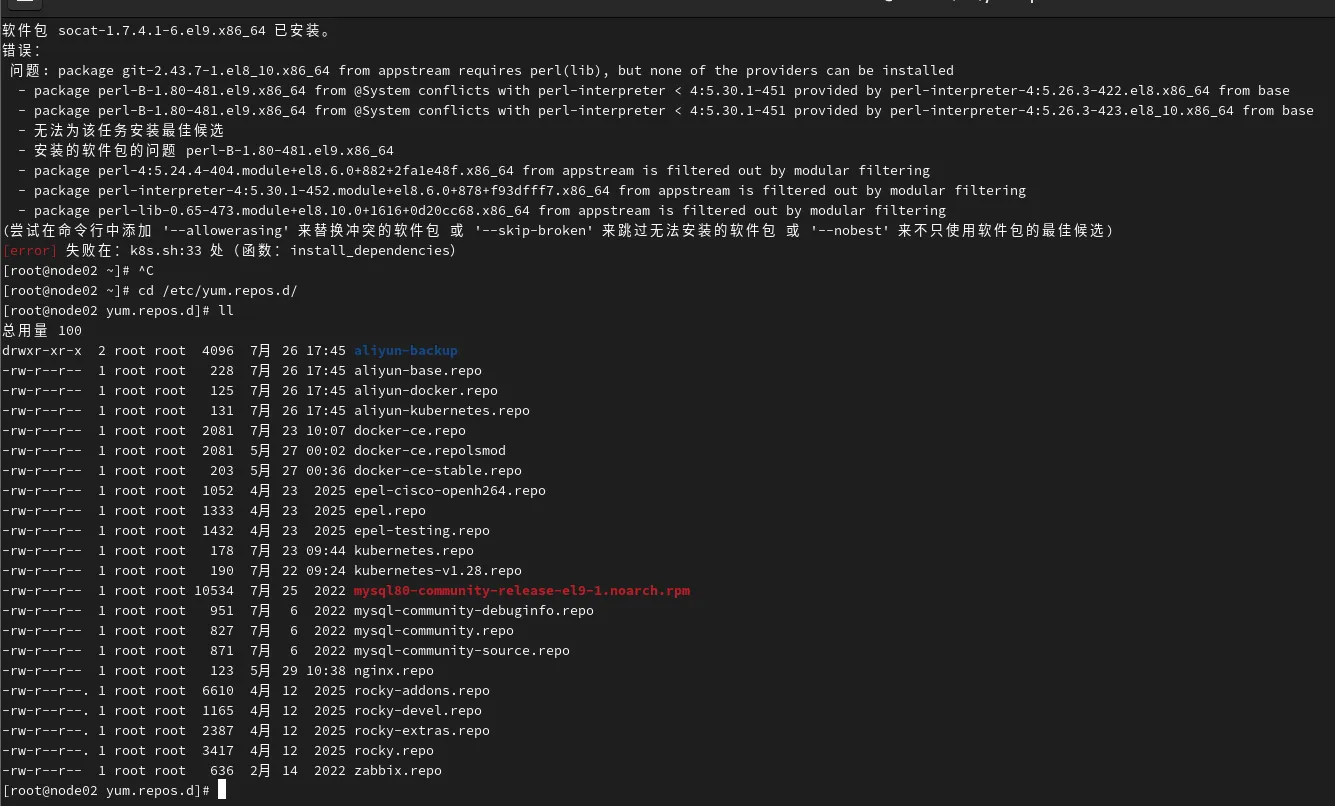
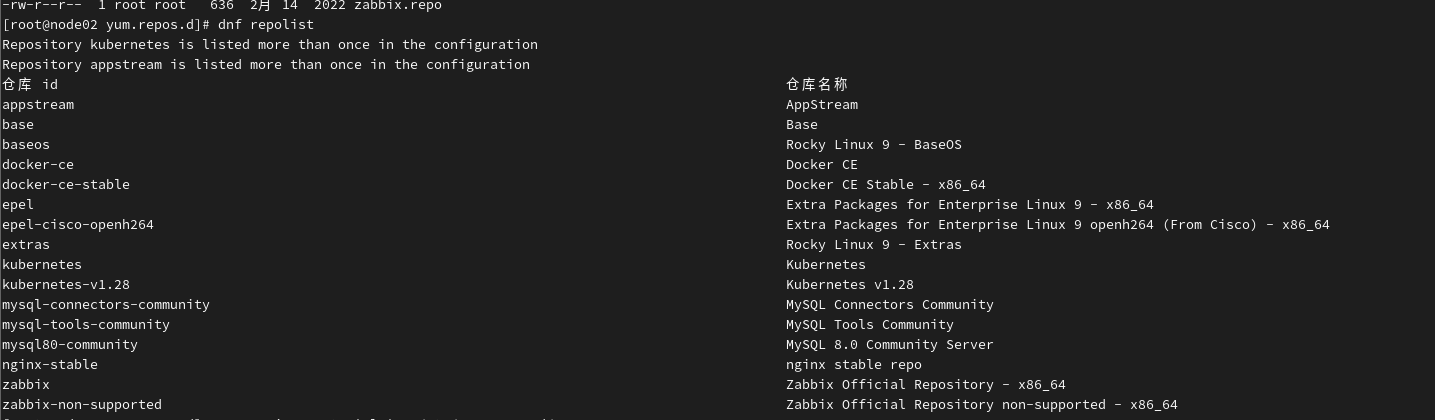
原因分析:这里说的是安装软件包失败,本质是yum仓库源错误、依赖冲突,在Rocky9系统安装EL8的模块,不兼容,产生了module报错;而且“Repository kubernetes is listed more than once in the configuration
Repository appstream is listed more than once in the configuration”仓库重复配置。
证明:
cat /etc/redhat-release
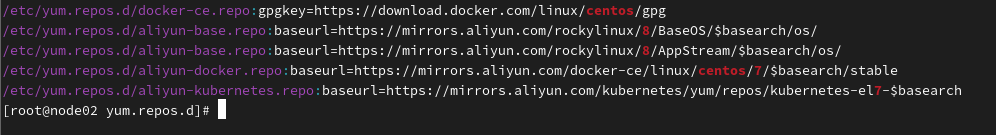
grep -RiE 'centos|el8|8' /etc/yum.repos.d/
执行grep -RiE ‘centos|el8|8’ /etc/yum.repos.d/,可以看到aliyun-base.repo,aliyun-docker.repo,aliyun-kubernetes.repo这两个文件的仓库指向EL8/7:
解决方法:
cd /etc/yum.repos.d/
#把el8的repo禁用
mv aliyun-base.repo aliyun-base.repo.bak
mv aliyun-docker.repo aliyun-docker.repo.bak
mv aliyun-kubernetes.repo aliyun-kubernetes.repo.bak

#删除el8模块缓存
dnf module reset '*'
dnf clean all
rm -rf /var/cache/dnf

#删除重复yum docker repo,这里视具体场景操作
grep -l "docker" *.repo
rm -f docker*.repo
后面执行对应的yum install。
(2)二次重跑脚本导致环境残留
现象:

原因分析:
invalid or incomplete external CA: failure loading key for apiserver: couldn't load the private key file /etc/kubernetes/pki/apiserver.key: open /etc/kubernetes/pki/apiserver.key: no such file or directory
这里是二次运行脚本时发生的,第一次init后/etc/kubernetes/pki/目录残留但不完整,kubeadm认为你在用外部CA(external CA),因此不会自动生成apiserver.key,但你没有提供对应的key(failure loading key),所以报错。
解决方法:
kubeadm reset -f
rm -rf /etc/cni/net.d
systemctl restart containerd
rm -rf /etc/kubernetes/pki
rm -f /etc/kubernetes/*.conf
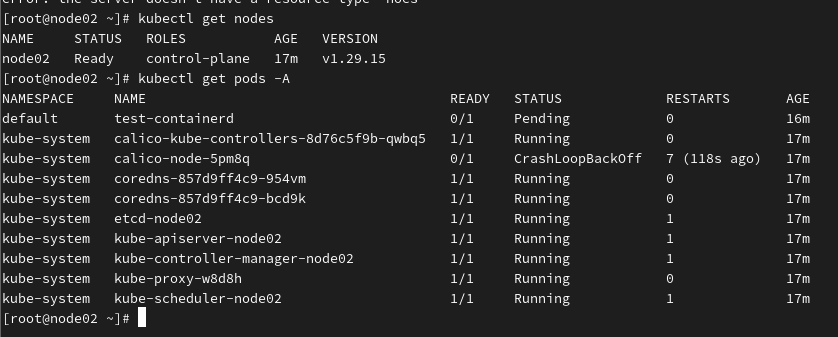
然后重新执行脚本,验证服务是否正常运行,仅示例(实际应该是rocky而非node02):
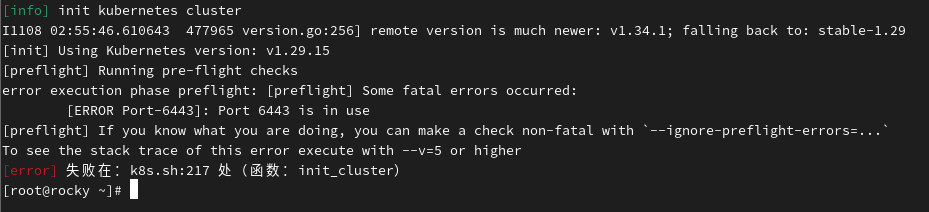
(3)端口占用
现象:
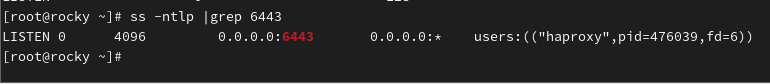
[ERROR Port-6443]: Port 6443 is in use
原因分析:
很明显,这种情况是因为在初始化前就起了haproxy,apiserver的6443端口是被haproxy占用了。
在当前方案中,6443端口属于kube-apiserver,如果先启动HAProxy,则Haproxy会bind *:6443,此时执行init的话,apiserver无法绑定该端口,这个问题是初始化与端口资源冲突。
解决方法:
#先停掉haproxy
systemctl stop haproxy

#reset,清数据和相关网络规则
kubeadm reset -f
systemctl stop kubelet
systemctl stop containerd

rm -rf /etc/kubernetes/*
rm -rf /var/lib/etcd/*
rm -rf /var/lib/kubelet/*
rm -rf /etc/cni/net.d/*
rm -rf /opt/cni/bin/*

iptables -F
iptables -X
iptables -t nat -F
iptables -t nat -X
ipvsadm --clear
sleep 5
systemctl restart containerd
systemctl restart kubelet

#init,这里用指定的VIP,如果你不用的话就只是普通集群,而不是高可用集群
kubeadm init --control-plane-endpoint "11.0.1.200:6443"  --upload-certs --pod-network-cidr=10.244.0.0/16

#初始化完再执行,这种方法比export简单,相较于export也不用担心环境变量污染的问题
 mkdir -p $HOME/.kube
 sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
 sudo chown $(id -u):$(id -g) $HOME/.kube/config
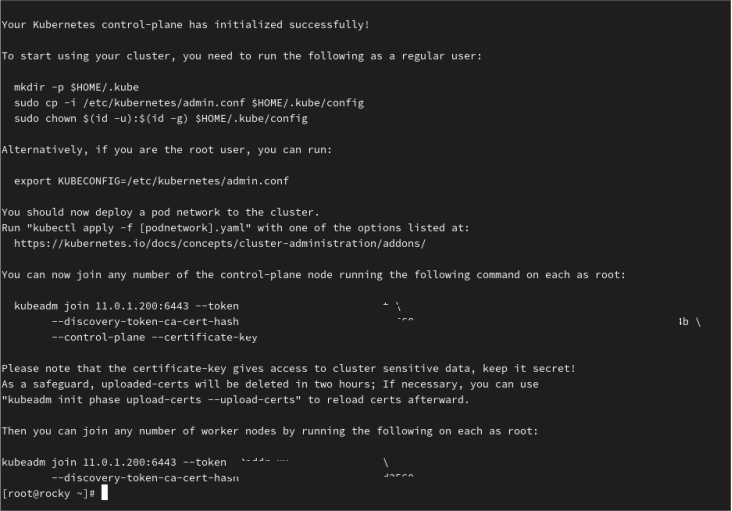
此刻可以看到,初始化成功:
需要强调的是:
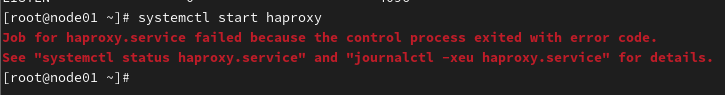
虽然此处通过停止haproxy让kubeadm正常init,但这只是临时解决,根本问题并未消失。如果你想再运行haproxy的话,同样会报错。
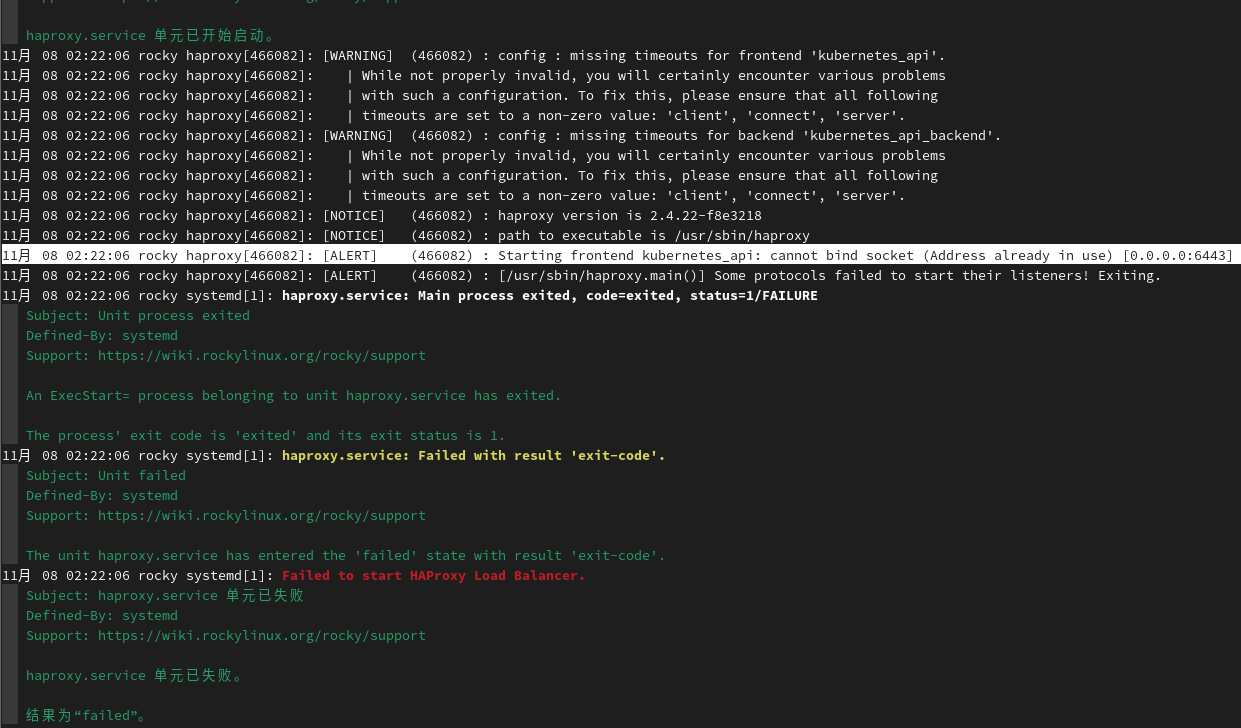
同时,这里也反映出了方案设计上的问题:
虽然rocky节点初始化成功,但是haproxy无法启动,负载均衡未生效。
初期曾尝试将 keepalived、HAProxy 与 API Server 共部署于三台控制节点直接实现HA,然而在这个方案中kube-apiserver占用6443,haproxy作为LB入口也要监听6443,自然不可避免的会引发端口冲突,这个设想本身就与主流的高可用负载均衡方案(一般是单独部署两个LB节点)相违背,该问题随后会在本文的方案缺陷与优化环节进行验证与解决。
5、安装calico
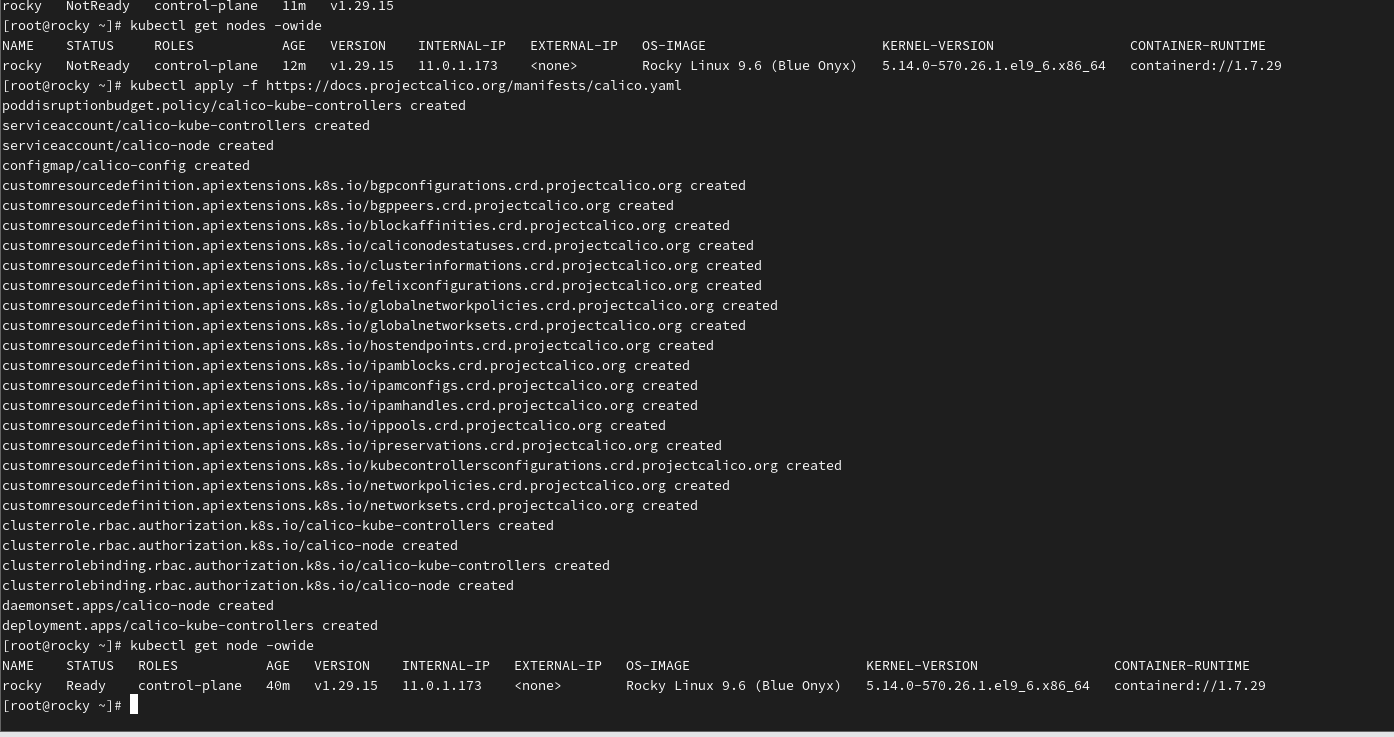
在没有安装cni前,node状态是not ready的,所以需要执行这一步骤。
kubectl apply -f https://docs.projectcalico.org/manifests/calico.yaml
sleep 10
kubectl get nodes -owide
6、扩容为集群
这里是为了扩展etcd集群,实现数据高可用,同时增加API Server实例,提升处理能力。
(1)node01(11.0.1.174)/node02(11.0.1.175)执行kubeadm join命令
#示例
kubeadm join 11.0.1.200:6443 --token <token> \
  --discovery-token-ca-cert-hash sha256:<hash> \
  --control-plane --certificate-key <cert-key> \
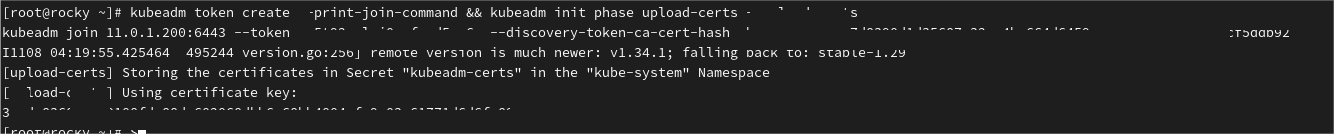
找不到命令了的话,也可以执行如下命令来手动生成再复制去node01/node02执行:
kubeadm token create --print-join-command && kubeadm init phase upload-certs --upload-certs
类似于这样,格式照上面样式自行组织即可:
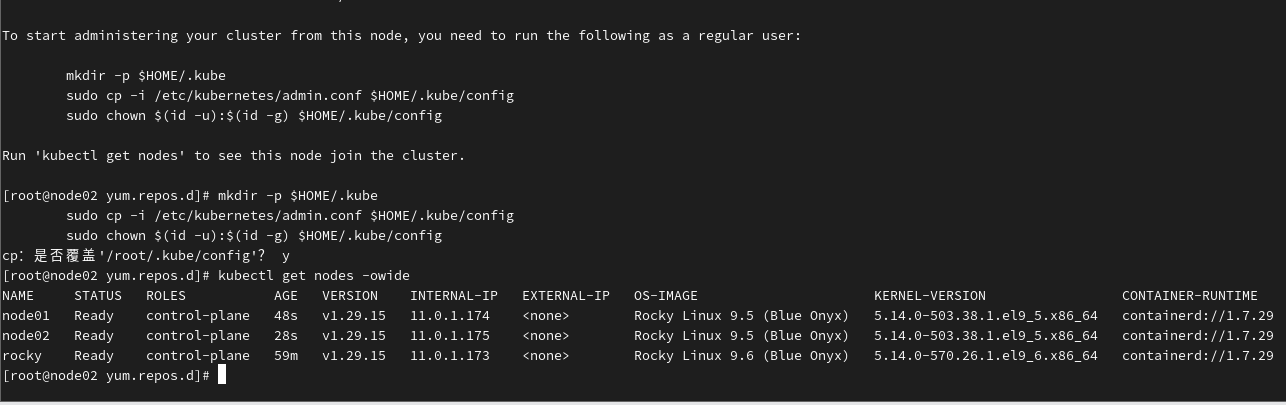
现在可以看到集群的状态了:
五、故障演练与方案缺陷
本节的目标不仅是验证功能,更在于通过实验暴露当前方案的缺陷,并引导出真正的解决方案。
1、故障演练
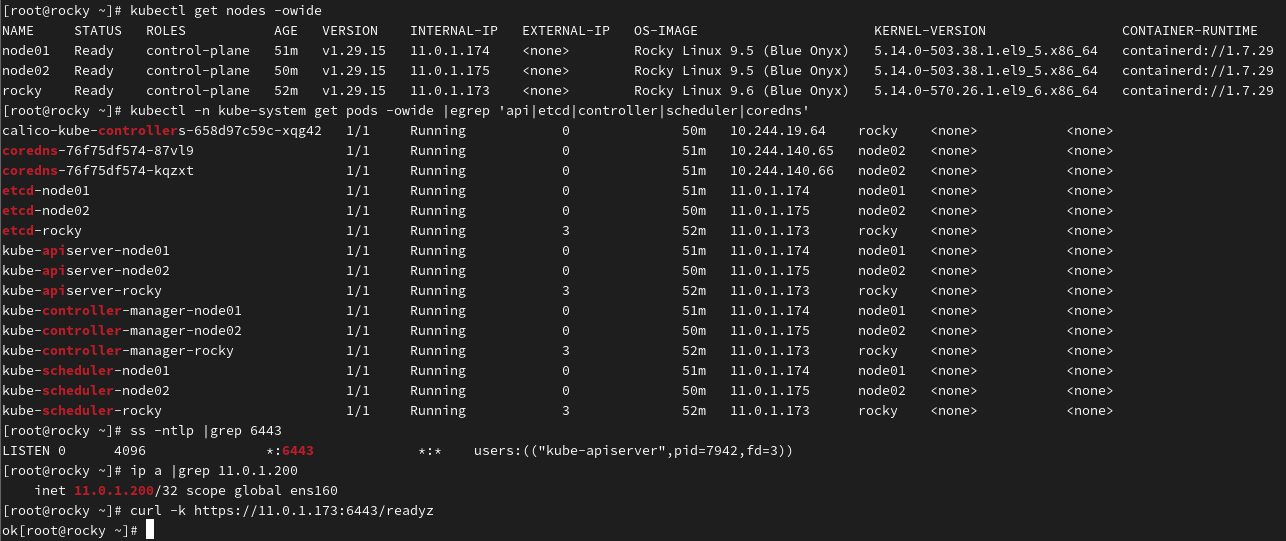
(1)基线记录
该环节的输出可与下文的测试进行对照,提供参考。
kubectl get nodes -owide
kubectl -n kube-system get pods -owide |egrep 'api|etcd|controller|scheduler|coredns'
ss -ntlp |grep 6443
ip a |grep 11.0.1.200
curl -k https://11.0.1.173:6443/readyz
(2)连续性监测
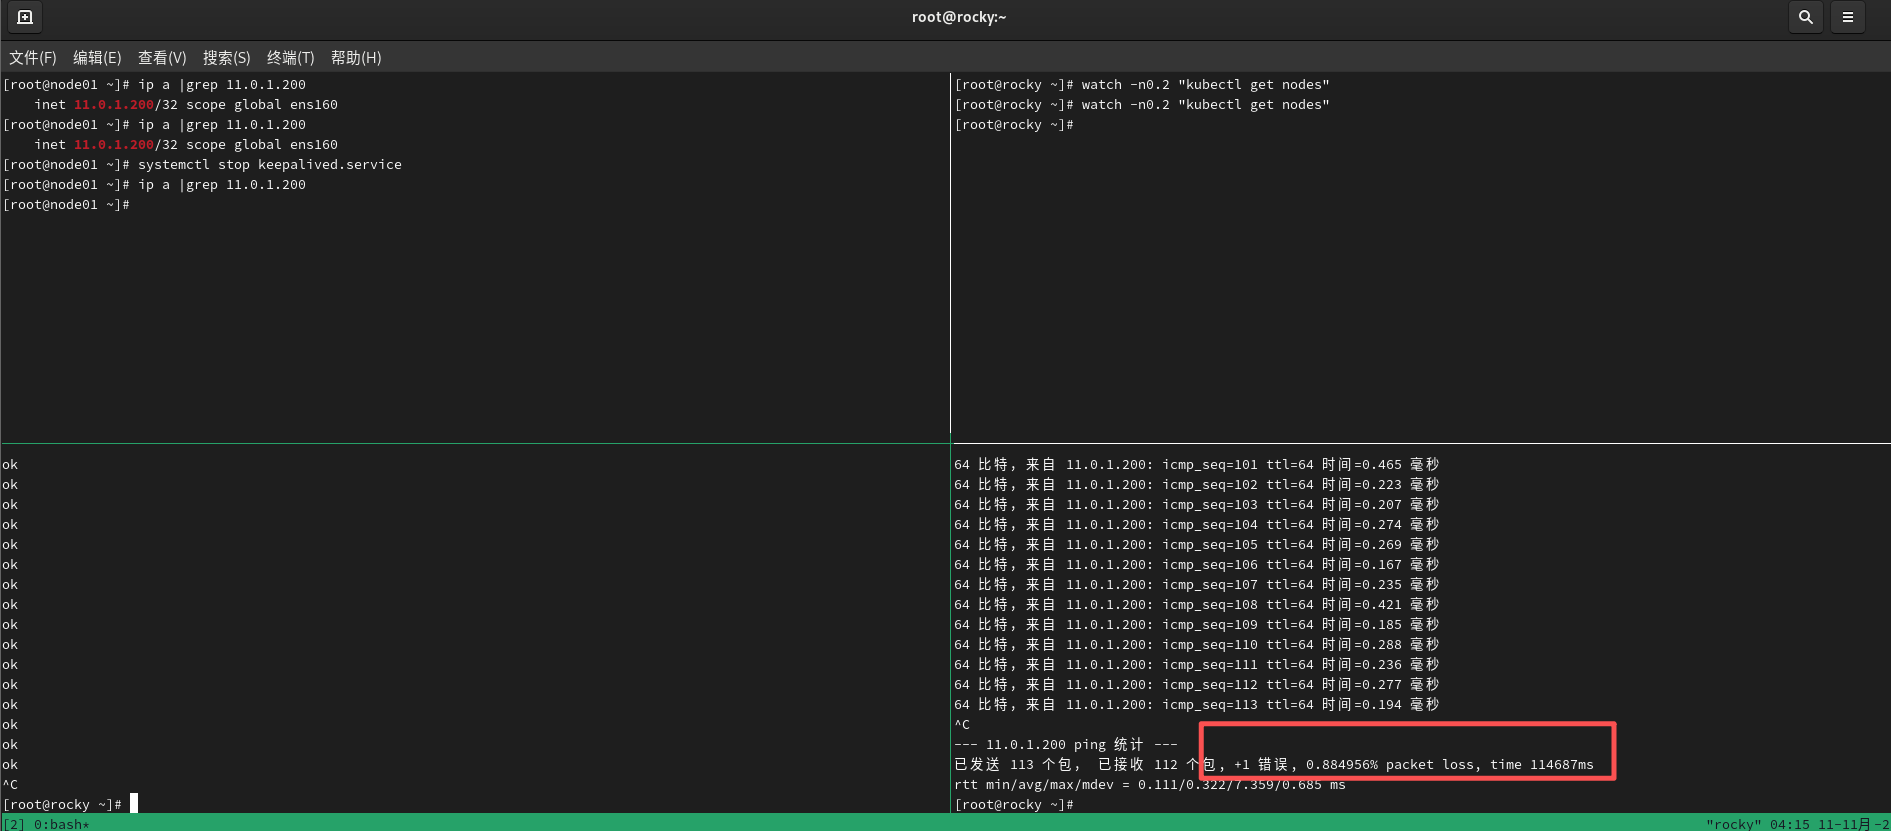
在关闭相应节点的keepalived的过程中,均会进行该项测试。
#不断监控集群状态
watch -n0.2 "kubectl get nodes"
#持续访问API Server,预期全程打印ok,有fail则代表有中断
while true;do curl -k https://11.0.1.200:6443/readyz >/dev/null && echo ok;sleep 0.2;done
#持续ping VIP
ping 11.0.1.200
(3)关闭rocky节点的keepalived验证VIP漂移
首先,我们手动停止rocky节点的keepalived。
systemctl stop keepalived
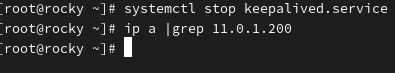
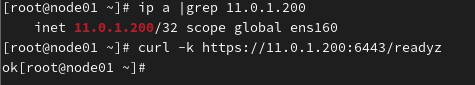
停服务后约1-3秒(VRRP广播),VIP从rocky漂移到了node01。
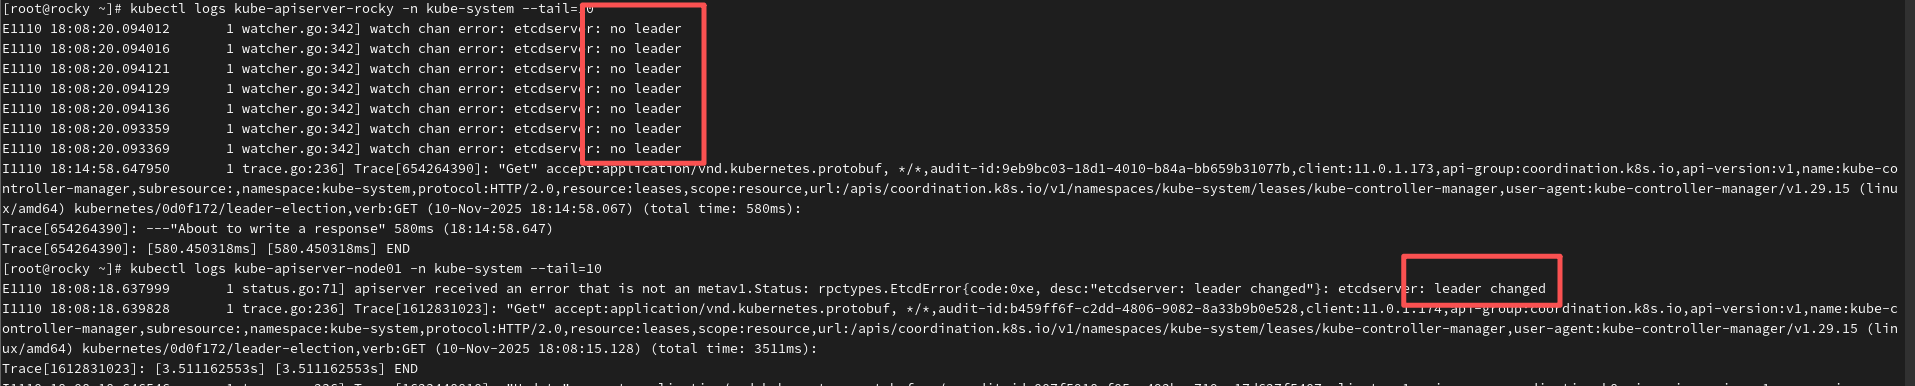
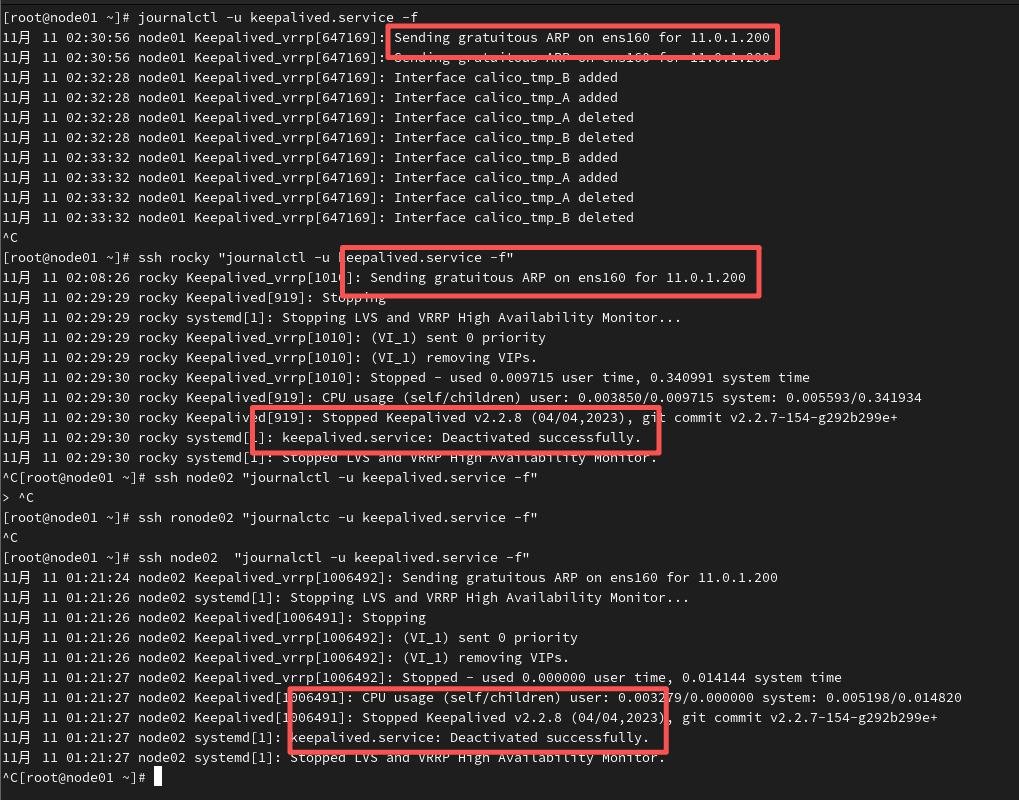
我们也可通过看日志进一步加强判断。
kubectl -n kube-system logs kube-apiserver --tail=10
journalctl -u keepalived -f
这里显示中间etcd因节点失联短暂无主,但它迅速完成了选举。
"Sending gratuitous ARP on ens160 for 11.0.1.200"说明VIP正在进行广播/漂移。
Deactived的状态是服务停用、进程退出,这里说明keepalived服务是被优雅停止,VIP已经释放。
最终,所有组件通过node01上的VIP与新的控制平面master重新建立连接,恢复正常。
这里是连续性监测的截图。
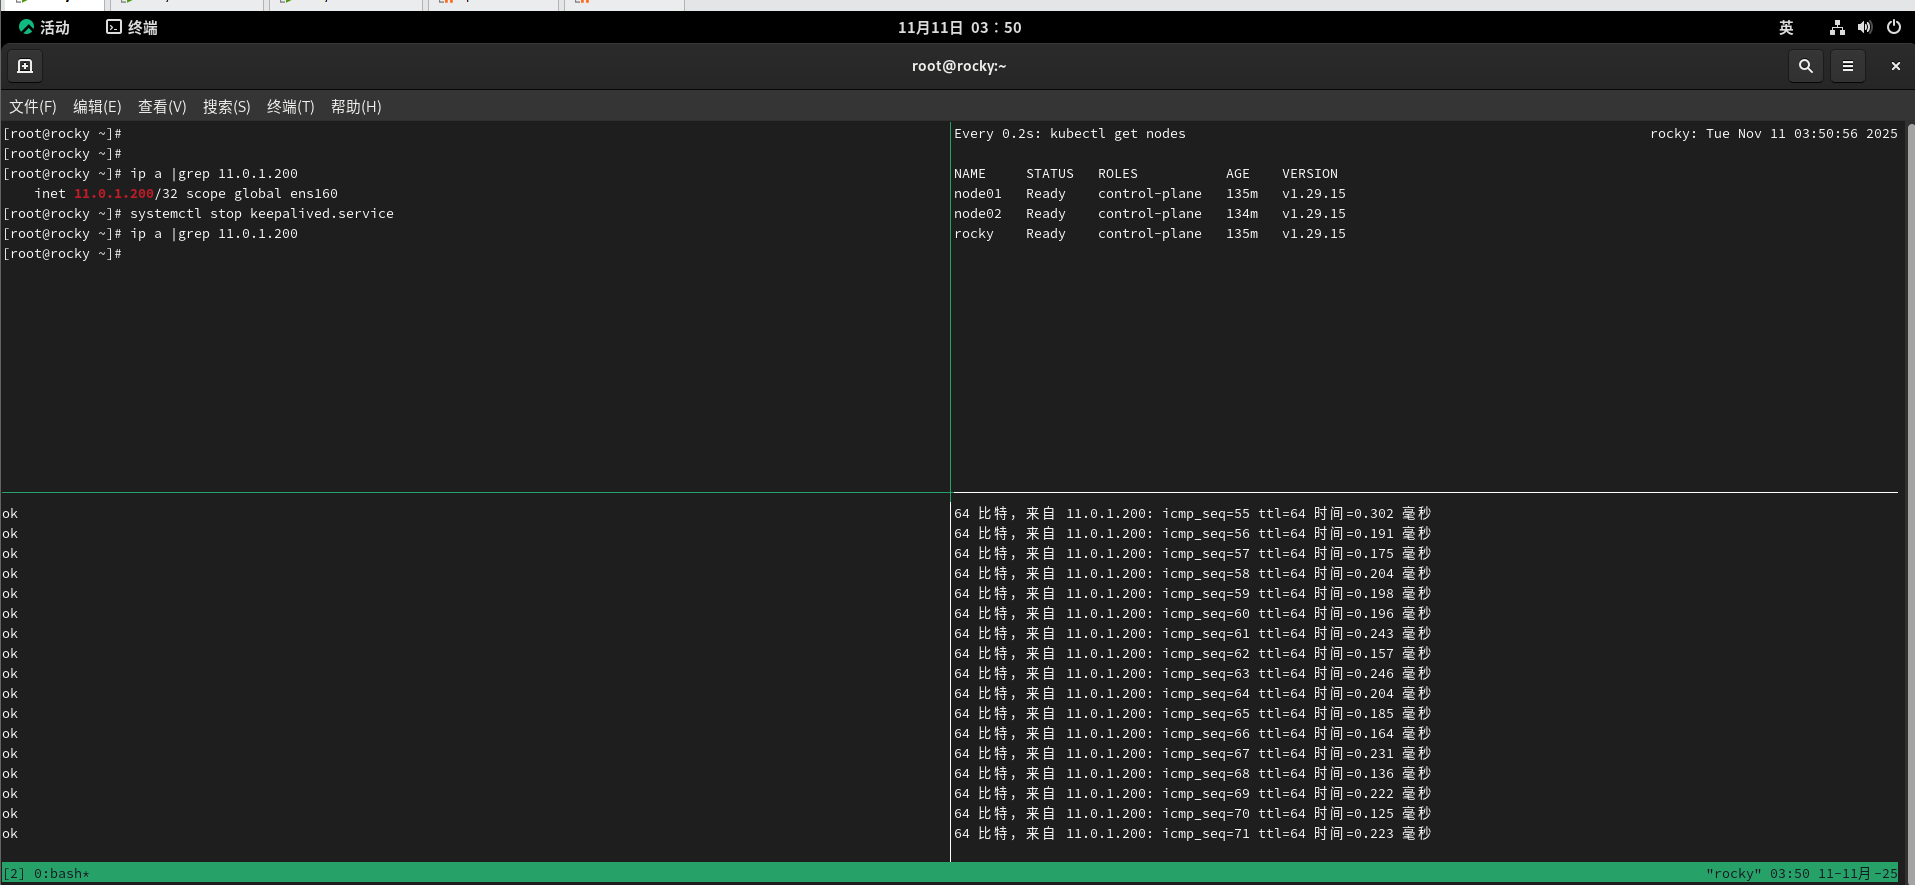
整个过程中:
没有出现丢包的情况,因为VIP通过二层ARP通告完成漂移,控制面本身也有三副本和重连机制;
同时curl readyz全程无fail,API Server无中断。
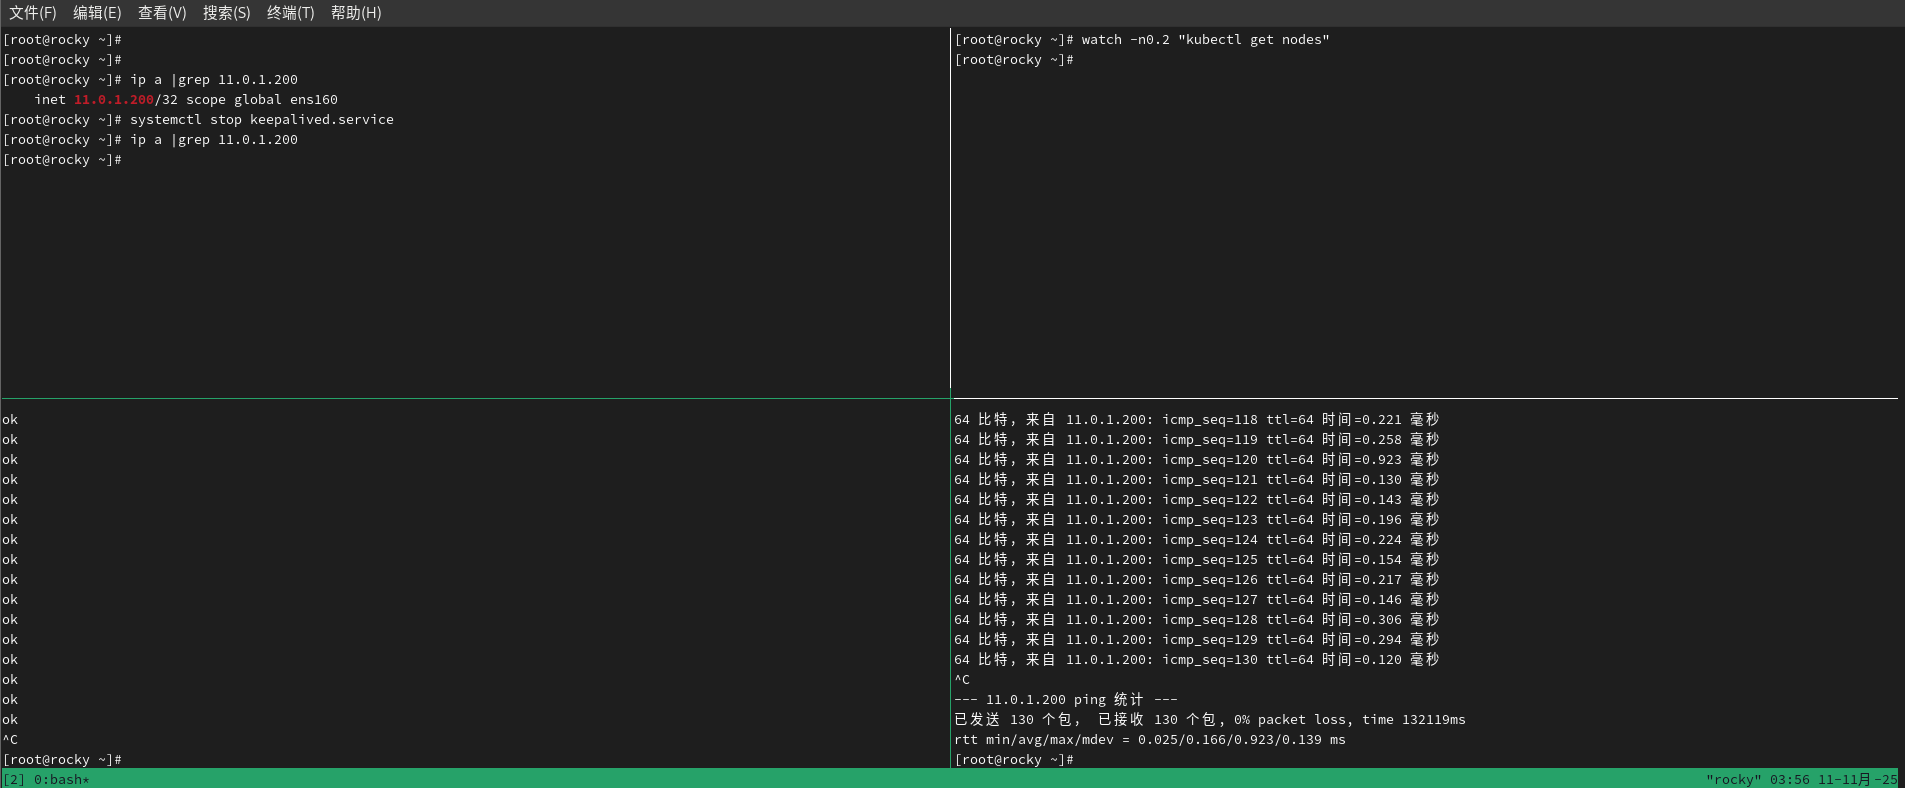
(4)关闭node01节点的keepalived验证VIP漂移
继续停止node01的keepalived,进行二次漂移验证。
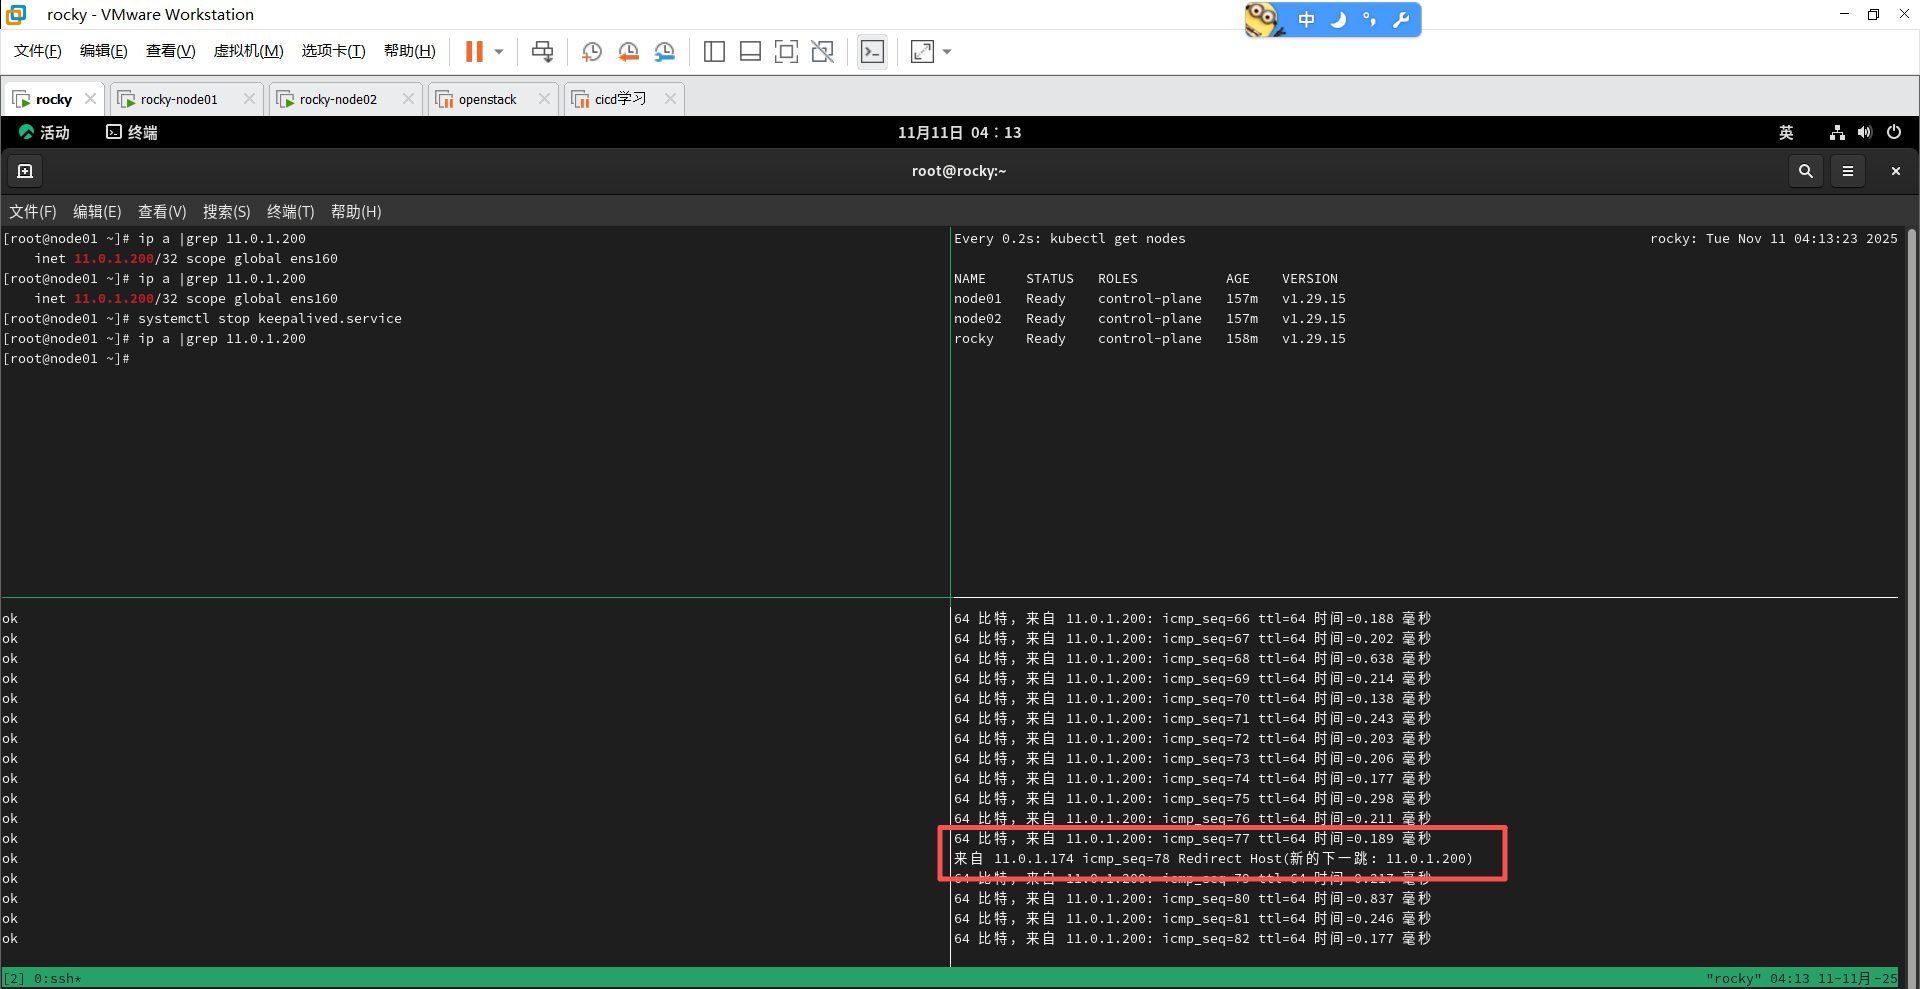
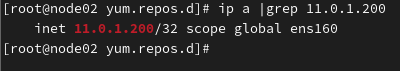
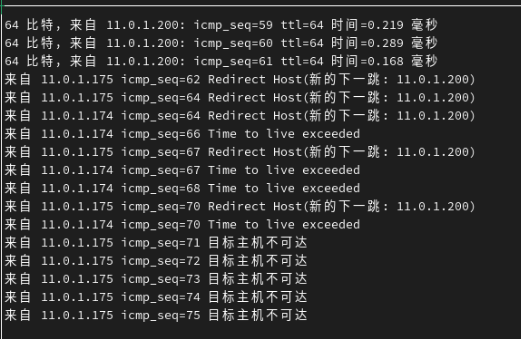
这里是VIP漂移和路由缓存导致的正常抖动,网络出现短暂 ARP/ICMP 重定向与 1~3 个 ICMP 丢包属正常现象。ICMP Redirect说明内核发现新的下一跳(VIP切换节点),linux内核收到VRRP广播更新ARP表,此时VIP漂移到了node02,不影响集群长期稳定性。
(5)关闭node02的keepalived验证VIP漂移
rocky和node01的keepalived都停掉了,我们将node02的keepalived也停掉,观察会发生怎样的现象。
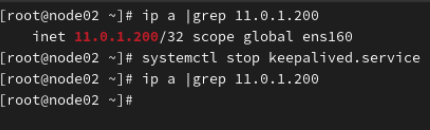
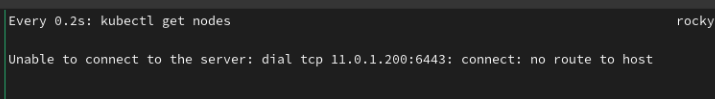
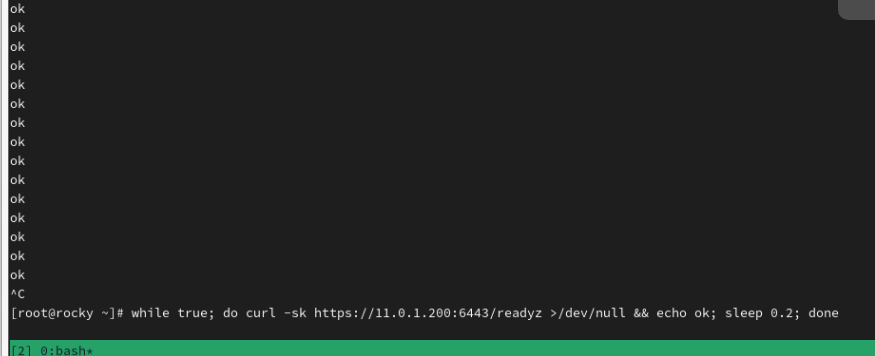
此时所有keepalived节点全部失效,VIP无法漂移,表现为:
ping VIP,多次ICMP重定向不可达。
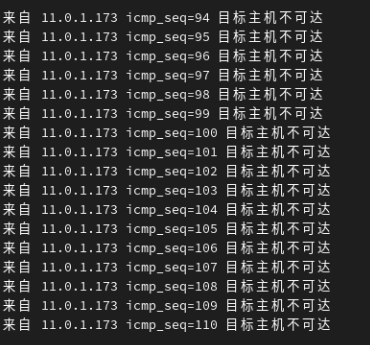
kubectl get nodes无法连接API,API Server无法访问。
curl -k https://VIP:6443/readyz无响应。
整个集群直接崩溃。
(6)对rocky和node01关机模拟宕机测试
刚才验证了三节点的keepalived全部关闭的情况,现在我们对rocky和node01节点进行关机操作,进一步模拟控制平面两台节点宕机的情况进行观察。
此时node02的keepalived已重新启动,集群正常:
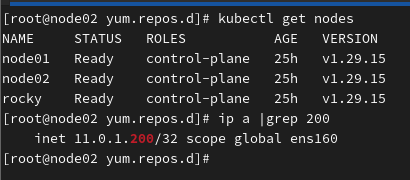
将rocky(11.0.1.173)、node01(11.0.1.174)关机:
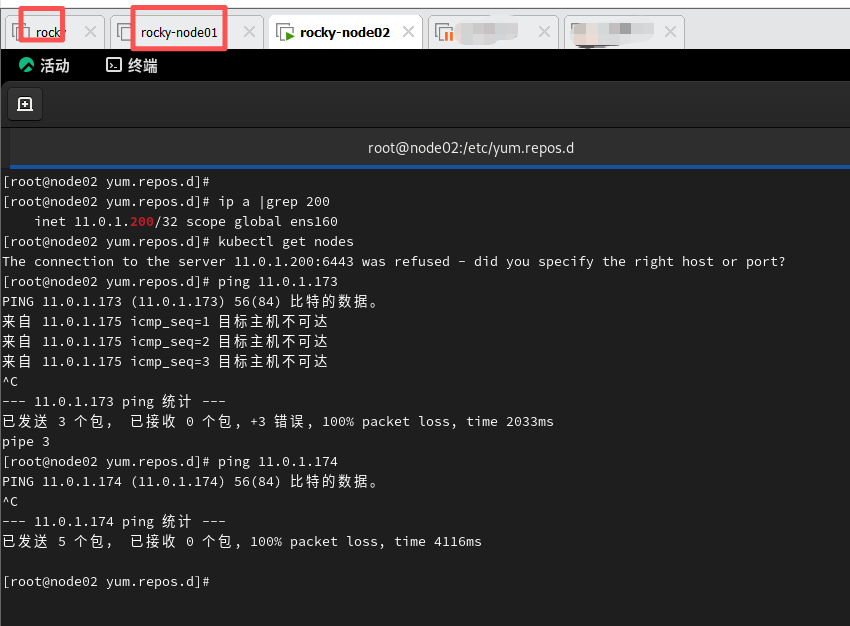
现在可以看到集群失联报错:
The connection to the server 11.0.1.200:6443 was refused - did you specify the right host or port?
根本原因:
Etcd多数派丢失。
k8s控制面依赖etcd存储所有的关键状态信息,同时etcd作为分布式强一致性存储组件,基于Raft协议运行,其核心机制之一是:集群必须有过半数的节点存活,集群才能正常工作,以此避免脑裂并保证数据一致性。
在当前三控制节点集群中,过半数的票数为2,即要求存活的节点数为2,但此时rocky和node01宕机,存活的Etcd实例仅剩node02,无法满足多数派要求,导致Etcd崩溃。
注:本实验仅用于模拟方案在极端情景下的表现(如宕机),真实的生产情况远复杂于此,仅供参考。
2、方案缺陷
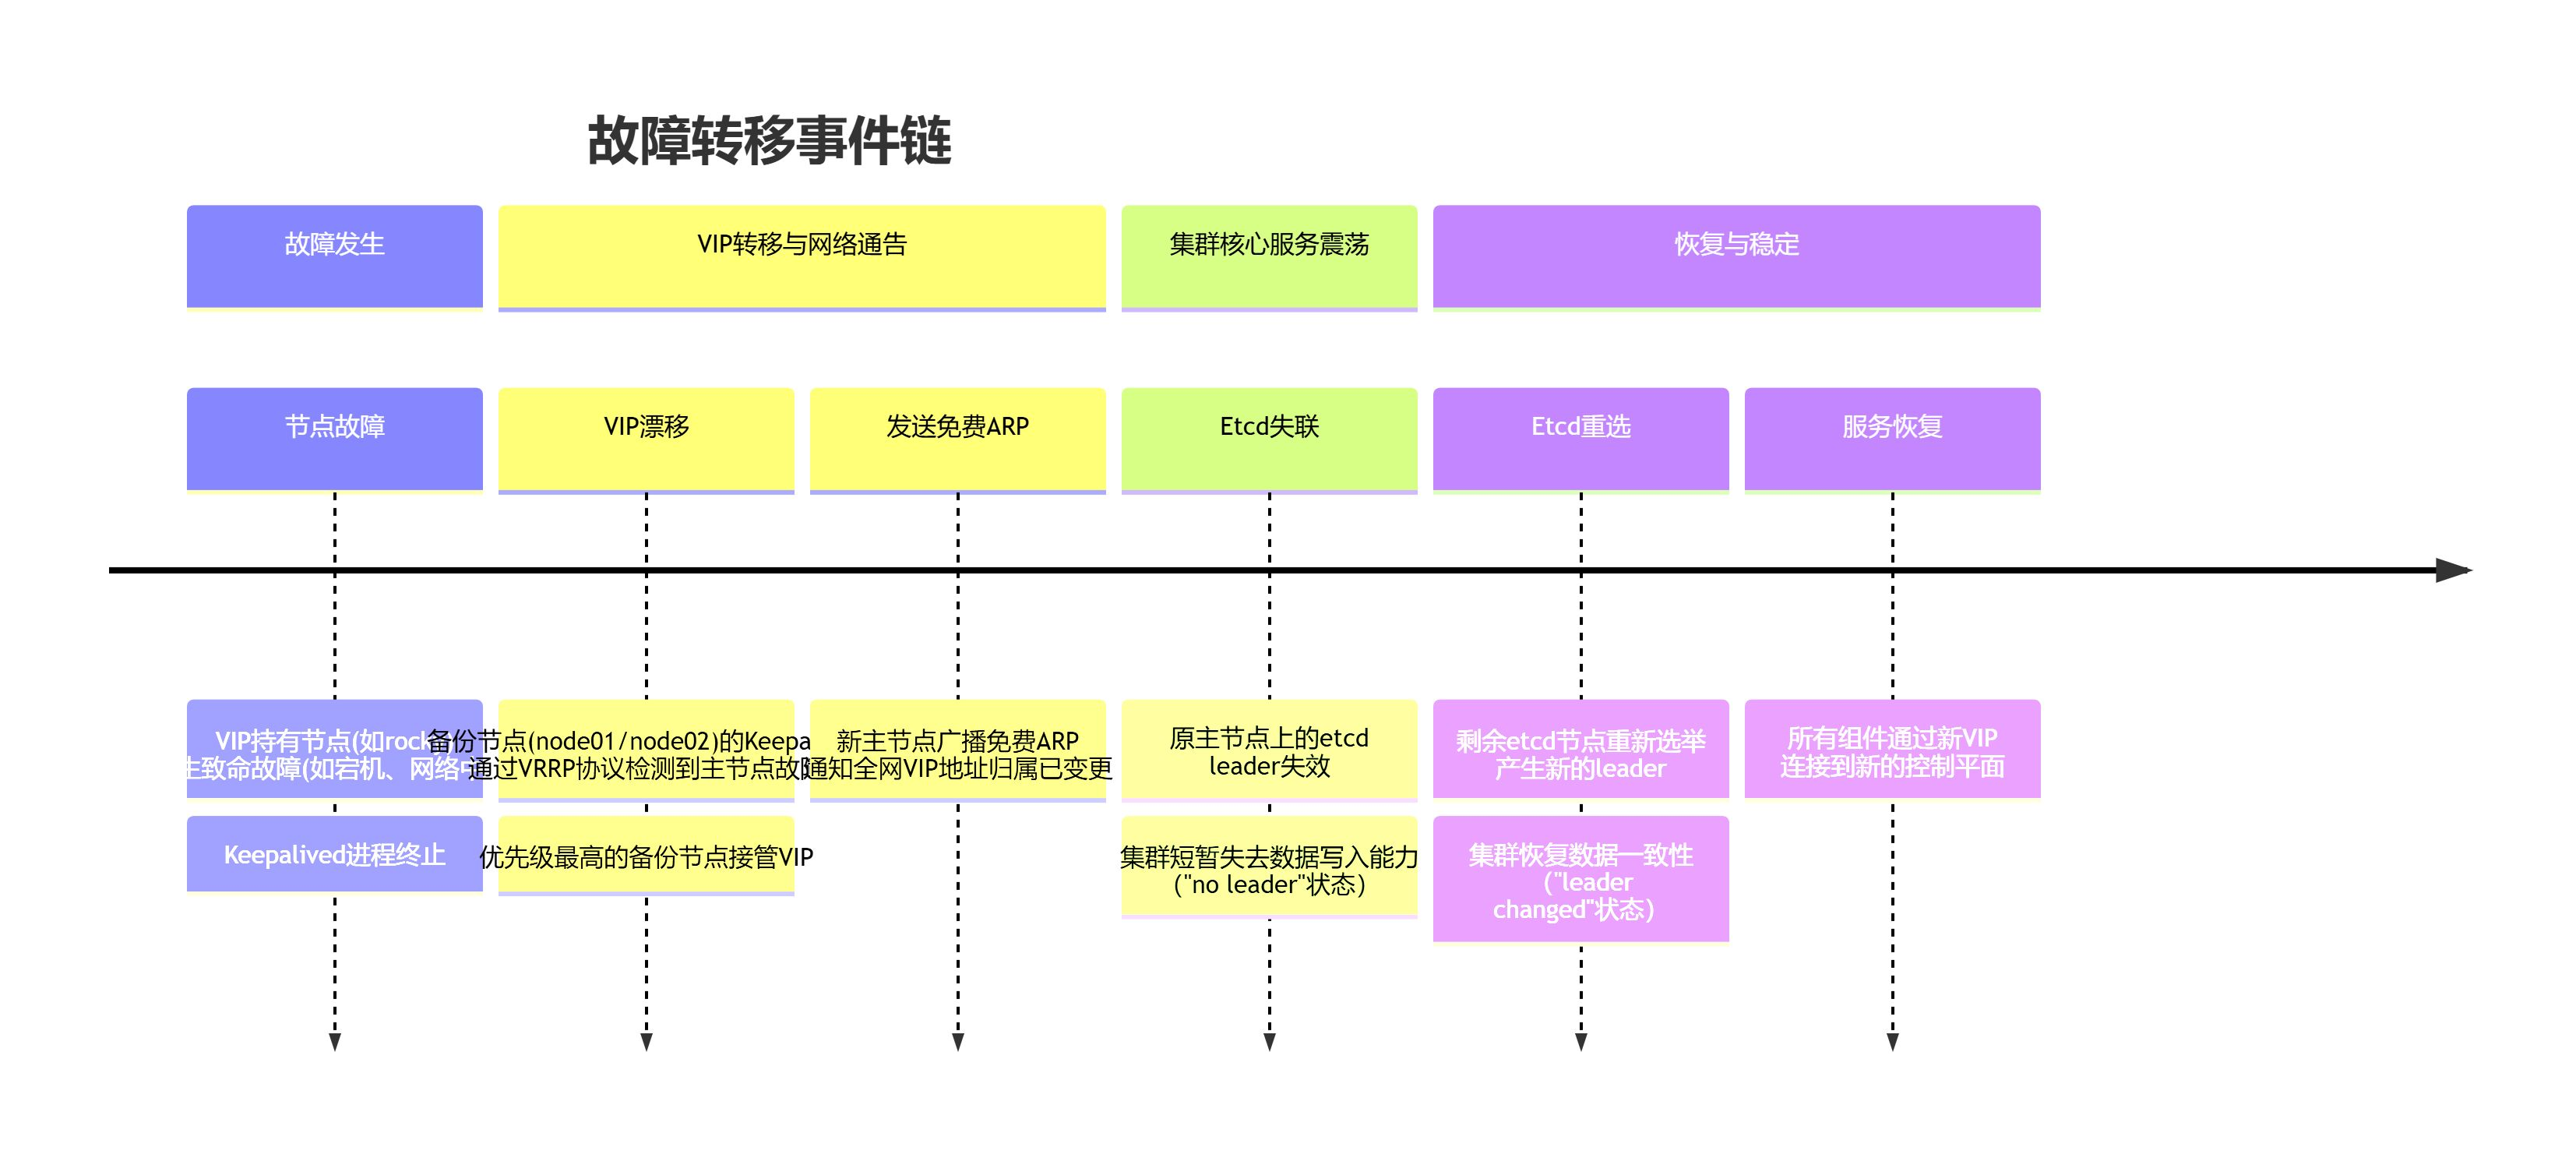
刚才的测试覆盖了从单节点故障到全节点关闭keepalived包括节点宕机的流程,通过测试,我们验证了当前环境多apiserver实例和VIP漂移机制的有效性:任意一个节点的keepalived关闭,VIP可自动漂移,控制平面仍旧可用。
但该方案同时也存在一些问题:
VIP在任意时刻仅指向一个实例,加上方案中LB与API Server共存于同一节点导致haproxy未能正常运行(端口冲突),因此导致以下问题:
(1)入口流量单点
问题:当前方案中,haproxy未能启动,无法实现流量分发负载均衡,所有外部请求只能由VIP所在的apiserver实例处理,其余两个实例处于闲置状态无法分担流量,资源利用率低下,性能有限。
影响:在处理大量请求的高并发场景下,当前设计会遭遇性能瓶颈。如果流量过大,控制平面节点被逐个打穿,宕机两台,仅剩单独的VIP节点,那么集群会直接崩溃瘫痪(如之前实验中遇到的etcd崩溃)。
(2)故障难以隔离
问题:Ha(负载均衡器)与apiserver(控制平面)在同一节点,会导致资源竞争(端口冲突)以及集群管理复杂化。
影响:如果集群中任意节点宕机,会同时失去一个负载均衡器及控制平面实例,资源损失较大。
之前实验的意义不在于避免错误,而是为了验证方案设计是否满足HA。
结合实验来看:控制面需要多副本、多数派、入口冗余,但当前方案实际上只是一个VIP代理的多master集群,属于伪高可用而非整体架构的高可用,并未提供真正的负载均衡与故障隔离能力。之前初始化时遇到的端口冲突,本质不是操作失误,而是方案设计的必然矛盾。
六、方案优化
基于方案实施过程中发现的问题,现在开始对方案进行优化以及执行具体操作。
1、Haproxy与apiserver控制平面共存
(1)场景
三节点都部署apiserver+etcd+keepalived+haproxy(LB)
(2)思路
修改三台VM的apiserver配置文件里绑定的IP地址,apiserver只监听本机IP(如11.0.1.173),haproxy绑定VIP(11.0.1.200)。这个方案是考虑到某些情境宿主机资源紧张,因此模拟LB与apiserver共同部署。
#修改apiserver配置文件绑定的地址,rocky/node01/node02都执行
vim /etc/kubernetes/manifests/kube-apiserver.yaml
#找到bind-address和advertise-address修改
- --advertise-address=本机IP	#改成本机IP
- --bind-address=本机IP			#如果的话没有加一行

#探针对应的host如果是VIP的话记得也修改一下
failureThreshold: 3
      httpGet:
        host: 本机IP		#修改成本机IP
#修改haproxy配置文件的监听地址
vim /etc/haproxy/haproxy.cfg
#找到bind
    bind 11.0.1.200:6443		#将*:6443改成VIP:6443
修改完成后,检查是否生效
systemctl enable --now haproxy		#现在可以启动了,不启动的话apiserver会报错11.0.1.200:6443: connect: connection refused
ss -ntp |grep 6443
rocky节点haproxy与apiserver都正常运行
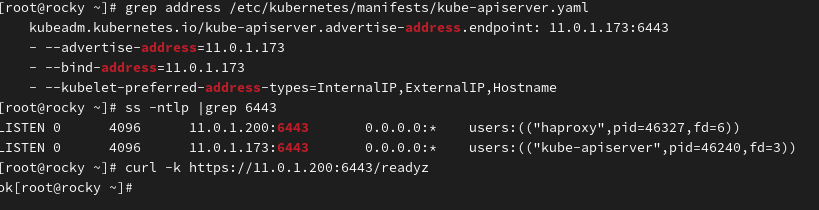
但是node01/node02启动haproxy时报错了
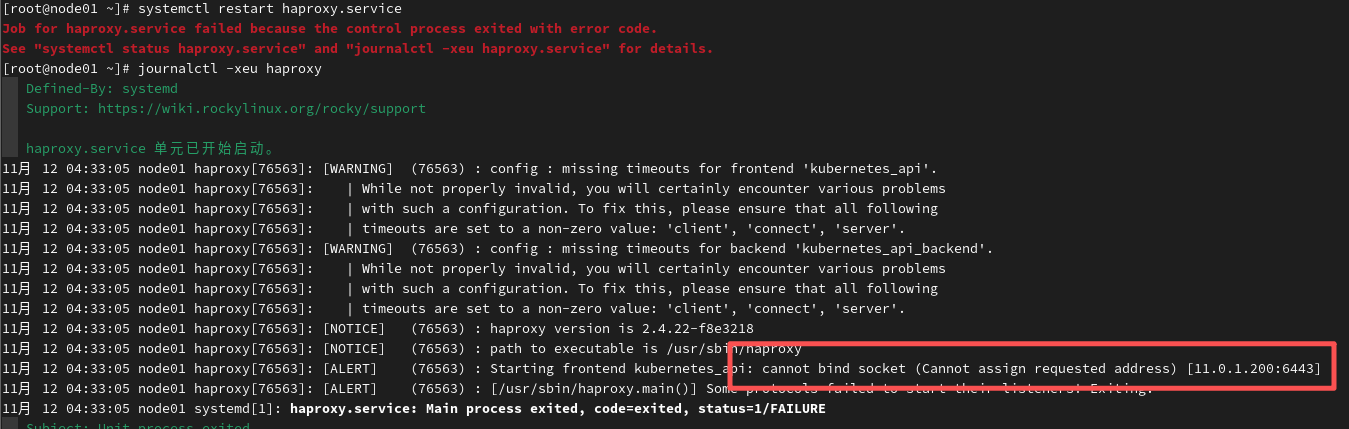
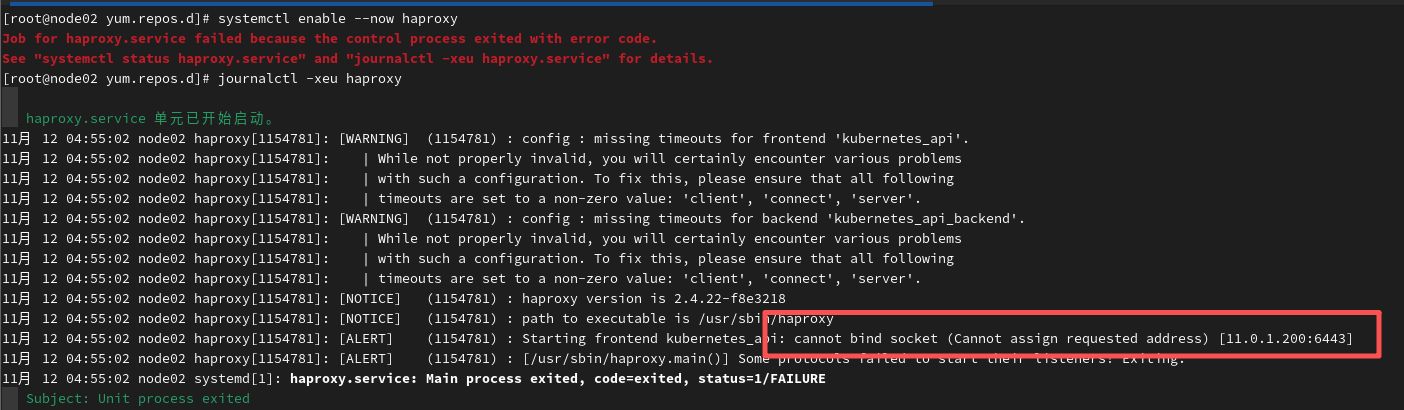
(3)分析
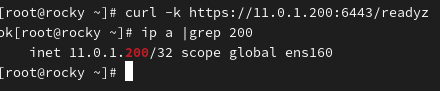
cannot bind socket (Cannot assign requested address) [11.0.1.200:6443]
该报错表明VIP地址绑定冲突,而非端口占用,node01/node02节点的haproxy尝试绑定VIP:6443,但是VIP此时在rocky节点,所以其它节点的haproxy报错,当前环境下haproxy必须在拿到VIP的节点才能绑定VIP:6443。
(4)解决方法
目前另外两个节点无法启动haproxy,折中解决方案是停止非VIP节点的HAProxy服务,仅保留VIP所在节点的服务运行,以减少报错与不必要资源消耗。
#在node01/node02节点停止haproxy
systemctl stop haproxy
(5)不足
该方案虽然临时解决了其它节点的报错和资源消耗,但还是存在不足:
单点故障:
如果rocky节点或其上的haproxy进程崩溃,那么整个k8s控制平面将无法访问,即使node01、node02节点正常。
手动切换时间成本高:
故障发生后,人工介入启动其它节点haproxy的时间可能较长,影响系统稳定与持续运行。
2、增加独立LB(LB主备)
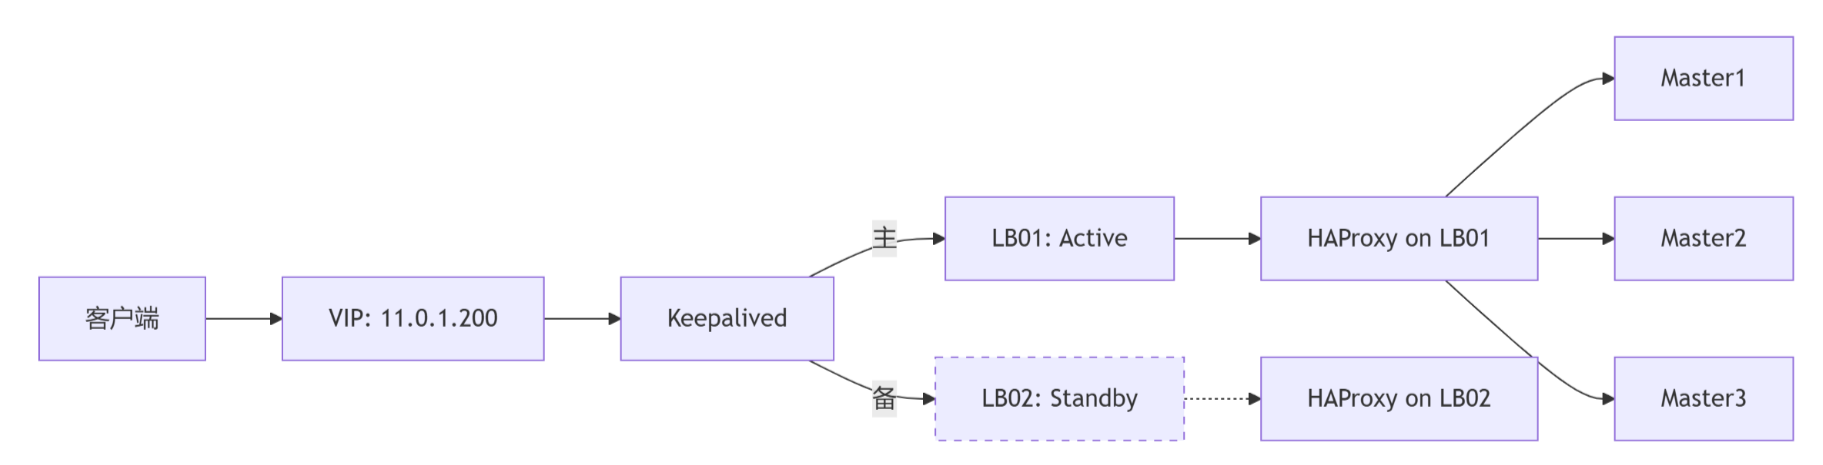
为解决LB与控制平面共存方案存在的问题,这里我们采用主流方案将LB与控制平面分离,增加两个单独的LB节点部署keepalived与haproxy。
(1)LB单独安装keepalived与haproxy
#在LB01(11.0.1.181)与LB02(11.0.1.182)执行,不同系统命令略有偏差
yum install -y keepalived haproxy	#RHEL
apt install -y keepalived haproxy	#Ubuntu
(2)配置keepalived
LB01(11.0.1.181)
vim /etc/keepalived/keepalived.conf
vrrp_instance VI_1 {
    state MASTER
    interface ens160
    virtual_router_id 51
    priority 100
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        11.0.1.200
    }
}
LB02(11.0.1.181)
vrrp_instance VI_1 {
    state BACKUP
    interface ens160
    virtual_router_id 51
    priority 90
    advert_int 1
    authentication {
        auth_type PASS
        auth_pass 1111
    }
    virtual_ipaddress {
        11.0.1.200
    }
}
(3)配置haproxy
#LB01和LB02都安装修改为同样的配置
vim /etc/haproxy/haproxy.cfg
frontend kubernetes_api
    bind 11.0.1.200:6443
    mode tcp
    default_backend kubernetes_api_backend

backend kubernetes_api_backend
    mode tcp
    balance roundrobin
    server rocky 11.0.1.173:6443 check
    server node01 11.0.1.174:6443 check
    server node02 11.0.1.175:6443 check
(4)LB节点启动keepalived与haproxy
systemctl enable --now keepalived && systemctl enable --now haproxy
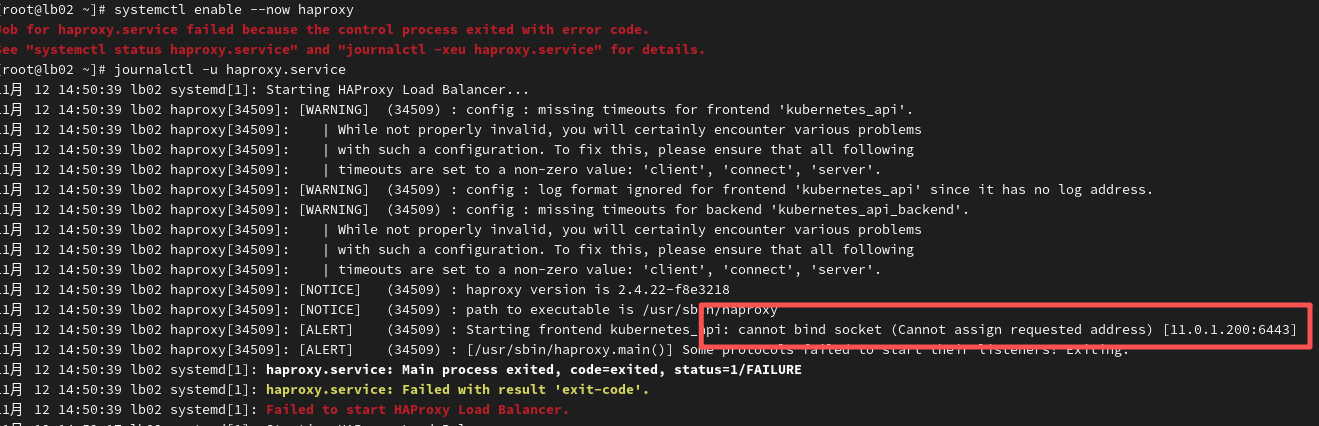
#修改LB01和LB02的HAProxy配置,将bind地址改为0.0.0.0
vim /etc/haproxy/haproxy.cfg
bind 0.0.0.0:6443

#替换保存后再重启LB02的haproxy
systemctl restart haproxy
ss -ntlp |grep 6443
可以看到,此时,LB01和LB02节点的haproxy均正常运行。
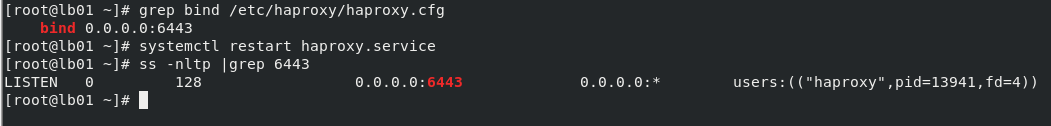
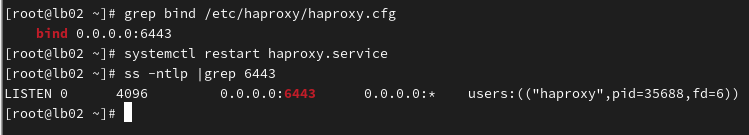
(5)验证LB层的工作模式(主备)
这套独立LB的主备架构,通过VIP高可用、LB主备、控制平面多活的方式解决之前LB与控制平面共存的单点故障、人工操作费时等问题,LB02充当备用节点,它可以提前预热进程充当热备,当VIP漂移到LB02时,它已经准备好了,只需接过VIP即可服务。
但它未能实现真正意义上的LB双活负载均衡,流量仅由主节点承担没有被两个LB节点分摊,且仍然存在单点瓶颈与资源消耗的问题,下面我们进行验证。
在LB01节点关闭keepalived,观察VIP漂移,同时查验集群状态
#LB01
systemctl stop keepalived
ip a |grep 200
ss -ntlp |grep 6443

#LB02
ip |grep 200
ss -ntlp |grep 6443

#master控制平面(rocky/node01/node02)执行
kubectl get nodes -owide
curl -k https://11.0.1.200:6443/readyz  # VIP
curl -k https://11.0.1.181:6443/readyz  # LB01
curl -k https://11.0.1.182:6443/readyz  # LB02
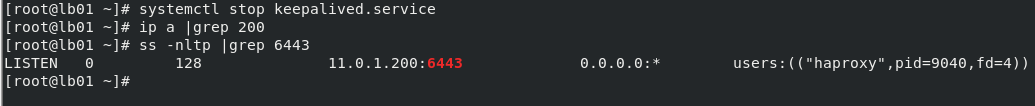
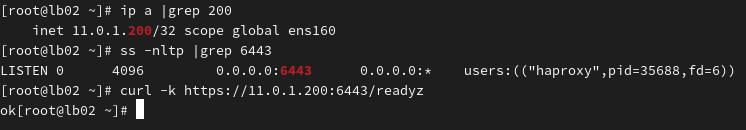
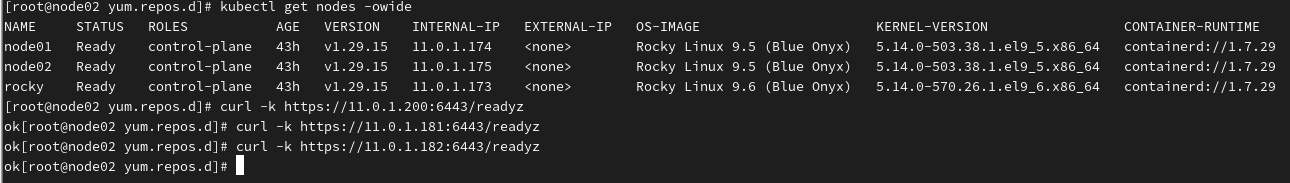
从某个节点不断向VIP发送请求
while true;do curl -k https://11.0.1.200:6443/readyz;sleep 1;done

在LB01抓包
#启动之前停掉的LB01的keepalived,VIP飘到LB01
systemctl start keepalived
ip a |grep 200
#等VIP飘到LB01,用tcpdump抓包
tcpdump -i any -n host 11.0.1.200 and port 6443
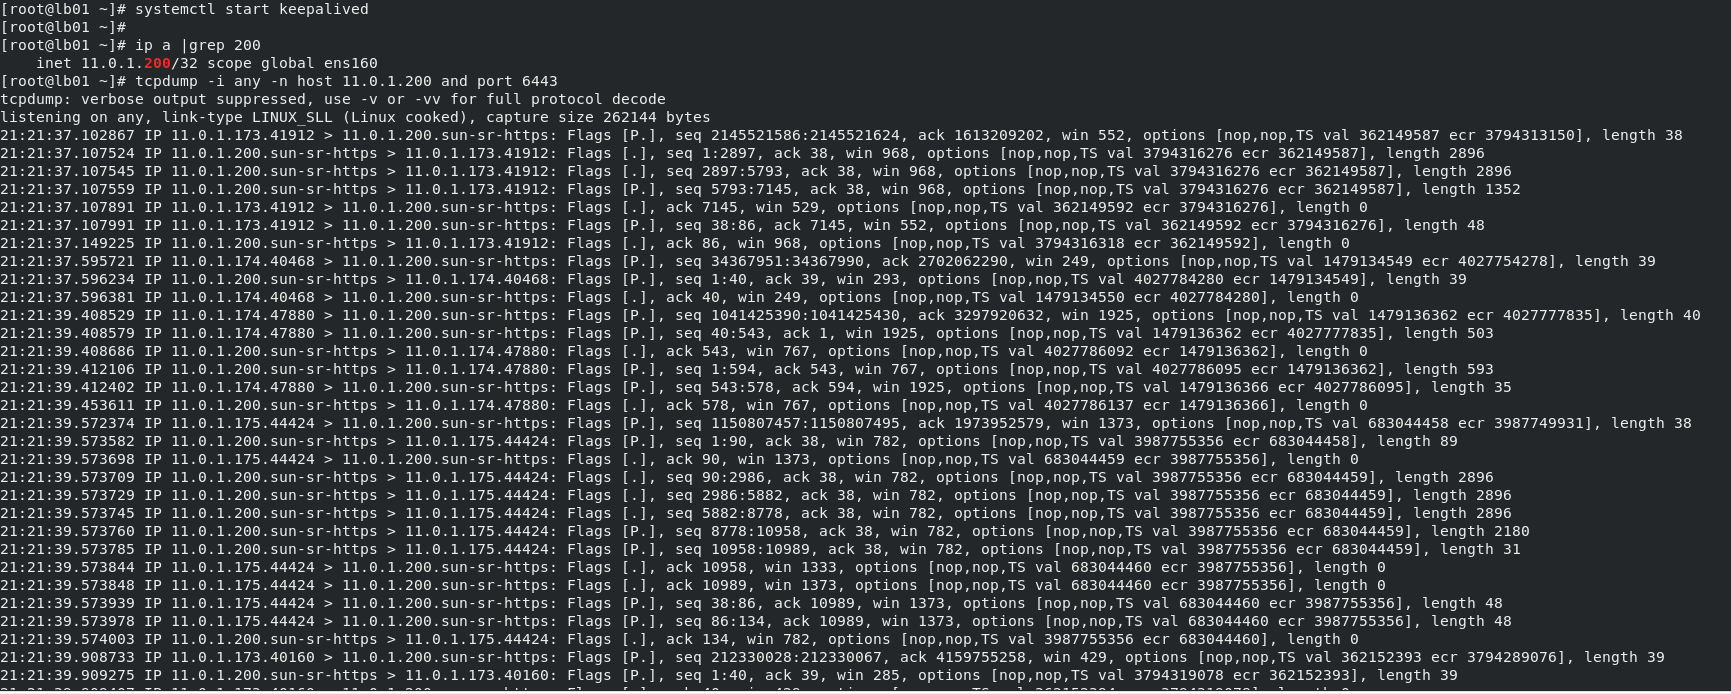
在LB02也实时抓包
tcpdump -i any -n host 11.0.1.200 and port 6443
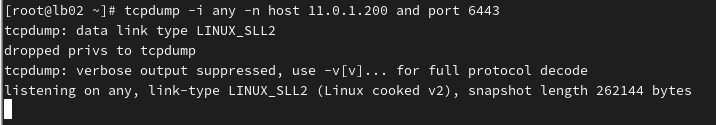
可以看到,LB01的tcpdump窗口会刷屏,显示TCP握手与数据包(ACK),而LB02没有动静,这里说明流量只流向了当前持有VIP的节点,备用节点虽然进程在运行端口在监听,但是不处理VIP的流量。
所以现在只是入口层高可用+LB主备,还没有做到VIP层的主动负载均衡,这个留待后续优化。
七、总结与反思
通过本次构建k8s三节点高可用控制平面的过程,我进行了以下总结与反思:
1、架构误区
初始误区:一开始我尝试了在各个master节点都部署keepalived与haproxy,导致了端口冲突,暴露了我对于高可用与负载均衡的混淆;
方案优化:在此次过程中,我从VIP代理三master节点,到LB与控制平面共存的方案,最后递进到增加独立LB以实现LB与控制面分离;
最终架构:最终我采用的是keepalived+haproxy主备模式,为集群提供一个高可用的VIP入口。
2、结论
本文方案的最终本质是主备高可用,它通过VIP漂移确保服务连续性,解决了单点故障,实现了VIP高可用、LB主备、控制面多活、etcd多数派选举。
同时,经过各种验证也得出本文的方案并非LB“双活”负载均衡,真正意义上的负载均衡(如LVS/DR)是该方案下一阶段的方向与目标。
本文写作过程中,我使用了AI助手作为协作工具,特别感谢其在技术细节梳理、架构图绘制以及语言表达优化方面提供的辅助。
更多推荐

 29
 0
- 0


 已为社区贡献2条内容

所有评论(0)