
深度解析 Hadoop 核心技术:从架构原理到实战优化
深度解析 Hadoop 核心技术:从架构原理到实战优化
在 TB/PB 级海量数据处理场景中,Hadoop 凭借分布式存储与计算的核心优势,成为大数据生态的基石。无论是互联网日志分析、金融风控建模,还是政务数据治理,其三大核心组件(HDFS、MapReduce、YARN)的协同机制,完美解决了传统单机架构 "存不下、算得慢、易丢失" 的痛点。本文将从底层架构出发,结合实战场景拆解核心技术,助力开发者快速掌握 Hadoop 核心能力。
一、Hadoop 核心架构:三大组件的协同逻辑
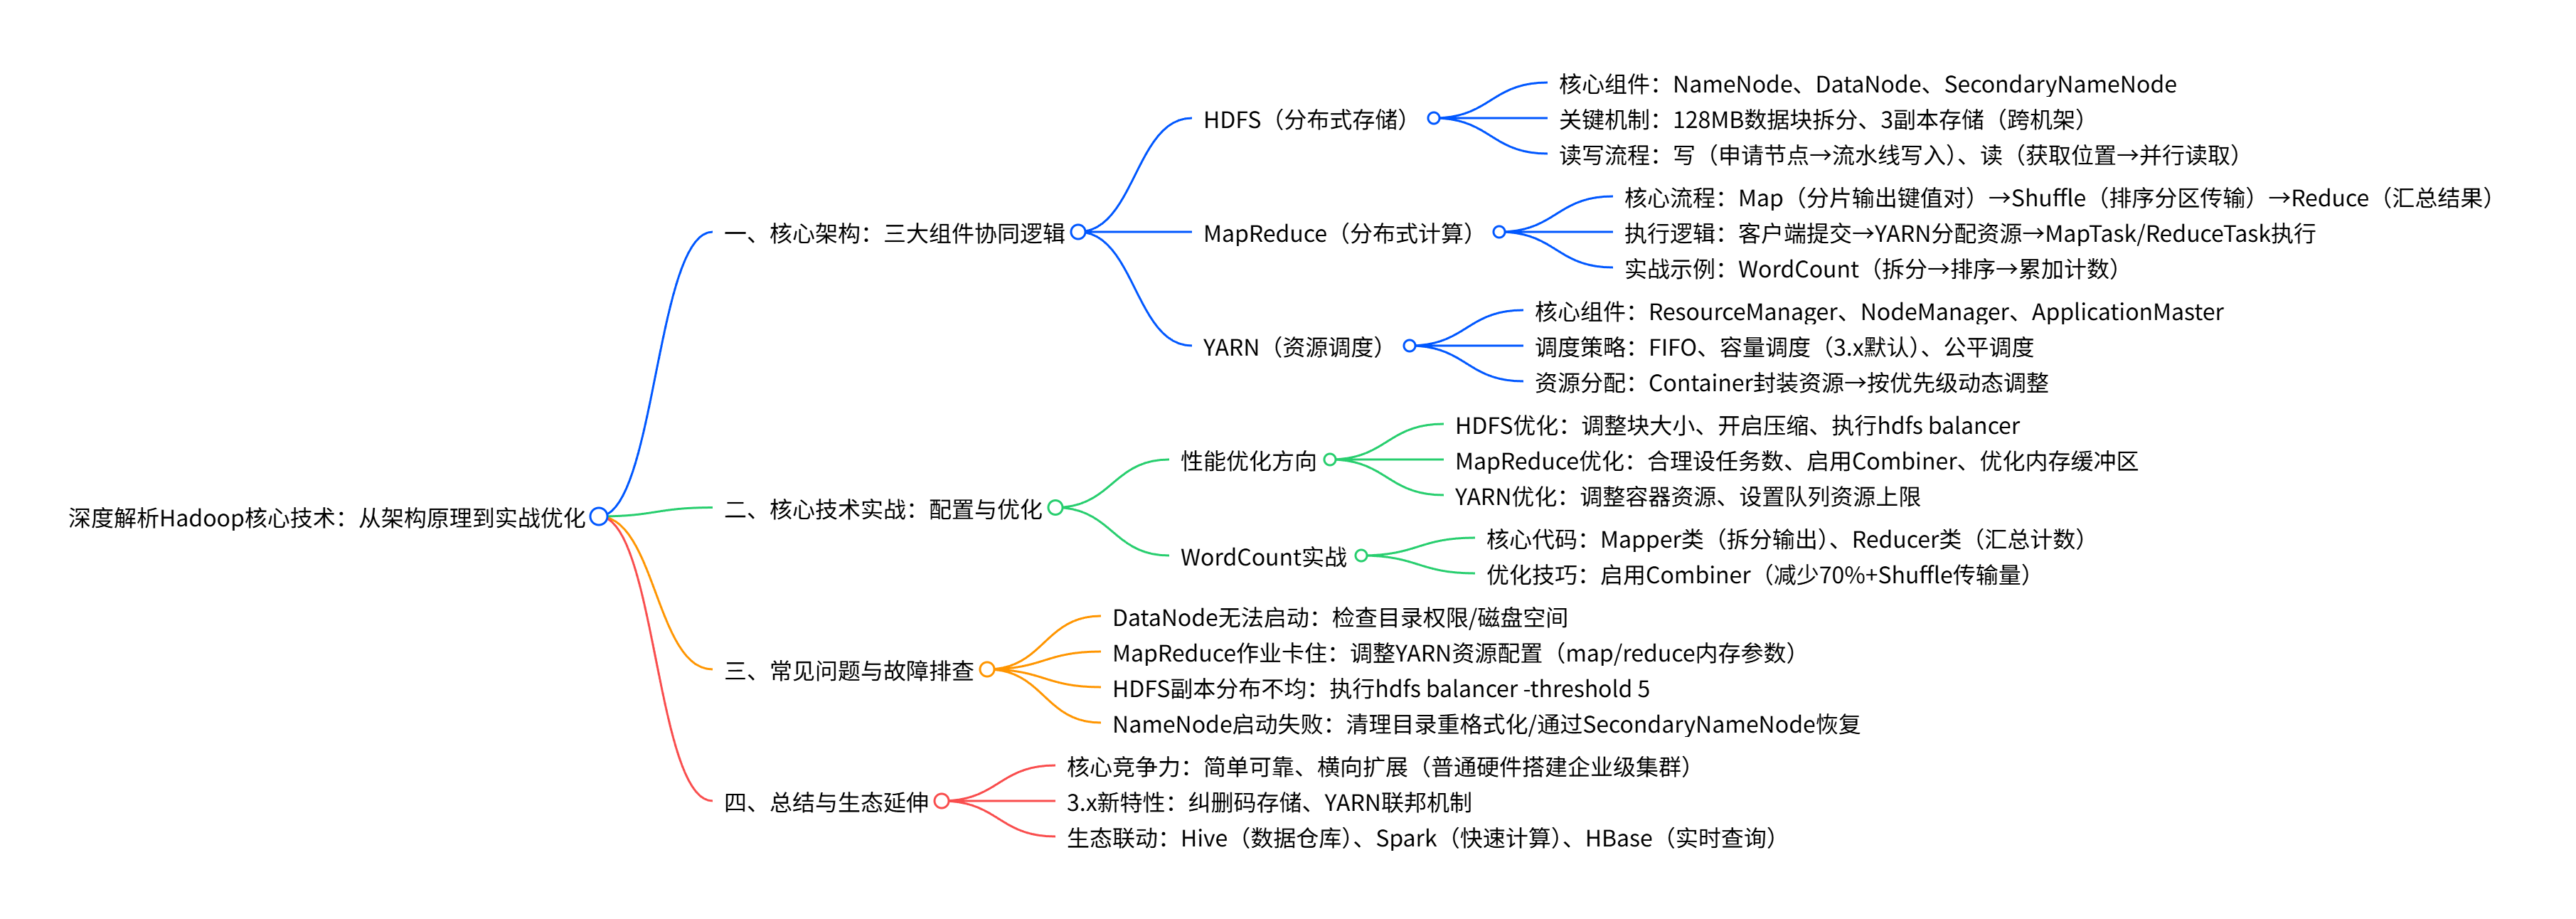
Hadoop 的核心价值在于 "分布式协同",通过 HDFS(存储层)、MapReduce(计算层)、YARN(资源调度层)的三层架构,实现 "存算一体" 的高效数据处理闭环。三者如同大数据处理的 "铁三角",分工明确又深度联动:HDFS 负责海量数据的可靠存储,MapReduce 提供分布式计算框架,YARN 则通过资源调度确保集群高效运行。
1. HDFS:分布式存储的 "数据仓库"
HDFS 采用主从架构(Master/Slave),核心解决 "海量数据如何安全存储" 的问题。
- 核心组件:NameNode 作为 "主节点",管理文件命名空间和数据块映射;DataNode 作为 "从节点",负责实际数据存储与读写操作;SecondaryNameNode 定期合并元数据日志,优化 NameNode 启动效率。
- 关键机制:默认 128MB 的数据块(Block)拆分策略,将大文件拆解为小数据块分布式存储;副本机制(默认 3 份副本)确保硬件故障时数据不丢失,副本优先存储在不同机架节点,兼顾可靠性与传输效率。
- 读写流程:写数据时客户端先向 NameNode 申请存储节点,再通过流水线模式将数据写入多个 DataNode;读数据时先获取数据块位置,再从多个 DataNode 并行读取,大幅提升吞吐量。
2. MapReduce:分布式计算的 "分工引擎"
MapReduce 是 Hadoop 的计算核心,通过 "分而治之" 的思想将复杂任务拆解为并行可执行的子任务。
- 核心流程:分为 Map、Shuffle、Reduce 三个阶段。Map 阶段对输入数据分片处理,输出中间键值对;Shuffle 阶段负责中间数据的排序、分区与传输,是性能优化的关键;Reduce 阶段汇总相同键的中间结果,输出最终计算结果。
- 执行逻辑:客户端提交作业后,YARN 分配资源启动 MapTask 与 ReduceTask,MapTask 本地处理数据后排序溢写,ReduceTask 拉取数据并归并计算,全程无需人工干预分布式细节。
- 实战示例:经典的 WordCount 任务中,Map 阶段拆分文本并输出 "单词:1" 键值对,Shuffle 阶段按单词分区排序,Reduce 阶段累加相同单词的计数结果,完成分布式统计。
3. YARN:集群资源的 "智能调度员"
YARN 作为资源管理系统,解决 "集群资源如何合理分配" 的问题,支持多计算框架共享集群资源。
- 核心组件:ResourceManager 负责全局资源调度,NodeManager 管理单节点资源,ApplicationMaster 为每个作业申请资源并监控任务执行。
- 调度策略:支持 FIFO(先来先服务)、容量调度(多队列资源隔离)、公平调度(动态资源分配)三种模式,Hadoop 3.x 默认采用容量调度,适配多租户共享集群场景。
- 资源分配:通过 Container 封装 CPU、内存等资源,根据作业优先级动态调整资源配额,避免单一作业独占集群资源。
二、核心技术实战:关键配置与优化技巧
1. 性能优化核心方向
- HDFS 优化:调整块大小(大文件设为 256MB,小文件合并存储),开启数据压缩(Snappy/Gzip 编解码器),定期执行 hdfs balancer 均衡副本分布。
- MapReduce 优化:合理设置 Map/Reduce 任务数(Map 数≈数据分片数,Reduce 数根据输出规模调整),启用 Combiner 减少 Shuffle 阶段数据传输,优化内存缓冲区(默认 100MB,可按需扩容)。
- YARN 优化:根据集群规模调整容器资源(yarn.nodemanager.resource.memory-mb),设置队列资源上限,避免资源争抢。
2. 经典实战案例:WordCount 核心代码
// Map阶段:拆分文本并输出键值对 public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable> { @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String[] words = value.toString().split(" "); for (String word : words) { context.write(new Text(word), new IntWritable(1)); } } } // Reduce阶段:汇总计数结果 public class WordCountReducer extends Reducer<Text, IntWritable, Text, IntWritable> { @Override protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int sum = 0; for (IntWritable value : values) { sum += value.get(); } context.write(key, new IntWritable(sum)); } }
提交作业时启用 Combiner 优化:job.setCombinerClass(WordCountReducer.class),可减少 70% 以上的 Shuffle 数据传输量。
三、常见问题与故障排查
- DataNode 无法启动:检查数据目录权限或磁盘空间,确保
dfs.datanode.data.dir配置路径存在且可写。 - MapReduce 作业卡住:排查 YARN 资源配置不足,调整
mapreduce.map.memory.mb和mapreduce.reduce.memory.mb参数。 - HDFS 副本分布不均:执行
hdfs balancer -threshold 5命令,将节点存储差异控制在 5% 以内。 - NameNode 启动失败:清理旧数据目录后重新格式化,或通过 SecondaryNameNode 的镜像文件恢复元数据。
四、总结与生态延伸
Hadoop 的核心竞争力在于 "简单可靠、横向扩展",基于普通硬件即可搭建企业级大数据集群。随着技术演进,Hadoop 3.x 引入的纠删码存储(Erasure Coding)、YARN 联邦机制等新特性,进一步提升了存储效率和集群扩展性。
在实际应用中,Hadoop 常与 Hive(数据仓库)、Spark(快速计算)、HBase(实时查询)等组件联动,构建完整的大数据处理链路。掌握其核心技术,不仅能解决海量数据处理难题,更能为后续学习大数据生态其他组件奠定基础。
更多推荐

 11
 0
- 0


 已为社区贡献12条内容

所有评论(0)