
从《孙子兵法》到大模型:AI 系统真正的力量来自标签体系
所有 AI 的底层逻辑,都是“标签”
在互联网行业,我们早就习惯了“标签”这一概念:
在电商平台,商品被分成衣服、家电、户外用品,各种分类让人一眼就知道去哪儿找东西。
在视频网站,美食、旅行、科技这类标签让平台能把你可能感兴趣的内容摆在前面。
在广告系统中,人们的浏览习惯会被整理成不同“兴趣档案”,用来决定哪些广告应该出现。
……
不过,我在这篇文章里要讨论的“标签”,比互联网行业常见的那些分类要宽得多、深得多。
本文说的“标签”,其实是人类认知世界最基础也最核心的分类法。
在人类所有的智能活动中,有一件极其基础、几乎本能的能力——我们会把世界分门别类。
从“这是食物还是毒物”到“这是朋友还是敌人”,从“这是急症还是小感冒”到“这是优质客户还是潜在风险”,我们的每一次判断、每一次选择,都依赖某种形式的“标签”。
AI 也不例外,无论它表现得多么聪明,本质上仍然是:通过标签来理解世界,通过标签来做出选择。
在我从事AI系统落地的这些年里,看得越多越深,就越是确信:如果一个 AI 系统无法有效地给处理对象打标签,它就无法在真实世界解决实际问题。
AI 需要能解决问题的“标签”
标签其实是分类的直观体现。而分类并没有唯一的答案——从不同的出发点,看见的就是不同的世界;想解决不同的问题,就会需要不同的分类体系。
同一辆车,可以按品牌分为德系、日系、美系;可以按排量来分为高排低排;也可以按用途来分为代步、越野、商务; 还可以按能耗分为燃油、混动、电车……哪种分类是对的?都对,但也都不够。关键在于:它们服务的是完全不同的目的。
在以解决问题为目标的现实工作中,我们逻辑永远是:先有任务目标,再定义标签体系。
比如,当你因为咳嗽、流鼻涕去内科,医生会根据你的症状做出诊断,到底是 “上呼吸道感染”、“过敏性鼻炎”,还是“流感”。其实就是给你贴上类似病症这样一个 “标签”。
这个标签看似简单,却直接决定了后续的治疗路径:不同的病症,对应完全不同的药物、剂量和恢复策略。
医院的标签体系,以及各行各业的标签体系,其存在目的都是为了识别服务对象/待解决问题的特征,从而提供服务/解决问题。
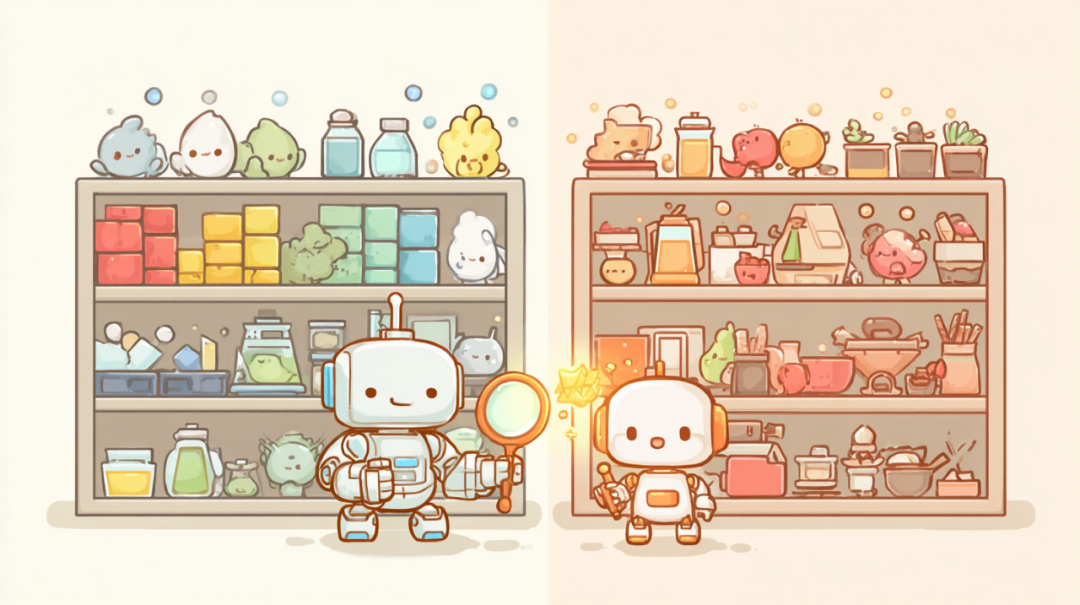
这正是我们在 AI 应用中需要理解的核心:现实世界的标签不是学术意义上的“按属性归类”,而是任务导向的,是为了解决具体问题而设计的。
也正因为如此,AI 在落地到真实场景时,几乎从来不能靠“通用标签”解决问题,而是必须重新建立面向任务的标签体系。
从《孙子兵法》看通用标签与专属标签的区别
如果说前面医院的例子展示了“标签如何帮助我们理解并解决一个现实问题”,那么《孙子兵法》中的“五危”,则更进一步展示了通用标签体系与专属标签体系的本质区别。
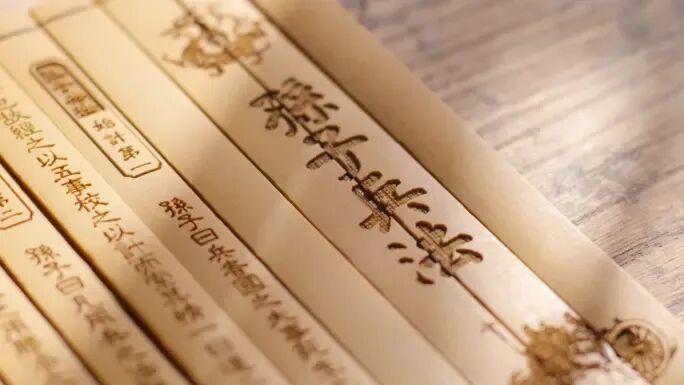
故将有五危,必死可杀,必生可虏,忿速可侮,廉洁可辱,爱民可烦。
《孙子兵法·九变篇》
短短的一句话,却既对“将”这个主体进行了分类,又依据不同分类分别给出了解决方案。
必死、必杀、忿速、廉洁、爱民 —— 这五个词是战争场景中,针对主将的“战场标签体系”作用于主将后所产生的结果的总和。也就是“将之危“(将领可能面临的五种固有风险)这个标签类型的标签的取值范围。
在我们用这个标签类型给具体的某位将领分类后,就会得出五种取值中的一种,相应的也就知道了这个将领的行为模式和价值体系最终会将他带入到五大类风险中的哪一类上。
这样分类的目的,则是为了决定“如何用人”或“如何克敌” —— 如果这名被分类的将领是己方的,标签帮助统帅识别和预防风险;如果他是敌方的,标签帮助制定针对性的战术。也就是说:给主将如此打标签的最终目的,是为了赢下战争。
由此可见,标签是否有效,取决于它能否支撑场景中的具体决策。
同样是在春秋战国时代,有一套更加广为人知的分类体系:礼、乐、射、御、书、数,也就是“君子六艺”。
“君子六艺”是一套典型的通用教育与选拔体系。它关注一个人平日里的学习能力、行为举止与综合素质,因此被用于教育和选拔年轻人才。
然而,这种通用分类方式,无法直接指导战场上的用人,也无法预测一名将领在战争环境中的真实表现。
毕竟,六艺只考察“一个人在和平环境中的样子”,却无法揭示“他在极端压力下会做什么”——一个人礼仪周全,不代表他不会在战场上冲动妄进;射艺出色,也不意味着他能稳住人心;书数精熟,更不能保证他不会在关键时刻犹豫不决。
六艺描述的是教育与文化层面的能力,而战争需要判断的是行为模式、价值取向和风险倾向。这正是《孙子兵法》提出“五危”的意义所在!
“五危”这五种风险标签,只有在真实的战场中,在资源紧张、局势不明、生命受到威胁的环境下,一个主将的决定方式、性格弱点与行为倾向才会被彻底暴露出来。
没有真实作战,就不可能准确判断一个将领究竟会落入“五危”中的哪一种;也就是说,五危是一套必须依赖实战数据才能建立的标签体系。
因此,六艺是一套通用标签,而五危则是一套专属标签。前者适用于课堂,后者适用于战场。两者之间没有直接映射,也不能相互替代。
当前的 AI 在真实世界中落地,往往面对困境:今天的大模型,看起来天文地理古今中外仿佛无所不能。却不知道在某个场景里应该关注什么、忽略什么、如何决策并不直接对应真实问题。
在企业应用中,我们需要的往往是“能够基于任务给对象打上标签的模型”。
例如:供应链系统要按需求波动、供应可靠性来打标签;金融风控要按收入结构、还款行为、资产类型来打标签;客服系统要按用户意图、情绪、场景来打标签……
这些标签体系都是任务驱动,专属于某个领域中的某些场景的。与当前大模型默认的大众知识驱动的标签体系截然不同。
这也是为什么大模型在商业落地时,总会出现理解不够深入、判断不够精准的问题——不是它不聪明,而是它没有那套场景专属的标签体系。
AI 要真正进入现实,就必须从“知道很多事”走向“知道这件事里什么最重要”。而“建立专属标签体系”就是让 AI 获得这种能力的途径。
标签是客观的,偏见是主观的
在讨论标签时,人们常常会担忧:给事物贴标签,会不会导致偏见?这其实是把两件完全不同的事情混为一谈。
标签本质上只是分类方式,是对客观世界特征的整理与呈现。它不带褒贬,也不包含价值判断,就像气象学把天气分为晴、雨、雪一样,只是为了更清晰地描述现象。
偏见则是另一回事。偏见来自人类主观上为标签附加的社会意义,是一种价值判断,而不是标签本身造成的结果。
举个生活化的例子:如果说某地的人普遍喜欢咖啡,某地的人普遍喜爱大蒜,这只是事实描述,是标签化的表达方式而已。然而,一旦有人把“喝咖啡”与先进、优雅、高贵联系起来,把“吃大蒜”与落后、贫穷、粗俗挂上关系,偏见才由此产生。
因此,我们需要清晰区分两类标签:
事实标签(Factual Label):描述客观特征,不带情绪、不含价值判断;
评价标签(Value Label):人为附加褒贬色彩,容易引发偏见和歧视。
科学与工程上的标签体系必须坚持使用事实标签,避免评价标签。这一点对于 AI 尤为重要。
AI 的任务是理解世界,而事实标签能让系统更准确、更稳定地把握对象特征;评价标签则会让模型吸收人类的偏见,并在应用中放大偏差。
标签本身从不决定我们如何看待一个对象,决定我们态度的是我们赋予标签的主观解释——理解这一点,是构建公平、可控、可解释 AI 系统的基础。
AI 落地第一步:构建“专属标签体系”
对于AI,很多人会第一时间想到推理、预测、规划这些高阶能力。但在真实世界的 AI 工程中,所有高阶能力的前提是:先让 AI 看得懂世界,这就需要构建一套能够有效表达专属领域内问题和解决方案的标签体系。
在企业应用场景中,对模型的需要首先是执行明确任务,解决具体问题,这在很大程度上取决于模型在这个领域,能否用正确的标签体系组织信息、理解对象、判断风险与选择策略。
如果标签体系与业务任务不匹配,模型的判断必然会偏离目标;如果标签体系不够细致,模型对业务对象的理解一定会浮在表面;如果标签体系无法反映现实业务的动态变化,模型在关键决策点就会显得迟钝、失效。
换句话说:在企业级应用中,标签体系决定了 AI 系统的能力上限。没有专属标签体系的构建,就没有真正意义上的 AI 企业落地。
在我看来,未来的企业 AI 工程将越来越像是一门“专属标签体系设计学”。它的核心不是从推理能力开始,而是从 企业希望 AI 如何看待业务对象开始;不是从写代码开始,而是从如何将场景分解为可管理、可计算、可决策的标签维度开始。
当一个企业能够把真实业务场景中的关键因素抽取出来,形成贴合任务的标签体系,并让 AI 在这套体系下运行,模型才会真正具备解决问题的能力。这个体系越扎实、越贴近业务、越体现行业经验,AI 的价值就越能被释放。
欢迎关注微软 智汇AI 官方账号
一手资讯抢先了解

喜欢就点击一下 在看 吧~
更多推荐


 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)