
机器学习入门必懂:核心术语与算法分类全解析
一,机器学习入门必懂:核心术语与算法分类全解析
“样本”“有监督学习”等术语是机器学习的基础,算法分类是核心逻辑。
1,机器学习常用术语“大白话”
以“预测奶茶销量”为例,串联核心术语理解:
-
样本(数据):学习的“原材料”,如30天的“气温、销量”等每条数据,组合成样本集。
-
特征:样本的关键属性,如“气温、促销活动”,是模型判断的核心依据,选对特征决定预测精度。
-
标签:样本的“答案”,分类别型(如“是/否奶茶”)和连续型(如奶茶销量)。
-
训练集/测试集:训练集(70%-80%数据)教模型找规律,测试集(20%-30%数据)检验学习效果。
总结:样本=30天数据,特征=影响因素,标签=实际销量,训练集学规律、测试集验效果。
2、机器学习算法分类核心逻辑
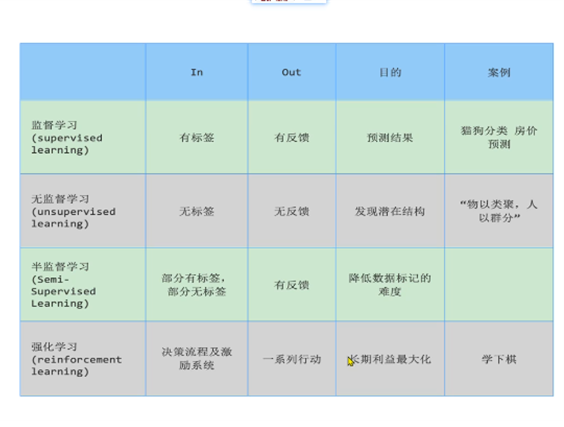
按数据是否有标签及学习方式,算法分四大类,核心区别是“有无标准答案(标签)”和“学习目标”。
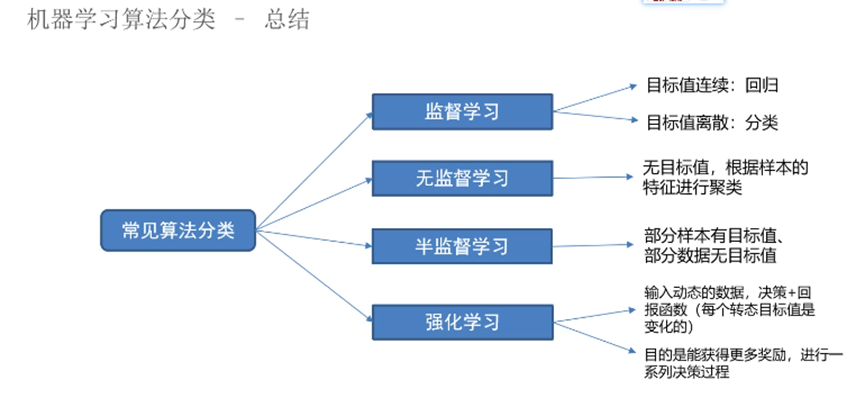
1). 有监督学习:“带着答案学”,最常用的入门算法
核心定义:训练数据“有特征有标签”,模型带“标准答案”学习,学会后预测新数据标签。
核心要求:需大量高质量标注数据,直接决定模型效果。
按标签类型分两类:
- 分类:预测类别型标签(数据不连续)。二分类(如垃圾邮件识别)、多分类(如猫狗鸟识别)。
常见算法:逻辑回归、决策树、支持向量机等。
回归:预测连续型标签(数据连续,如销量、气温)。常见算法:线性回归、梯度提升树等。
2). 无监督学习:“没有答案自己悟”,挖掘数据隐藏规律
核心定义:训练数据“只有特征无标签”,模型自主挖掘数据隐藏规律。
核心目标:发现数据相似性或关联性,核心应用是聚类。
聚类应用:电商用户分群(如学生党、职场人)、新闻内容分类(如科技、体育)。
常见算法:K-均值聚类、层次聚类等。
3). 半监督学习:“部分答案辅助学”,平衡数据成本与效果
核心定义:用“部分标签+大量无标签数据”学习,解决标签标注成本高的问题。
典型场景:手写汉字识别,用10%有标签数据引导,90%无标签数据提升效果。
4). 强化学习:“试错中找最优”,聚焦决策与奖励
核心定义:智能体通过与环境交互试错学习,根据“奖励/惩罚”调整策略,找到最优方案(如训练小狗握手)。
核心关键词:智能体、环境、动作、奖励、最优策略。
典型场景:自动驾驶(安全到达获奖励)、游戏AI(如AlphaGo赢棋获奖励)。
3、总结:一张图理清核心逻辑
核心知识点梳理:
-
基础术语:样本→特征→标签→训练集/测试集;
-
算法分类:有监督(分类/回归)、无监督(聚类)、半监督(平衡成本)、强化(试错找最优)。
-
二,特征工程概念入门
特征工程核心是结合业务背景,筛选、转换数据特征,让模型更高效学习规律。核心环节及精简解析如下:
**- 1. 特征提取:**从原始数据中提取任务相关特征,会改变原数据形态。如将“奶茶销售文本记录”提取为“促销时长”“口味关键词”等结构化特征。
**- 2. 特征预处理:**解决特征量纲、鲁棒性问题,统一特征影响力。核心手段包括:
归一化/标准化:消除量纲差异,如将“气温(℃)”与“销量(杯)”转为同一数值范围。
**3. 特征选择:**从多特征中筛选关键子集,不改变原数据。如预测奶茶销量时,保留“气温、促销”,剔除“门店装修”等无关特征。
**4. 特征降维:**降低特征维度,简化模型。如将“每日最高温、最低温、平均温”降为“温差”一个综合特征。
**5. 特征组合:**合并多特征生成新特征,增强表达力。如“气温≥30℃”与“有促销”组合为“高温促销”特征。
三,机器学习建模流程
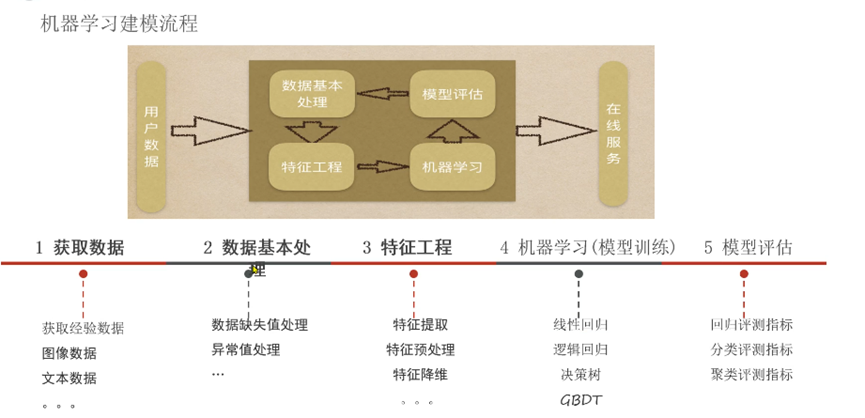
建模核心为“六步闭环”,以“预测奶茶销量”为例,步骤如下:
**- 1. 数据加载(采集):**采集目标相关数据(如气温、促销、销量),来源包括POS、气象平台等,保证全面性。
**- 2. 数据预处理:**处理缺失、异常、重复数据,如均值替换异常销量,插值补缺失值。
**- 3. 特征工程:**构造有效特征(如气温→是否高温),删除无关特征,提升模型效果。
**- 4. 模型训练:**选适配算法(回归用线性回归,分类用逻辑回归),训练集拟合特征与标签规律。
**- 6. 模型预测:**用合格模型预测新数据,定期用新数据重训维持效果。
**- 5. 模型评估:**测试集检验,回归看均方误差,分类看准确率,不达标则调整。
四,模型拟合问题全解析
拟合是模型对样本分布的模拟效果,核心看模型在训练集与测试集的表现,分为欠拟合、过拟合和正好拟合三类,其中欠拟合与过拟合是建模核心痛点。
1. 欠拟合:模型“学不会”规律
核心表现:训练集与测试集表现均较差,如预测奶茶销量时,误差始终很高。
核心原因:模型过于简单,无法捕捉特征与标签的关联,如用线性模型拟合复杂的“气温+促销+客流量”与销量的关系。
解决办法:① 提升模型复杂度,如将线性回归换为梯度提升树、神经网络等;
② 优化特征工程,增加高价值特征(如“客流量”“竞品活动”)或构建特征组合(如“高温+周末”);③ 减少正则化约束(若有),避免过度限制模型学习能力。
2. 过拟合:模型“死记硬背”训练集
核心表现:训练集表现极好(误差极低),但测试集表现差,如在训练集上精准预测销量,换新数据后误差骤升。
核心原因:模型过复杂、训练数据少或数据不纯,如用高阶模型学习少量含异常值的销量数据,连异常值规律都“死记”下来。
解决办法:① 简化模型,如裁剪决策树深度、选用线性模型,契合奥卡姆剃刀原则;
② 扩充训练数据,增加样本量或通过数据增强生成新样本(如调整销量数据的微小波动); ③ 数据清洗,剔除异常值、重复数据,保证数据纯度;
④ 加入正则化(如L1/L2正则),限制模型参数规模;
⑤ 采用交叉验证,用多组训练集-测试集拆分验证模型,减少偶然误差。
3. 泛化能力:模型的“实战能力”
泛化(Generalization)指模型在新数据集(非训练数据)上的表现,是衡量模型价值的核心指标。欠拟合与过拟合的本质都是泛化能力差。
4. 优化指引:奥卡姆剃刀原则
给定两个泛化误差相同的模型,优先选更简单的模型。这能从根源减少过拟合风险,也更易落地维护。
更多推荐


 24
 0
- 0


 已为社区贡献2条内容

所有评论(0)