
千问 0.5 大模型联邦学习代码实战
·
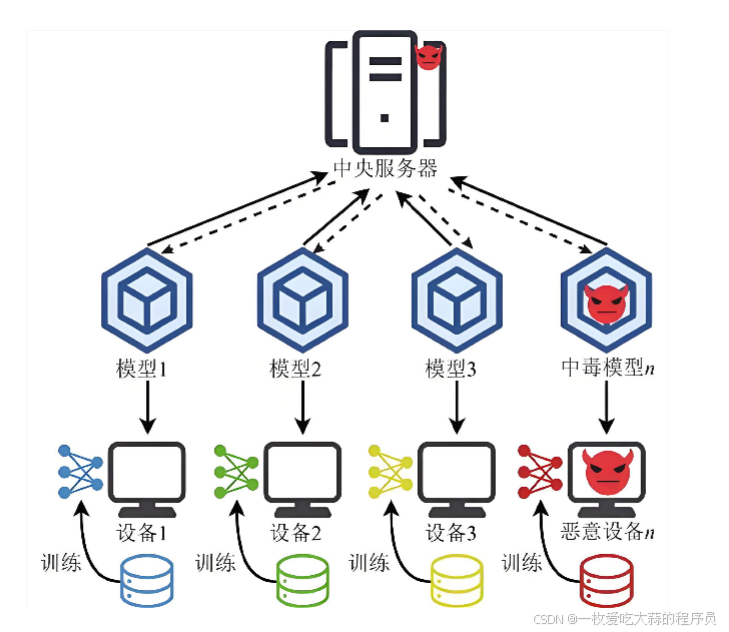
联邦学习(Federated Learning)的核心是 “数据不动模型动”:多个客户端在本地用私有数据训练模型,仅上传模型参数 / 梯度到服务器,服务器聚合后将新模型分发给客户端,反复迭代直至收敛。本示例模拟 3 个客户端 + 1 个服务器的联邦学习场景,任务为文本分类(基于情感分析数据)。
环境准备
先安装依赖:pip install flwr torch transformers datasets
pip install torch transformers datasets numpy
import sys
import numpy as np
import torch
import torch.nn.functional as F
from torch.utils.data import DataLoader
from transformers import DistilBertForSequenceClassification, DistilBertTokenizer
from datasets import load_dataset
import flwr as fl
from flwr.client import FlowerClient, start_client
from flwr.server import start_server
from flwr.server.strategy import FedAvg
from flwr.common import Context, Parameters, ndarrays_to_parameters, parameters_to_ndarrays


# -------------------------- 1. 模型与分词器定义 --------------------------
def get_model():
    """加载基础模型(替代千问0.5,这里用distilbert演示)"""
    model = DistilBertForSequenceClassification.from_pretrained(
        "distilbert-base-uncased", num_labels=2  # 二分类任务
    )
    return model

# 全局加载分词器(所有客户端共享)
tokenizer = DistilBertTokenizer.from_pretrained("distilbert-base-uncased")


# -------------------------- 2. 客户端数据准备(非IID分布) --------------------------
def prepare_client_data(num_clients=3):
    """拆分IMDb数据集,模拟非IID分布的客户端数据"""
    dataset = load_dataset("imdb")["train"]  # 加载电影评论数据集(正/负面分类)

    client_datasets = []
    for i in range(num_clients):
        # 每个客户端侧重不同类别(非IID特性)
        target_label = i % 2  # 客户端0/2侧重0类,客户端1侧重1类
        mask = dataset["label"] == target_label
        client_data = dataset.select(np.where(mask)[0])  # 筛选目标类别数据
        client_datasets.append(client_data)

    return client_datasets

# 预先生成3个客户端的数据集(全局变量,供客户端使用)
client_datasets = prepare_client_data(num_clients=3)


# -------------------------- 3. 数据预处理函数 --------------------------
def preprocess_function(examples):
    """对文本数据进行分词、截断和填充"""
    return tokenizer(
        examples["text"],
        truncation=True,
        max_length=128,  # 固定长度,便于批量处理
        padding="max_length"
    )


# -------------------------- 4. 联邦学习客户端实现 --------------------------
class FedClient(FlowerClient):
    def __init__(self, client_id, model, dataset):
        self.client_id = client_id
        self.model = model
        self.dataset = dataset

        # 预处理数据并创建DataLoader
        self.processed_dataset = self.dataset.map(preprocess_function, batched=True)
        self.processed_dataset.set_format("torch", columns=["input_ids", "attention_mask", "label"])
        self.dataloader = DataLoader(self.processed_dataset, batch_size=8)  # 批量大小8

    def get_parameters(self, context: Context):
        """获取本地模型参数(转为numpy数组)"""
        return ndarrays_to_parameters([
            p.cpu().detach().numpy() for p in self.model.parameters()
        ])

    def fit(self, parameters, context: Context):
        """本地训练:用全局参数初始化→训练→返回新参数"""
        # 1. 用服务器传来的全局参数更新本地模型
        params = parameters_to_ndarrays(parameters)
        for p, new_p in zip(self.model.parameters(), params):
            p.data = torch.tensor(new_p).to(p.device)  # 适配设备(CPU/GPU)

        # 2. 本地训练(1个epoch,简化演示)
        optimizer = torch.optim.Adam(self.model.parameters(), lr=1e-5)  # 优化器
        self.model.train()
        for batch in self.dataloader:
            # 提取批次数据
            input_ids = batch["input_ids"]
            attention_mask = batch["attention_mask"]
            labels = batch["label"]

            # 前向传播+计算损失
            outputs = self.model(
                input_ids=input_ids,
                attention_mask=attention_mask,
                labels=labels
            )
            loss = outputs.loss

            # 反向传播+参数更新
            loss.backward()
            optimizer.step()
            optimizer.zero_grad()

        # 3. 返回训练后的参数和本地数据量
        return self.get_parameters(context), len(self.dataset), {}

    def evaluate(self, parameters, context: Context):
        """简化评估:返回0(实际场景需计算准确率等指标)"""
        return 0.0, len(self.dataset), {}


def client_fn(context: Context):
    """客户端工厂函数(Flower框架调用)"""
    client_id = int(context.node_config["client_id"])  # 获取客户端ID
    model = get_model()  # 加载模型
    dataset = client_datasets[client_id]  # 分配对应ID的本地数据
    return FedClient(client_id, model, dataset)


# -------------------------- 5. 联邦学习服务器实现 --------------------------
def start_fl_server():
    """启动联邦学习服务器(聚合客户端参数)"""
    # 服务器策略:使用FedAvg算法聚合参数
    strategy = FedAvg(
        fraction_fit=1.0,  # 每次训练使用所有客户端
        fraction_evaluate=0.0,  # 简化:不进行评估
    )

    # 启动服务器(监听本地8080端口,训练3轮)
    start_server(
        server_address="0.0.0.0:8080",
        strategy=strategy,
        config={"num_rounds": 3}
    )


# -------------------------- 6. 启动入口(区分服务器/客户端) --------------------------
if __name__ == "__main__":
    # 通过命令行参数区分角色:server 或 client+ID
    if len(sys.argv) < 2:
        print("使用方式:")
        print("  启动服务器:python script.py server")
        print("  启动客户端:python script.py client 0(或1、2)")
        sys.exit(1)

    role = sys.argv[1]
    if role == "server":
        print("启动联邦学习服务器...")
        start_fl_server()
    elif role == "client" and len(sys.argv) == 3:
        client_id = int(sys.argv[2])
        print(f"启动客户端 {client_id}...")
        start_client(
            server_address="localhost:8080",
            client_fn=client_fn,
            client_id=client_id
        )
    else:
        print("参数错误!请参考使用方式。")
更多推荐

 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)