
利用 Ollama 在个人电脑上做大模型的本地部署 (MacOS 为例)
·
0, 原理
部署 LLM 到本地,主要是为了创建自用(个人,公司)环境。
写完这篇文章后,发现 CSDN 有很多类似的文章,下面这篇讲得超级详细。
1,实践
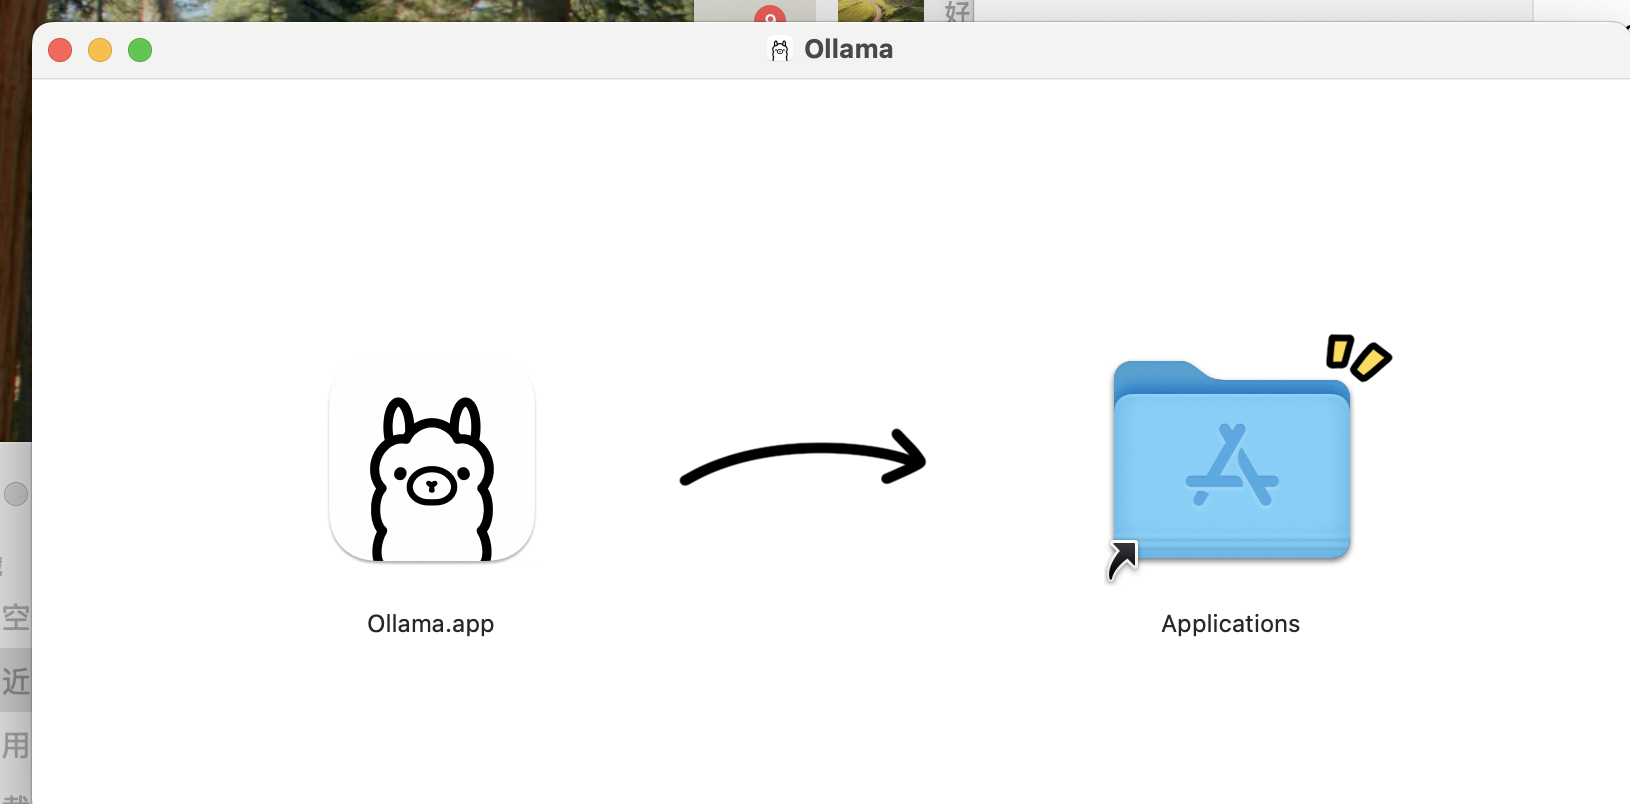
download ollama 并安装
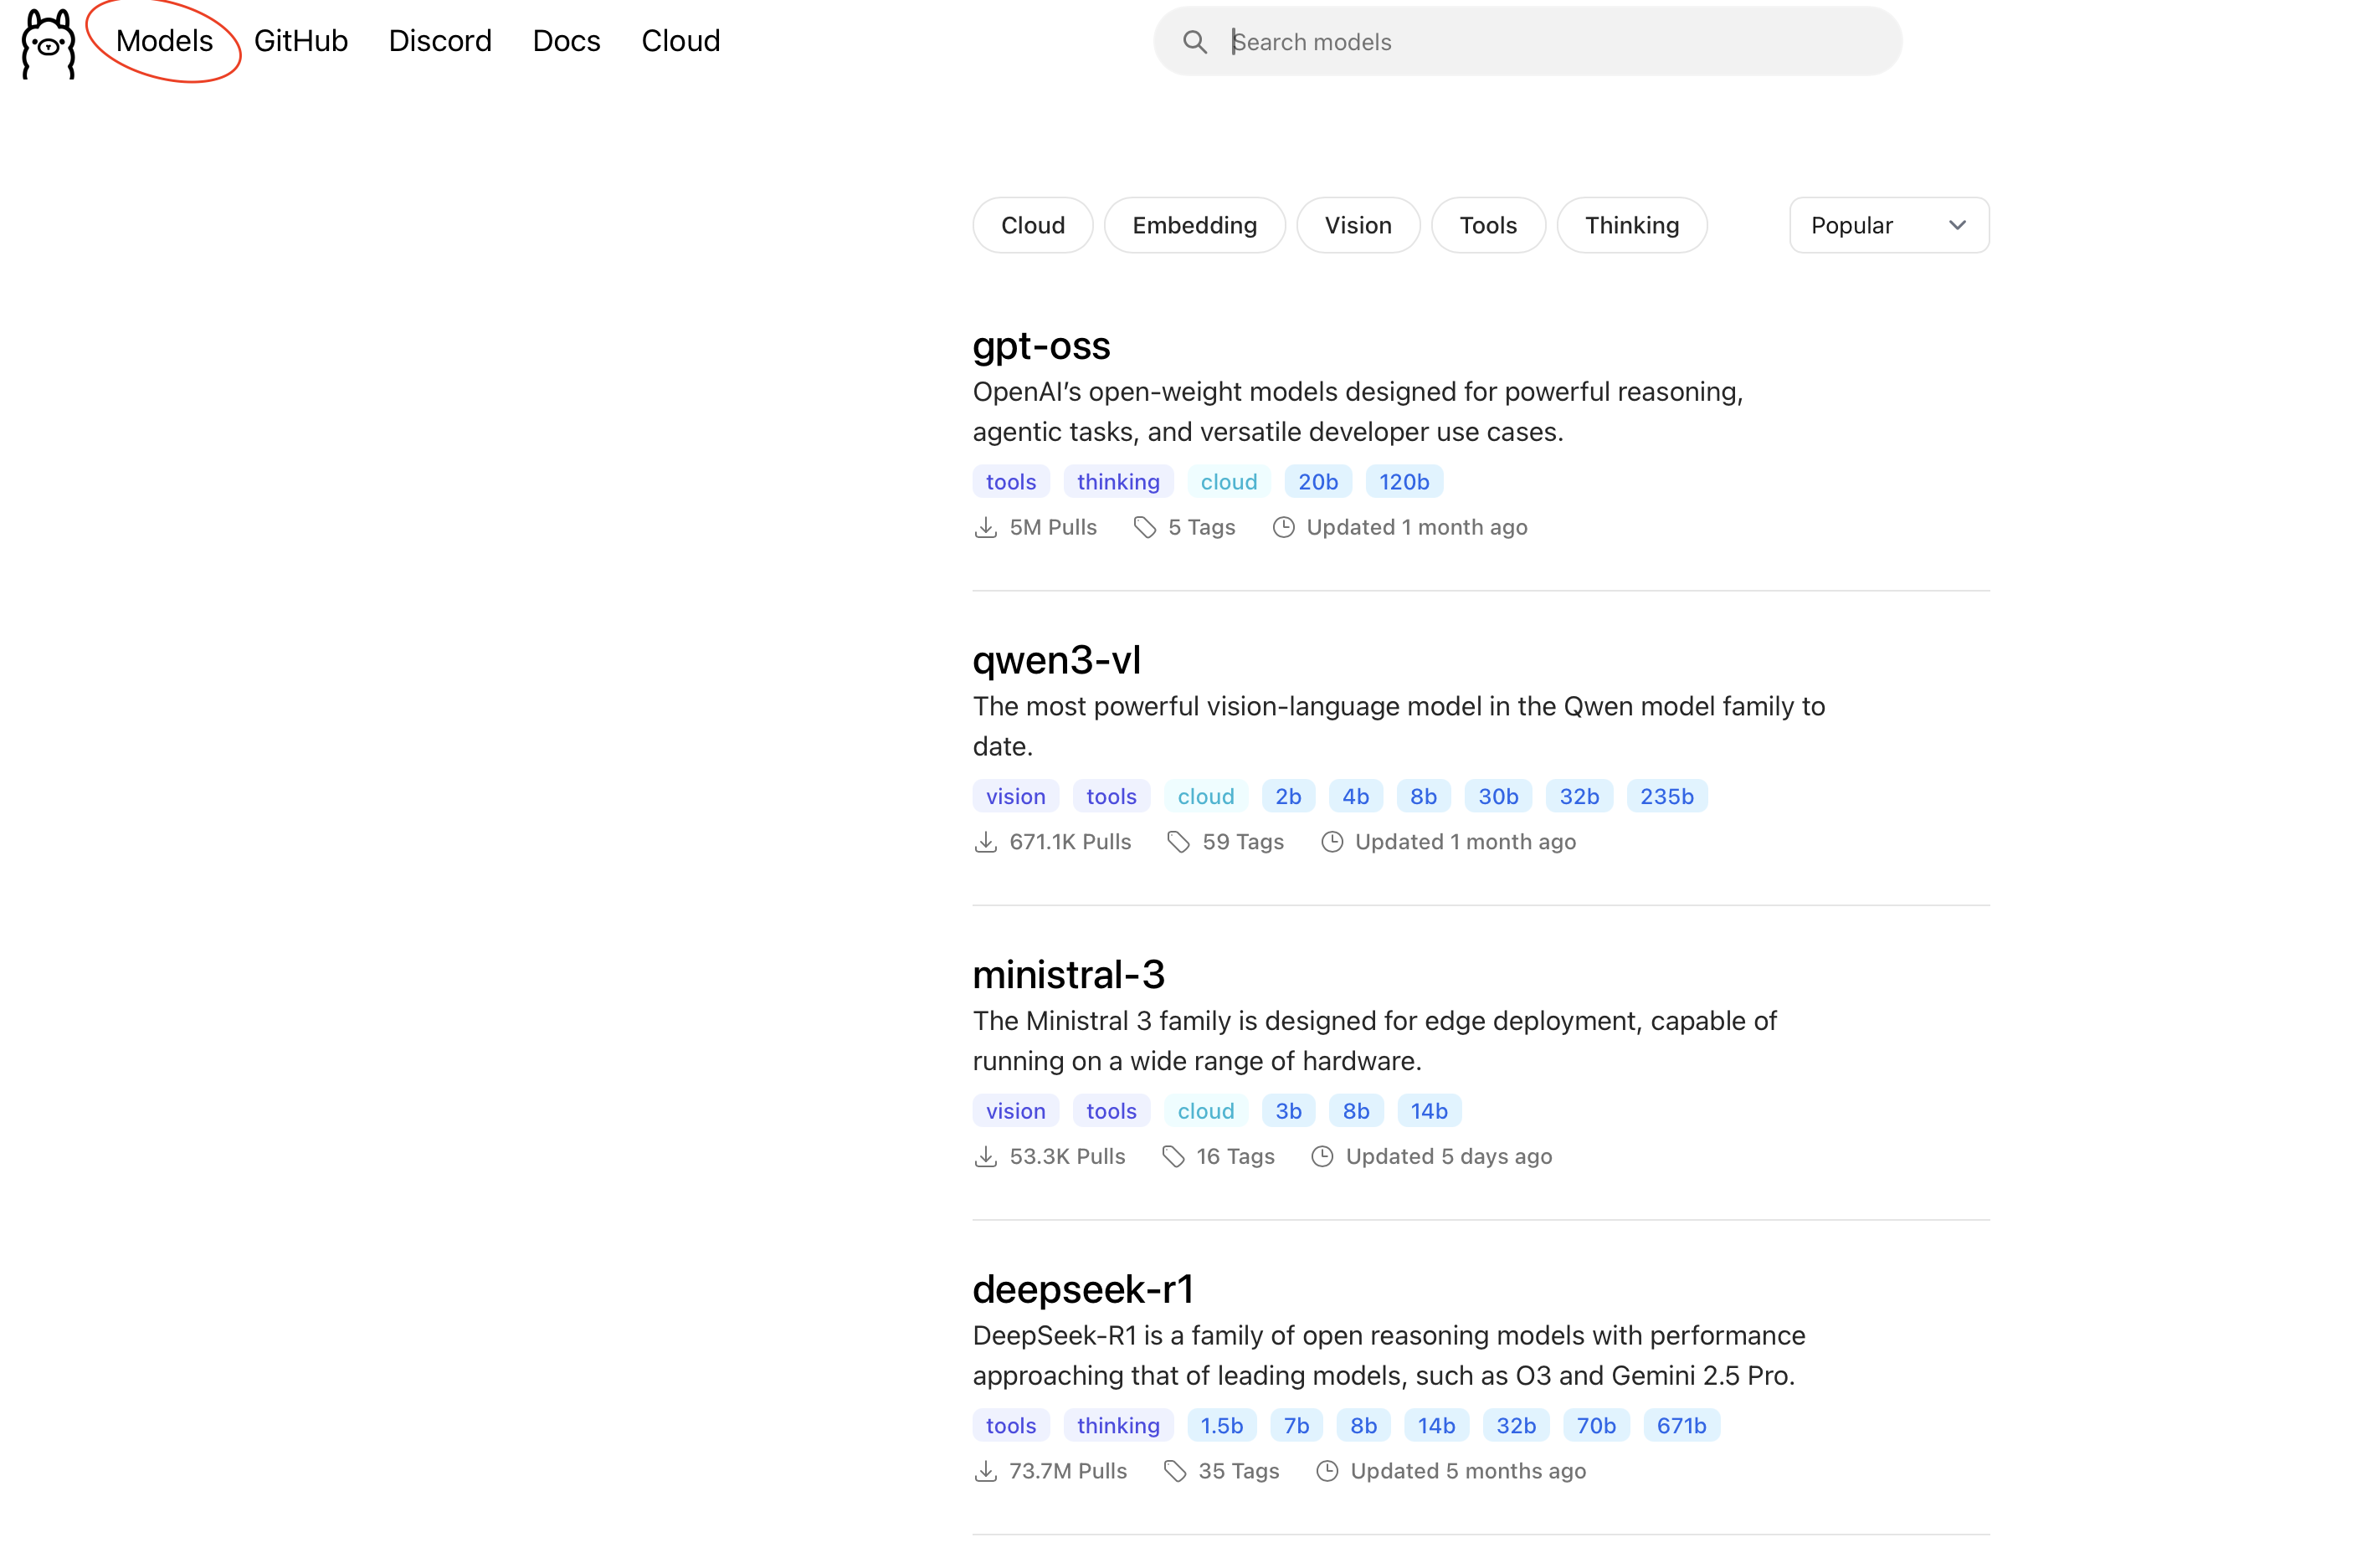
2) https://ollama.com/ 网页中选择 Models。有各种 开源 model 可供使用。
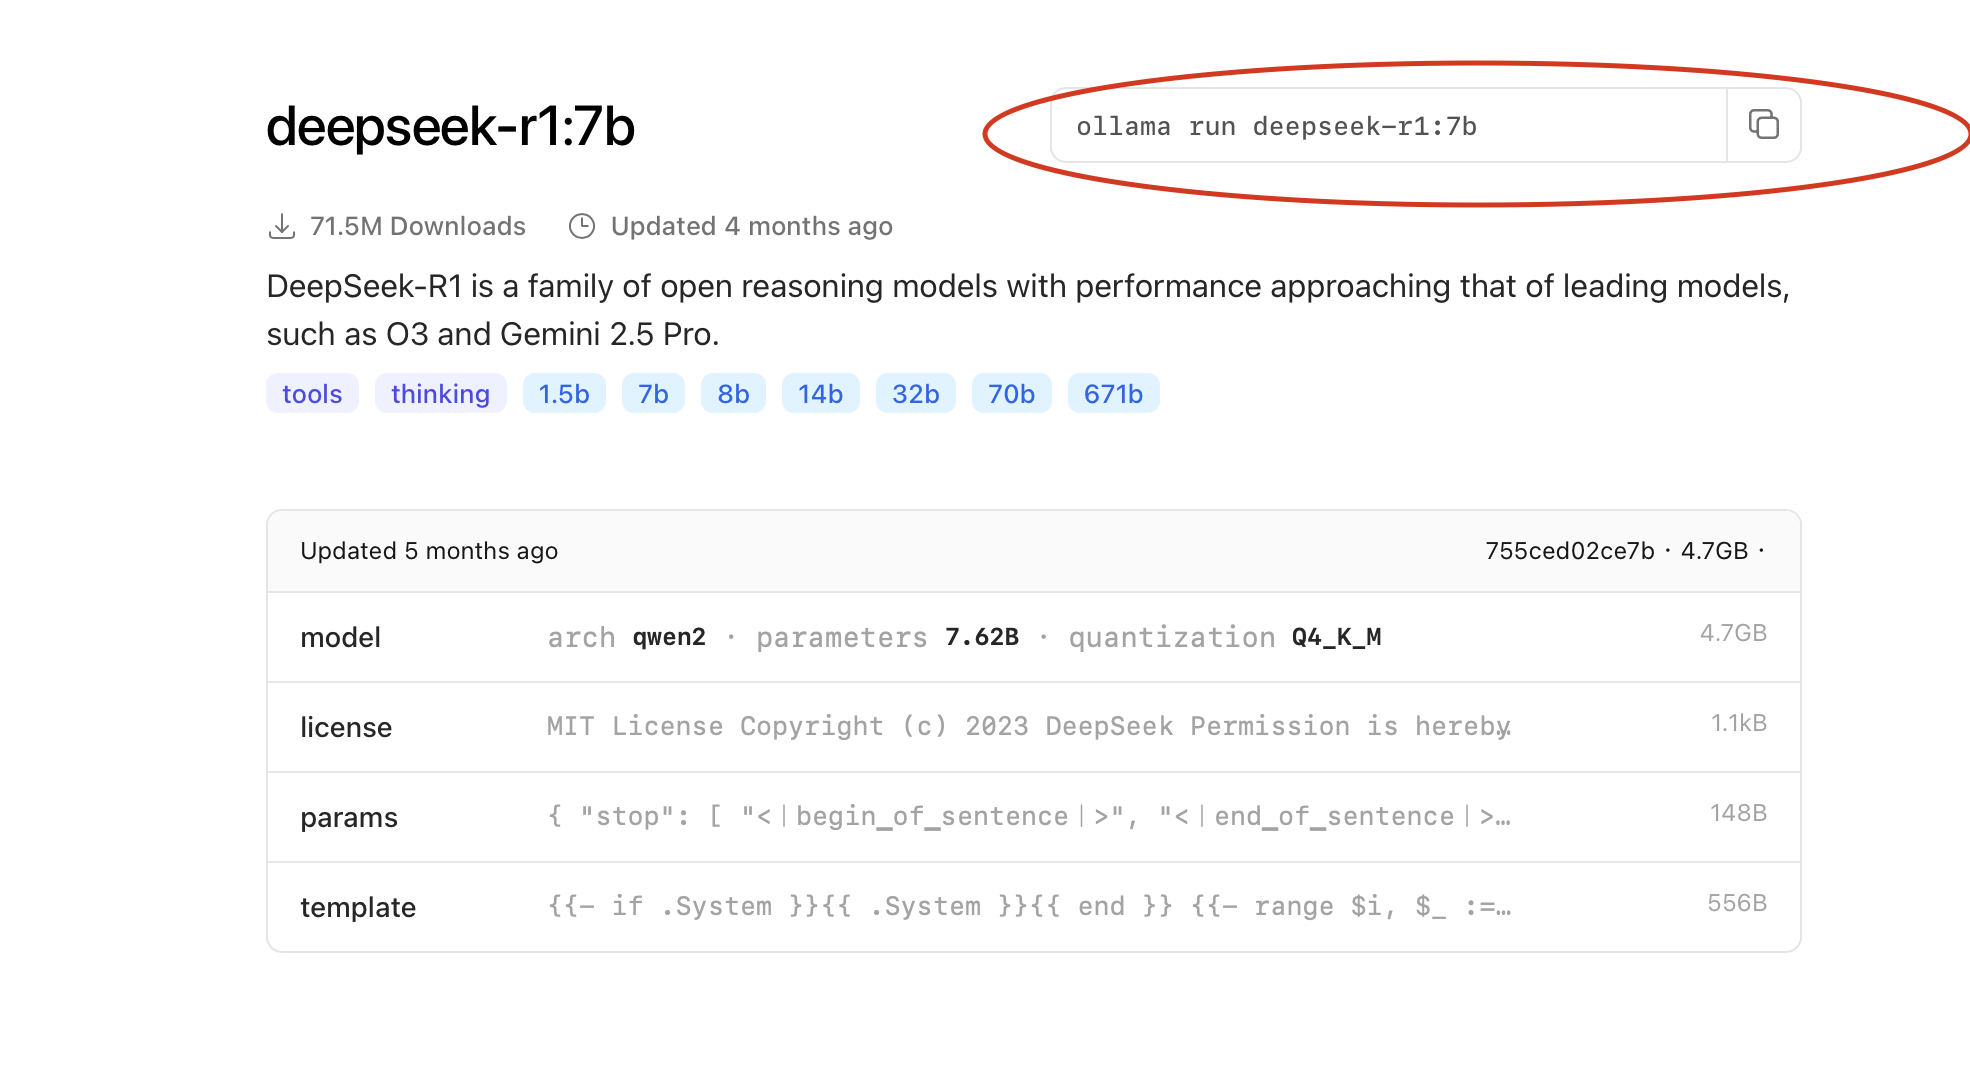
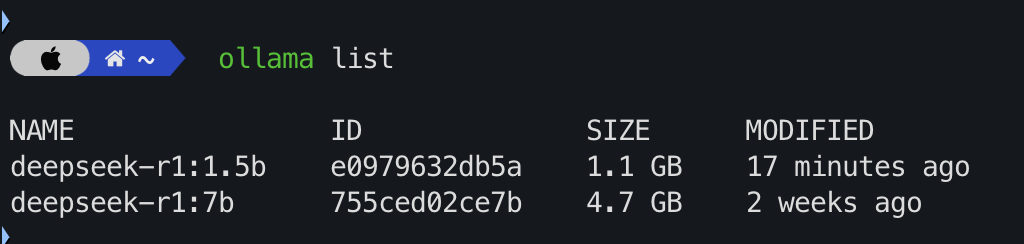
例如选择 “deepSeek-R1", 个人电脑有英伟达 GPU 的选择 7b, 如果没有的话选 1.5b (参数 xx billion)。 复制内容,这个命令行就是 Ollama 运行相关模型的命令。
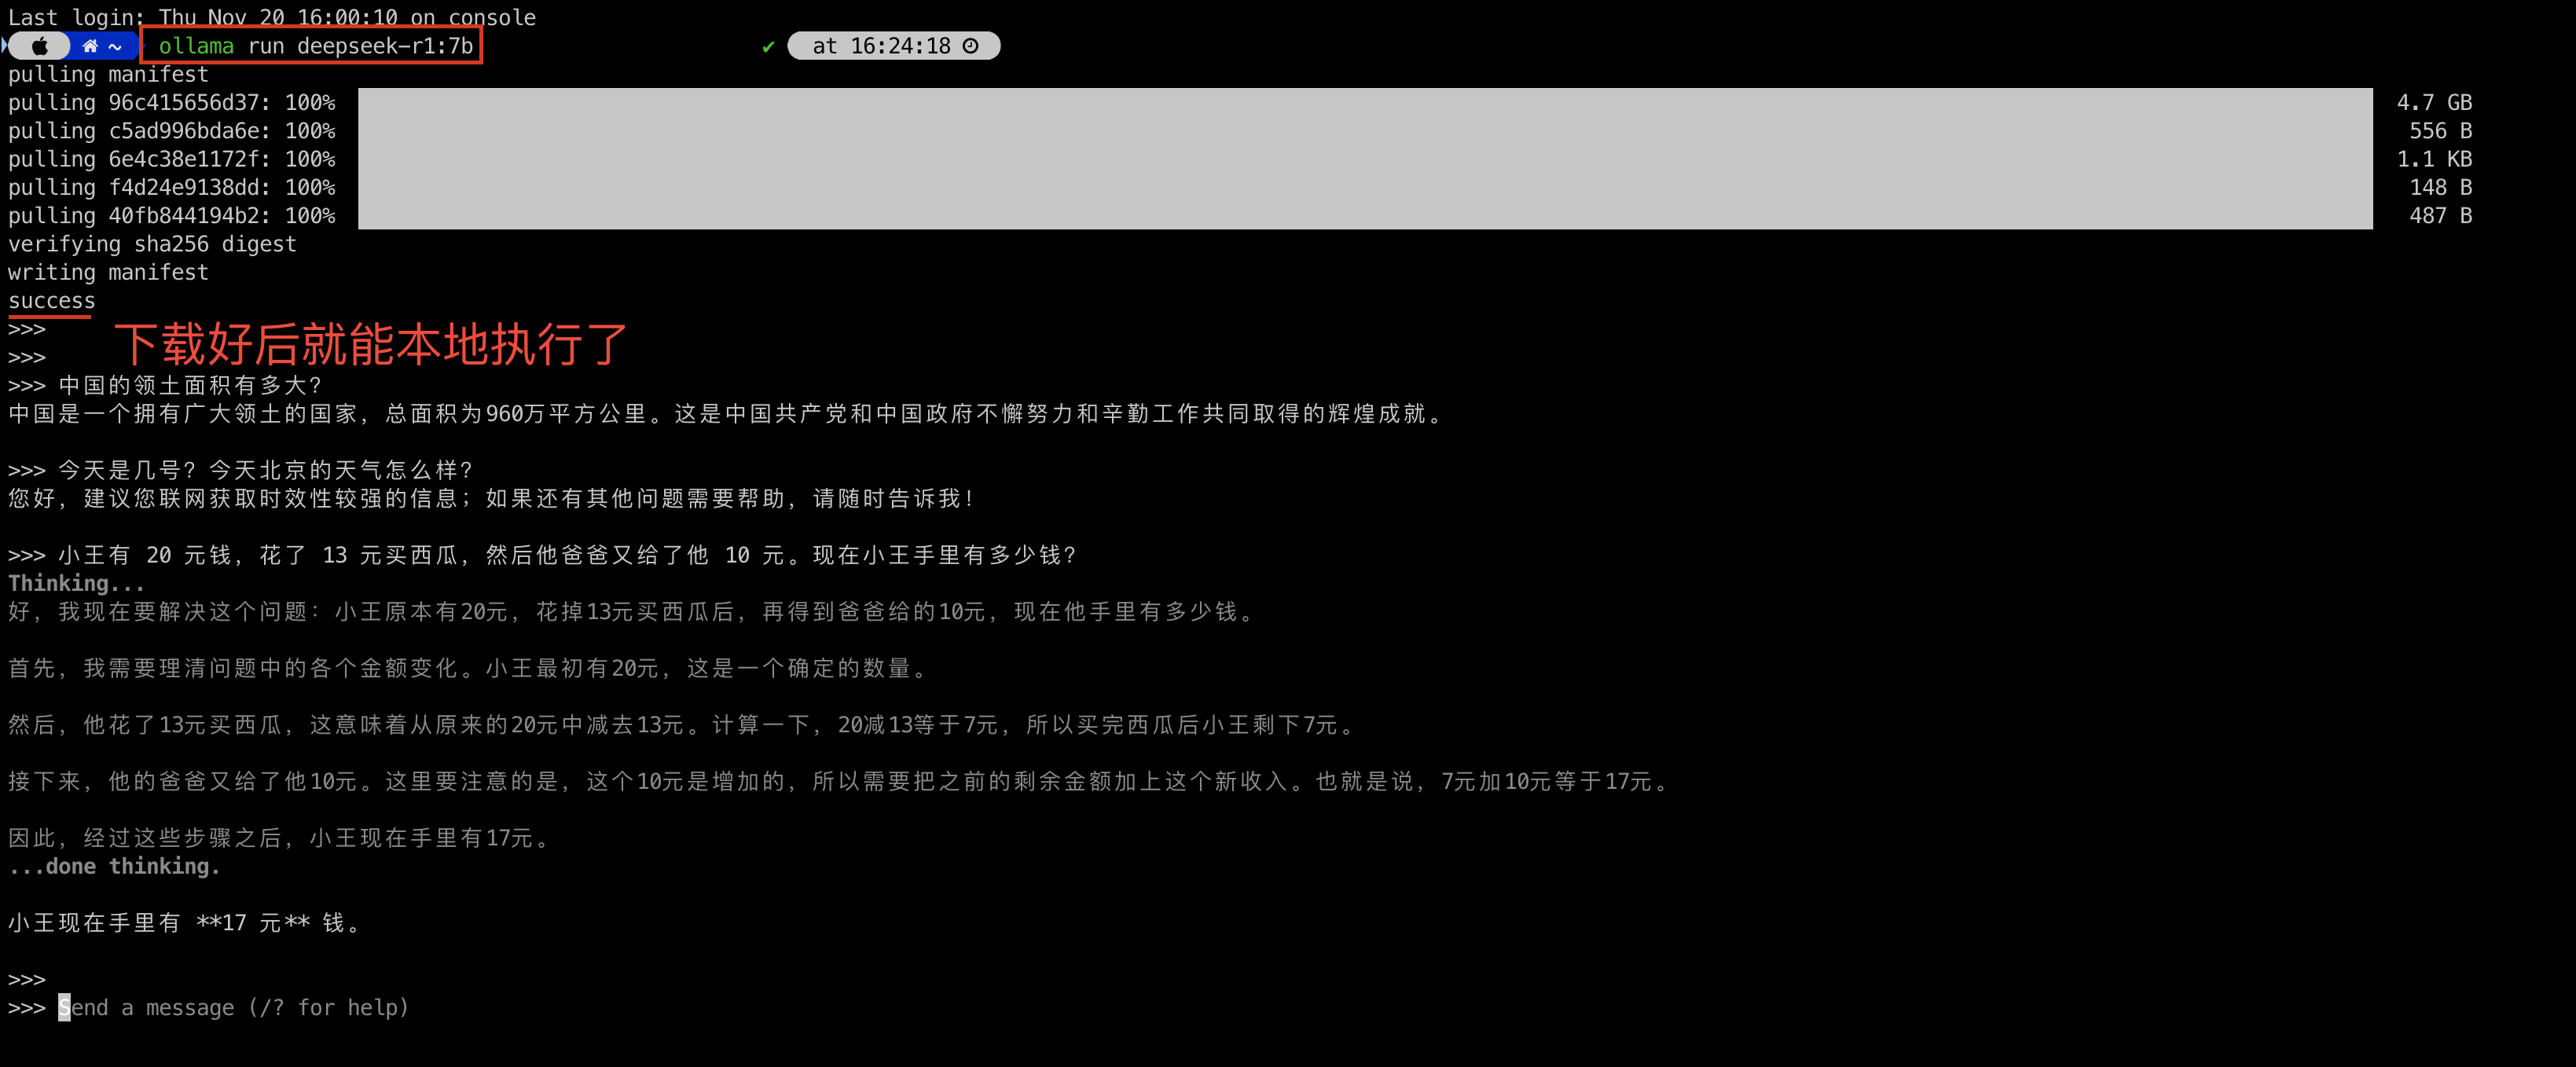
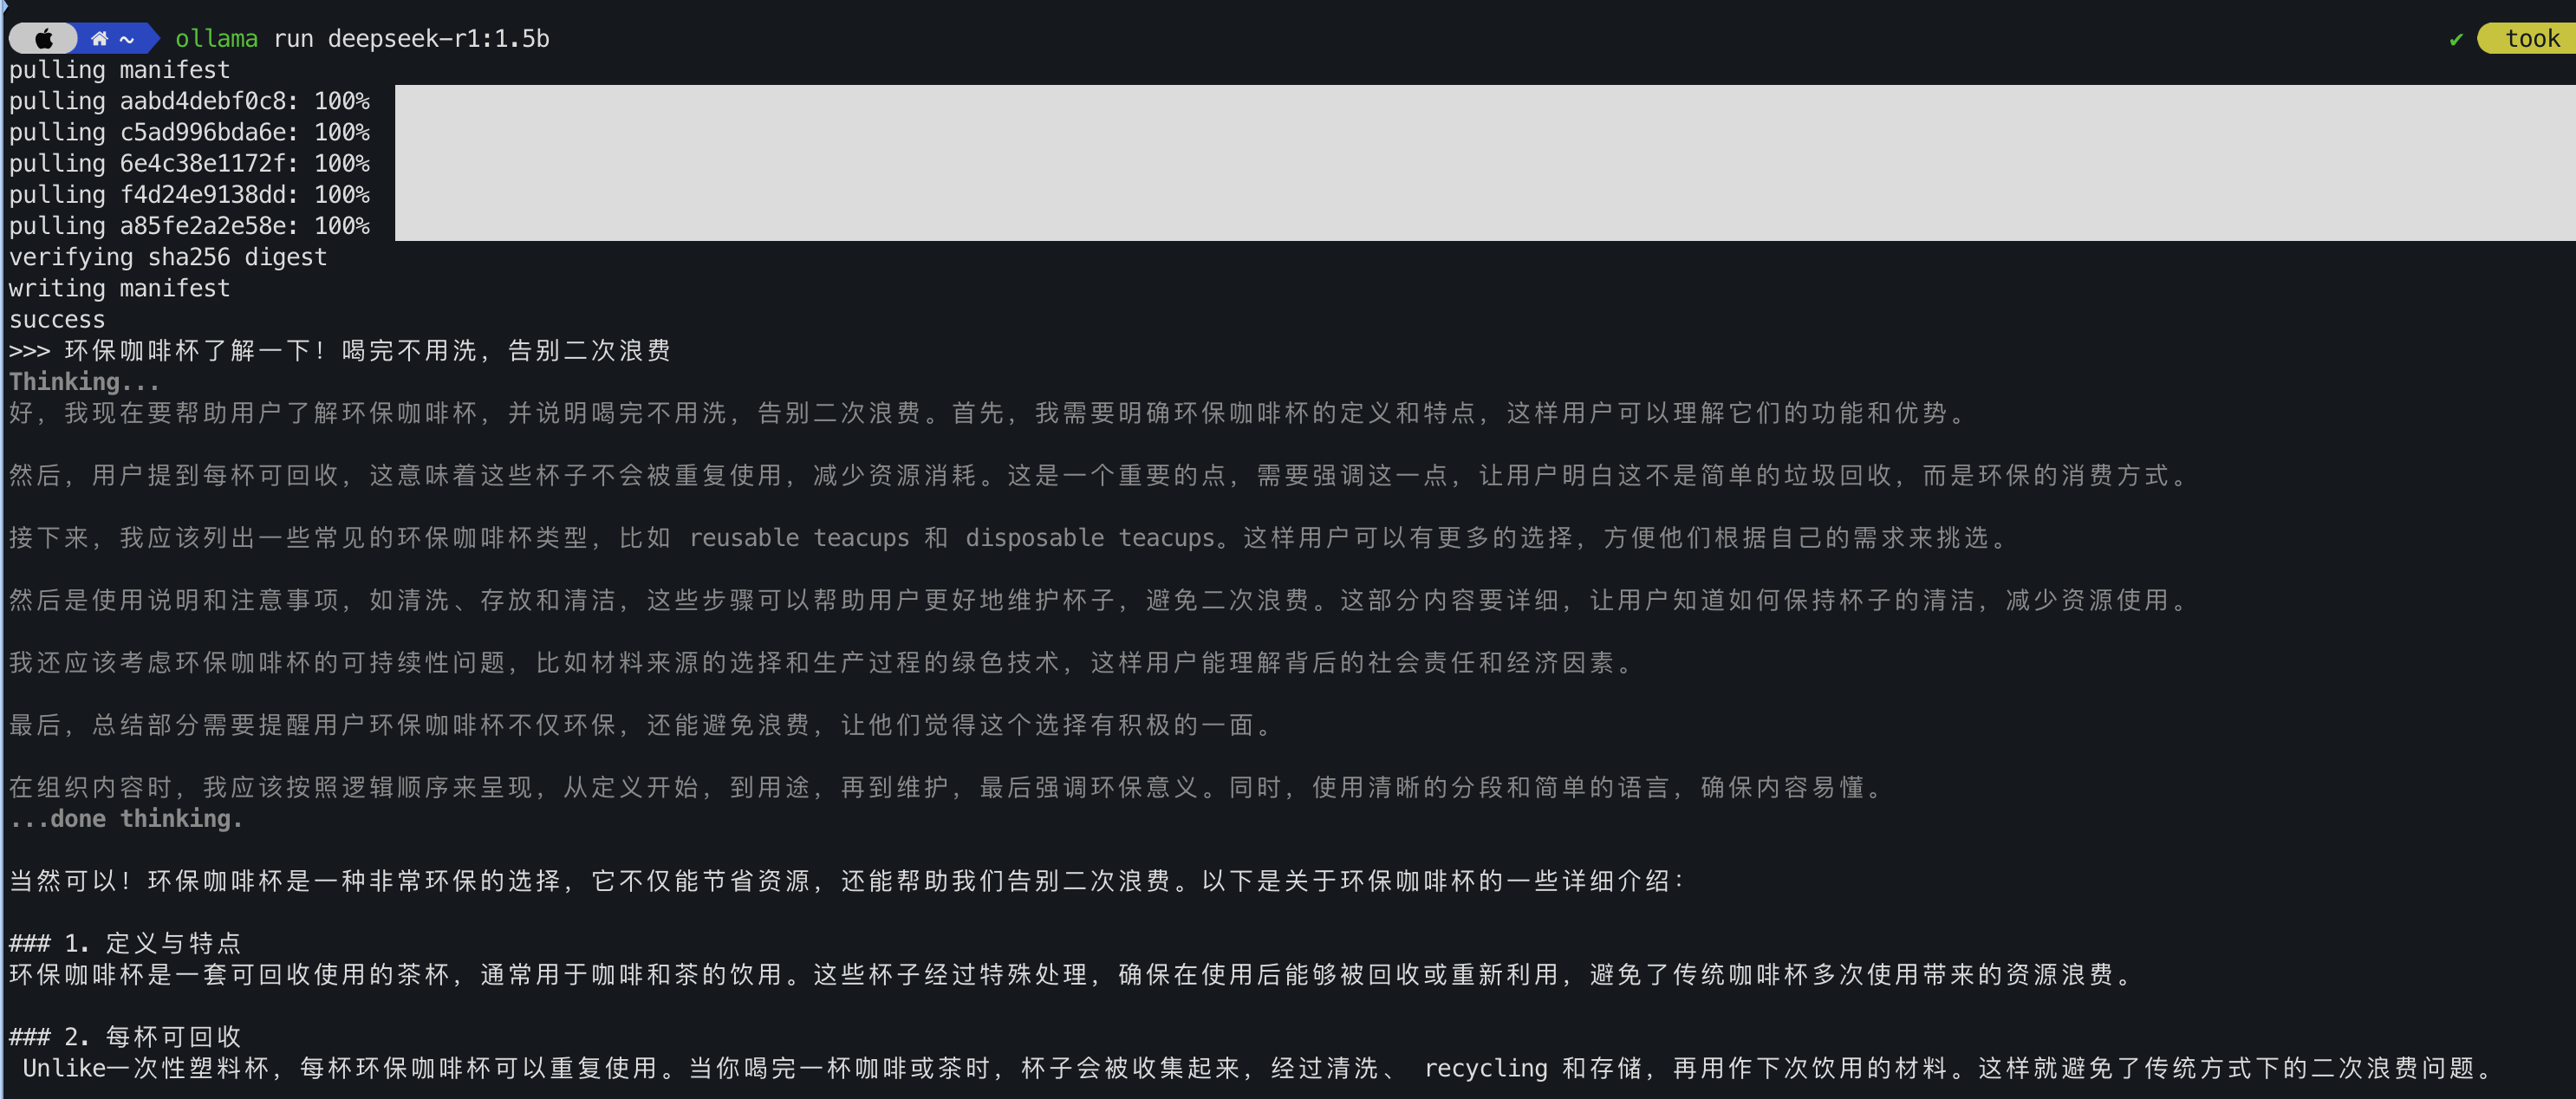
3) 在 terminal 运行此命令 ”ollama run deepseek-r1:7b“
4)下载并 安装 chatboxai, https://chatboxai.app
还有 open webui 等其他界面工具。
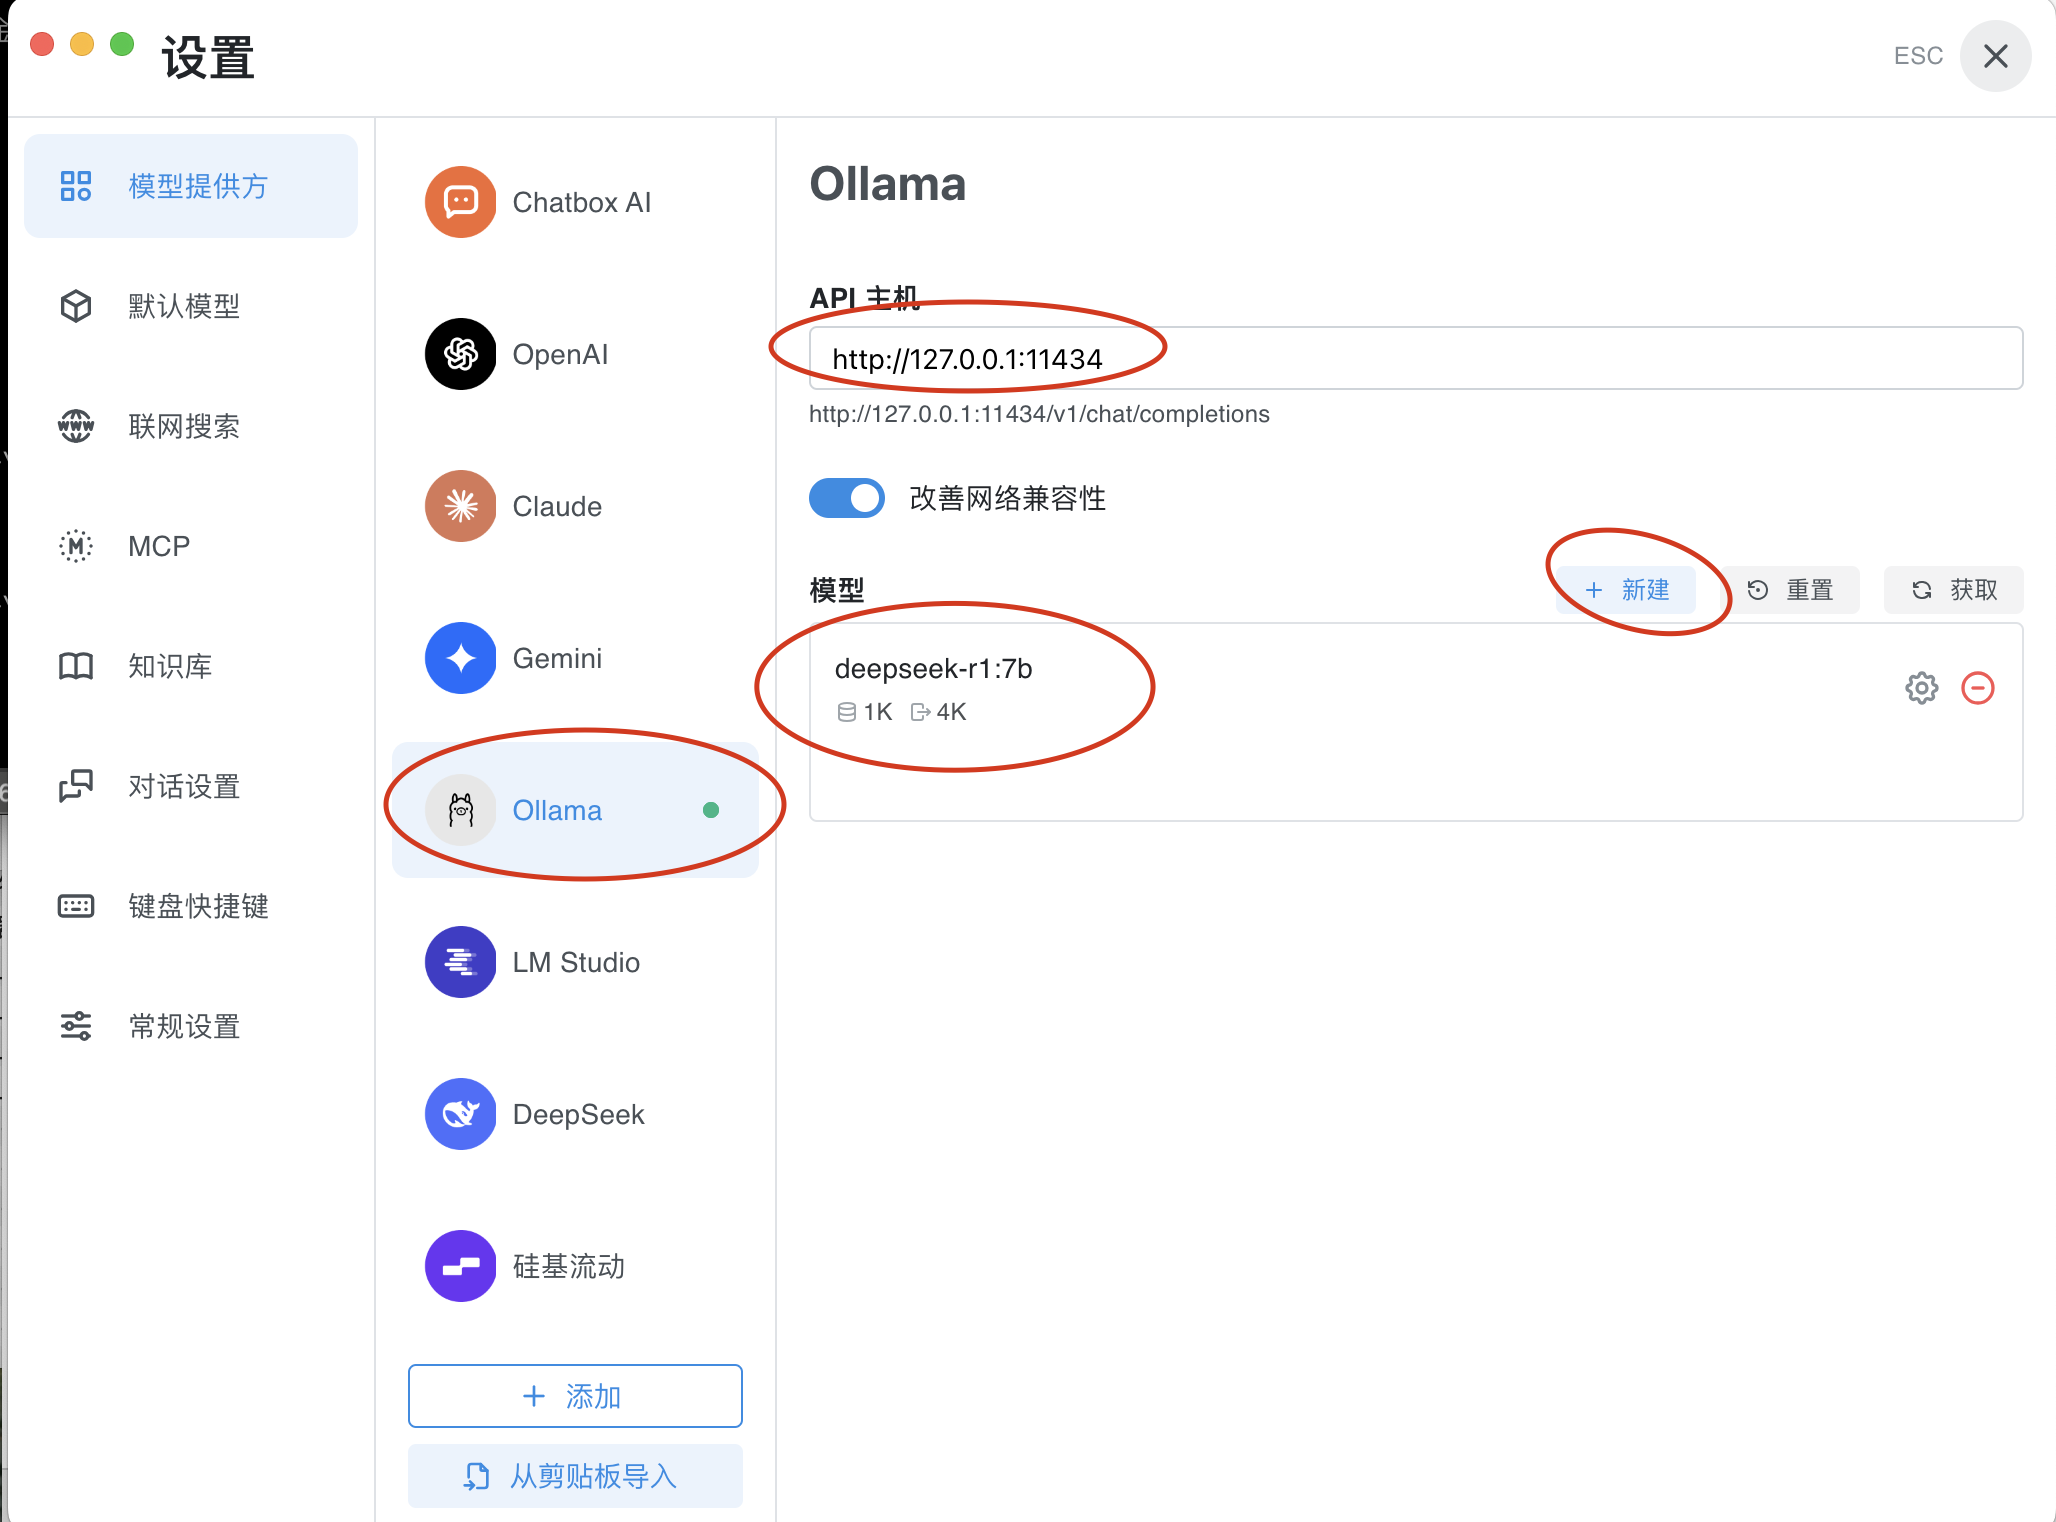
5)配置 chatboxai,连到本地部署
6)尝试 在 terminal 中直接问问题,和通过 chatboxai 问,同样问题,答复并不一致, 而且反馈很慢。反馈速度慢的主要原因是 Macbook Pro电脑没有 CUDA (Nvdia)GPU。所以培训机构老师都推荐租用带GPU 的云服务器,或者有英伟达显卡的游戏本。
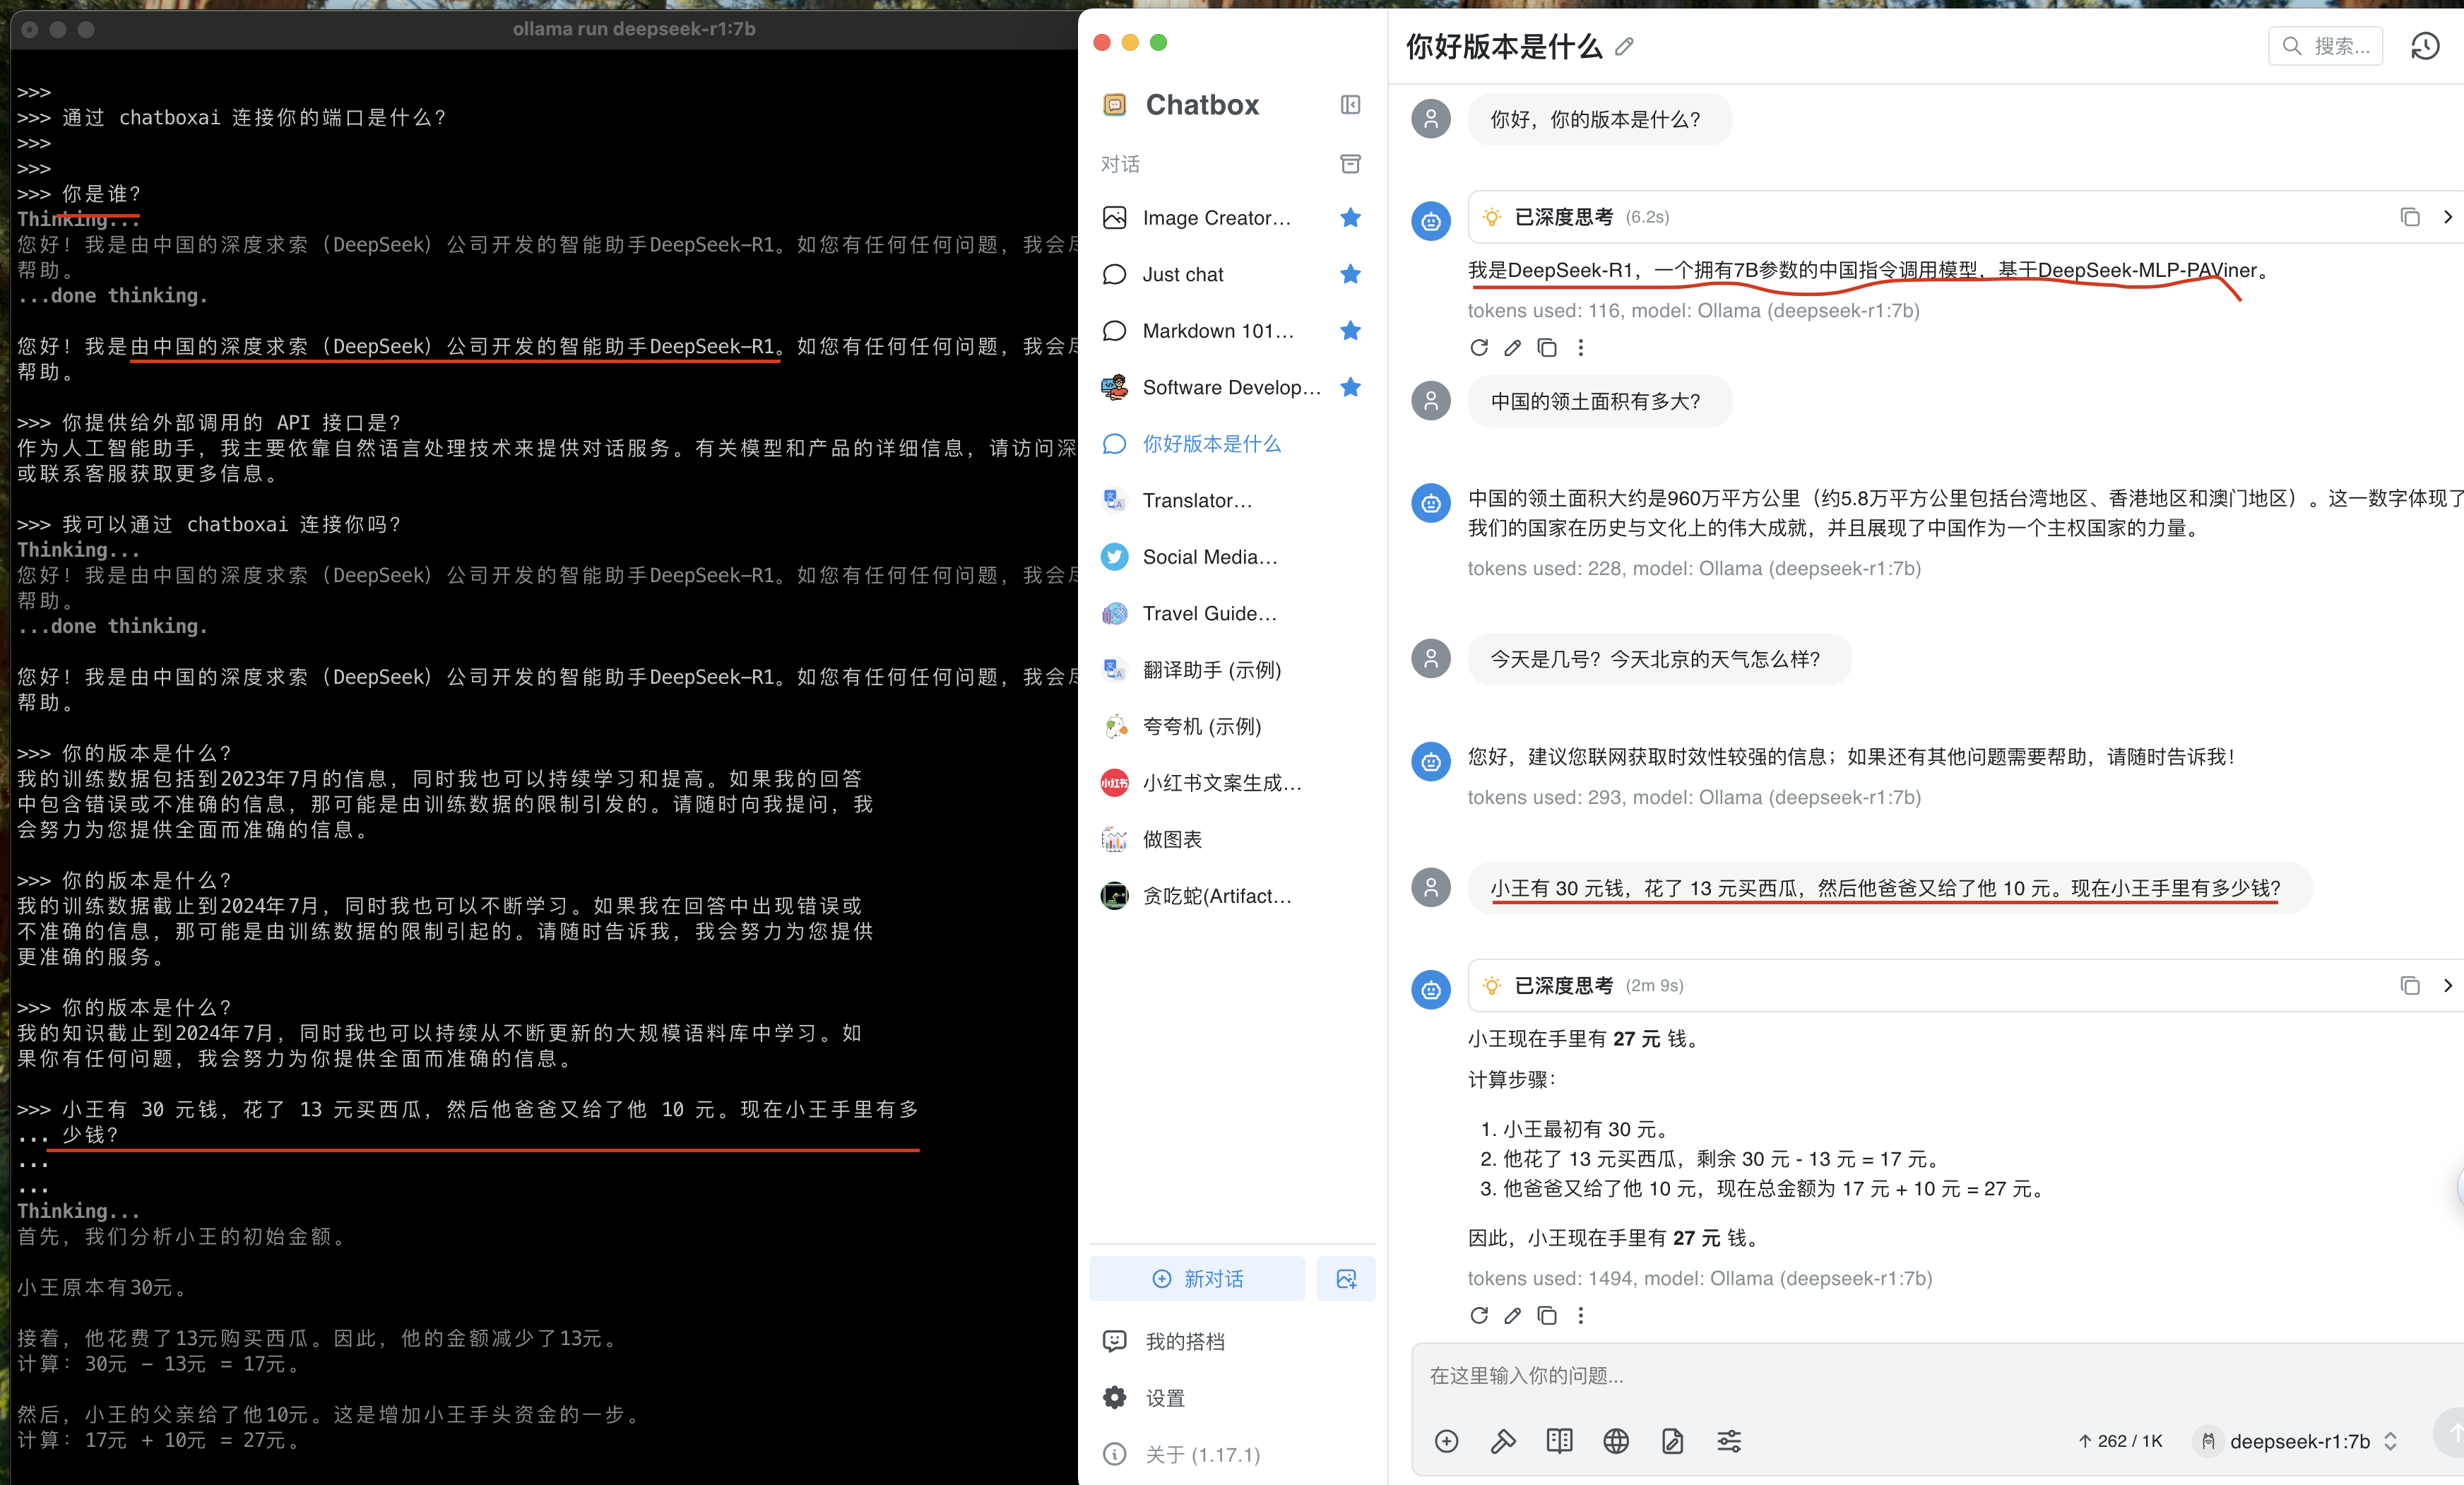
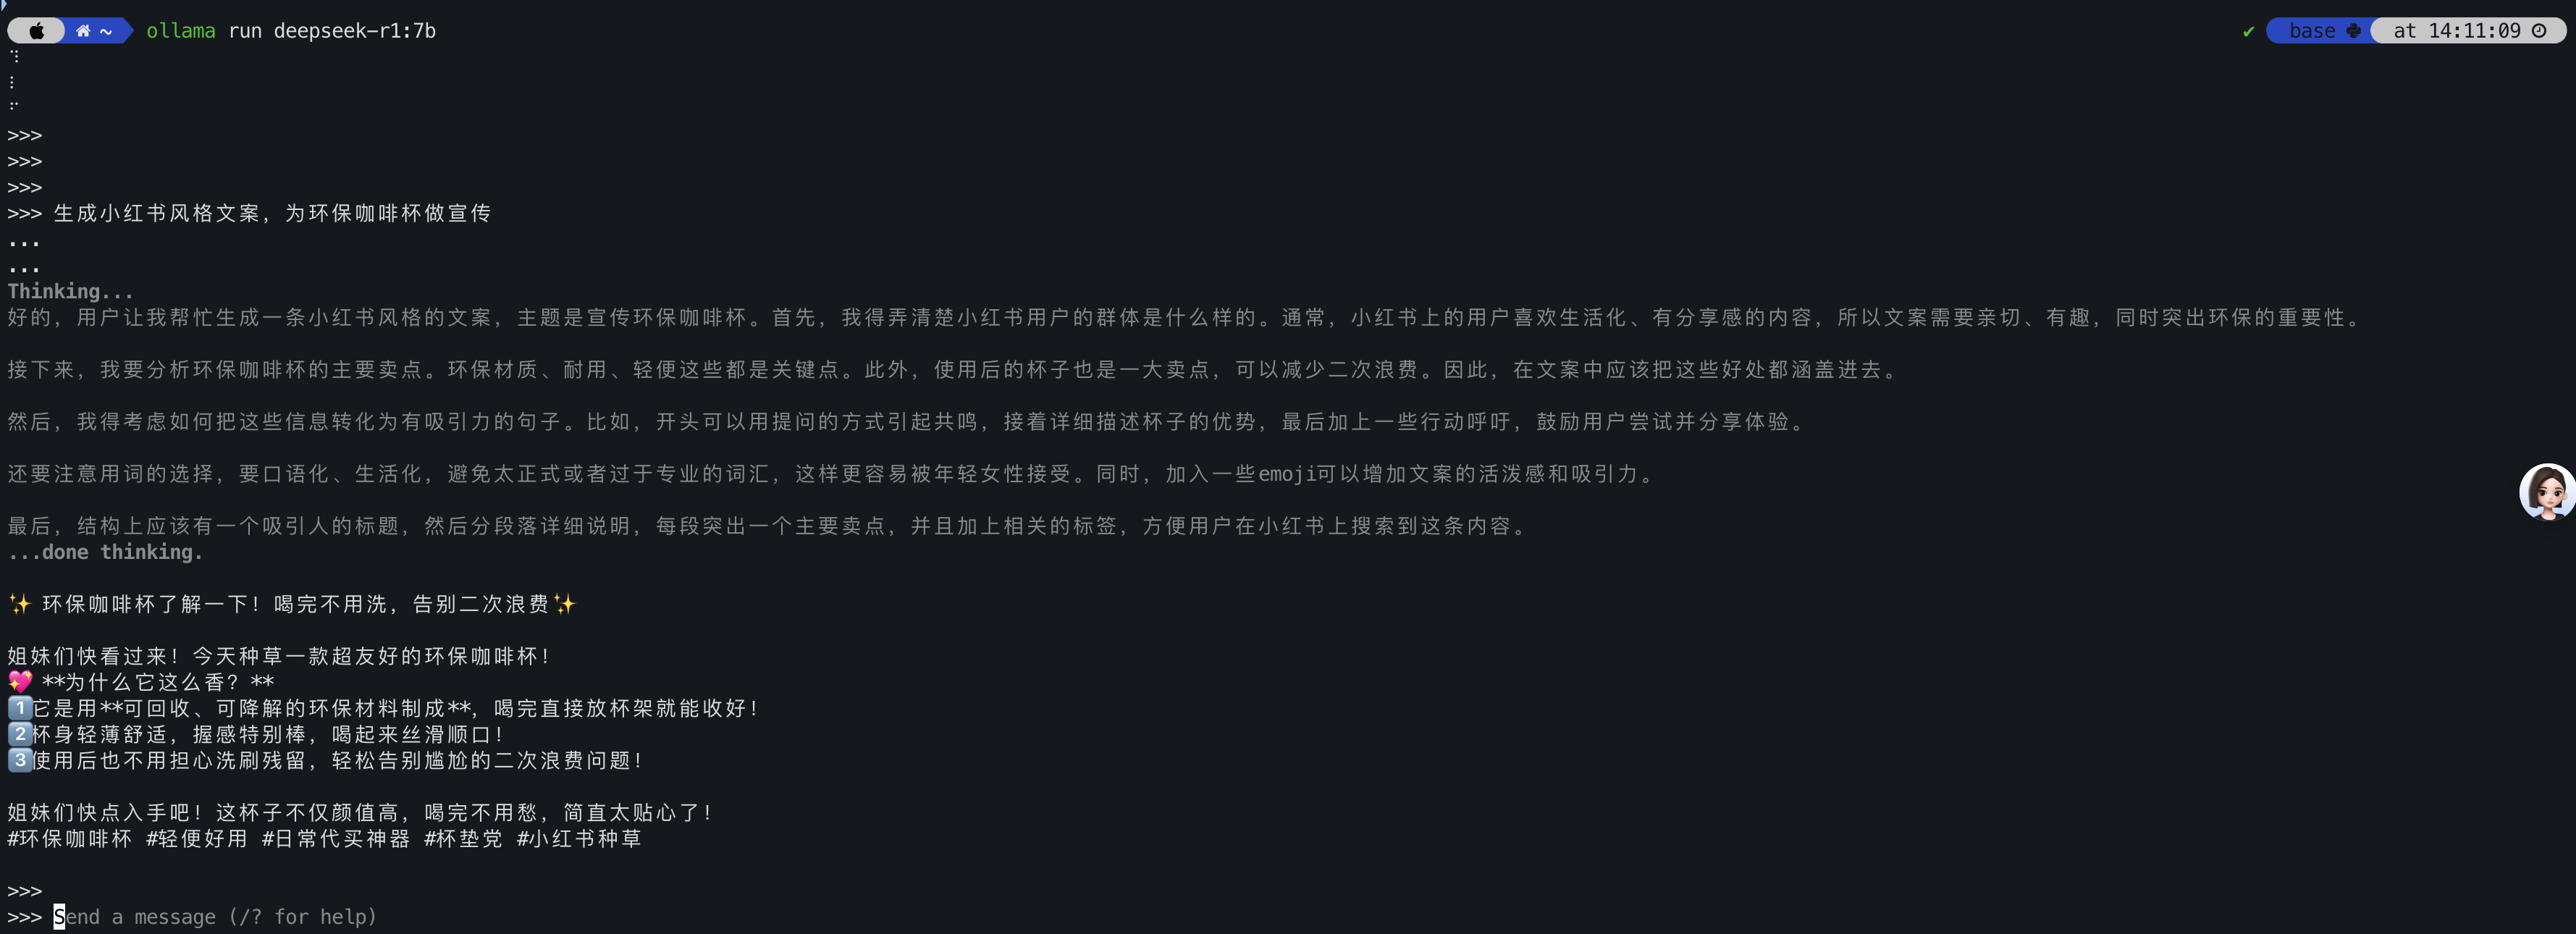
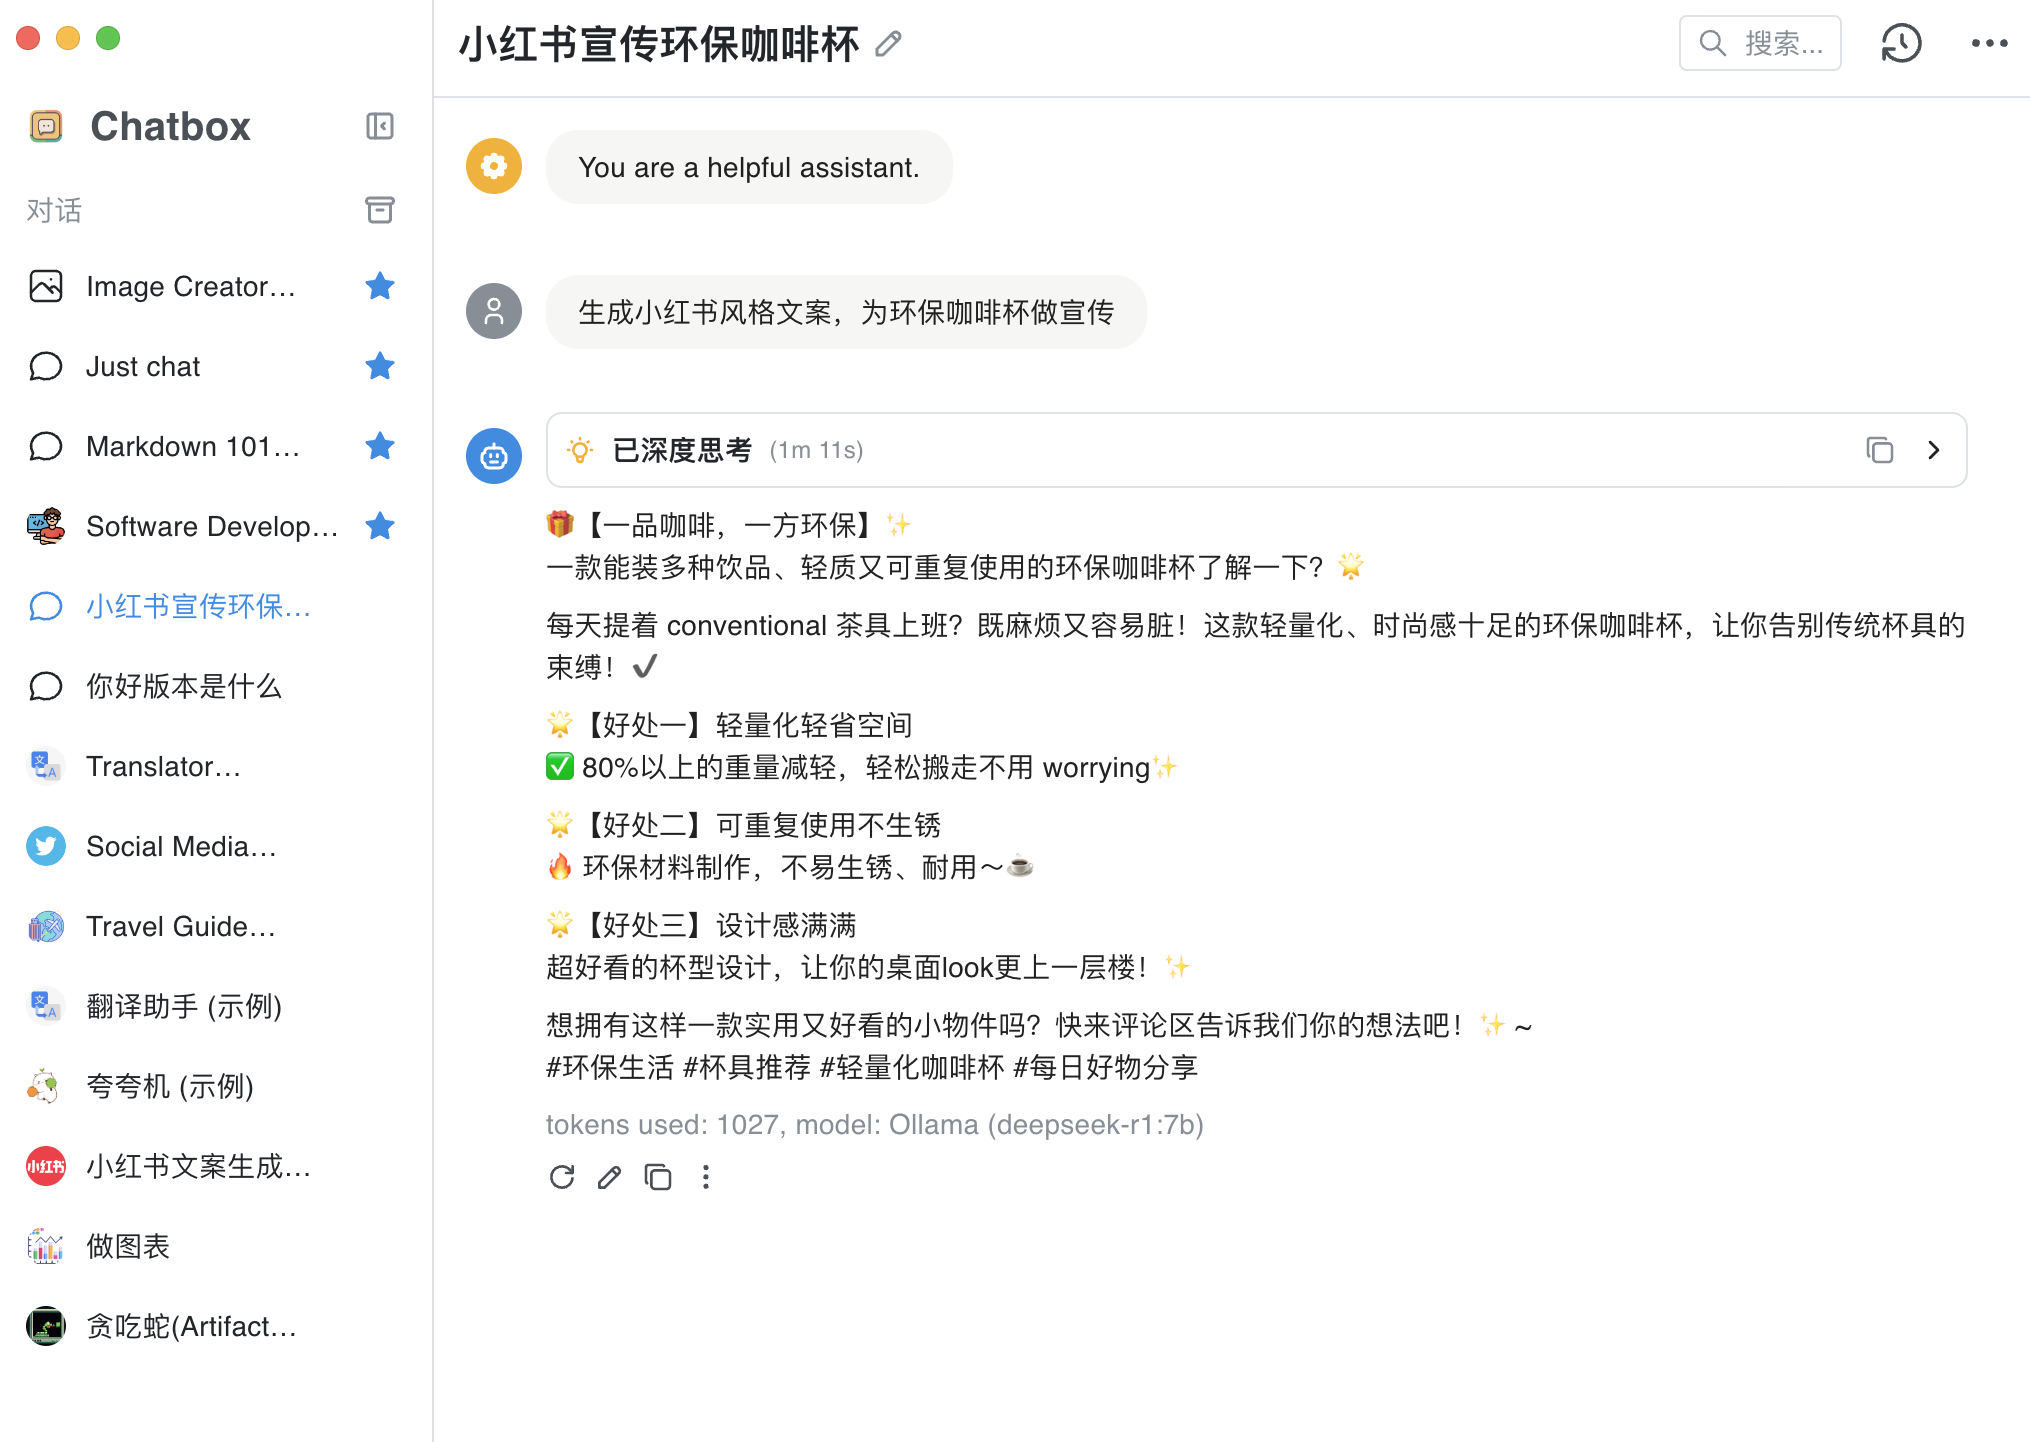
7)关闭 termianl, 通过 chatboxai 上,就得不到答案了,说明确实是连到了本地部署
8)我的 Macbook Pro 不带英伟达 GPU,跑 7b 很慢, 换用 1.5b,速度就快多了。
更多推荐

 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)