
基于 PPG 时频域特征融合与多机器学习算法的心理压力智能诊断模型研究
0 引言
随着社会节奏的加快与竞争压力的提升,心理压力已成为影响当代人群身心健康的重要因素。短期心理压力可能引发焦虑、失眠等不适,而长期累积的慢性压力则会破坏神经内分泌系统与心血管功能的平衡,显著增加抑郁症、高血压、冠心病等疾病的发病风险 [1-2]。尤其对于大学生群体而言,学业负担、社交适应、就业焦虑等多重压力源交织,使其成为心理压力的高发人群,且该群体对压力的自我调节能力相对薄弱,亟需精准、便捷的压力诊断工具为早期干预提供支撑 [3]。
心率变异性(HRV)作为反映自主神经功能与心理压力状态的核心生理指标,已被临床证实与压力水平密切相关 —— 压力状态下,交感神经兴奋会导致 HRV 降低,而放松状态下副交感神经占优则使 HRV 升高 [4]。传统 HRV 检测依赖心电图(ECG)设备,需通过电极片采集心电信号并提取 R-R 间期,虽测量精准,但存在操作复杂、设备昂贵、需专业人员协助等局限,难以满足日常场景下的实时、无创监测需求 [5]。因此,开发替代型压力诊断技术成为当前研究的热点方向。
光电容析(PPG)技术的兴起为解决这一难题提供了新思路。PPG 通过光信号穿透皮肤组织,捕捉血液容积变化引发的光强波动,进而提取脉搏率变异性(PRV)—— 即 PPG 信号中连续两个脉搏峰值的时间间隔,其与 HRV 在生理机制上具有相关性,且 PPG 传感器具有便携、低成本、无创、低功耗等优势,可集成于可穿戴设备中实现常态化监测 [6]。然而,PPG 信号易受运动、噪声、皮肤状态等因素干扰,直接提取的 PRV 特征针对性不足,需结合高效的数据处理与识别算法方法才能实现心理压力的精准诊断。
机器学习算法凭借强大的特征学习与分类能力,已在生理信号分析、疾病诊断等领域展现出显著优势 [7-8]。不同机器学习算法(如支持向量机、随机森林、逻辑回归等)在抗干扰性、泛化能力等方面存在差异。基于此,本研究以健康本科生为研究对象,以耳垂的PPG脉搏信号为基础,提取 PRV 相关特征参数,通过引入多种机器学习算法构建心理压力分类模型,采用评估指标来评估各算法的诊断性能,旨在验证 PPG 信号结合机器学习算法进行心理压力诊断的有效性,筛选最优算法模型,为开发低成本、可穿戴式心理压力监测设备提供技术参考,同时为大学生群体的心理压力早期筛查与干预提供新的解决方案。
目录
本文完整代码和数据如下:【免费】博客-基于PPG时频域特征融合与多机器学习算法的心理压力智能诊断模型研究-完整代码和数据资源-CSDN下载
注:若使用此数据,请引用参考[9]
1 数据
1.1 数据来源
本文数据来自于Kaggle平台,该平台中对数据简介如下:光体积描记法(PPG)则被认为是检测心理压力的一种替代方案,其通过计算 PPG 信号中连续两个峰值之间的时间间隔(即脉率变异性,PRV)来实现。共招募 27 名健康本科生(男性 15 名、女性 12 名)参与 PRV 数据采集,受试者平均年龄为 21±2 岁。研究采用一款高灵敏度、低成本、低功耗且符合欧盟(RoHS)要求的 PPG 传感器,从受试者耳垂处采集数据。实验方案包含两个阶段:基线阶段和测试阶段。在基线阶段,要求每位受试者于在校期间在教室中保持舒适坐姿,将传感器附着于其耳垂处。随后,受试者需通过一款安卓应用程序完成测试。该数据对应于一篇文章[9]。相关数据及对应研究文章的完整链接如下。数据链接:
若下载不了,可下载本文中的链接:【免费】基于PPG时频域特征融合与多机器学习算法的心理压力智能诊断模型研究-完整代码和数据资源-CSDN下载
1.2 数据预处理
1.2.1数据分布情况
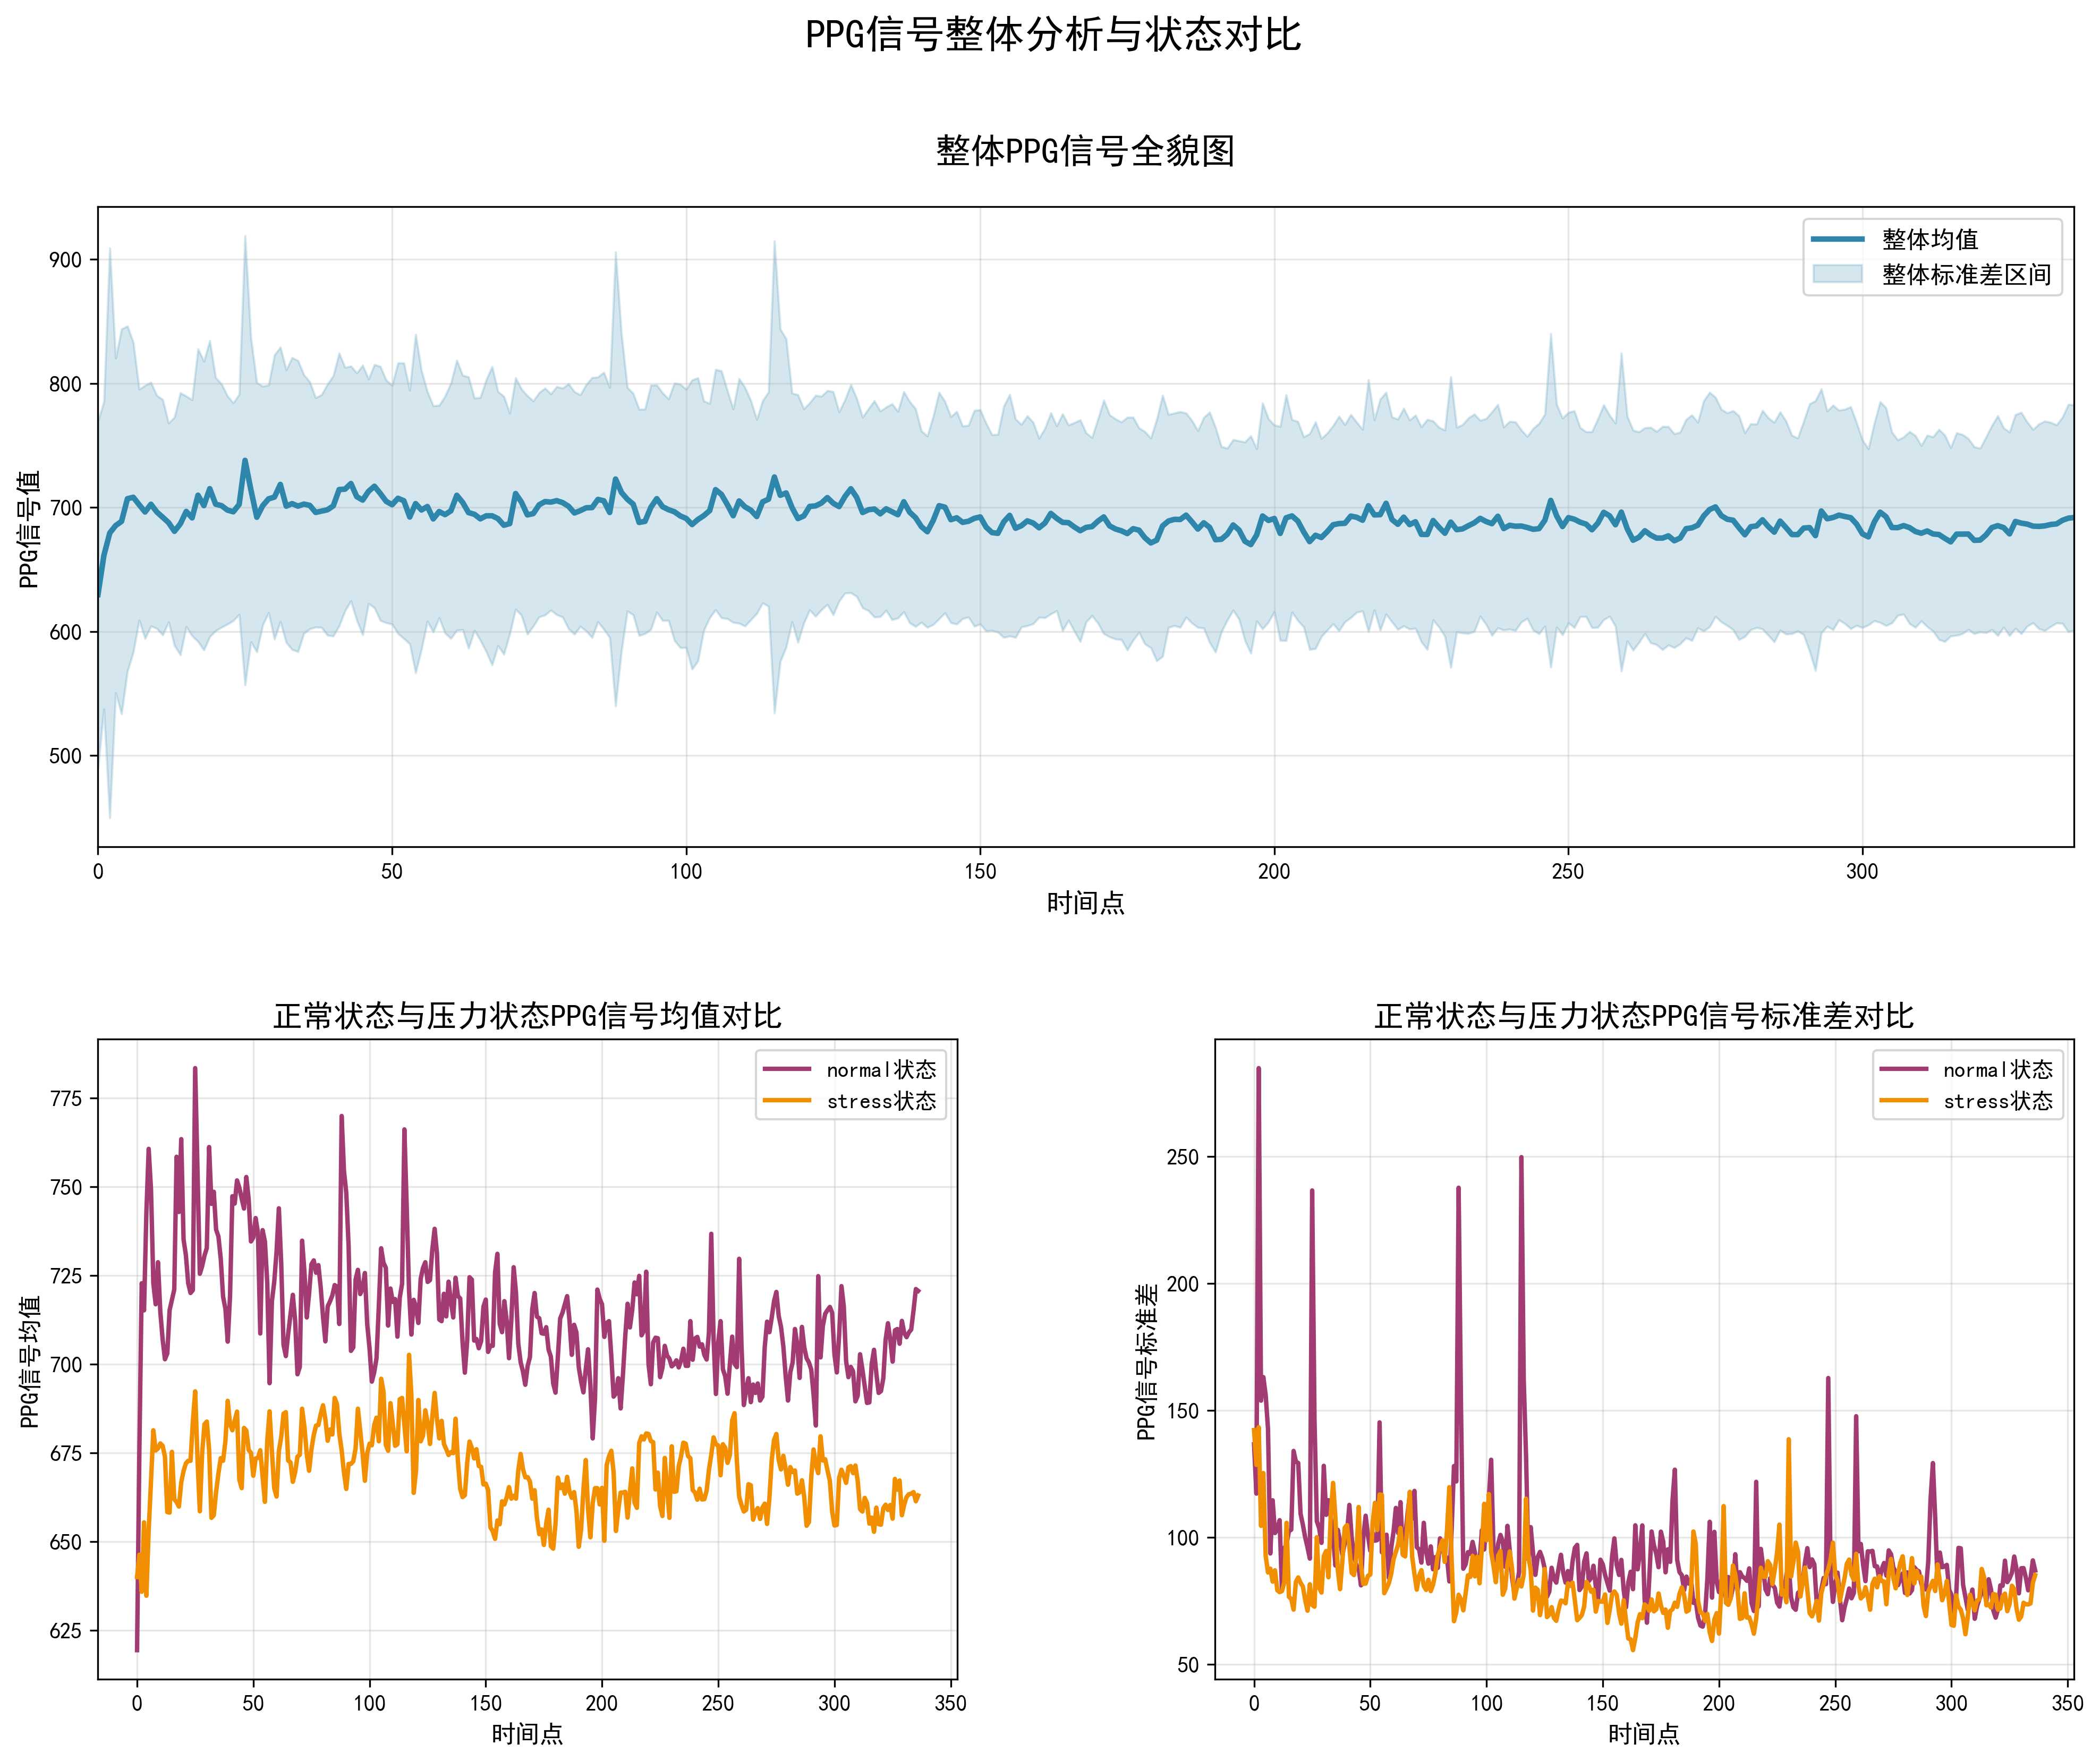
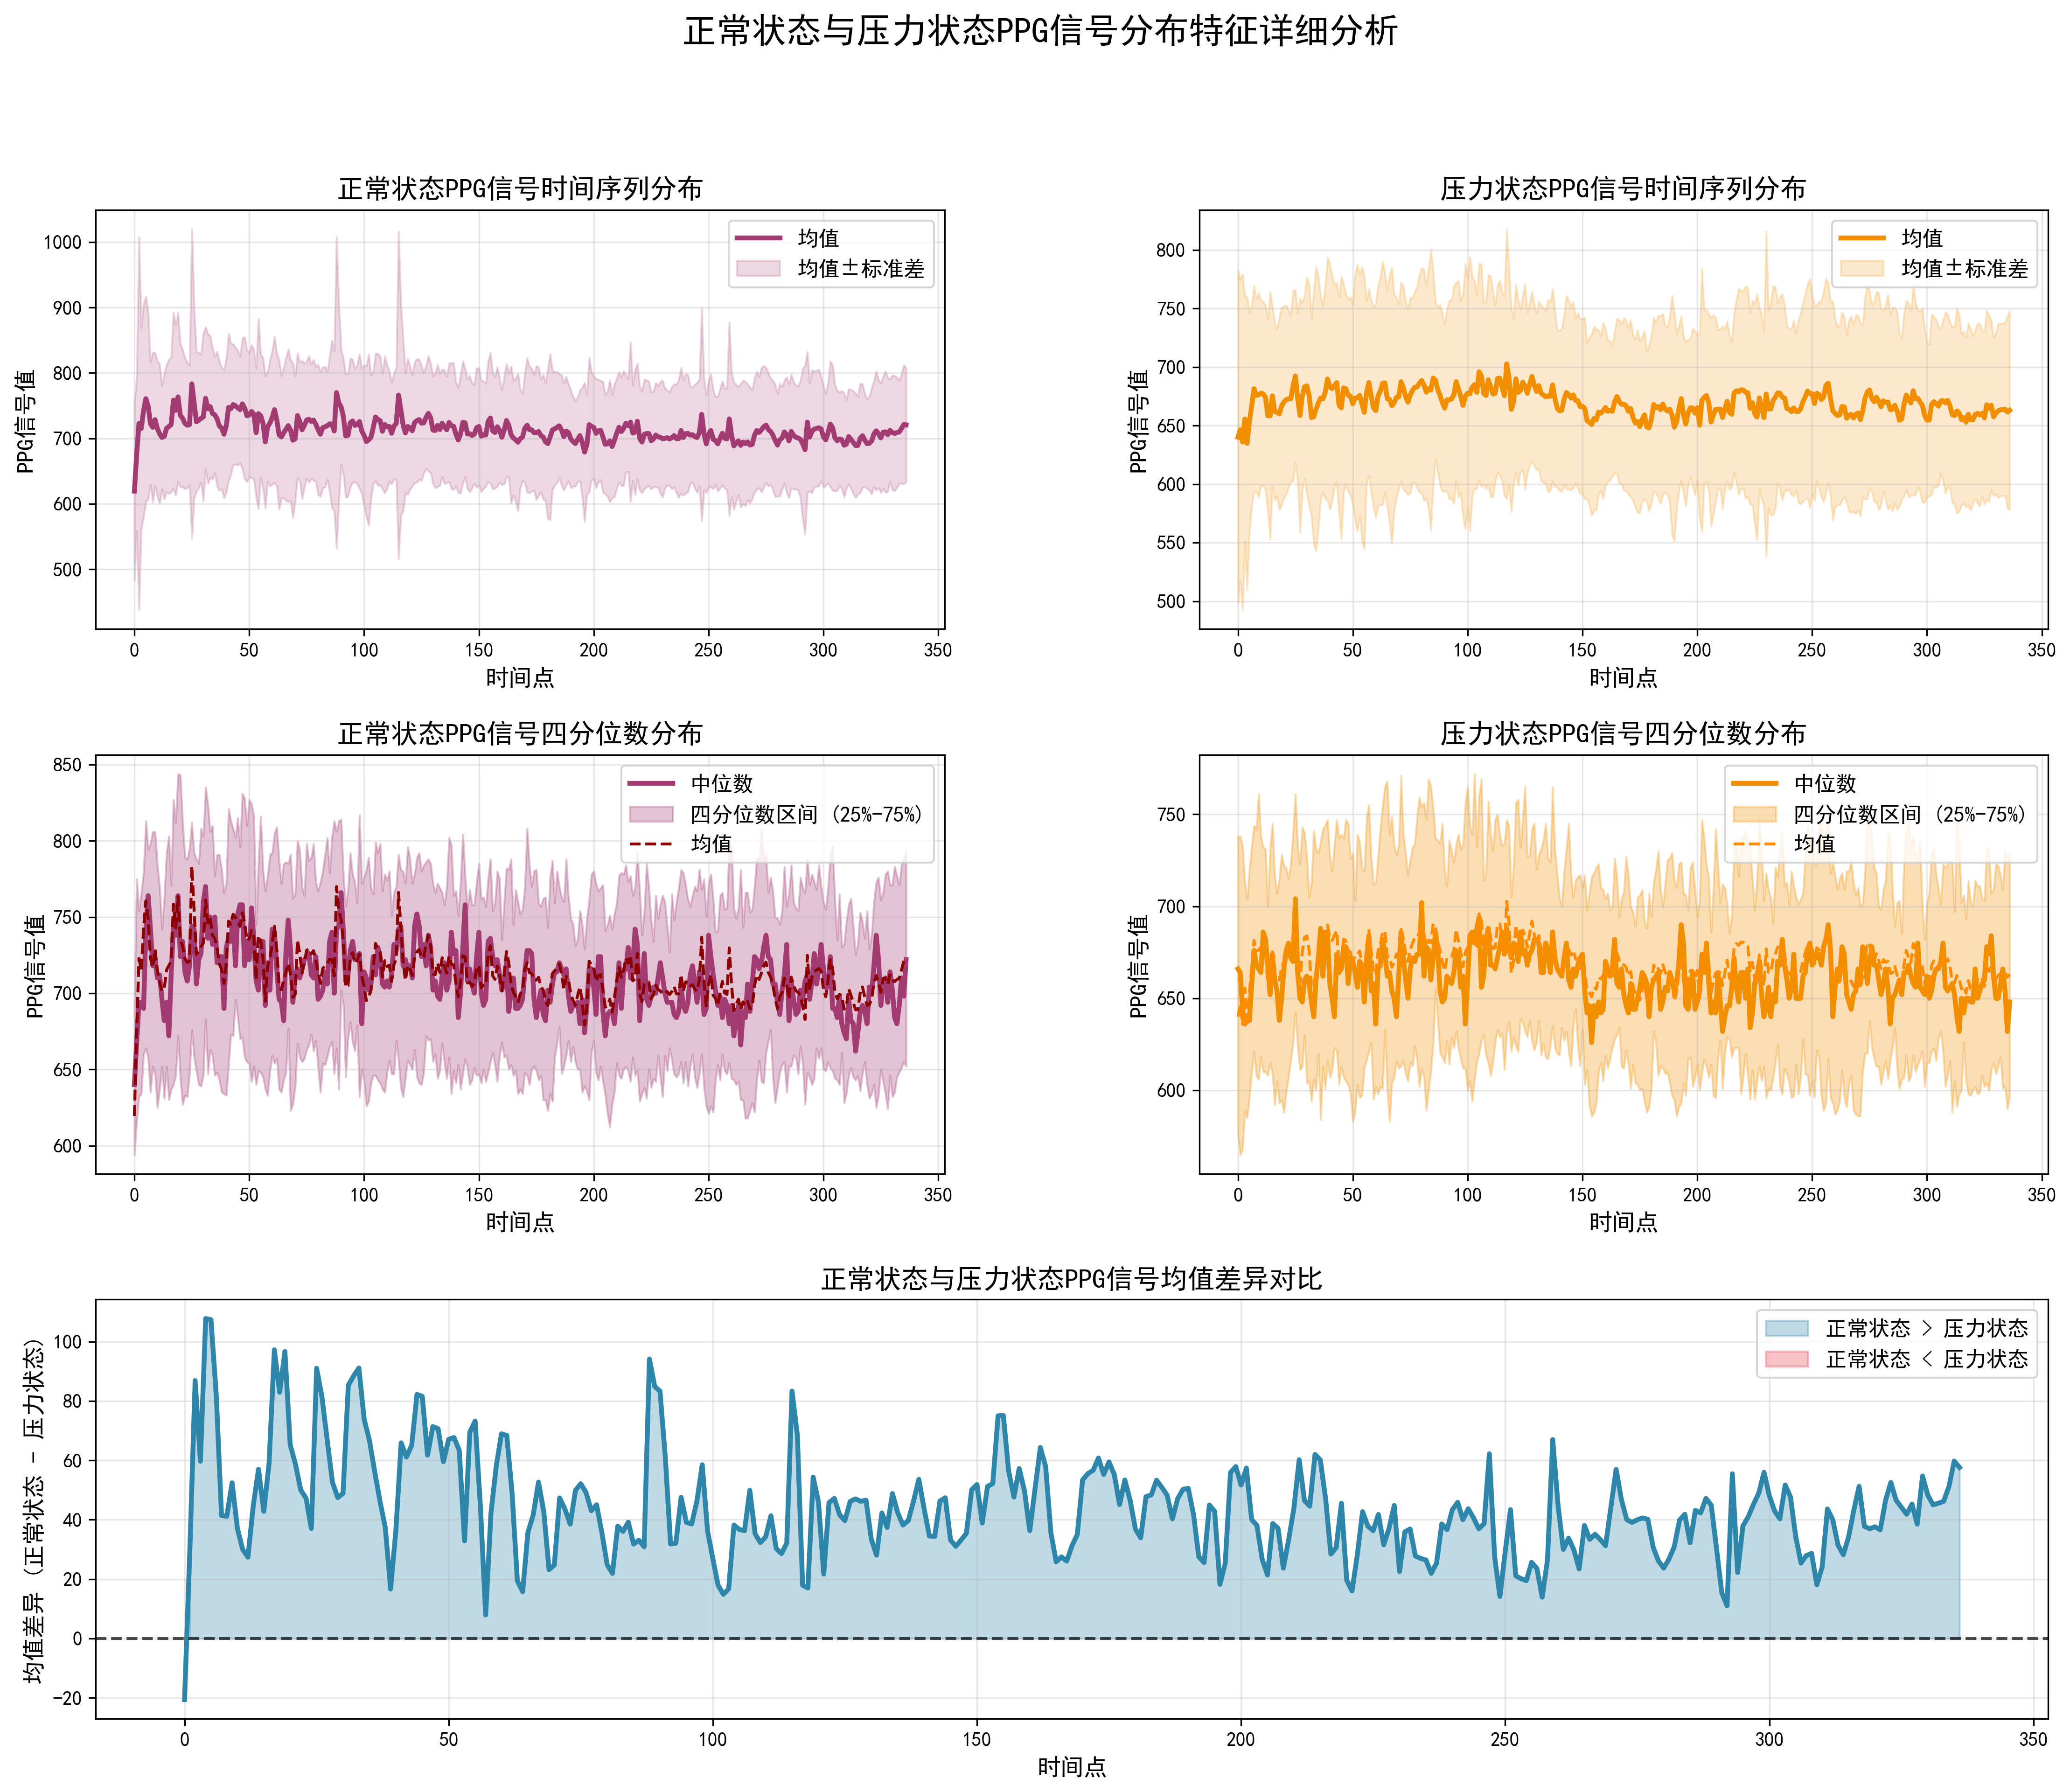
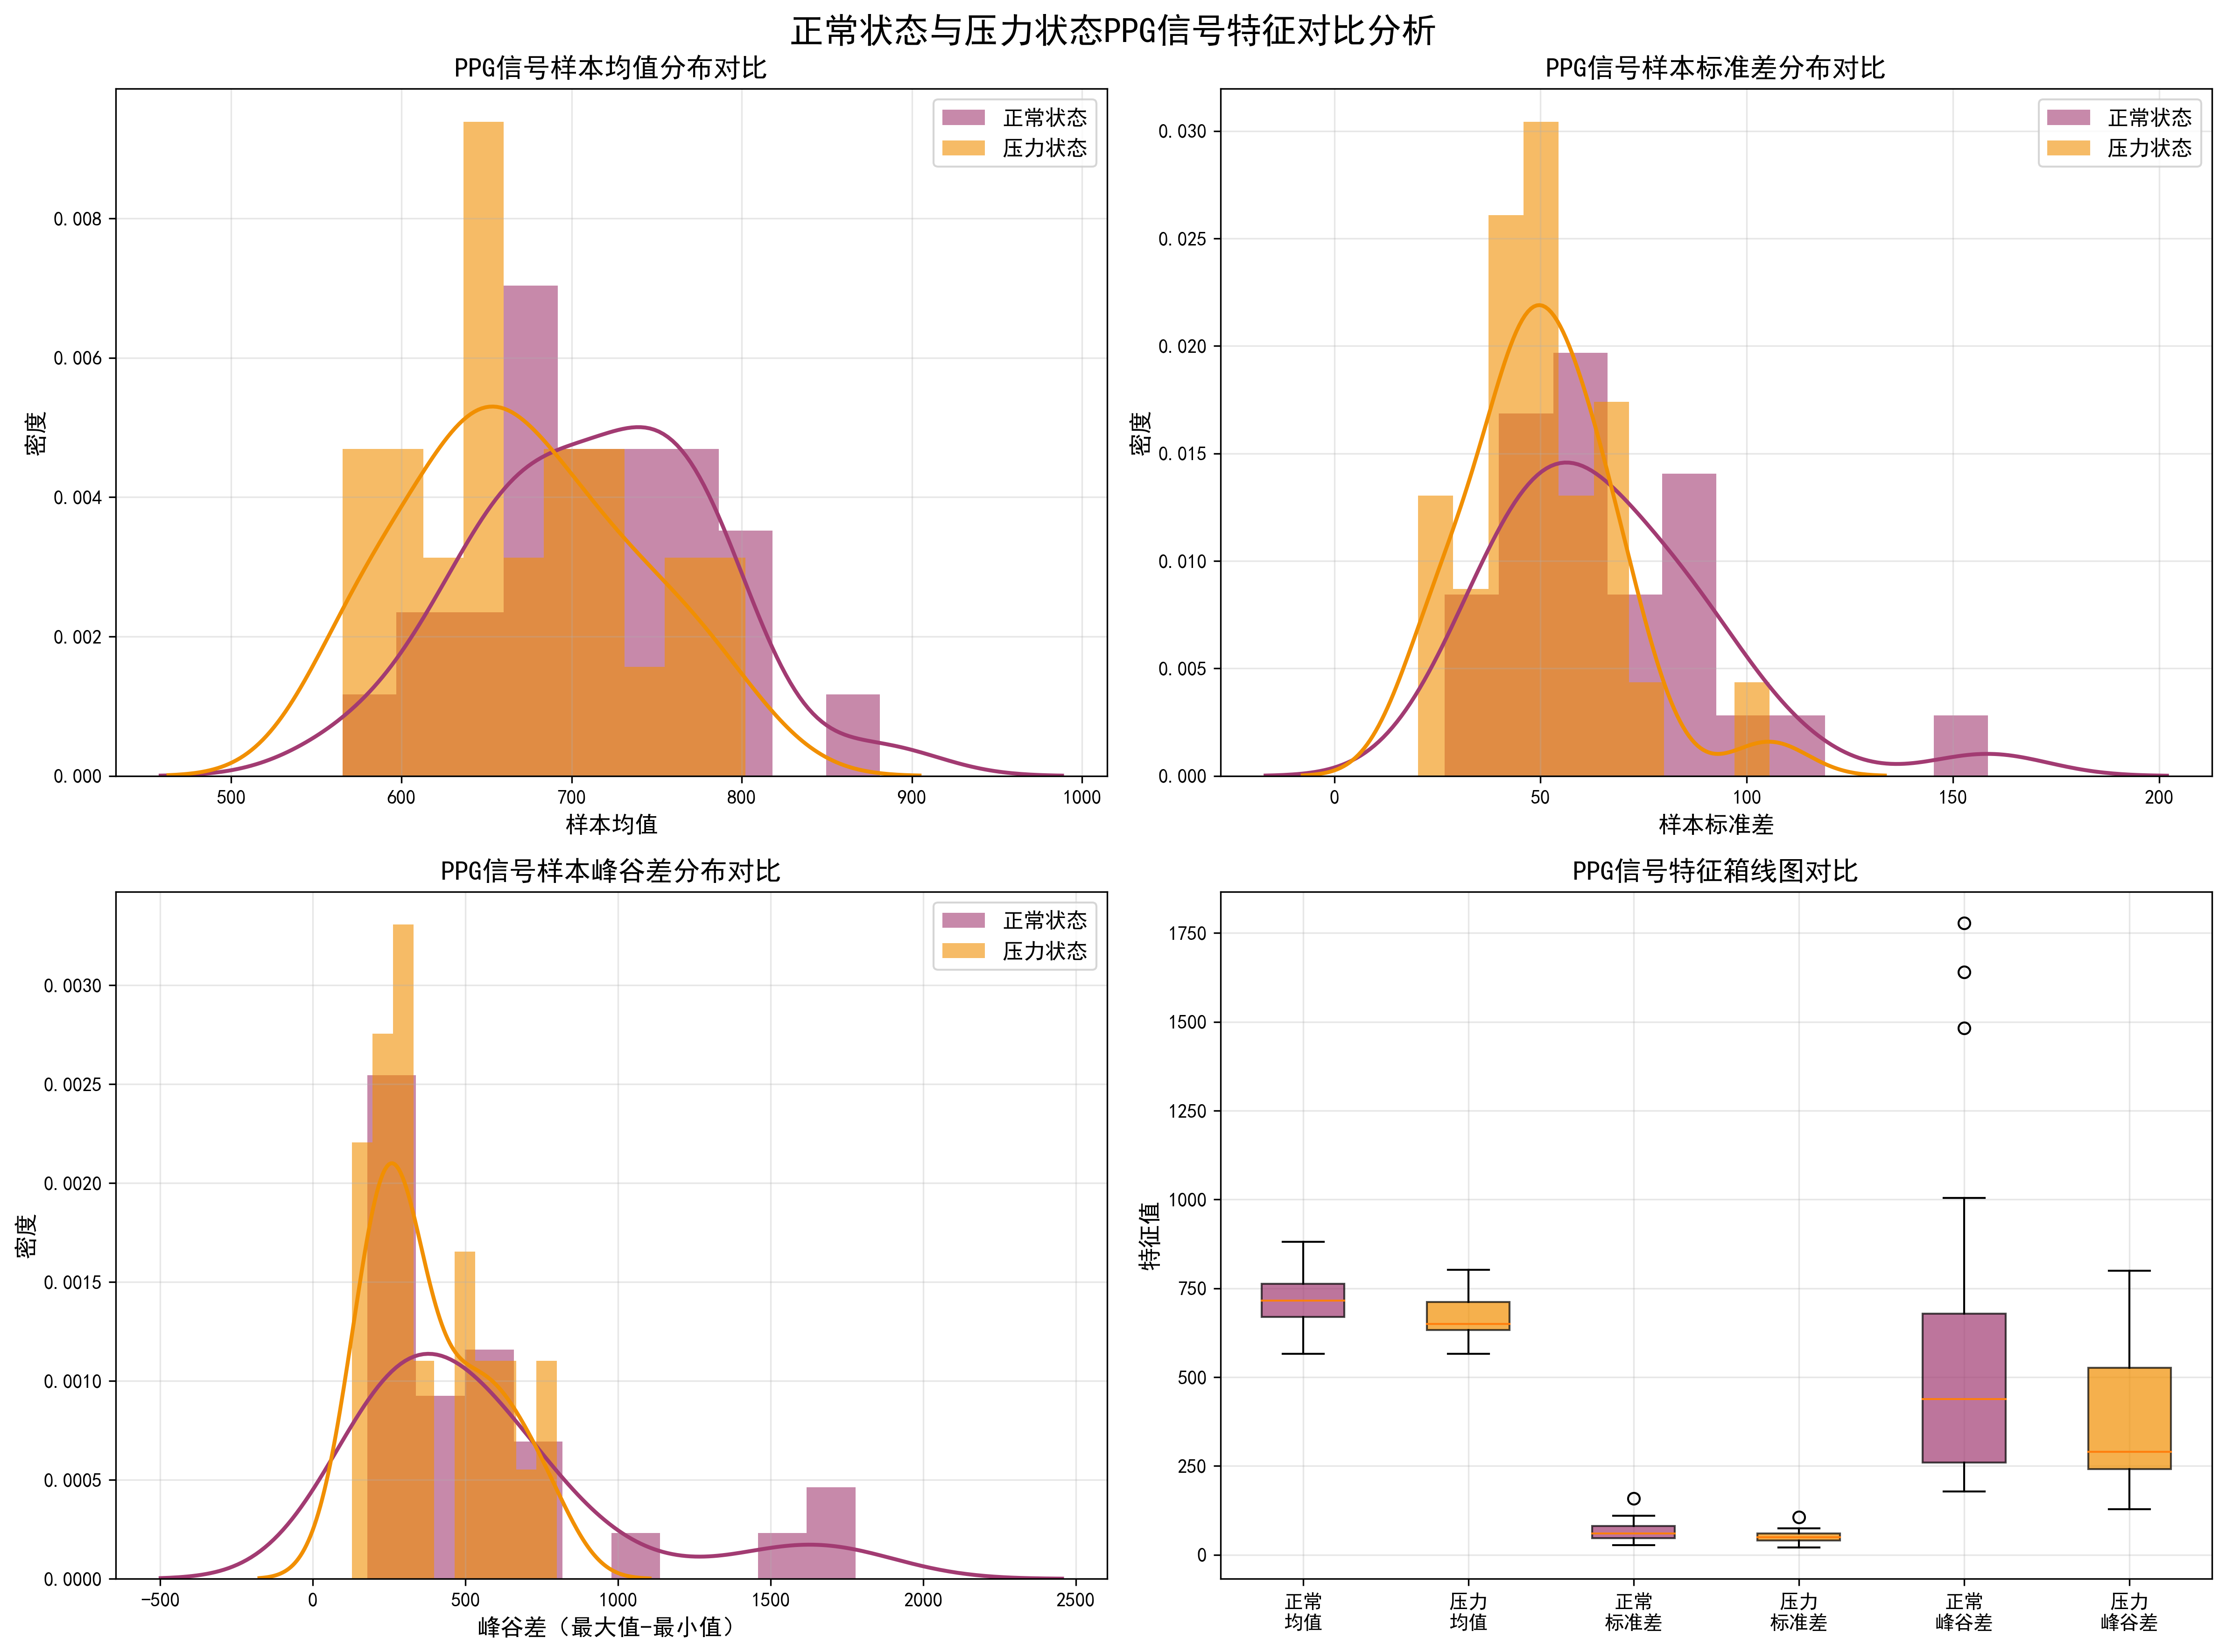
我们首先对下载获取的原始数据进行初步查看与梳理,明确数据结构及完整性;其次,针对正常状态与压力状态下的 PPG 信号特征展开对比分析,并绘制可视化对比图,直观呈现两种状态下信号的差异;最后,分别绘制整体 PPG 信号的全貌图,以及正常状态、压力状态下 的分布特征图,部分结果详见表1,图 1 - 图 3。数据结构分析如下:数据规模:54 行 ×684 列,包含 27 名受试者的 PPG 信号数据;数据构成:(1)subject ID:受试者编号(27 个唯一值,每人 2 条记录),(2)labels:状态标签(2 个唯一值:norma正常状态、stress压力状态),(3)数字列(0-681):PPG 信号的时间序列数据,共 682 个时间点,其中有效长度如下:(正常状态:平均有效长度 440.19 个时间点,范围 337-682,压力状态:平均有效长度 494.44 个时间点,范围 360-661);缺失值情况:仅少量缺失值(主要集中在部分样本的尾部时间点),整体数据质量良好。缺失值处理:仅仅对含缺失值的列进行删除处理,故最终样本长度为:337。表1,图 1 - 图 3分析如下:表1中结果显示:正常状态下 PPG 信号比压力状态整体强度更高。图 1中结果显示:上图:整体 PPG 信号均值趋势及标准差区间,显示信号的整体变化规律;左下:两种状态的均值曲线对比,正常状态始终高于压力状态;右下:两种状态的标准差对比,正常状态波动更大。图 2中显示:上两图:两种状态的时间序列分布,包含均值及标准差区间;中两图:两种状态的四分位数分布,展示数据的离散程度;下图:均值差异曲线,显示正常状态在所有时间点均高于压力状态,差异稳定。图3中显示:左上:样本均值分布,正常状态呈右偏分布,整体水平更高;右上:样本标准差分布,正常状态分布更分散,波动范围更大;左下:样本峰谷差分布,正常状态分布更宽,幅度差异更显著;右下:箱线图对比,直观展示两种状态在三个核心特征上的差异。
| 状态 | 正常状态 | 压力状态 |
| 样本均值 ±标准差 | 713.38 ± 67.61 | 669.61 ± 64.71 |
1.2.2 数据滤波
这里主要针对漂移和噪声两大问题。首先,为校正漂移并处理异常值,我们设定信号值的合理范围为 600 至 1000,任何超出此范围的值均被视为异常,并以数据的全局中位数替换。其次,为抑制噪声,我们应用了 Savitzky-Golay 滤波进行信号平滑。该滤波算法是一种数字信号处理算法,用于对信号进行平滑处理。该算法利用最小二乘法拟合局部数据段,然后用拟合的函数来估计每个数据点的值,从而实现平滑处理。 SG 滤波算法的优点是可以同时实现平滑和去噪,可以有效滤除高频噪声,对于非线性信号也有较好的适应性。此外,该算法计算速度快,不需要频域转换,适用于实时信号处理[10]。本文在此滤波过程中,窗口大小参数设置为 5(注意:此参数必须为奇数,它决定了每次平滑操作所涉及的邻近数据点数量,窗口越大,平滑效果越强);而多项式拟合次数则设定为 3(通常在 2 或 3 之间取值,用于对窗口内的数据点进行多项式拟合,随后可通过求导或直接输出拟合结果来得到平滑后的信号)。
代码如下:
data=pd.read_csv('data.csv')
data=df.iloc[:,2::].T
labels=df.iloc[:,1].T
data.dropna(how='any',inplace=True,axis=0)
data=np.where((data.values > 1000) | (data.values<600), np.median(data.values), data.values)#
from scipy.signal import savgol_filter#将超出合理范围的信号值替换为全局中值。
data1=savgol_filter(data,5,3)#SG滤波
plt.plot(data[:,10:11],label='Non Filtered');
plt.plot(data1[:,10:11],label='Filtered');
plt.xlabel('time')
plt.ylabel('R-R interval')
plt.title('Savitzky-Golay filte data')
plt.legend()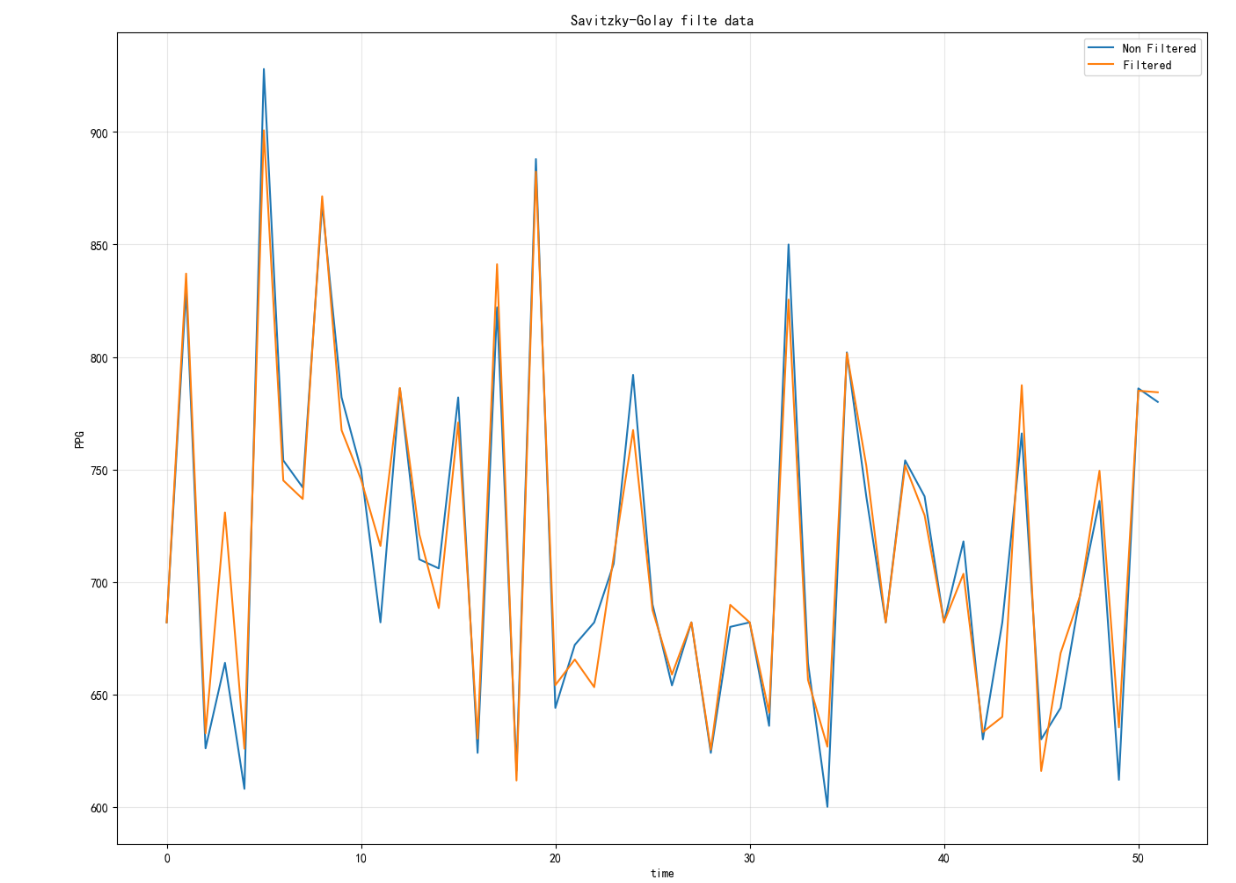
2 特征工程
2.1 特征提取
2.1.1 时域特征提取
本文针对PPG信号选择了18个时域特征对应如下:
(1)均值 (Mean)
(2)方差 (Variance):
(3)中位数 (Median)
n为奇数:
n为偶数:
(4)最大值 (Maximum)
(5)最小值 (Minimum)
(6) 极差 (Range)
(7) 均方根差值 (RMSSD)
(8)标准差差值 (SDSD)
(9)相邻差值大于 50 的个数 (NNI_50)
(10)相邻差值大于 50 的百分比 (PNNI_50)
(11) 相邻差值大于 20 的个数 (NNI_20)
(12)相邻差值大于 20 的百分比 (PNNI_20)
(13)平均心率 (Average Heart Rate)
(14) 心率标准差 (Standard Deviation of Heart Rate)
(15) 最小心率 (Minimum Heart Rate)
(16)最大心率 (Maximum Heart Rate)
(17) 能量 (Energy)
(18) 绝对差分和 (Sum of Absolute Differences, SAD)
其中, x 为输入序列;n 为序列 x 的长度;;指示函数
在条件满足时返回 1,否则返回 0。
将54个样本按照上述公式进行求解,最终得到54X18的时域特征集,最后将时域特征数据集进行绘制直方图,具体见图4。从直方图及结果来看 18 个特征的分布呈现出类别化特点:统计类特征(mean、median、max、min)整体呈近似正态分布,数据集中在特定区间且无明显异常值,其中 mean 和 median 集中在 700-730 区间,max 集中在 800-850 区间,min 集中在 620-640 区间,反映出基础数据的稳定性;var(方差)和 ranges(范围)分布略有差异,var 呈右偏分布,存在少量高方差样本(,ranges 则分布相对均匀,覆盖 100.86-350.29 的区间,体现部分样本离散程度的差异性。心率变异性相关特征中,rmssd 与 sdsd分布高度一致(集中在 24-30 区间),符合二者数学定义的关联性;nni_50 与 pnni_50 呈明显右偏分布,多数样本集中在低值区域,仅少数样本出现高值;nni_20 与 pnni_20 分布平缓,数据集中度较高。心率特征(avg_hr、std_hr、min_hr、max_hr)均表现出良好的分布特性,avg_hr 在 82.32-88.61 区间呈正态分布,符合正常心率范围;std_hr 集中在 3.28-4.60 区间,反映心率稳定性较好;min_hr 和 max_hr 分别集中在 70.36-77.99、94.09-99.27 区间,无极端异常值。能量类特征中,energy 分布均匀(,abs_sum_diff 呈轻微右偏分布,多数样本集中在一定 区间,整体数据质量良好,无严重分布倾斜问题。

直方图代码如下:
df=time_features
features_to_plot = df.columns.tolist()
# 创建4x5的子图布局(共20个子图位置,使用前18个)
fig, axes = plt.subplots(4, 5, figsize=(20, 16))
fig.suptitle('18个特征的直方图分布', fontsize=20, fontweight='bold', y=0.98)
# 展平axes数组以便于索引
axes_flat = axes.flatten()
# 定义颜色方案
colors = ['#2E86AB', '#A23B72', '#F18F01', '#C73E1D', '#6A994E',
'#577590', '#F8961E', '#90A959', '#F9844A', '#90BE6D',
'#43AA8B', '#577590', '#277DA1', '#F94144', '#F3722C',
'#F8961E', '#F9C74F', '#90BE6D']
# 为每个特征绘制直方图
for i, (feature, color) in enumerate(zip(features_to_plot, colors)):
ax = axes_flat[i]
# 绘制直方图
n, bins, patches = ax.hist(df[feature].dropna(),
bins=15,
color=color,
alpha=0.7,
edgecolor='white',
linewidth=0.8)
# 添加统计信息
mean_val = df[feature].mean()
median_val = df[feature].median()
# 绘制均值线和中位数线
ax.axvline(mean_val, color='red', linestyle='--', linewidth=2, label=f'均值: {mean_val:.2f}')
ax.axvline(median_val, color='darkblue', linestyle='-.', linewidth=2, label=f'中位数: {median_val:.2f}')
# 设置标题和标签
ax.set_title(f'{i+1}. {feature}', fontsize=12, fontweight='bold', pad=10)
ax.set_xlabel('特征值', fontsize=10)
ax.set_ylabel('频数', fontsize=10)
# 设置网格
ax.grid(True, alpha=0.3, linestyle='-', linewidth=0.5)
# 添加图例
ax.legend(fontsize=8, loc='upper right')
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)
ax.spines['left'].set_color('#CCCCCC')
ax.spines['bottom'].set_color('#CCCCCC')
ax.tick_params(axis='both', labelsize=9)
for j in range(18, 20):
axes_flat[j].set_visible(False)
plt.tight_layout(rect=[0, 0, 1, 0.96])
plt.savefig('features_histogram.png', dpi=300, bbox_inches='tight',
facecolor='white', edgecolor='none')
plt.close()
print("\n各特征统计信息摘要:")
summary_stats = df[features_to_plot].describe().T[['count', 'mean', 'std', 'min', '25%', '50%', '75%', 'max']]
print(summary_stats.round(2))2.1.2 频率特征提取
首先,经过数据预处理后,PPG间期数据是不等时距的,因为心跳并不总是匀速的。而频域分析(如功率谱估计)通常要求输入数据是等时距,所以通过Python中interpldi 函数对每个PPG间期序列进行三次样条插值。首先计算每个 RR 间期对应的累计时间点,然后在一个固定的、均匀的时间网格上(由采样频率fs决定,这里设置为:fs=4 Hz )重新计算PPG 间期值,最后生成一个新的、时间间隔固定的 PPG间期序列 (如图5),为后续的频域特征提取做好准备。
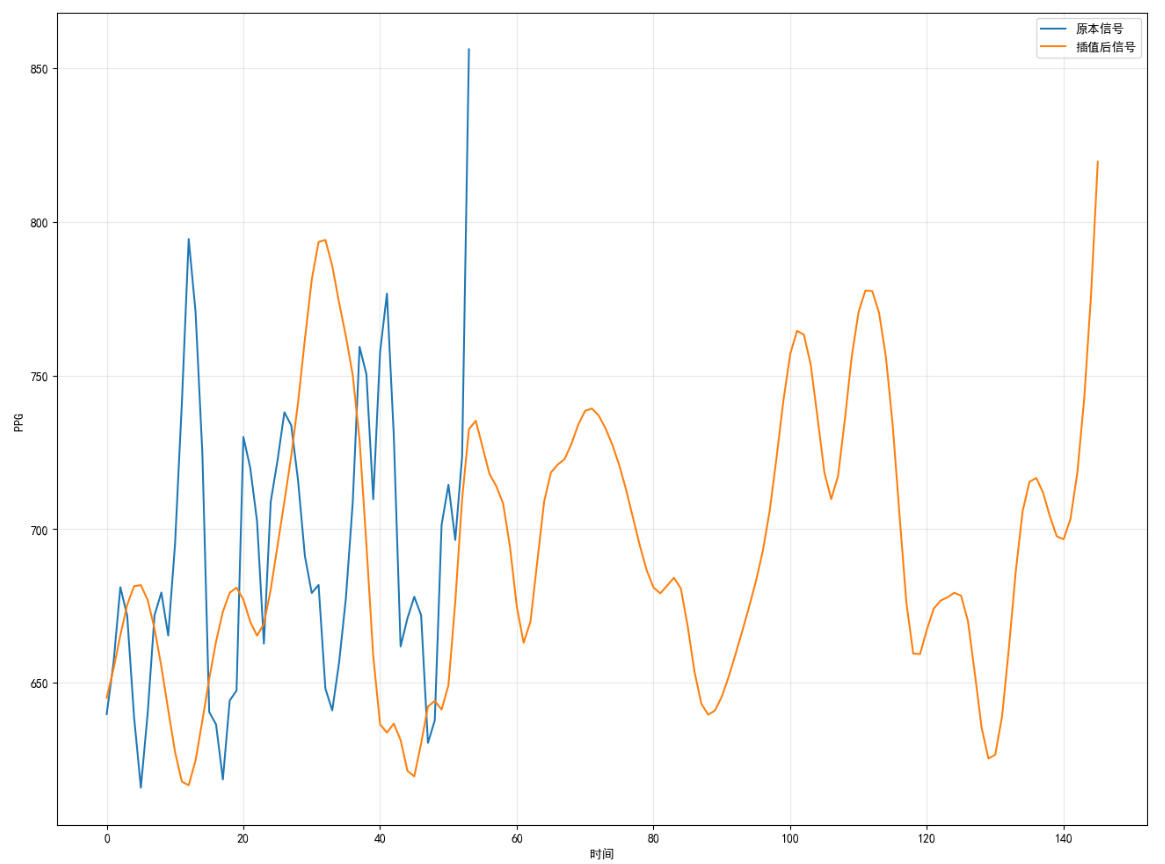
代码如下:
from scipy import signal
from scipy.ndimage import label
from scipy.stats import zscore
from scipy.interpolate import interp1d
from scipy.integrate import trapz
rr_interpolated=[]
for i in range(len(data1)):
    rr_manual=data1[i]
    x = np.cumsum(rr_manual) / 1000.0
    f = interp1d(x, rr_manual, kind='cubic',fill_value="extrapolate")
    fs = 4.0
    steps = 1 / fs
    xx = np.arange(1, np.max(x), steps)
    rr_interpolated.append(f(xx))
plt.plot(data1[0],label='原本信号');
plt.plot(rr_interpolated[0],label='插值后信号');
plt.xlabel('时间')
plt.ylabel('PPG ')
plt.legend()其次,针对新的PPG间期序列共提取了15个特征,公式见如下:
(1) 极低频功率 (VLF)
(2) 低频功率 (LF) :这个频段的功率被认为与交感神经和副交感神经的共同作用(尤其是交感神经)相关。
(3) 高频功率 (HF):这个频段的功率主要反映副交感神经(迷走神经)的活动,与呼吸节律同步。
(4) 总功率 (Total Power):整个分析频段内的功率总和,反映了 PPG间期总体的变异性。
(5)LF/HF 比值:是评估交感神经与副交感神经平衡状态的一个关键指标。比值升高通常表示交感神经活动增强,比值降低则可能表示副交感神经活动占优。
(6) 标准化 LF
(7) 标准化 HF
(8)LF 峰值频率:指在 LF 各频段内,功率谱密度达到最大值时所对应的频率。它反映了该频段内生理活动的主要节律频率。
(9)HF 峰值频率:指在 HF 频段内,功率谱密度达到最大值时所对应的频率。它反映了该频段内生理活动的主要节律频率。
(10)VLF 峰值频率:指在 VLF, 频段内,功率谱密度达到最大值时所对应的频率。它反映了该内生理活动的主要节律频率。
(11)重心频率 (Centroid Frequency):重心频率反映了信号的“中心”频率,或者说是信号频率分布的平均位置。若重心频率较低,表示信号中低频成分较多;若重心频率较高,表示信号中高频成分较多。
(12) 均方频率 (Mean Squared Frequency):均方频率反映了频谱的能量分布的集中程度。频谱的能量越集中在高频区域,均方频率的值就越大。
(13)均方根频率 (RMS Frequency):均方根频率是衡量信号频谱能量分布的集中程度的指标,通常用于描述信号的频率特征和频谱宽度。较高的均方根频率意味着信号的频率成分分布较为广泛,能量分布在较高的频率范围。
(14)频率方差 (Frequency Variance):频率方差越大,说明信号的频谱更加分散,频率成分的波动性较强。相反,频率方差越小,说明频率成分分布较为集中。
(15)频率标准差 (Frequency Standard Deviation):频率方差越大,说明信号的频谱更加分散,频率成分的波动性较强。相反,频率方差越小,说明频率成分分布较为集中。
其中, 表示功率谱密度,f 为频率(单位:Hz)。
注:(11)-(15)频率特征解释来自于[11]
最后,依据上述公式,得到54X15个频率特征集,将此特征数据集进行绘制直方图,具体见图6。在 15 个频域特征中,功率类特征(vlf、lf、hf、tot_pow)呈现出不同的分布特性:vlf(极低频功率)呈右偏分布,多数样本集中在 100-300 区间,存在少量高值样本,表明部分样本极低频段能量较强;lf(低频功率)分布分散且右偏,覆盖 168-1594 的宽范围,均值低于中位数,存在明显的高功率异常值;hf(高频功率)近似正态分布,集中在 800-1200 区间,数据稳定性较好,是 15 个特征中均值最高的指标;tot_pow(总功率)分布相对均匀,集中在 1500-2000 区间,反映整体频域能量的集中性。比值与峰值类特征(lf_hf_ratio、peak_vlf、peak_lf、peak_hf)方面:lf_hf_ratio(低频 / 高频比值)右偏分布显著,多数样本集中在 0.2-0.8 区间,少数样本比值超过 1.5(最高 2.19);peak_vlf(极低频峰值)分布高度集中,几乎所有样本都在 0.026 附近,标准差仅 0.0003,是 15 个特征中最稳定的指标;peak_lf(低频峰值)呈双峰或均匀分布,覆盖 0.05-0.14 区间,存在两个明显的数值集中区域;peak_hf(高频峰值)近似正态分布,集中在 0.18-0.25 区间,数据离散程度适中。标准化与频率统计类特征(lf_nu、hf_nu、f_centroid 等)中:lf_nu(标准化低频功率)与 hf_nu(标准化高频功率)分布呈互补关系,lf_nu 右偏、hf_nu 左偏,符合标准化指标的数学特性;f_centroid(频率重心)右偏分布,集中在 0.08-0.15 区间,少数样本超过 0.2,反映频率分布的中心位置差异;f_mean_squared(频率均方)、f_rms(频率均方根)、f_variance(频率方差)、f_std(频率标准差)四者均呈右偏分布,且分布形态高度相似,集中在低值区域,存在少量高值样本,符合频率统计指标的关联性。从整体来看,这些频域特征存在三大关键特点:一是特征关联性强,f_mean_squared、f_rms、f_variance、f_std 四个频率统计指标分布形态高度一致,lf_nu 与 hf_nu 呈严格互补,体现了频域指标的数学关联性;二是稳定性差异大,peak_vlf最稳定,lf最不稳定,反映不同频域指标的波动性差异;三是分布类型集中,15 个特征中 12 个呈右偏分布,仅 hf 和 peak_hf 接近正态分布,表明频域指标普遍存在少数高值样本的特点。

直方图代码如下:
df=freq_features
features_to_plot = df.columns.tolist()
# 创建3x5的子图布局,适配15个特征
fig, axes = plt.subplots(3, 5, figsize=(22, 15))
fig.suptitle('15个特征(频域特征)直方图分布', fontsize=20, fontweight='bold', y=0.98)
axes_flat = axes.flatten()
colors = [
    '#1f77b4', '#ff7f0e', '#2ca02c', '#d62728', '#9467bd',
    '#8c564b', '#e377c2', '#7f7f7f', '#bcbd22', '#17becf',
    '#aec7e8', '#ffbb78', '#98df8a', '#ff9896', '#c5b0d5'
]

for i, (feature, color) in enumerate(zip(features_to_plot, colors)):
    ax = axes_flat[i]
    data = df[feature].dropna()
    if feature in ['vlf', 'lf', 'hf', 'tot_pow']:  # 大数值特征
        bins = 12
    elif feature in ['lf_hf_ratio', 'peak_vlf', 'peak_lf', 'peak_hf',
                     'lf_nu', 'hf_nu', 'f_centroid', 'f_mean_squared',
                     'f_rms', 'f_variance', 'f_std']:  # 小数值特征
        bins = 15
    else:
        bins = 10
    n, bins_edges, patches = ax.hist(
        data,
        bins=bins,
        color=color,
        alpha=0.7,
        edgecolor='white',
        linewidth=1.2,
        density=False
    )
    mean_val = data.mean()
    median_val = data.median()
    std_val = data.std()
    ax.axvline(mean_val, color='#d62728', linestyle='--', linewidth=2.5,
               label=f'均值: {mean_val:.3f}')
    ax.axvline(median_val, color='#1f77b4', linestyle='-.', linewidth=2.5,
               label=f'中位数: {median_val:.3f}')
    ax.set_title(f'{i+1}. {feature}', fontsize=14, fontweight='bold', pad=12)
    ax.set_xlabel('特征值', fontsize=11)
    ax.set_ylabel('频数', fontsize=11)
    ax.grid(True, alpha=0.3, linestyle='-', linewidth=0.8)
    ax.legend(fontsize=9, loc='upper right', framealpha=0.9)
    ax.spines['top'].set_visible(False)
    ax.spines['right'].set_visible(False)
    ax.spines['left'].set_color('#cccccc')
    ax.spines['bottom'].set_color('#cccccc')
    ax.tick_params(axis='both', labelsize=10)
    if feature in ['peak_vlf', 'peak_lf', 'peak_hf', 'f_variance']:
        ax.ticklabel_format(style='plain', axis='x', scilimits=(0, 0))
plt.tight_layout(rect=[0, 0, 1, 0.96])

plt.savefig('15_features_histogram.png', dpi=300, bbox_inches='tight',
            facecolor='white', edgecolor='none')
plt.close()
2.2 特征筛选
通过时域与频域两个维度的特征提取,共获取 18 项时域特征与 15 项频域特征,总计 33 项特征指标。考虑到样本量相对较小,为有效避免后续建模过程中可能出现的过拟合问题,需进一步开展特征筛选工作。从直方图分布结果可见,绝大多数特征呈现近似正态分布或具备向正态分布靠拢的特性,符合参数检验的前提条件。基于此,本文选用 t 检验作为特征筛选方法,以筛选出对分类或预测任务具有统计显著性的关键特征。首先,介绍一下t检验,独立两样本 t 检验是比较两个独立样本均值有无显著差异。它假定两样本分 别来自正态总体,且总体方差齐性。通过考量样本均值差、标准差及样本量等信 息,推断总体均值是否不同。依据自由度与给定显著性水平算出 p 值,若 p 值小 于显著性水平,便拒绝原假设,认定两总体均值差异显著;反之,则不拒绝,即 两总体均值无显著差异。
原假设:两个独立样本均值无差异。
备择假设:两个独立样本均值有差异。
检验统计量如下:
其中 和
为两个样本的均值,
和
分别是两个样本的样本量,
和
分别是两个样本的方差。
基于此,将33 项特征指标的两种不同状态(正常、压力)进行t检验,筛选出P值小于0.05特征作为最终特征集,其结果如图7和图8,基于 t 检验的特征筛选结果显示,在 33 项时域与频域特征中,共有 19 项特征通过了显著性检验(p < 0.05),占总特征数的 57.6%。涵盖 7 个时域特征与 12 个频域特征:时域特征包括min_hr(最小心率)、max(最大值)、ranges(数据范围)、mean(均值)、median(中位数)、std_hr(心率标准差)、avg_hr(平均心率),覆盖心率核心指标与基础统计信息;频域特征包含peak_vlf(极低频峰值,显著性最高)、f_std(频率标准差)、f_centroid(频率重心)、tot_pow(总功率)、lf(低频功率)、hf(高频功率)、lf_hf_ratio(低频 / 高频比值)、peak_lf(低频峰值)、peak_hf(高频峰值)、lf_nu(标准化低频功率)、hf_nu(标准化高频功率)、f_rms(频率均方根)。
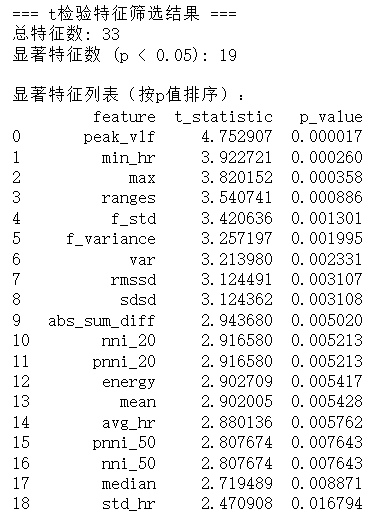
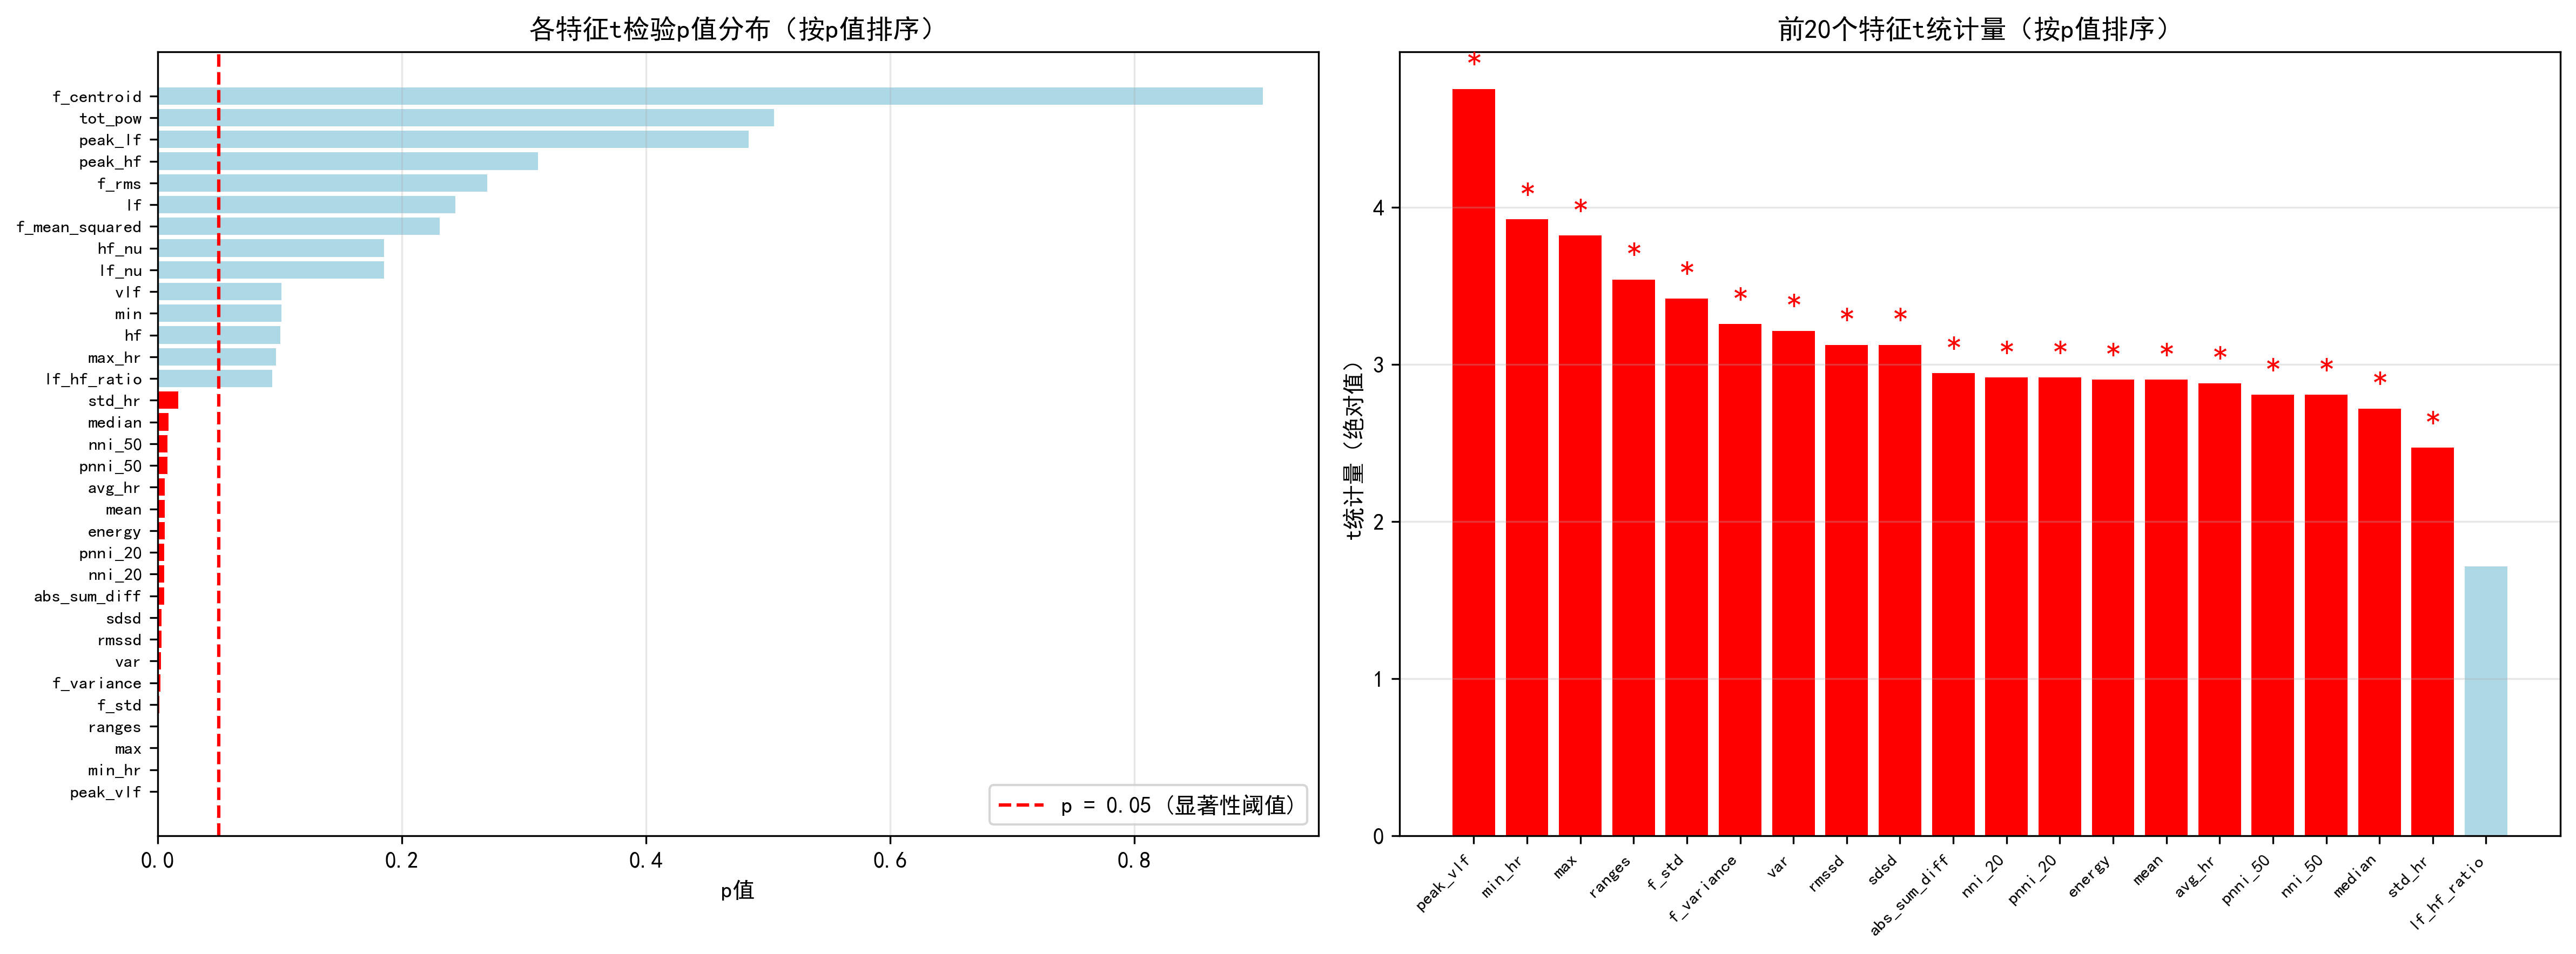
t检验代码如下:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
from sklearn.model_selection import train_test_split, cross_val_score, GridSearchCV
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score
import warnings
warnings.filterwarnings('ignore')
# 设置中文显示
plt.rcParams["font.family"] = ["SimHei"]
plt.rcParams['axes.unicode_minus'] = False
combined_features_df = pd.concat([time_features, freq_features,labels], axis=1)
combined_features_df.to_csv('combined_features.csv', index=False)
df = pd.read_csv('combined_features.csv')
X = df.drop('labels', axis=1)
y = df['labels']
# 将目标变量转换为数值型(normal=0, stress=1)
y_encoded = (y == 'stress').astype(int)
# 2. 进行t检验筛选特征
t_statistics = []
p_values = []
feature_names = X.columns
for feature in feature_names:
    # 分离两个类别的特征值
    group_normal = X.loc[y == 'normal', feature]
    group_stress = X.loc[y == 'stress', feature]
    # 进行独立样本t检验(假设方差不齐)
    t_stat, p_val = stats.ttest_ind(group_normal, group_stress, equal_var=False)
    t_statistics.append(abs(t_stat))
    p_values.append(p_val)
# 创建t检验结果DataFrame并排序
t_test_results = pd.DataFrame({
    'feature': feature_names,
    't_statistic': t_statistics,
    'p_value': p_values
})
t_test_results_sorted = t_test_results.sort_values('p_value')
significant_features = t_test_results_sorted[t_test_results_sorted['p_value'] < 0.05]
print("=== t检验特征筛选结果 ===")
print(f"总特征数: {len(feature_names)}")
print(f"显著特征数 (p < 0.05): {len(significant_features)}")
print("\n显著特征列表(按p值排序):")
print(significant_features[['feature', 't_statistic', 'p_value']].reset_index(drop=True))
# 显示所有特征的t检验结果(前20个)
print(f"\n所有特征t检验结果(前20个,按p值排序):")
print(t_test_results_sorted[['feature', 't_statistic', 'p_value']].head(20).reset_index(drop=True))
# 3. 可视化t检验结果
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))
# 图1:p值分布
ax1.barh(range(len(t_test_results_sorted)), t_test_results_sorted['p_value'],
         color=['red' if p < 0.05 else 'lightblue' for p in t_test_results_sorted['p_value']])
ax1.set_yticks(range(len(t_test_results_sorted)))
ax1.set_yticklabels(t_test_results_sorted['feature'], fontsize=8)
ax1.axvline(x=0.05, color='red', linestyle='--', label='p = 0.05 (显著性阈值)')
ax1.set_xlabel('p值')
ax1.set_title('各特征t检验p值分布(按p值排序)')
ax1.legend()
ax1.grid(axis='x', alpha=0.3)
# 图2:t统计量分布(前20个特征)
top_20_features = t_test_results_sorted.head(20)
colors = ['red' if p < 0.05 else 'lightblue' for p in top_20_features['p_value']]
bars = ax2.bar(range(len(top_20_features)), top_20_features['t_statistic'], color=colors)
ax2.set_xticks(range(len(top_20_features)))
ax2.set_xticklabels(top_20_features['feature'], rotation=45, ha='right', fontsize=8)
ax2.set_ylabel('t统计量(绝对值)')
ax2.set_title('前20个特征t统计量(按p值排序)')
ax2.grid(axis='y', alpha=0.3)
for i, (bar, p_val) in enumerate(zip(bars, top_20_features['p_value'])):
    if p_val < 0.05:
        ax2.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.1,
                '*', ha='center', va='bottom', fontsize=12, color='red')
plt.tight_layout()
plt.savefig('t_test_feature_selection.png', dpi=300, bbox_inches='tight')
plt.close()
# 4. 选择显著特征构建新的特征矩阵
if len(significant_features) > 0:
    selected_features = significant_features['feature'].tolist()
else:
    # 如果没有显著特征,选择p值最小的前10个特征
    selected_features = t_test_results_sorted.head(10)['feature'].tolist()
    print(f"\n警告:没有p < 0.05的显著特征,将选择p值最小的前10个特征进行后续分析")
X_selected = X[selected_features]
t_test_results_sorted.to_csv('t_test_feature_results.csv', index=False)
3 方法
3.1 机器学习算法理论
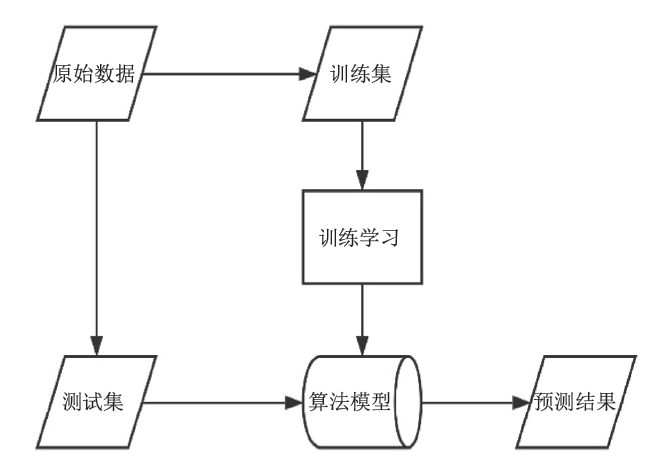
机器学习是一门多领域交叉学科,涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等多门学科。专门研究计算机怎样模拟或实现人类的学习行为,以获取新的知识或技能,重新组织已有的知识结构使之不断改善自身的性能。它是人工智能核心,是使计算机具有智能的根本途径[12]。其流程如下(见图9):首先将收集到的原始数据拆分为两个部分,一部分作为 “训练集”,另一部分作为 “测试集”。其中,训练集被输入到 “训练学习” 环节,通过算法对数据特征与标签之间的关联规律进行学习、拟合,最终生成具备预测能力的 “算法模型”;之后,将独立的测试集数据输入到已训练完成的算法模型中,由模型基于训练阶段学到的规律进行计算推理,最终输出对应的 “预测结果”。
而本文的算法模型主要为:Logistic回归、支持向量机、K-近邻分析、随机森林和梯度提升,这五种模型覆盖了传统线性、非线性和集成学习方法。其原理如下[13]:
(1)Logistic 回归用于解决分类问题,基于线性回归,但通过 Sigmoid 函数将线 性回归的输出映射到[0,1]区间,从而表示样本属于某一类别的概率。假设数据存在线性可分关系,通过最大似然估计来确定模型参数,使样本属于其真实类别的概率最大化。
其中,是表示在给定自变量
,
的概率,同样
如此,
是截距项,
是回归系数,它们表示每个自变量的影响程度。
(2)支持向量机模型旨在找到一个最优超平面,以最大化不同类之间的间隔。当数据不是 线性可分时,支持向量机模型使用核函数将数据映射到高维空间。在这个高维空间内,找 到一个超平面来分隔不同类别。支持向量机模型的核心是一个优化问题,旨在最小化一个 正则化项和一个损失函数。优化目标可以表示为:
其中,是松弛变量,
表示惩罚参数,其用于平衡间隔和分类错误之间的权衡。
(3)K-近邻分析是一种基本分类的方法。是数据挖掘技术中原理最简单的算法之一,核心功能是解决有监督的分类问题。KNN能够快速高效地解决建立在特殊数据集上的预测分类问题,其核心思想是:若某样本在特征空间中的k个最邻近样本多数属于某个类别,则该样本也归为此类[14]。
(4) 随机森林是一种集成学习模型,基于重抽样自举法的样本创建多个子集,用于构建每个决 策树,将多个决策树整合一起,最终构成整片森林。其核心思想是 “集体智慧优于个体”,它通过集成学习策略,先利用重抽样自举法从原始数据中随机生成多个不同的样本子集,再为每个子集独立构建一棵决策树,最后让所有决策树共同参与预测,通过投票(分类任务)或取平均(回归任务)的方式输出最终结果,以此降低单棵决策树的过拟合风险,提升模型的稳定性和预测精度。
(5) 梯度提升算法同样是一种集成学习方法,它的核心思想是利用损失函数的负梯度作为残差的近似值,然后用一个基学习器拟合这个残差,再将其加到之前的模型上,从而不断地减小损失函数的值。这种算法可以用任何可微分的损失函数,并且可以用任何基学习器,如决策树等。因此,梯度提升算法比其他基于单一类型损失函数的算法更加灵活和通用[15]。
3.2 基于PPG信号的心理压力预测方法
根据上节筛选得到的 19 个显著特征,本研究采用以下步骤进行模型训练与性能评估,并结合超参数优化策略提升模型性能:首先,将包含 56 个样本的数据集按 7:3 比例划分为训练集和测试集,为避免单次划分的随机性对结果造成影响,共进行五次独立的数据划分,确保每次测试集样本均不重复;考虑到样本量较小(仅 56 个),传统的单次划分评估方法可能导致结果过拟合或欠拟合,因此采用交叉验证法对模型性能进行综合验证,以提高评估结果的可靠性。其次,针对五种不同的机器学习算法(逻辑回归、随机森林、支持向量机、近邻分析、梯度提升),设计了针对性的超参数搜索网格:逻辑回归重点优化正则化强度 C(0.01、0.1、1、10、100);随机森林调整决策树数量(50、100、200)、最大深度(无限制、5、10)和最小分裂样本数(2、5);支持向量机优化惩罚参数 C(0.1、1、10、100)和核函数系数 gamma(scale、auto、0.01、0.1、1);近邻分析关注邻居数量(3、5、7、9、11)、权重策略(均匀、距离加权)和距离度量方式(欧氏距离、曼哈顿距离);梯度提升则调整弱学习器数量(50、100、200)、学习率(0.01、0.1、0.2)和决策树最大深度(3、5、7)。在每次数据划分中,使用训练集通过网格搜索进行超参数寻优,确定最优参数组合后训练模型,再将对应的测试集输入模型得到预测结果。最后,针对五次实验的预测结果,计算评价指标(如准确率等),并取五次指标的均值作为模型的最终性能评价结果,从而全面、客观地反映不同算法在该数据集上的泛化能力及超参数优化的实际效果。
3.3 评价指标
(1)Accuracy(准确率):指模型正确预测的样本数占总样本数的比例,反映模型整体的预测正确性,公式为:
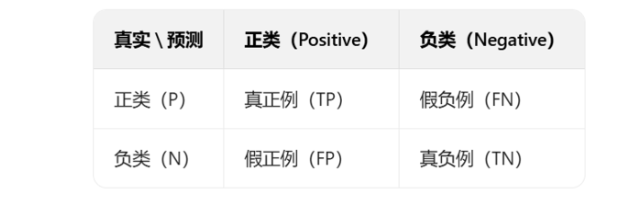
其中 TP 为真阳性,TN 为真阴性,FP 为假阳性,FN 为假阴性。
(2)混淆矩阵:是评估分类模型性能的核心工具之一,它通过统计模型在不同类别上的 “预测结果” 与 “真实标签” 的匹配情况,直观展示模型的分类误差分布[16]。
4 结果
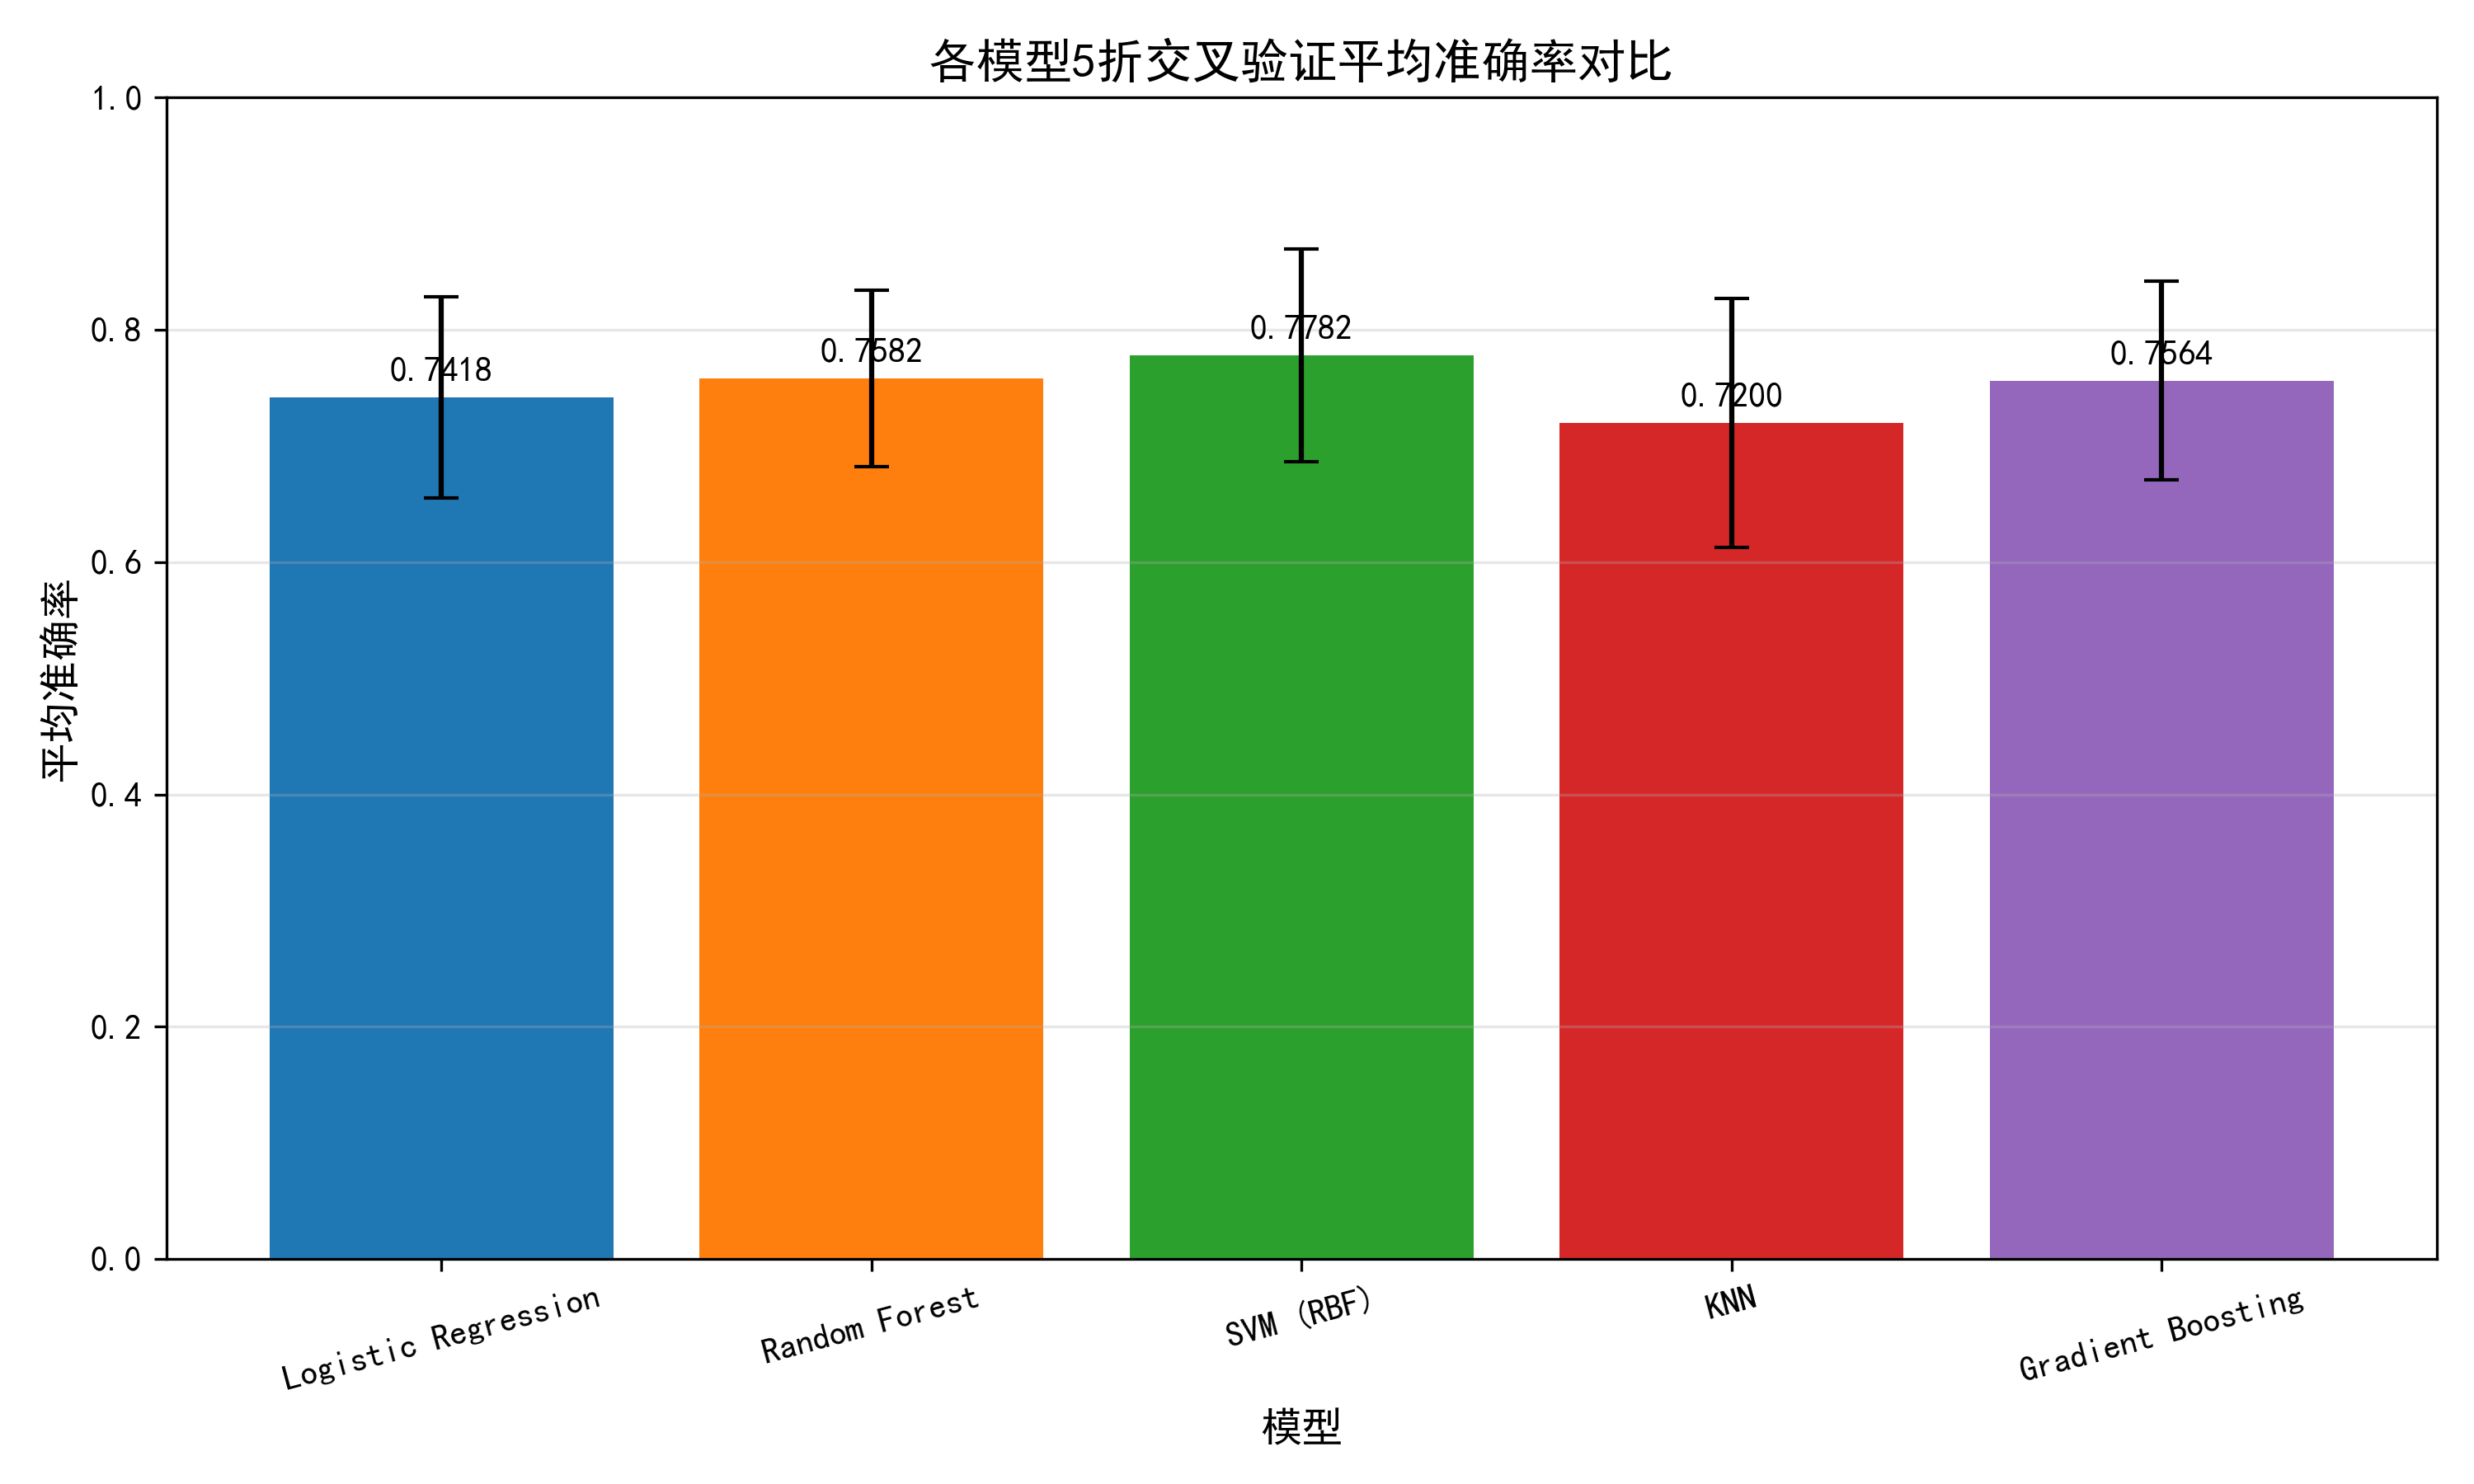
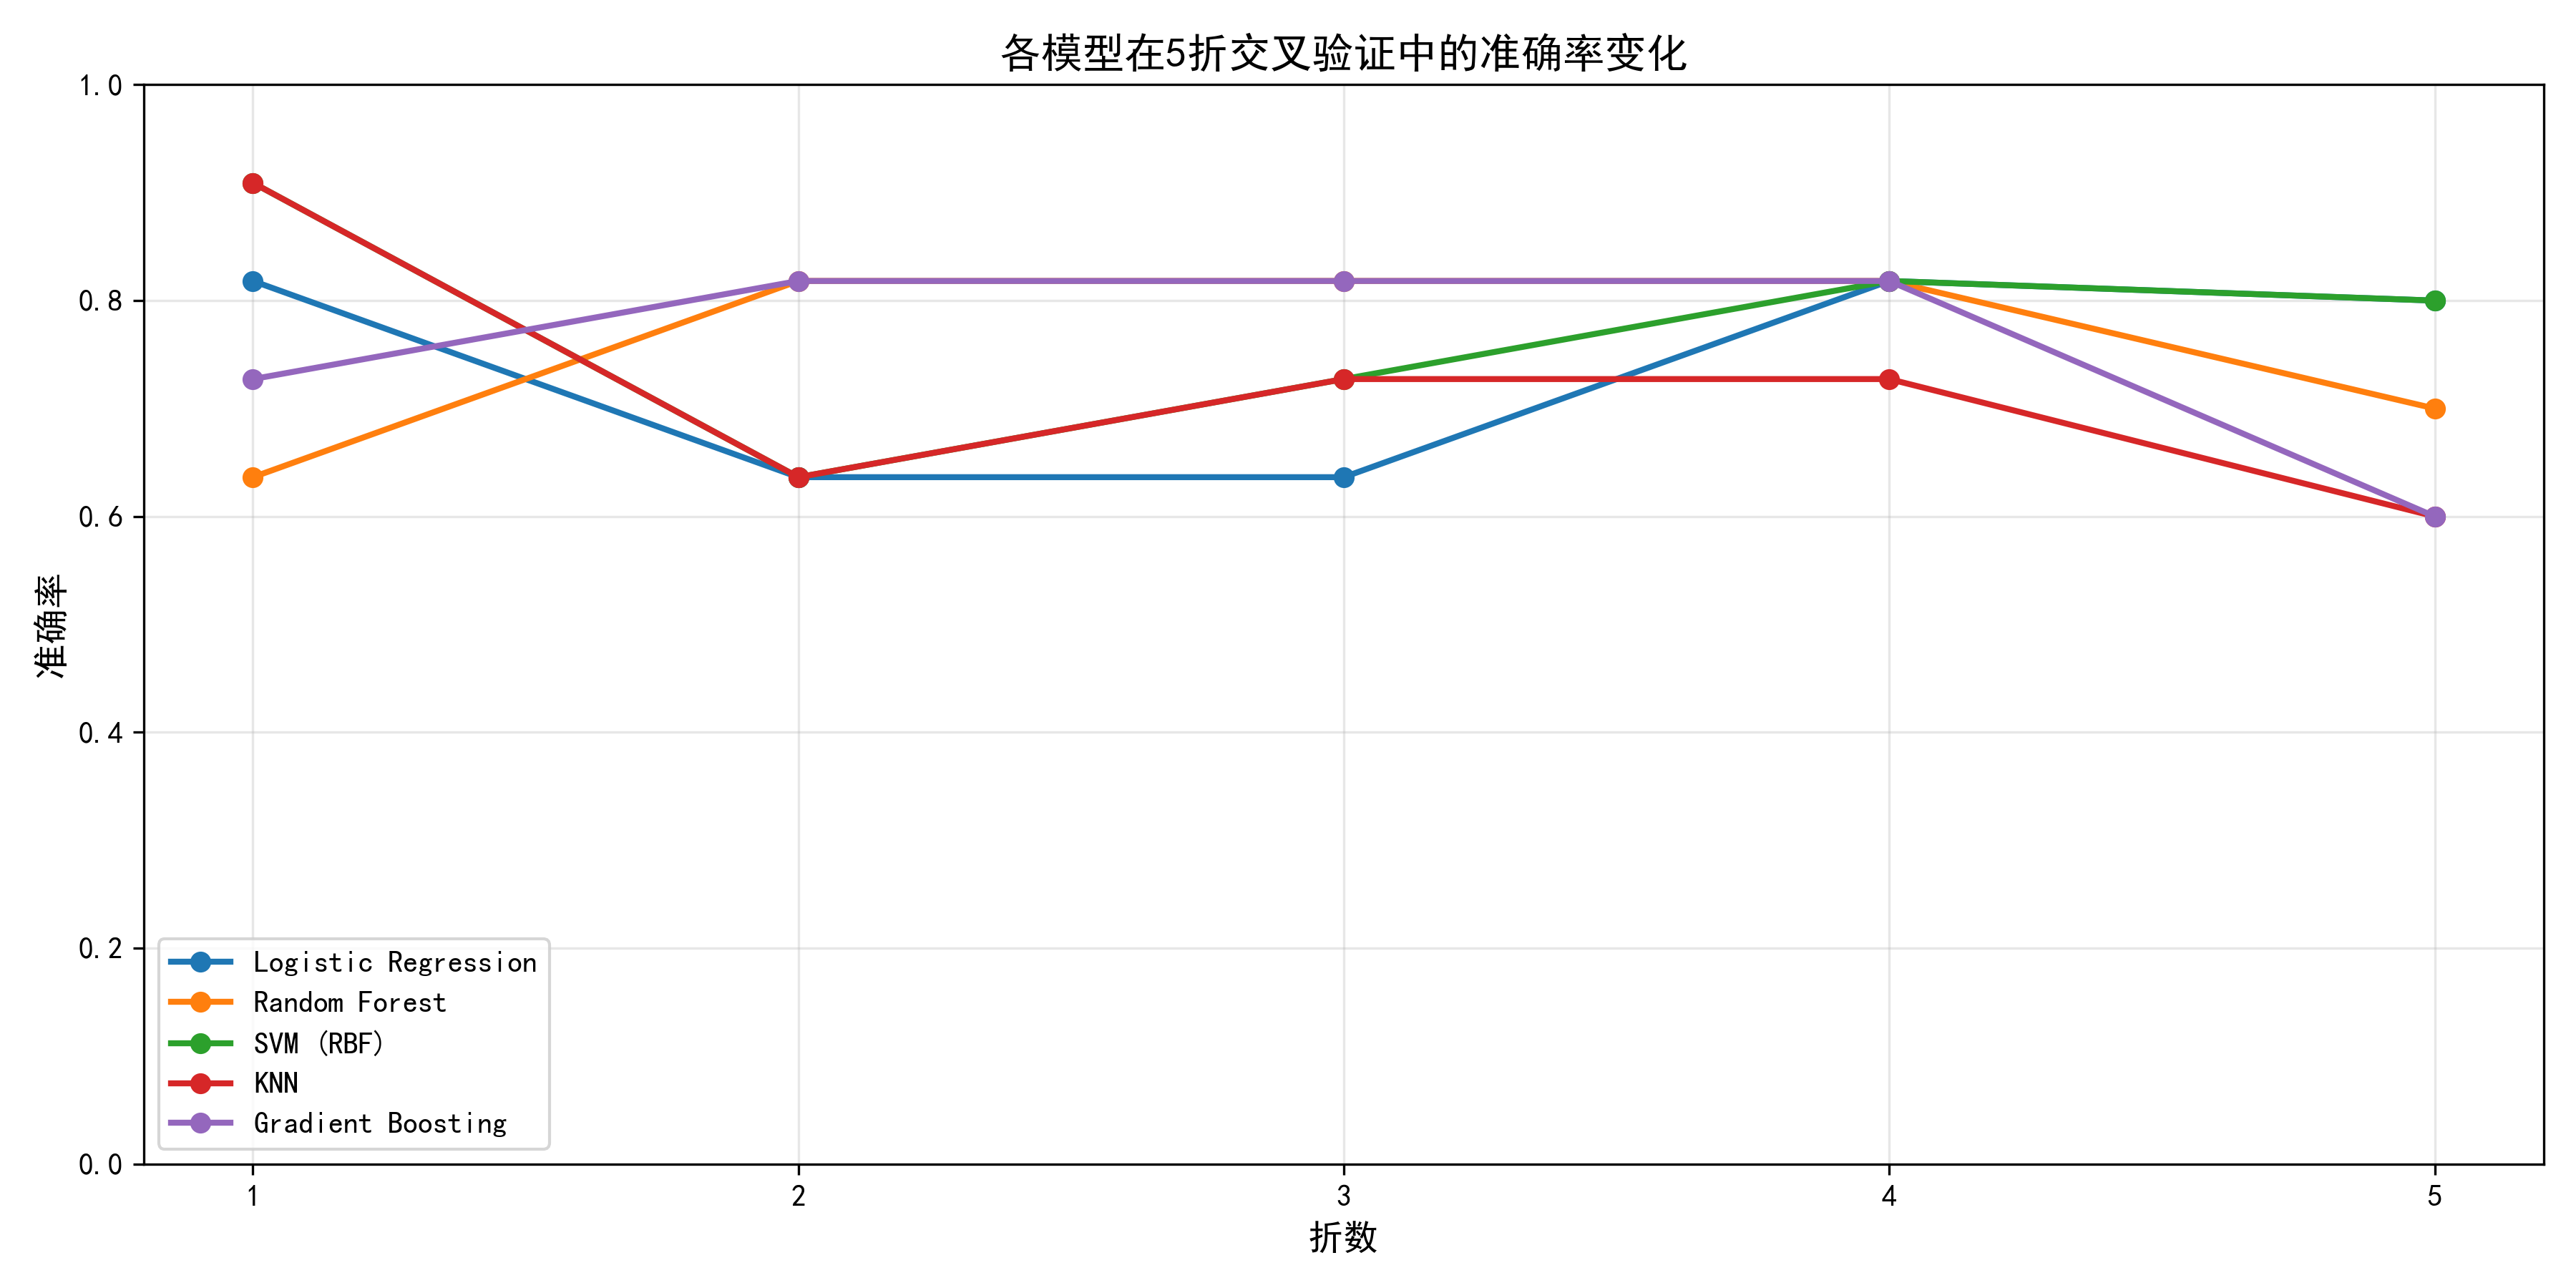
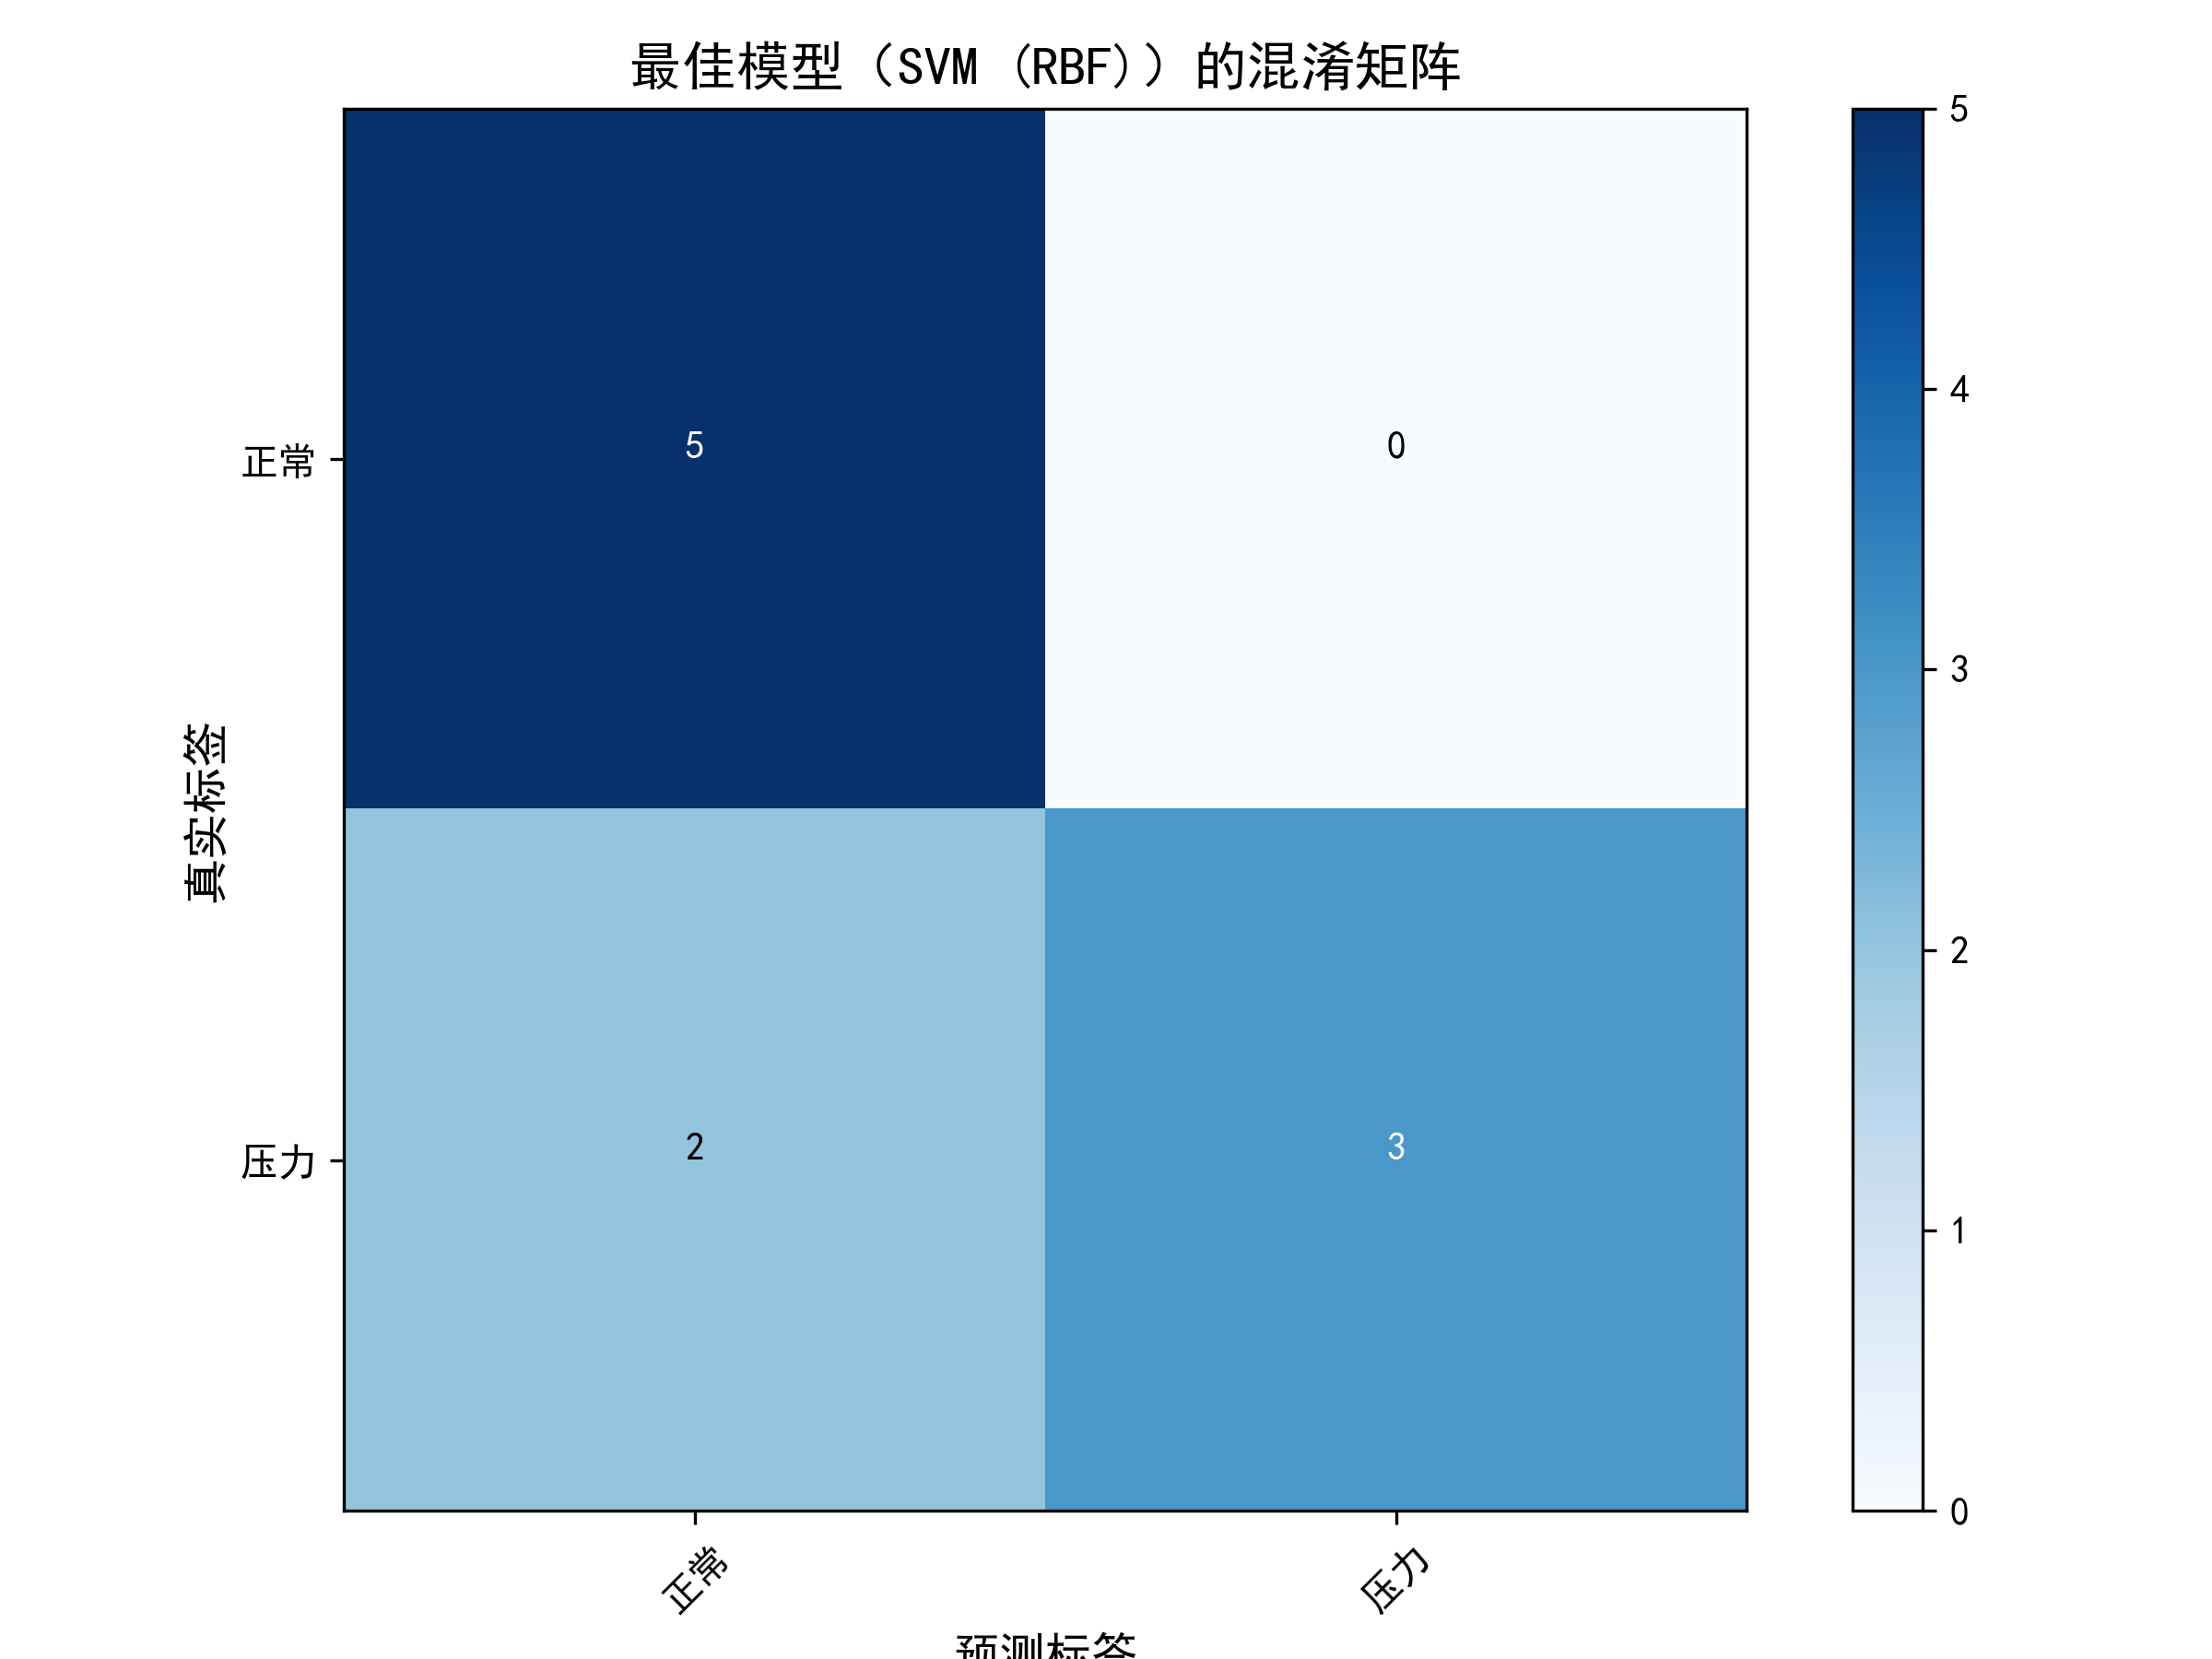
本文以PPG脉搏波信号为基础,提取 19 个显著时域与频域特征,采用 5 折交叉验证对逻辑回归、逻辑回归、随机森林、支持向量机、近邻分析、梯度提升共 5 种机器学习算法的心理压力诊断性能展开分析。结果如图11-13所示,从模型平均准确率对比结果来看,支持向量机以 0.7782 的平均准确率位居首位,随机森林(0.7682)、梯度提升(0.7664)紧随其后,逻辑回归(0.7418)与近邻分析(0.7200)的性能相对偏低,各模型准确率集中在 0.72-0.78 区间,整体体现出 PPG 信号特征对心理压力状态的区分能力。从 5 折交叉验证的准确率变化曲线可知,支持向量机的准确率在各折中始终保持较高水平,而梯度提升、、近邻分析的准确率波动较大(如梯度提升在第 5 折准确率降至 0.6),说明支持向量机在小样本数据集上的泛化稳定性更优。作为最优模型,支持向量机的混淆矩阵揭示了其分类细节:该模型对 “正常” 类别的识别实现了 100% 的精准度(5 个真实正常样本全部正确预测,无假正例),但对 “压力” 类别的诊断存在 2 例误判(5 个真实压力样本中 2 例被预测为 “正常”),这一偏差既反映了 PPG 信号在 “压力” 状态下的特征特异性不足(部分压力样本的生理特征与正常样本存在重叠),也与小样本数据集中 “压力” 样本的分布局限性有关。而从 5 折交叉验证的准确率变化曲线可知,支持向量机的性能在各折中始终保持稳定(基本维持在 0.8 左右),相比之下,梯度提升、近邻分析的准确率波动更为明显(如梯度提升在第 5 折准确率降至 0.6),这一结果表明 SVM支持向量机在小样本、高维特征场景下的适配性 —— 其 RBF 核能够有效捕捉 PPG 信号特征与心理压力间的非线性关联,同时通过超参数网格搜索优化的正则化策略,避免了小样本数据下的过拟合风险。
5 讨论
本文通过基于耳垂PPG信号并提取PRV特征,系统评估了多种机器学习算法在心理压力诊断中的性能。结果表明,基于PPG信号的机器学习模型能够有效区分压力状态,为心理压力的无创诊断提供了可行的技术路径。在模型性能方面,支持向量机在五种对比算法中表现最佳,其优势主要源于PPG信号特征与心理压力状态之间存在的非线性关联——其所采用的径向基函数核能够有效捕捉生理信号中复杂的波动模式,同时通过超参数优化在小样本条件下较好地平衡了拟合能力与泛化性能。相比之下,近邻分类器性能相对薄弱,主要由于其“近邻投票”机制对样本分布高度敏感,在有限样本中存在的特征重叠问题显著影响了分类的可靠性。PPG信号具备采集便捷、设备成本低的天然优势,结合经筛选所得的19个核心特征,所构建模型实现了约78%的诊断准确率,为日常场景下的心理压力无创监测提供了可行的技术路径。然而,本研究亦存在局限性:样本规模较小(仅56例)限制了模型的泛化能力与稳定性;PPG信号易受个体基础生理差异及环境干扰影响,导致“压力”状态对应的特征区分度不足;部分特征不服从正态分布,在此情况下使用t检验进行特征筛选可能导致误判;研究对象局限于大学生群体;尚未引入时频域图像特征以挖掘更深层的节律信息,亦缺乏与心电图(ECG)等标准生理参考信号的对比验证。后续研究可从以下方面推进:扩大样本规模并覆盖更广泛的人群;引入动态PPG特征(如心率变异性的时序趋势分析);融合皮肤电、呼吸等多模态生理信号以增强系统鲁棒性;采用非参数检验或基于模型的特征重要性评估方法优化特征选择;进一步探索时频图特征在表征心理压力细微变化方面的潜力,并与ECG进行同步对比以提升结果的生理可解释性。
参考
[1] 紧张
[2]心率变异性
[3] 王培丞.基于多模态生理信号的心理压力评估系统研究与应用[D].济南大学,2024.
[4] Electrophysiology T F E S C N A S P. Heart rate variability: standards of measurement, physiological interpretation, and clinical use[J]. Circulation, 1996, 93(5): 1043-1065.
[5] Pinge A, Bandyopadhyay S, Ghosh S, et al. A comparative study between ECG-based and PPG-based heart rate monitors for stress detection[C]//2022 14th International Conference on COMmunication Systems & NETworkS (COMSNETS). IEEE, 2022: 84-89.
[6] 李亚美,Martin Glos,张远,等.基于PPG信号的时频表示学习方法用于睡眠阶段识别[C]//中国睡眠研究会.第十七届中国睡眠研究会学术年会论文摘要汇编.郑州大学电气与信息工程学院;Interdisciplinary Sleep Medicine Center,Charité-Universit?tsmedizin Berlin;西南大学电子信息工程学院;,2025:388
[7] 袁钰帅.多模医学信号结合机器学习的疾病辅助诊断技术研究[D].新疆大学,2021.
[8] 基于EEGNet网络的脑电信号对阿尔茨海默与额颞叶痴呆的辅助诊断研究-CSDN博客
[9] Anwar T, Zakir S. Machine learning based real-time diagnosis of mental stress using photoplethysmography[J]. Journal of Biomimetics, Biomaterials and Biomedical Engineering, 2022, 55: 154-167.
[10] MATLAB | 数字信号处理 | SG 滤波算法 | 附数据和出图代码 | - 知乎
[11] 频域特征指标详解_重心频率-CSDN博客
[12] 机器学习(多领域交叉学科)_百度百科
[13] 基于 PPG 信号与机器学习算法的心肌梗死预测研究_-CSDN博客
[14] 一文掌握KNN(K-近邻算法,理论+实例) - 知乎
[15] 梯度提升(Gradient Boosting)算法:原理与实践-百度开发者中心
[16] 基于主成分分析的PPG信号特征用于心肌梗死预测研究-CSDN博客
注:若有侵权部分,请留言将会删除。
个人观点 ,仅供参考。
更多推荐
 39
 0
- 0


 已为社区贡献2条内容

所有评论(0)