
《动手学深度学习》-3.6Softmax回归的从零实现
要完成一个模型的训练,包括一下几个步骤,(1)有数据,并进行批量处理;(2)模型;(3)初始化模型参数;(4)损失函数,优化算法;(5)训练,即优化参数;(6)模型评价
注:以下代码在Pycharm运行
一、前期了解
1.问题
输入是28*28的灰度图。输出属于10个类别哪一类。x∈R784⟶概率向量∈R10
2.模型采用什么
o=XW+b,即把X拉成2维向量,通过每个特征*权重+偏执,为每个类别“打分”,谁得分高认为属于哪一类,同时由于打分过程可能出现负数,以及为了让打分高的更高,进行归一化处理,将其转变成概率
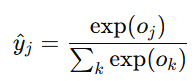
二、框架
1.首先对包进行引用
import torch
import torchvision
from torch.utils import data
from torchvision import transforms
from d2l import torch as d2l
2.获取数据集并拿到训练数据和测试数据
(1)下载数据
首先定义trans操作列表,如果需要resize操作,将其插到列表最前面,其次下载训练和测试数据集,并将其进行批量化处理并返回
需要注意的是,如果是wins,不建议多进程,可以对num_workers设置为0,教程是对其采用4线程
def load_data_fashion_mnist(batch_size, resize=None):
trans = [transforms.ToTensor()]
if resize:
trans.insert(0, transforms.Resize(resize))
trans = transforms.Compose(trans)
mnist_train = torchvision.datasets.FashionMNIST(
root="../data", train=True, transform=trans, download=True)
mnist_test = torchvision.datasets.FashionMNIST(
root="../data", train=False, transform=trans, download=True)
return (data.DataLoader(mnist_train, batch_size, shuffle=True,
num_workers=get_dataloader_workers()),
data.DataLoader(mnist_test, batch_size, shuffle=False,
num_workers=get_dataloader_workers()))
batch_size = 256
train_iter, test_iter = load_data_fashion_mnist(batch_size)
(2)初始化模型
num_inputs=28*28
num_outputs=10
W=torch.normal(0,0.01,(num_inputs,num_outputs),requires_grad=True)
b=torch.zeros(num_outputs)
def softmax(x):
x_exp=torch.exp(x)
partition=x_exp.sum(dim=1,keepdim=True)
return x_exp/partition
def net(X):
return softmax(np.dot(X.reshape(-1,W.shape[0]),W)+b)
#定义损失函数和优化算法
def cross_entropy(yhat, y):#求正确预测数量
return -np.log(yhat[range(len(yhat))],y)
def accuracy(yhat, y):
yhat=yhat.argmax(dim=1)
yhat=yhat.numpy() #运行李沐代码报错,显示astype操作并不能用于tensor,所以将其转为np
y=y.numpy()
cmp=yhat.astype(y.dtype)==y
return float(cmp.astype(y.dtype).sum())
class Accumulator:
def __init__(self,n):
self.data=[0.0]*n
def add(self,*args):
self.data=[a+float(b) for a,b in zip(self.data,args)]
def reset(self):
self.data=[0.0]*len(self.data)
def __getitem__(self,idx):
return self.data[idx]
def evaluate_accuracy(net,data_iter):#完成数据的总精确度
metrics = Accumulator(2)
for X,y in data_iter:
yhat = net(X)
metrics.add(accuracy(yhat,y),d2l.size(y))
return metrics[0]/metrics[1]
(3)训练
def train_epoch_ch3(net,train_iter,loss,updater):
if isinstance(net,torch.nn.Module): #判断模型是否是内置模型
net.train()#开始训练
metrics = Accumulator(3)#对三个参数进行累加
for X,y in train_iter:
yhat = net(X)
l = loss(yhat,y)
if isinstance(updater,torch.optim.Optimizer):
updater.zero_grad()
l.mean().backward()
updater.step()
else:
l.sum().backward()
updater(X.shape[0])
metrics.add(float(l.sum()),accuracy(yhat,y),y.numel())
return metrics[0]/metrics[2],metrics[1]/metrics[2]
(4)动图显示
class Animator:
def __init__(self,xlabel=None,ylabel=None,legend=None,xlim=None,ylim=None,fmts=('-','g-','r:'),xscale='linear',yscale='linear',nrows=1,ncols=1,figsize=(3.5,2.5)):
if legend is None:
legend=[]
self.fig,self.axes=d2l.plt.subplots(nrows,ncols,figsize=figsize)
if nrows*ncols==1:
self.axes=[self.axes]
#初始化,对子图,坐标轴进行初始化设置
self.config_axes=lambda:d2l.set_axes(self.axes[0],xlabel,ylabel,xlim,ylim,xscale,yscale,legend)
self.x,self.y,self.fmts=None,None,fmts
self.fig.show()
def add(self,x,y):
x,
是要增加的点,将点在图像里显示出来
if not hasattr(y,'__len__'):#判断y是否标量,并将其转换成标量
y=[y]
n=len(y)
if not hasattr(x,'__len__'):#判断x是否是标量,并与y对齐
X=[x]*n
if not self.X:#判断是否是首次调用,即self.X是否为空,并将其转换成n维的n条曲线列表
self.X=[[] for _in range(n)]
if not self.y:
self.y=[[] for _in in range(n)]
for i,(a,b) in enumerate(zip(x,y)): #循环拿到x里的新横坐标,y里的新的纵坐标,配对,拿到标号
if a is not None and b is not None:#将新点加入到曲线中
self.X[i].append(a)
self.y[i].append(b)
self.axes[0].cla()#清空子图
for x,y, fmts in zip(self.X,self.y,self.fmts):
self.axes[0].plot(x,y,fmts)#绘制新曲线
self.config_axes()#每次重画完线条,都能保持统一的坐标格式。
self.fig.canvas.draw()
self.fig.canvas.flush_events()
plt.pause(0.001)
(5)训练
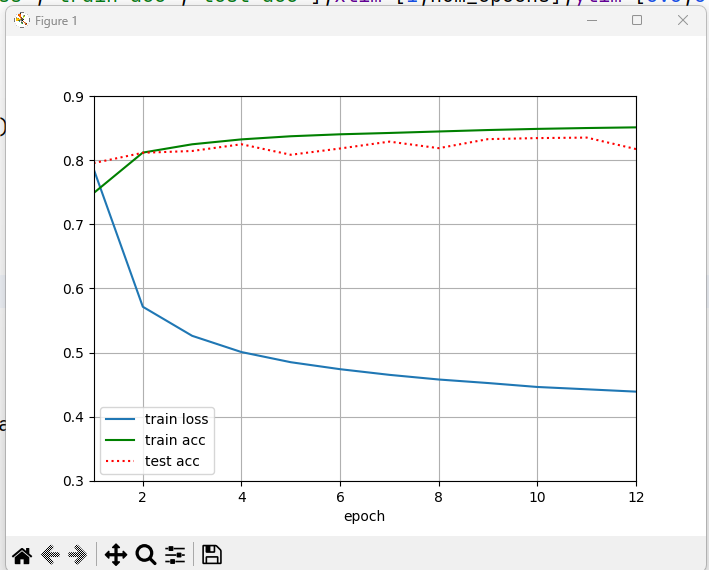
def train_cha3(num_epochs,net,train_iter,loss,updater,test_iter):
animator=Animator(xlabel='epoch',legend=['train loss','train acc','test acc'],xlim=[1,num_epochs],ylim=[0.3,0.9])
for epoch in range(num_epochs):
train_metrics=train_epoch_ch3(net, train_iter, loss, updater)
test_acc=evaluate_accuracy(net,test_iter)
animator.add(epoch+1,train_metrics+(test_acc,))
train_loss,train_acc=train_metrics
# assert train_loss<=0.5,train_loss
# assert train_acc>=0.7,train_acc
# assert test_acc>=0.7,test_acc
lr=0.1
def updater(batch_size):
return d2l.sgd([W,b],lr,batch_size)
num_epochs = 12
train_cha3(num_epochs,net,train_iter,cross_entropy,updater,test_iter)
plt.ioff()
plt.show()
三、其他文件
自定义了一个d2l文件,放了如下代码
import numpy as np
import torch
import torchvision
from IPython import display
from torch.utils import data
from torchvision import transforms#数据操作
import random
import matplotlib.pyplot as plt
import matplotlib
from matplotlib_inline import backend_inline
import d2l
from torch.utils import data
def set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend):
"""设置matplotlib的轴"""
axes.set_xlabel(xlabel)
axes.set_ylabel(ylabel)
axes.set_xscale(xscale)
axes.set_yscale(yscale)
axes.set_xlim(xlim)
axes.set_ylim(ylim)
if legend:
axes.legend(legend)
axes.grid()
return axes
def sgd(params, lr, batch_size):
with torch.no_grad():
for param in params:
param -= lr * param.grad / batch_size
param.grad.zero_()
更多推荐


 18
 0
- 0


 已为社区贡献40条内容

所有评论(0)