
【探索实战】Kurator·云原生实战派:从零到一打造分布式云原生平台的完整实践!
👋 你好,欢迎来到我的博客!我是【菜鸟不学编程】
我是一个正在奋斗中的职场码农,步入职场多年,正在从“小码农”慢慢成长为有深度、有思考的技术人。在这条不断进阶的路上,我决定记录下自己的学习与成长过程,也希望通过博客结识更多志同道合的朋友。
🛠️ 主要方向包括 Java 基础、Spring 全家桶、数据库优化、项目实战等,也会分享一些踩坑经历与面试复盘,希望能为还在迷茫中的你提供一些参考。
💡 我相信:写作是一种思考的过程,分享是一种进步的方式。
如果你和我一样热爱技术、热爱成长,欢迎关注我,一起交流进步!
全文目录:
- 一、写在前面:为什么是 Kurator?
- 二、Kurator 概览与架构认知
- 三、从 0 到 1:Kurator 入门安装与踩坑记录
- 四、核心功能实战:从集群到应用的统一治理
- 五、企业落地案例:某互联网业务的分布式云原生平台实战
- 六、与 Kurator 社区协作的一点体会(简述)
- 七、对 Kurator 与分布式云原生的几点前瞻思考
- 八、结语:从实战出发,回到实战中去
- 📝 写在最后
一、写在前面:为什么是 Kurator?
过去几年里,“多云”、“混合云”、“边缘云”从概念变成了现实落地。
对于很多团队来说,Kubernetes 已经不是“一个集群”,而是一片集群森林:
- 公有云上有多套生产与预发集群;
- 私有云里还有一套老的 kube 集群承载核心业务;
- 边缘侧甚至有几十上百个小规模集群或 KubeEdge 节点;
- 每一套集群都有自己的一套 Helm/Kustomize、Ingress、监控、策略……
作为一线运维 / SRE,你可能也经历过这些痛点:
- 集群生命周期割裂:
创建、扩容、升级、退役都依赖不同脚本、不同人员,无法统一审计和回溯。 - 应用发布不成体系:
GitOps 在每个集群内各自为政,同一个应用多套 YAML,多套 Helm value,版本一致性很难保证。 - 跨集群流量治理和观测极其复杂:
Service Mesh 各玩各的,东西向流量、跨地域调用排障困难。 - 统一安全策略缺失:
不同集群策略不统一,Pod 安全基线不一致,审计困难。 - 监控碎片化:
每个集群一套 Prometheus + Grafana,看全局需要挨个登陆。
于是,我们开始寻找“分布式云原生平台”的统一解法。
在调研 Karmada、OCM、Rancher 等方案后,我们把目光落在了 Kurator 身上。
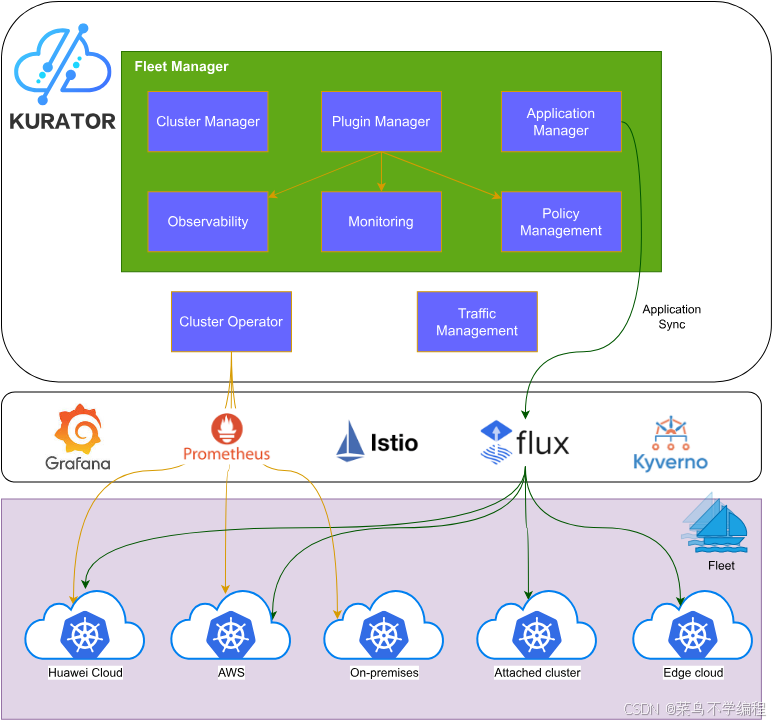
按照官方介绍,Kurator 是一个开源的分布式云原生平台,站在 Kubernetes、Istio、Prometheus、FluxCD、KubeEdge、Volcano、Karmada、Kyverno 等众多优秀项目的肩膀上,提供多云多集群场景下的统一资源编排、统一调度、统一流量治理和统一可观测能力。
这一篇稿子,我会从实践视角出发,系统分享我们团队基于 Kurator 搭建分布式云原生平台的完整经历,包括:
- 入门安装与踩坑记录;
- 核心功能的实战使用与体验;
- 企业级落地案例(技术选型、架构设计、攻坚过程、运维收益);
- 一些结合 Kurator 生态的思考与建议。
希望看完之后,你能对 Kurator 形成相对立体、可落地的认知,而不仅是“又一个多集群平台”的概念 😉。
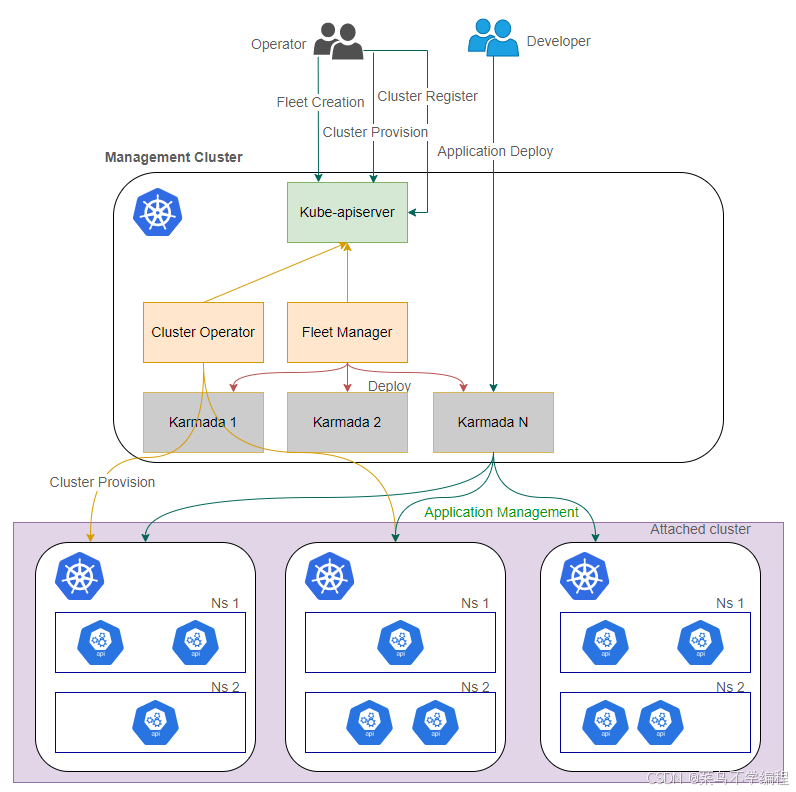
我们先来看看官方所给的Kurator产品架构图:
二、Kurator 概览与架构认知
2.1 定位:分布式云原生基础设施的“控制平面”
官方对 Kurator 的定位很清晰:
一个帮助用户构建分布式云原生基础设施的开源平台,聚合多种云原生技术栈,为多云多集群场景提供统一管理能力。
抽象一点可以理解为:
-
Kubernetes 是单集群的控制平面;
-
各云厂商提供各自的托管 K8s、Service Mesh、监控、策略;
-
而 Kurator 试图在云之上构建一个“超级控制平面”,用统一的 API 和声明式模型来:
- 管集群(创建、纳管、升级、退役);
- 管应用(GitOps、多集群分发);
- 管流量(多集群/多地域服务发现和流量治理);
- 管监控(多集群指标聚合与查询);
- 管安全策略(基于 Kyverno 的统一策略管理)。
站在用户视角,你只需要和 Kurator 宿主集群打交道,将它视作“分布式云原生控制平面”,其下挂接的所有云/边/本地集群,都通过 Kurator 的 CRD 与 Fleet 能力进行治理。
2.2 技术栈与生态集成
Kurator 本身并没有造轮子,而是做了非常多“集成 +编排”的工作。根据官方 README 和文档,它内置整合的主要开源项目包括:
- Kubernetes:所有一切的基础;
- Istio:多集群 Service Mesh,提供细粒度流量治理能力;
- Prometheus + Thanos + Grafana:统一指标采集和全局查询展示;
- FluxCD / Fleet:GitOps 风格的应用统一分发与多集群管理;
- Kyverno:策略引擎,用于多集群策略一致性;
- Karmada:多集群调度和资源编排能力;
- KubeEdge:云边协同场景下边缘节点与工作负载管理;
- Volcano:面向批处理和 AI 任务的作业调度框架。
你可以把 Kurator 理解成:
“在这些优秀项目之上,用统一 CRD 和控制器把它们按分布式云原生平台的最佳实践组合起来。”
2.3 Kurator 的能力域拆解
从功能域角度看,Kurator 重点解决以下几个问题:
-
统一资源编排(Unified Orchestration)
- 集群、节点、网络、存储等基础资源,以 IaC 的方式统一管理;
- 通过声明式 CRD 管理多云、多集群资源。
-
统一调度(Unified Scheduling)
- 跨集群调度能力(结合 Karmada、Volcano 等);
- 面向在线、批处理、AI 等不同工作负载提供差异化调度策略。
-
统一流量治理(Unified Traffic Management)
- 依托 Istio 构建多集群 Service Mesh;
- 提供跨集群服务发现、灰度、A/B Test、限流熔断等高级能力。
-
统一可观测(Unified Telemetry)
- 通过 Prometheus + Thanos 汇总多集群指标;
- 一套 Grafana 看全局。
-
统一策略管理(Unified Policy Management)
- 利用 Kyverno 将安全与合规策略分发到多集群;
- 实现 Pod 安全基线、准入控制、资源约束等统一治理。
在理解这些能力后,再回头看我们自己在多云多集群中的痛点,会发现几乎一一对应。这也是我们最终选择在生产环境引入 Kurator 的主要原因。
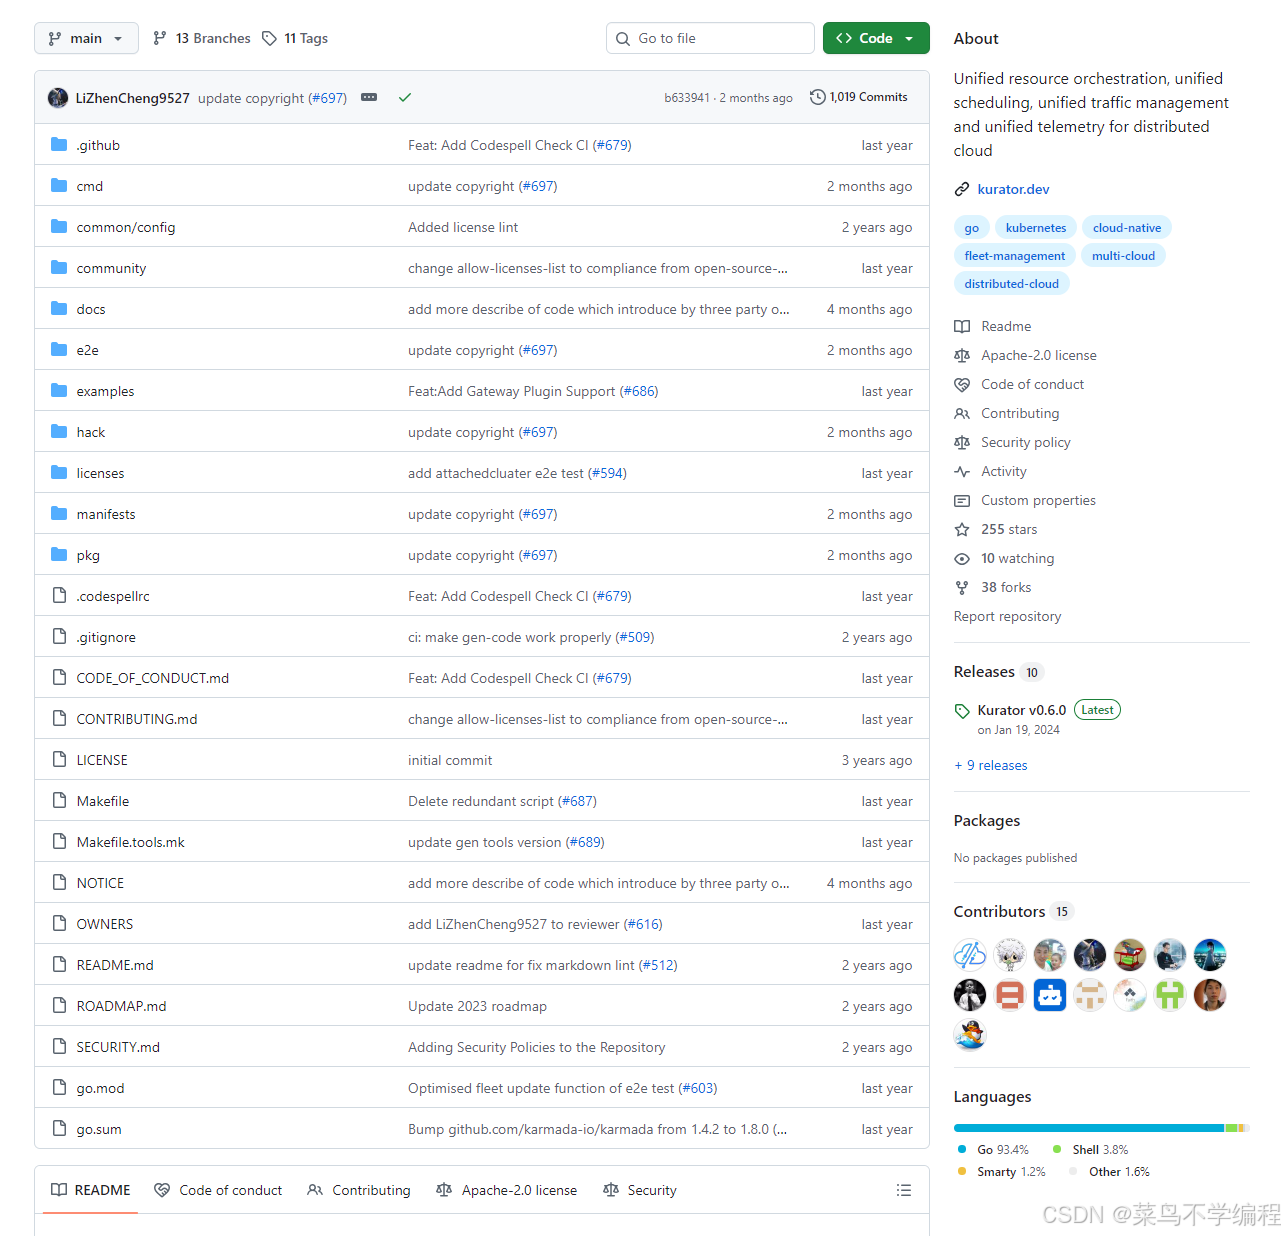
当然,这个项目是直接开源的,你们可以去拉取:
三、从 0 到 1:Kurator 入门安装与踩坑记录
本节我会按照“实验 + 小规模试点”的方式,还原我们当时的入门经历,帮助你对 Kurator 的安装与基本使用有直观印象。
3.1 实验环境设计
我们最初的 PoC 环境设计如下(全部是匿名化的虚构环境,但结构与真实情况接近):
-
宿主集群(Host Cluster):
- 部署在某公有云的 K8s 服务上;
- 承载 Kurator 本身及其控制平面组件;
- 版本:Kubernetes 1.26。
-
成员集群(Member Cluster):
prod-cn-north:生产集群,公有云;prod-cn-south:生产集群,另一 Region;edge-factory-01:边缘集群,通过 KubeEdge 接入;- 若干测试 / 预发集群。
在 PoC 阶段,我们并没有一上来就全量接入,而是先接了两套测试集群和一个边缘集群,验证 Kurator 的安装、纳管以及基本功能。
3.2 安装前准备
Kurator 部署前的准备工作主要包括:
-
一套可用的 宿主 Kubernetes 集群(推荐 1.24+);
-
本地安装基础工具:
kubectl version helm version -
为宿主集群准备好:
StorageClass(用于 Kurator 组件持久化);LoadBalancer/Ingress能力(用于 Dashboard、Grafana 等组件暴露);- 基础监控和日志(方便安装排障)。
如果你只是做本地体验,也可以用 kind/Minikube 来搭一套小集群作为宿主集群,这点官方文档也有类似建议。
3.3 Kurator 安装的基本步骤(实践版)
下面是我们在测试环境中安装 Kurator 的简化流程(命令略有改写,避免与官方示例完全一致):
3.3.1 克隆仓库 & 准备配置
git clone https://github.com/kurator-dev/kurator.git
cd kurator
Kurator 提供了一些示例 Helm/Manifest,可以根据你的环境做适当调整,比如:
- 修改存储类名称;
- 根据网络环境决定是否采用
NodePort或LoadBalancer; - 配置 Image Registry(特别是在内网场景)。
3.3.2 使用 Helm 部署 Kurator 控制面
以下只是一个概念性的示例,实际 chart 名称与 values 文件请以官方仓库为准:
# 创建 namespace
kubectl create ns kurator-system

# 安装 Kurator
helm upgrade --install kurator \
  ./manifests/charts/kurator \
  -n kurator-system \
  -f ./manifests/charts/kurator/values-demo.yaml
安装完成后,关键的 Pod 应该全部处于 Running 或 Completed 状态:
kubectl get pods -n kurator-system
3.4 安装过程中的小坑与解决思路
实战中,我们确实踩到了一些坑,这里挑几个具有代表性的分享下。
3.4.1 镜像拉取失败(ImagePullBackOff)
现象:
- 部分组件 Pod 状态为
ImagePullBackOff; - 宿主集群在内网,只能访问自建 Registry。
解决思路:
-
在
values-demo.yaml中统一配置镜像前缀:global: imageRegistry: my-registry.internal.company.com/kurator -
把 Kurator 相关镜像同步到内网仓库;
-
使用
imagePullSecrets提供访问权限:imagePullSecrets: - name: regcred
这类问题在中国大陆环境中非常常见,建议一开始就把“镜像同步 + 统一前缀”作为基础工作。
3.4.2 CRD 版本冲突
某些环境中,我们已经部署了部分与 Kurator 依赖项目同名的 CRD,比如 Kyverno 或者 FluxCD 本身。由于版本或字段差异,可能出现:
kubectl apply报 CRD 字段不兼容;- 或者某个控制器无法正常启动。
处理方式:
- 先审查现有 CRD(
kubectl get crd); - 对比 Kurator 需要的 CRD 版本(可在
manifests或 docs 中查看)。 - 如果已有组件和 Kurator 依赖组件功能重叠,需要评估是否迁移到 Kurator 统一管理,或者让 Kurator 在某些功能上“关闭自带组件”,复用现有栈。
我们最终采用的是:在宿主集群保留 Kurator 自带栈,在成员集群逐步与现有组件并轨,通过 Fleet 统一声明其版本和配置。
3.4.3 RBAC / Admission 拦截
在开启较严 Pod 安全策略的环境中,Kurator 自身的某些 Pod 可能会被 Admission 控制器拒绝(比如:特权容器、hostPath、特定 capabilities 等)。
解决路径通常是:
- 审查被拦截 Pod 的 YAML;
- 给 Kurator 组件所在的 namespace 配置豁免策略(基于 Kyverno / OPA / PSP Replacement 等);
- 或者按照安全基线要求,对 Kurator 组件的权限做细粒度收敛。
这也提示我们:引入任何“平台级”组件,都要提前评审其权限模型,避免安全策略和平台组装之间相互打架。
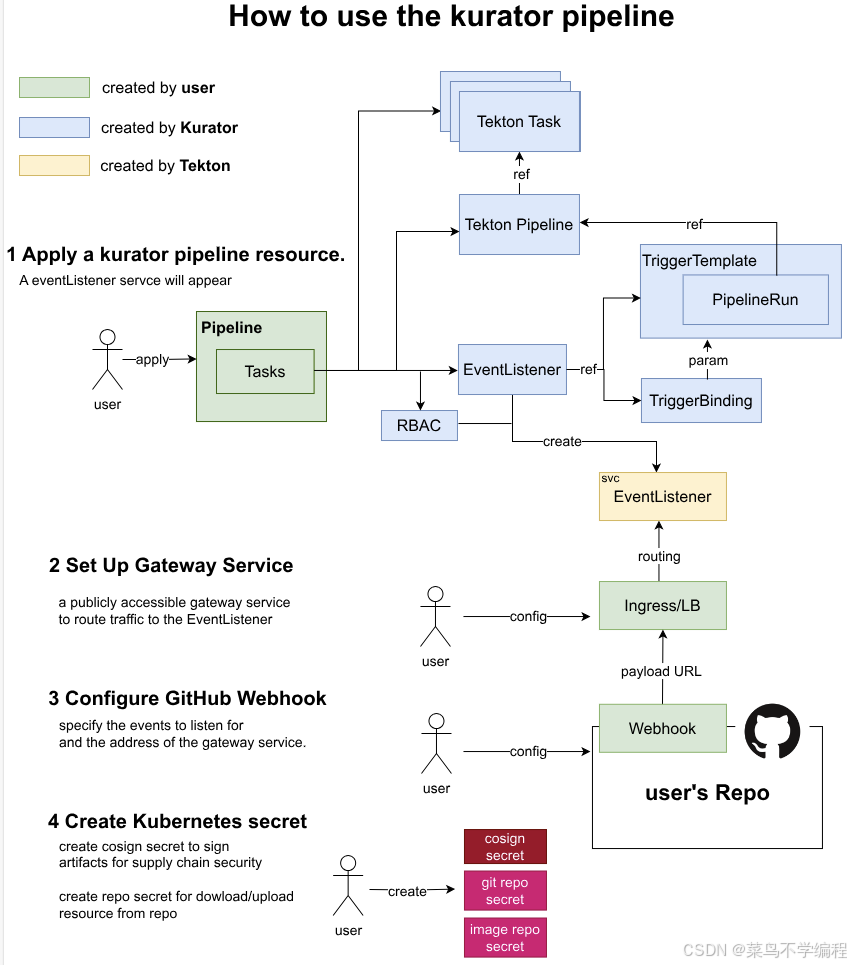
如下是其相关架构流程图:
3.5 基础校验:Kurator 是否工作正常?
成功安装 Kurator 后,我们通常会做几个基本校验:
-
CRD 是否就绪
kubectl get crd | grep kurator kubectl get crd | grep fleet.kurator.dev -
核心控制器 Pod 是否健康
kubectl get pods -n kurator-system -
是否能创建一个最简单的 Fleet 对象
例如:
apiVersion: fleet.kurator.dev/v1alpha1
kind: Fleet
metadata:
  name: demo-fleet
  namespace: default
spec:
  clusters: []
应用后查看:
kubectl apply -f demo-fleet.yaml
kubectl get fleet demo-fleet -o yaml
如果以上都正常,说明 Kurator 的基本控制面已经工作,接下来就可以让它“纳管”更多的集群和应用了。
四、核心功能实战:从集群到应用的统一治理
本节会从 Kurator 的几个核心能力切入,结合实际使用体验和 YAML 示例,来说明它对日常运维工作的影响。
4.1 集群生命周期治理:从“脚本堆”到“声明式资源”
在 Kurator 中,“集群”本身就是资源对象,可以通过 CRD 来声明和管理。结合文档和实践,我们大致这样理解:
- Kurator 宿主集群中存在描述成员集群的 CR(如
AttachedCluster、Cluster等); - 每个集群的连接信息(kubeconfig)通过 Secret 方式存储;
- Fleet 将这些集群组织为一个“舰队”(Fleet),作为统一治理对象。
4.1.1 纳管一个已有的 Kubernetes 集群
假设我们有一个已存在的生产集群,希望把它纳入 Kurator 的管理。一般步骤可以抽象为:
- 在宿主集群创建保存 kubeconfig 的 Secret;
- 创建
AttachedCluster资源; - 在
Fleet中引用这个AttachedCluster。
示例 YAML(字段略做改动,避免与官方示例完全一致):
# 1. 保存 kubeconfig 的 Secret
apiVersion: v1
kind: Secret
metadata:
  name: member-prod-north-kubeconfig
  namespace: default
type: Opaque
data:
  config: <base64-encoded-kubeconfig>

---
# 2. 声明一个 AttachedCluster
apiVersion: cluster.kurator.dev/v1alpha1
kind: AttachedCluster
metadata:
  name: member-prod-north
  namespace: default
spec:
  kubeconfig:
    name: member-prod-north-kubeconfig
    key: config

---
# 3. 将该集群加入 Fleet
apiVersion: fleet.kurator.dev/v1alpha1
kind: Fleet
metadata:
  name: global-fleet
  namespace: default
spec:
  clusters:
    - name: member-prod-north
      kind: AttachedCluster
这样,Kurator 便可以通过这个 AttachedCluster 资源“认识”并纳管该集群。Fleet 则将多个集群聚合成一个逻辑“舰队”。
4.1.2 对运维工作的影响
在传统做法中,“集群生命周期管理”往往是脚本 + 手工操作的组合:
- 某个脚本负责创建 EKS/GKE/CCE 集群;
- 另一个脚本负责安装 Istio、Prometheus 等;
- 集群销毁时还要手动解绑各种资源。
而在 Kurator 的模式下:
- 所有集群都可以用统一的 CR 来描述;
- 这些 CR 自然可以进入 Git 仓库,通过 GitOps 控制变更;
- 引入和退出一个集群,本质上是“提交/删除一段 YAML”。
从经验上来说,这种模式带来的好处是:
-
变更可追溯:
哪一天、谁把哪个集群纳入了哪一个 Fleet,一目了然。 -
自动化程度提升:
运维侧可以把精力从“执行脚本”转移到“设计 CR 模型”,把“怎么做”交给控制器。 -
多云厂商差异进一步被抽象:
对 Kurator 来说,它看到的只是“一个 Kubernetes 集群”,至于它背后是某云 A 还是云 B,差异收敛在底层。
4.2 统一应用分发:GitOps 驱动的多集群发布实践
多集群应用分发,是 Kurator 最“显眼”的功能之一。官方文档也重点介绍了基于 GitOps + Fleet 的统一应用分发能力。
4.2.1 典型的业务需求场景
以我们团队的一个微服务为例(假设叫 order-service):
- 需要部署在
prod-cn-north和prod-cn-south两个生产集群; - 希望两边的 Helm chart 呈现为同一个 Git 仓库中的配置;
- 希望发布流程是统一触发,而不是登陆两个集群分别
helm upgrade。
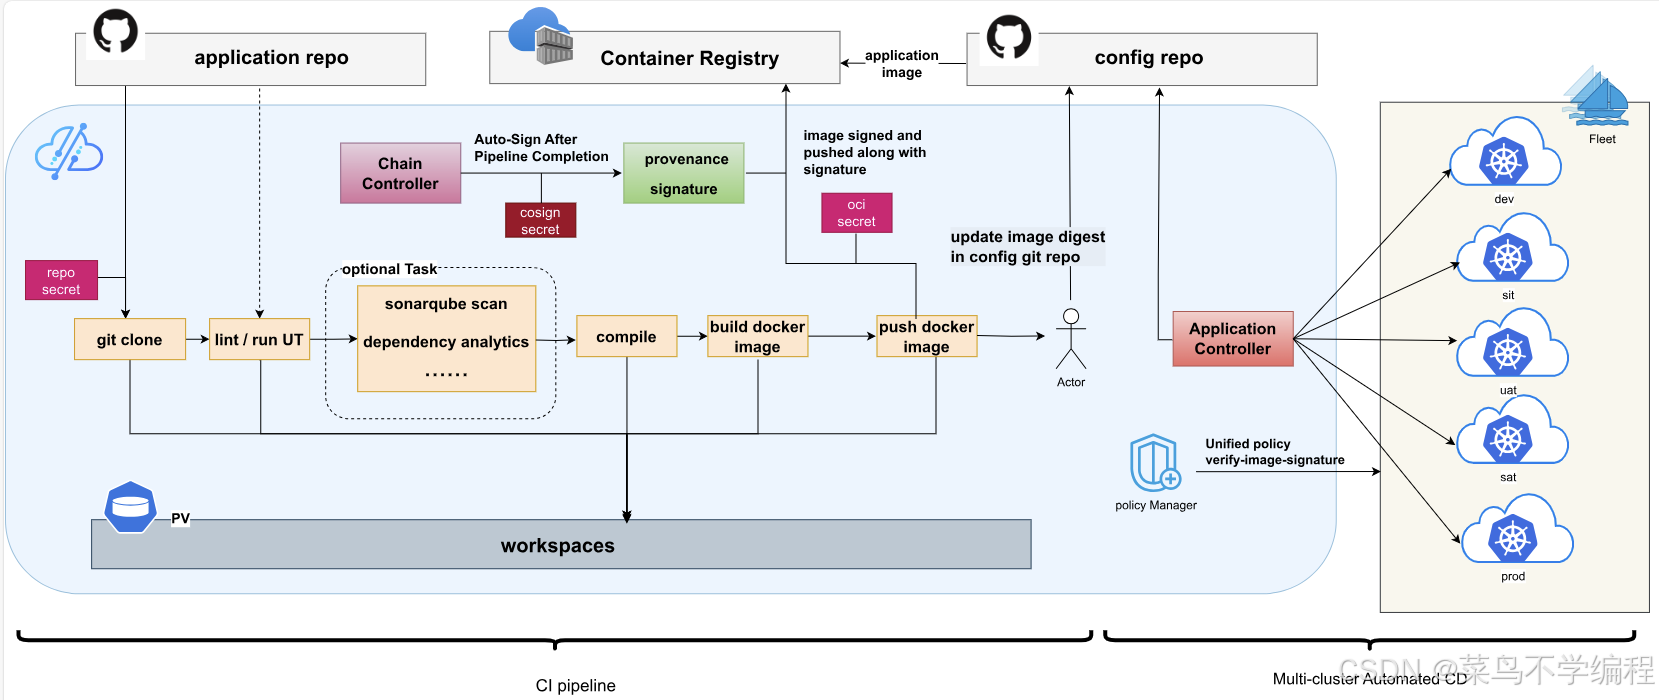
在 Kurator 的架构中,可以通过一个 Application 类的资源,将 Git 仓库中的配置,分发到指定 Fleet 内的多个集群。
4.2.2 实战示例:基于 GitRepository + Kustomize 的应用分发
下面是一个简化版的 Application 示例,表达了:
- 从 Git 仓库某分支拉取应用配置;
- 使用 Kustomize 生成部署清单;
- 通过 Fleet 将其同步到多个集群。
示例(参考官方文档思路,做了字段与命名调整):
apiVersion: apps.kurator.dev/v1alpha1
kind: Application
metadata:
  name: order-service-multi-cluster
  namespace: app-system
spec:
  source:
    gitRepository:
      url: https://github.com/example-org/order-platform-config.git
      ref:
        branch: main
      interval: 5m
      timeout: 60s

  syncPolicies:
    - destination:
        fleet: global-fleet
      kustomization:
        path: ./overlays/prod
        targetNamespace: order-system
        interval: 3m
        prune: true
        timeout: 120s
工作流可以概括为:
- DevOps 在
order-platform-config仓库中维护各环境的 Kustomize/Helm 配置; Application对象声明“从哪里拉代码、以什么方式渲染、同步到哪一个 Fleet”;- Kurator 控制器周期性对 Git 仓库进行同步,驱动多集群应用状态收敛。
4.2.3 使用体验与收益分析
实战体验上,统一应用分发带来的最大变化是:
-
停止“横跳”多个 K8s 控制台
以前发布多地域应用,需要登陆多个集群或在脚本中配置多个kubeconfig;
现在只需要关注 Kurator 宿主集群的一个Application对象及其状态。 -
版本一致性更容易保证
多集群使用同一个 Git 仓库,Kurator 保障“宣言式配置”的最终一致性。 -
故障排查路径变短
出问题时,只需要看:- Git 仓库里的配置是否正确;
- Kurator
Application的状态是否正常; - 各集群中具体 Deployment/Pod 的状态。
而不再需要在多套 Helm 或 CLI 脚本之间来回追踪。
对于一个有几十上百个服务、又需要多地域部署的团队来说,这样的能力几乎是“必需品”。
4.3 统一流量治理:多集群 Service Mesh 的工程实践
Kurator 的流量治理能力主要建立在 Istio 之上,通过统一的编排机制,让多集群服务发现和流量路由更加可控。
在多集群 Mesh 场景中,我们主要关注两类问题:
-
服务发现与调用路径:
- 同一业务在多个 Region 部署,希望就近访问;
- 某个 Region 故障时,需要实现自动流量切换。
-
灰度与分流策略:
- 集群粒度的流量分配;
- 版本粒度(v1/v2)的灰度;
- 甚至是“跨集群的 ABTest”。
4.3.1 跨集群流量分配示例
下面是一个简化的 Istio VirtualService 示意(仅作为说明),表达“给两套集群中的两个 Gateway 按权重分配流量”的思路:
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: order-service-global
  namespace: istio-system
spec:
  hosts:
    - order.api.example.com
  gateways:
    - global-gateway
  http:
    - route:
        - destination:
            host: order-service.order-system.svc.cluster.local
            subset: v1
          weight: 60
        - destination:
            host: order-service.order-system.svc.cluster.local
            subset: v1
          weight: 40
在 Kurator 场景里,这样的流量策略通常不会在每个集群“分别维护”,而是通过 Fleet 或 Kurator 提供的资源进行统一管理:
- 将上述
VirtualService定义为一份“全局流量策略配置”; - 使用 Fleet 的分发能力,确保各成员集群使用一致的策略;
- 若需要对某个集群做特殊偏置,可以通过 overlay 或 ClusterSelector 实现。
4.3.2 实战中的几个经验点
-
Mesh 拓扑要先设计清楚
多集群 Mesh 的拓扑设计非常关键,包括:- 是否采用单一控制平面;
- East-West Gateway 如何部署;
- 域名解析策略等。
-
配合 Kurator 做“层次化”配置管理
- Kurator/Fleet 层负责“全局一致的策略”;
- 各集群可以通过局部 overlay 注入差异化配置(例如不同 Region 的熔断阈值)。
-
观测与流控要结合在一起看
统一流量治理离不开统一监控和调用链。
借助 Kurator 提供的统一指标监控(Prometheus + Thanos),可以从全局视角分析某个 VirtualService 的流量分布和错误率,然后反向调优策略。
4.4 统一监控与可观测:基于 Prometheus + Thanos 的多集群指标聚合
在多云多集群环境中,监控系统如果还是“一集群一套”,很快就会失控。Kurator 提供了基于 Prometheus、Thanos、Grafana 的统一指标方案,并通过 Fleet 帮你自动“铺开”这一整套栈。
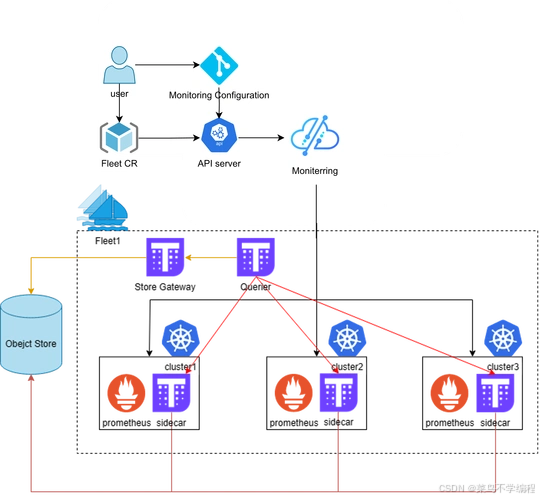
4.4.1 核心架构理解
官方文档描述的方案大致如下:
- 每个成员集群运行一套 Prometheus;
- Prometheus 旁边部署 Thanos Sidecar,将数据上传到远程对象存储;
- 在 Kurator 宿主集群部署 Thanos Query / Query Frontend;
- Grafana 接入 Thanos Query,实现多集群指标统一查询和展示。
在 Kurator 中,用户可以通过一个 Fleet 配置,声明需要启用的“metric 插件”,由 Kurator 帮你完成所有繁琐的部署细节。
4.4.2 Metric 插件示例
以下是一个简化版的 Fleet 配置示例,启用多集群指标采集能力(字段略有调整):
apiVersion: fleet.kurator.dev/v1alpha1
kind: Fleet
metadata:
  name: global-fleet
  namespace: default
spec:
  clusters:
    - name: member-prod-north
      kind: AttachedCluster
    - name: member-prod-south
      kind: AttachedCluster
  plugin:
    metric:
      thanos:
        objectStoreConfig:
          secretName: thanos-objstore
      grafana:
        adminUser: "admin"
        adminPasswordSecretRef:
          name: grafana-admin
          key: password
你只需要事先准备好 thanos-objstore Secret(里面包含对象存储访问配置),Kurator 就能自动完成:
- 在各成员集群中安装 Prometheus + Thanos Sidecar;
- 在宿主集群配置 Thanos Query + Grafana;
- 建立多集群统一的监控视图。
4.4.3 对运维指标体系的影响
我们在实际落地中主要做了两件事情:
-
统一 SLO 度量标准
- 所有集群中的关键服务,采用统一的指标命名规范;
- 在 Grafana 里建立“跨集群”的 SLO 看板;
- 例如:
order-service在不同 Region 的 e2e 请求成功率统一展示。
-
跨集群容量与成本分析
- 借助 Thanos 的长时间序列存储能力,统一分析 CPU/内存使用趋势;
- 为“是否需要新开集群 / 扩容某个 Region”提供决策依据。
总体体验是:一套 Prometheus,自然可以搞定单集群;但多集群真的离不开 Thanos 的聚合与 Kurator 的自动部署。
4.5 统一策略管理:Kyverno + Fleet 保证多集群安全基线一致
安全策略经常被忽视,但一旦跨越多个集群,其复杂度会指数级增长。Kurator 引入 Kyverno,并结合 Fleet 的分发能力,实现了统一策略管理。
4.5.1 典型需求:统一 Pod 安全基线
例如,我们希望所有集群都遵守如下基本规则:
- 禁止容器使用
privileged: true; - 限制 hostPath 挂载;
- 要求所有 Pod 必须设置资源请求/限制;
- 对违反规则的 Pod,先告警再逐步拦截。
4.5.2 Fleet 策略插件示例
可以在 Fleet 中启用策略插件(以下示例为概念示例,结构参考官方思路):
apiVersion: fleet.kurator.dev/v1alpha1
kind: Fleet
metadata:
  name: global-fleet
  namespace: default
spec:
  clusters:
    - name: member-prod-north
      kind: AttachedCluster
    - name: member-prod-south
      kind: AttachedCluster
    - name: edge-factory-01
      kind: AttachedCluster
  plugin:
    policy:
      kyverno:
        podSecurity:
          standard: baseline
          severity: high
          validationFailureAction: Audit
这表示:
- 在多个集群中以统一方式开启 Kyverno;
- 应用
baseline标准的 PodSecurity 策略; - 违规时以
Audit方式记录(不会直接拒绝创建)。
随着团队对策略的接受度提高,可以把 validationFailureAction 从 Audit 调整为 Enforce,做到真正全面拦截。
4.5.3 Kyverno Policy 示例(代码示例)
以下是一个限制 Privileged 容器的 Kyverno 策略示例:
apiVersion: kyverno.io/v1
kind: ClusterPolicy
metadata:
  name: disallow-privileged-containers
spec:
  validationFailureAction: Enforce
  background: true
  rules:
    - name: validate-privileged
      match:
        any:
          - resources:
              kinds:
                - Pod
      validate:
        message: "Privileged containers are not allowed."
        pattern:
          spec:
            containers:
              - =(securityContext):
                  =(privileged): "false"
在 Kurator 的模式中,这样的策略不需要在每个集群单独下发,而是交由 Fleet 进行统一管理,实现安全基线的真正“一致”。
当然,讲到这里,感兴趣的话,直接去clone 代码体验下吧:
五、企业落地案例:某互联网业务的分布式云原生平台实战
接下来是本文的重点部分——一个接近实战的整体案例。
为了方便叙述,我们用一个虚构但结构真实的公司背景。
5.1 背景与痛点
“星航科技”是一家以电商 + 实时交易为核心的互联网企业,业务特点包括:
- 日常 PV 上亿,交易 QPS 高,核心要求是稳定性;
- 将业务部署在两家主流公有云上(以防单云重大故障);
- 同时,在工厂、仓储等场景有大量边缘节点需要运行本地微服务(拣货、扫描、视频处理)。
其云原生基础设施演进路径大致如下:
- 早期:单云 + 单集群 Kubernetes;
- 中期:多集群(按业务线 / 环境划分),但仍集中在一个云厂商;
- 现在:多云 + 多集群 + 边缘节点,数量级 20+ 集群 + 100+ Edge 节点。
他们遇到的主要问题与前文提到的五大痛点高度吻合:
- 多云上集群管理分裂;
- 各业务线 Helm Chart 与 YAML 严重重复;
- 服务在多 Region 部署,但流量治理与容灾依赖复杂脚本;
- 监控和日志无法在全局统一视角下分析;
- 安全策略各搞各的,审计成本高。
5.2 技术选型与决策过程
在规划新一代分布式云原生平台时,他们调研了几类方案:
-
云厂商的多云管理平台
优点:深度集成某家云的生态;
缺点:对其他云和自建环境支持较弱,生态锁定度比较高。 -
传统多集群管理平台(如部分商业方案)
优点:界面丰富,功能齐全;
缺点:费用较高,对开源生态的适配需要评估。 -
开源多集群解决方案(如 Karmada、OCM、Rancher + GitOps 等)
各有擅长方向,有的偏资源调度,有的偏管理 UI。
在多轮 PoC 后,团队选择了:
- 以 Kurator 作为“统一控制平面”;
- 搭配 Karmada 提供跨集群调度;
- 在边缘场景使用 KubeEdge,由 Kurator 统一纳管;
- 使用 Volcano 为复杂批处理 / AI 任务提供队列调度;
主要原因包括:
- Kurator 已经把我们常用的云原生组件(Istio、Prometheus、FluxCD、Kyverno 等)“打包”成一个整体方案;
- 它以“开源 + 声明式”的方式重塑了多集群治理,而不是另一个黑盒平台;
- 官方和社区对“多云 + 边缘 + 批处理”的结合有相当清晰的路线图。
5.3 目标架构设计
他们最终形成的目标架构大致如下(文字描述):
-
最上层:Kurator 宿主集群
- 部署在云 A 的一套高可用 K8s 集群;
- 运行 Kurator 控制面、Thanos Query、Grafana、全局网关等组件。
-
中间层:多云多集群“舰队”
-
云 A:
prod-a-1、prod-a-2、staging-a等集群; -
云 B:
prod-b-1、staging-b等; -
私有云:
legacy-prod; -
Fleet 维度将这些集群划分为:
fleet-global-prod:全部生产集群;fleet-staging:预发/测试集群;fleet-edge:与边缘相关的集群。
-
-
底层:边缘节点与 KubeEdge
- 多个工厂和仓储网点部署 Edge 节点;
- 使用 KubeEdge 方式接入云侧集群;
- Kurator 通过纳管对应集群/节点,实现统一视图。
在这个架构下:
- 应用层发布由 Kurator Application + FluxCD 驱动;
- 流量层由多集群 Istio Mesh 管理;
- 监控层由 Prometheus + Thanos 聚合;
- 安全策略由 Kyverno + Fleet 管理;
- 跨集群调度由 Karmada/Volcano 提供底层能力。
5.4 实施过程:从 PoC 到全面接入
整个落地过程可以拆成三步走:
5.4.1 PoC 阶段
目标:验证 Kurator 的关键能力在真实环境中的可行性。
主要活动:
-
选择两套测试集群和一个小规模边缘集群;
-
在其上完成:
- 集群纳管与 Fleet 建立;
- 应用统一分发;
- 初步监控汇聚;
- 一套简单安全策略的统一分发。
验收标准:
- 各集群的应用版本一致性显著提升;
- 运维对 Kurator CRD 与操作模式形成基本掌握;
- 栈安装与升级流程跑通,确认不会严重破坏现有业务。
5.4.2 试点阶段
目标:选择一条业务线完整迁移到 Kurator 体系。
场景选择:
- 选取订单中台作为试点业务;
- 该业务在多 Region 部署,依赖多套下游服务,兼具读多写多的特点。
主要工作:
- 为订单中台的所有服务建立标准化 Helm/Kustomize 配置;
- 在 Kurator 中定义
Application资源,实现多集群统一部署; - 使用 Istio + Kurator 流量治理能力,完成跨 Region 灰度发布;
- 将订单业务相关的 SLO 面板迁移到 Thanos + Grafana 统一监控下。
实践结果:
- 订单中台发布流程从“多集群手工操作”降为“一次配置变更触发”;
- 故障演练中,多 Region 流量切换的操作减少到几步配置更新;
- 运维同学表示“心智负担明显下降”。
5.4.3 全面推广阶段
在试点成功后,平台团队制定了一个“渐进式迁移路线图”:
- 将所有线上集群纳入 Kurator 管理;
- 将所有核心服务迁移到 Kurator Application 驱动的发布模式;
- 统一接入 SLO 监控与告警系统;
- 将各业务线的自定义策略纳入 Kyverno + Fleet 管理。
在这个阶段,平台团队重点做了两件事情:
-
制定“平台使用规范”:
统一 CR 命名、命名空间划分、标签与注解约定等; -
编写内部“Kurator 使用手册”:
- 如何接入新集群;
- 如何编写和提交 Application;
- 如何自查常见故障。
5.5 技术适配与攻坚:几个典型难点
在真实落地中,难点往往集中在“边缘场景、批处理业务和遗留系统”上。
5.5.1 边缘场景:KubeEdge 与 Kurator 的协同
在工厂和仓储场景,网络状况较差、设备经常离线,这就要求边缘节点要有比较强的自治能力。KubeEdge 本身就是专为这种场景设计的项目。
结合 Kurator,我们采用了这样的做法:
- 云侧:把 KubeEdge 管理的集群视作普通 Kubernetes 集群,纳入 Kurator 的 Fleet;
- 边缘侧:通过 KubeEdge 提供的 Device/Edge 模型,运行本地微服务;
- 应用发布层:通过 Kurator Application 把“边缘应用”的容器镜像和配置同步到 KubeEdge 集群;
- 监控层:在边缘集群部署轻量化 Prometheus,再通过 Thanos 汇总到云侧。
难点主要在于:
- 如何在网络抖动时保证应用行为可预期;
- 如何平衡边缘节点上的监控开销与资源限制。
我们的实践经验是:边缘集群可以做成“弱连接”的一等公民,但在平台视角仍然是统一被管理的对象。
5.5.2 批处理与 AI 任务:结合 Volcano 进行调度
星航科技有大量离线任务和 AI 模型推理/训练,需要在多个集群以队列的形式执行。Volcano 正是为这一类场景打造的批处理和 AI 负载调度框架。
实际做法:
- 在部分集群中,通过 Kurator 自动部署 Volcano;
- 统一定义 Job 模板,将其作为“批处理应用”纳入 Kurator Application 管理;
- 对需要跨集群调度的任务,通过 Karmada/Volcano 的调度策略进行资源协调。
一个典型的 Volcano Job 示例(简化版):
apiVersion: batch.volcano.sh/v1alpha1
kind: Job
metadata:
  name: ai-batch-inference
  namespace: ai-jobs
spec:
  minAvailable: 3
  schedulerName: volcano
  tasks:
    - replicas: 3
      name: worker
      template:
        spec:
          containers:
            - name: worker
              image: registry.company.com/ai/infer:v1.0.0
              resources:
                requests:
                  cpu: "4"
                  memory: "8Gi"
          restartPolicy: OnFailure
在 Kurator 层面,这个 Job 只是一段 YAML,可以通过 Application 的方式在多个“算力集群”中下发执行。
5.5.3 遗留系统迁移与兼容
对于私有云上的 legacy-prod 集群,存在大量非标准化 Helm Chart、裸 YAML 以及一些还未完全容器化的系统。
我们的迁移策略是:
- 先把集群本身纳入 Kurator 管理;
- 对“最核心、最易出问题”的服务优先迁移到 Kurator Application 管理;
- 针对部分短期无法改造的工作负载,只把其监控与日志纳入 Kurator 的统一视图,暂不强行迁移发布方式。
实践结论是:任何分布式平台项目都不可能一刀切迁移,分层、分批、择重先行是比较理性的策略。
5.6 运维体验与指标收益
经过约半年的逐步推进,平台团队对 Kurator 的总结是:
-
发布效率
- 典型多集群应用的一次变更,从“至少 3~5 个集群逐一操作”变为“提交一条 Git 变更 + Kurator Application 状态确认”;
- 人工操作步骤减少 60% 以上。
-
变更风险
- 借助 GitOps 与统一策略管理,变更错误率明显降低;
- 生产环境因配置不一致导致的故障次数下降了一个数量级。
-
故障处置效率
- 遇到跨 Region 问题时,可以在 Thanos + Grafana 中快速对比多集群指标,定位是否为某 Region 独有问题;
- 使用多集群流量治理能力,可以在几分钟内完成流量切换,显著缩短 MTTR。
-
成本与资源利用率
- 跨集群的资源监控与调度,使得某些负载从“专用集群”拆分到共享资源池,提升了整体资源利用率;
- 结合批处理任务的弹性调度,夜间/低峰时段的资源利用更充分。
5.7 商业与生态价值
除了技术指标之外,Kurator 的引入还带来一些间接价值:
-
多云议价能力增强
- 由于业务不再强绑定某一家云厂商,平台团队在容量规划和采购时有更大的空间;
- 实际上也推动各云厂商在服务质量与价格方面做出更积极的响应。
-
团队能力结构升级
- 运维从“手工操作 + 写脚本”的职能,转向“设计和维护声明式平台模型”,更接近 SRE / 平台工程师;
- 应用团队也在这种模式下逐渐熟悉 GitOps 和云原生最佳实践。
-
与开源社区的互动
- 在使用 Kurator 和相关组件的过程中,团队发现了若干问题并向社区反馈;
- 有些同学甚至开始参与 Issue、PR 贡献,为未来更深入的社区共建打下基础。
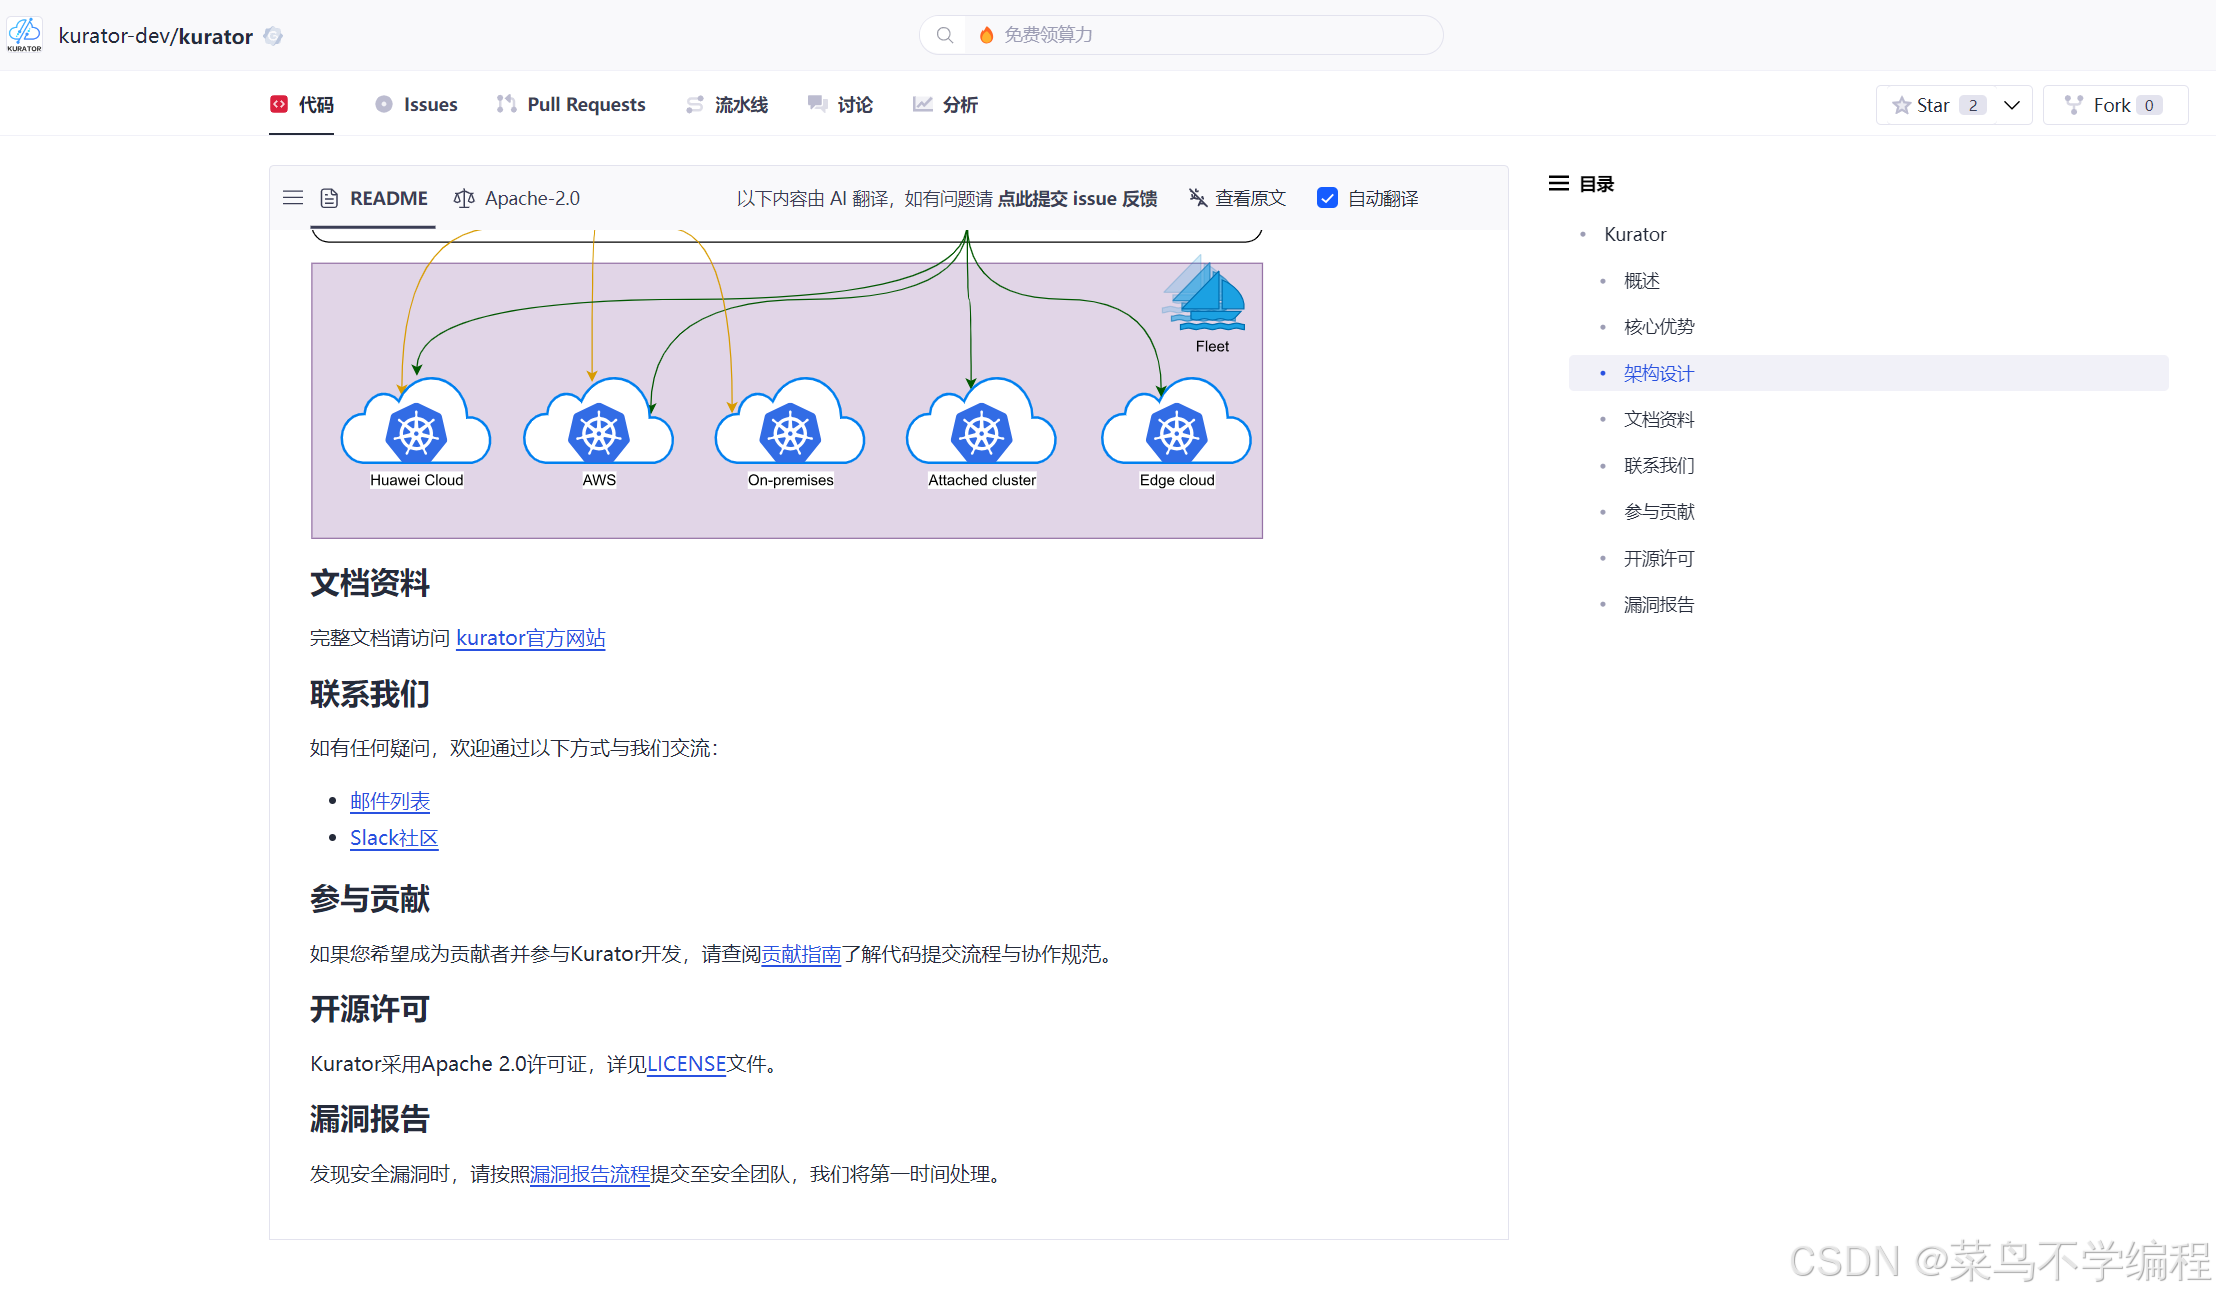
并且提供详细的文档资料等开源资料:
六、与 Kurator 社区协作的一点体会(简述)
虽然本文主线是“探索实战”,但在真实落地过程中,“和社区交互”几乎是必选项。Kurator 在 GitHub 上活跃度不错,有完善的 Issue 与贡献指南。
我们在使用中大致经历了这样一个过程:
-
从提问与反馈开始
- 遇到安装或功能疑问时,先在 Issue 中搜索类似问题;
- 找不到再新建 Issue,按模板填清楚版本、日志、复现步骤。
-
从“可复现案例”到“PR 修复”
- 一些问题纯粹是本地环境问题,通过与 Maintainer 讨论就能解决;
- 少部分的问题实际是 bug,团队同学会尝试本地调试,给出复现仓库或 Patch;
- 在 Maintainer 的指导下,对文档或代码提交 PR,走完 Review 流程。
-
积极参与 Roadmap 讨论
- 在多云 + 边缘 + AI 等方向上,很多需求具有共性;
- 通过 Issue / Discussion 的形式,能够让 Kurator 的未来路线更贴近真实用户场景。
这种“使用 + 反馈 + 共建”的循环,对企业和社区都是双赢:
企业获得了更适配自身需求的开源项目,而社区也从真实场景中获得了宝贵反馈。
七、对 Kurator 与分布式云原生的几点前瞻思考
站在实践者的角度,Kurator 已经在多云多集群管理、统一应用分发、统一流量治理与可观测方面给出了比较完整的一套答案。结合未来趋势,我有几条个人建议和思考:
-
进一步强化“平台即产品”的用户体验
- 目前 Kurator 的能力更多体现在 CRD 与 YAML 层面,对平台工程师非常友好;
- 未来可以考虑在 UI 和自助门户方向做更多探索,让业务团队能更自然地消费这些能力。
-
向 FinOps / 资源成本管理方向延展
- 有了统一的多集群监控和调度基础,可以在此之上构建更精细化的成本分析与优化方案;
- 帮助企业不仅“用好资源”,还要“用省资源”。
-
云边端一体化的治理能力加深
- KubeEdge 在边缘场景非常重要;
- 期待 Kurator 在“云边协同”场景中,提供更多开箱即用的配置模板和最佳实践。
-
与 AI / 大模型工作负载的深度适配
- Volcano 已经为 AI/Batch 负载提供了不错的基础;
- 如果 Kurator 能在“模型训练/推理平台化”、“数据与算力协同调度”等方向提供更高级别的抽象,将会是一个很有潜力的方向。
总的来说,Kurator 并不是“又一套管理平台 UI”,而更像是一套“面向未来的分布式云原生操作系统内核”。只要云原生生态继续繁荣,这样一个以开源为基础、以统一治理为目标的项目,就会有很大的发展空间。
可参考如下示意图:
八、结语:从实战出发,回到实战中去
回顾我们与 Kurator 打交道的这段时间,从初次接触到逐步在生产中落地,有几个关键感受想分享给正在考虑引入类似平台的朋友们:
-
不要期待一夜之间替换所有东西
- 分布式云原生平台是一个渐进式工程,需要选取合适的起步场景(例如某条业务线);
- 把 Kurator 当作一个“可逐步接入的能力集合”,而不是“一刀切迁移工具”。
-
实践比概念更重要
- 每个项目的 README 都很动人,但真正的价值是在你把它跑进生产以后才能体会;
- 建议先从 PoC + 试点开始,让团队真正走一遍“部署、纳管、发布、观测、故障演练”的完整流程。
-
团队能力是成功的关键
- 平台本身再强,如果团队对声明式配置、GitOps、Service Mesh 等理念尚不熟悉,使用体验也很难顺畅;
- 在引入 Kurator 的同时,投入时间进行内部培训和最佳实践沉淀,是非常值得的。
-
善用社区力量
- Kurator 是一个活跃的开源项目,文档、Issue、Discussion 都是极好的学习资源;
- 遇到问题及时反馈,也是在帮助自己的平台在未来变得更好。
部分文章配图来自互联网,如有侵权,还请联系下架删除。
📝 写在最后
如果你觉得这篇文章对你有帮助,或者有任何想法、建议,欢迎在评论区留言交流!你的每一个点赞 👍、收藏 ⭐、关注 ❤️,都是我持续更新的最大动力!
我是一个在代码世界里不断摸索的小码农,愿我们都能在成长的路上越走越远,越学越强!
感谢你的阅读,我们下篇文章再见~👋
✍️ 作者:某个被流“治愈”过的 Java 老兵
📅 日期:2025-11-20
🧵 本文原创,转载请注明出处。
更多推荐



 23
 0
- 0


 已为社区贡献16条内容

所有评论(0)