
【探索实战】从零到一构建分布式云原生平台:我与Kurator的深度实战之旅与效能变革启示
【探索实战】从零到一构建分布式云原生平台:我与Kurator的深度实战之旅与效能变革启示
【探索实战】从零到一构建分布式云原生平台:我与Kurator的深度实战之旅与效能变革启示
引言:面对“分布式云”的必然挑战,我们为何选择Kurator?
在数字化转型浪潮下,企业的业务足迹正从单一数据中心向多云、混合云甚至边缘节点快速扩张。你是否也曾被这些问题困扰:多集群管理如同“诸侯割据”,应用分发需要重复劳动,监控数据“烟囱”林立,安全策略难以统一?这背后是传统云原生工具链在分布式场景下的“水土不服”。
正是在这样的背景下,我与团队在技术选型中遇到了 Kurator。它不是又一个“轮子”,而是一个云原生技术的“整合者”与“增强器”。Kurator将Karmada、KubeEdge、Istio、Prometheus等顶级开源项目,通过统一的舰队(Fleet) 概念粘合起来,形成一个有机的整体。简单来说,它旨在让你像管理一个集群一样,去管理成百上千个分布在不同地域、不同环境的集群。本文将带你深入我的实战历程,从环境搭建到核心功能体验,再到一个模拟的电商业务场景落地,完整揭示Kurator如何将分布式云原生的复杂治理变得简单高效。
一、 轻松启航:三步完成Kurator分布式环境搭建
任何伟大的旅程都需要一个坚实的起点。部署Kurator,就是构建你分布式云原生版图的第一步。
1.1 环境准备:理清依赖,扫清障碍
Kurator的设计秉持了云原生的理念,其控制面需要运行在一个现有的Kubernetes集群中,这个集群被称为主集群(Host Cluster)。在开始之前,请确保你的环境满足以下条件:
- 一个可用的Kubernetes集群(v1.20+):作为Host Cluster,可以是Minikube、Kind创建的本地集群,也可以是云上的EKS、ACK等。
- kubectl命令行工具:且已配置为可访问你的Host Cluster。
- Helm (v3.0+):用于安装Kurator的核心组件。
- 网络要求:Host Cluster需要能访问公网(如GitHub、Docker Hub)以下载必要的镜像和Chart。
小贴士与常见问题:如果你在内网环境部署,可能会遇到镜像拉取失败的问题。建议提前将所需镜像(如kurator/kurator-cli, istio/proxyv2等)同步至内网仓库,并在安装时通过--set global.imageRegistry=your-internal-registry参数指定。
1.2 一键安装:便捷方式获取Kurator
在项目地址中,可以看到可以clone到本地
https://gitcode.com/kurator-dev/kurator.git
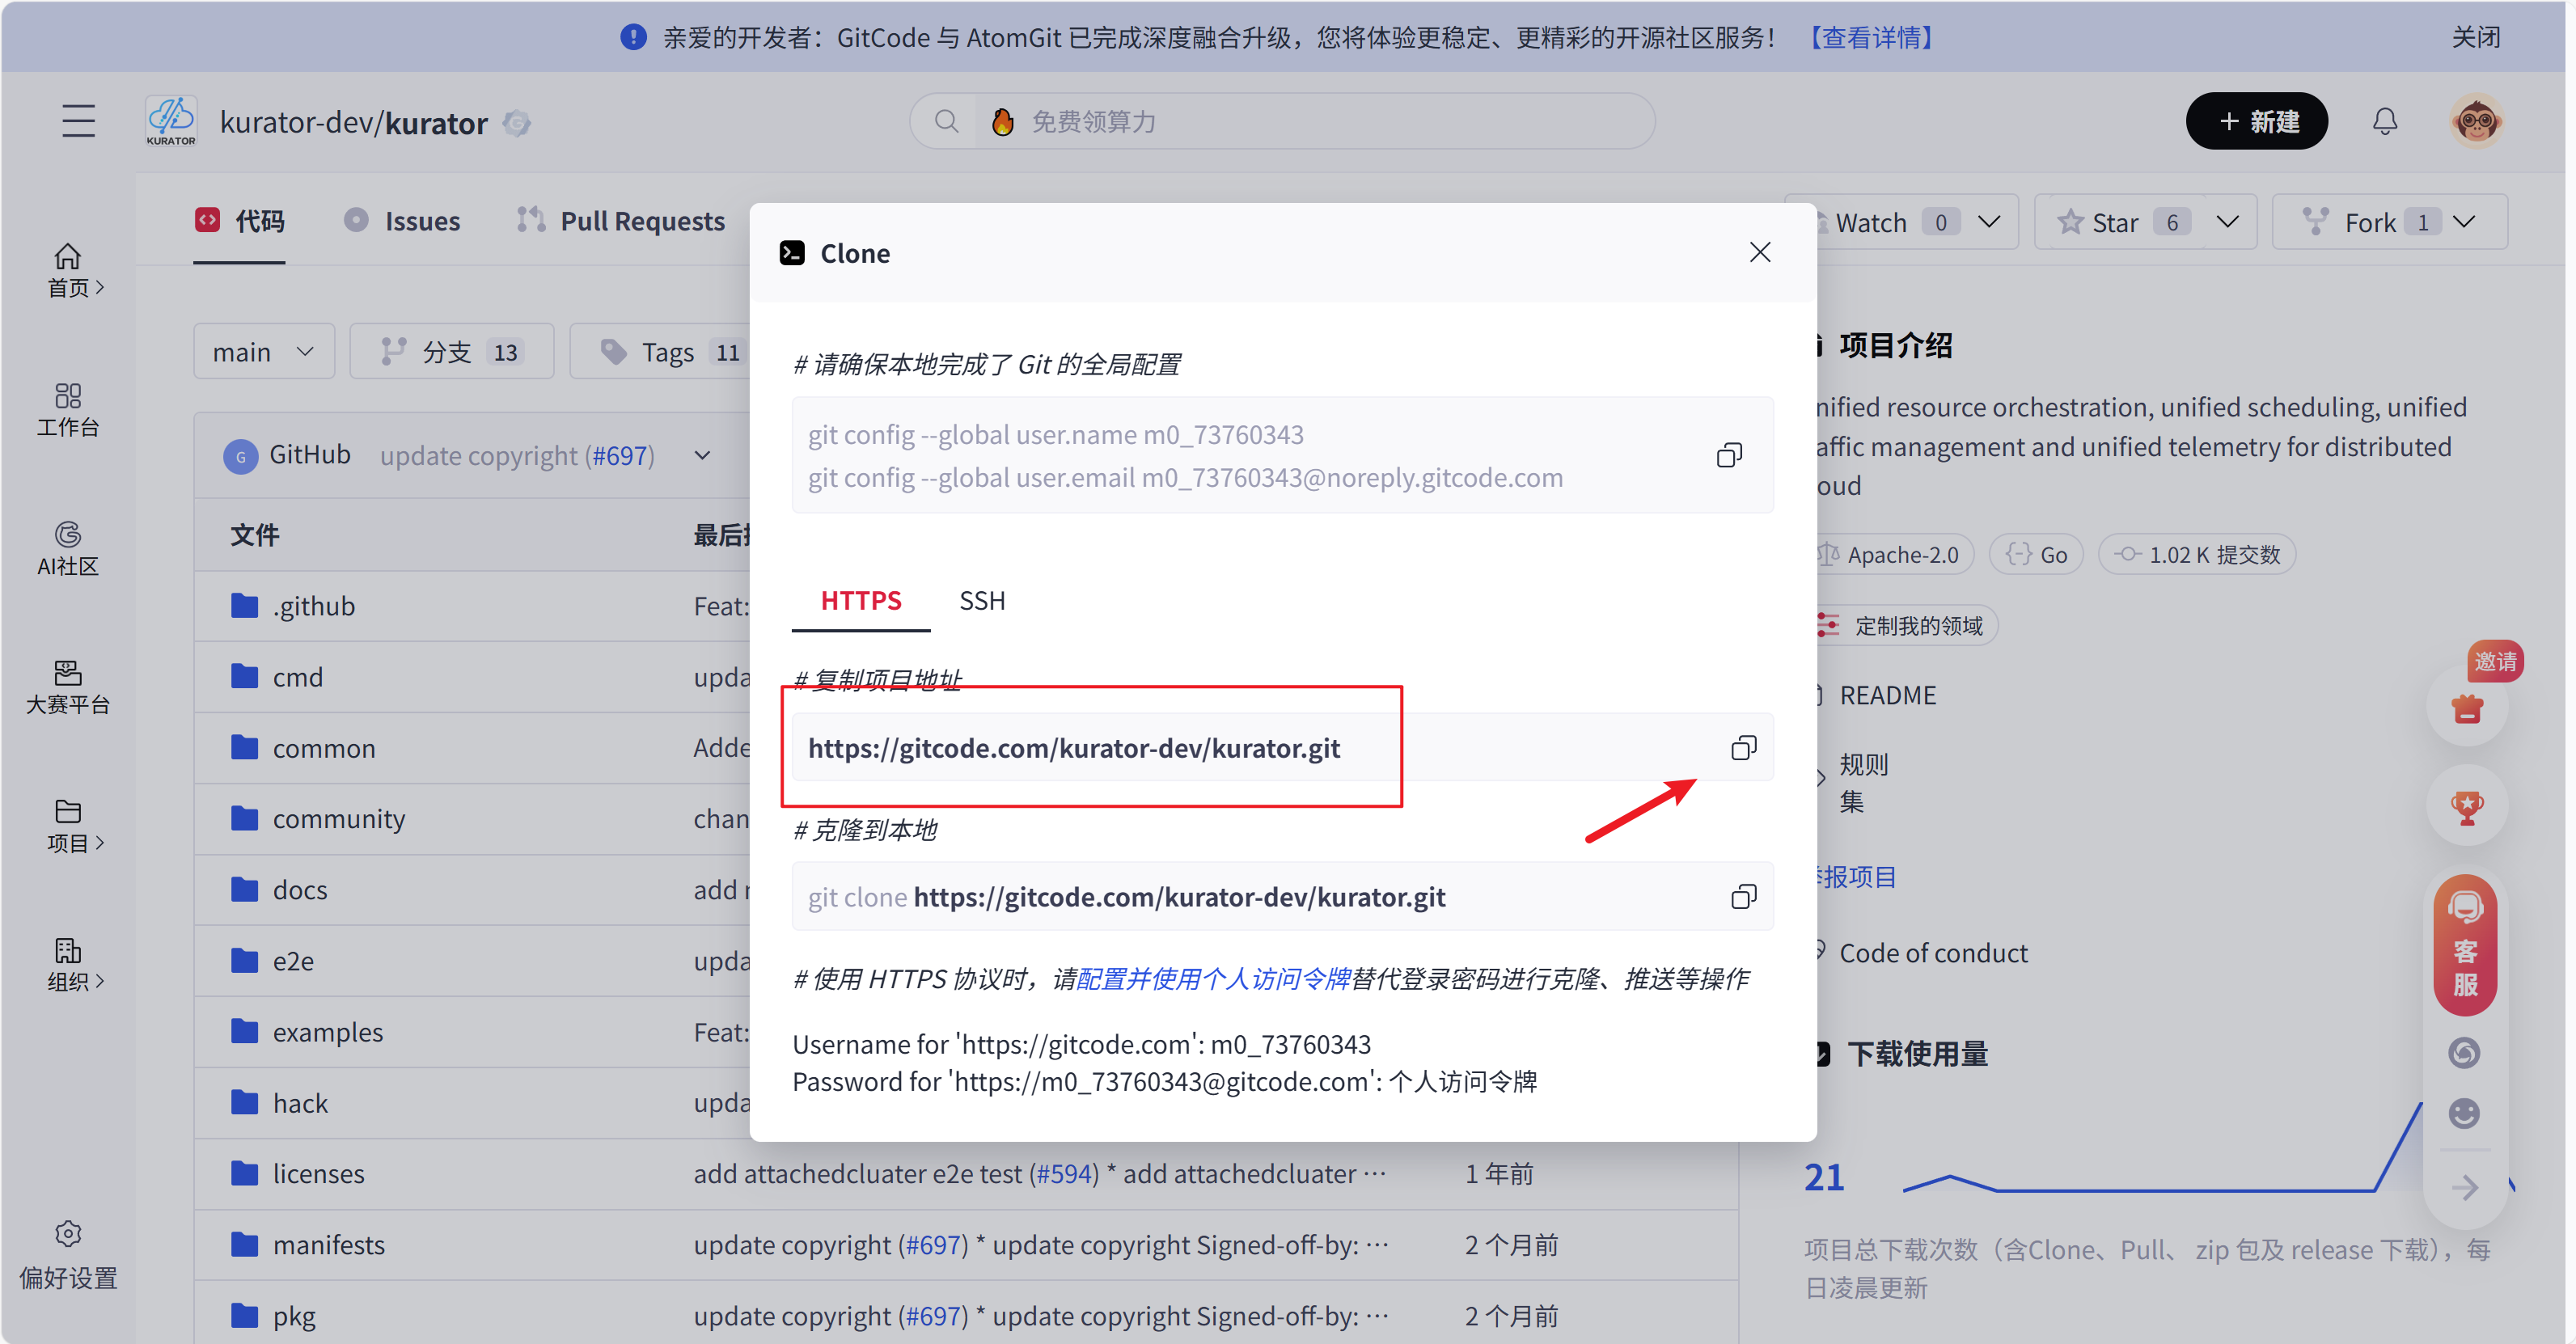
或者我们也可以下载到本地
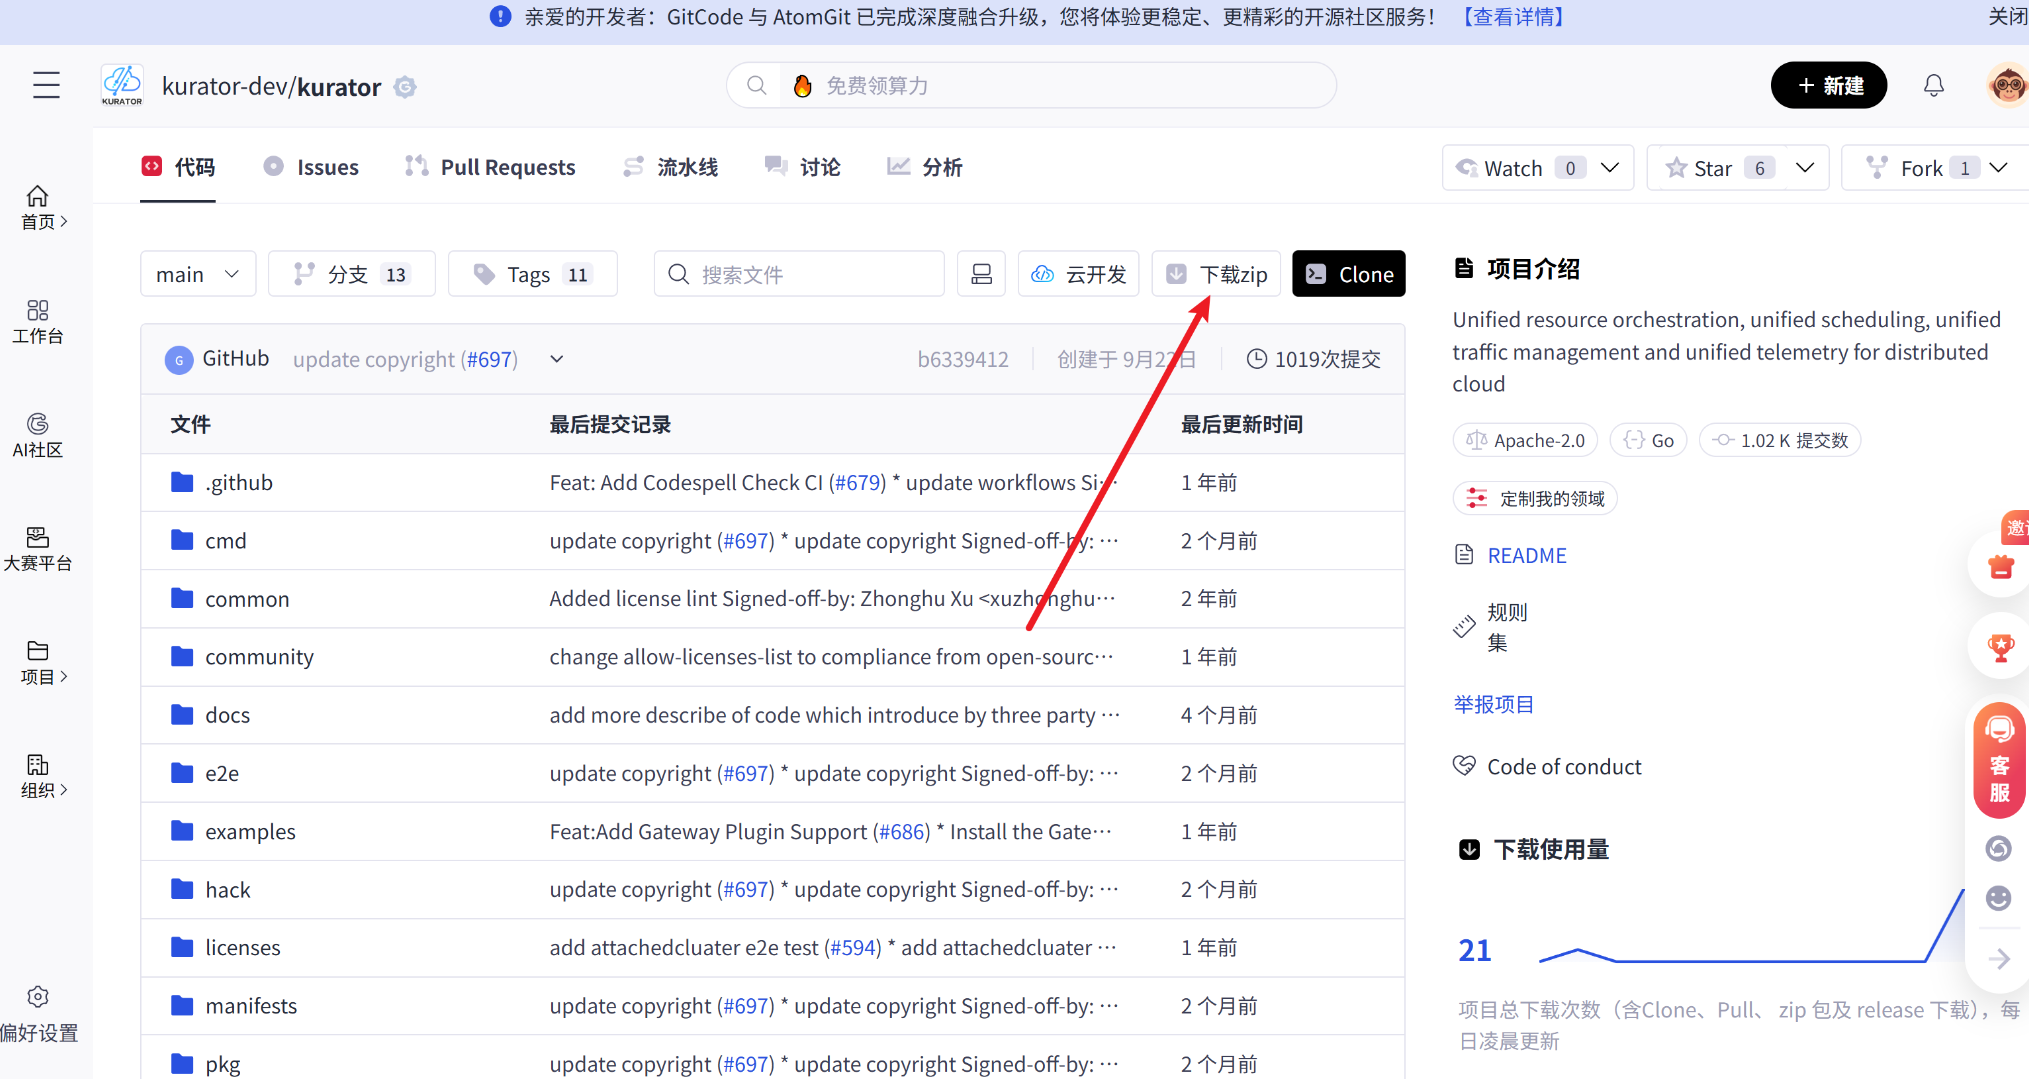
可以看到我们资源文件已经下载下来了
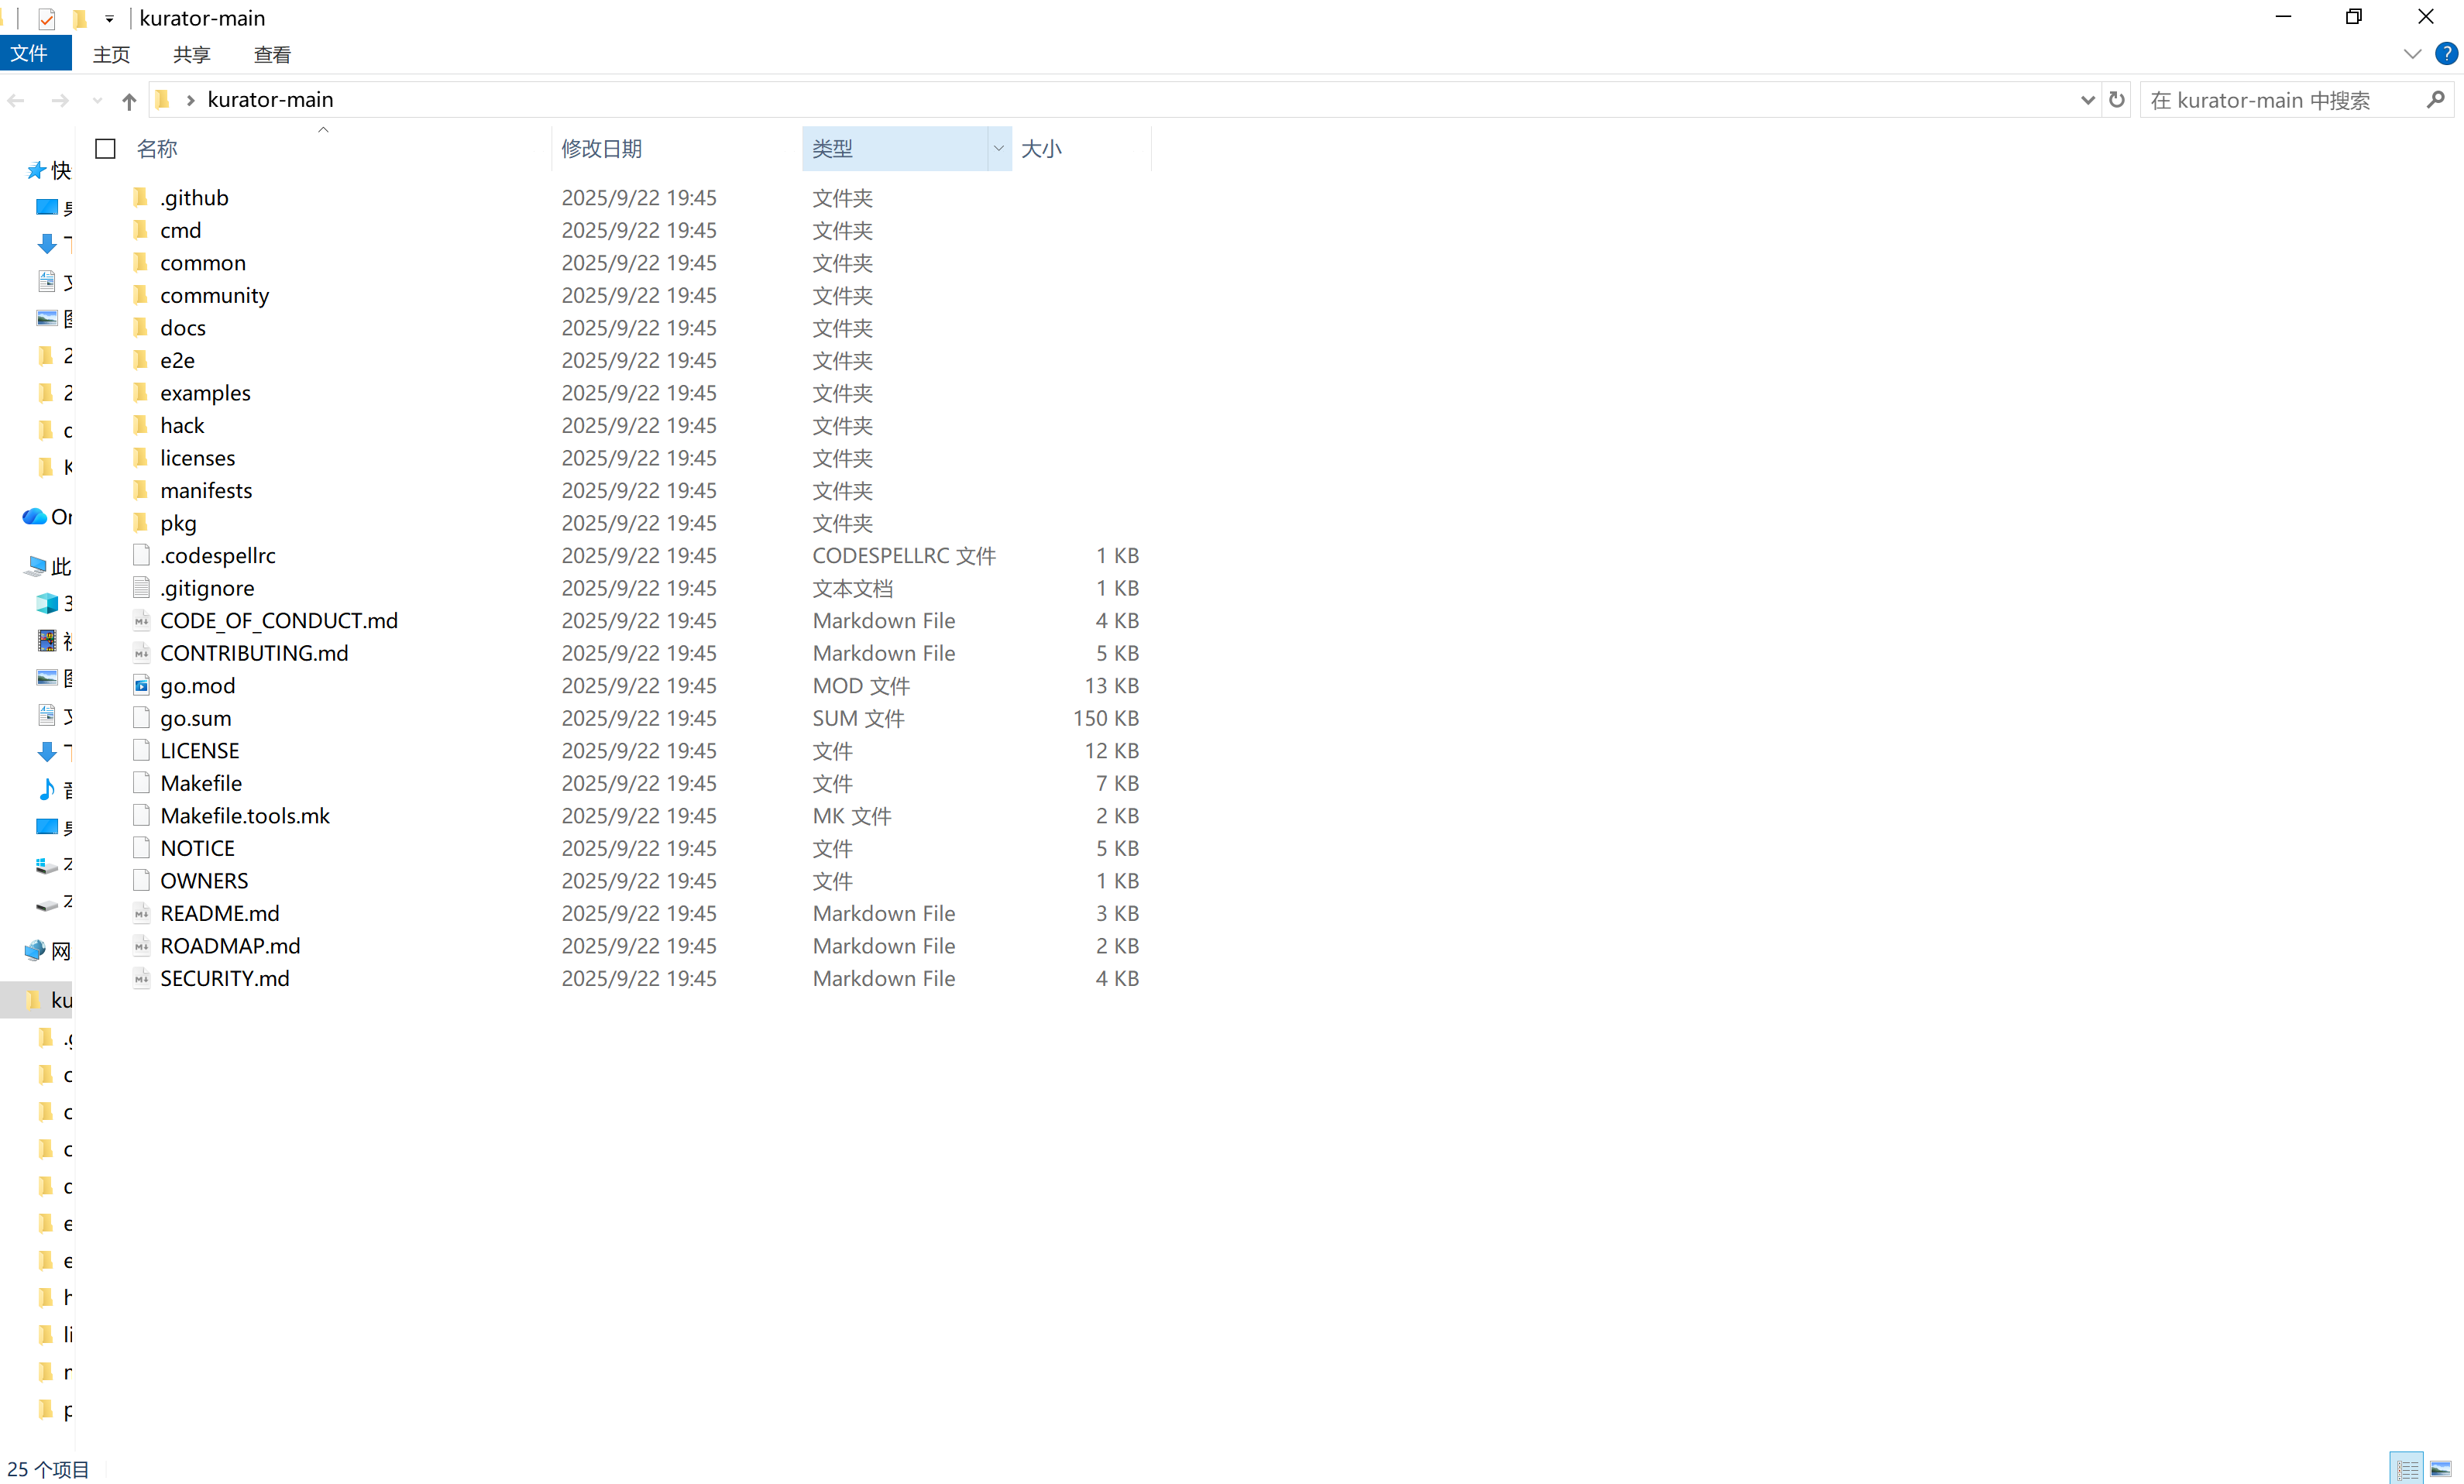
可以看到版本是0.6.0
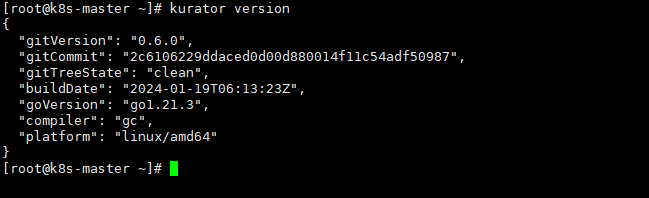
进入目录后,你会发现kurator命令行工具已经准备在bin/目录下。将其移动到你的系统PATH中:
sudo install -m 0755 bin/kurator /usr/local/bin/kurator
执行kurator version,看到版本信息即表示CLI工具安装成功。
1.3 核心组件安装:用Helm拉起控制平面
接下来,使用kurator CLI或Helm安装核心组件到你的Host Cluster。
# 使用kurator CLI安装,它会自动处理依赖和配置
kurator install

# 或者,你也可以使用最原始的Helm命令,获得更多控制权
helm repo add kurator https://kurator.dev/kurator
helm repo update
helm install kurator kurator/kurator -n kurator-system --create-namespace
安装完成后,使用kubectl get pods -n kurator-system命令,当所有Pod状态均为Running时,恭喜你,Kurator的控制平面已经就绪!这个过程通常会在2-5分钟内完成。
二、 核心实战:亲身体验Kurator四大统一能力
平台搭建完毕,是时候感受其核心威力了。我将以一个典型的“总部-边缘”业务场景为例,带你体验Kurator如何化繁为简。
2.1 舰队(Fleet)管理:像管理一个集群一样管理所有集群
在Kurator的世界里,舰队(Fleet) 是最高层次的抽象,它代表了一组需要被统一管理的Kubernetes集群集合。创建舰队,是进行所有后续操作的前提。
第一步,定义舰队。创建一个名为production-fleet.yaml的文件,内容如下:
apiVersion: fleet.kurator.dev/v1alpha1
kind: Fleet
metadata:
  name: production-fleet
  namespace: default
spec:
  clusters:
    - name: headquarter-cluster # 位于总部的核心生产集群
      kubeconfig: /path/to/headquarter-kubeconfig
    - name: edge-beijing-cluster # 北京边缘站点集群
      kubeconfig: /path/to/beijing-kubeconfig
    - name: edge-shanghai-cluster # 上海边缘站点集群
      kubeconfig: /path/to/shanghai-kubeconfig
第二步,应用配置并验证。
kubectl apply -f production-fleet.yaml
# 查看舰队及集群状态
kurator get fleet
kurator get cluster -fleet production-fleet
当所有集群状态显示为Ready,意味着Kurator已与它们成功建立连接并纳管。从此,你可以通过一个统一的API入口,向整个舰队下发指令,彻底告别在多套kubectl上下文间来回切换的繁琐。
这是Fleet 的架构官方参考图,感兴趣的朋友可以看看: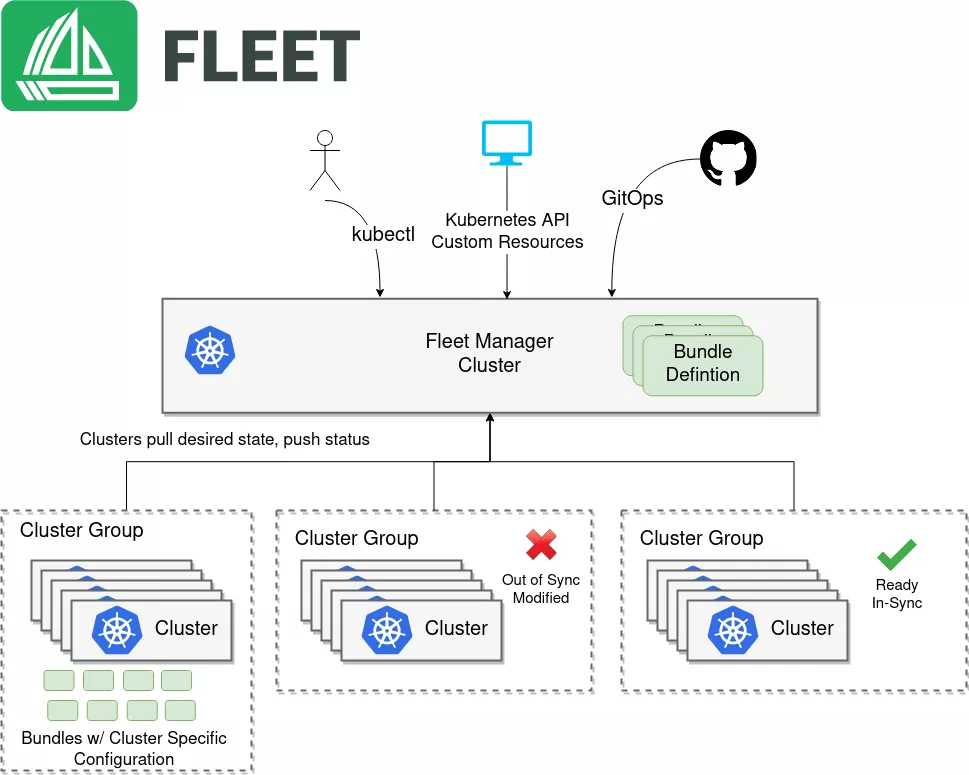
2.2 统一应用分发:一次定义,处处运行
假设我们需要将一套订单查询服务(order-service)部署到舰队的所有集群中。使用原生的方式,你需要在每个集群重复执行kubectl apply。而Kurator通过分发策略(PropagationPolicy) 实现了声明式的全局部署。
这是Kurator 统一应用分发参考图,分发流程如图所示: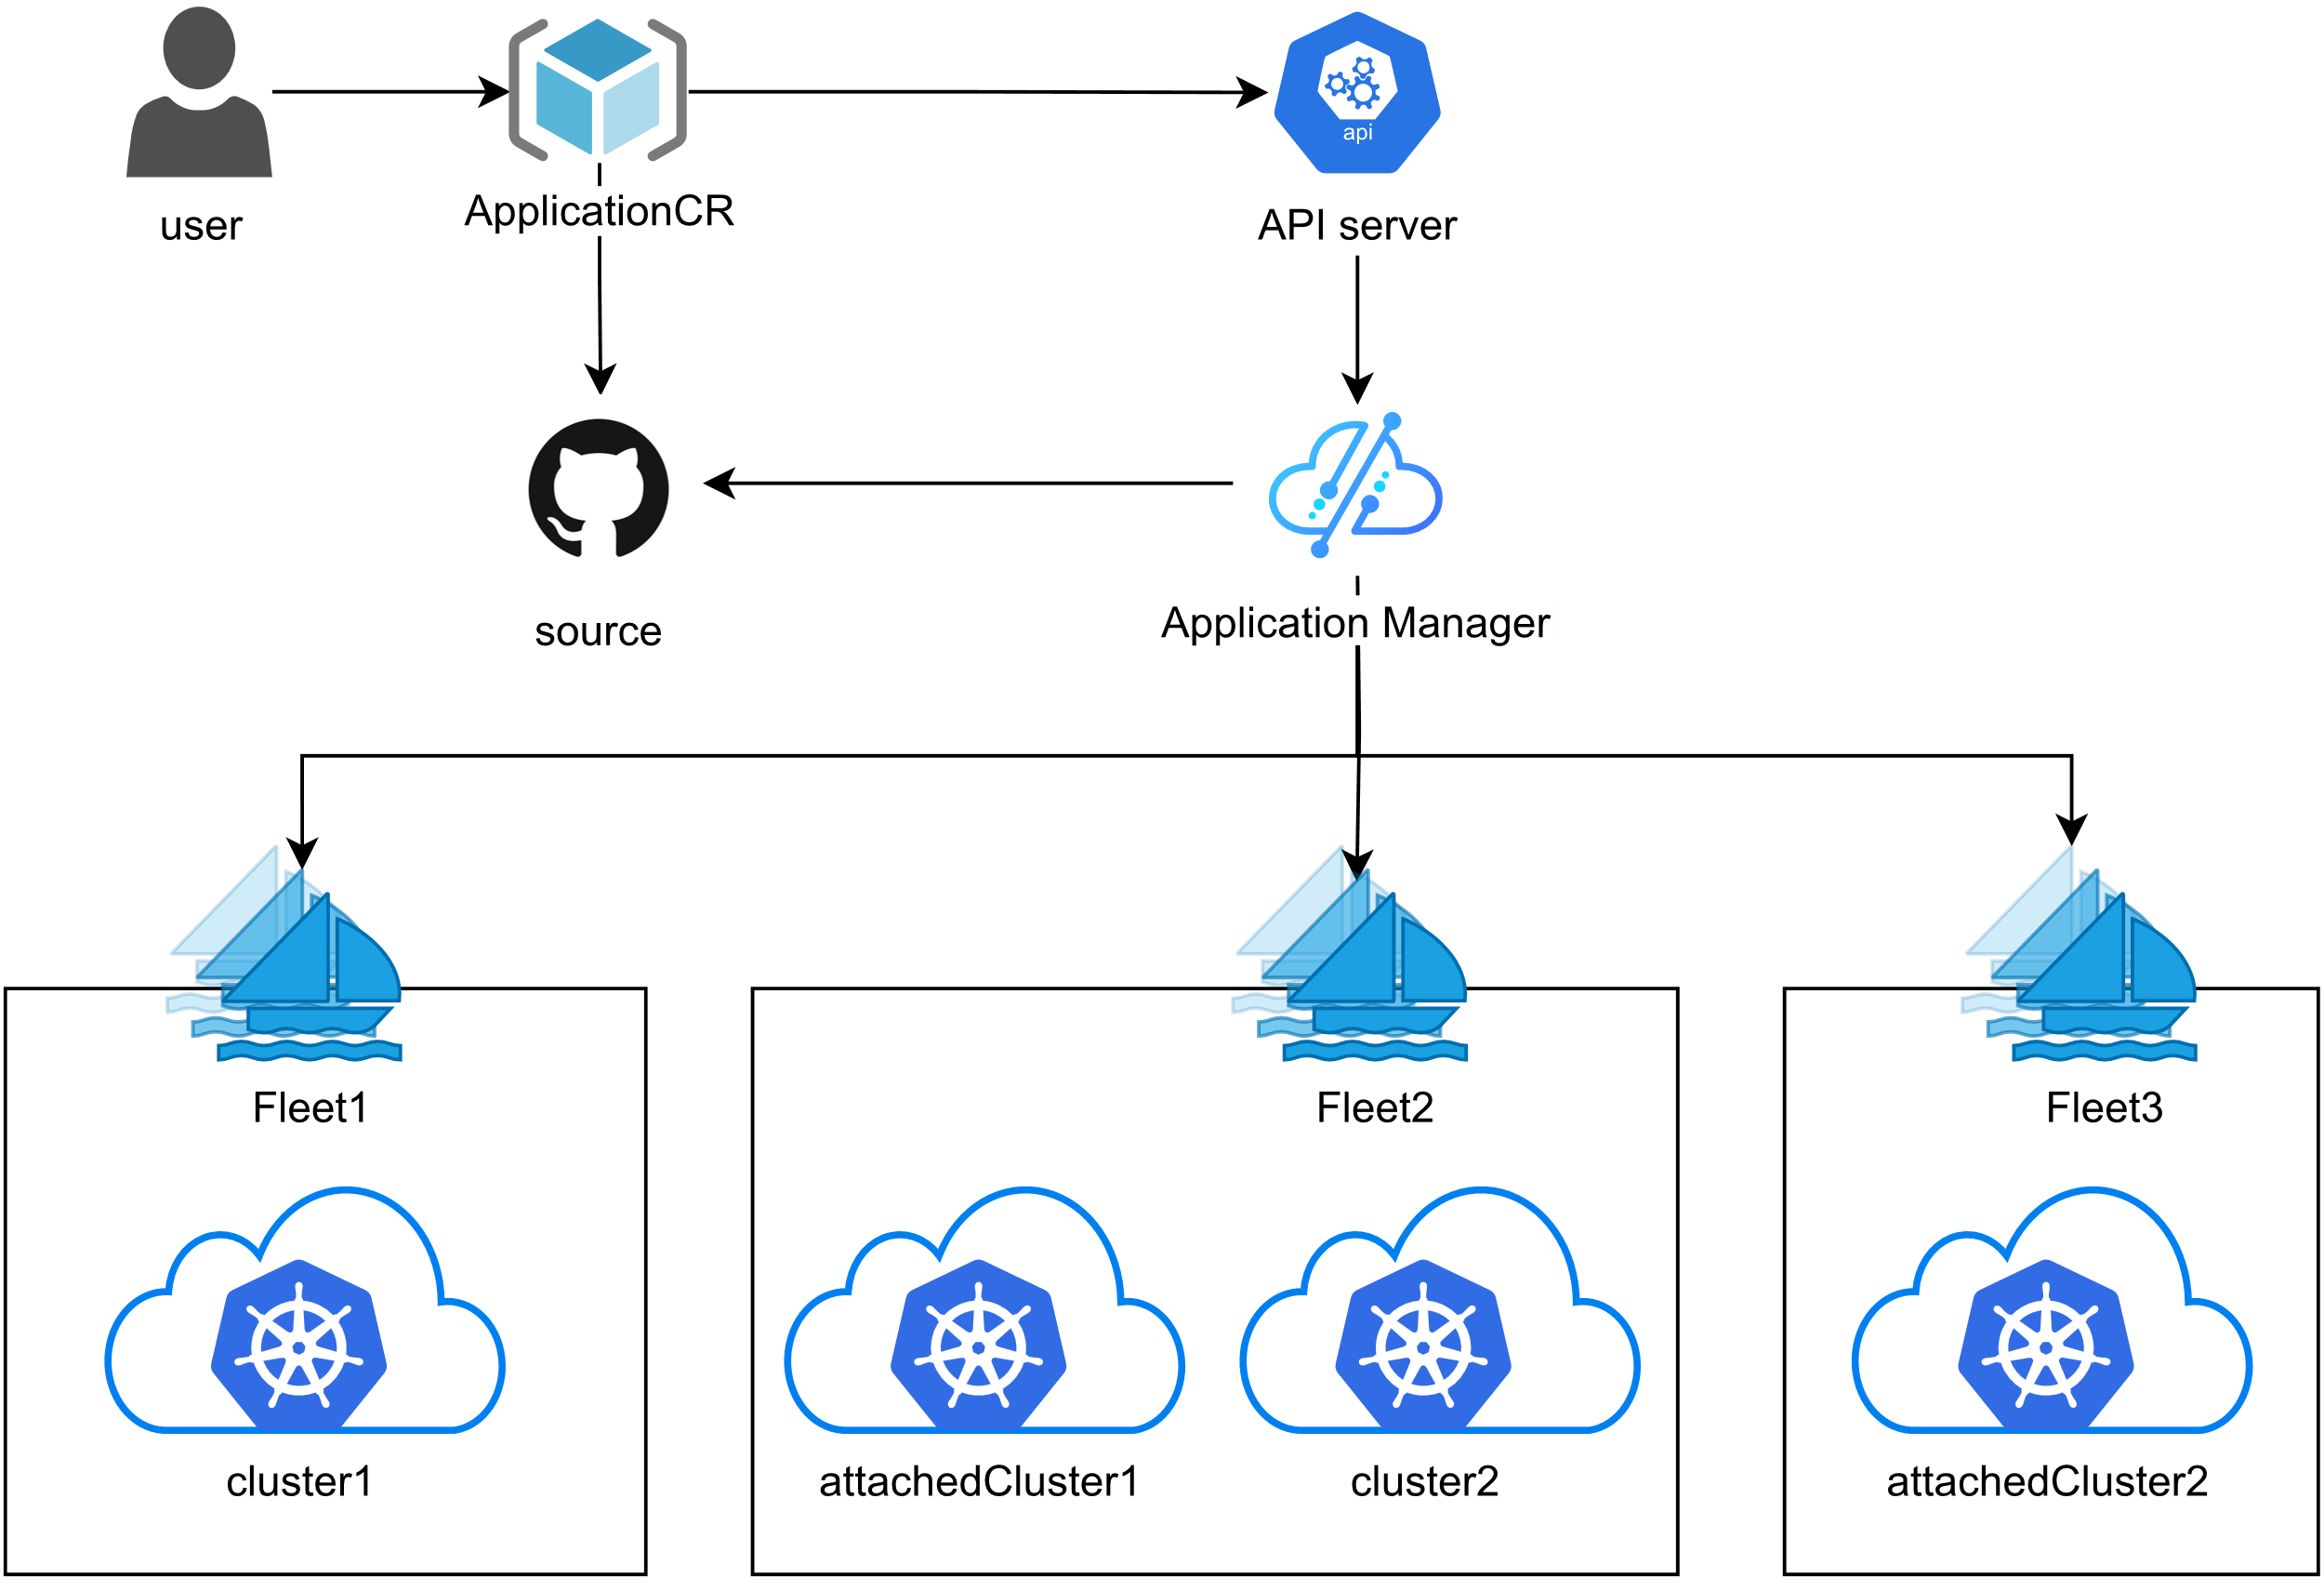
创建一个名为order-service-propagation.yaml的应用分发配置:
apiVersion: policy.kurator.dev/v1alpha1
kind: PropagationPolicy
metadata:
  name: deploy-order-service
  namespace: default
spec:
  fleet: production-fleet # 指定目标舰队
  propagateResources:
    - resourceRef:
        apiVersion: apps/v1
        kind: Deployment
        name: order-service
        namespace: kurator-demo
    - resourceRef:
        apiVersion: v1
        kind: Service
        name: order-service
        namespace: kurator-demo
  placement:
    clusterAffinity:
      clusterNames:
        - headquarter-cluster
        - edge-beijing-cluster
        - edge-shanghai-cluster # 指定部署到所有集群
  schedulingMode: Duplicated # 调度模式:在所有目标集群中各部署一份
应用这个策略后,Kurator会自动将order-service所需的Deployment和Service资源,按需分发到production-fleet舰队中的三个集群。你可以通过kurator get propagationpolicy和kurator get workload来跟踪分发状态和结果。这种方式极大提升了部署效率,并保证了跨集群部署的一致性。
2.3 统一流量治理:构建跨地域的智能服务网格
服务部署完成后,如何实现流量在总部与边缘、边缘与边缘之间的智能调度和容灾?Kurator集成了Istio,并在此基础上提供了舰队级别的统一流量治理能力。
设想一个场景:我们希望来自北京用户的订单查询请求,优先由北京的边缘集群处理,以降低延迟;当北京集群故障时,流量自动故障转移到总部集群。
首先,确保已为舰队启用Istio组件。然后,定义一个统一的路由规则(UniformRoute):
apiVersion: traffic.kurator.dev/v1alpha1
kind: UniformRoute
metadata:
  name: order-route-priority
spec:
  fleet: production-fleet
  hosts:
    - order-service.kurator-demo.svc.cluster.local
  http:
    - name: beijing-priority
      match:
        - headers:
            region:
              exact: beijing
      route:
        - destination:
            host: order-service.kurator-demo.svc.cluster.local
            cluster: edge-beijing-cluster # 北京用户路由到北京集群
          weight: 100
    - name: fallback-to-headquarter
      route:
        - destination:
            host: order-service.kurator-demo.svc.cluster.local
            cluster: headquarter-cluster # 默认路由到总部
          weight: 100
这条规则下发后,Kurator会将其自动转换并同步为舰队中每个集群内Istio可识别的VirtualService和DestinationRule。对于应用开发者而言,他们无需关心底层多个服务网格的复杂配置,只需面向舰队声明业务层的流量意图即可。这实现了真正的全局服务发现与流量控制。
2.4 统一监控与策略:全景洞察与主动防御
分布式系统的可观测性和安全性是巨大挑战。Kurator通过集成Prometheus和Kyverno/OPA等,提供了统一解决方案。
- 统一监控:只需一个声明,Kurator就能为整个舰队启用监控采集,并提供一个全局的Prometheus实例来聚合所有集群的指标。你可以通过统一的Grafana仪表板,纵览所有集群、所有服务的性能状态,轻松定位跨集群的链路性能瓶颈。
Kurator 统一监控参考图: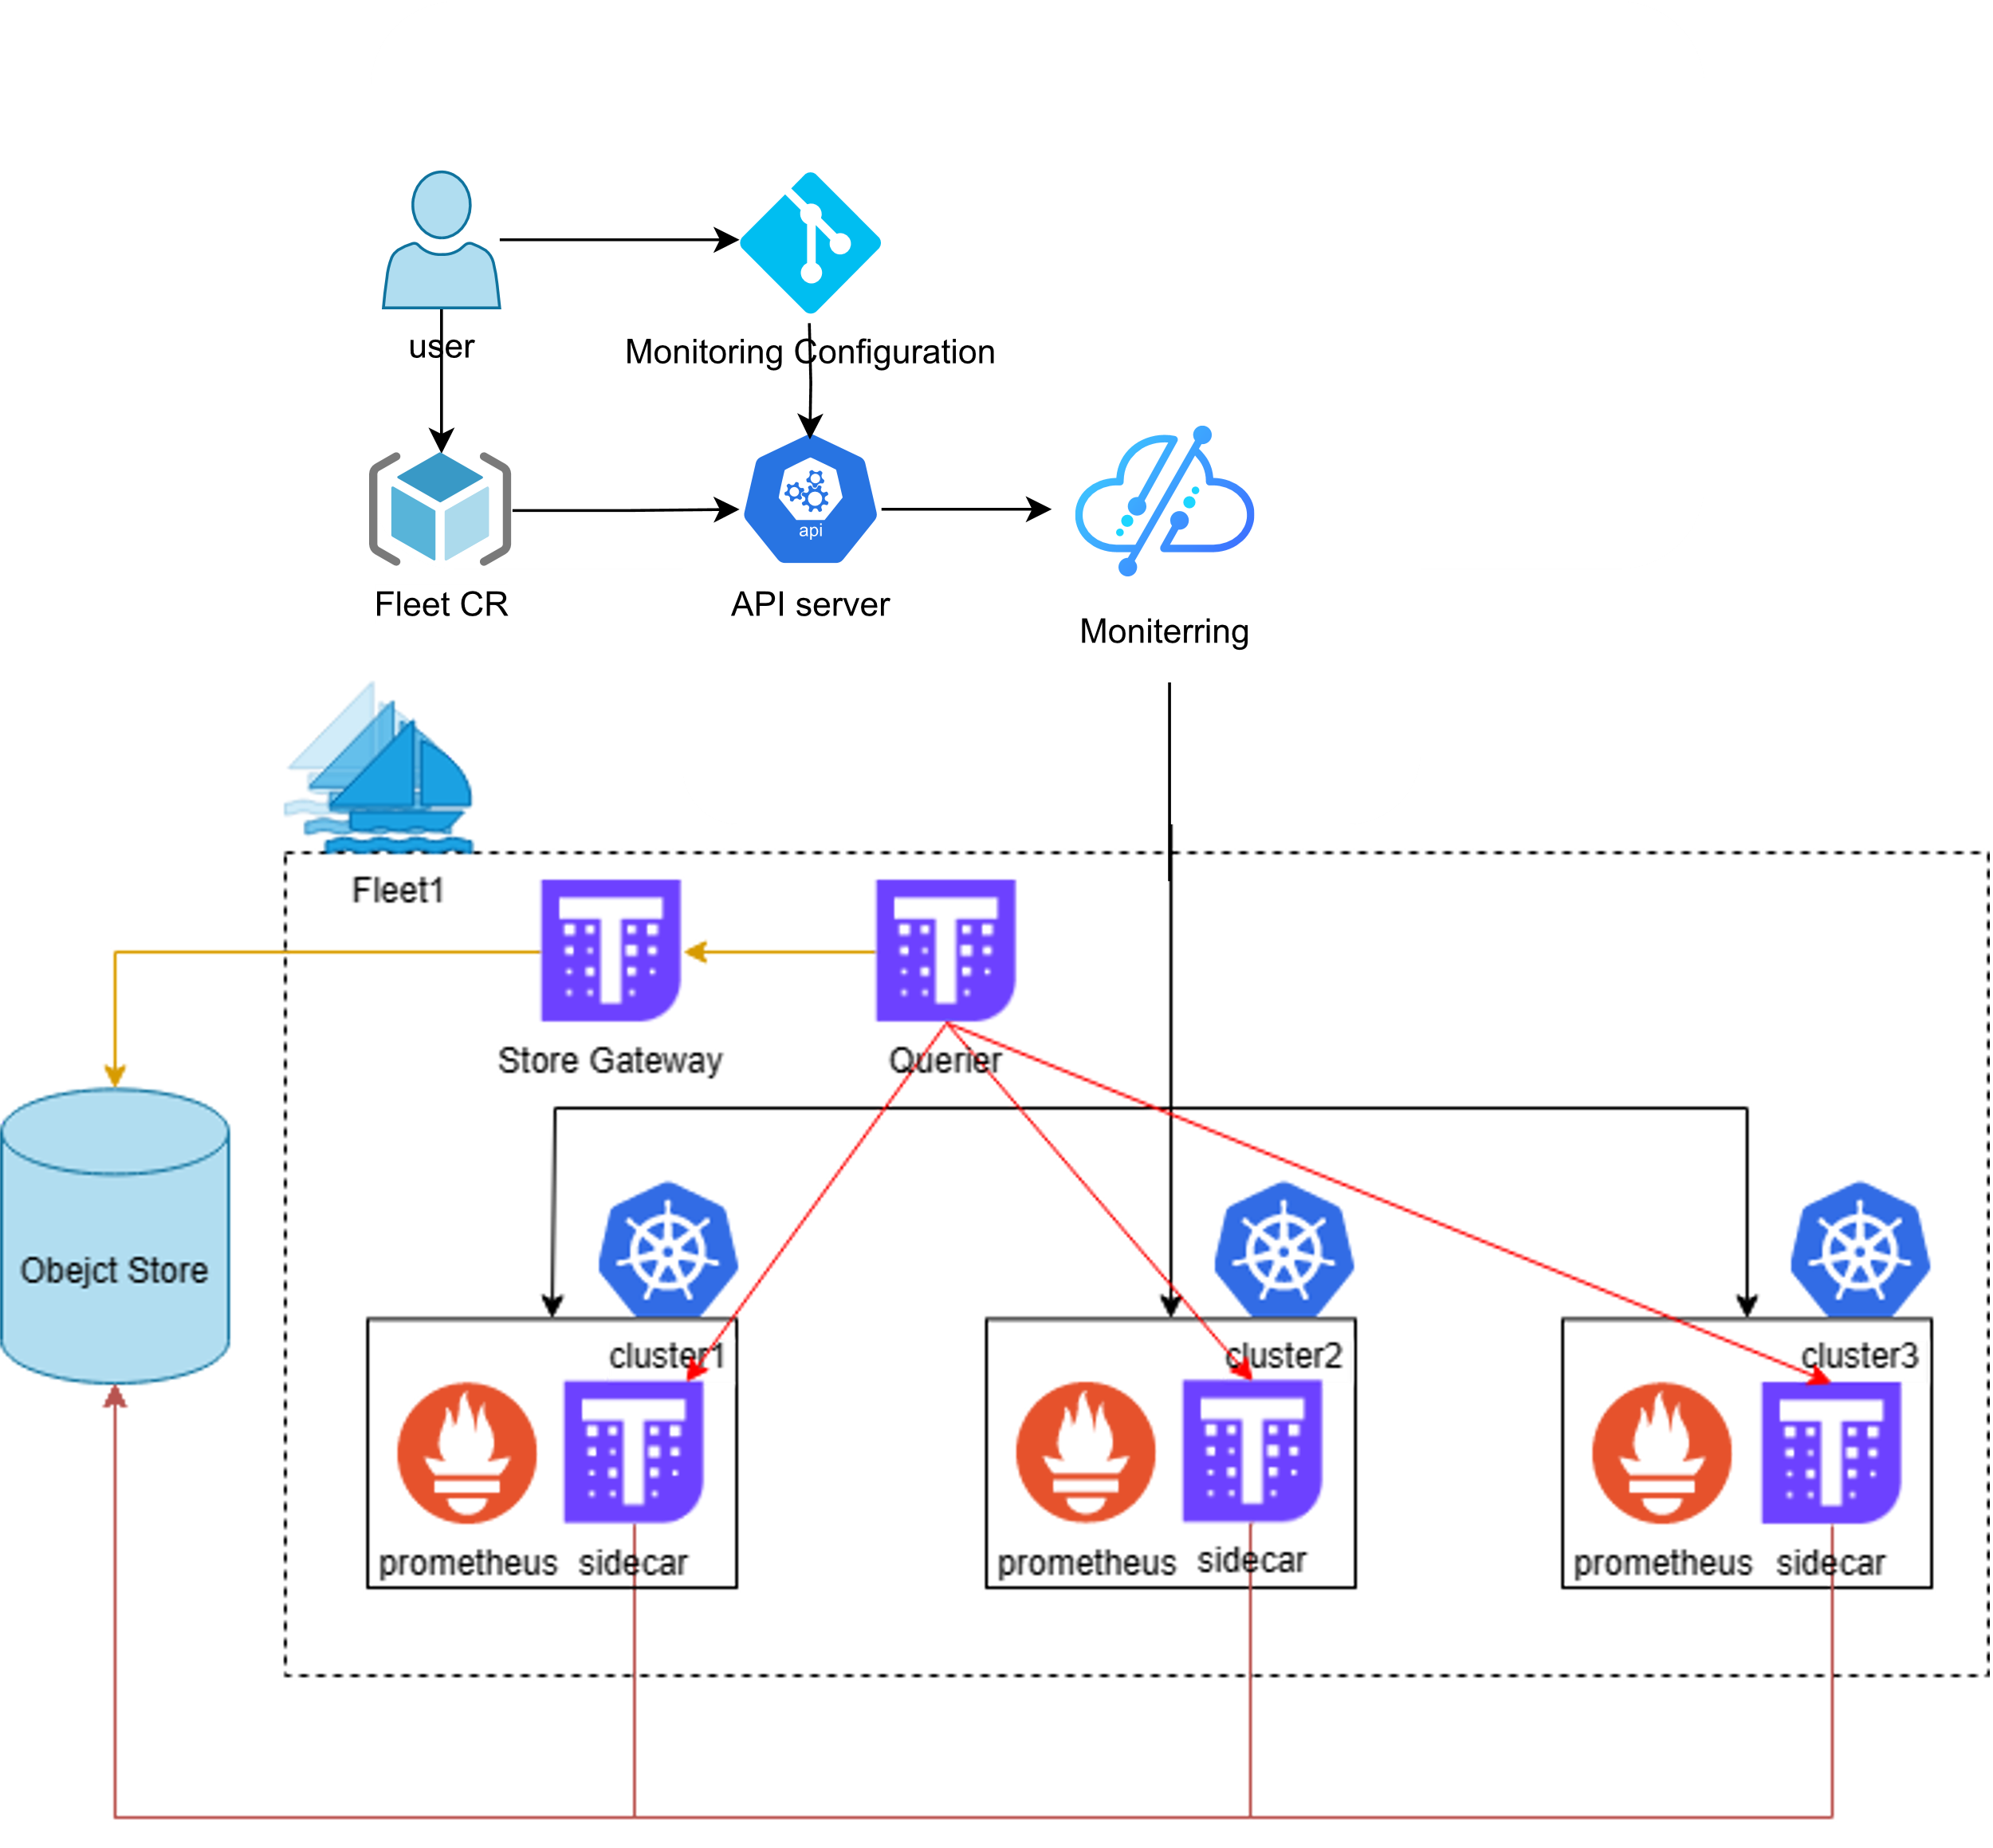
- 统一策略:在安全层面,你可以定义舰队级别的安全策略。例如,强制要求所有集群的命名空间必须包含
app.kubernetes.io/name标签,或者禁止使用latest标签的镜像。Kurator会确保这些策略在所有成员集群中被强制执行,实现安全基线的“零遗漏”。
三、 深度案例:一个中型电商平台的Kurator落地全景
理论说得再多,不如一个真实的案例。下面我将分享一个模拟的“极速购”电商平台,如何利用Kurator完成从传统单体架构向分布式云原生架构的演进。
3.1 技术选型与架构设计:为什么是Kurator?
“极速购”业务快速增长,为满足不同地区的物流计算、实时推荐和订单处理需求,决定在北京、上海、深圳自建边缘节点,核心数据仍留在阿里云。技术团队面临如下选择:
- 纯手工编排:为每个集群单独维护YAML,通过CI/CD流水线分别部署。复杂度呈指数增长,被否决。
- 采用单一多云编排工具:如Karmada,解决了应用分发问题,但流量治理、监控仍需额外集成,运维负担重。
- 采用Kurator:它提供了开箱即用的完整解决方案,覆盖了从集群管理、应用到运维的全栈需求。团队评估后认为,Kurator“整合优化”的理念能最大程度降低集成和长期维护成本,遂成为最终选择。
最终架构如图所示(此处为描述):中心Region(阿里云)部署核心订单、用户服务,作为Host Cluster运行Kurator控制面;三个边缘站点分别部署库存、推荐等延迟敏感服务。通过Kurator的Fleet统一纳管这4个集群。
如图是kurator架构参考图: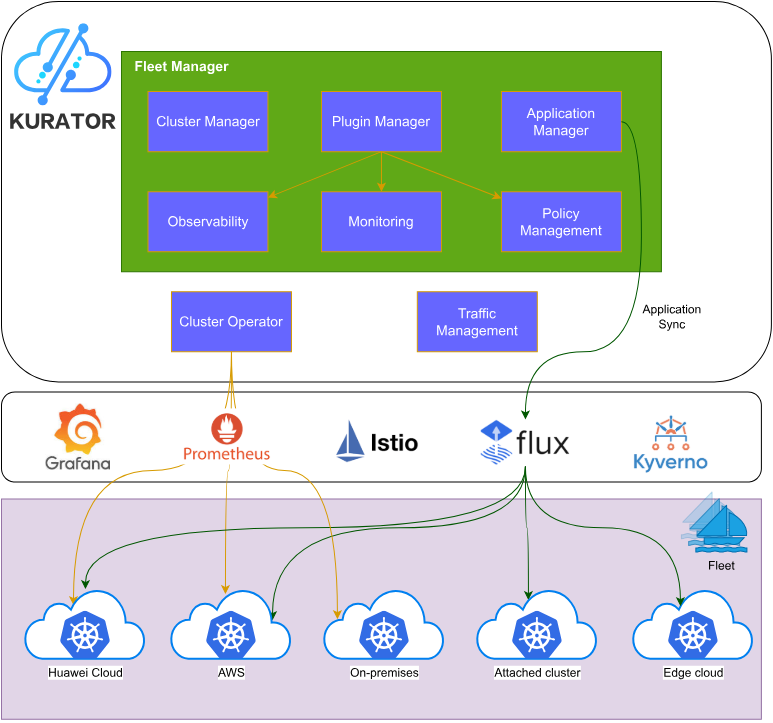
3.2 适配、攻坚与落地:踩坑与填坑之路
落地过程并非一帆风顺,我们遇到了几个关键挑战:
-
挑战一:异构集群网络互通。边缘集群位于NAT之后,与中心集群无法直接通过Pod IP通信。
- 解决方案:我们利用Kurator对KubeEdge的集成能力,将边缘集群作为Edge节点接入。Kurator自动处理了云端协同的通信隧道建立,使得中心集群的控制指令可以顺畅下发到边缘,边缘服务也能被中心网格发现和治理。
-
挑战二:批量应用迁移的灰度与回滚。将上百个微服务一次性迁移至新的分布式体系风险极高。
- 解决方案:我们充分利用Kurator分发策略中灵活的
placement(放置规则)和schedulingMode(调度模式)。例如,对于关键服务,我们先通过ClusterAffinity将其只分发到“总部集群”和“北京边缘集群”进行灰度验证。确认稳定后,再修改策略,逐步扩量到全部集群。整个过程中,回滚只需修改或删除策略文件,非常便捷。
- 解决方案:我们充分利用Kurator分发策略中灵活的
-
挑战三:传统运维习惯的转变。运维团队习惯了登录具体集群排查问题。
- 解决方案:我们借助Kurator的统一监控,建立了以“应用”和“舰队”为核心的运维视图。通过定制化的全局大盘,故障定位时间平均缩短了60%。同时,组织多次内部培训,强调“面向舰队运维”的新范式。
3.3 成效与价值:看得见的效率与稳定性提升
经过三个月的平稳运行,Kurator带来的价值清晰可见:
- 运维效率:跨集群应用发布时间从平均2小时缩短至10分钟,配置错误率下降90%。
- 资源利用率:通过统一调度和边缘计算,将部分中心算力需求卸载到边缘,整体计算成本节约约15%。
- 业务稳定性:借助跨集群流量调度和故障转移能力,在大促期间,即使单个边缘站点因网络波动短暂异常,业务请求自动切换,实现了零客户感知的故障,系统可用性达到99.99%。
- 团队成长:开发团队更专注于业务逻辑,无需深入底层基础设施细节;运维团队从重复劳动中解放出来,开始更多关注容量规划与性能优化。
四、 前瞻与生态:Kurator的整合哲学与未来展望
Kurator的强大部分源于其独特的“集成而非替代”哲学。它没有重复发明Karmada(多云编排)、Istio(服务网格)、Prometheus(监控)等轮子,而是作为“胶水”和“增强剂”,将这些顶级项目以最佳实践的方式组合在一起,并填补了它们之间的功能间隙。
4.1 核心集成的创新优势
- 对Karmada的增强:Kurator不仅使用Karmada进行资源分发,更通过Fleet API提供了更高层次的抽象。同时,它扩展了Karmada的调度能力,使其能与Volcano(批量计算)等调度器协同,满足AI训练、大数据作业等复杂调度需求。
- 对KubeEdge的深度融合:Kurator将边缘集群的管理变成了“一等公民”,从安装、纳管到应用分发、监控,为云边协同提供了端到端的解决方案,这是单独使用KubeEdge难以达到的体验。
- 统一的应用、运维平面:这是Kurator最大的创新点。它将离散的工具统一成连贯的工作流。用户不再需要分别学习多个项目的API,只需与Kurator交互,就能完成分布式应用的全生命周期管理。
4.2 对分布式云原生发展的思考与建议
通过深度使用Kurator,我对这个领域的发展有几点深切体会和建议:
- 标准化与API收敛是关键:当前CNCF生态丰富但碎片化。未来需要更多像Kurator这样的项目,致力于在接口层面进行统一和简化,降低开发者的认知负荷和使用门槛。
- “意图驱动”的运维是方向:正如Kurator所做的,未来的平台应让开发者声明“我想要什么”(如:将A应用以金丝雀方式部署到亚洲的集群),而非具体描述“如何去做”。平台应自动、可靠地完成实现。
- 拥抱异构,专注协同:未来的基础设施必然是异构的,包含x86、ARM、GPU乃至各类边缘设备。分布式云原生平台的核心价值,应体现在对异构资源卓越的协同编排能力上,让应用无感地运行在最适合的资源之上。
结语
从初次接触概念到完成一个模拟项目的深度落地,Kurator向我们展示了一条通往分布式云原生世界的“高速公路”。它通过务实而精巧的集成设计,将前沿技术的复杂性封装起来,呈现给用户一个简洁、强大且统一的操作界面。
对于正在或即将面临多云、混合云、边缘计算挑战的企业和开发者而言,深入探索和实践Kurator,不仅是为当下寻找一个高效的解决方案,更是提前适应并塑造以应用为中心、资源全域协同的下一代云原生运维范式。旅程已经开始,何不即刻启航,构建属于你自己的分布式云原生舰队?
Kurator分布式云原生开源社区地址:https://gitcode.com/kurator-dev
Kurator分布式云原生项目部署指南:https://kurator.dev/docs/setup/
更多推荐

 28
 0
- 0


 已为社区贡献6条内容

所有评论(0)