
TOD3Cap: Towards 3D Dense Captioning in Outdoor Scenes
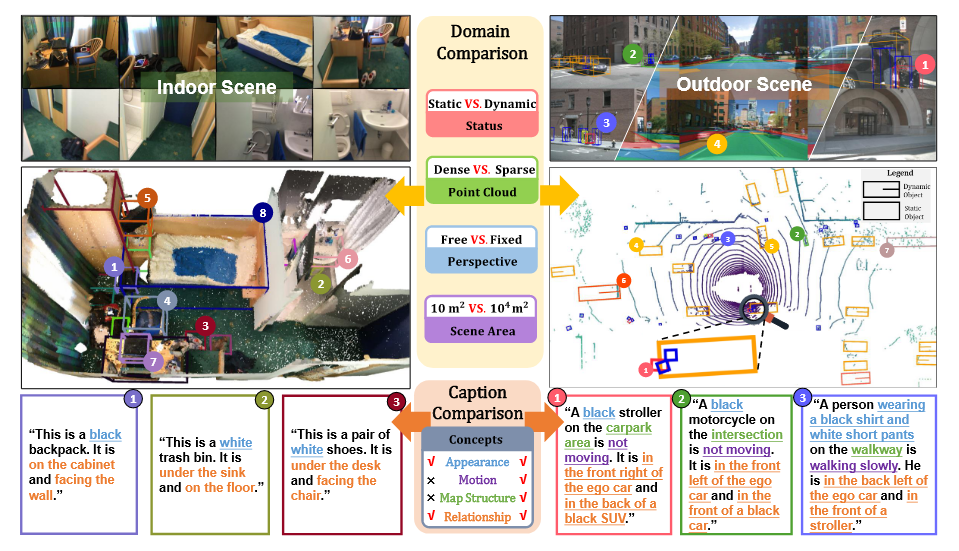
图1:我们介绍了户外场景中3D密集字幕的任务(右图)。给定点云(右中间)和多视角RGB输入(右上),我们预测3D户外场景中所有物体的框状字幕对。室内和室外场景之间存在几个基本的领域空白(中间列),包括状态、点云、透视和场景区域,带来了户外场景特有的新挑战。与此同时,我们的户外3D密集字幕(右下角)比室内场景(左下角)包含了更全面的概念。
摘要
3D密集字幕是通过自然语言全面理解3D场景的基石。近年来,尤其是在室内环境中取得了显著成就。然而,户外场景中3D密集字幕的探索受到两个主要挑战的阻碍:1)室内与室外场景之间的领域差距,如动态和稀疏的视觉输入,使得直接适应现有室内方法变得困难;2)缺乏专门针对户外场景的全面框与字幕对注释的数据。为此,我们引入了户外3D密集字幕的新任务。作为输入,我们假设有一个激光雷达点云和一组由全景相机设备捕获的RGB图像。预期输出是一组带有说明的对象框。为完成这一任务,我们提出了TOD3Cap网络,利用BEV表示生成对象框提案,并将Relation Q-Forform与LLaMA-Adapter集成,为这些对象生成丰富的字幕。我们还介绍了TOD3Cap数据集,这是我们目前已知最大的户外场景3D密集字幕数据集,包含了来自nuScenes中850个场景中64.3K个户外对象的230万个描述。值得注意的是,我们的TOD3Cap网络能够有效定位并为户外场景中的3D对象添加字幕,其性能远远优于基线方法(+9.6 CiDEr@0.5IoU)。代码、数据和模型均公开于 https://github.com/jxbbb/TOD3Cap。
关键词:3D密集字幕 ·3D场景理解 ·三维视觉语言·数据
1 简介
近年来,社区在3D密集字幕方面取得了显著进展。通过用自然语言明确表达三维场景的理解,它在跨模态检索[8, 26]、机器人导航[24, 46, 52, 61]、交互式增强现实/虚拟现实[41]和自动驾驶[29,47,48]中展现了多种应用。在这一具有挑战性的环境中,需要算法定位3D场景中的所有物体,并为其多样属性添加字幕。
之前的一些作品[4, 7, 11, 12, 28, 51, 57]探索了3D密集字幕任务,并取得了有希望的成果。然而,这些方法主要聚焦于室内场景的3D密集字幕,而室外3D密集字幕则鲜少被探索。此外,仔细观察室内和室外场景之间的显著差异(见图1),我们认为直接将这些室内方法应用于室外场景并不理想,因为:
- 动态,而非静态。户外场景通常是动态的,需要检测和跟踪具有时间变化状态的物体。
- 稀疏的激光雷达点云。利用激光雷达收集的稀疏点云在户外场景中带来了形状理解的重大挑战。更糟的是,稀疏度在空间上变化很大。
- 固定摄像机视角。室内场景扫描允许自由的摄像机轨迹(例如绕过感兴趣物体),而户外场景通常采用固定的6摄像机设备,呈现更高的自遮挡效果。
- 面积更大。户外场景通常覆盖更大的区域。
这些域差距对户外场景中成功的3D密集字幕构成了重大挑战。本文首先正式化了户外3D密集字幕的新任务。它接收LiDAR点云和全景RGB图像作为输入,预期输出是一组带有说明的对象框。随后,我们提出了一种基于变压器的架构,名为TOD3Cap网络,以应对这一任务。具体来说,我们首先从3D LiDAR点云和2D多视图图像创建统一的BEV地图。然后我们使用基于查询的检测头生成对象提案。我们还使用关系Q-Forformer来捕捉对象提案与场景上下文之间的关系。最终,对象提案特征被输入视觉语言模型,生成密集的字幕。得益于适配器[58]的使用,TOD3Cap网络无需重新训练语言模型,因此我们可以利用语言基础模型中预训练的常识,这些模型在大量数据上进行预训练。
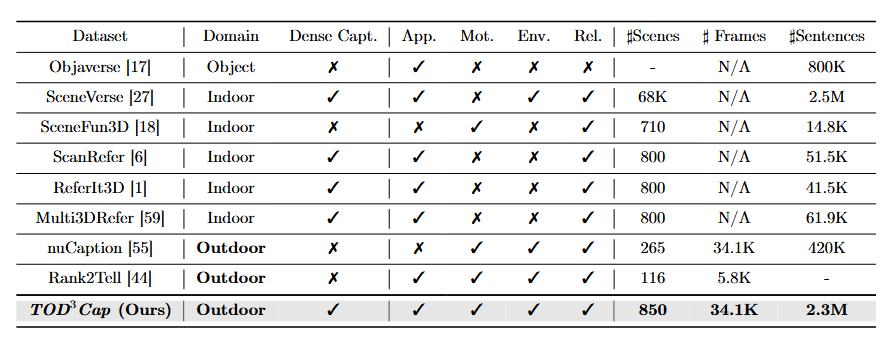
表1:现有3D字幕数据集概览。应用、机动、环境、关系分别表示外观、运动、环境和关系。
除了室内与室外领域的差距使室内架构不适合户外场景外,成功解决户外3D密集字幕还存在数据需求[56]问题,即户外场景缺乏对齐的框框与字幕对。为了促进未来户外3D密集字幕的研究,我们收集了TOD3Cap数据集,该数据集为来自nuScenes的LiDAR点云和全景RGB图像提供按框的自然语言字幕[3]。我们共获得了230万条字幕,包含63400个户外实例。据我们所知,我们的TOD3Cap数据集是首个涵盖百万句子的3D密集字幕项目,也是迄今为止户外场景中最大的一次。总结来说,我们的贡献如下:
- 我们引入了户外3D密集字幕任务,利用LiDAR点云和一组全景RGB图像作为输入,密集地检测和描述3D物体。其独特挑战在图1中得到了突出展示。
- 我们提供了包含230万个户外场景实例描述的TOD3Cap数据集,并将现有的TOD3Cap数据集的先进方法用于基准测试。
- 我们证明,我们的方法显著优于代表性室内方法的基线(+9.6 CiDEr@0.5IoU)。
2 相关工作
3D密集字幕。近年来,社区在3D密集字幕方面取得了显著进展 [4, 7, 11, 12, 28, 51, 57]。以往研究主要有两种范式:“检测后描述”[4, 7, 12, 28, 51, 57]和“集合对集合”[11]。“先检测再描述”范式首先使用检测器生成提案,然后使用生成器生成字幕。例如,Scan2Cap [12] 利用 VoteNet [42] 定位场景中的对象,基于图的关系模块建模对象关系,以及一个译码器生成句子。[7, 13] 深入探讨,展示密集字幕与视觉基础任务的相互强化效应。另一种解决该问题的方法是“集合对集合”范式,如Vote2Cap-DETR [10]及其后续工作[11]。这些方法将三维密集字幕视为对场景问题,并利用单阶段架构来解决。此外,还有一些研究[9,21,55,62]关注通过多任务设置进行大规模预训练,以解决3D密集字幕任务。然而,这些方法主要集中在室内场景,难以直接适应户外场景。相比之下,我们提出的TOD3Cap网络则面向户外3D密集字幕制作。
3D字幕数据集。获得既以对象为中心又具上下文感知的三维语言描述是一项艰巨的工作。最常用的3D密集字幕数据集是基于丰富注释的3D室内数据集Scannet [15]的ScanRefer [6]和ReferIt3D(Nr3D)[1]。值得注意的是,尽管像Objaverse [16, 17]等近期开发尝试了大规模物体字幕以实现3D语言对齐,但它们缺乏场景上下文信息。最近提出的室内场景数据集如SceneVerse [27]、SceneFun3D [18]和Multi3DRefer [59]分别聚焦于大尺度场景图字幕、对象部分级字幕和多对象关系字幕。然而,现有数据集大多基于室内场景,未能涵盖如图1所示户外场景的独特科学挑战。nuCaption [55] 和 Rank2Tell [44] 设计用于户外场景,但它们仅专注于以事件为中心的场景字幕,而非密集的字幕。相比之下,我们提出的TOD3Cap数据集在户外场景中提供了密集的以对象为中心的语言描述。我们在标签页1展示了数据集与现有3D字幕数据集的统计对比,突出其独特价值。
基于BEV的3D感知。近年来,基于BEV的三维感知技术发展迅速且兴趣不断增长[25, 31, 32, 45],因为BEV表示已被证明在户外感知任务中极为有益,如3D物体检测和跟踪。LiftSplat-Shoot [40] 及其后续研究[22, 31]利用预测深度概率将投影图像嵌入BEV柱中。BEVFormer [32] 利用空间交叉注意力将二维图像特征聚合到 BEV 空间,并采用时间自注意融合时间特征以建模物体运动。BEVFusion [34] 结合了 LiDAR 的点云特征和图像特征,以增强 BEV 空间中的几何信息。受其启发,我们的方法融合了激光雷达和多视图图像的特性,并利用时间融合技术获得更丰富的上下文信息和物体运动建模,帮助解决户外密集字幕的挑战。
3 TOD3Cap数据集
为了促进户外3D密集字幕任务的研究,我们引入了TOD3Cap,这是一个百万尺度的多模态数据集,扩展了nuScenes[3],并附有密集字幕注释。我们在第3.1节介绍了数据收集流程,并在第3.2节展示了我们拟议数据集的总体统计数据。
3.1 数据收集
本节介绍了拟议数据集的数据收集流程。我们利用一个广受欢迎且规模庞大的户外数据集 nuScenes[3],包含850个场景,3.4k帧。每帧由6台相机和一个激光雷达点云拍摄的6张图像组成。原始数据集提供了23个类的三维边界框注释。我们通过为所有物体的外观、运动、环境和关系进行注释,将其扩展到3D密集字幕。
收集原则。当在户外场景中描述一个物体时,人类会考虑一系列的问题:“它是什么,它看起来像什么?",“它在做什么?",“它在哪里?",“它周围是什么?",我们分别称之为它们的外观,运动,环境和关系。
外观:描述对象的外观是人类智能的一个标志。要回答这个问题,人类注释者应该识别对象的类别及其视觉属性(颜色,材料等)。例如,有一个穿着蓝色衬衫和黑色牛仔裤的人。
运动:与静态室内场景不同,室外场景通常是动态的。在我们的注释中,我们关注物体的运动。例如,一只猫快速远离,或者一只狗缓慢接近。
环境:对于户外场景,物体在环境中的相对位置至关重要。因此,我们要求标注者大致将物体与其环境对齐定位。比如,停车场里有一辆车。
关系:人类往往会用“白色卡车旁边的摩托车”或“自我汽车左后部的婴儿车”来描述某个物体。按照[1],我们使用以下合成模板进行关系:
其中目标对象表示要描述的对象,锚对象代表描述目标的锚点。
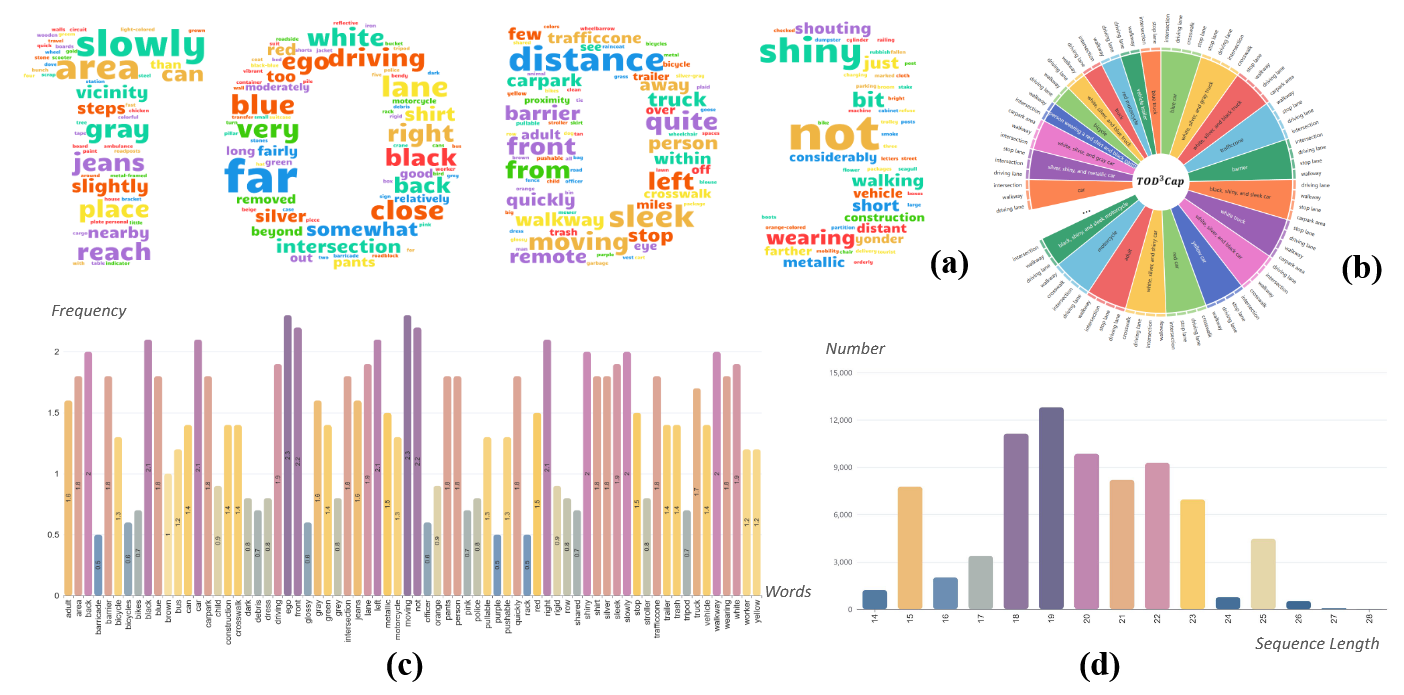
图2:TOD3Cap数据集的统计属性。(a) TOD3Cap 的词云可视化。(b) 物体与环境关系的可视化。(c) 前70个常用词的百分比统计数据。(d) 句子长度分布。
注释与验证。通过多重注释和验证步骤,专家标注员为对象级字幕制作高质量的注释。
值得注意的是,鉴于大型基础模型在语言自动标记领域的显著成功,我们部署了半自动流水线。具体来说,我们首先将预先标记的三维边界框投影到二维上。然后利用二维边界框将相机图像裁剪成主要由一个物体组成的图像补丁,然后作为输入传递给预训练的字幕模型(即LLaMA-Adapter [58]),以生成每个物体的字幕。之后,我们会使用人工标注员对生成句子进行严格的修正和优化。在给说明文的四个部分全部命名后,我们利用GPT-4[38]来总结它们。随后,工作人员会被聘请检查字幕的正确性、流畅性和可读性。只有当三名标注者达成一致后,注释才会被保留。我们在附录中详细说明了注释过程。
3.2 数据统计
我们总共雇佣了十名专业的人工注释员,工作时间约2000小时。语言描述总数约为230万条,平均每帧67.4条,每场景2705.9条描述。我们在图2中展示了数据集的属性。描述涵盖了500多种户外物品,总词汇量约2000个单词。我们发现该物体的外观通常比其他属性更为多样化。外貌、运动、环境和关系词汇的比例为69.7%、2.6%、7.1%和20.6%。此外,我们发现人类用更多词语来描述物体之间的关系。不同词部分的平均词数为3.7、2.0、2.9和11.2。由于我们的字幕非常多样且复杂,成功的密集字幕涉及理解以对象为中心的属性、对象动态、物体间的相互作用以及对象与环境的关系。关于该数据集的更多细节见附录。
4 TOD3Cap网络
为了解决具有挑战性的户外3D密集字幕问题,我们提出了一种新的端到端方法,称为TOD3Cap网络。图3展示了TOD3Cap网络架构的概述。
首先,从3D LiDAR点云和二维多视图图像中提取BEV特征,随后通过查询检测头从BEV特征生成一组3D对象提案(见第4.1节)。其次,为了捕捉对象提案与场景上下文之间的关系,我们使用关系Q-former,使对象与其他对象及周围环境交互,以获得上下文感知特征(见第4.2节)。最后,使用适配器[58],对象提案特征被处理为语言模型生成密集字幕的提示。这种表述不需要对语言模型进行重新训练,因此我们可以利用在大量数据语料库上预训练的大型基础模型的常识(见第4.3节)。
4.1基于BEV的探测器
给定多视角相机图像 和 LiDAR 点云
,我们首先将它们转换为统一的鸟瞰图(BEV)特征
,并生成目标候选框。
对于多视角图像 ,参考文献 [32] 中的方法,采用一个时空 BEV 编码器将图像特征提升到 BEV 空间,并有效融合历史 BEV 特征以建模动态变化。具体而言,我们首先使用图像主干网络从
中提取多视角图像特征。接着,一组针对相机可学习的 BEV 查询
通过空间交叉注意力层 [32] 与这些特征进行交互,以捕捉空间信息,从而得到
:
为了建模时间依赖性并捕获动态特征,如果前一时刻保留的 BEV 特征存在,则 BEV 查询
将首先通过时间自注意力层与 $ F_c^p $ 进行交互,得到更新后的查询
:
对于初始时刻,BEV 查询 会被复制并输入到时间自注意力层中。得到的
随后作为空间交叉注意力层的输入,替代原始的
。
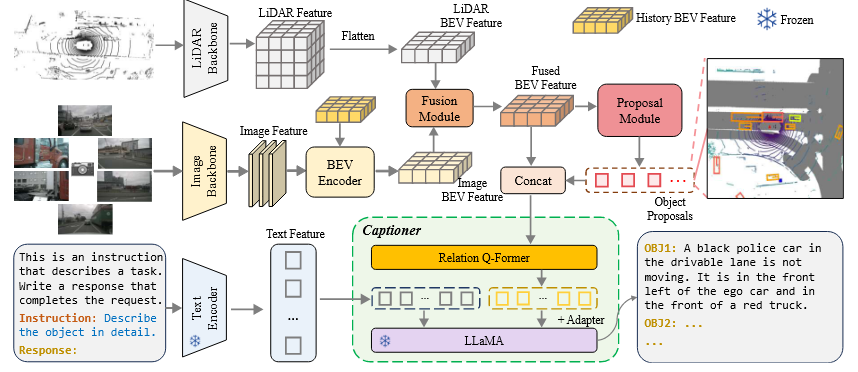
图3:我们拟议的TOD3Cap网络架构。首先,从3D LiDAR点云和二维多视图图像中提取BEV特征,随后通过基于查询的检测头,从BEV特征生成一组三维对象提案。其次,为了捕捉关系信息,我们使用关系QFormer,使对象与其他对象及周围环境交互,以获得上下文感知特征。最后,使用适配器,特征被处理为提示,语言模型生成密集字幕。该表述不需要对语言模型进行重新训练过程。
对于 LiDAR 输入 ,首先使用 LiDAR 主干网络提取体素化的 LiDAR 特征。然后,将这些特征在高度维度上进行展平,得到 BEV 特征
。最后,通过一个卷积融合模块将两种不同模态的 BEV 特征融合在一起,获得统一的 BEV 特征
。
随后,我们采用一种基于查询的目标候选框生成模块,以 BEV 特征 作为输入,生成目标框候选
,其中
是预设的目标查询数量,
对应候选框特征的维度。该候选框生成过程与传统检测头(如 DETR [5])中的方法一致。
4.2 Relation Q-Former
在获得 BEV 特征 和目标候选框
之后,设计了一个关系查询变换器(Relation Q-Former),用于为每个目标提取具有上下文感知能力的特征。具体而言,我们首先使用一个可学习的多层感知机(MLP)对目标候选框
进行编码,生成目标查询,从而得到与
具有相同特征维度的目标特征。这些特征随后被拼接并输入到 Relation Q-Former 中,该模块包含多个自注意力层,用于实现特征之间的交互。如后文所示,该模块显著提升了模型性能。
生成的目标查询 将作为文本生成解码器的输入,用于自然语言描述的生成,相关内容将在下一节中详细阐述。
4.3 字幕解码器
受大型语言模型(LLMs)在上下文推理方面最新进展的启发,我们采用一个固定的(frozen)语言模型作为语言生成器,它以目标查询 为输入,并为每个目标输出描述性文本。为了确保
与语言模型隐藏层之间的维度一致性,我们首先使用一个多层感知机(MLP)将
的维度进行转换,得到
。此外,我们进一步引入一个适配器(Adapter)[58],用于将目标候选框的表示对齐到预训练语言模型的特征空间中,从而弥合模态间的差异。经过适配的目标特征被用作提示(prompt)
,供语言模型生成对应的文本描述。
其中 是系统文本提示(如图3左下角所示),而
是生成的文本描述,包含
个词。
在训练过程中,我们采用标准的交叉熵损失作为文本生成损失 ,并以“教师强制”(teacher-forcing)方式训练模型:
其中 是真实标签文本,
表示语言模型的参数,
是预测的概率分布。需要注意的是,
在训练过程中保持冻结,以降低计算成本并缓解语言模型可能出现的灾难性遗忘问题。
此外,考虑到在训练过程中一次性将数百个目标查询送入文本生成解码器会带来较大的内存负担和优化难度,我们并未直接全部输入。相反,我们使用一个三维匈牙利分配器 [53] 对查询进行筛选,仅保留与真实标签匹配的查询,然后在训练时从中随机采样一部分进行学习。在推理阶段,我们应用非极大值抑制(NMS)来抑制重叠的目标候选框。
更多推荐



 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)