
数据仓库理论及代码详细总结
声明:
本文为借鉴科大讯飞产教融合部在课上总结的知识
借鉴了黑马程序员Hive课程:
黑马程序员Hive全套教程,大数据Hive3.x数仓开发精讲到企业级实战应用_哔哩哔哩_bilibili
为个人学习数据仓库Hive过程中的知识笔记
内容详细,适合初学者从0开始深入学习,其中有自己理解的部分和便于理解通俗表达方式。
目录
数仓概念
概念:
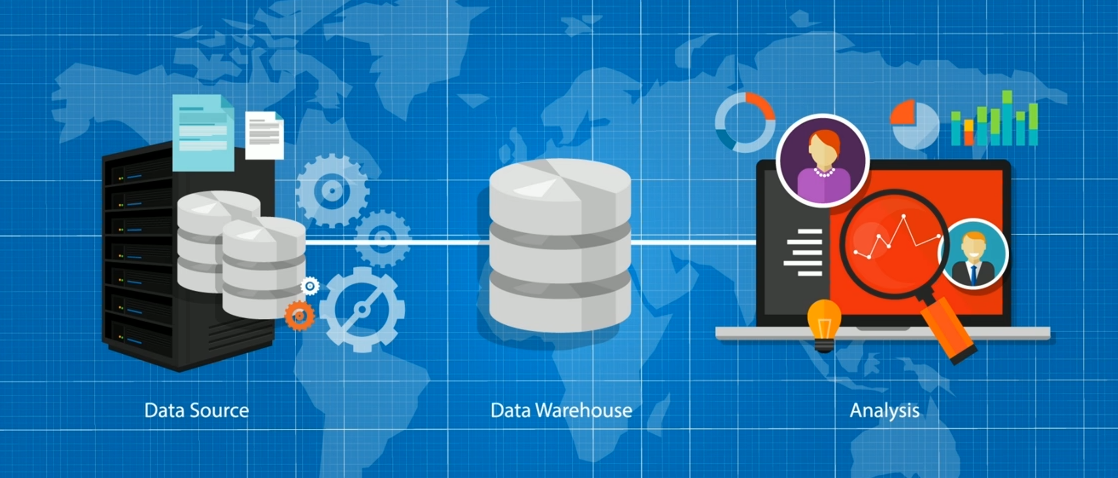
数据仓库(Data Warehouse 简称数仓、DW),是一个用于存储、分析、报告的数据系统。
数据仓库的目的是构建面向分析的集成化数据环境,分析结果为企业提供决策支持。
特点:
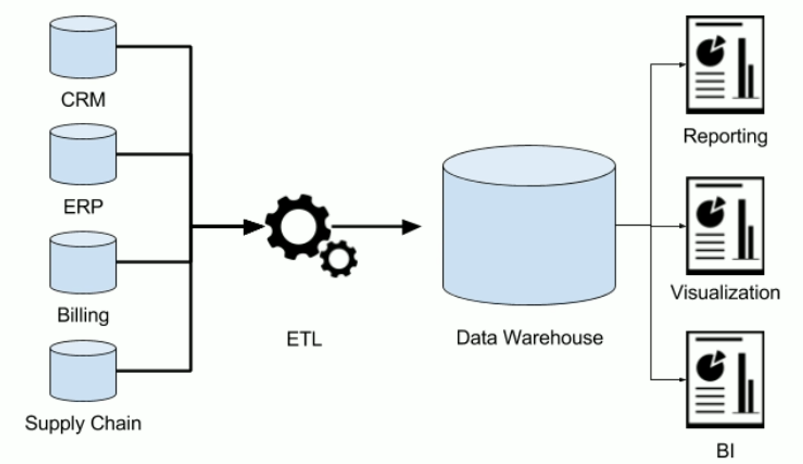
数据仓库本身并不"生产"任何数据,其数据来源于不同的外部系统;
同时数据仓库自身也不需要消费任何的数据,其结果开放给各个外部应用使用;
这也是为什么叫"仓库",而不叫"工厂"的原因。
场景互动:数仓为何而来
先下结论:为了分析数据而来,分析结果给企业决策提供支撑。
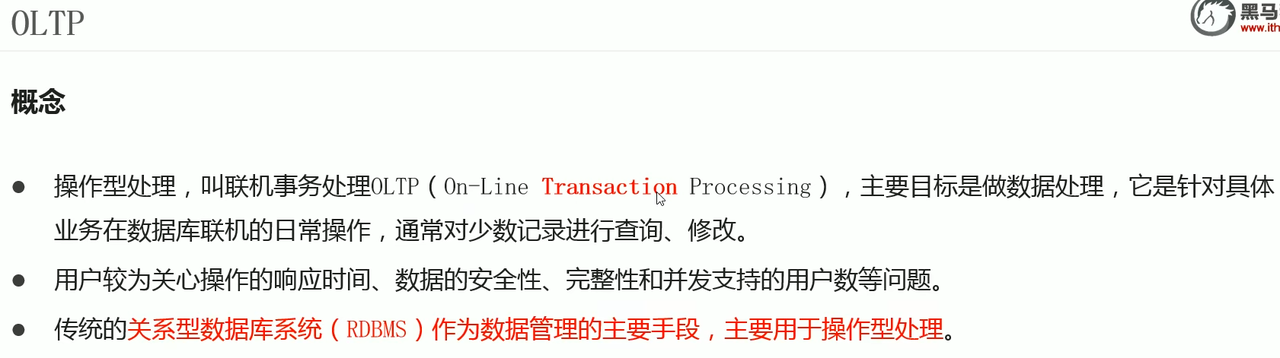
联机事务处理系统(OLTP)正好可以满足操作性记录保存业务需求的开展,其主要任务是执行联机事务处理。其基本特征是前台接收的用户数据可以立即传送到后台进行处理,并在很短的时间内给出处理结果。
关系型数据库(RDBMS)就是OLTP的典型应用,比如:Oracle,MySQL等
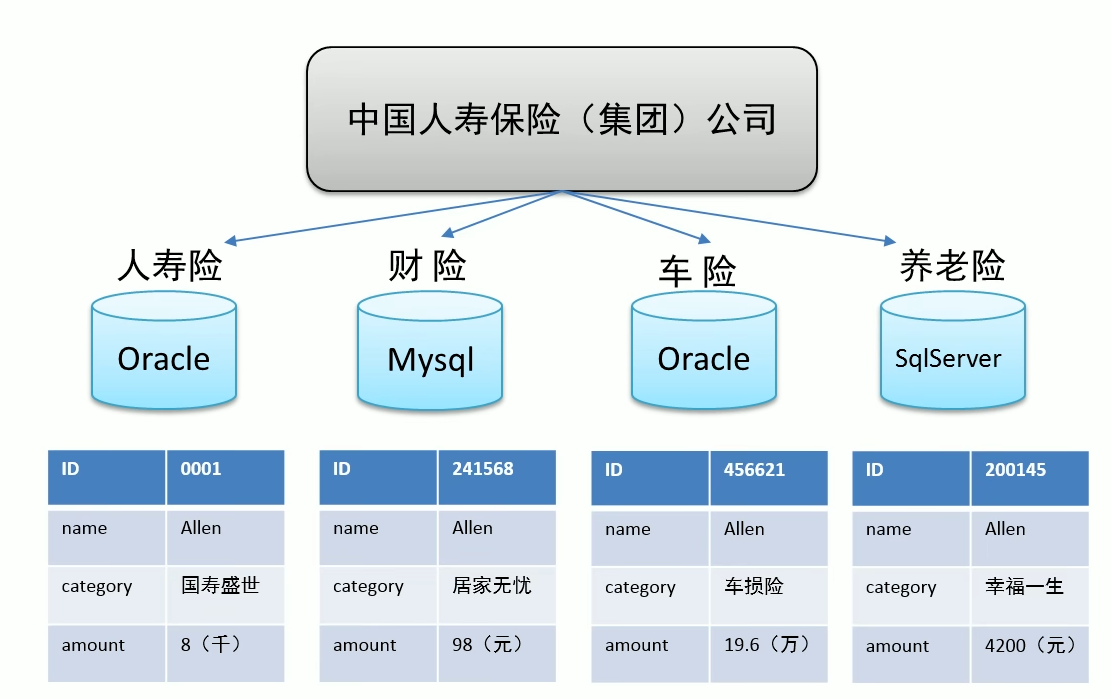
企业中做决策要基于业务数据开展分析,基于分析结果给决策提供支撑
但是不适合在OLTP环境开展分析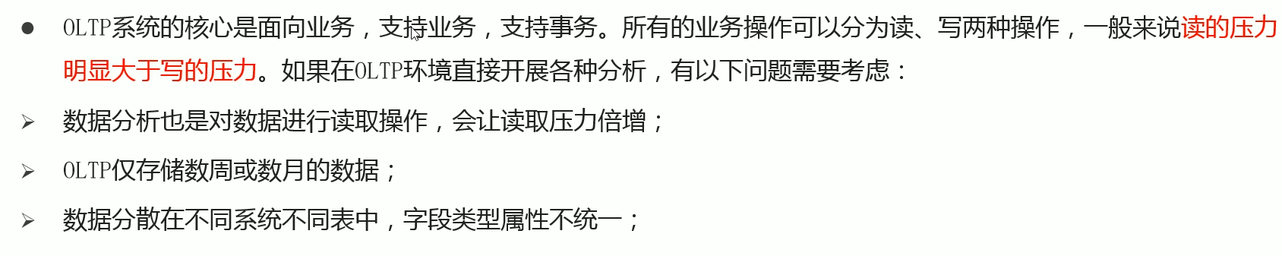
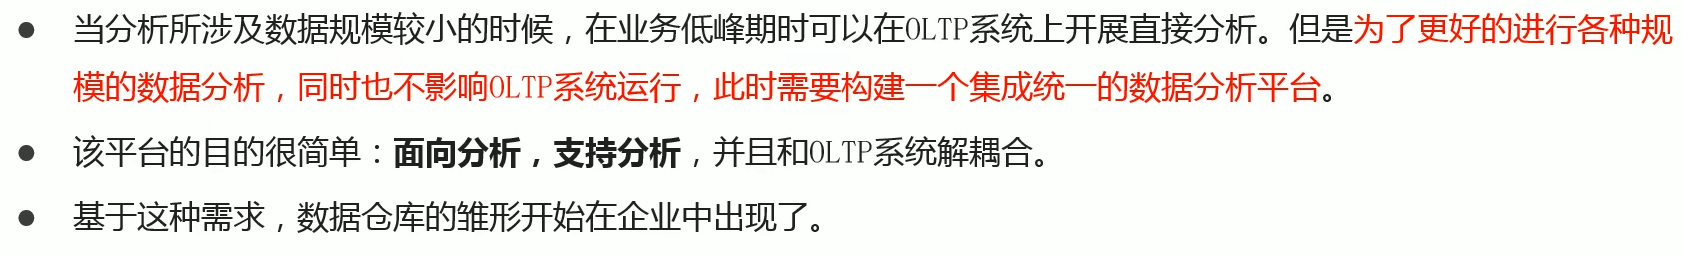
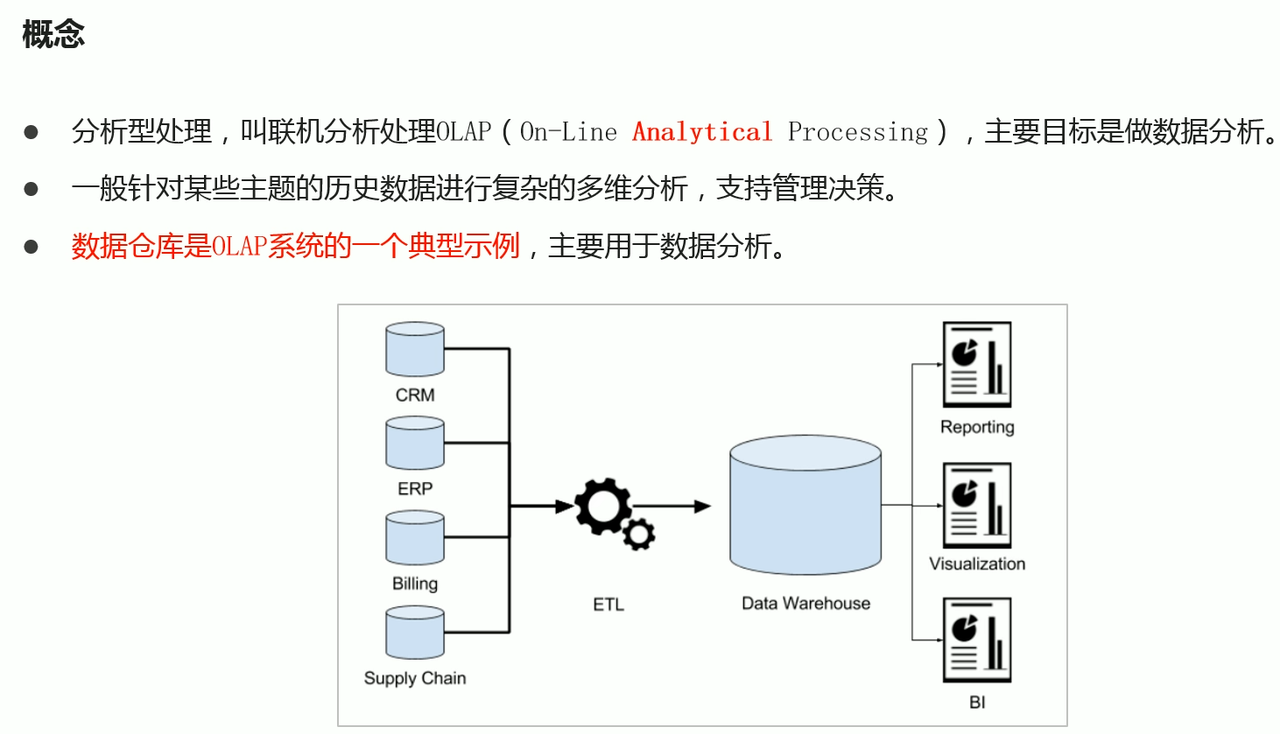
如数仓定义所说,数仓是一个用于存储、分析、报告的数据系统,目的是面向分析的集成化数据环境。我们把这种面向分析、支持分析的系统称之为OLAP(联机分析处理)系统。数据仓库是OLAP一种。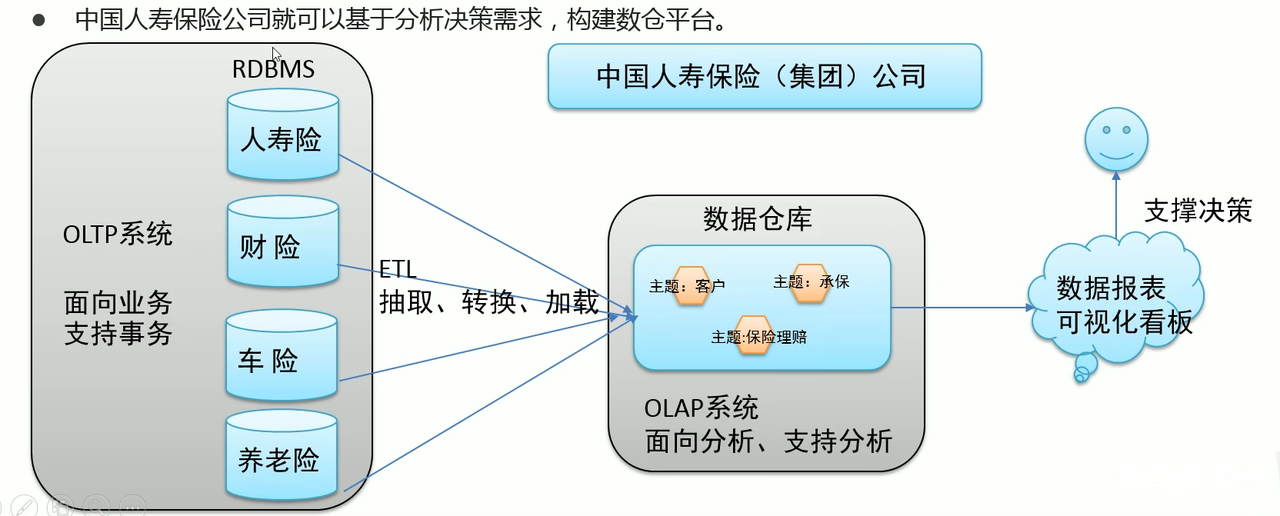
数仓主要特征
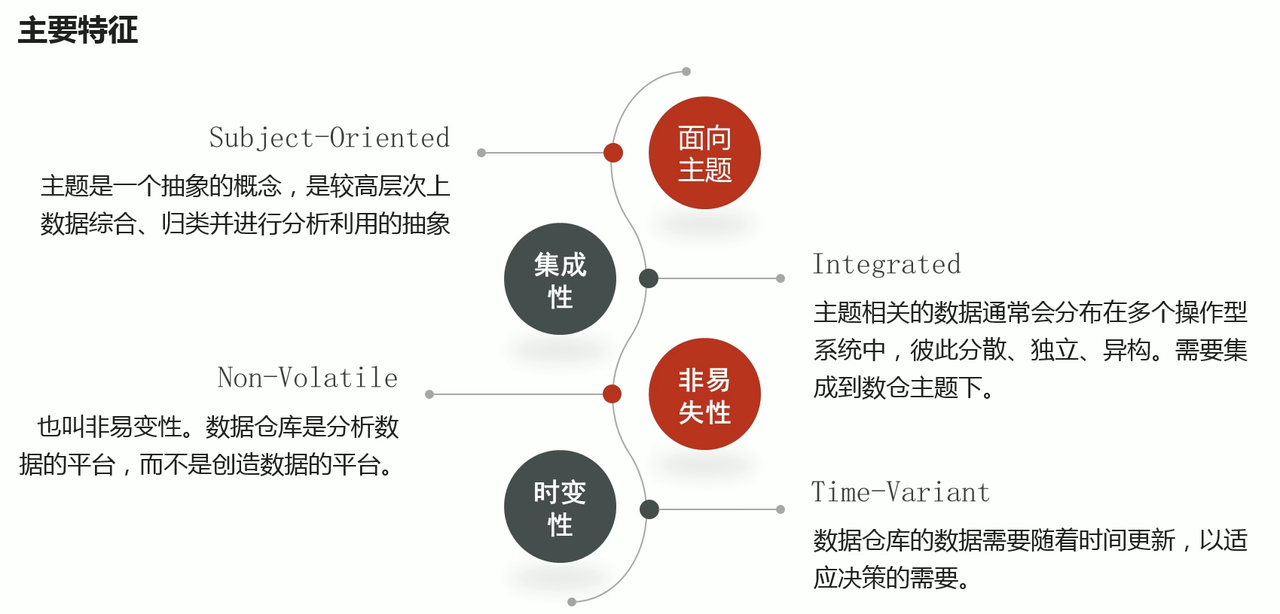
面向主题性:
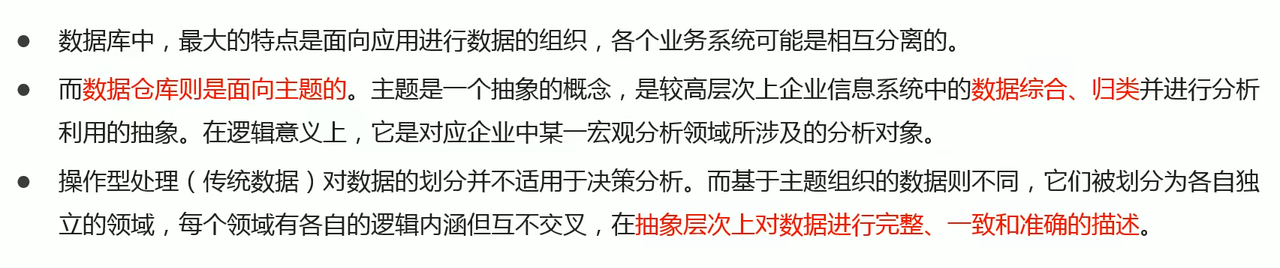
比如在保险公司要分析客户,那么客户就是一个主题(把抽象的概念具象化)
集成性:
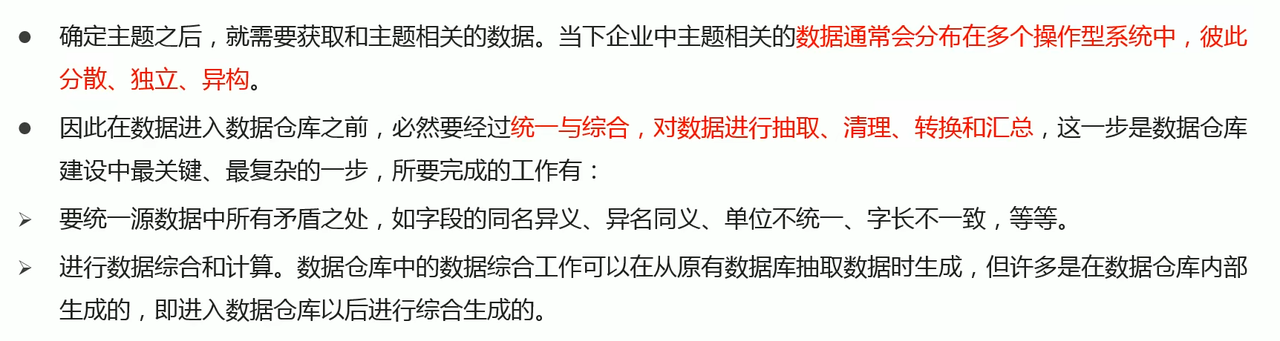
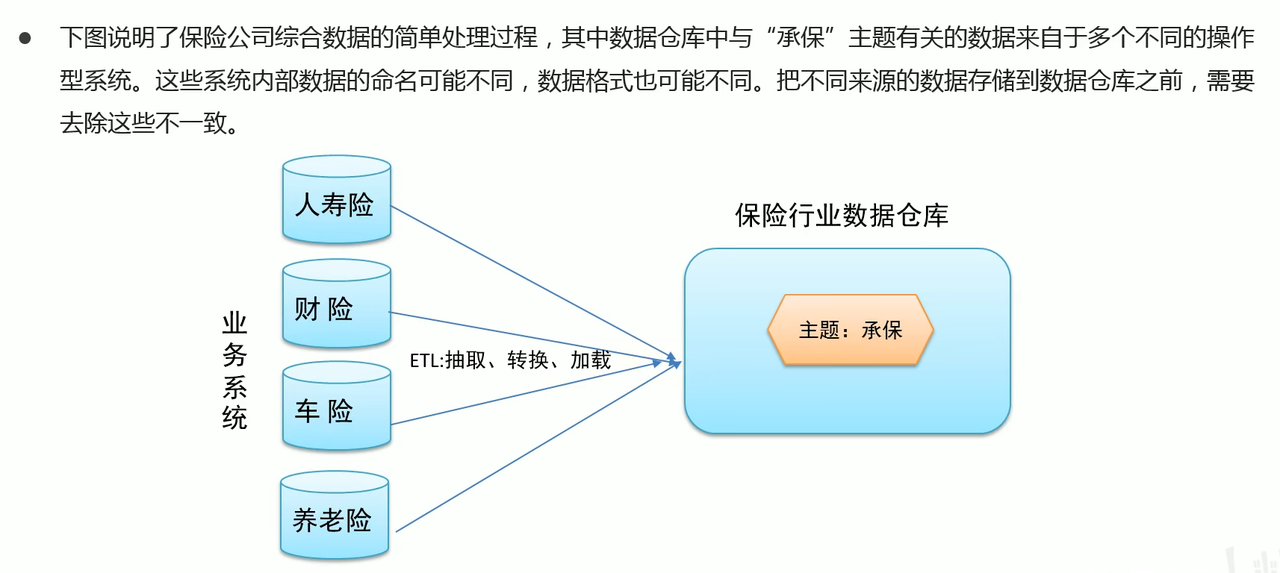
要考虑与这个主题相关的数据之间差异性(如字段或者单位等)统一化处理
非易失性、非异变性:
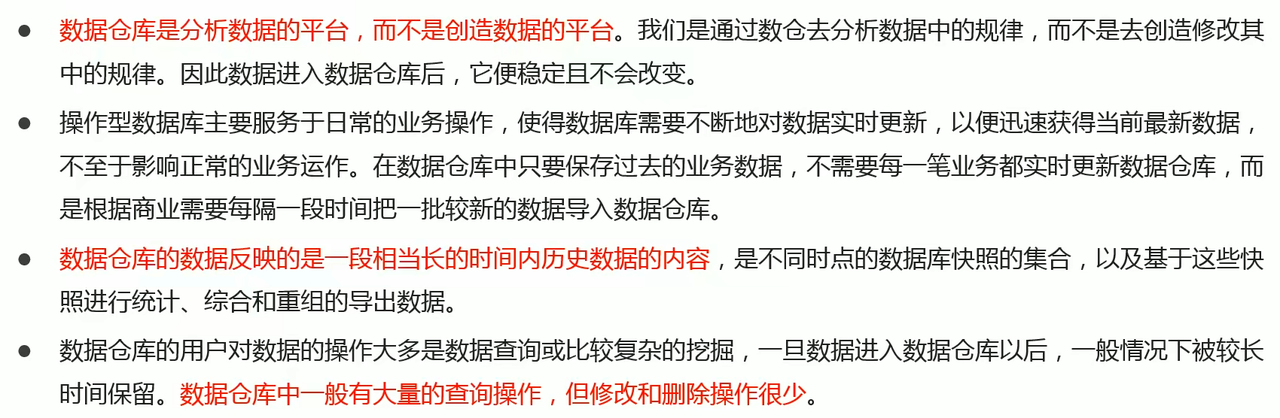
时变性:
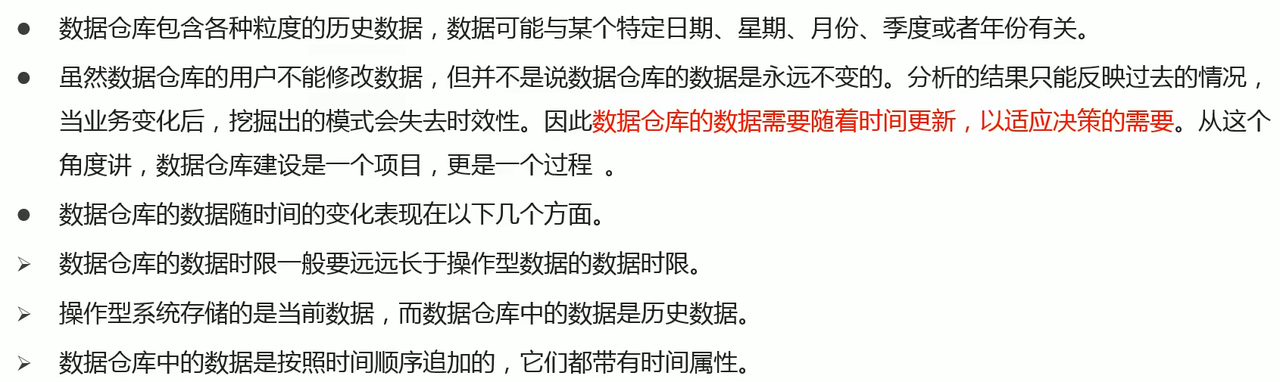
OLTP、OLAP系统
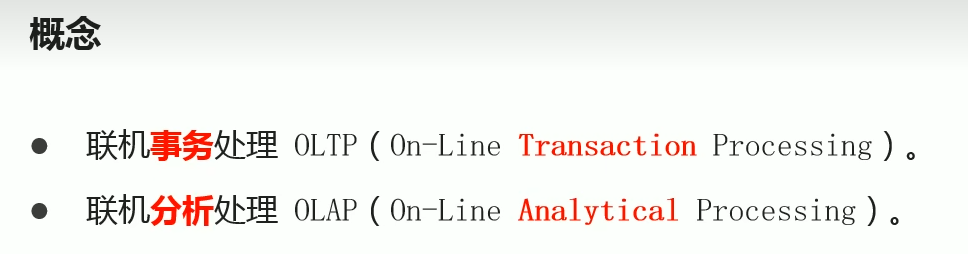
OLTP:
OLAP:
OLAP的三种类型
关系OLAP
ROLAP将分析用的多维数据存储在关系数据库中并根据应用的需要有选择的定义一批视图作为表也存储在关系数据库中
ROLAP适用于数据量较大,查询复杂度低的场景,如大规模数据分析和决策支持系统。
多维OLAP
MOLAP将OLAP分析所用到的多维数据物理上存储为多维数组的形式,形成"立方体"的结构。它使用预计算和压缩技术,将数据存储在专门设计的多维数据库中,以提供快速的查询和分析性能。
混合OLAP
HOLAP就是把MOLAP和ROLAP两种结构的优点结合起来。
对比:
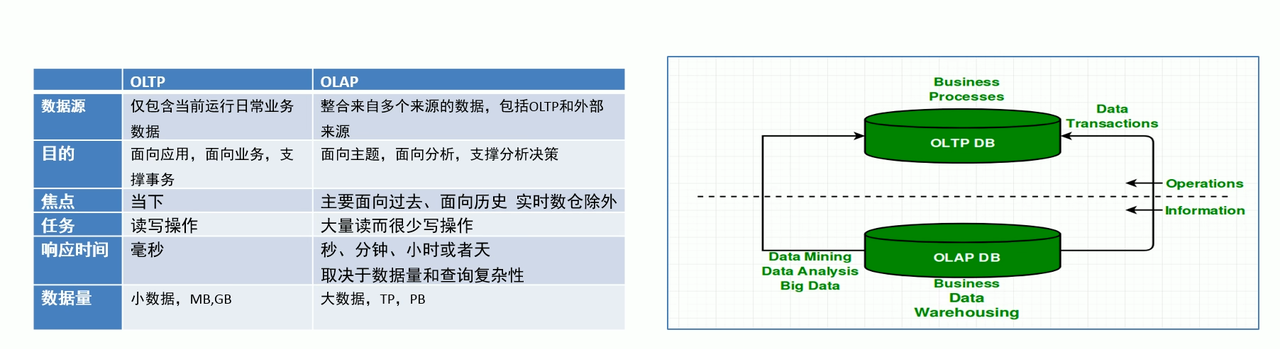
简单来说,比如用户在平台上下单,相关的订单数据就保存在关系型数据库中(OLTP),支持对数据的CRUD操作;而OLAP系统是对已有的数据进行分析,基本不会做修改操作。
数据仓库、数据库的区别
区别:
数据仓库不是大型的数据库,虽然数据仓库存储数据规模大。
数据仓库的出现,并不是要取代数据库。
数据库是面向事务的设计,而数据仓库是面向主题设计的。
数据库一般存储业务数据,数据仓库一般存储的是历史数据。
数据库是为了捕获数据设计,数据仓库是为了分析数据而设计。
注:这里所说的数据库指关系型数据库,Nosql数据库不在讨论范围内。
数据仓库、数据集市区别
数据仓库(Data Warehouse)是面向整个集团组织的数据,数据集市(Data Mart)是面向单个部门使用的。
可以认为数据集市是数据仓库的子集,也有人把数据集市叫做小型的数据仓库。数据集市通常只涉及一个主题领域,这样数据量小,且数据更加具体,更加专业,通常更易于管理和维护,并具有灵活的结构。
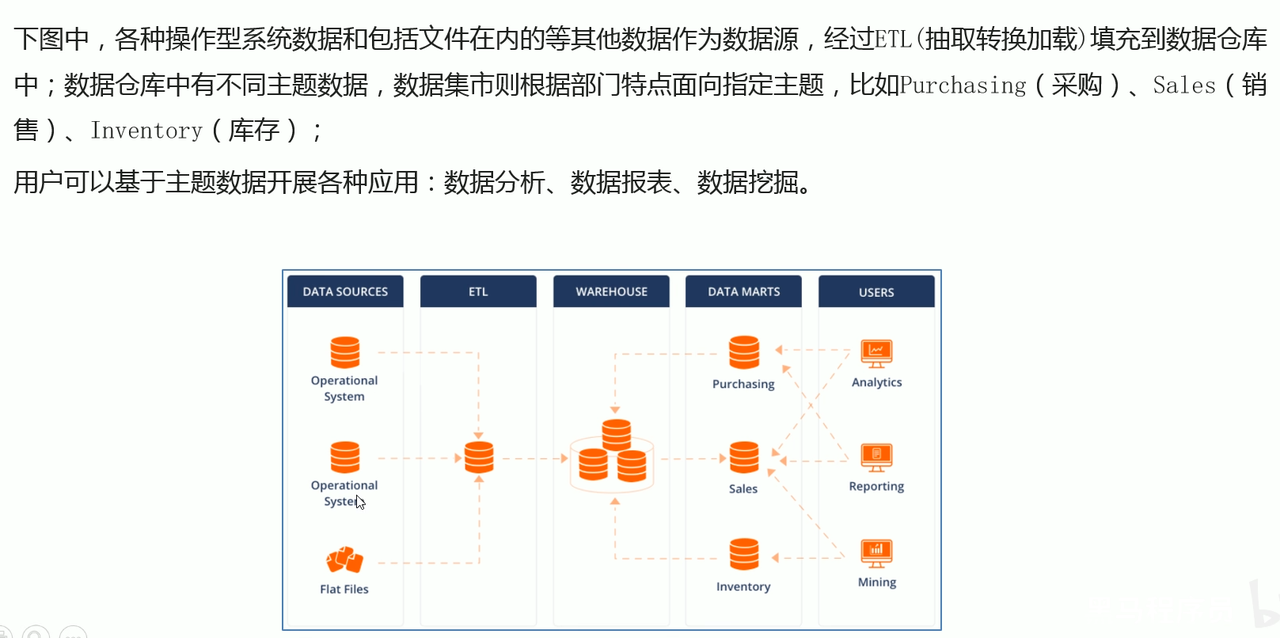
不同的集市进行不同方向不同操作的分析、如果有业务上的交流也可以采纳别的集市的数据,更利于数据的分析。
数仓分层思想与架构(ODS、DW、DA)
数据仓库最基础的分层思想理论上分为三个层:操作型数据库(ODS)、数据仓库层(DW)和数据应用层(DA)。
企业在实际运用中可以在这个基础上添加新的层次,来满足不同的业务需求。
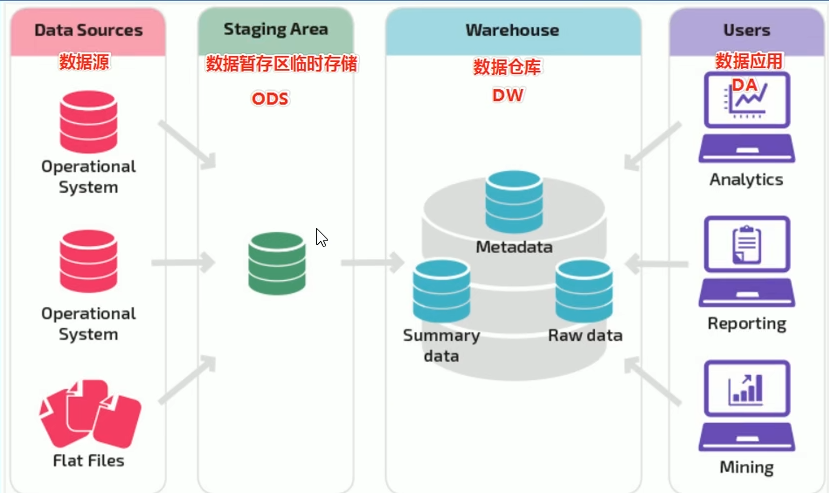
阿里巴巴数仓3层架构
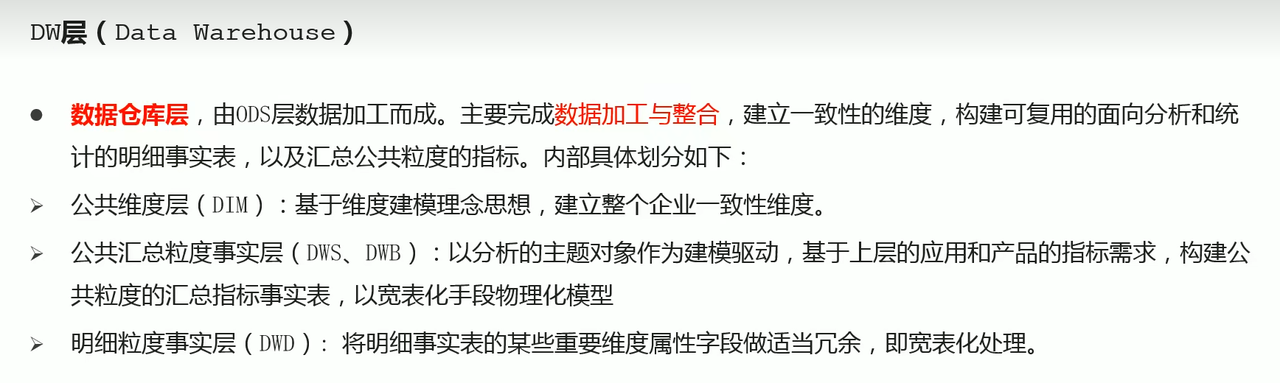
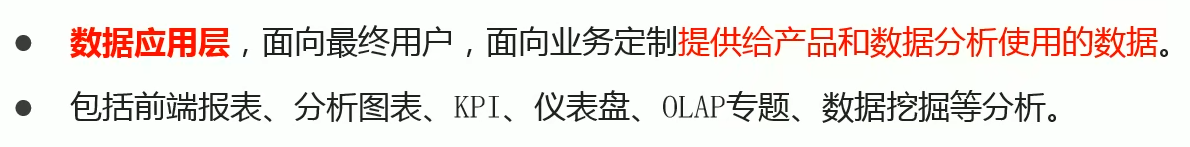
阿里数仓是非常经典的三层架构,从下往上依次是:ODS、DW、DA。
通过元数据管理和数据质量监控来把控整个数仓中数据的流转过程、血缘依赖关系和生命周期。
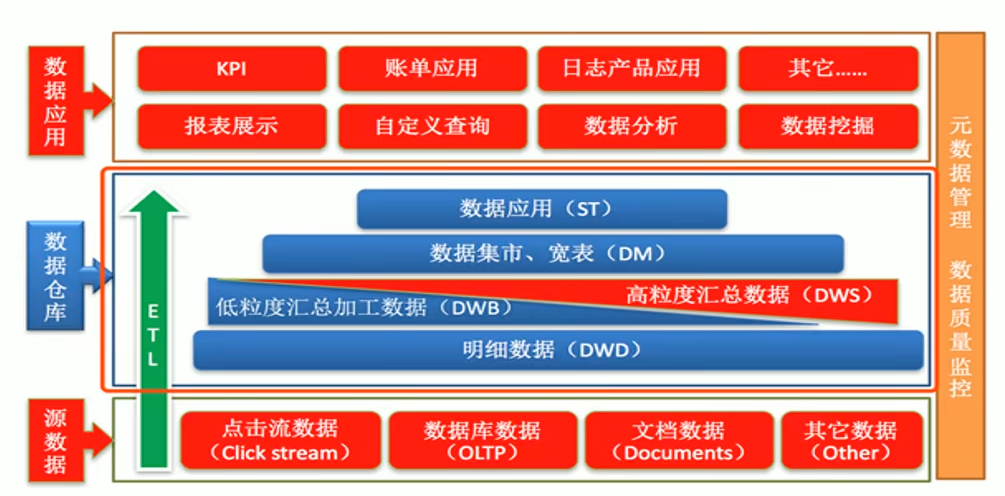
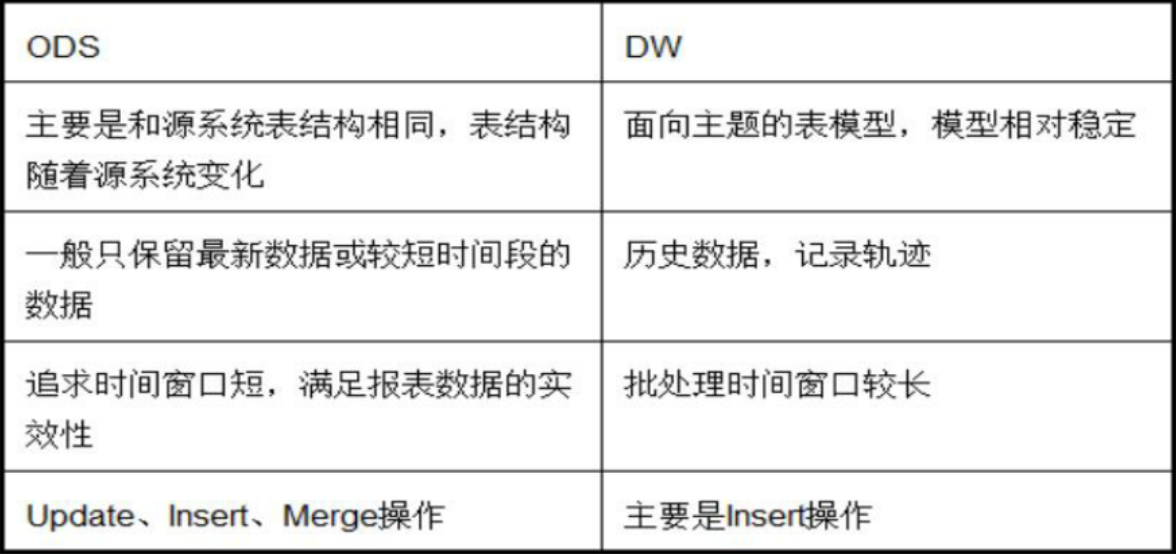
ODS层: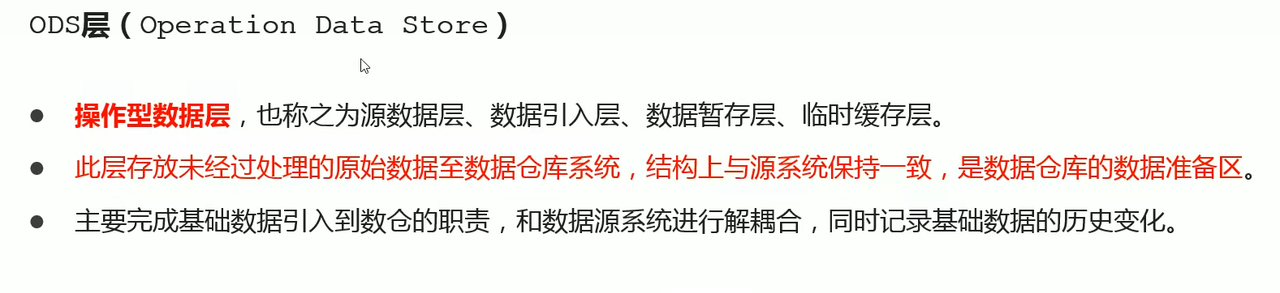
DW层:
DA层:
数据仓库分层的好处:
清晰数据结构
每一个数据分层都有它的作用域,在使用表的时候能更方便地定位和理解。
数据血缘追踪
简单来说,我们最终给业务呈现的是一个能直接使用的业务表,但它的来源有很多,如果有一张表出问题了,我们希望能快速地定位到问题,并清除它的危害范围。
减少重复开发
规范数据分层,开发一些通用的中间层数据,能够减少极大的重复计算。
把复杂问题简单化
将一个复杂的任务分解成多个步骤来完成,每一层只处理单一的数据,比较简单和容易理解。而且便于维护数据的准确性,当数据出现问题之后,可以不用修复所有的数据,只需要从有问题的步骤开始修复。
屏蔽原始数据的异常
屏蔽业务的影响,不必改一次业务就重新接入数据。(例:这个月的某条指标单位为千,下个月该指标的单位变成了万,在使用数仓分层的情况下,DA应用层不必关心原始数据的这种变化,因为DW层做了统一化处理,因此只要把数仓维护好,业务怎么变都不影响操作)
ODS与DW的区别
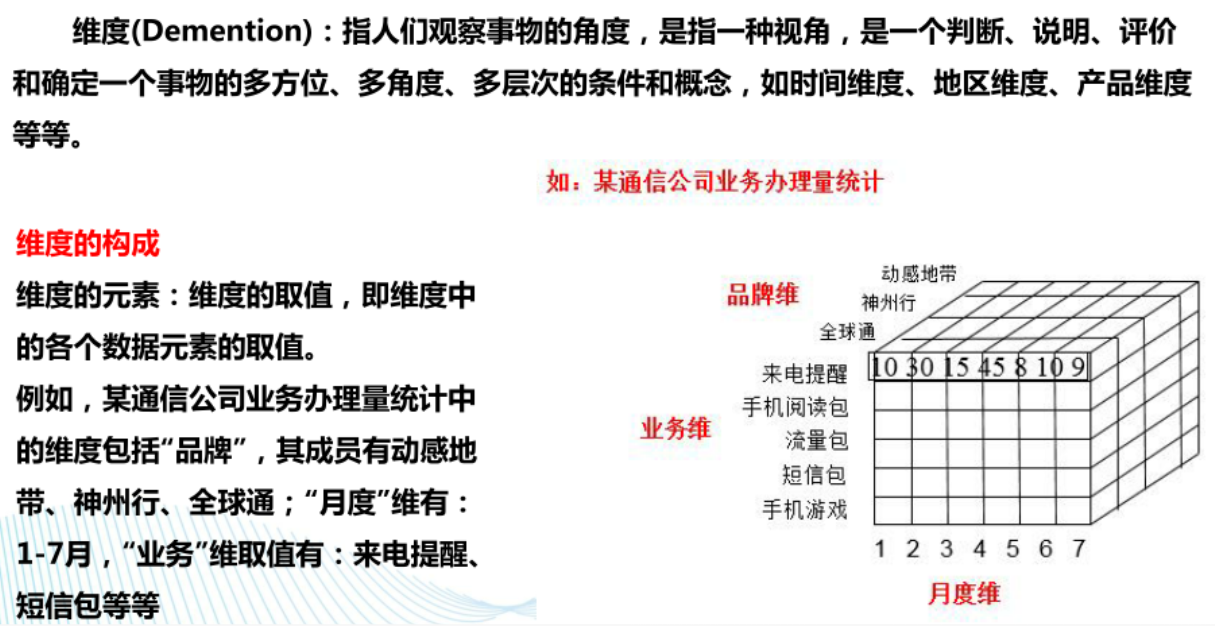
维度与粒度
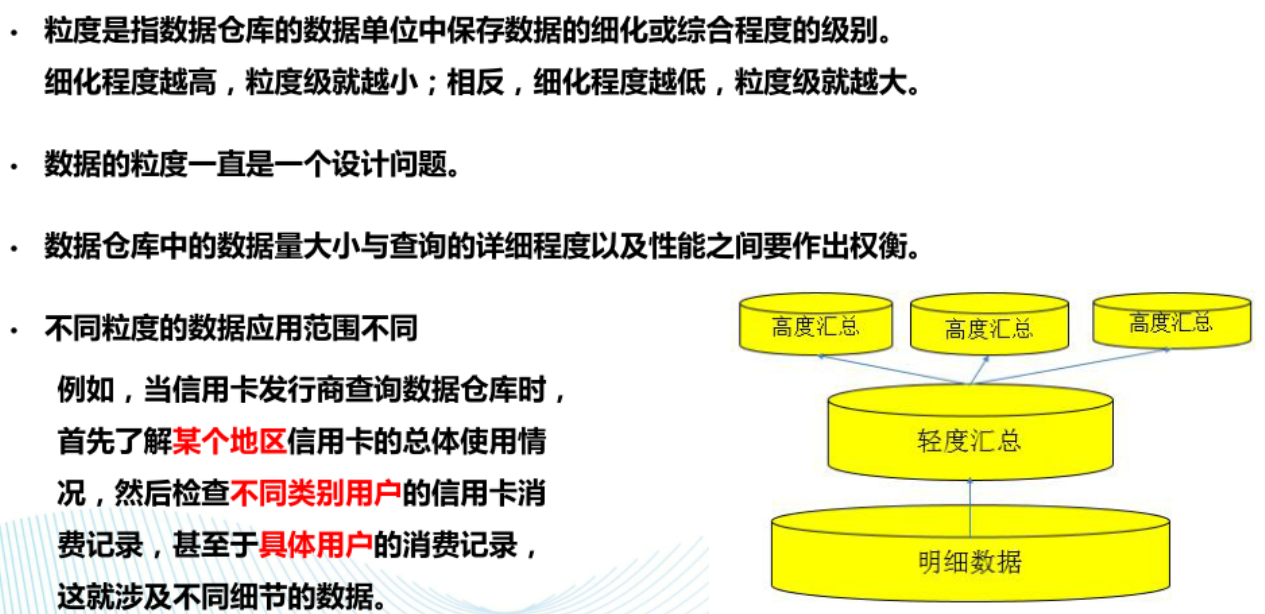
多维度模型
多维度模型是为了满足用户从多角度多层次进行数据查询和分析的需要而建立起来的给予事实和维度的数据库模型,其基本的应用是为了实现OLAP。
多维度模型把数据看做是数据立方体形式。
多维数据模型围绕中心主题(事实表)组织。
多维数据模型的存在形式:
A、星型模型
B、雪花模型
C、事实星座
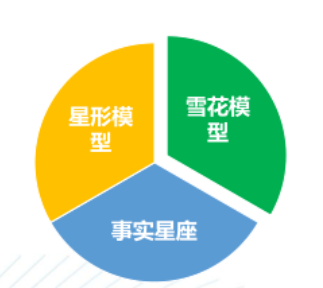
多维度模型多用于数据集市。
星型模型:
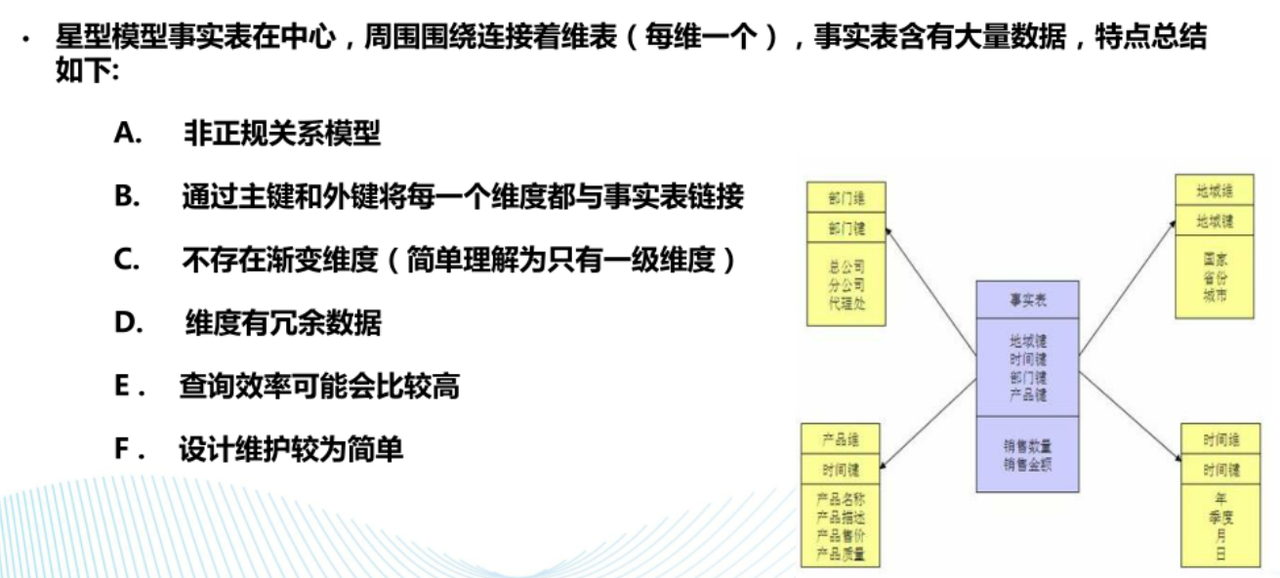
雪花模型:
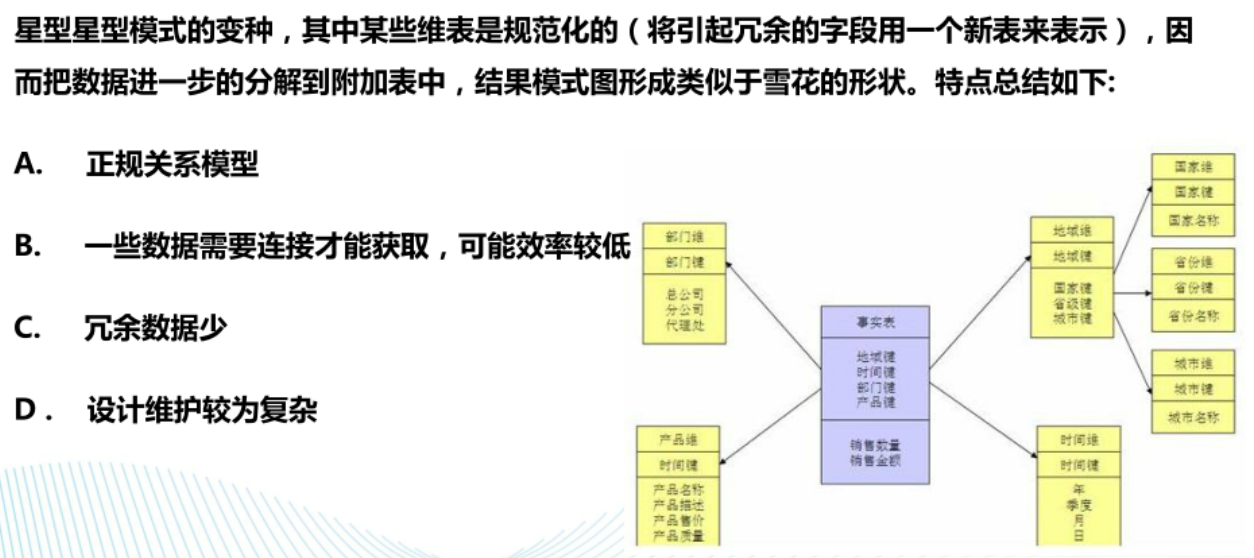
数据仓库建模基础
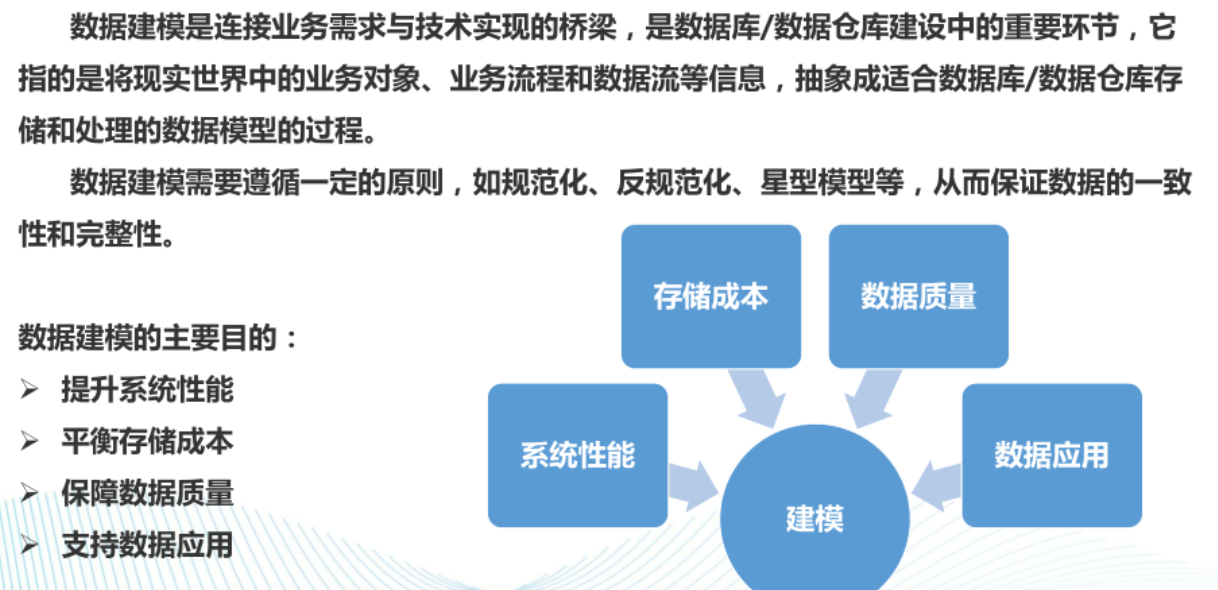
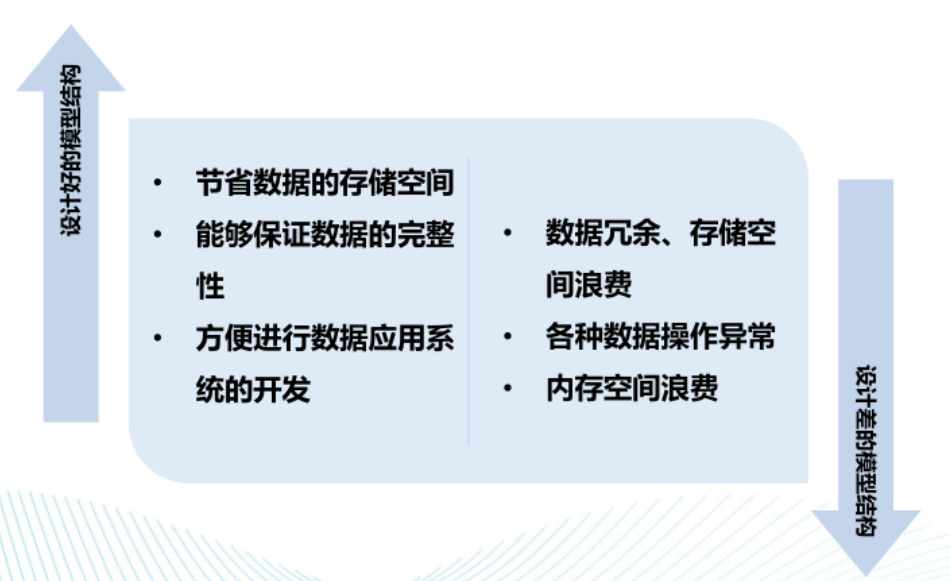
建模概述:
为什么要建模?
数据建模方法
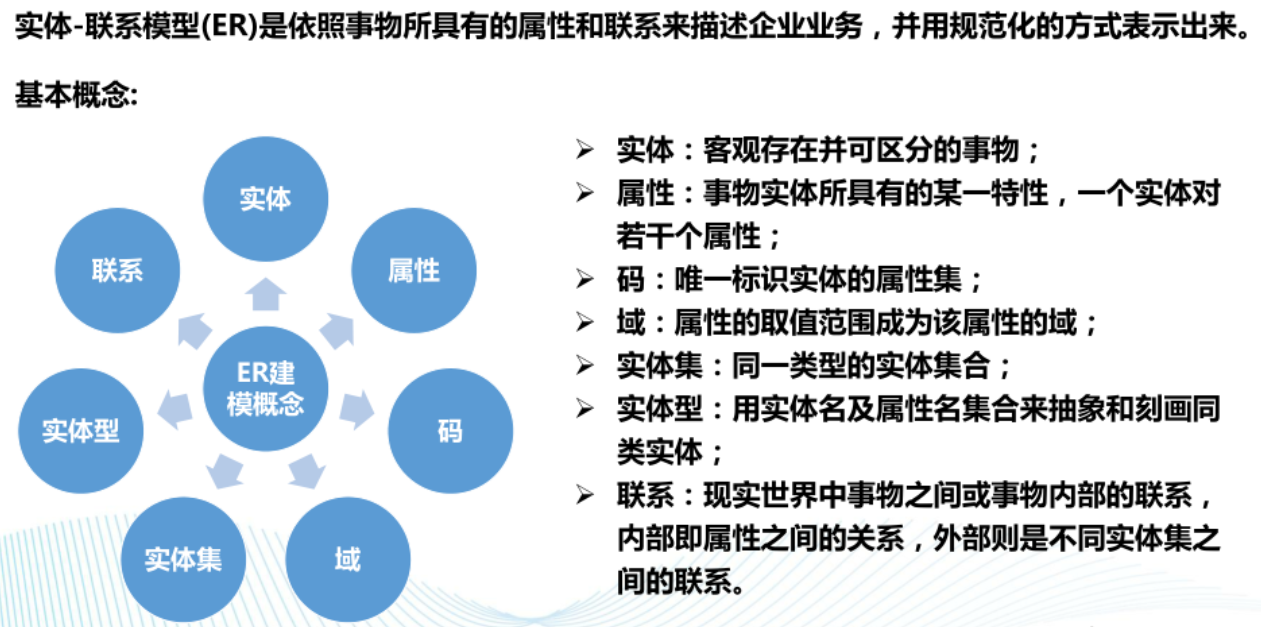
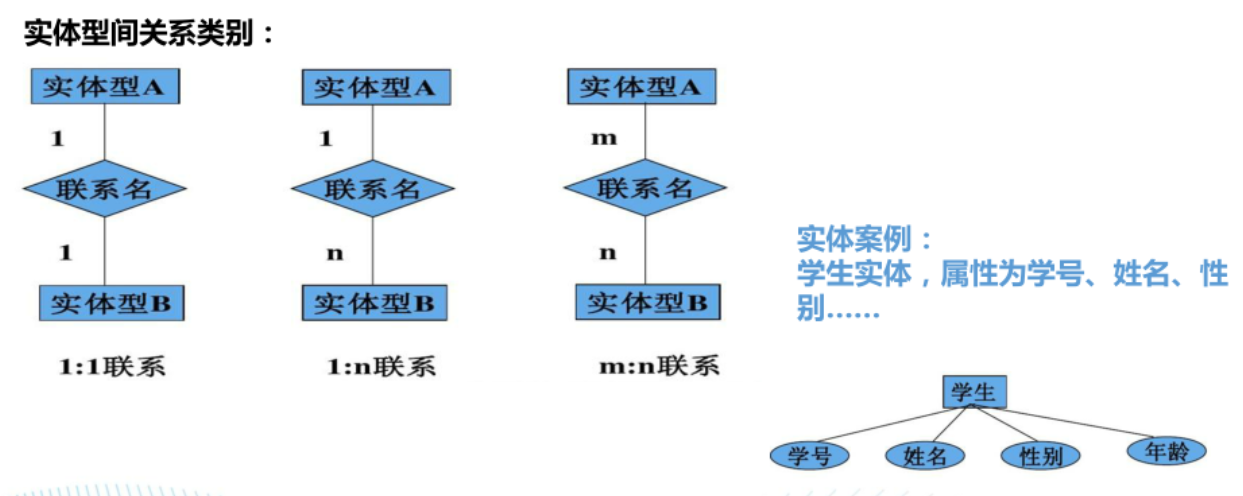
ER(Entity Relationship)建模
基本概念:
ER建模方法:
ER建模步骤: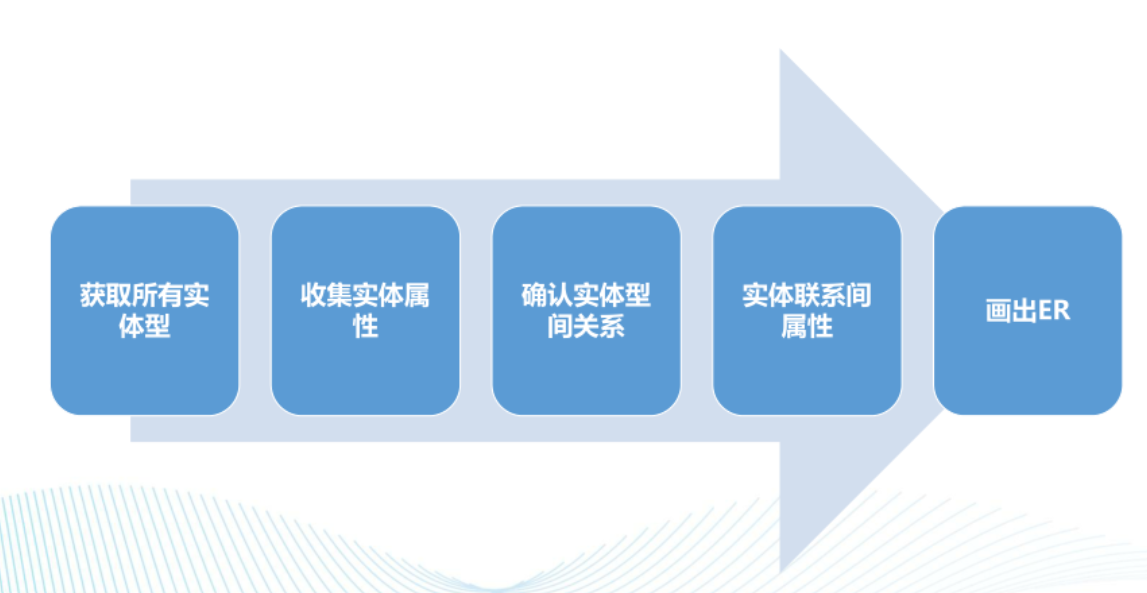
ER建模案例: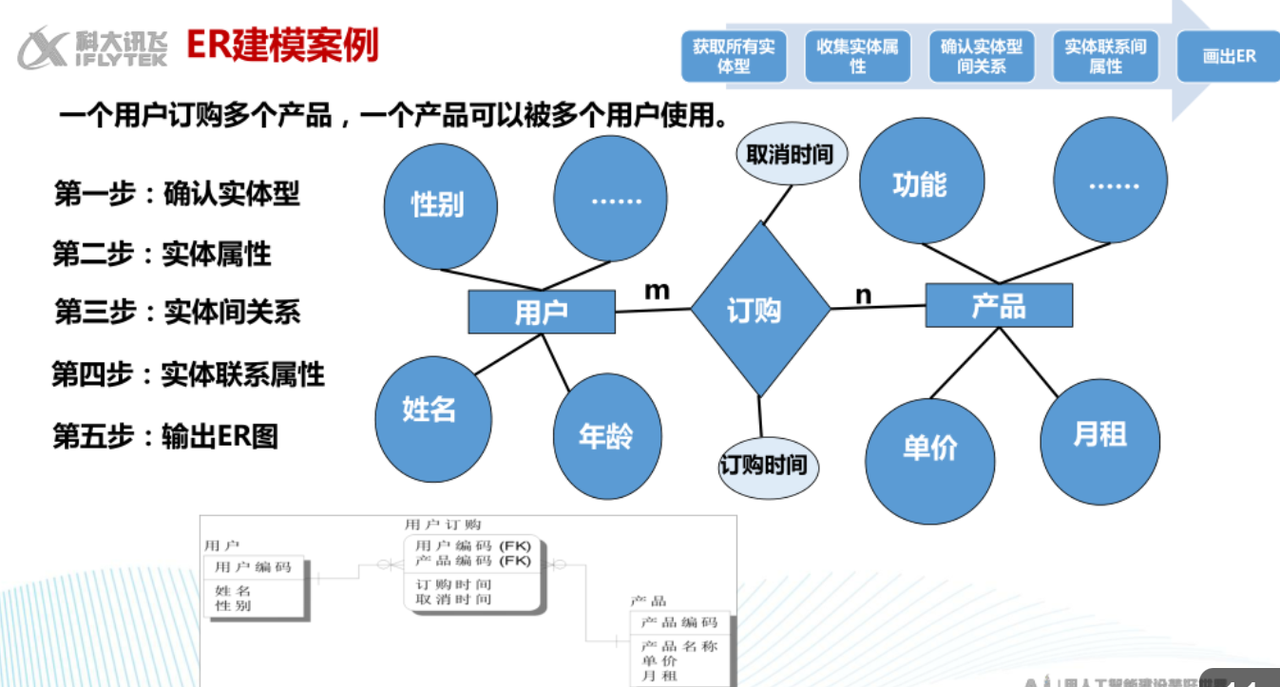
思考:
校园图书馆借阅系统中,基于读者借阅图书场景,绘制ER图。
维度建模
背景:
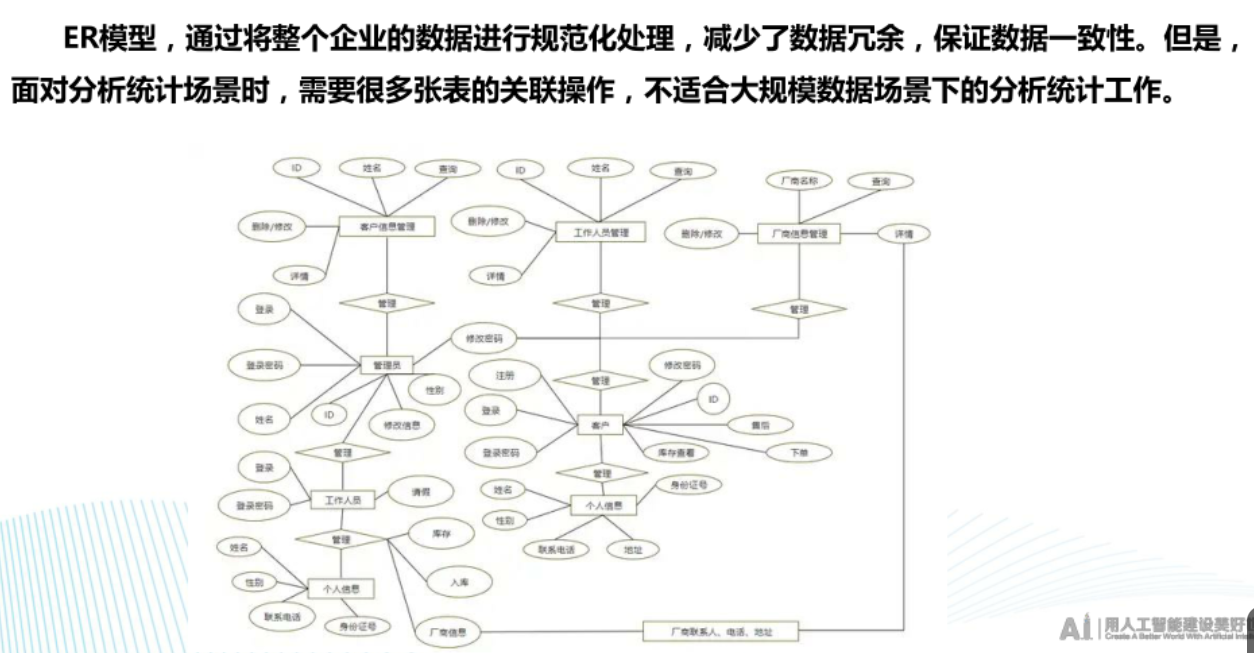
概念:
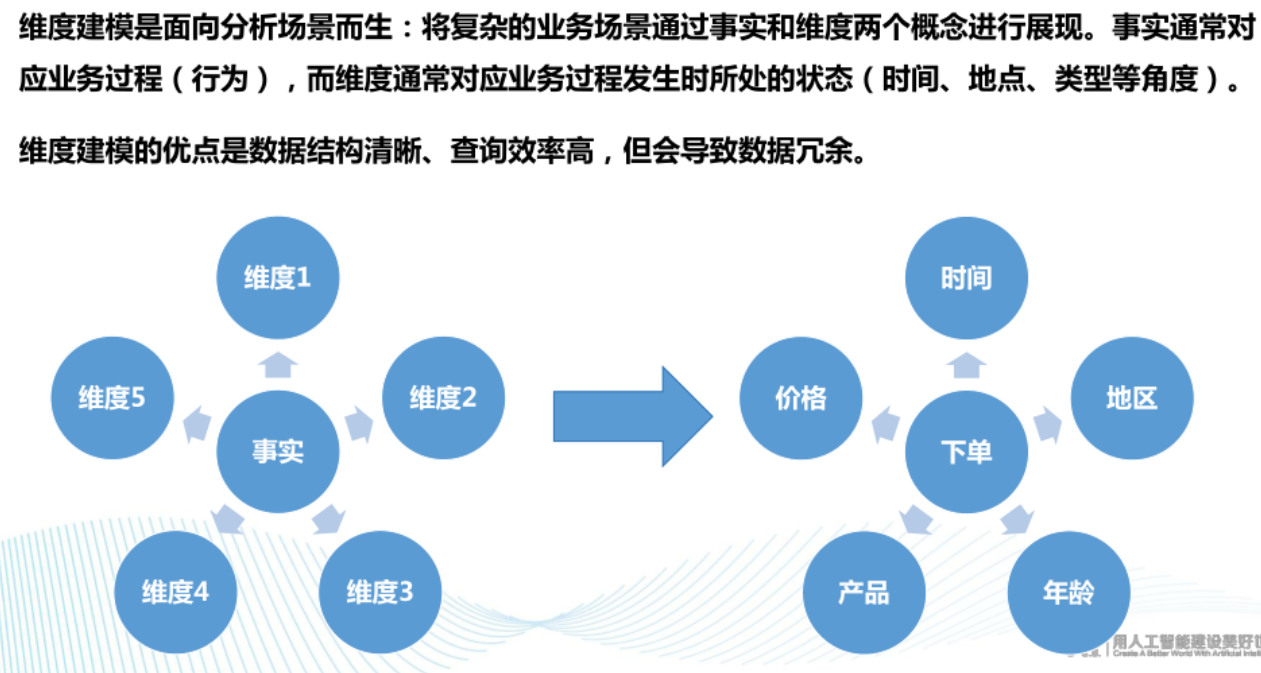
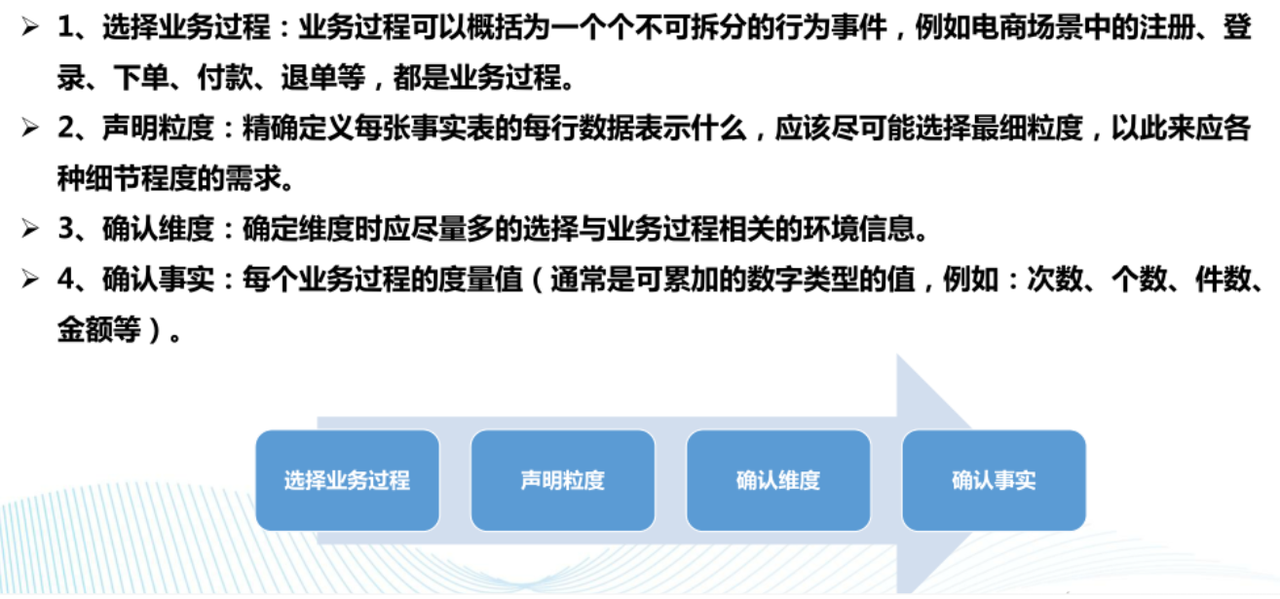
设计流程:
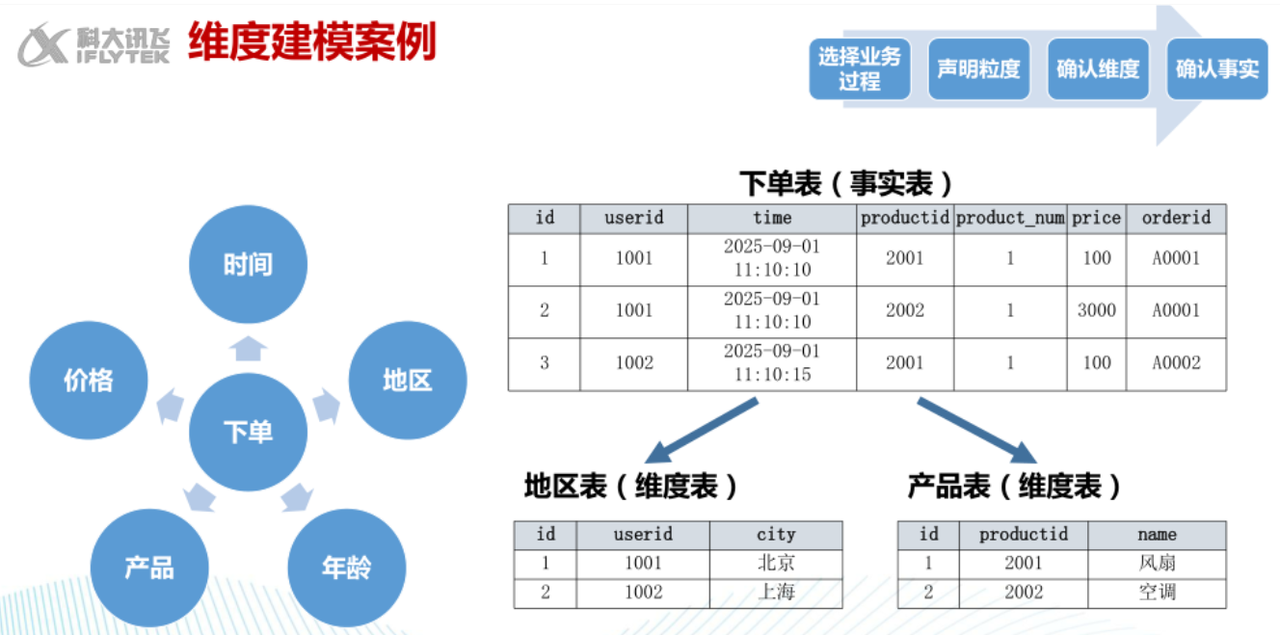
维度建模案例:
思考:
根据旅游平台中,游客下单消费场景,思考怎么进行维度建模?
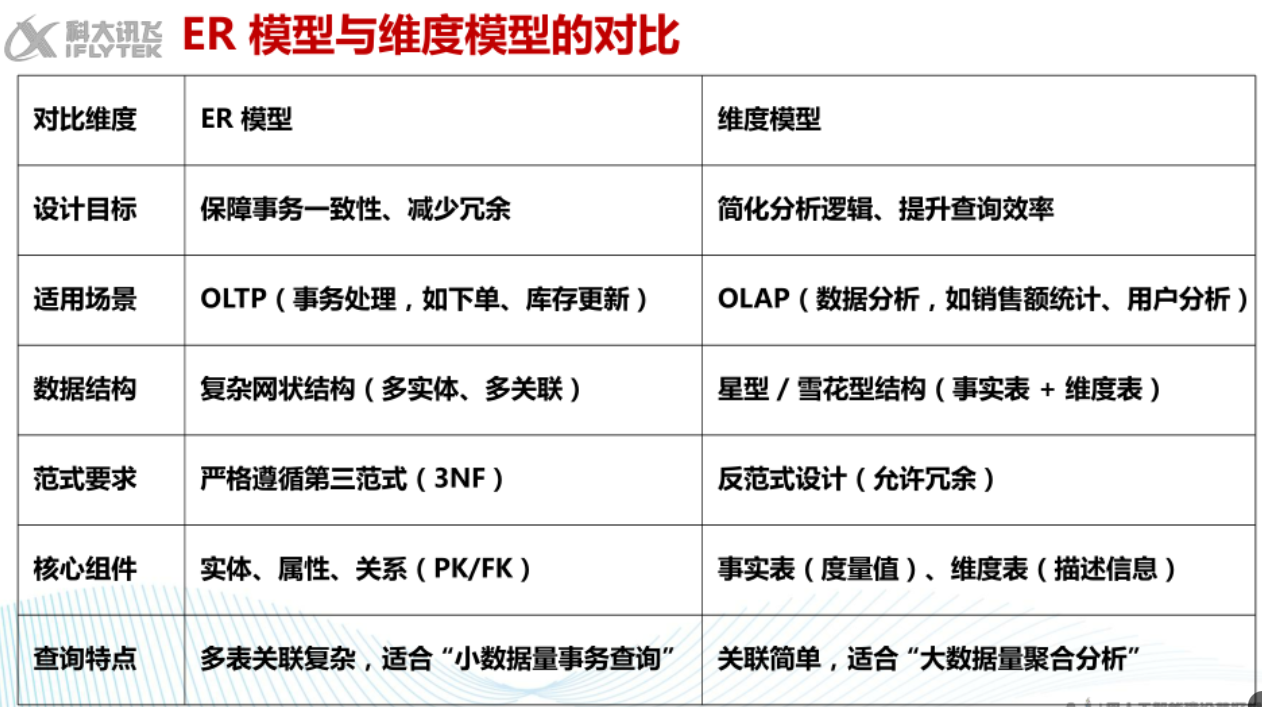
概念设计、逻辑设计与物理设计
数据库建模过程
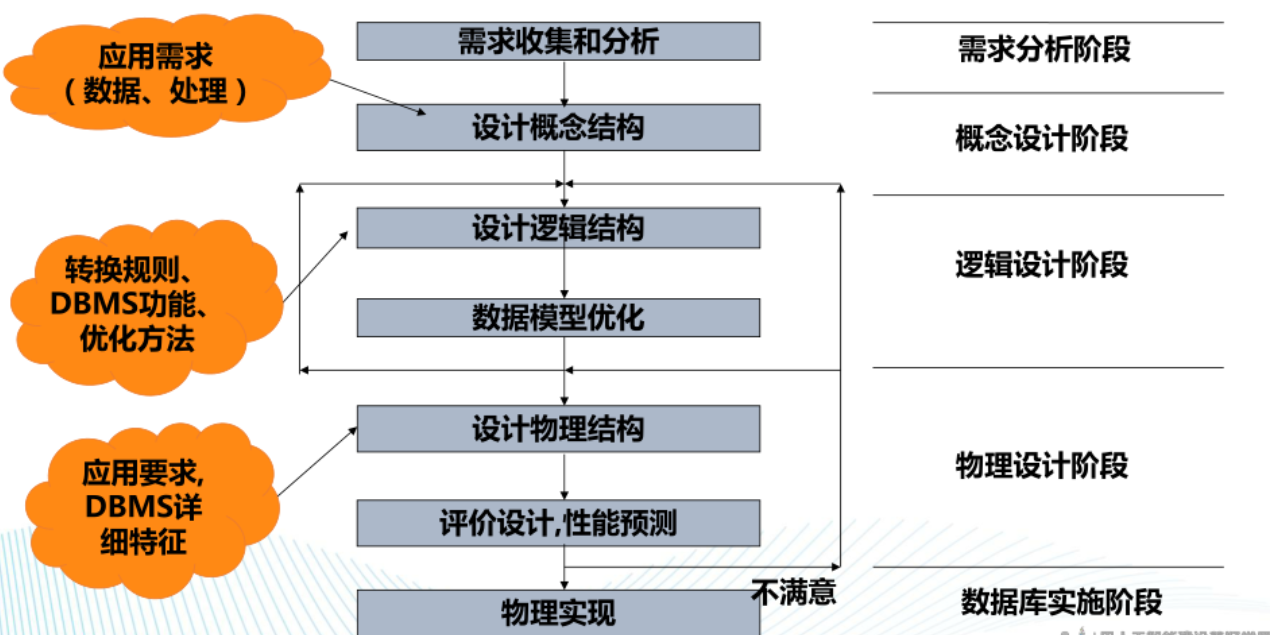
数据库建模过程解决的问题
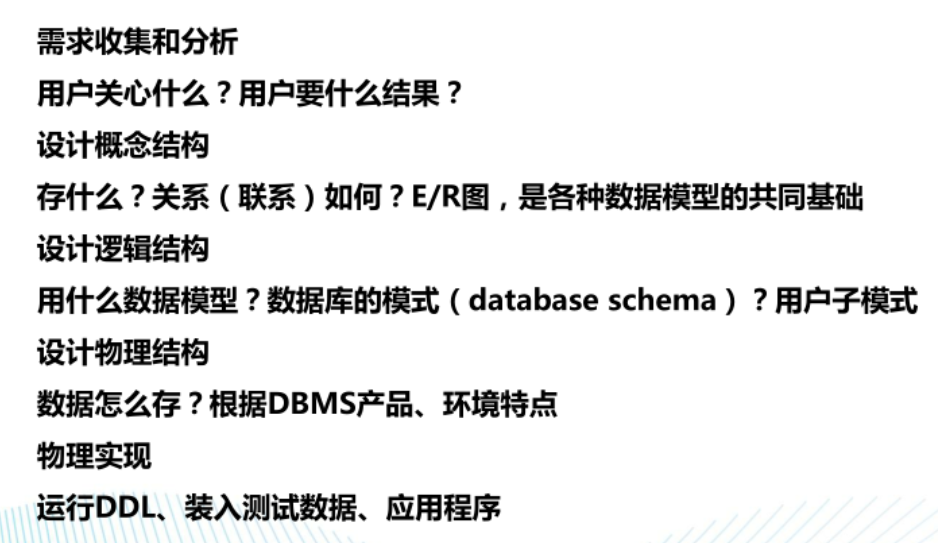
数据库建模总图
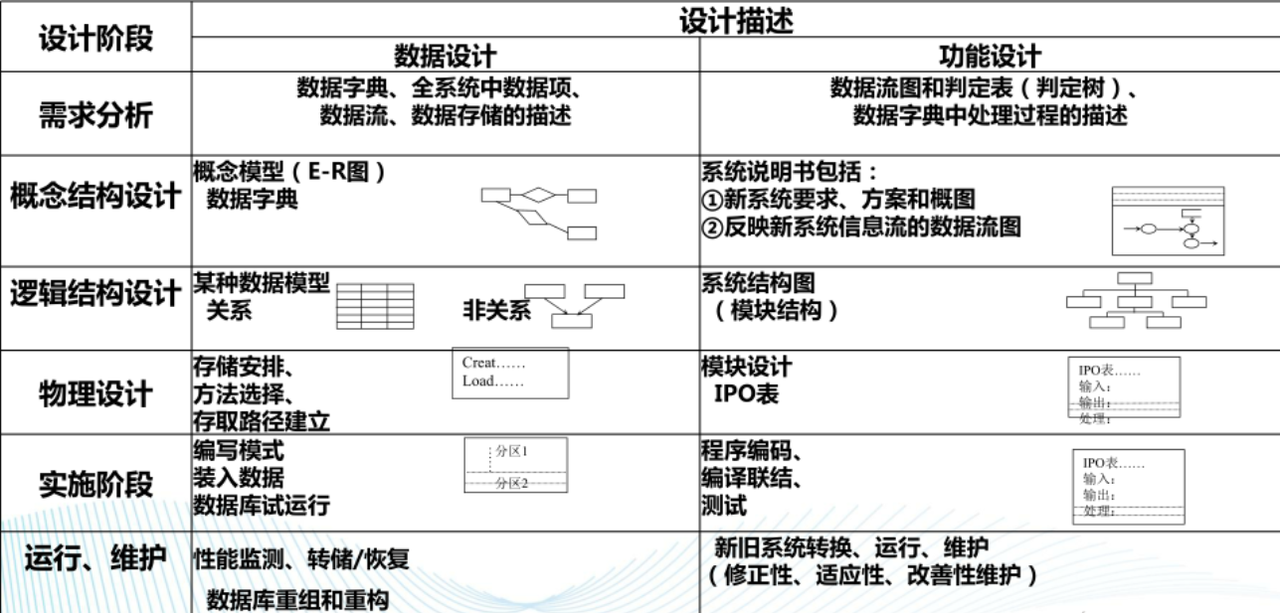
概念结构设计
概念结构设计就是讲需求分析得到的用户抽象为信息结构即概念模型的过程。是对现实世界的一种抽象,抽取人们关心的共同特性,忽略非本质的细节,并把这些特性用各种概念精确的加以描述。
概念结构的主要特点:
(1)反映现实世界,包括实体与实体之间的联系。
(2)易于理解,便于使用者参与。
(3)易于调整修改。
(4)易于向关系、网状、层次等各种数据模型转换。
设计概念结构通常有四类方法:
(1)自顶向下
(2)自底向上
(3)逐步扩张
(4)混合策略
一般采用自顶向下进行需求分析,然后再自底向上的设计概念结构。
无论采用哪种设计方法,一般采用E-R模型为工具描述概念结构。
概念结构设计基本概念:
实体关系模型:数据库设计过程,表示DB的整个逻辑结构。
实体:实体可以是具体的(一个人或一本书),也可以是抽象的(如一个节日或一个概念)
属性:实体是由一组属性来表示的。例如:Person(个人)实体的属性有Name(名称)、Age(年龄)、Street(街道)、City(城市)
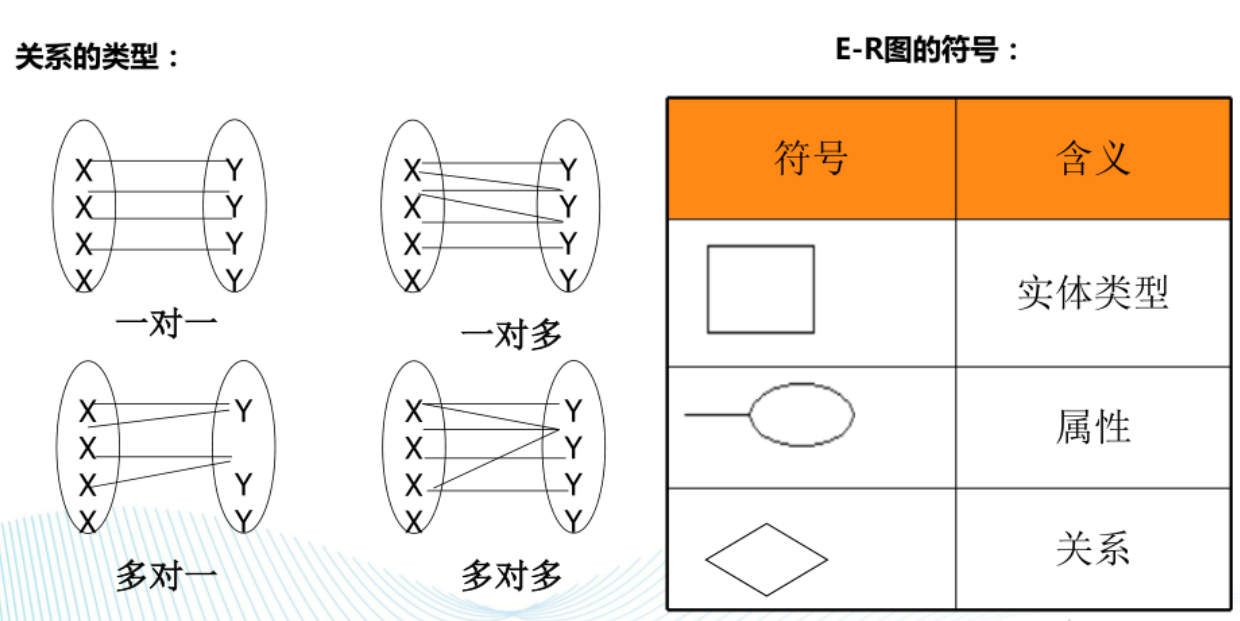
关系:两个或多个实体之间的联系
抽象:
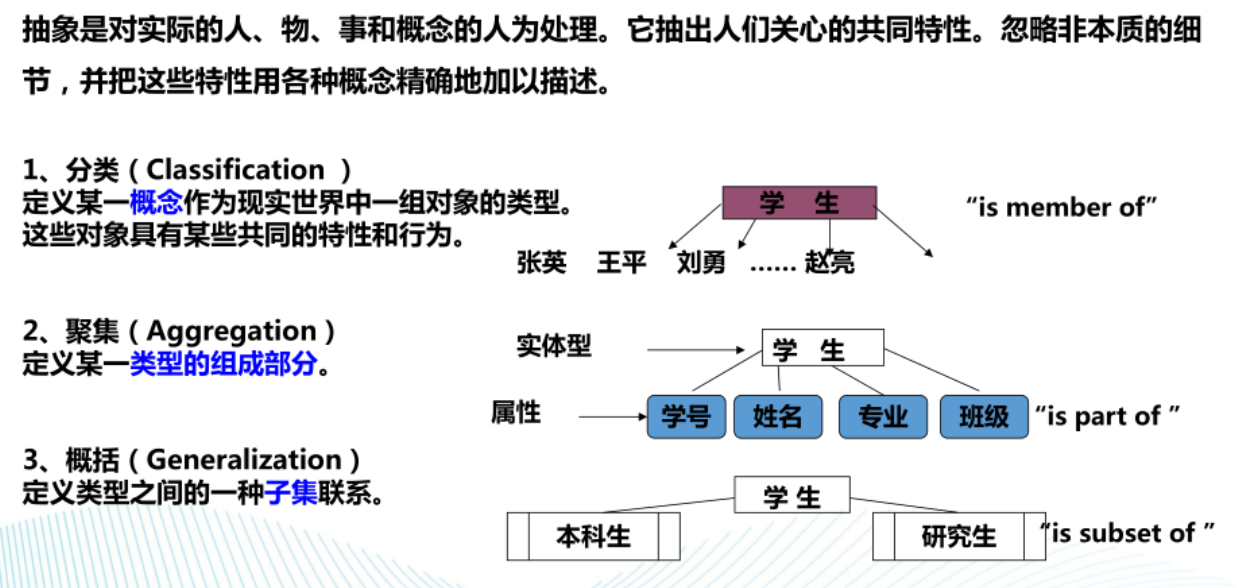
概念结构设计-关系类型:
逻辑结构设计
逻辑结构设计是数据库/仓库模型实施过程中最为重要的一环,因为它能直接反映出业务部门的需求,同时对系统的物理实施有着指导性的作用。逻辑结构设计是在概念设计的基础上对实体、实体关系的细化。
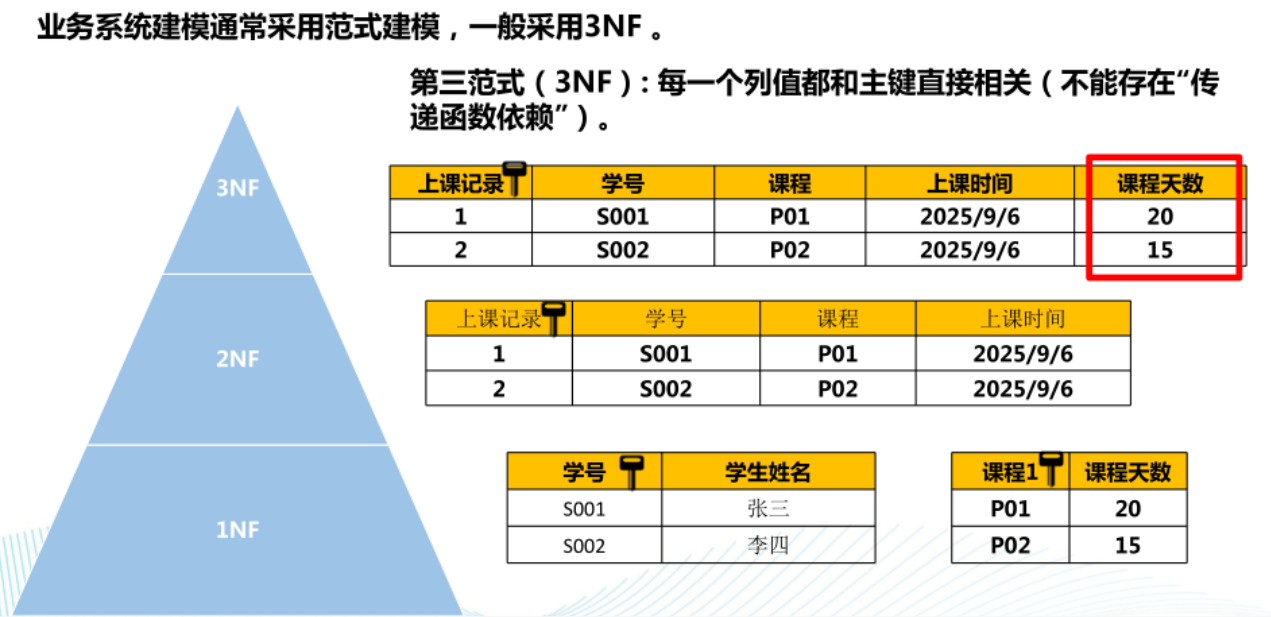
目前数据库用到的较多的是3NF建模:
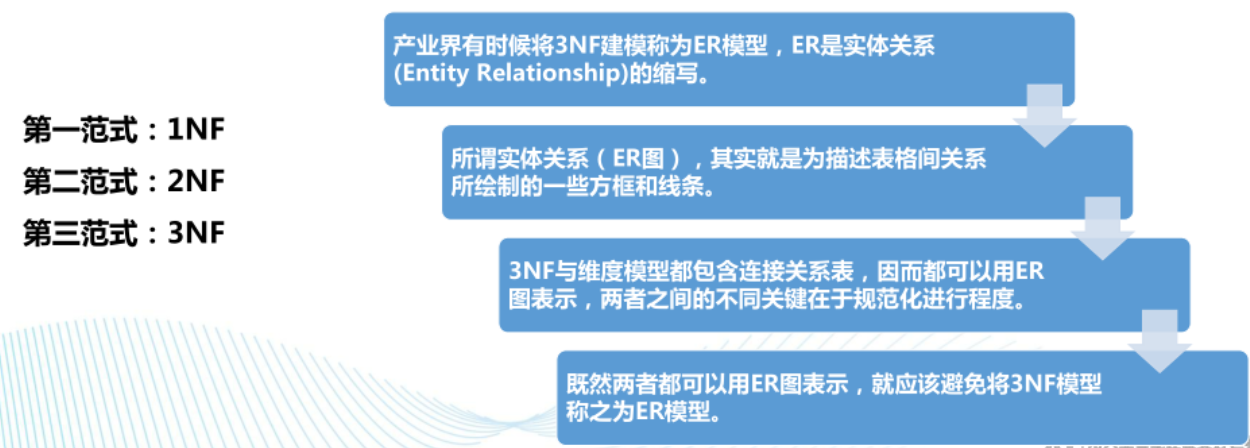
逻辑结构设计-范式建模
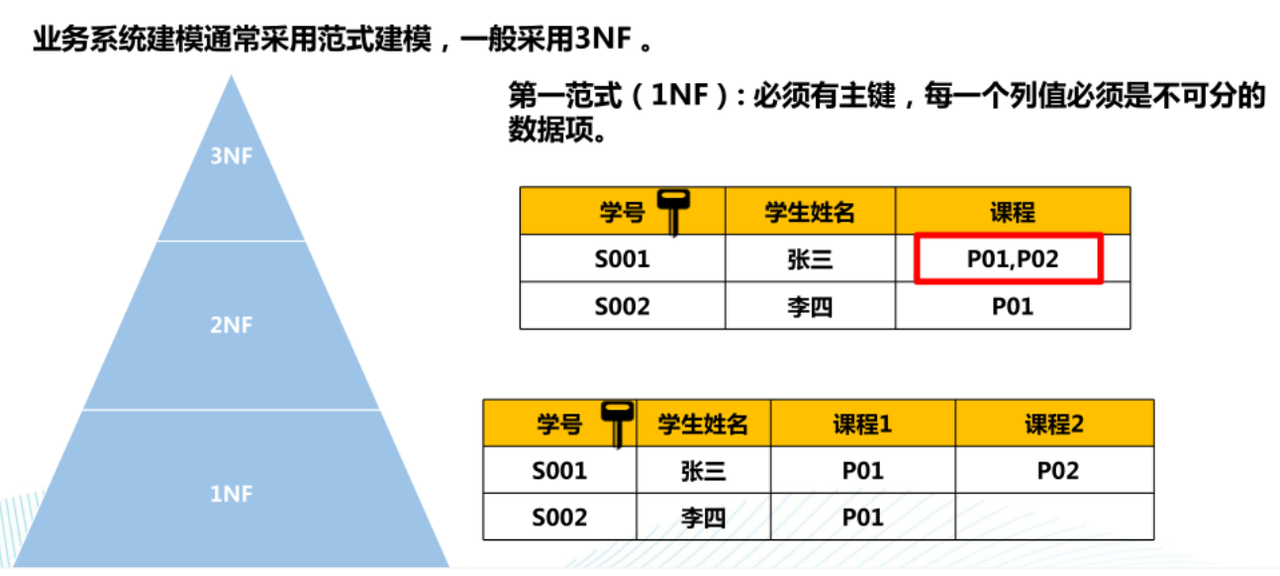
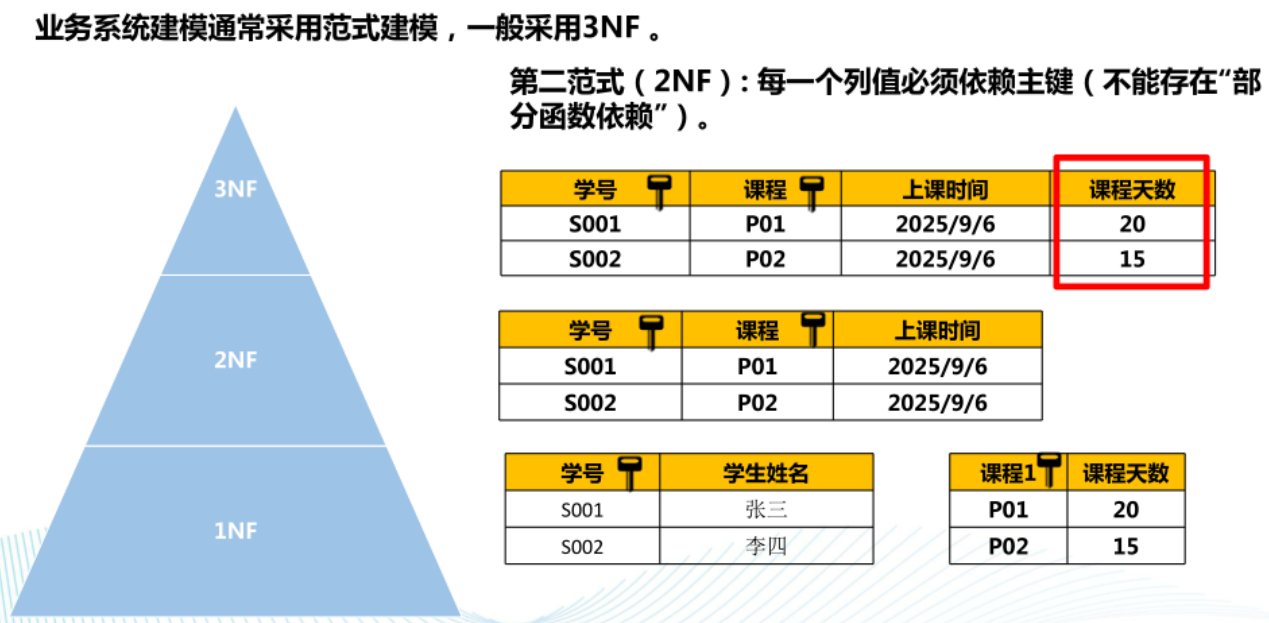
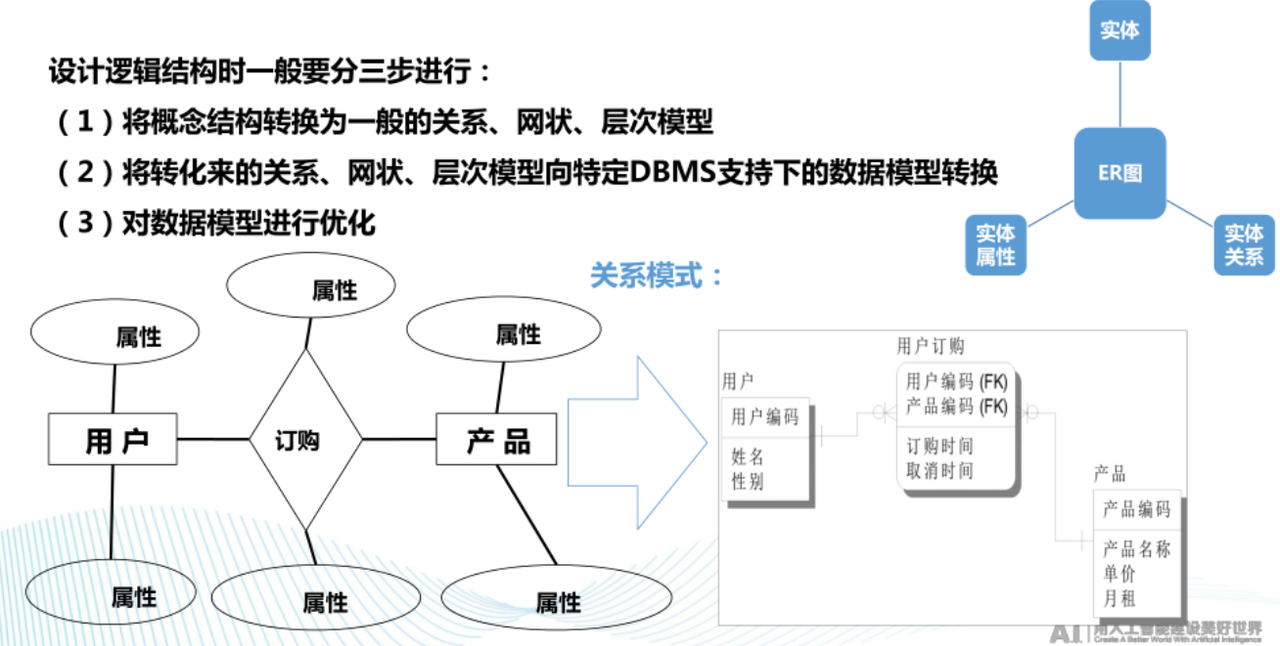
逻辑结构设计-模型转换
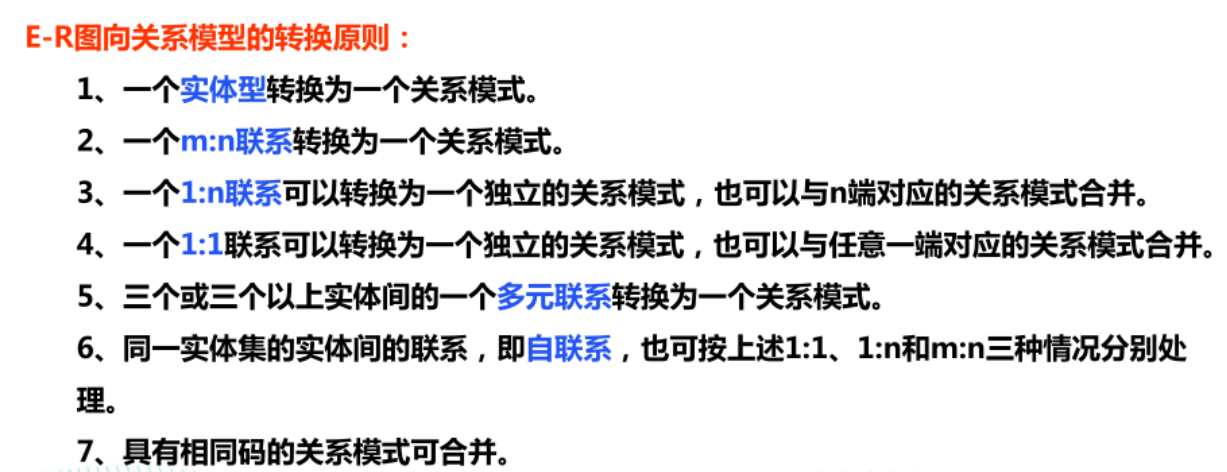
逻辑结构设计-模型转换原则
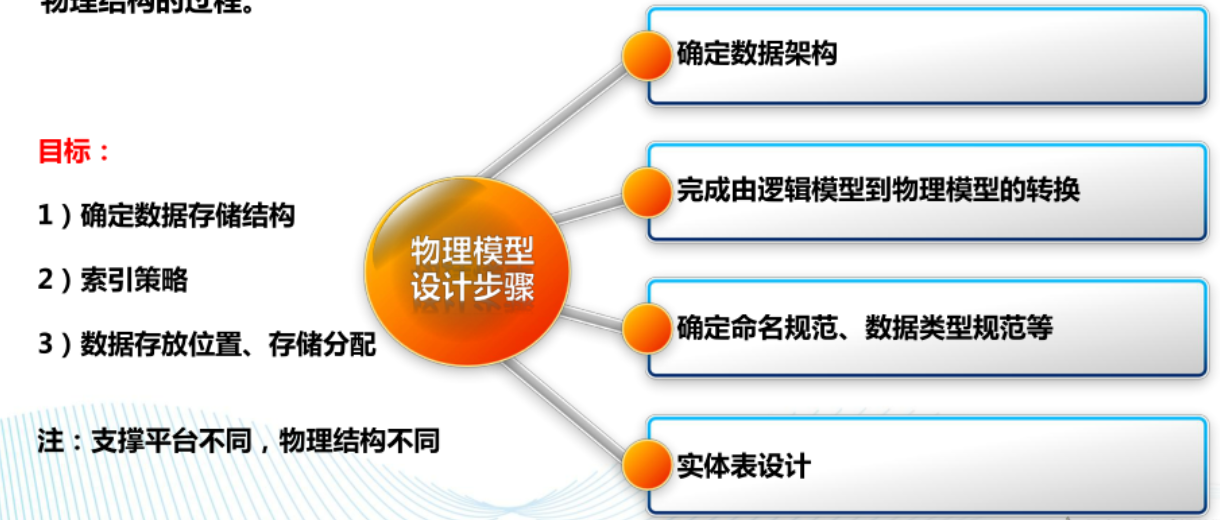
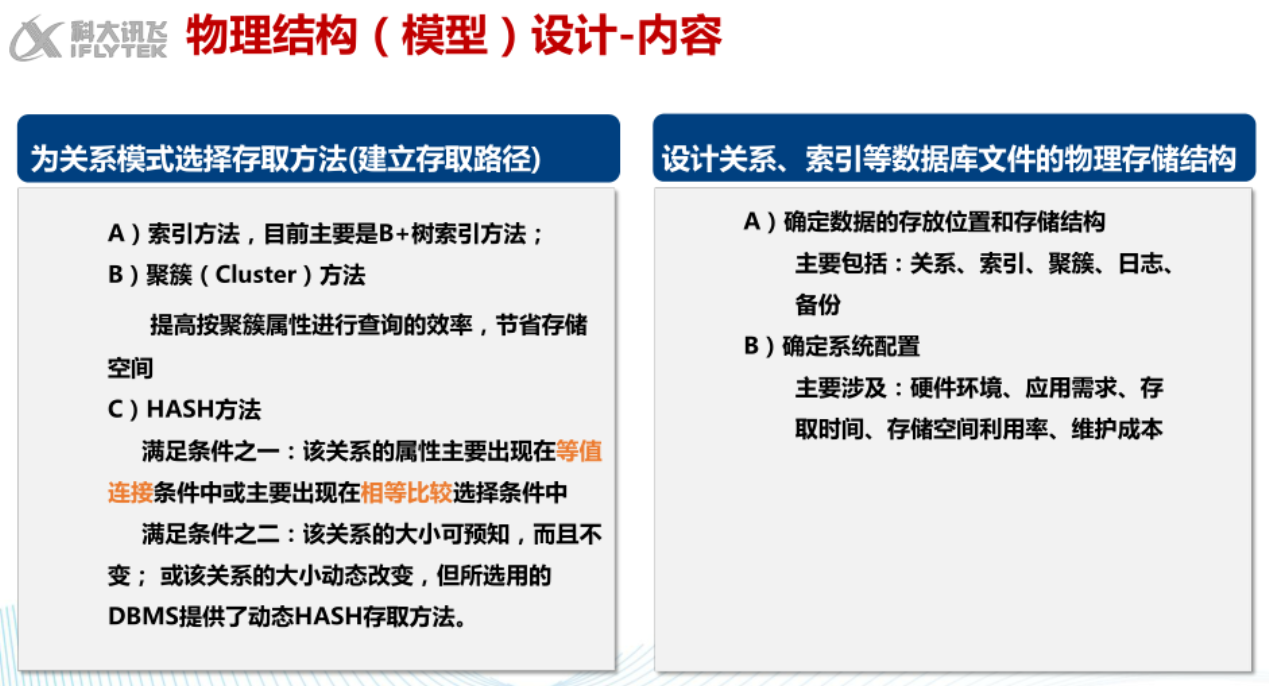
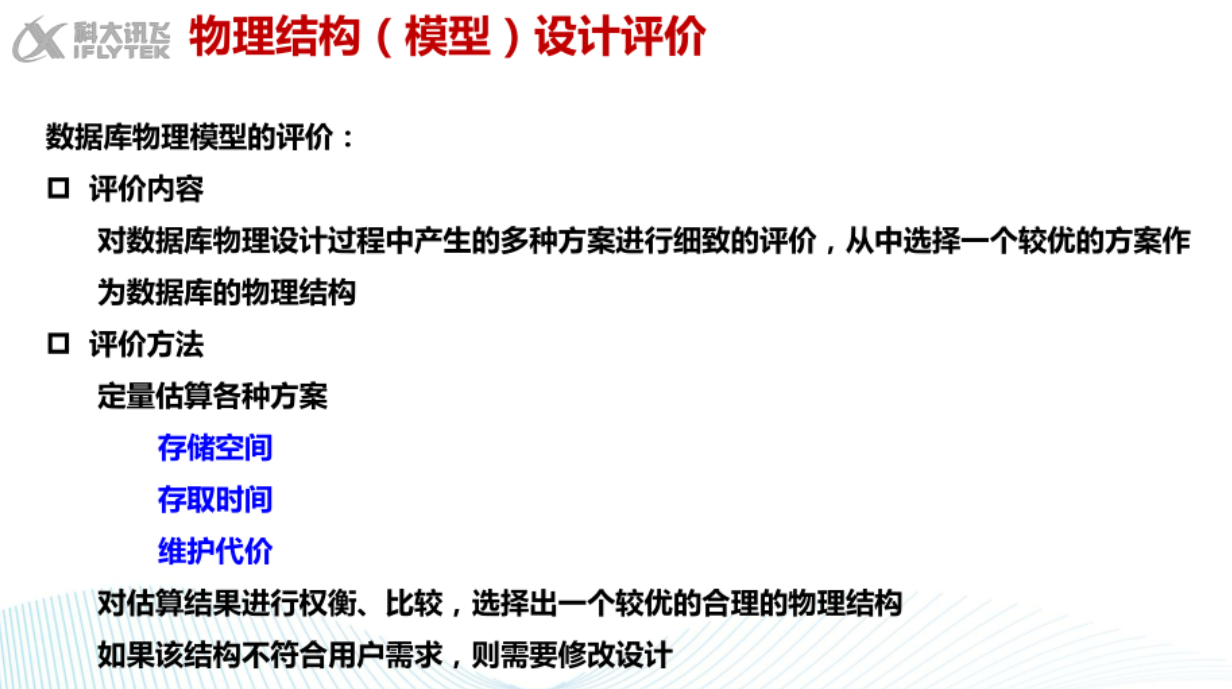
物理结构(模型)设计
数据库的物理结构(模型)设计是为一个给定的逻辑数据模型选取一个最适合应用环境的物理结构的过程。
数据仓库方法论
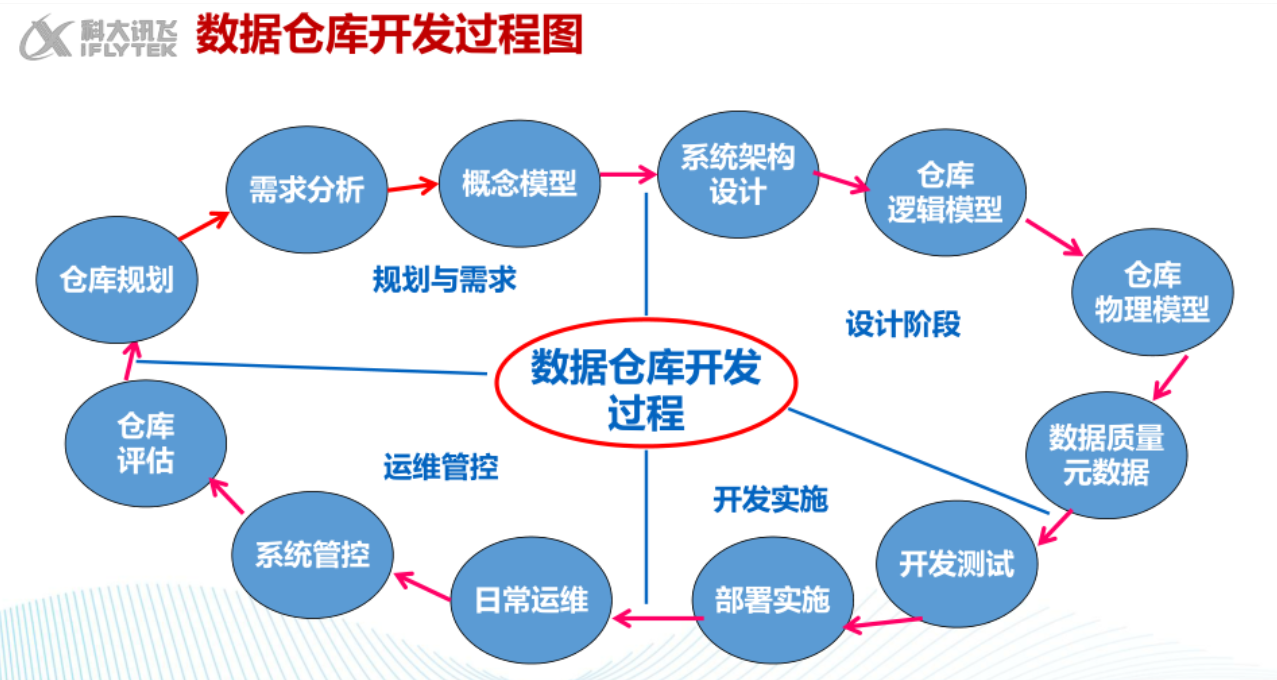
数据仓库开发过程
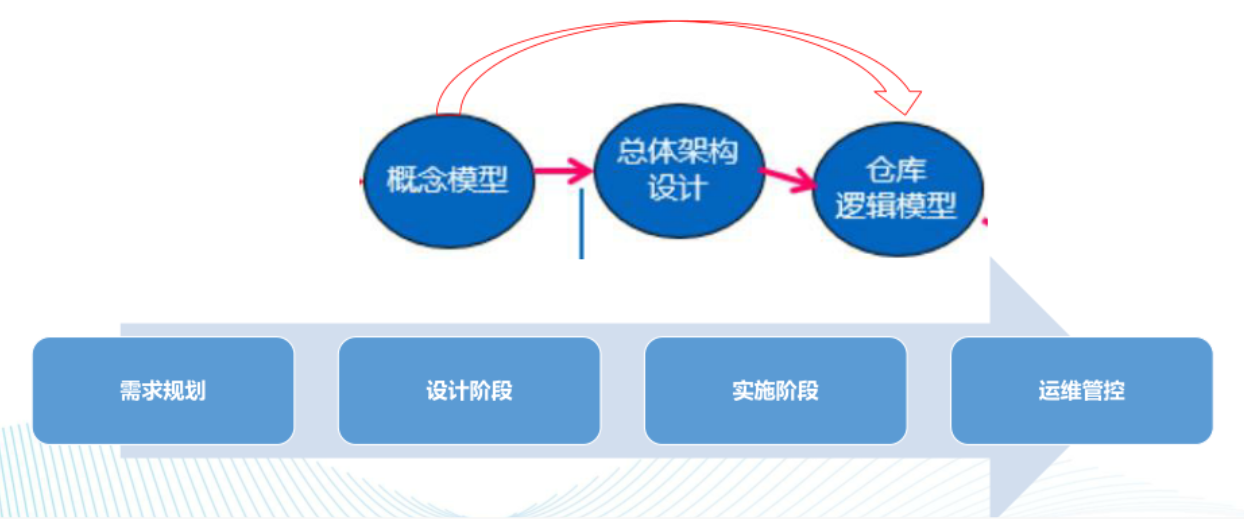
数据仓库建设的四个阶段
总体上可以分为四个阶段,每个阶段又可细分为多个阶段,各阶段实施不是严格的时序排列通常会采用迭代开发的模型,如概念模型确定后,总体架构,仓库模型都可以开始设计了。
数据仓库规划与需求
数据仓库规划是仓库系统目标与范围的描述
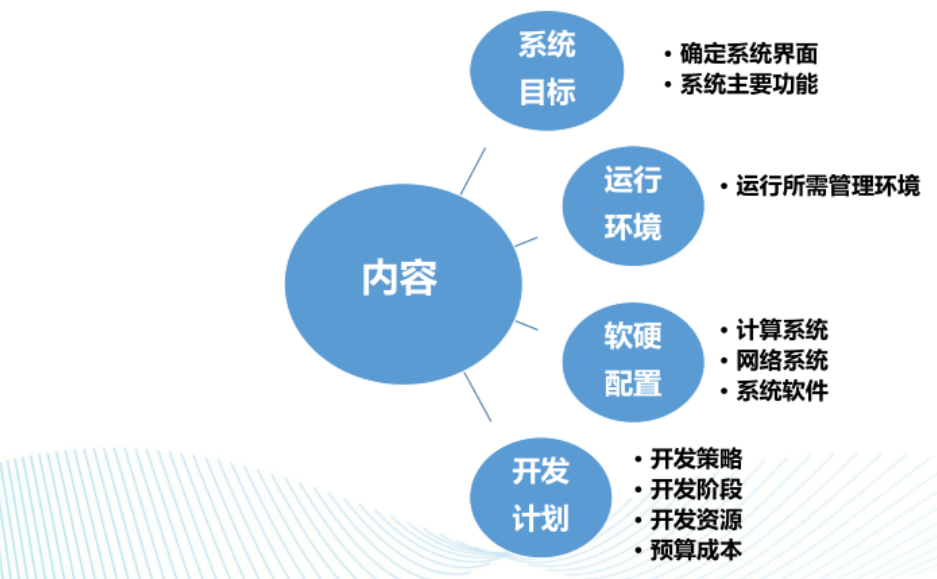
需求是设计开发的重要基础
需求是设计的语句依据,满足需求也是完成仓库建设的基本要求。需求分为需求收集、需求整理、需求确认、需求评估四个阶段:
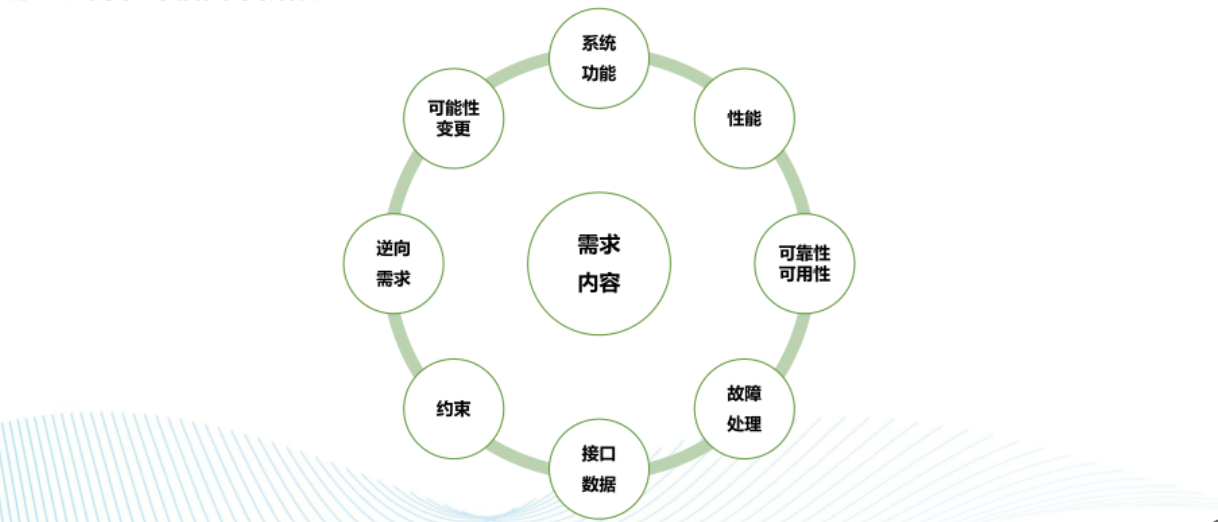
需求整理和确认
需求分析是仓库设计的重要依据,仓库的需求阶段实际上是问题识别、分析与综合指定规格说明、评审的过程。同时需求分析还是一个信息收集、总结的过程。
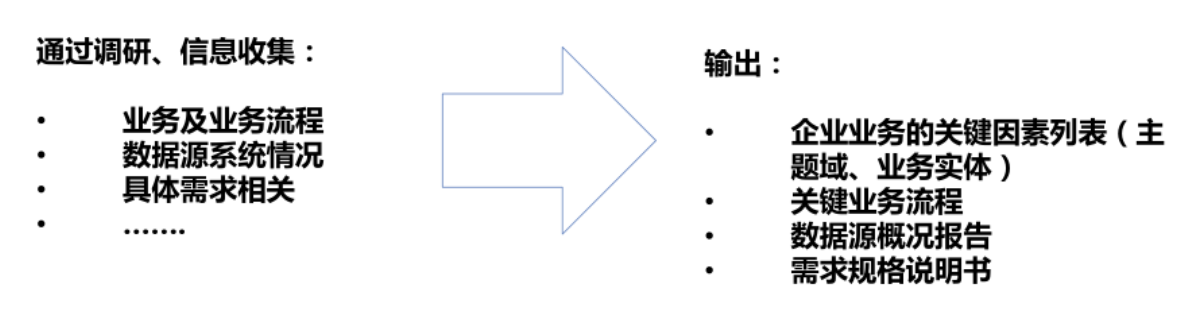
概念模型的目标
概念模型是联系主观与客观的桥梁,概念模型主要来源于业务和需求。
是一个高层次的数据模型
定义了重要的业务概念和彼此的关系
由核心的业务实体或其集合、实体之间的业务关系组成
设计时可以采用实体建模法,来保证概念的完整性,以及减少概念的重复
目的是在不考虑具体技术实现的前提下:
确定系统边界
参考行业规范、企业规范
业务对象分类、分组
规划主题域
概念模型的内容
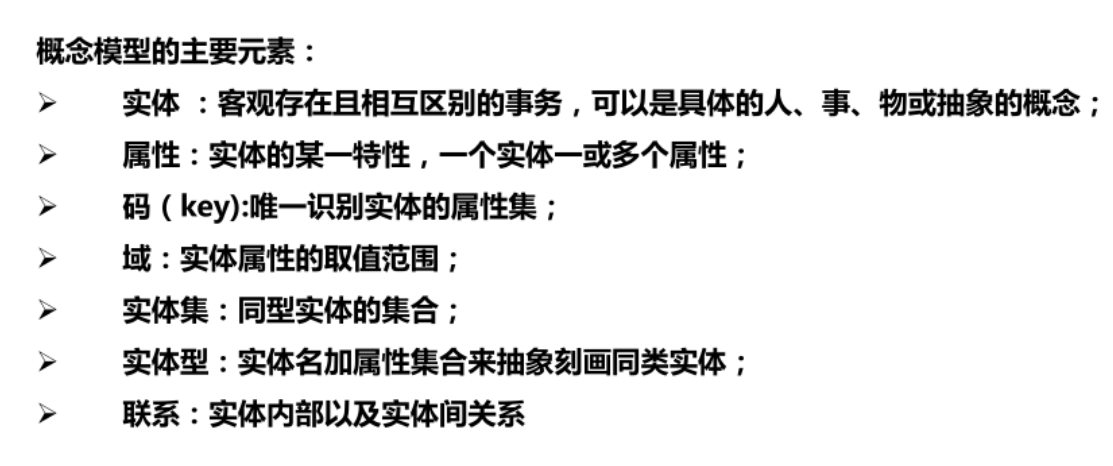
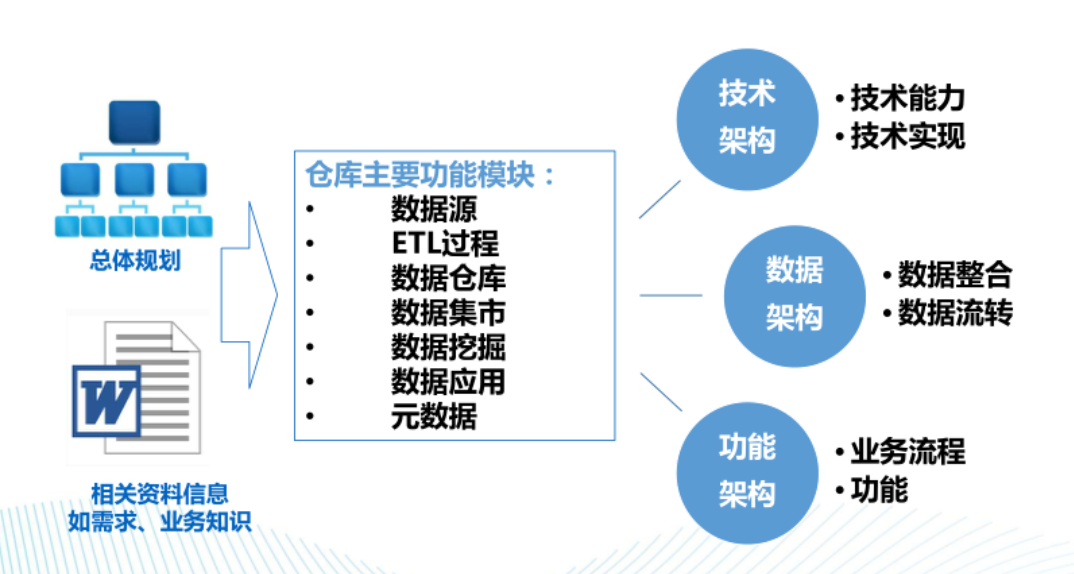
数据仓库的设计
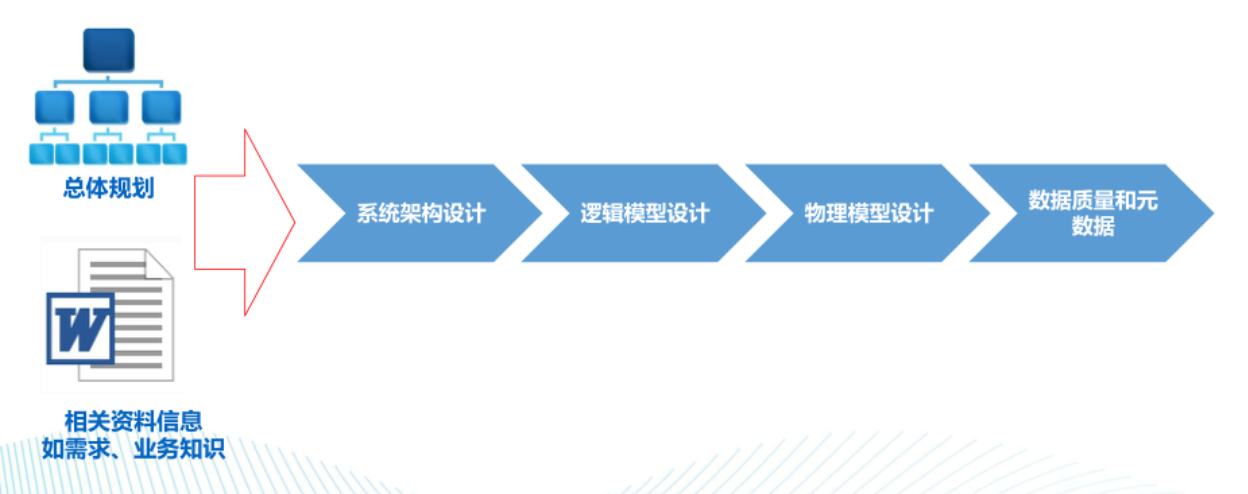
系统架构设计
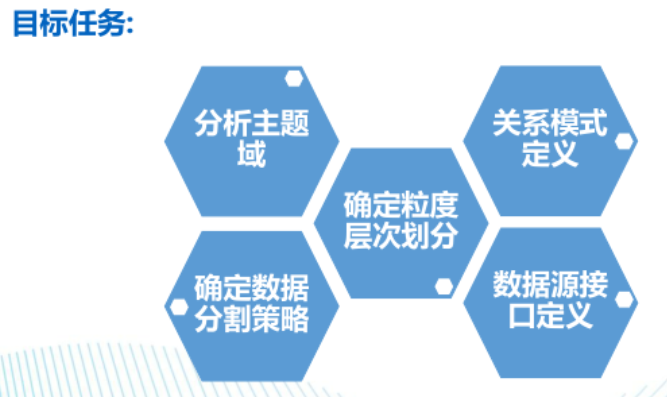
逻辑模型设计
对概念模型的各个主题域进行细化,根据业务定义、分类和规则,定义其中的实体并描述实体间的关系,并产生实体关系图(ERD),然后遵照规范化思想在实体关系的基础上明确各个实体的属性。
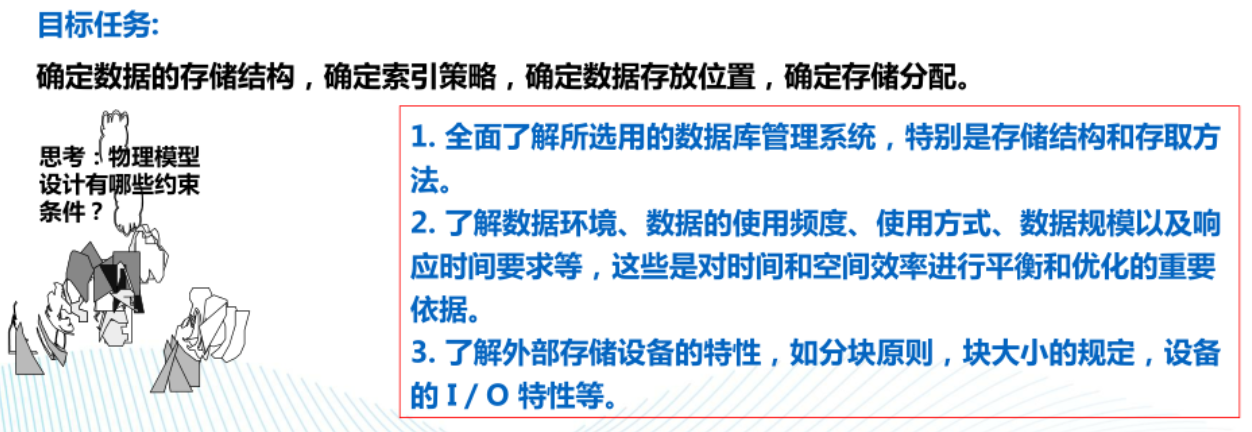
物理模型设计
物理模型设计是依据具体的逻辑模型针对具体的分析需求和物理平台采取相应的优化策略,是一种反规范化的处理。
数据质量
数据质量管理(Data Quality Management),是指对数据从计划、获取、存储、共享、维护、应用和消亡生命周期的每个阶段每个阶段里可能引发的数据质量问题,进行识别、度量、监控、预警的一系列管理活动,并通过改善和提高组织的管理水平使得数据质量获得进一步提高。
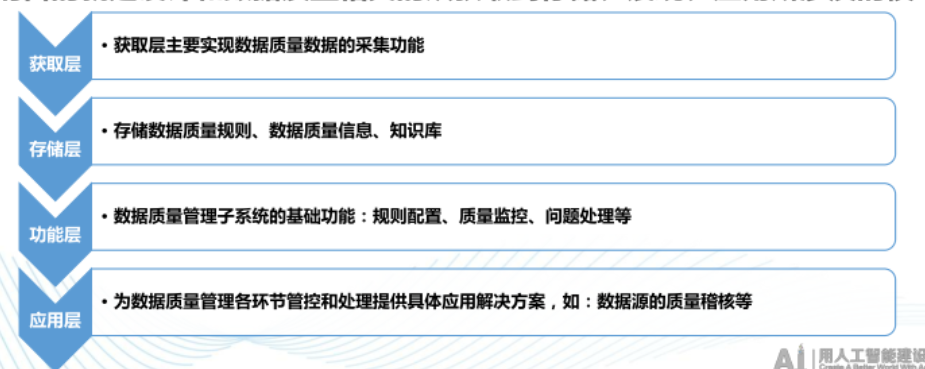
数据质量设计的目的就是设计和数据质量相关的从获取到存储、展现、应用所涉及的模型、流程。
常见的四层结构
元数据
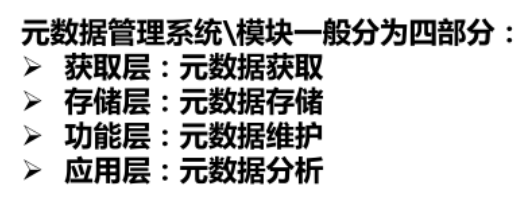
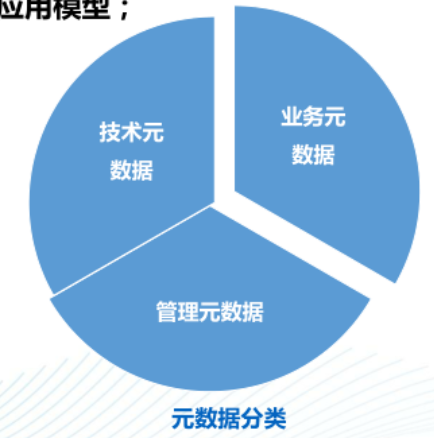
元数据是管理数据的数据,目标是统一的理解企业信息资源,建立一套动态数据字典,方便应用,保持整个企业的标准,协助提升数据质量、进行数据生命周期的管理,方便数据跨部门横向、纵向传递。
元数据的模型设计即元数据的数据的相关存储、应用模型;
数据仓库的开发实施
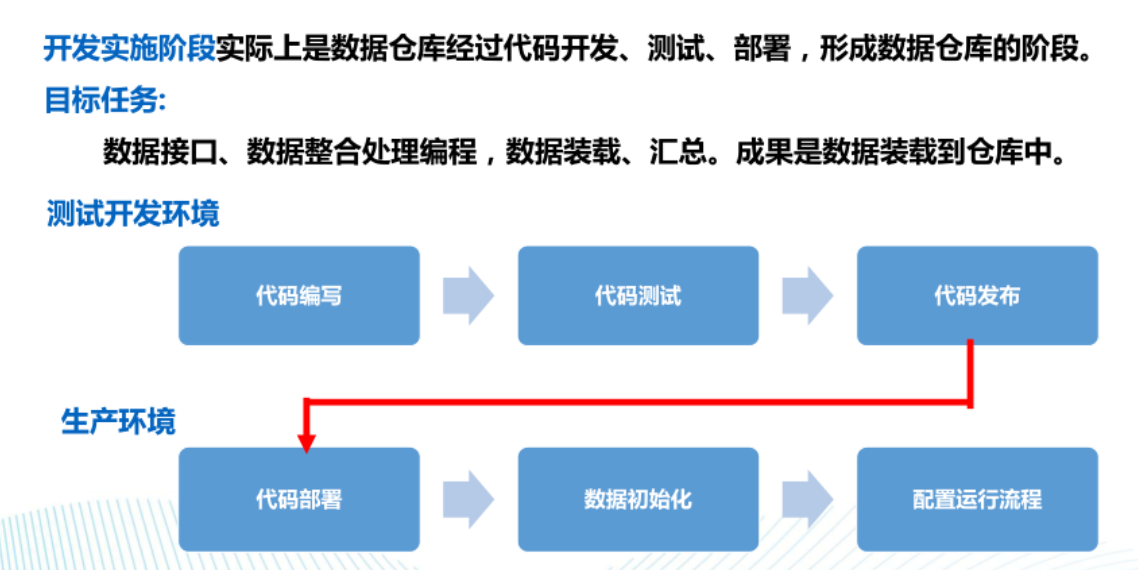
开发实施阶段
数据存储与处理的支持和增强
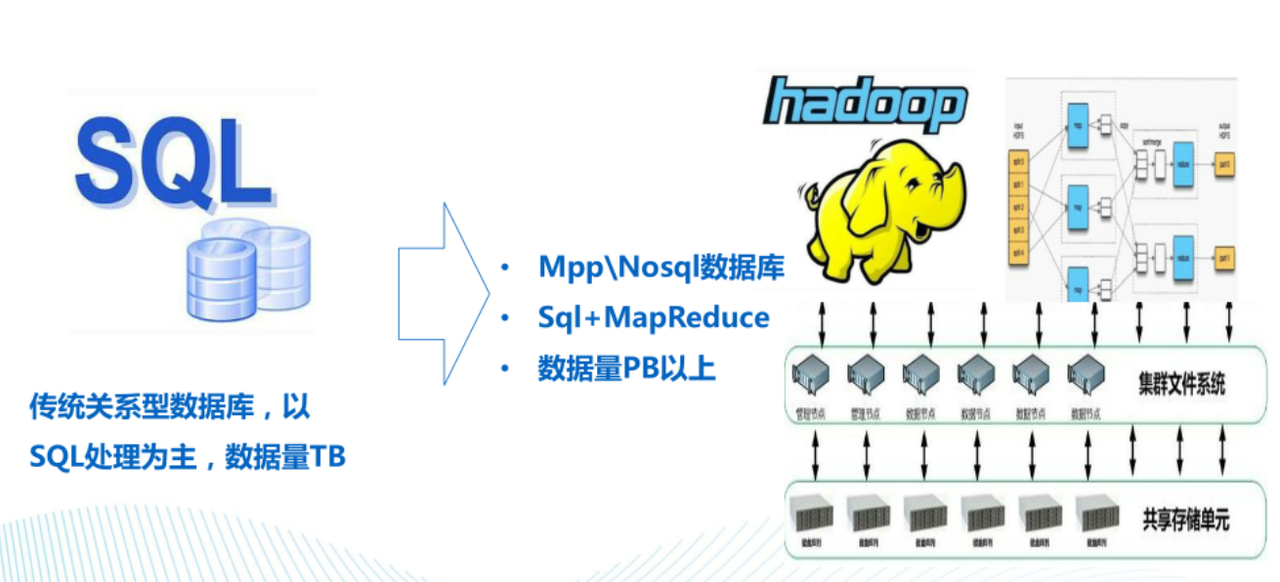
数据应用的支持和增强
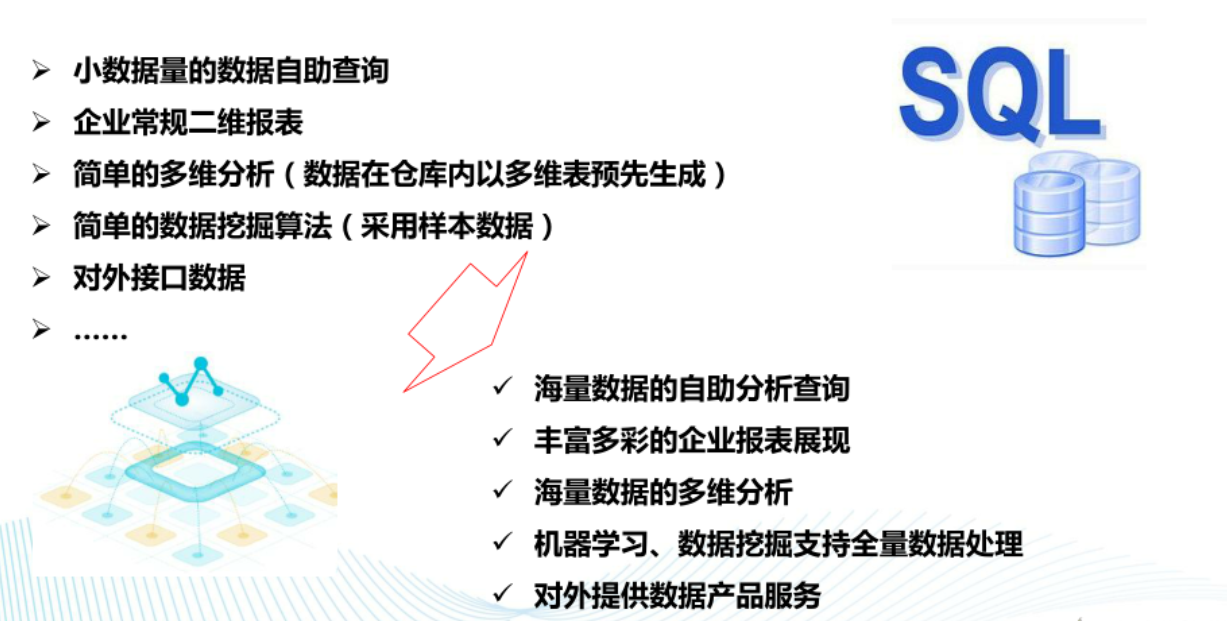
大数据环境下数据仓库的特点
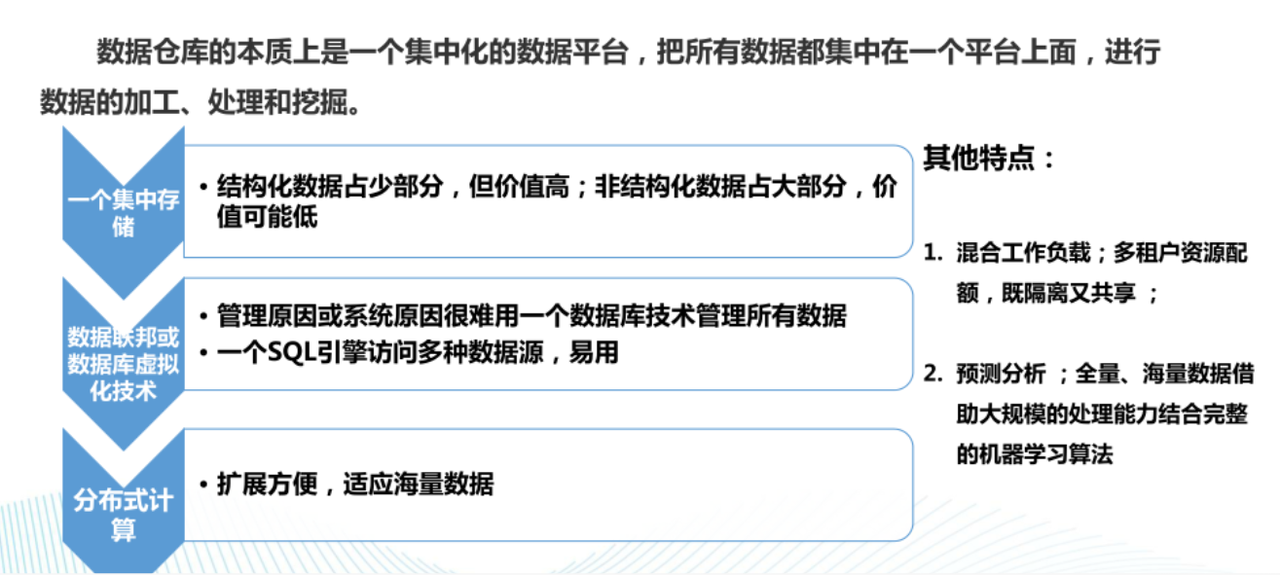
Apache Hive
Hive概述
什么是Hive?
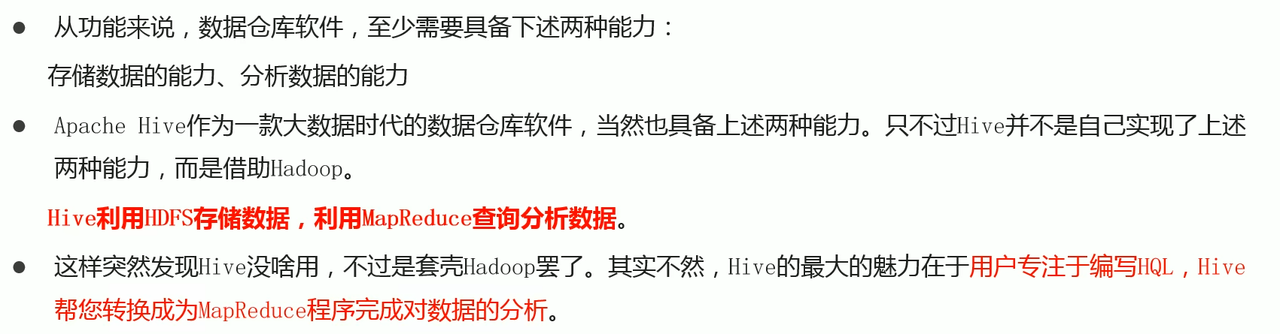
Apache Hive是一款建立在Hadoop之上的开源数据仓库系统,可以将存储在Hadoop文件中的结构化、半结构化文件映射为一张数据库表,基于表提供了一种类似SQL的查询模型,成为Hive查询语言(HQL),用于访问和分析存储在Hadoop中的大型数据集。
Hive核心是将HQL转换为MapReduce程序,然后将程序提交到Hadoop集群执行。
为什么使用Hive?
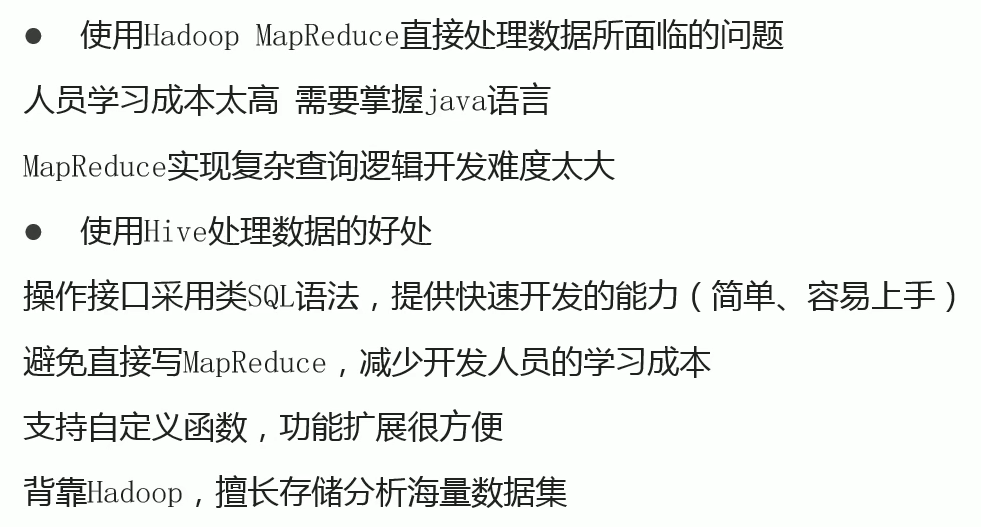
Hive与Hadoop的关系
Hive拉链表
数据同步问题
背景
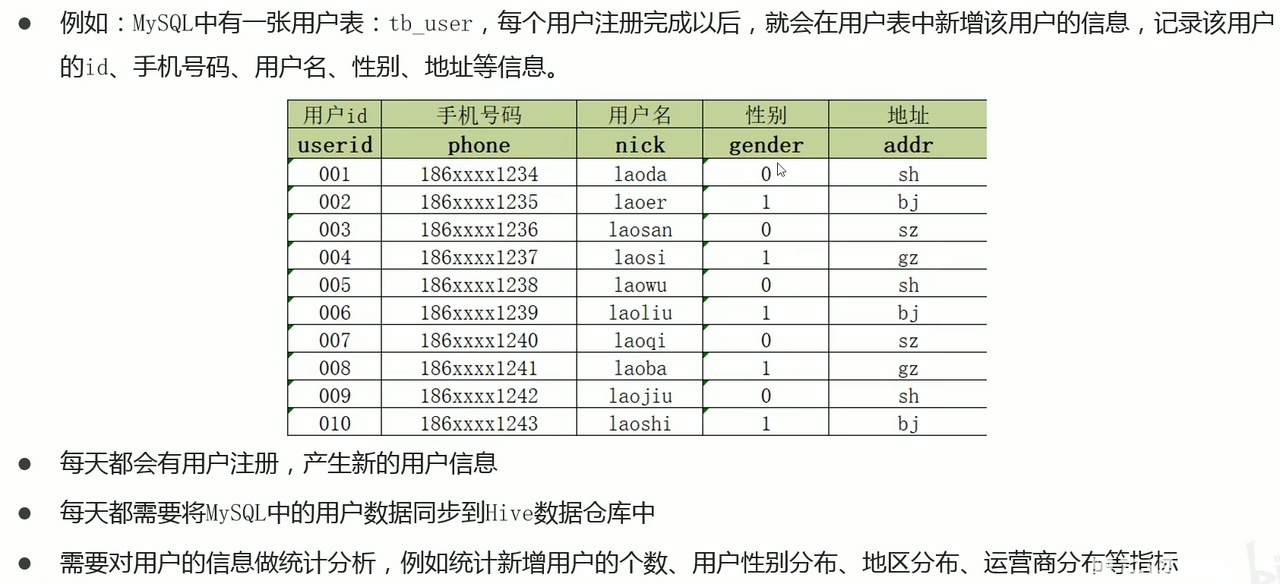
Hive在实际工作中主要用于构建离线数据仓库,定期的从各种数据源中同步采集数据到Hive中,经过分层转换提供数据应用。
例如每天需要从MySQL中同步最新的订单信息、店铺信息、用户信息等到数据仓库中进行订单分析、用户分析。
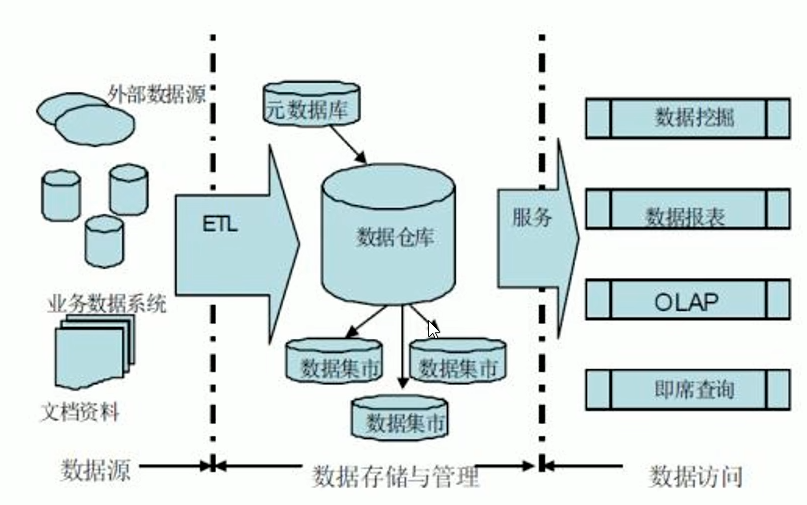
这种策略也告诉我们,数仓是一个持续维护的过程,按照分析的频率、时间的间隔来同步数据。
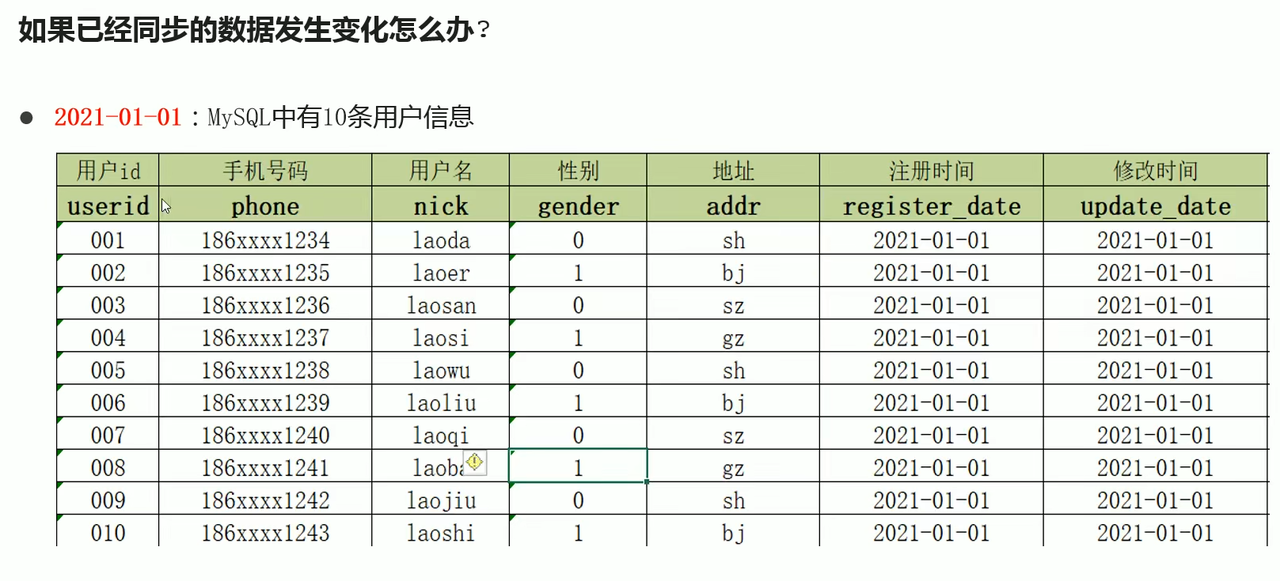
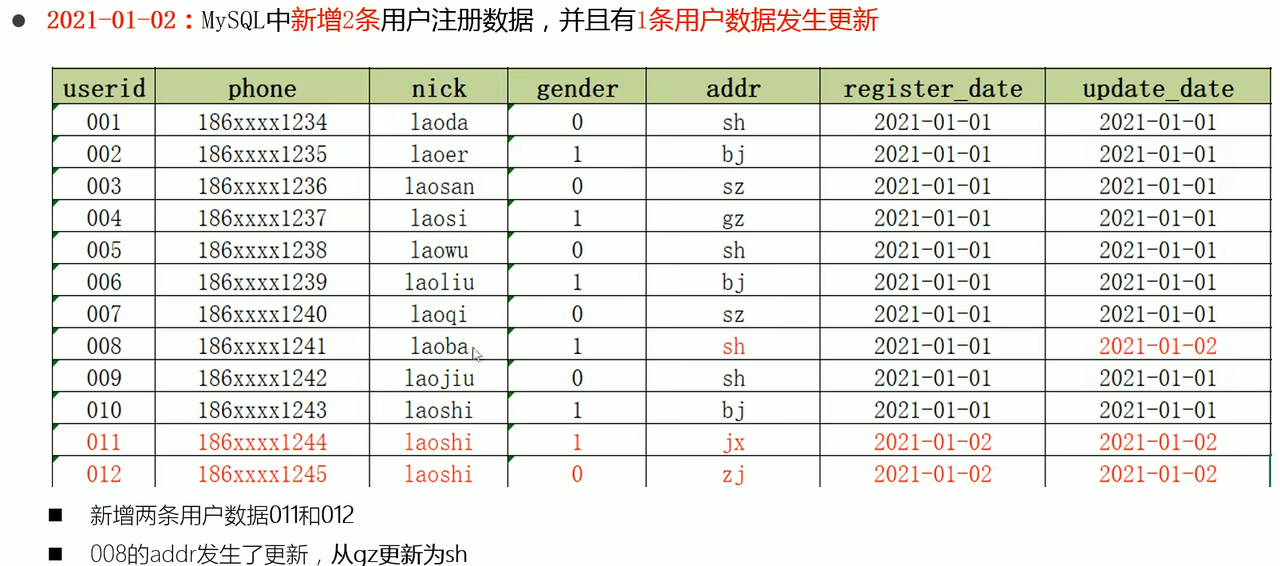
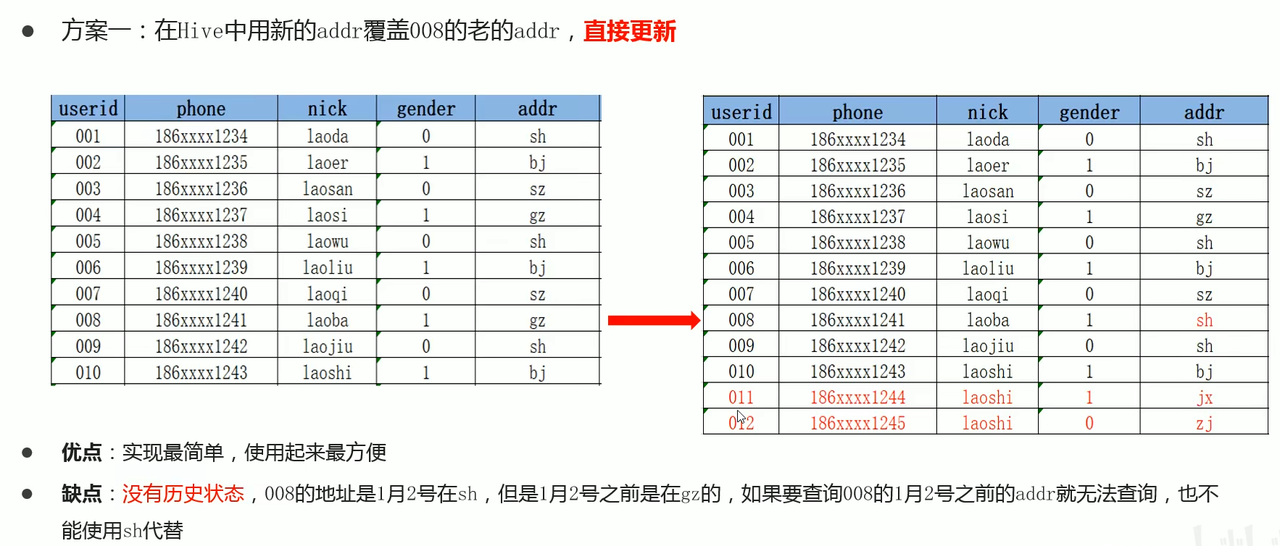
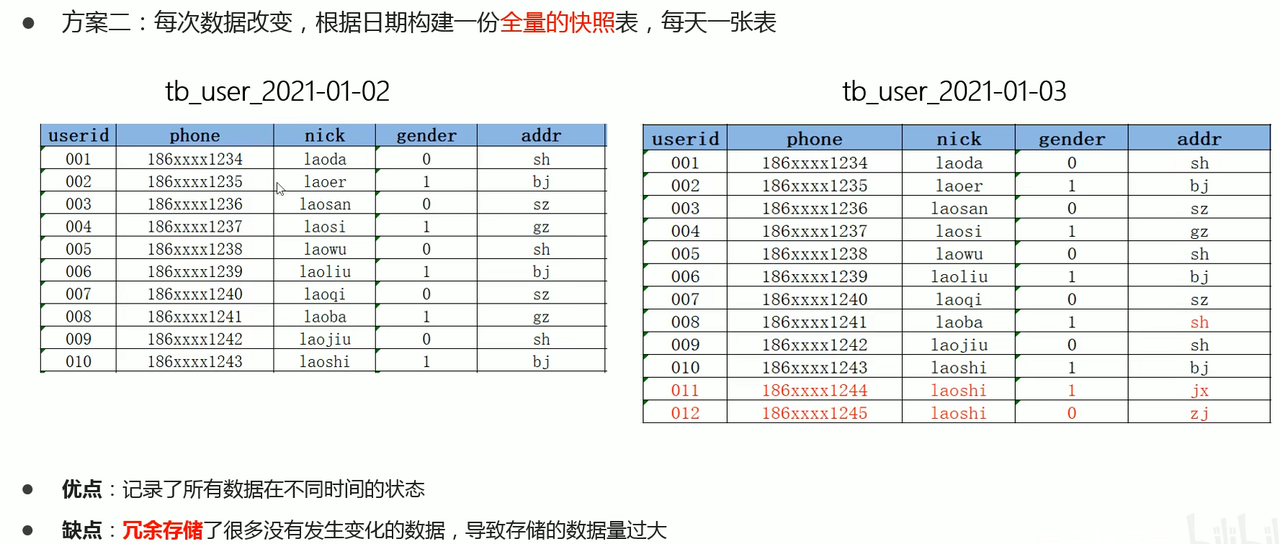
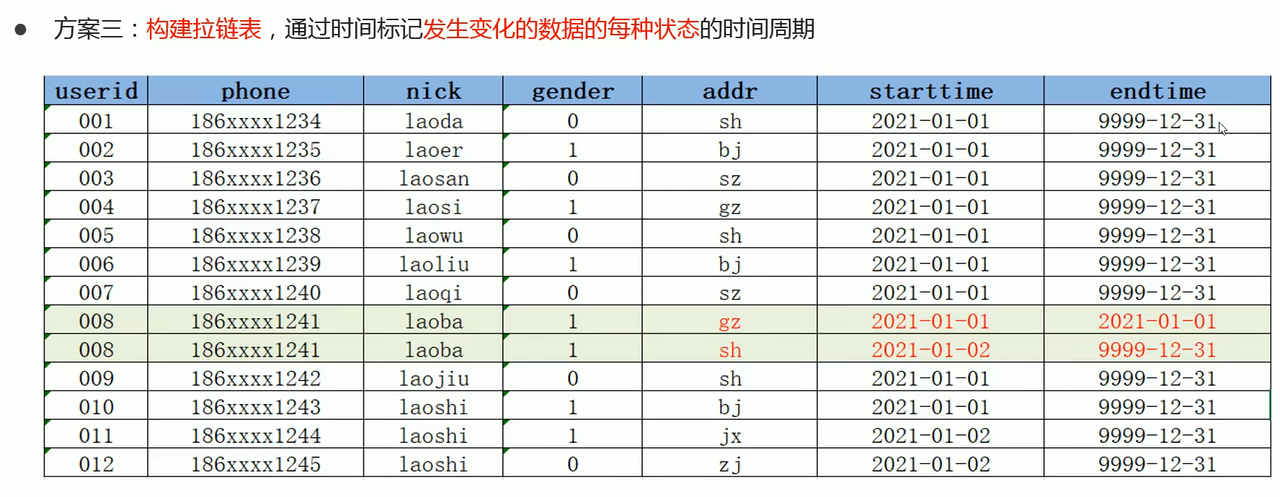
功能和应用场景
拉链表专门用于解决数据仓库中数据发生变化如何实现数据存储的问题。 拉链表的设计是将更新的数据进行状态记录,没有发生更新的数据不进行状态存储,用于存储所有数据在不同时间上的所有状态,通过时间进行标记每个状态的生命周期,查询时根据需求可以获得指定时间范围状态的数据,默认用9999-12-31等最大值来表示最新状态。
实现过程:
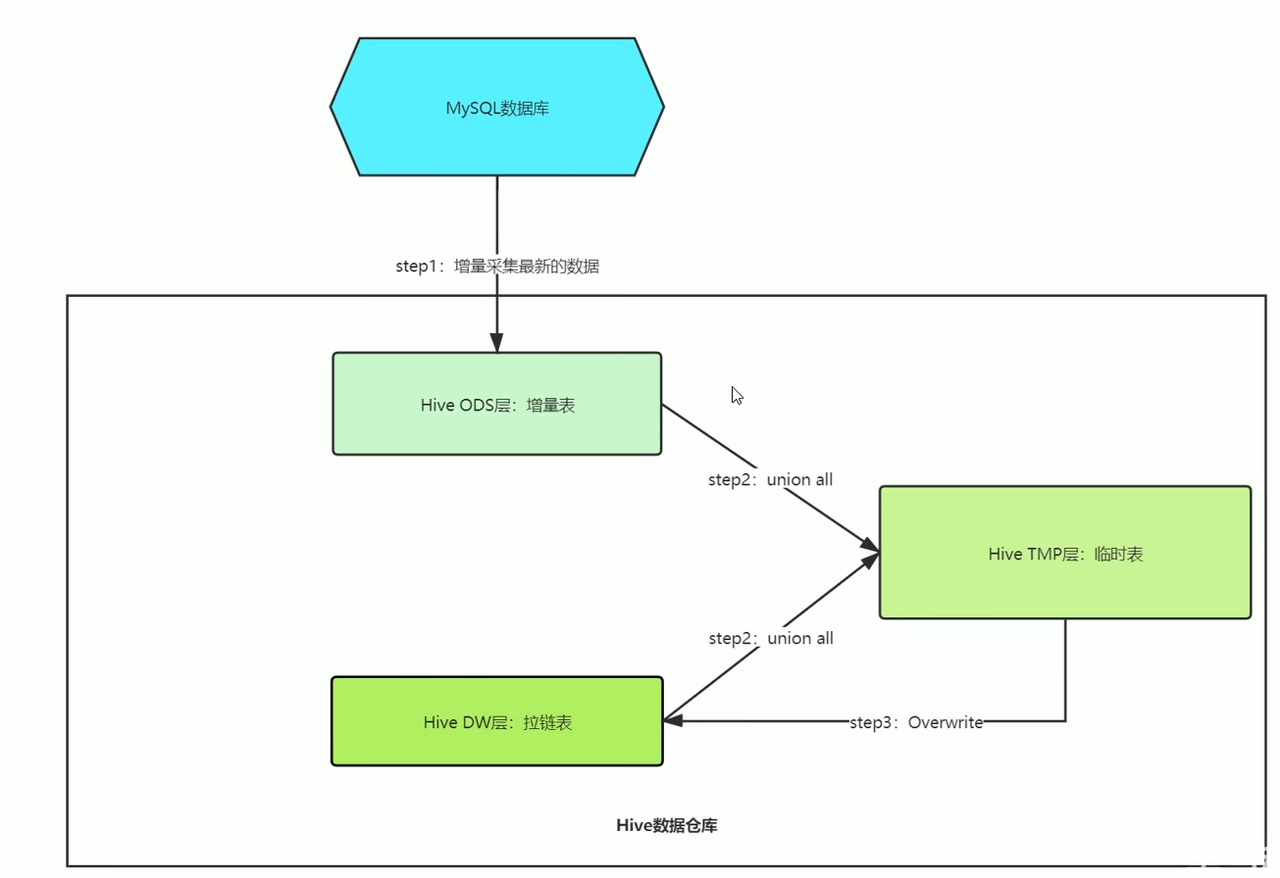
MySQL中发生变化的数据采集为一个增量表将其与现有的拉链表结合更新为一张临时表,最后用临时表重写现有的拉链表即可。
拉链表的实现
insert overwrite table tmp_zipper
select
    user_id,
    phone,
    nick,
    gender,
    addr,
    starttime,
    endtime
from ods_zipper_update
union all
--查询原来拉链表的所有数据
--并将这次需要更新的数据的endtime更改为更新值的starttime
select
    a.userid,
    a.phone,
    a.nick,
    a.gender,
    a.addr,
    a.starttime
    --如果这条数据没有更新或者这条数据不是要更改的数据
    --就保留原来的值,否则就改为新数据的开始时间-1
    if(b.userid is null or a.endtime<'9999-12-31',a.endtime,date_sub(b.starttime,1)) as endtime
 from dw_zipper a left join ods_zipper_update b
         on a.userid = b.userid;
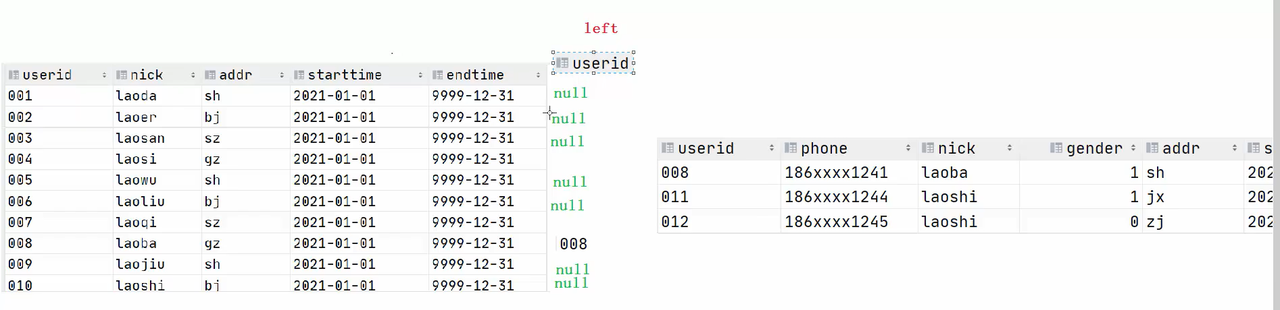
整体上这个SQL是一个insert加上select,即把后面查询的结构插入到临时表当中。
而下面的查询是两个语句的union all(合并结果集不去重)
上面的第一个select是把增量的数据拿取过来即from ods_zipper_update
下面的第二个查询把原始的拉链表起别名叫做a,增量表叫做b,进行左连接(以左边为准,右边与之关联),所以b表关联后与a表中userid不相同的b.userid都是null。
接下来看这一句条件判断
if(b.userid is null or a.endtime<'9999-12-31',a.endtime,date_sub(b.starttime,1)) as endtime
如果b.userid is null就代表左表的原始拉链表中这条数据没有发生变化即没有更新,
或者a.endtime<'9999-12-31',a.endtime
a.endtime<'9999-12-31'这部分表示如果a表(原始拉链表)中endtime小于最大时间,则表示他是之前某个历史状态的数据,所以也不是要更新的数据,后面的a.endtime表示这部分endtime不变
date_sub(b.starttime,1)) as endtime
这部分SQL表示如果不满足前面的if条件,说明这些是要更新的数据,把endtime改为新数据的开始时间-1,该条数据就保留了历史状态。
Hive数据存储
Hive的架构
Hive架构,一般包括:用户接口、元数据存储、Driver驱动程序、执行引擎四部分。
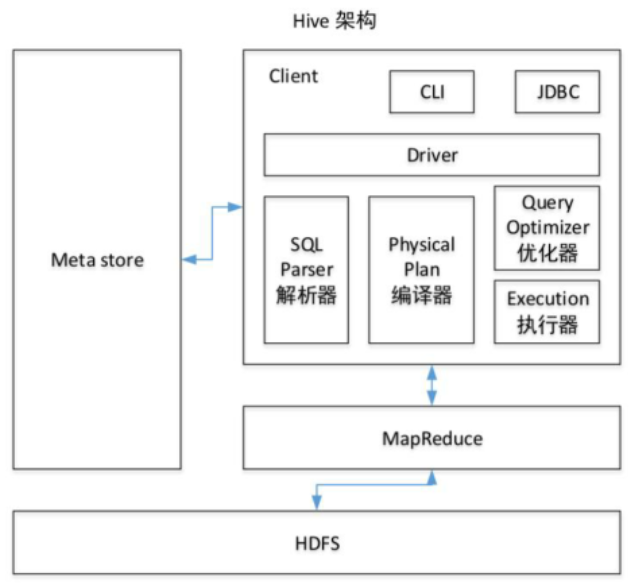
用户接口
用户接口:用户访问Hive的方式,包括CLI(command line interface)、JDBC/ODBC协议、Web浏览器访问。
元数据存储
元数据存储:存储Hive中表和文件的映射关系,表的名称,字段,及其各种属性信息,表的位置等。通常存储在关系型数据库中,如MySQL,derby等。
Driver驱动程序
Driver驱动程序:负责将用户输入的HQL语句,转换为可在Hadoop集群上执行的任务。包括解析器、编译器、优化器、执行器。
完成HQL语句从词法分析,语法分析,编译,优化,以及查询计划的生成等步骤。
词法分析:将HQL语句拆分为一个个的词法单元(Token)。如关键 字(SELECT、FROM)、表名、列名、运算符(=、>)等。
例如:HQL语句SELECT id FROM user WHERE age > 18;
会被拆分为Token序列:SELECT,id,FROM,user,WHERE,age,>,18。
语法分析:根据HQL的语法规则,将词法单元序列转换为抽象语法树 (AST,Abstract Syntax Tree)。
功能:检查HQL语句的语法正确性(如关键字顺序、括号匹配等), 若语法错误则抛出异常。
语义分析:对AST进行合法性校验,结合Hive元数据(Metastore)验证表、列、函数等是否存在,以及数据类型是否匹配。将AST进一步划分为QueryBlock。
逻辑计划生成与编译:将语法树转换为逻辑查询计划,描述查询到逻辑执行步骤(如扫描表、过滤连接、聚合等)。
例子:对于SELECT id FROM user WHERE age >18,逻辑计划为:TableScan(user)->Filter(age>18)->Project(id)。
优化:由优化器(Optimizer)对逻辑计划进行优化,生成更高效的执行计划,减少计算资源消耗。
常见优化手段,如:谓词下推:将过滤条件(WHERE)尽可能下推到数据源(如扫描表时直接过滤,减少数据传输量)。
物理计划生成:由执行器(Executor)将优化后的逻辑计划转换为物理查询计划(Map阶段、Reduce阶段),即具体的Hadoop可执行任务(如MapReduce、Tez或Spark作业)。
执行计划提交执行:物理计划被转换为对应执行引擎的任务(如MapReduce的Job),提交到Hadoop集群执行。
执行引擎
执行引擎:Hive本身并不直接操作数据,而是通过执行引擎处理。
目前支持的执行引擎有MapReduce、Tez、Spark。
Hive存储格式
行存储与列存储
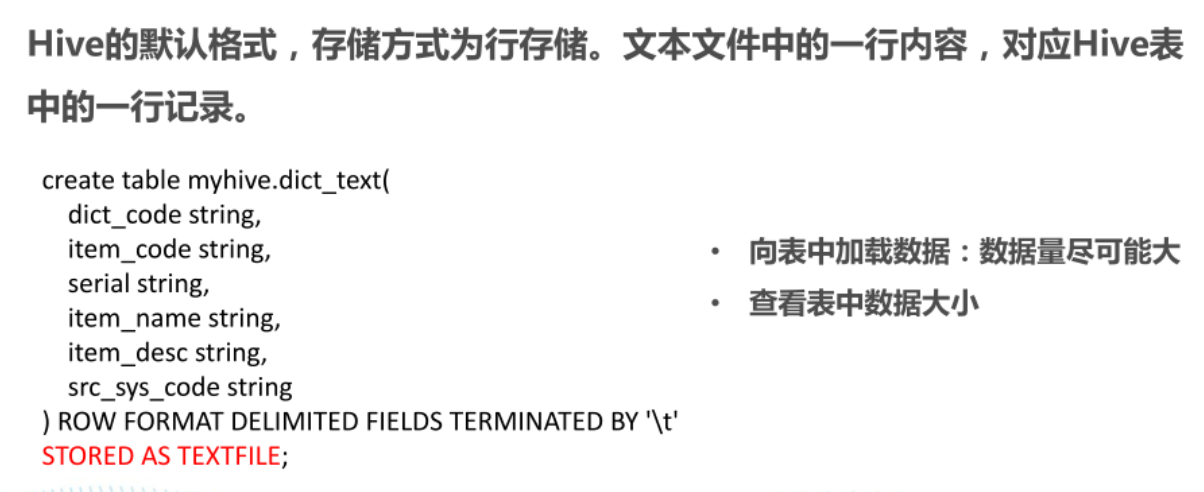
行存储:一行数据存储在文件中的相邻位置。
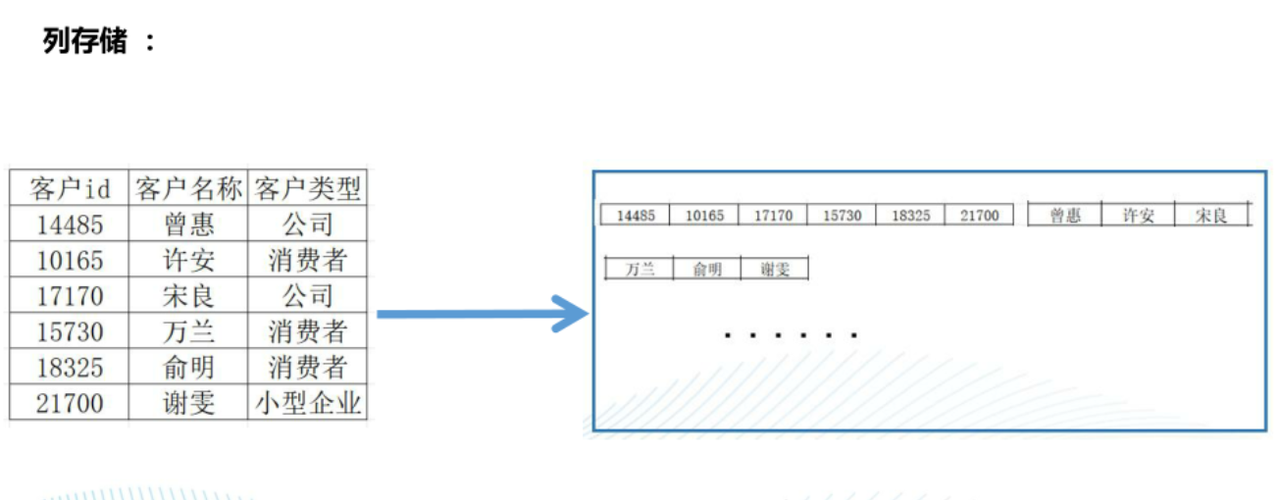
列存储:一列数据存储在文件中的相邻位置。
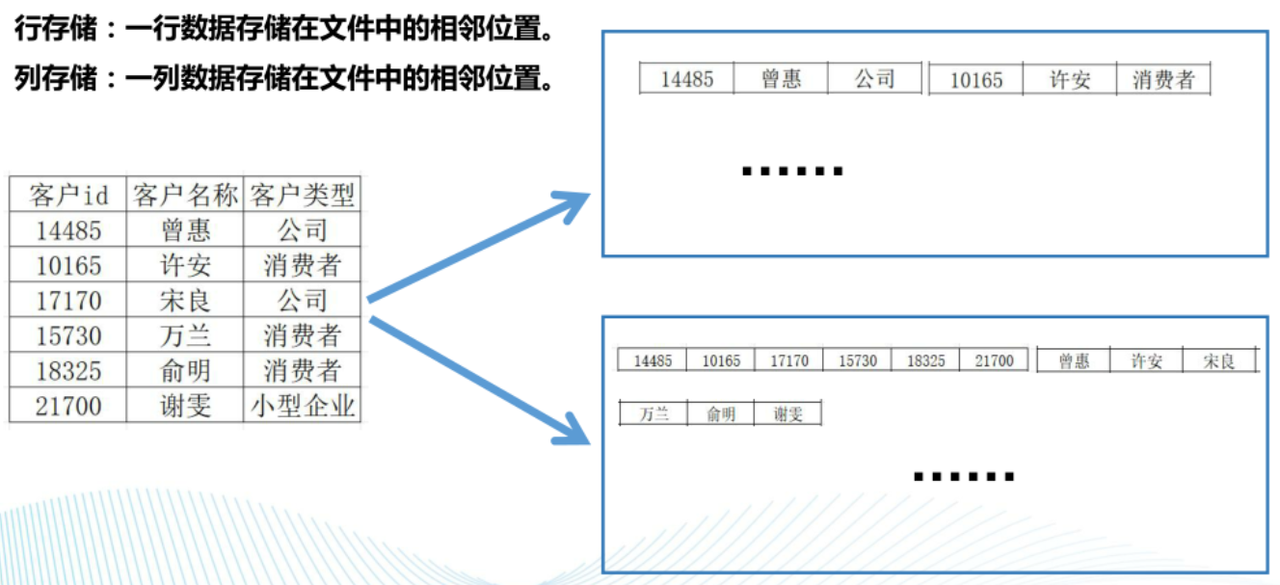
行存储
常见的关系型数据库都是行式存储的,在我们查询的条件需要得到大多数列的时候,相比列式格式,查询效率更高。Hive默认的Text就是行式存储的。
特点:
查询满足条件的一整行数据的时候,行存储只需要定位到这一行在文件中的起点,再定位这一行的长度,就能快速找到文件中的数据,所以此时行存储查询的速度更快。
列存储
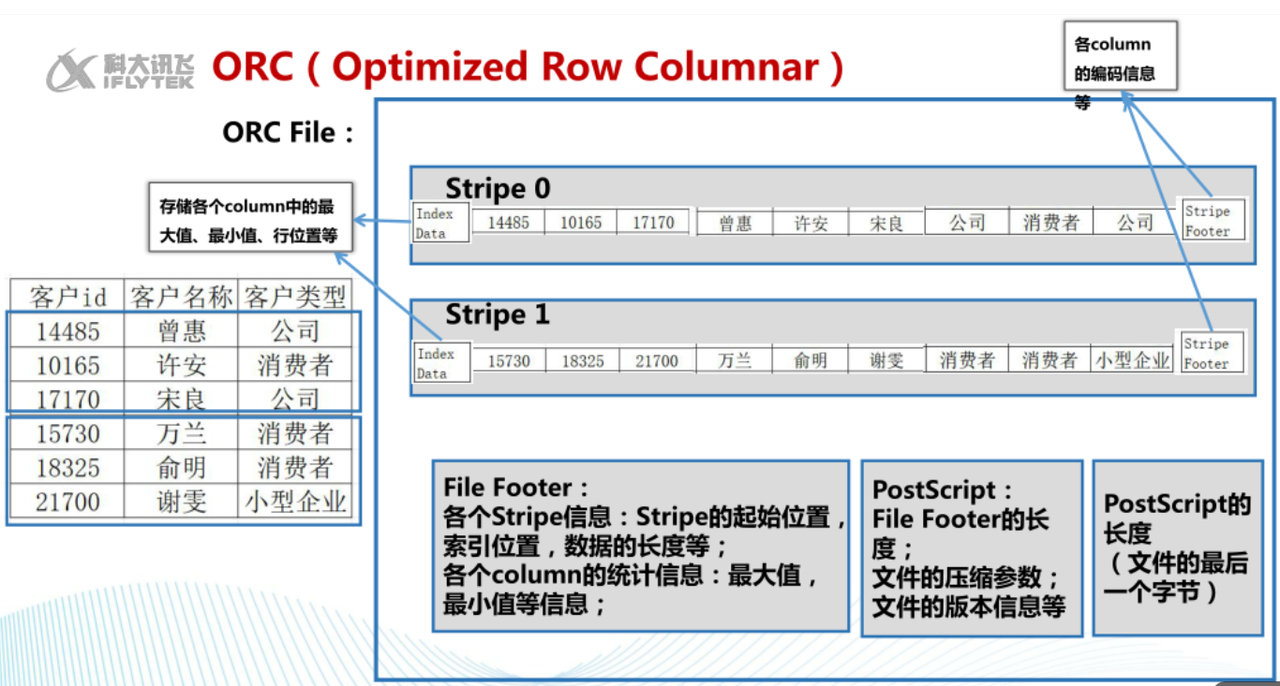
需要根据每个聚焦的字段找到对应每个列的值。列式存储,它存储的方式是采用数据按照行分块,每个块按照列存储。
特点:
1.对于查询内容之外的列,不必执行I/O和解压操作。
2.适合仅访问小部分的查询,如果查询的列很多,则行式存储更为合适。
3.列压缩的效率会更高,尤其是列中取值不多的时候。
4.数据仓库中经常会有在非常大的数据集上对某些列进行聚合的需求,列式格式非常符合这种场景的需要。
存储格式
-
为了提高查询性能,需要为Hive表中的数据选择合适的文件格式。
-
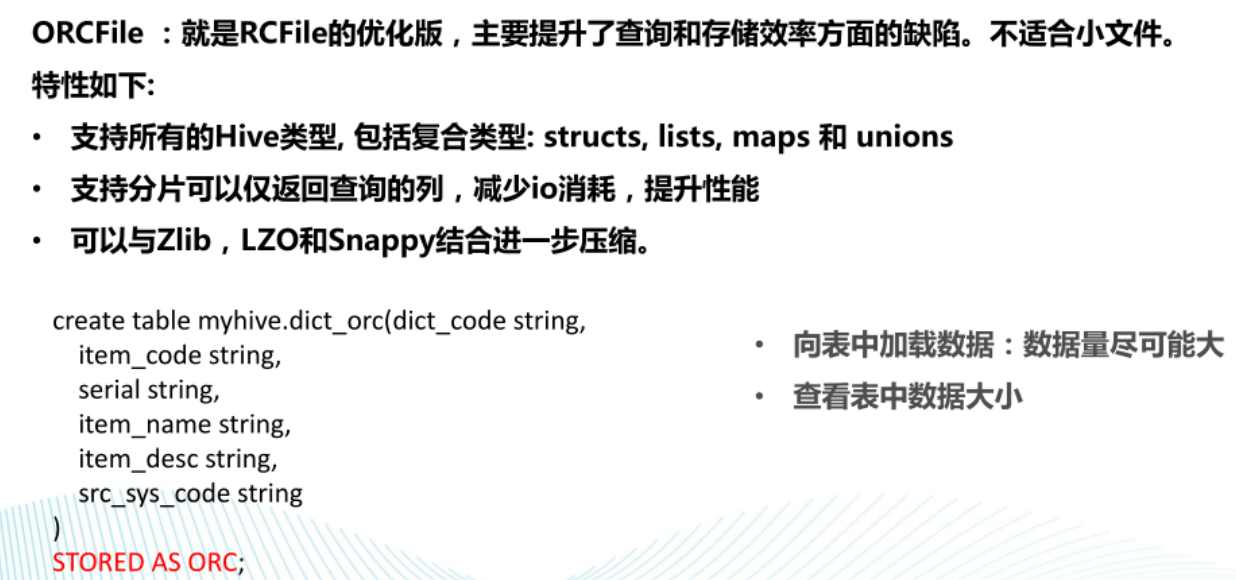
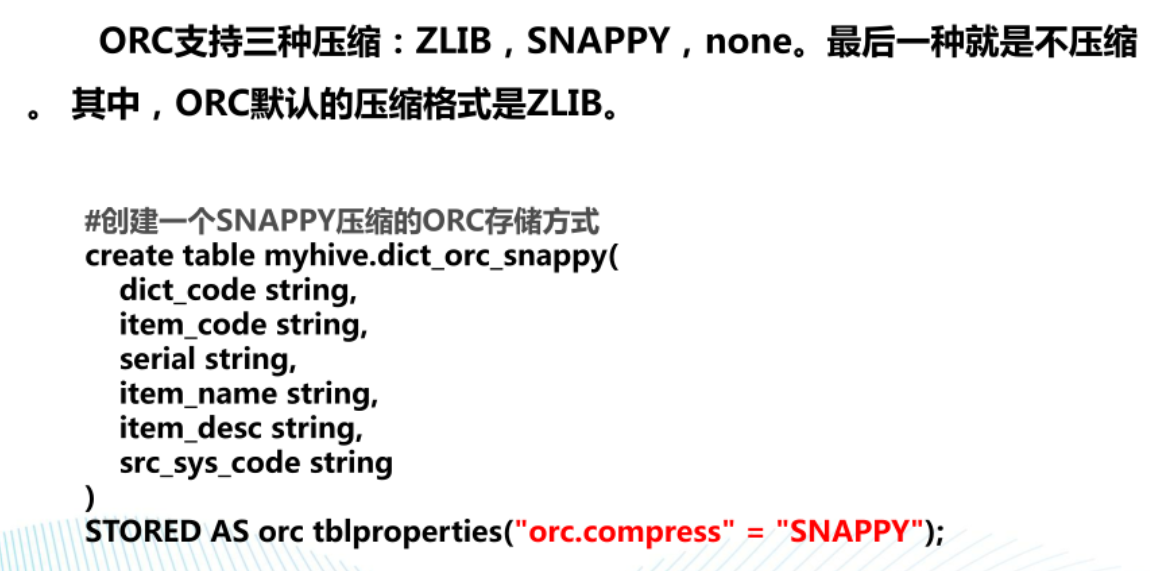
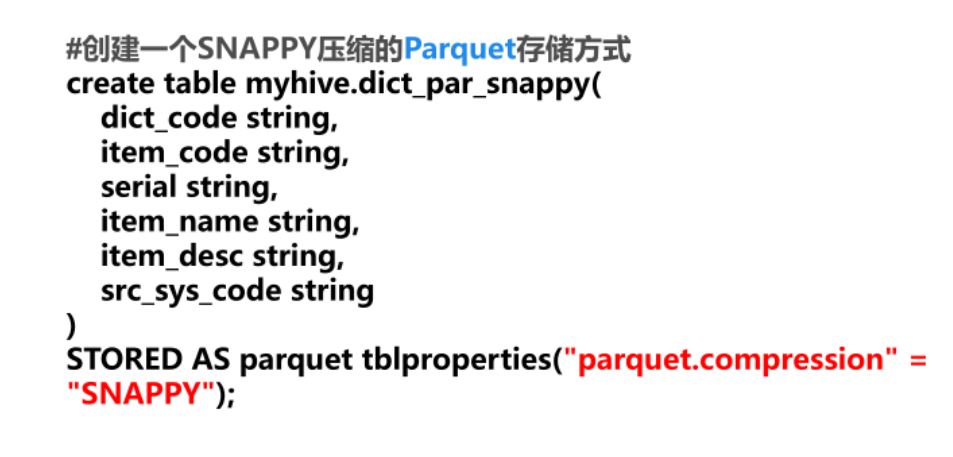
Hive表常用的存储格式主要包括:orc、parquet、textfile、sqeuencefile几种,存储格式一般会选择综合性能最好的orc或者parquet,这两种都是列式存储格式。
-
压缩格式一般会选择snappy、lzo、gzip,针对不同的应用场景使用不同的压缩方式。
常用的存储格式对比
TextFile
ORC(Optimized Row Columnar)
Parquet
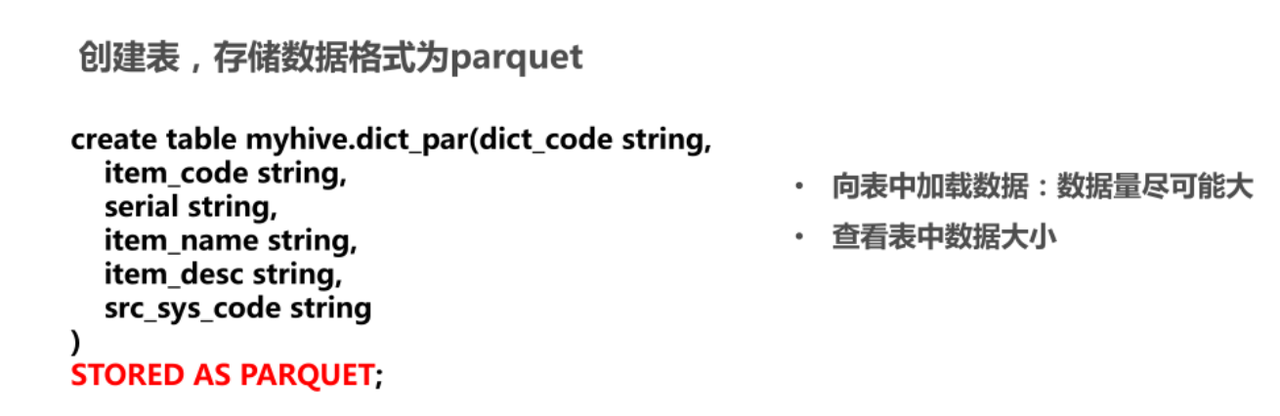
对比
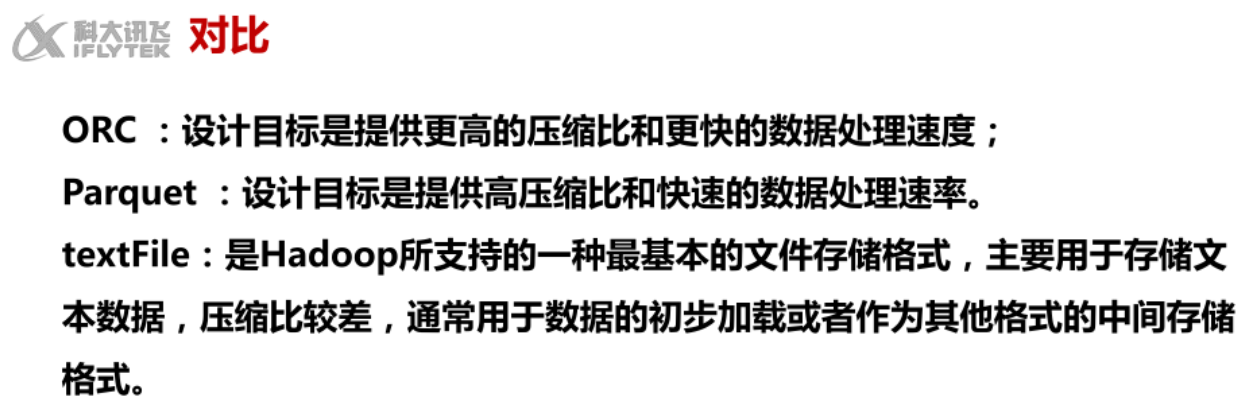
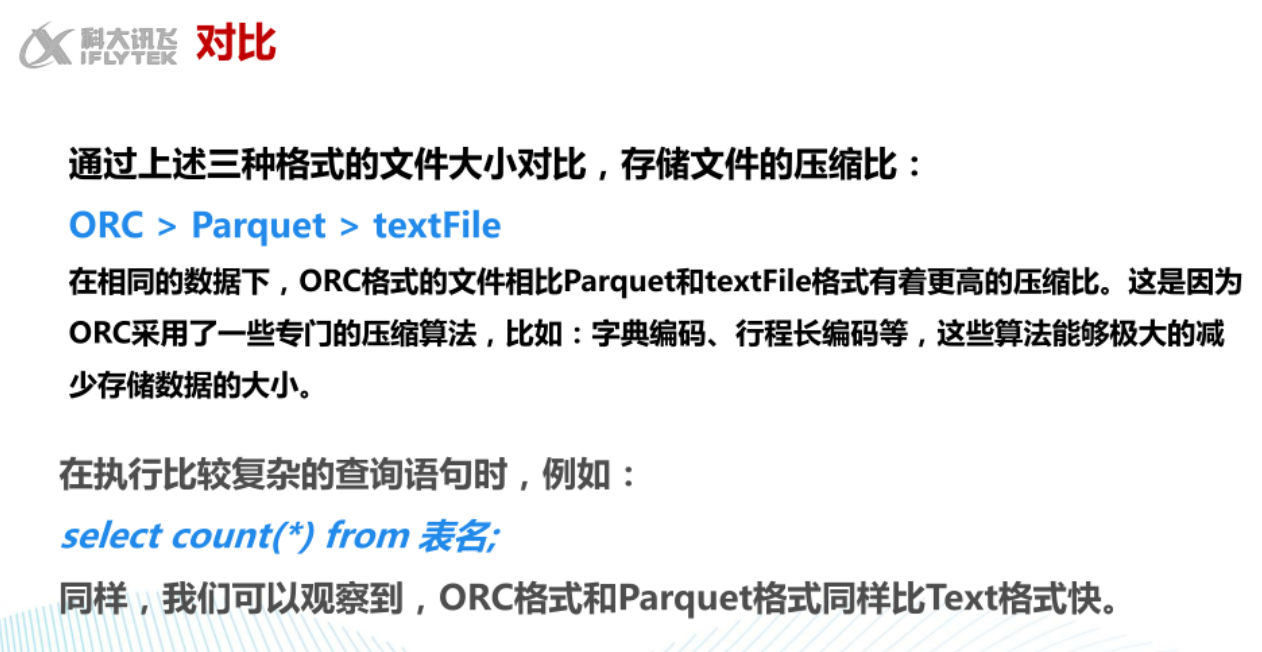
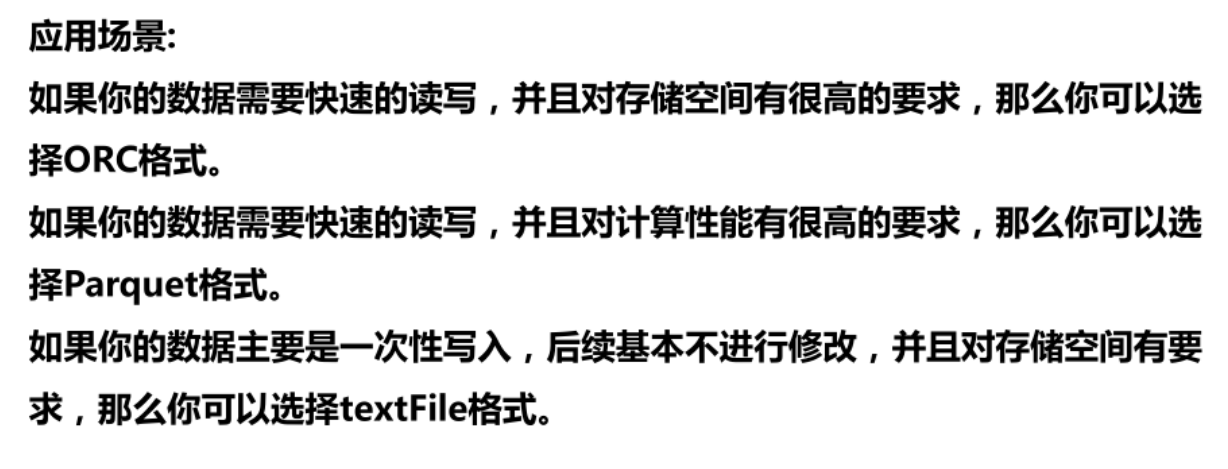
存储与压缩
Hive数据定义
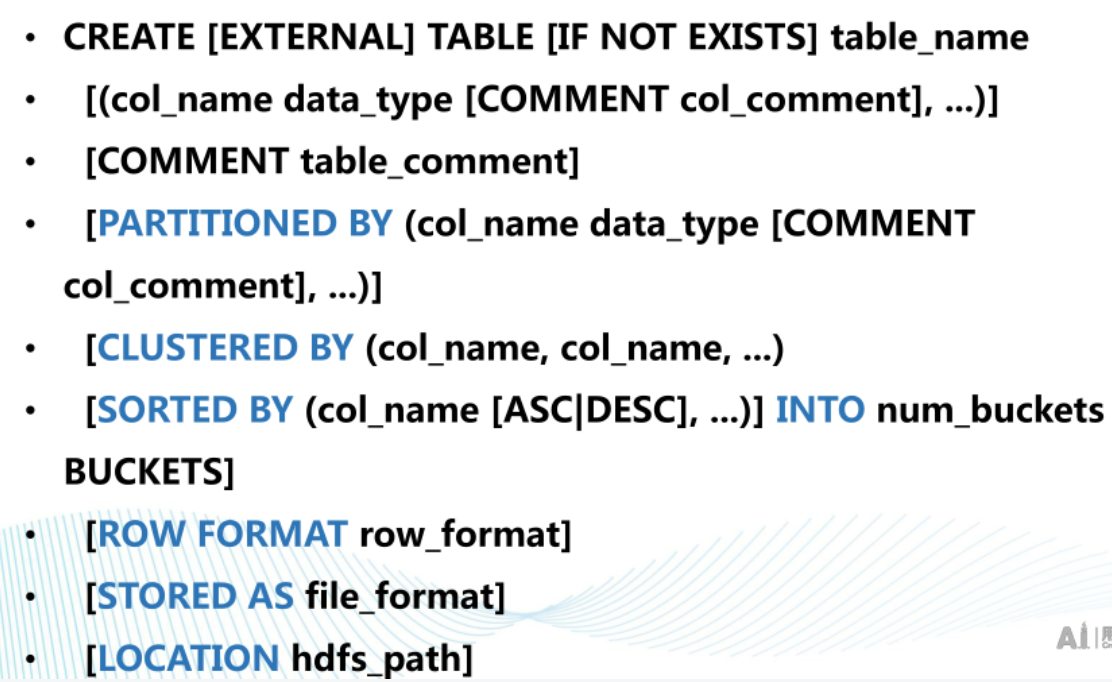
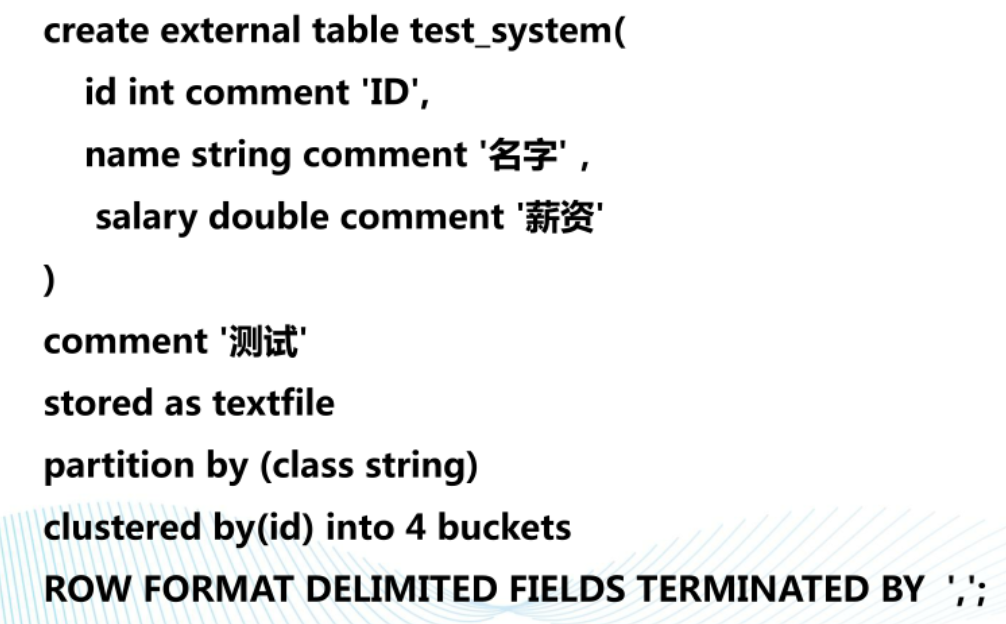
Hive表
Hive表的定义-举例
Hive内部表(Internal Table)
内部表是Hive管理的表,也叫托管表(MANAGED_TABLE)。
默认情况下,创建的表就是内部表。
特点:当删除内部表时,内部表的元数据和数据文件会被一起删除。
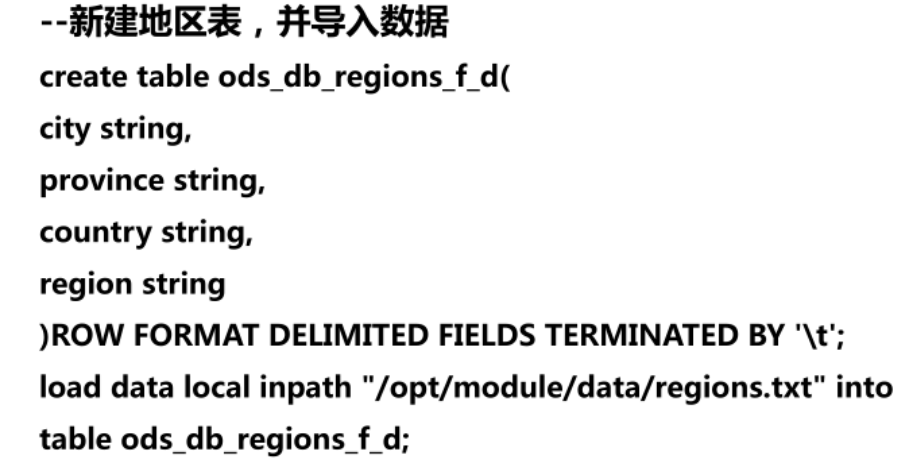
查询表的类型
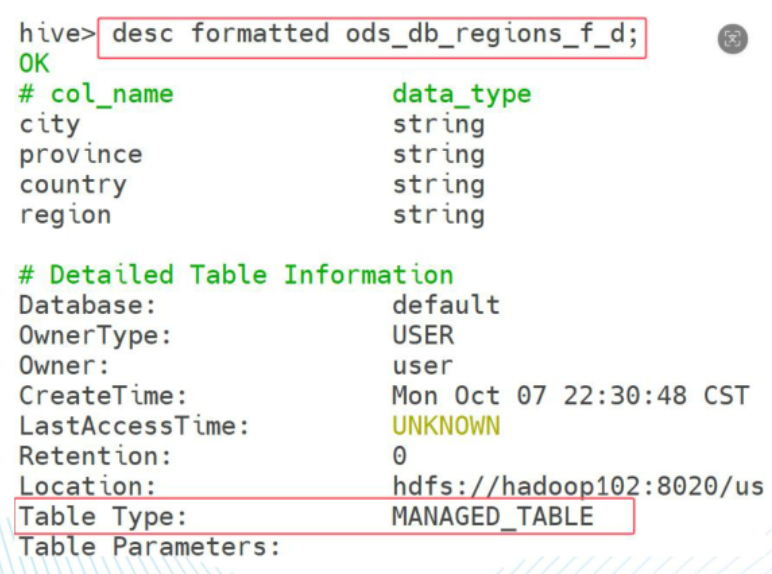
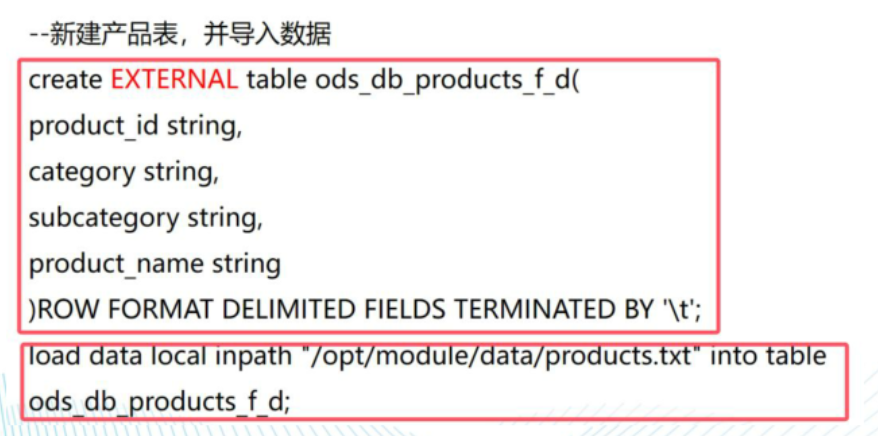
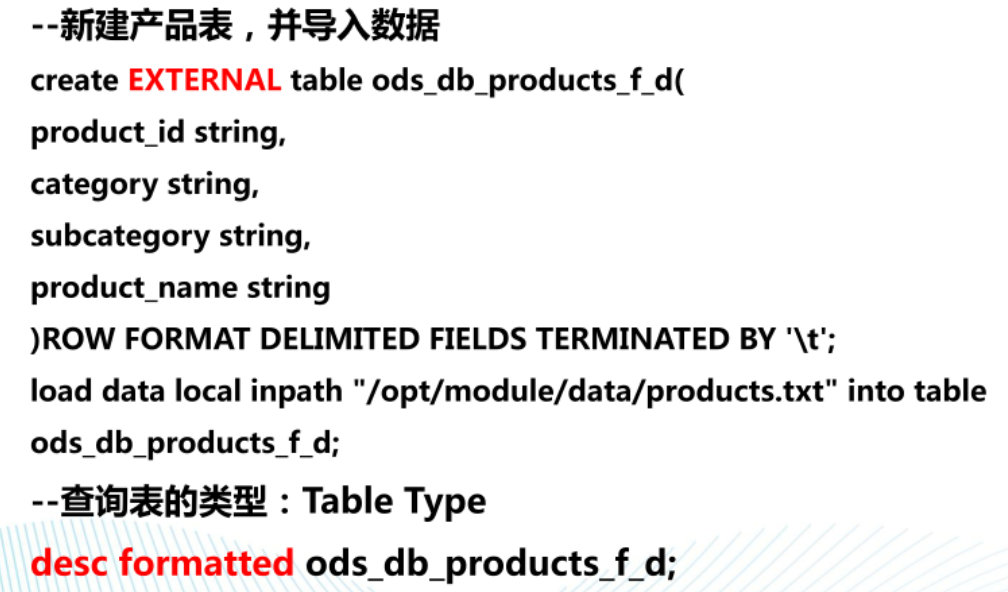
Hive外部表(External Table)
外部表,是通过External关键字创建的表。
特点:当删除外部表时,不会删除表的数据文件,只删除对应表的元数据信息。
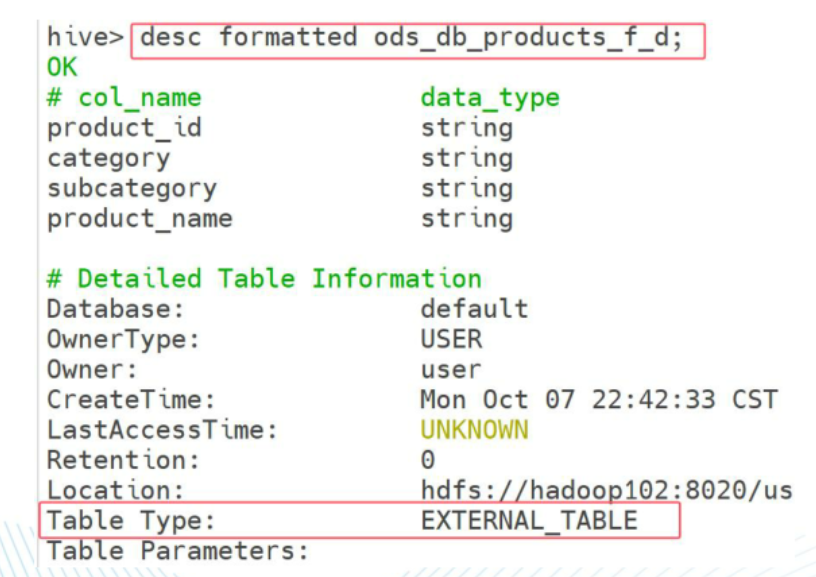
内部表和外部表的转换
外部表转为内部表:
修改外部表ods_db_products_f_d为内部表
alter table ods_db_products_f_d set tblpropertities('EXTERNAL' = 'FALSE');
查询表的类型
desc formatted ods_db_products_f_d;

注意:('EXTERNAL' = 'FALSE')和('EXTERNAL' = 'TRUE')为固定写法,区分大小写!
内部表转为外部表
修改内部表ods_db_products_f_d为外部表
alter table ods_db_products_f_d set tblpropertities('EXTERNAL' = 'TRUE');
查询表的类型
desc formatted ods_db_products_f_d;
内部表和外部表的应用场景
1.当需要通过Hive完全管理控制表时,就使用内部表。比如,在做统计分析时用到的中间表、结果表可以用内部表,因为这些数据不需要共享。
2.查询表的类型当数据比较重要,为了防止误删而使用外部表。因为即使删除表,文件也不会被删除。例如,每天对收集的数据,做大量的统计分析,数据源可使用外部表进行存储,方便数据的共享。
分区
分区产生的背景
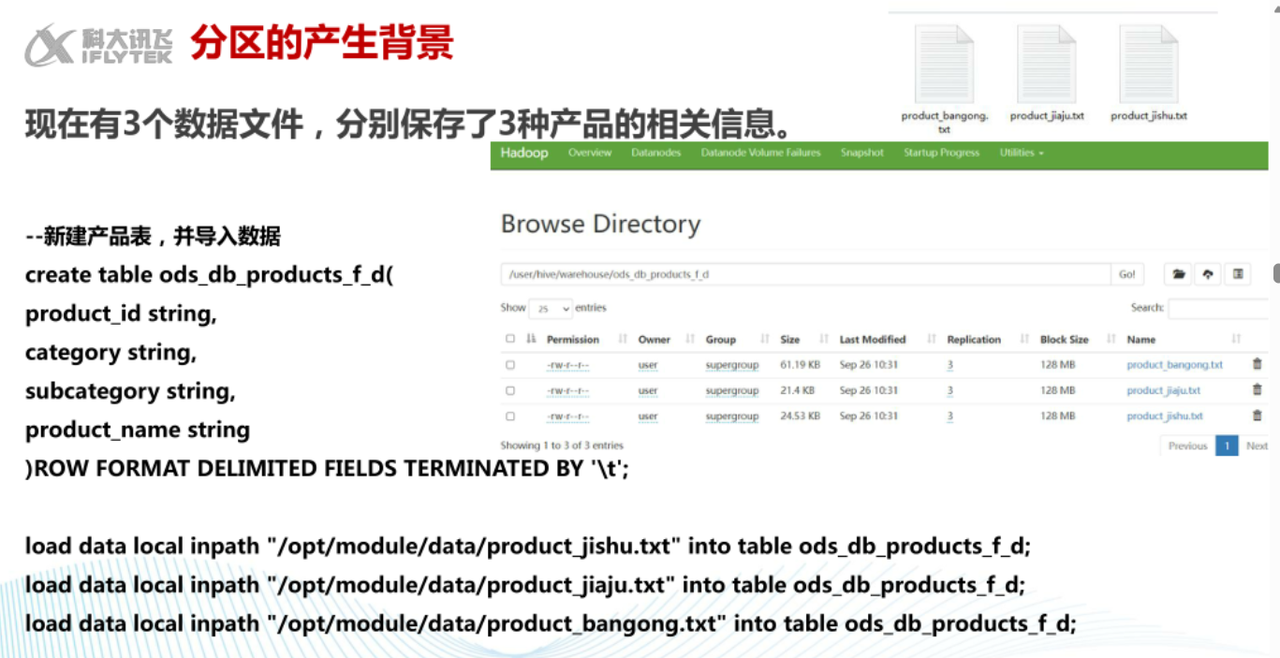
业务需求:要求查询产品类型是技术的复印机个数
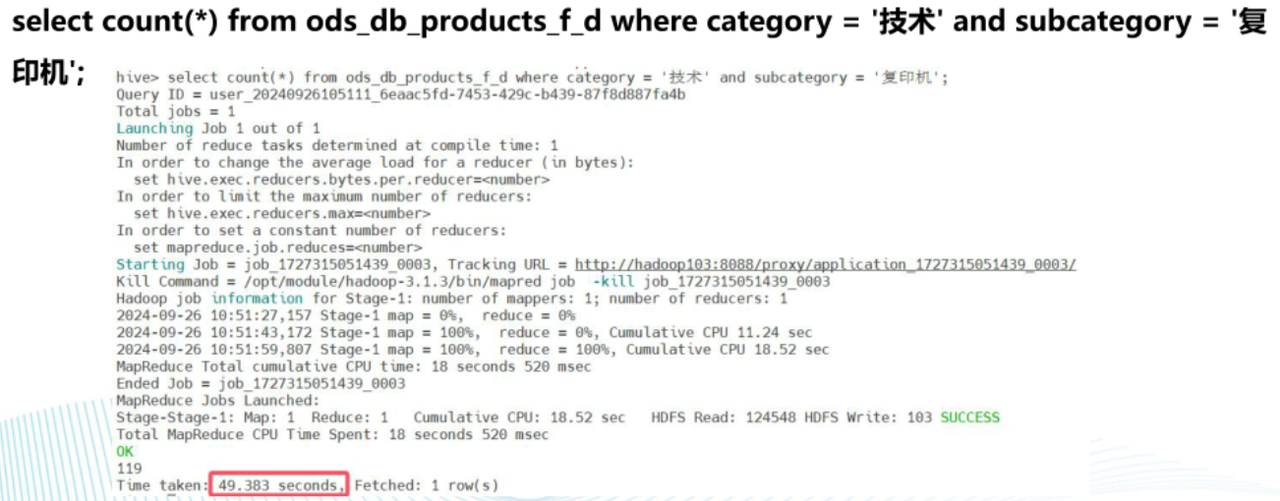
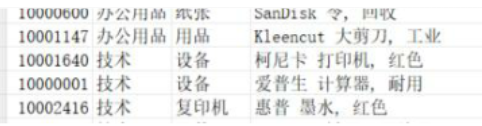
1.where条件逻辑:进行全表扫描,过滤对应结果,如果表数据特别多,扫描效率很差;
2.其实只通过扫描product_jishu.txt文件就可以,那么怎么优化提升查询效率?
结论:扫描指定的文件,避免全表扫描。
分区的概念
分区:面对数据量大,文件个数多,为了对表进行合理的管理以及提高查询效率,Hive根据指定字段将表进行"分区"。
分区字段,可以是日期、地区、类别等具有标识意义的字段。
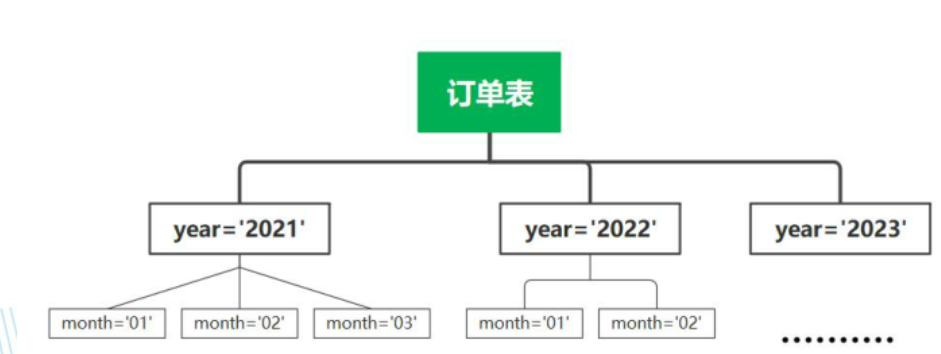
分区是将列值作为目录来存放数据,就是一个分区。这样查询时使用分区列进行过滤,只需根据列值直接扫描对应目录下的数据,不扫描其他不关心的分区,快速定位,提高查询效率。
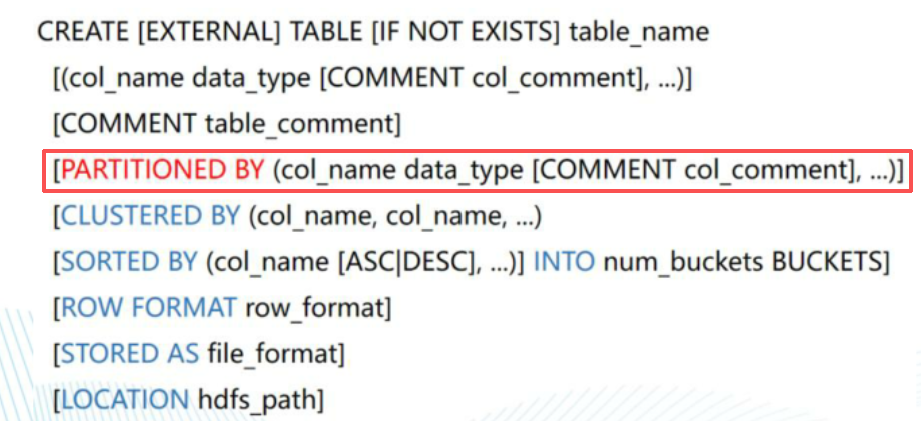
分区类型
Hive中支持两种类型的分区:静态分区SP(static partition)、动态分区DP(dynamic partition)。
静态分区与动态分区的主要区别在于:静态分区需要手动指定,动态分区是通过数据来进行判断。进一步讲,静态分区的列是在编译时期,通过用户传递来决定的;动态分区只有在SQL执行时才能决定。
静态分区
静态分区是指在插入或者导入时需要指定具体的分区。创建时,需在PARTITIONED BY后面跟上分区字段,分区类型。例如:
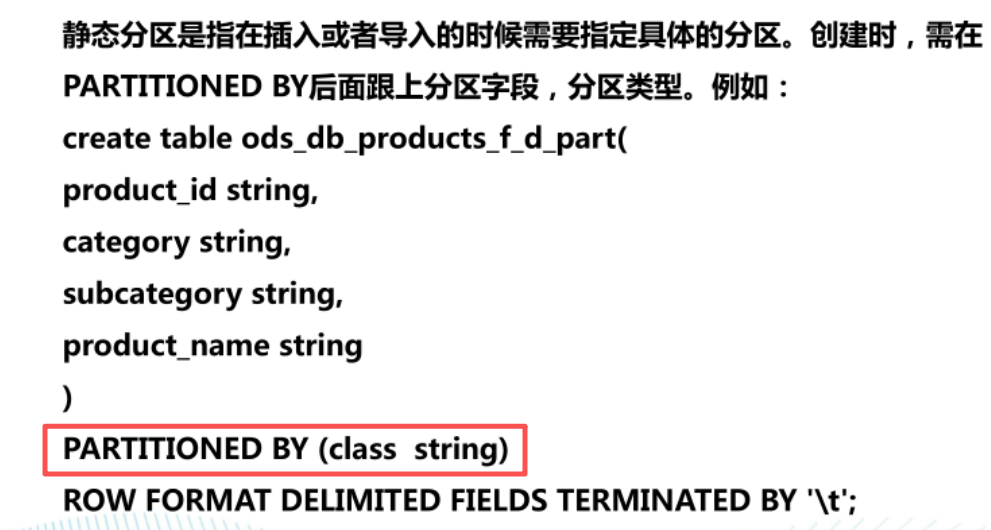
注意:分区字段不能和建表语句内字段重复!
静态分区是指在插入或者导入时需要指定具体的分区。
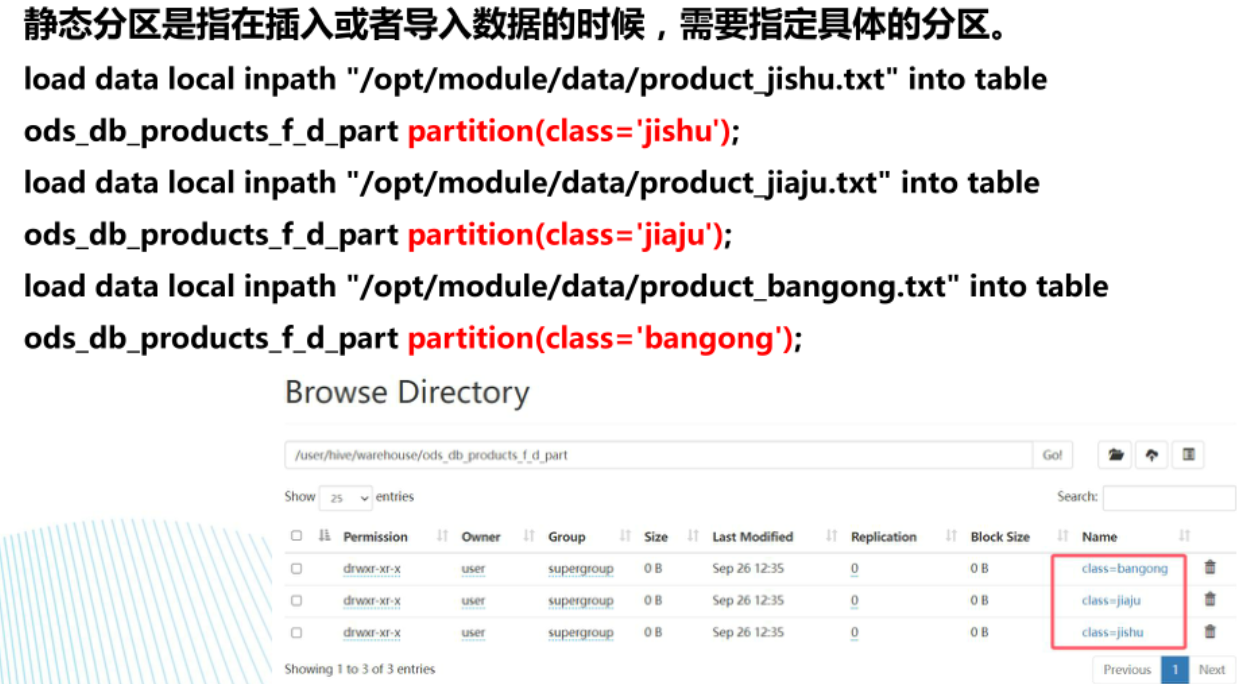
上面是一级分区当然也可以创建多级分区。例如:
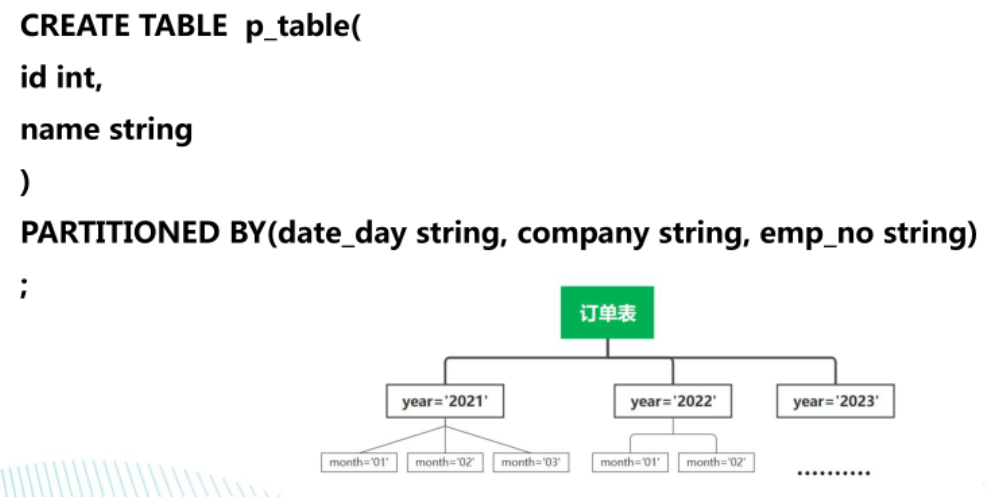
数据插入:
静态分区插入数据:
insert overwrite table p_table partition(date_day='2025-9-15')values(1,'Lucy');
插入新的数据,追加的形式:
insert into table p_table partition(date_day='2025-9-15')values(2,'Tom');
查看分区,删除分区:
查看所有分区
show partitions p_table;
查看某个分区
show partitions p_table(date_day='2025-9-15')
删除某个分区
alter table p_table drop p_table(date_day='2025-9-15')
删除范围内的分区
alter table p_table drop p_table(date_day>='2025-9-15')
动态分区
创建方式与静态分区表完全一样,一张表可同时被静态和动态分区键分区,只是动态分区键需要放在静态分区键的后面(因为HDFS上的动态分区目录下不能包含静态分区的子目录)。
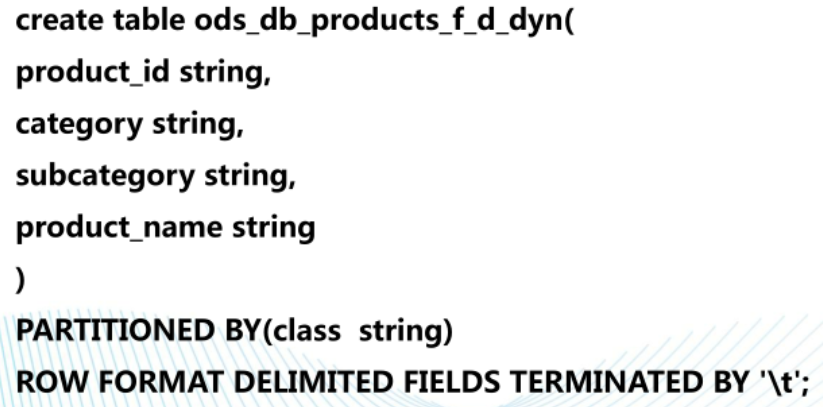
动态分区插入数据时需要开启动态数据支持:
set hive.exec.dynamic.partition=true;
set hive.exec.dynamic.partition.mode=nostrict;
插入数据:
insert into table ods_db_products_f_d_dyn partition(class)
select t.*,t.category from ods_db_products_f_d t;
分区并没有写死,而是根据查询到的结果动态创建分区。
分区表总结
1.分区只是一种优化手段,不是建表必须要执行的;
2.分区字段不能是表中已经存在的字段;
3.静态分区:分区字段的值需要手动执行;
动态分区:分区字段是根据查询结果自动推断;
4.Hive支持多重分区,根据业务判断是否继续分区;
分桶
分桶概念及优点
分桶规则:
对分桶字段值进行哈希,哈希值除以桶的个数求余,余数决定了该条字段在哪个桶中,也就是余数相同的在一个桶中。
优点:
1.提高join查询效率
2.提高抽样效率
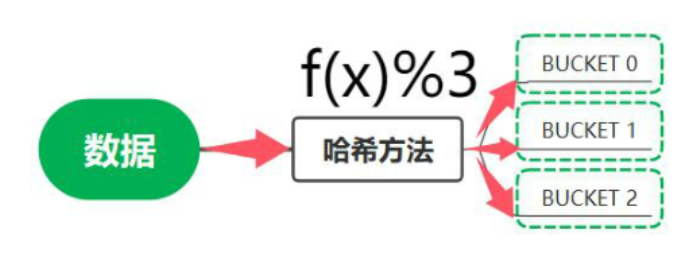
分桶表创建
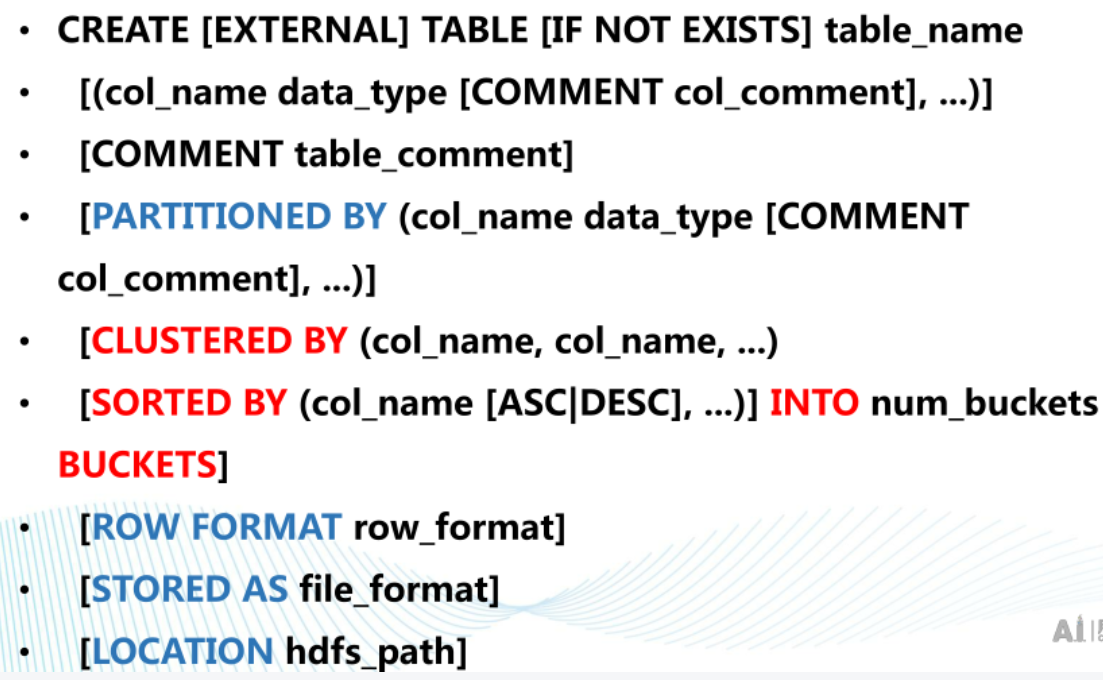
通过CLUSTERED BY(字段名)into bucket_num buckets分桶,意思是根据字段名分成bucket_num个桶。
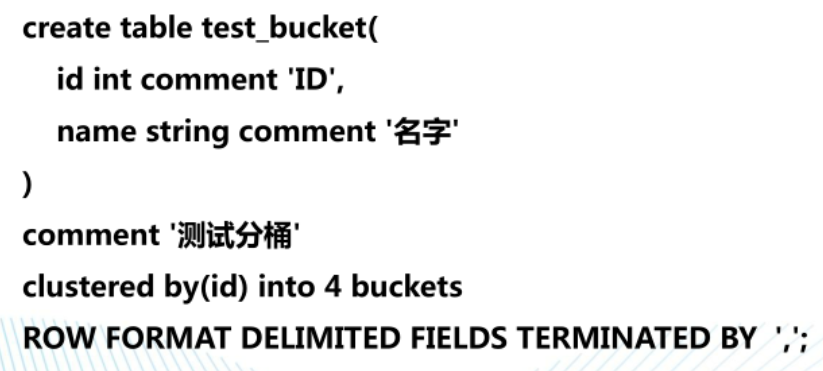
插入数据
注意:直接load data不会有分桶的效果,这样和不分桶一样,在HDFS上只有一个文件。
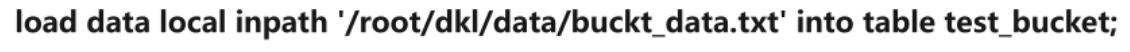
需要借助中间表:
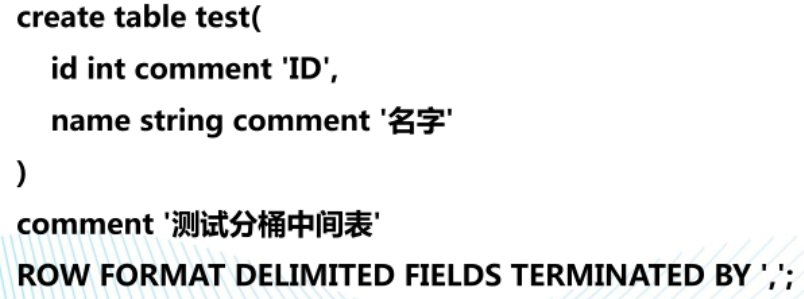
先将数据load到中间表
然后通过下面的语句,将中间表的数据插入到分桶表中,这样会产生四个文件。

注:HDFS中桶是以文件的形式存在的,而不是像分区那样以文件夹的形式存在。
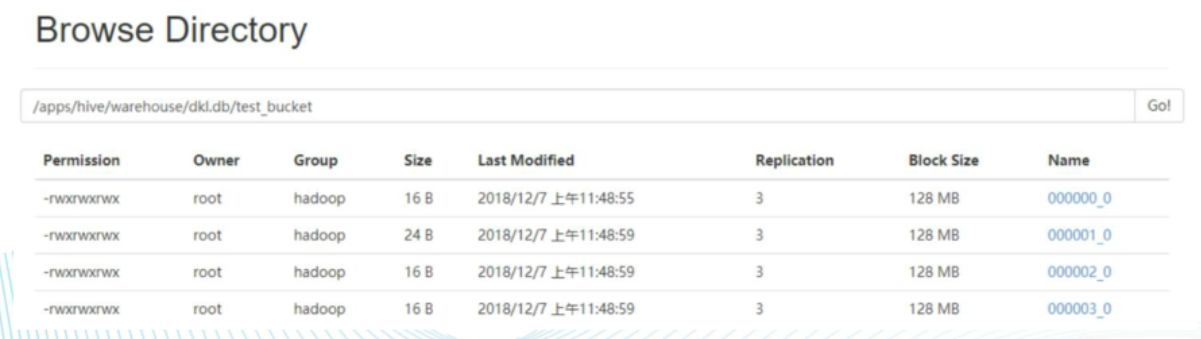
桶排序
上一个步骤中创建的表每个桶内是没有排序的,如果希望数据有序入桶,比如:按照ID排序。需要重新创建表结构,如下所示:
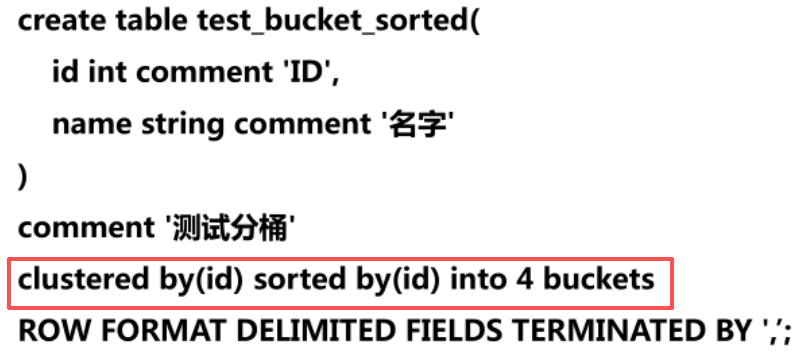
好处:因为每个桶内的数据是排序的,这样每个桶进行连接时就变成了高效的归并排序。
使用场景
假设表A和表B进行join,join的字段为id
条件:
1.两个表为大表
2.两个表都为分桶表
3.A表的桶数是B表桶数的倍数或因子
这样join查询的时候,表A的每个桶都可以和表B对应的桶直接join,而不用全表join,提高查询效率。
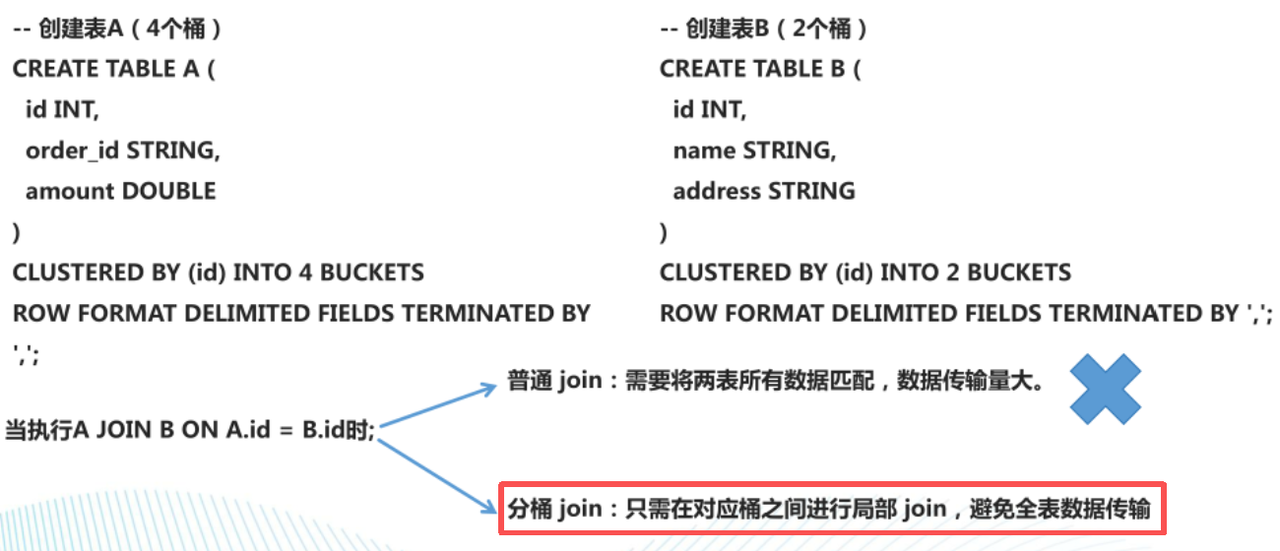
表的分桶由CLUSTERED BY(id)INTO N BUCKETS定义,其中N是桶数
每条数据的id会通过哈希函数的计算得到一个哈希值,再对桶数N取模,决定该数据放到哪个桶:
因为A有4个桶:表A的桶编号 = hash(id)%4
因为B有2个桶:表B的桶编号 = hash(id)%2
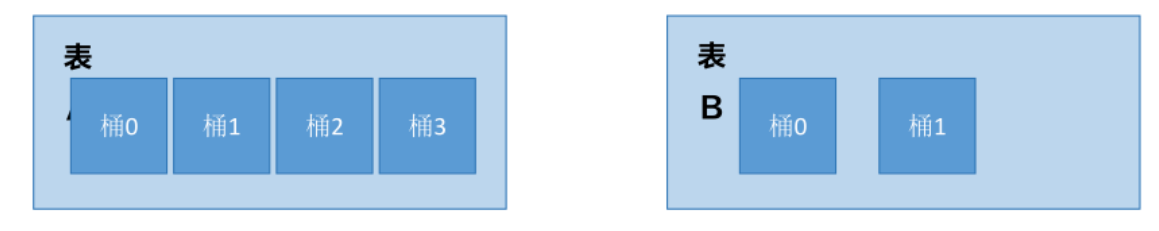
表A桶0、2对应表B桶0,(因为hash(id)%4=0或2时,hash(id)%2=0)
表A桶1、3对应表B桶1,(因为hash(id)%4=1或3时,hash(id)%2=1)
HiveSQL
Hive SQL查询
SELECT基本查询
select查询语句语法格式
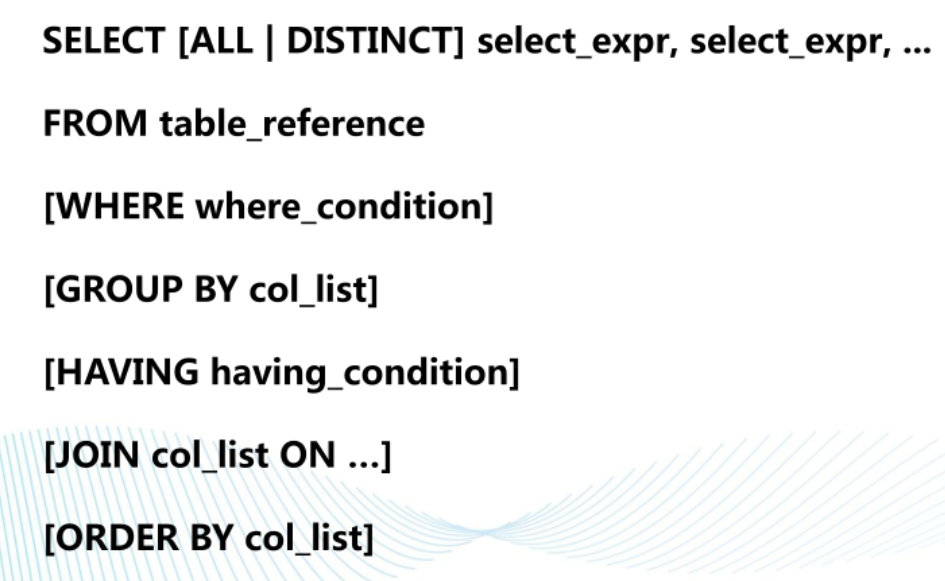
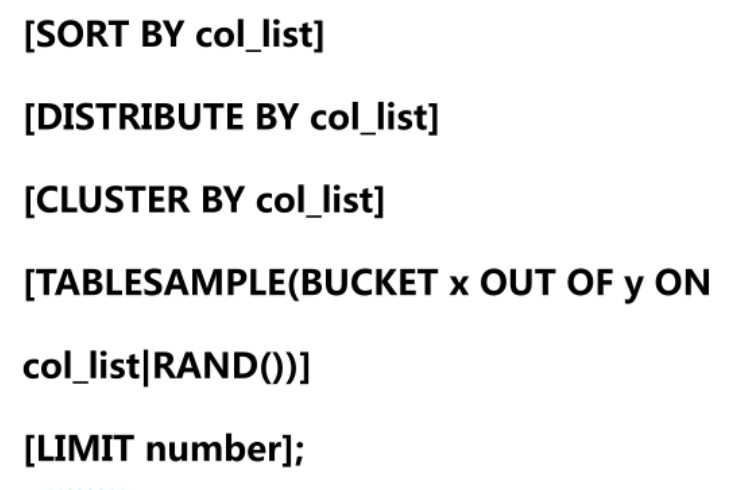
注意:
1.HQL语言对大小写不敏感;
2.HQL语句可以写在一行或者多行;
3.关键字不能被缩写也不能分行;
4.各子句一般要分行写;
5.使用缩进提高语句的可读性;
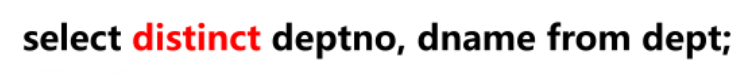
all | distinct
1.不去重,全部显示,默认就是all
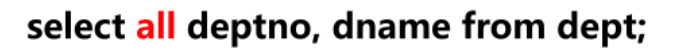
2.distinct:去重操作(只显示第一次出现的记录)
select_expr
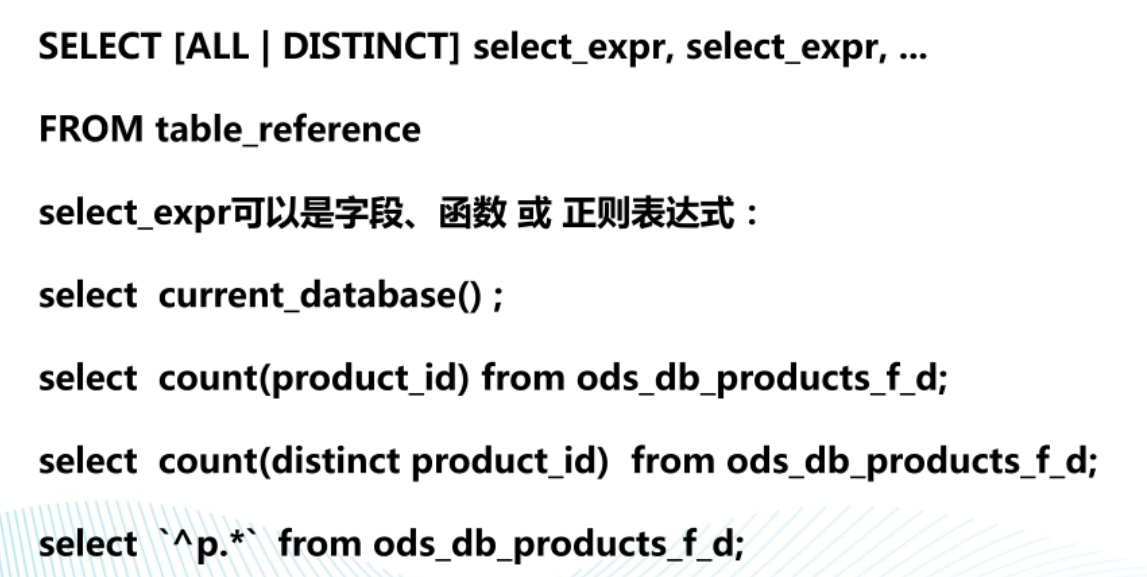
select_expr可以是字段、函数或正则表达式
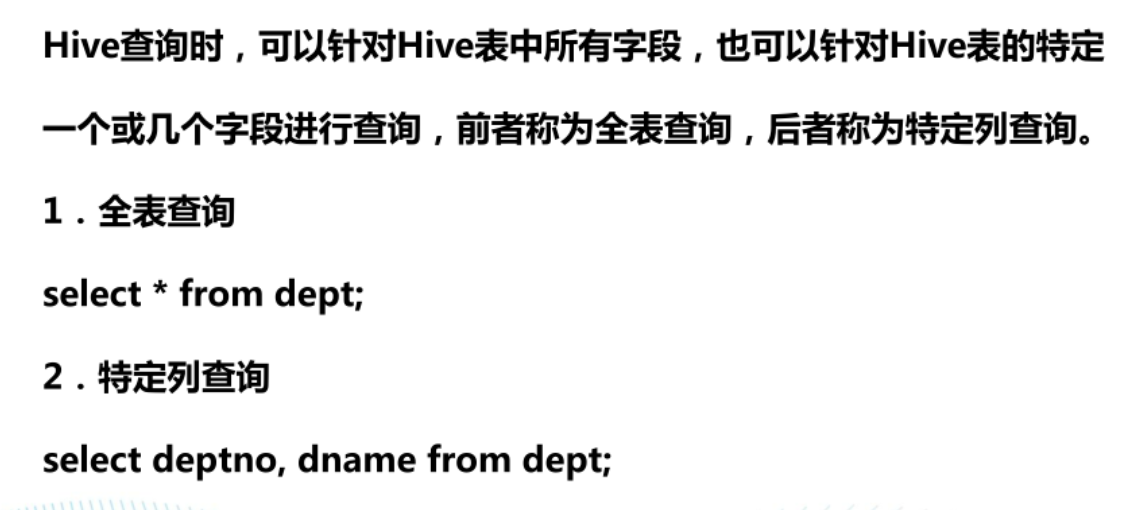
全表和特定列查询
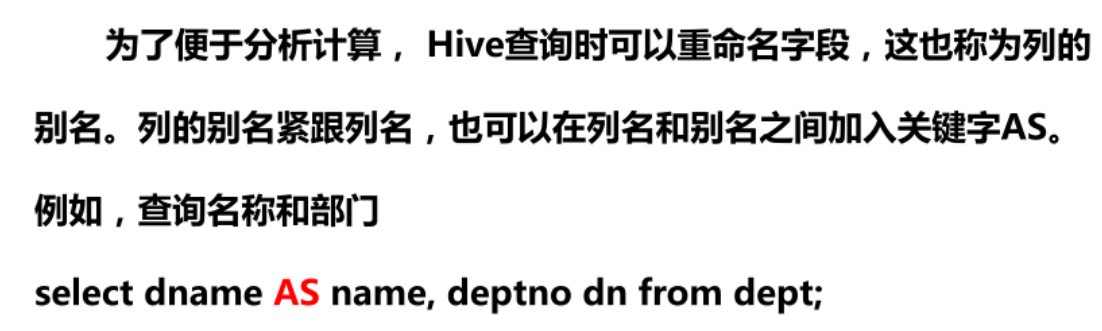
列的别名
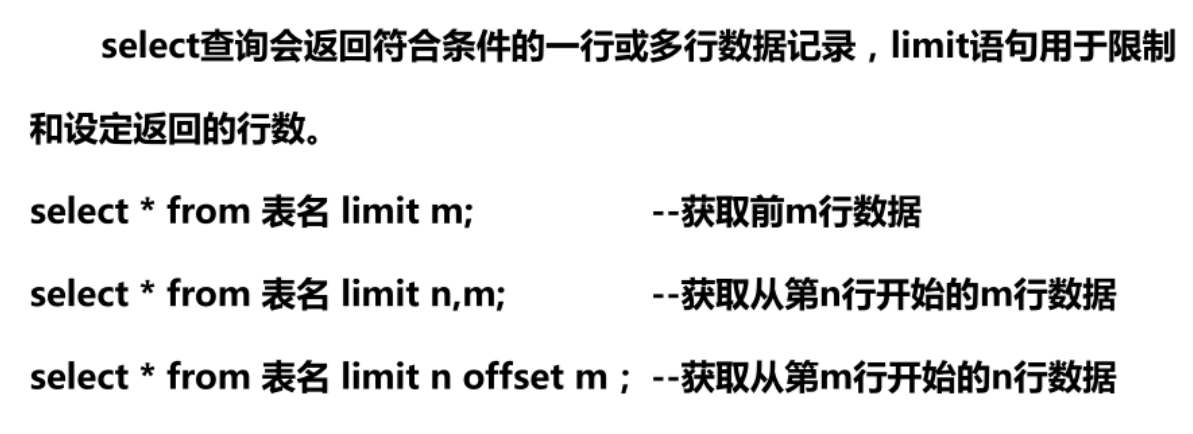
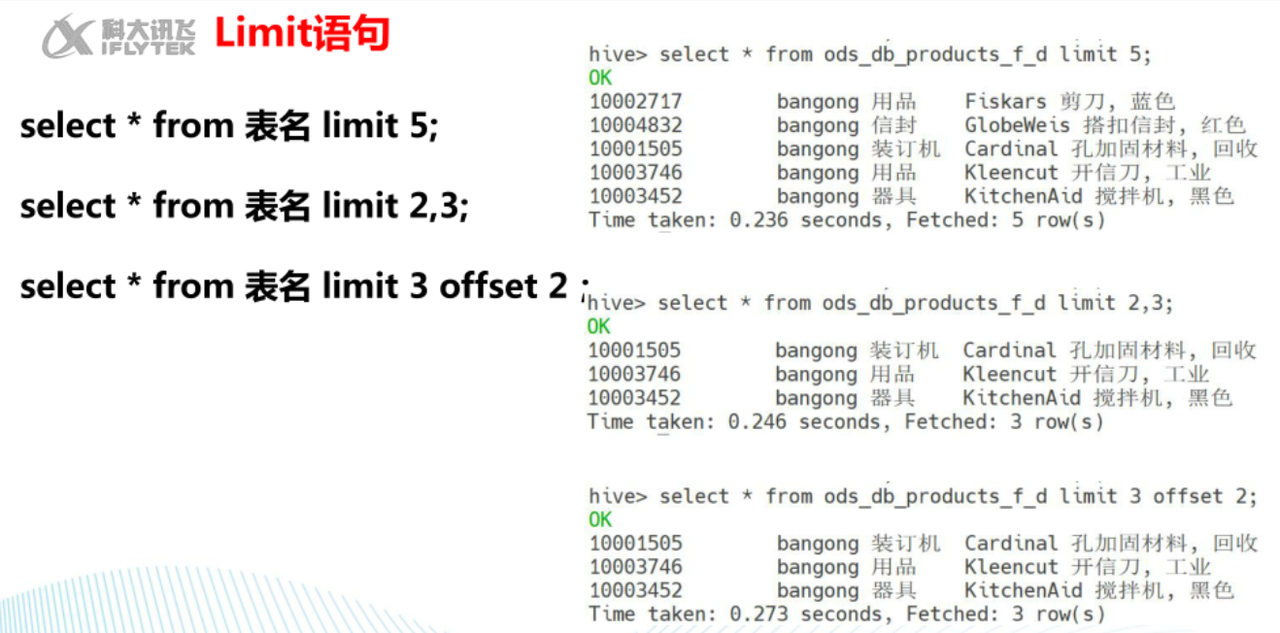
limit语句
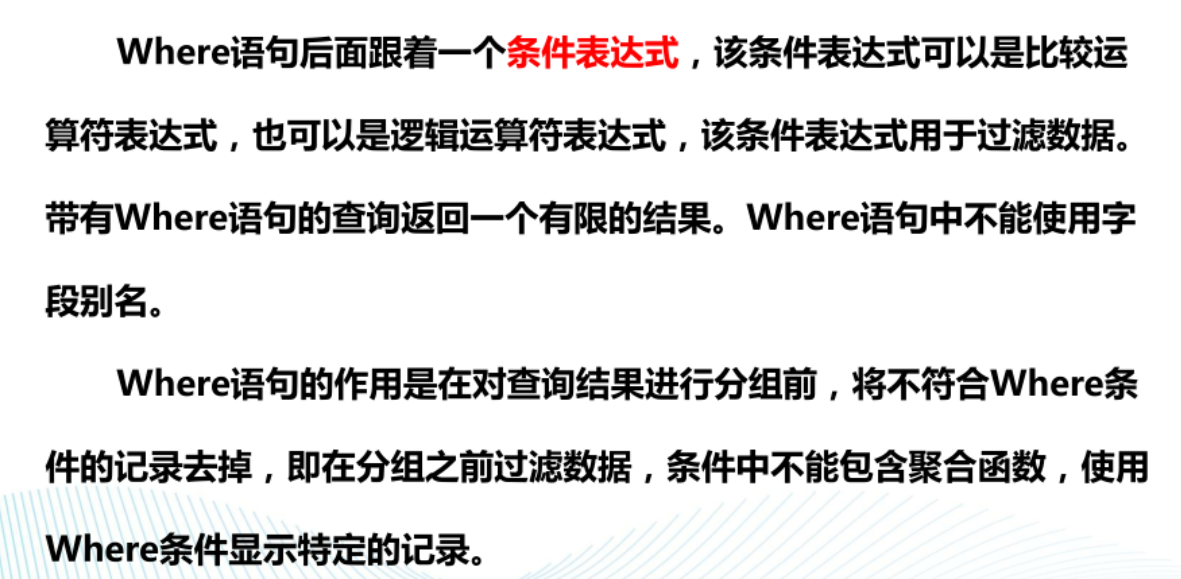
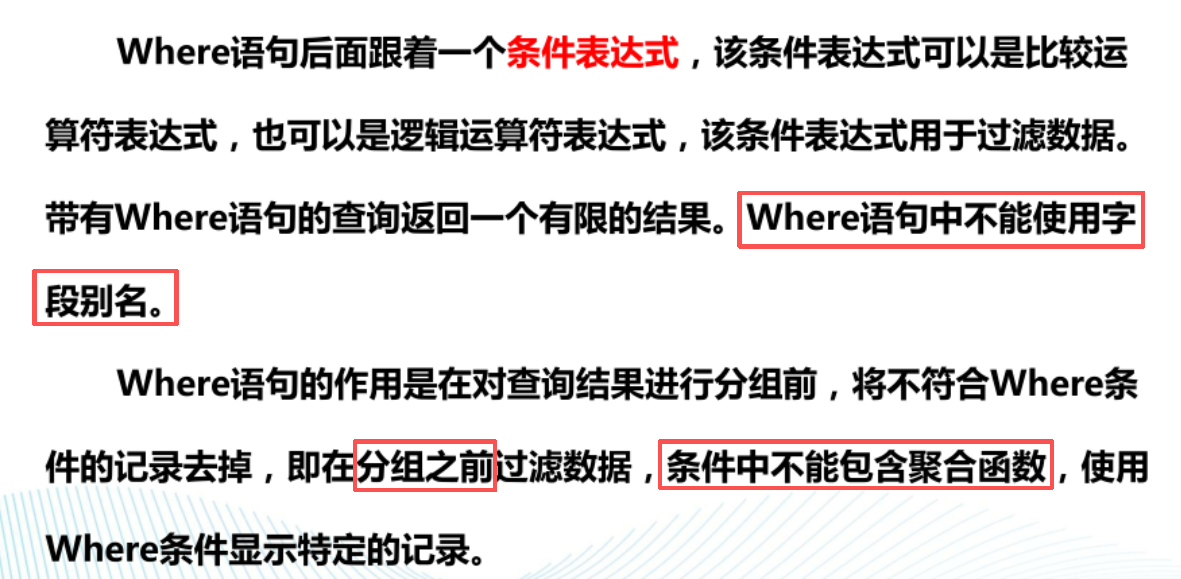
Where语句
Hive运算符
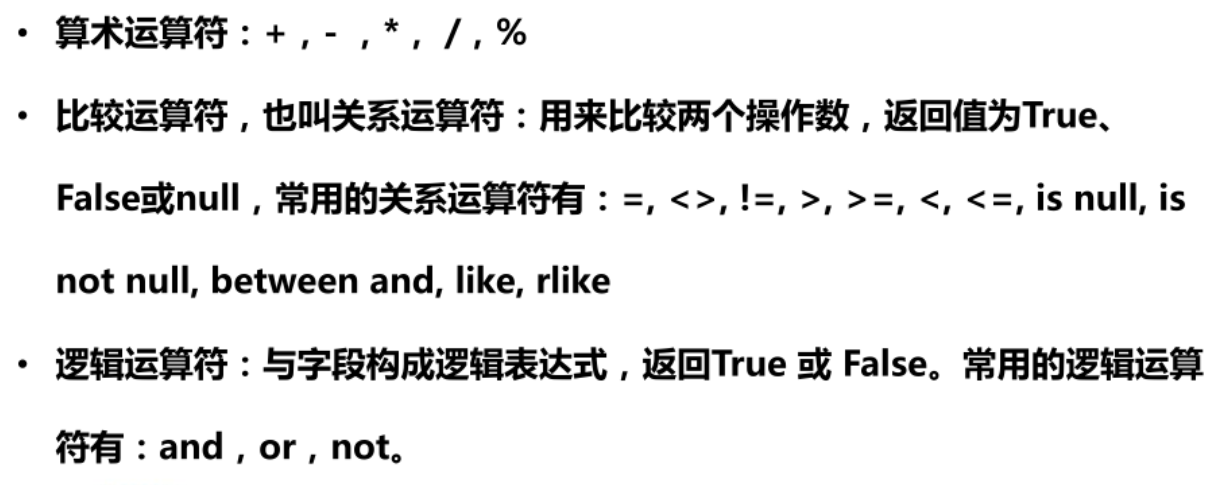
比较运算符
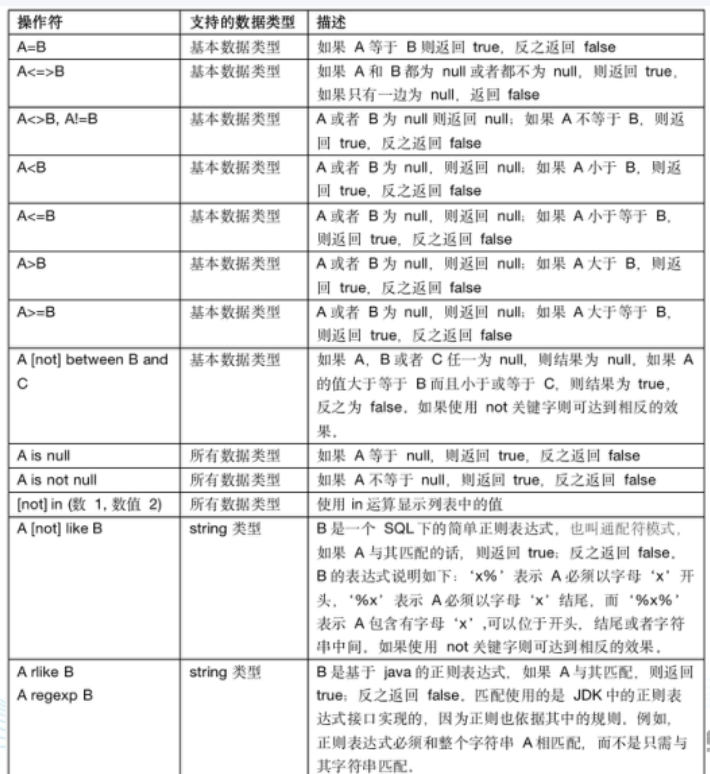
比较运算符的应用
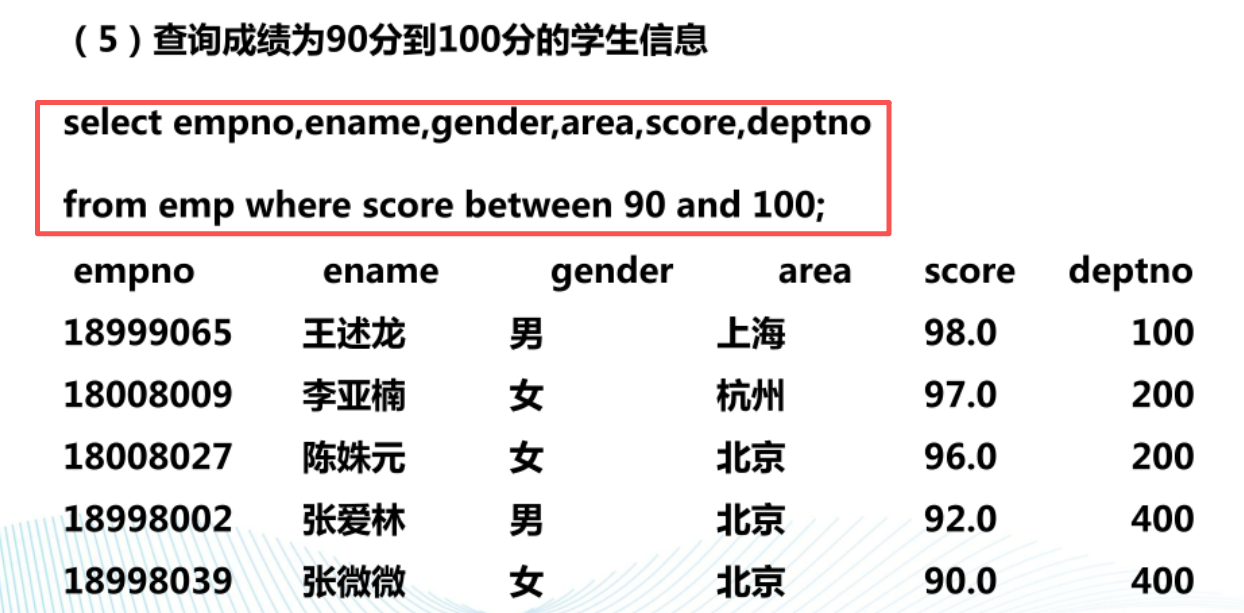
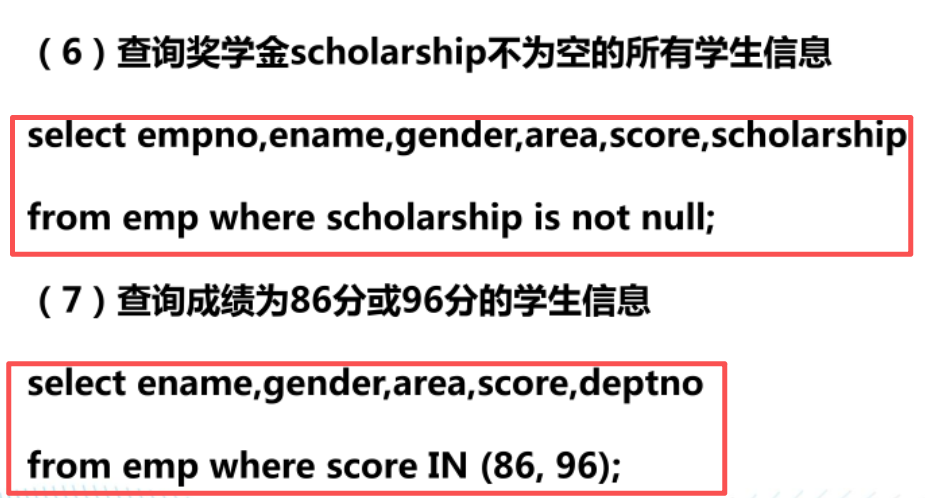
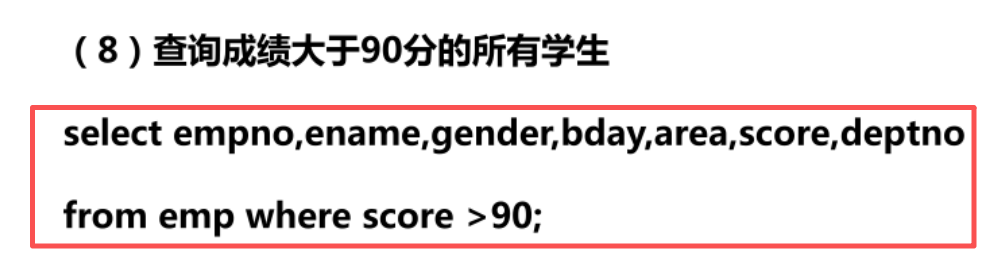
1.需求:创建学生emp外部表,向外部表中导入数据,并应用比较运算符做简单查询。
2.数据准备:
(1)原始数据
emp表中数据见下表
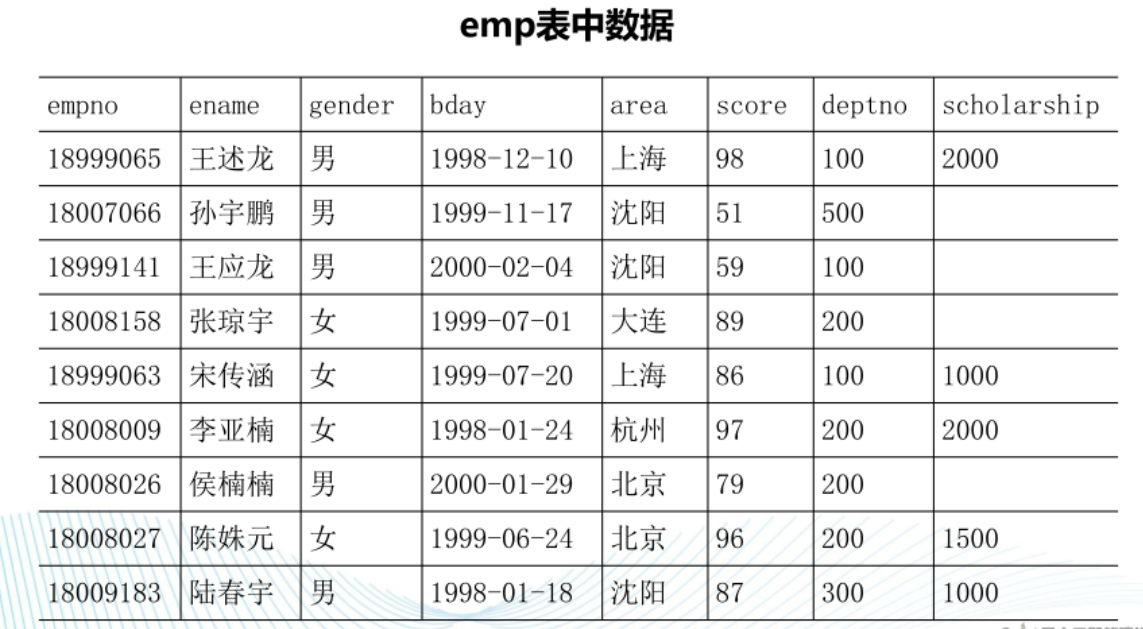
(2)创建本地数据文件emp.txt
vim emp.txt
将表中数据导入其中,然后保存并退出。
3.Hive实例操作
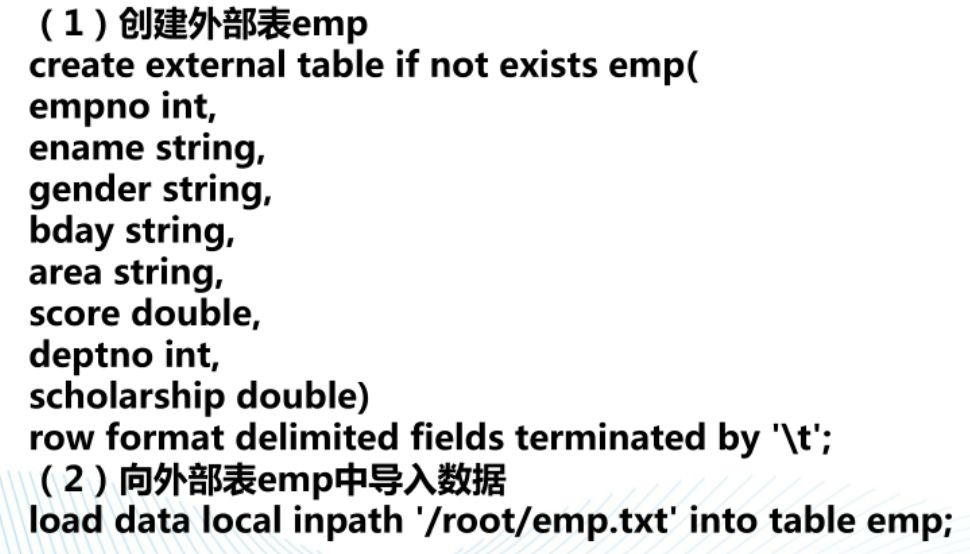
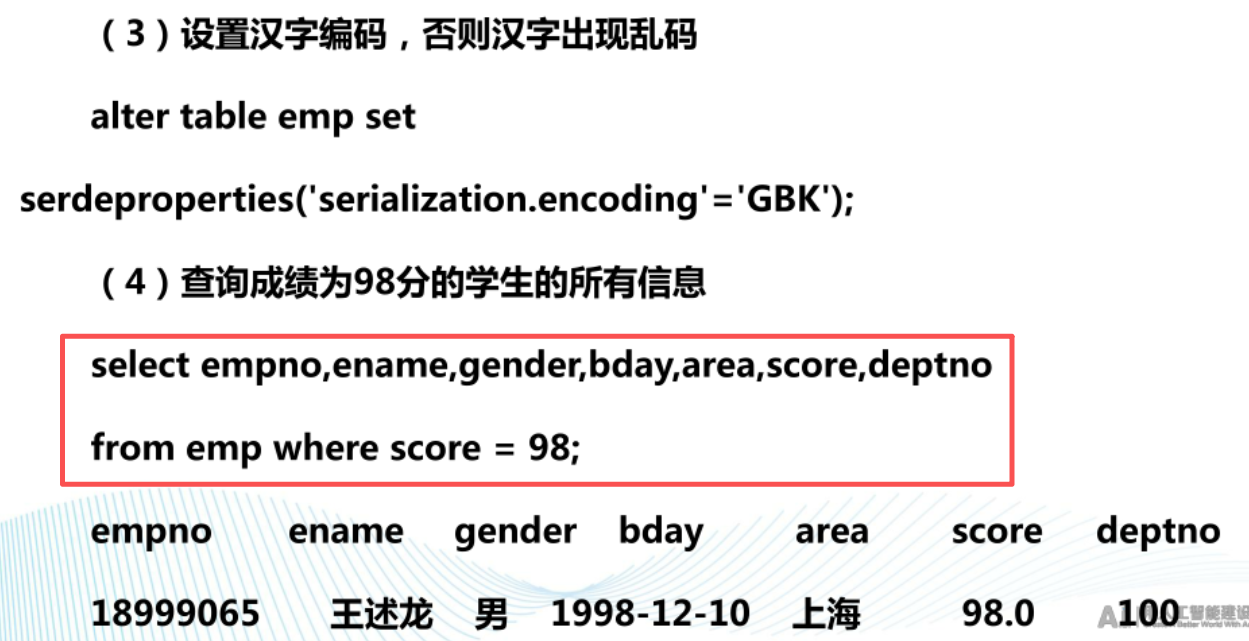
Like的使用
1.语法格式
语法格式为:A Like B
其中A是Hive中表的字段名称,B是表达式,表示能否用B去完全匹配A的内容,换句话说,能否用B这个表达式去表示A的全部内容。返回的结果是True或False。
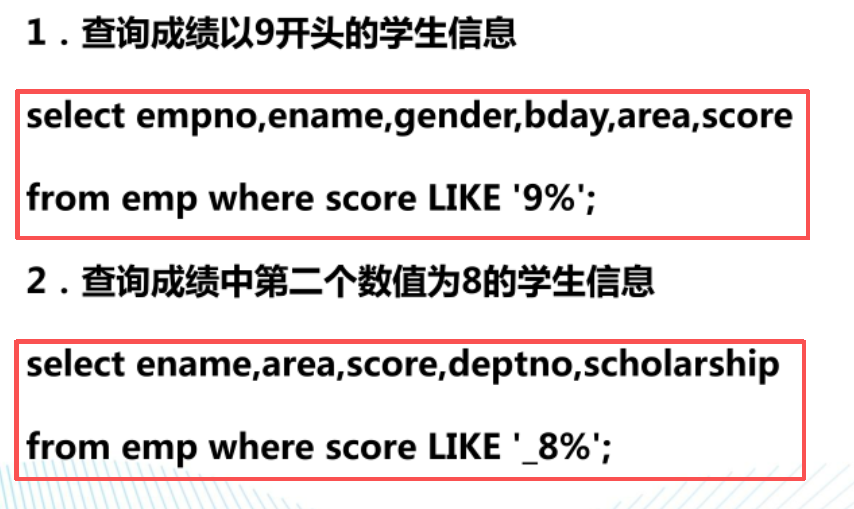
B只能使用简单的匹配符,"_"和"%",字符"_"表示任意单个字符,"%"表示任意数量的字符。Like的匹配是按字符逐一匹配的,使用B从A的第一个字符开始匹配,所以即使有一个字符不同都不能完全匹配。
Not A Like B是对Like的结果否定如果Like的匹配结果是True,那么Not...Like...的结果就是False。实际中也可以使用A Not Like B,也是对Like的否定,与前者一样。当然要排除出现Null问题,Null值除外,Null的结果都是Null值。
Like应用
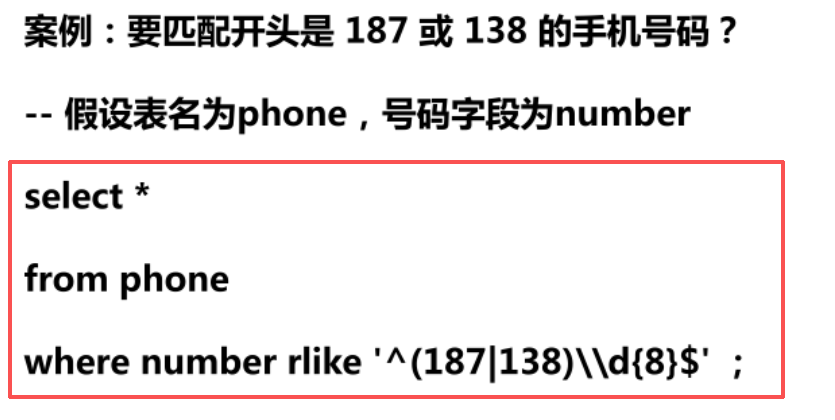
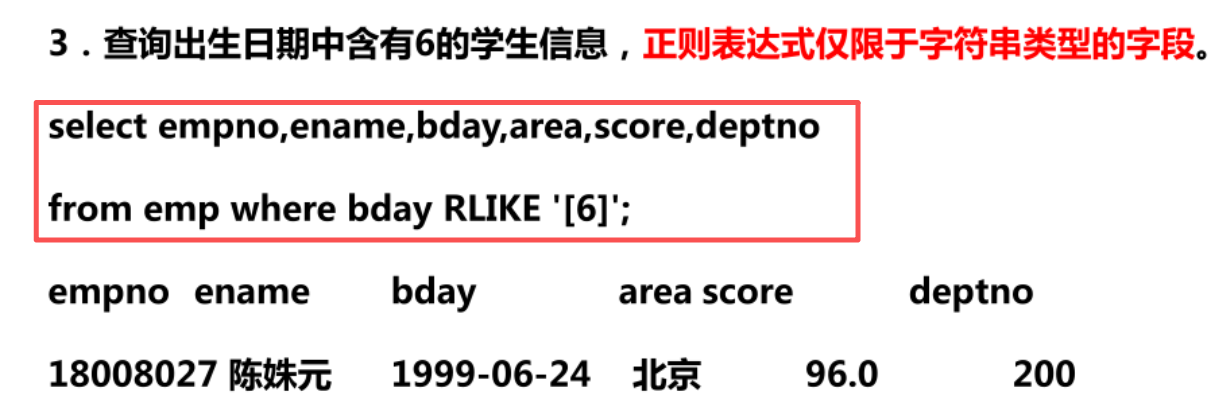
Rlike的使用
1.语法格式:A Rlike B
表示B是否在A里面,而A Like B表示的是B是否是A。B中的表达式可以使用Java中全部的正则表达式。
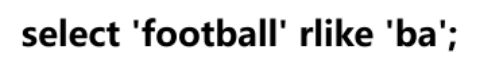
2.使用描述:如果字符串A或者字符串B为Null,则返回Null;如果A符合Java正则表达式B的正则语法,则为True,否则为False。
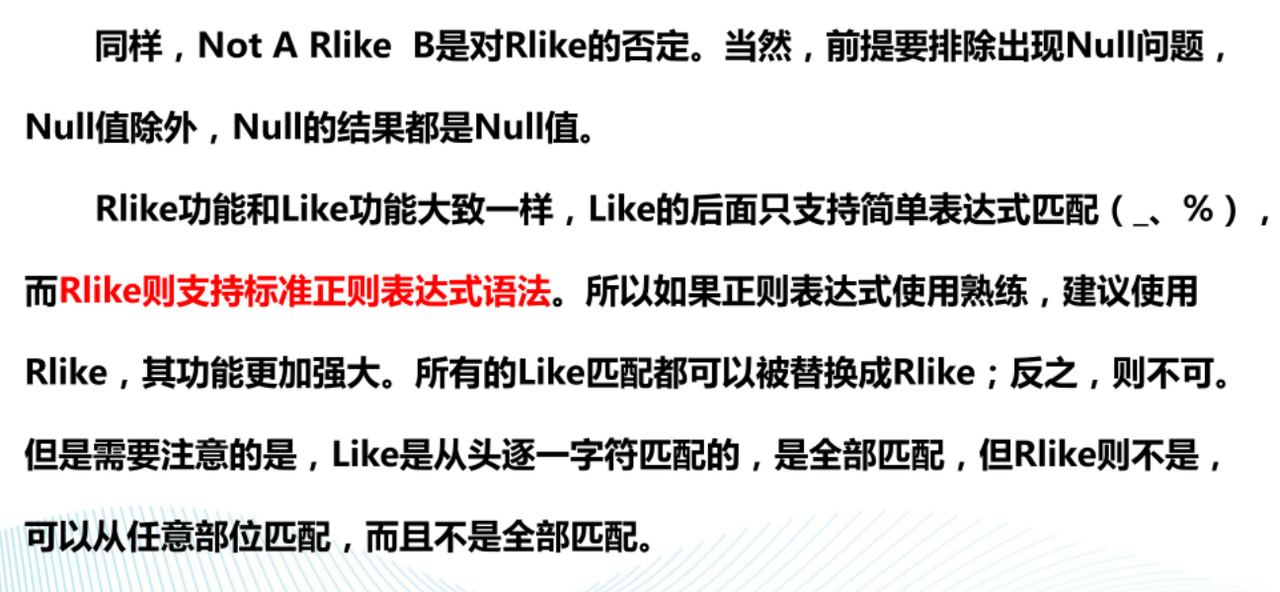
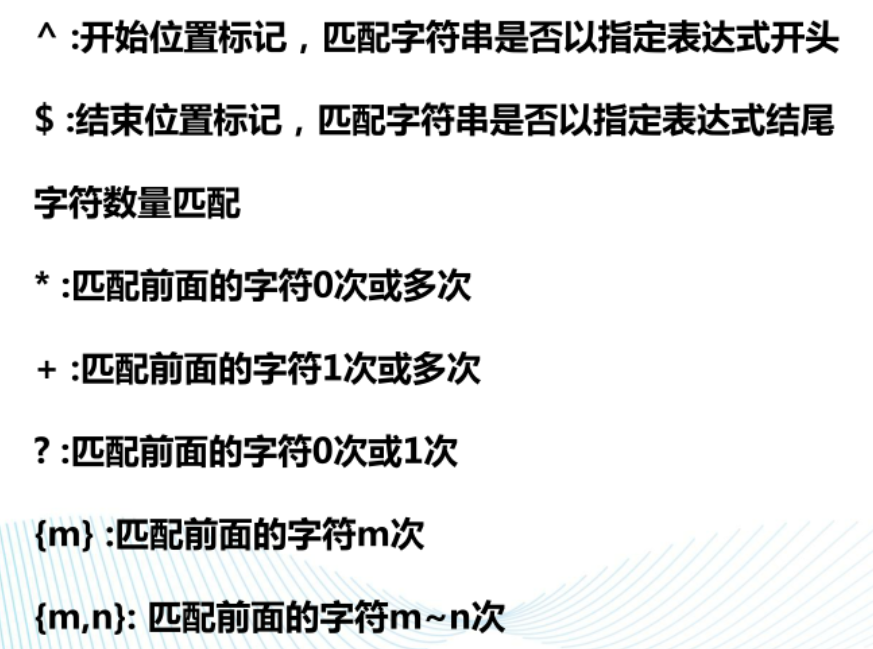
Java中正则表达式规则:
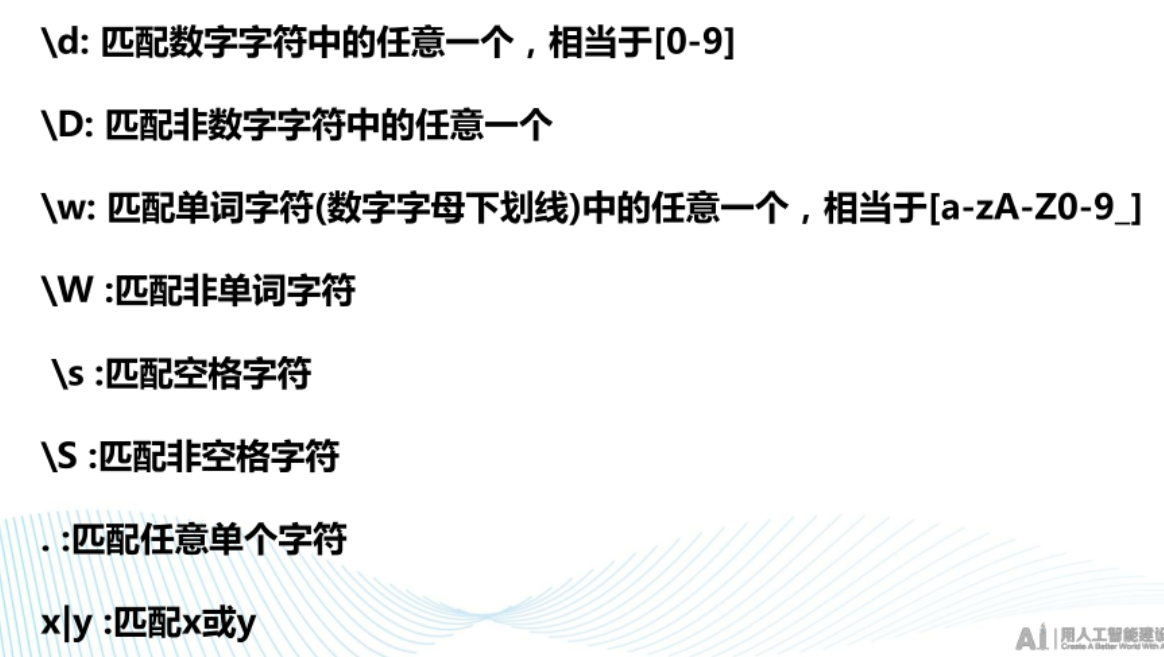
Rlike应用
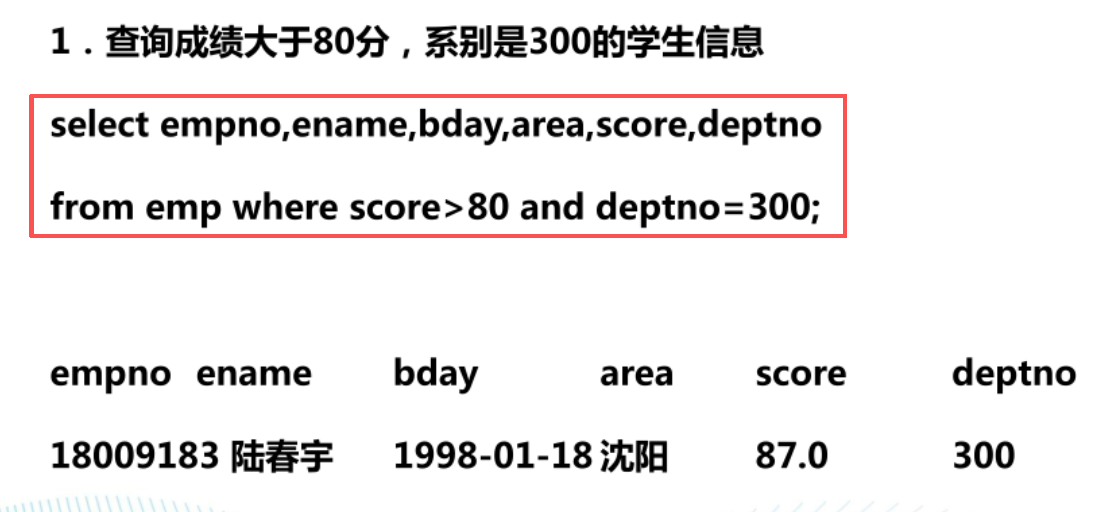
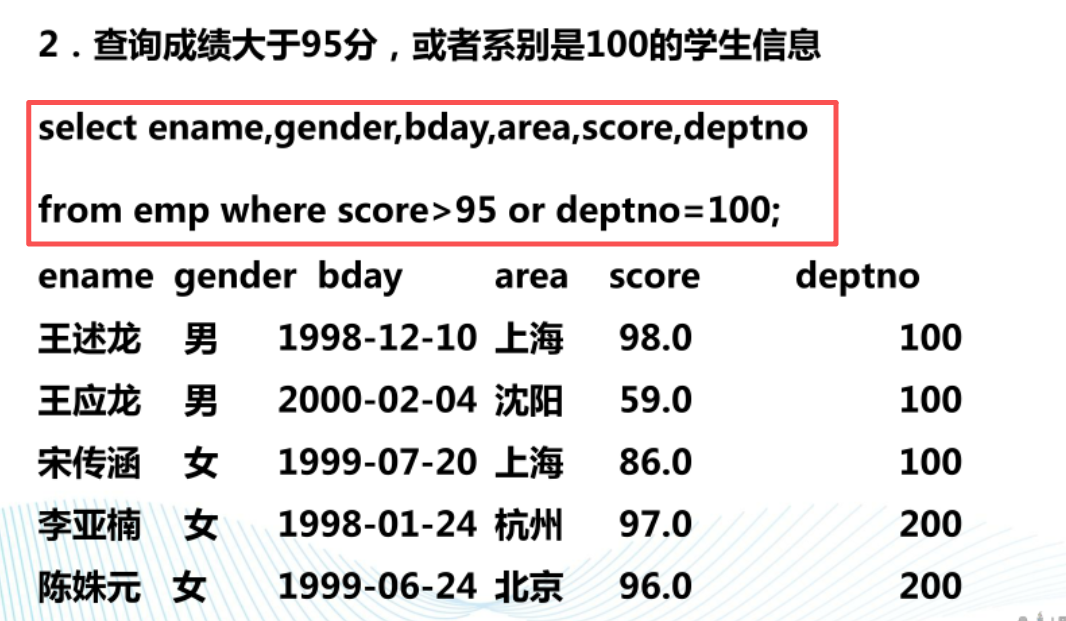
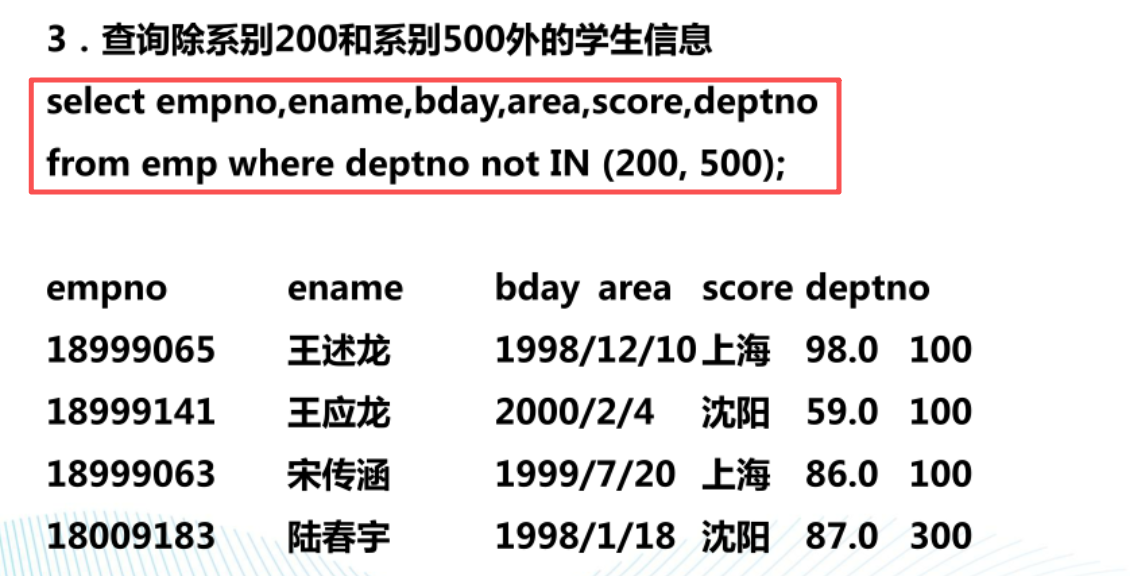
案例:逻辑运算符的应用
分组语句
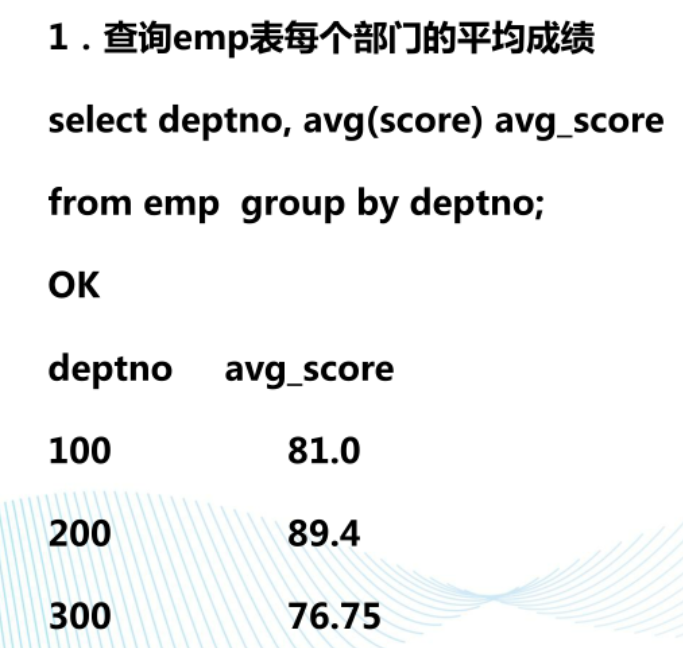
分组语句主要有Group By语句和Having语句。
Group By语句通常和聚合函数一起使用,按照一个或者多个字段进行分组,然后对每个组执行聚合操作。
Group By语句
Having语句
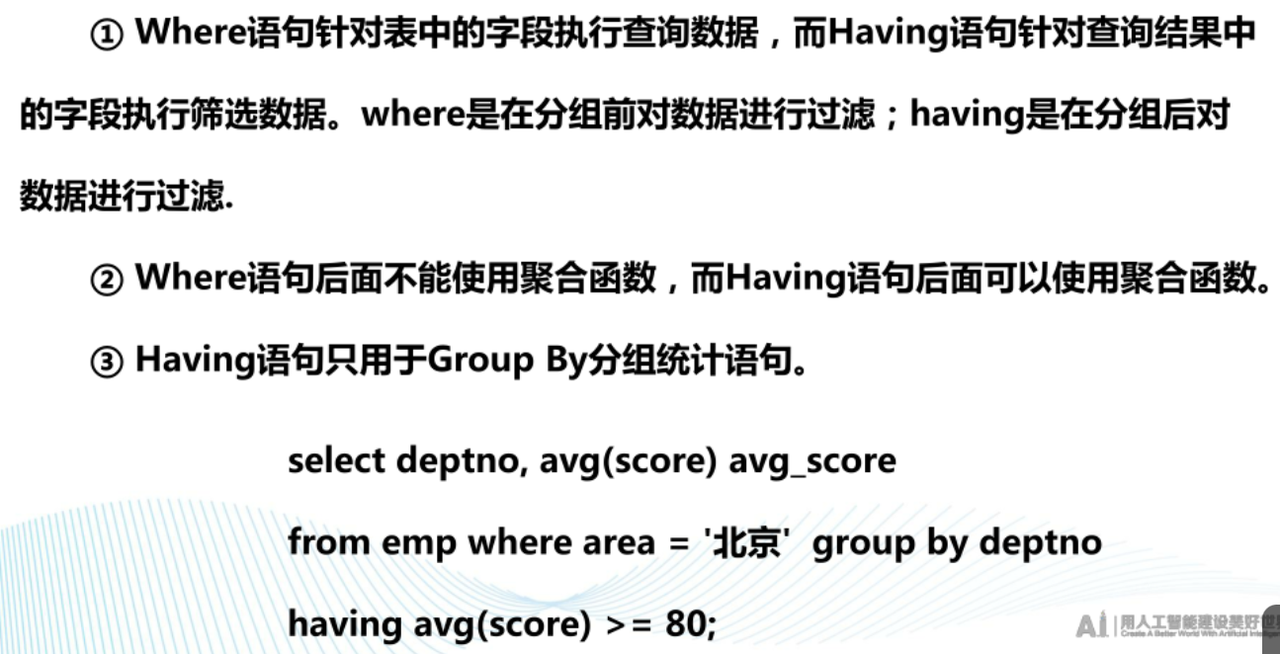
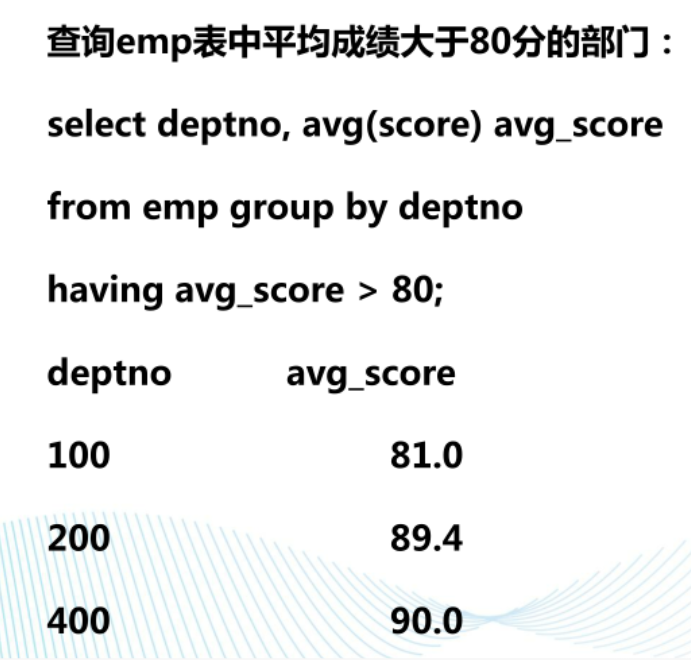
Having语句也是限定返回的数据集。只有在Group By和Having语句中,才可以使用聚合函数。Having语句在Group By语句之后,HQL会在分组之后计算Having语句,查询结果中只返回满足Having条件的结果。
Having语句与Where语句的不同点
Having案例
Join语句
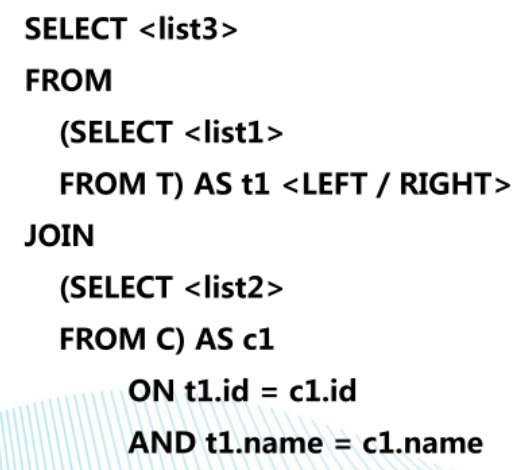
Join基本语法
Join通过共同值组合来自两个表的特定字段,它是两个或者更多的表组合的记录。
Hive支持通常的SQl Join语句。
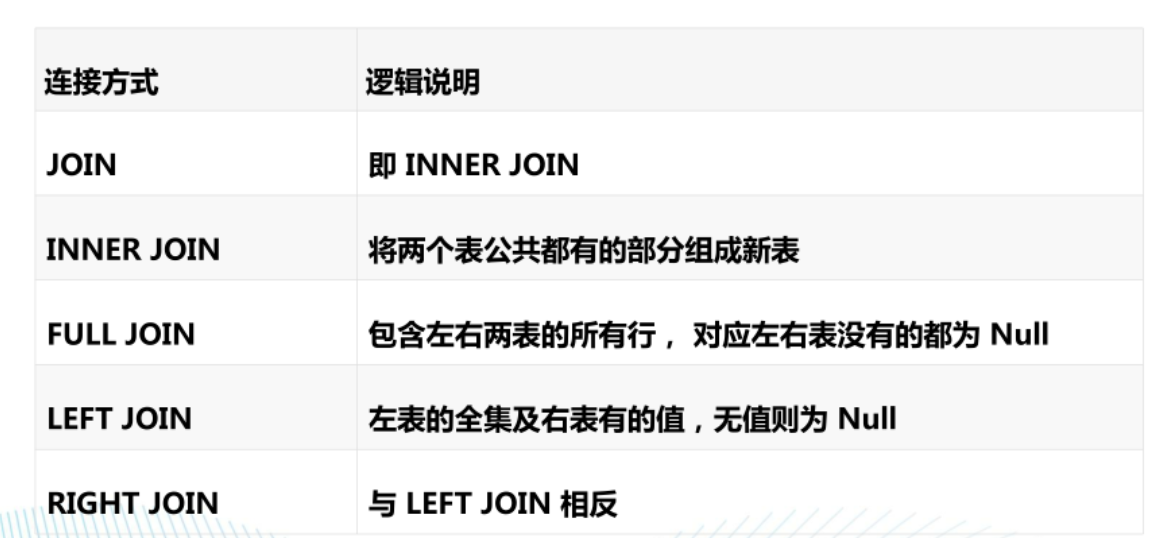
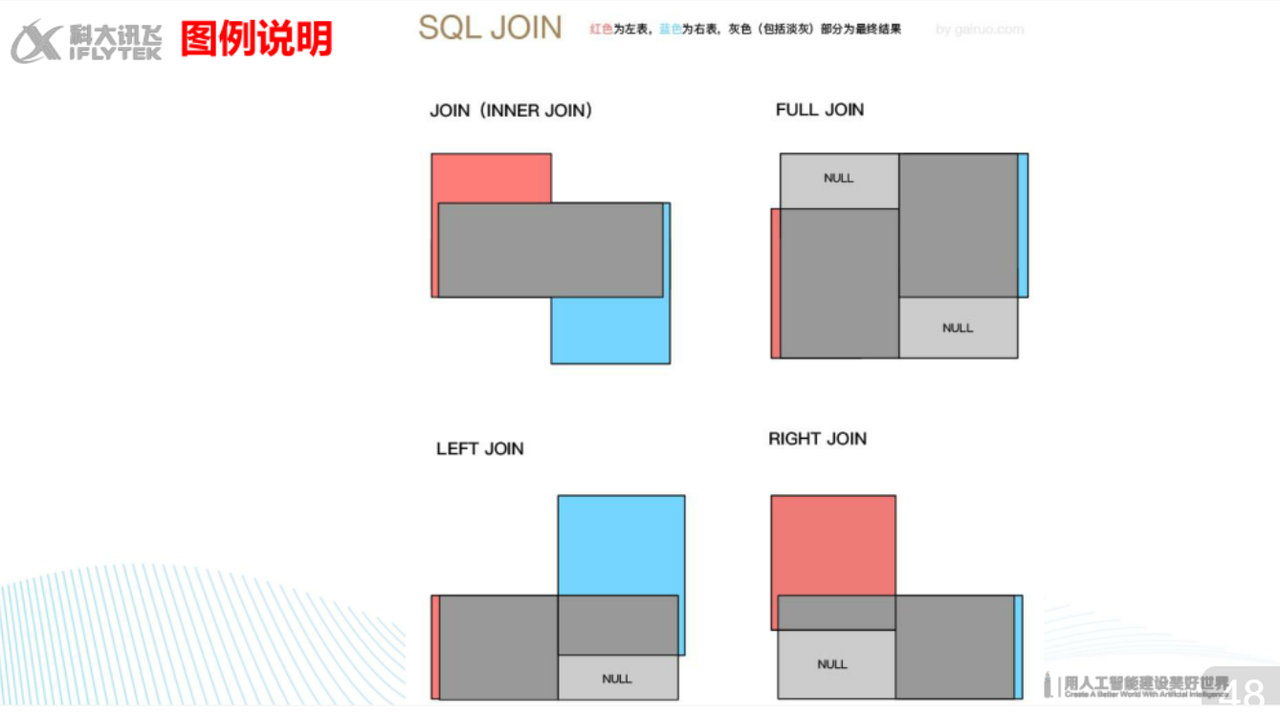
Join类型
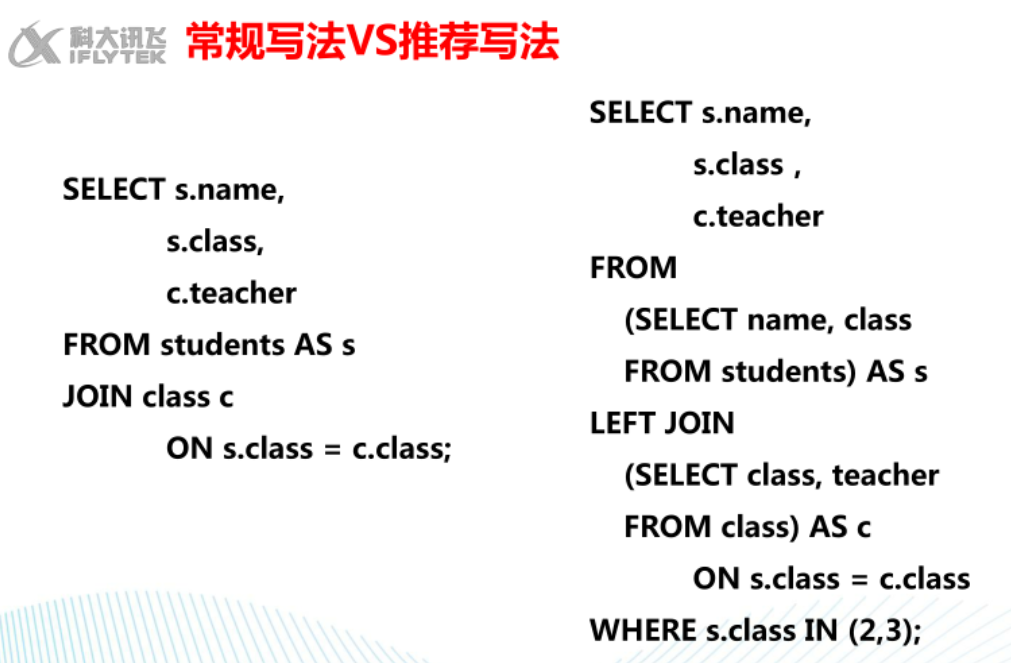
表的别名
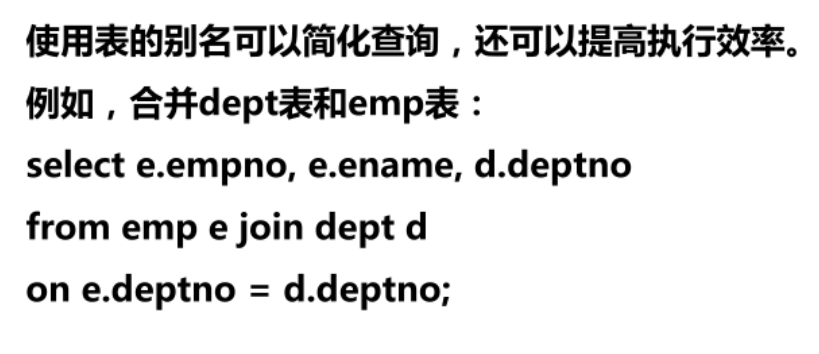
内连接
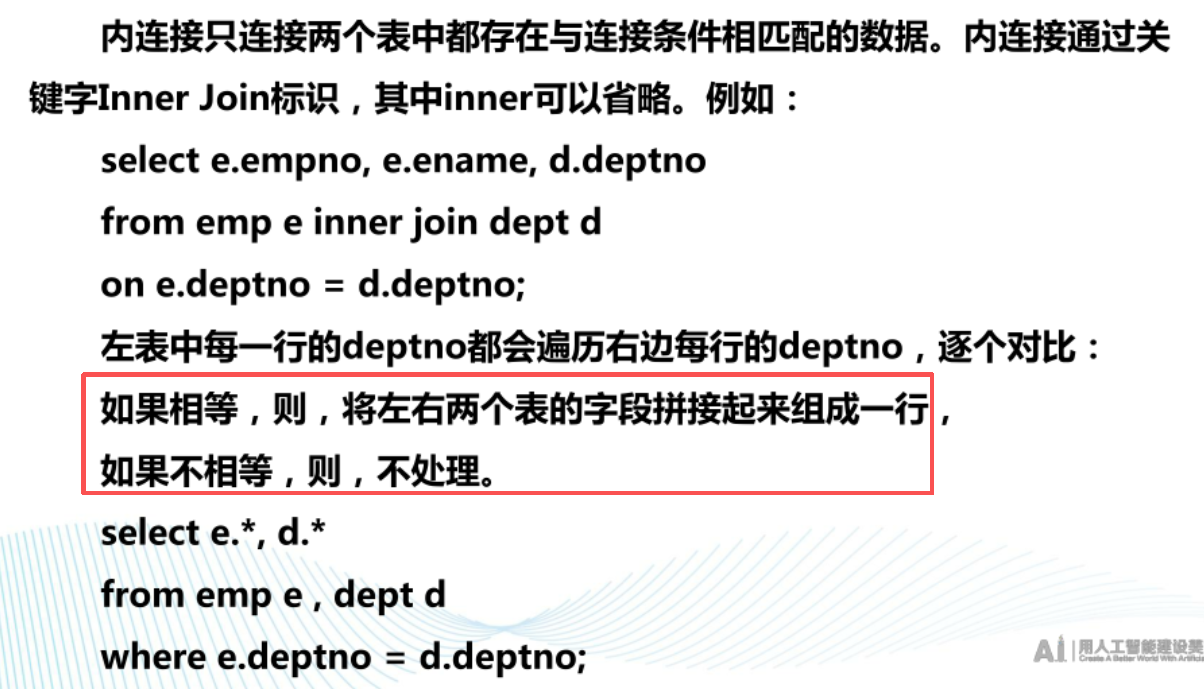
内连接的结果是两张表交集的部分
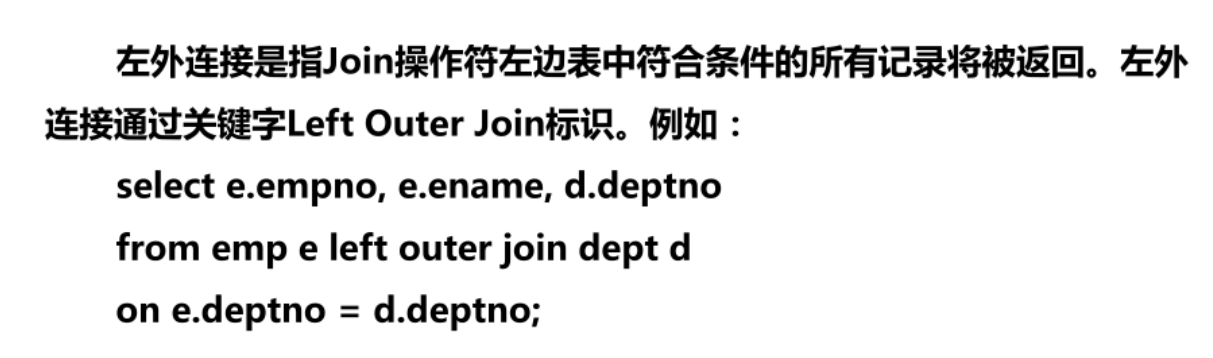
左外连接
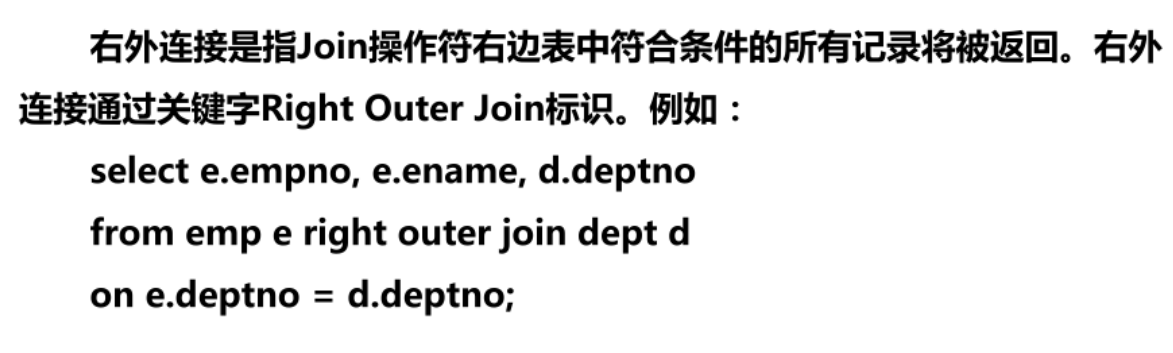
右外连接
满外连接
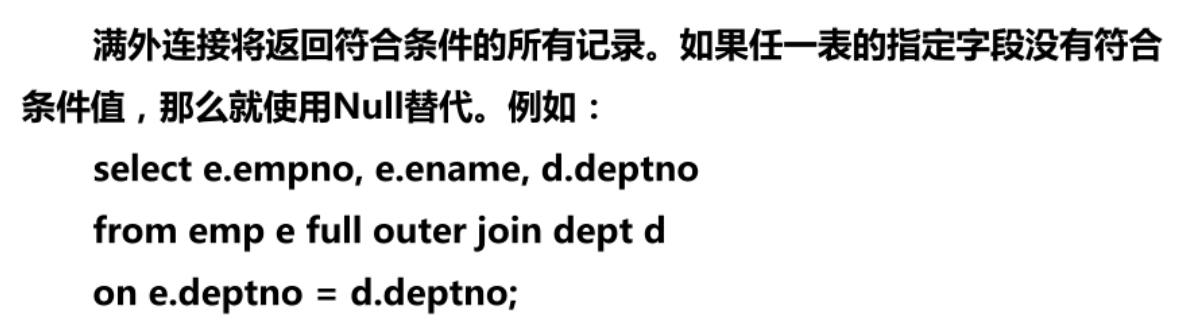
对于表A中有而表B中没有的记录,表B的字段用 NULL 填充。
对于表B中有而表A中没有的记录,表A的字段用 NULL 填充。
简单来说,它就是 左外连接 和 右外连接 的“并集”。
Join语句扩展
左半开连接
只返回左边表的记录,前提是这些记录对于右边表满足on条件。
可以理解为,两个表进行inner join之后,返回左表的结果。
左半开连接与左外连接的区别
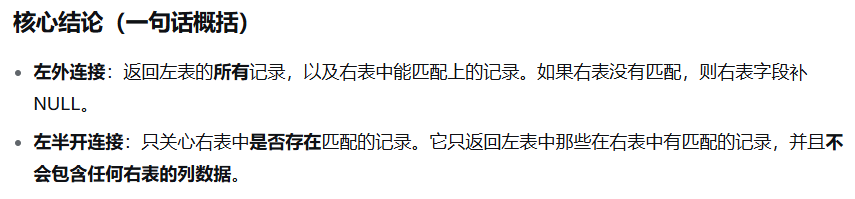
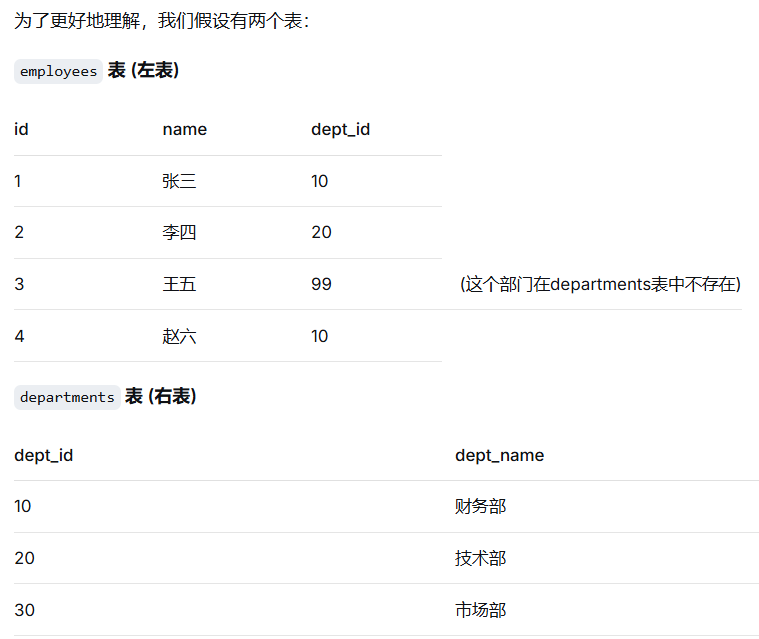
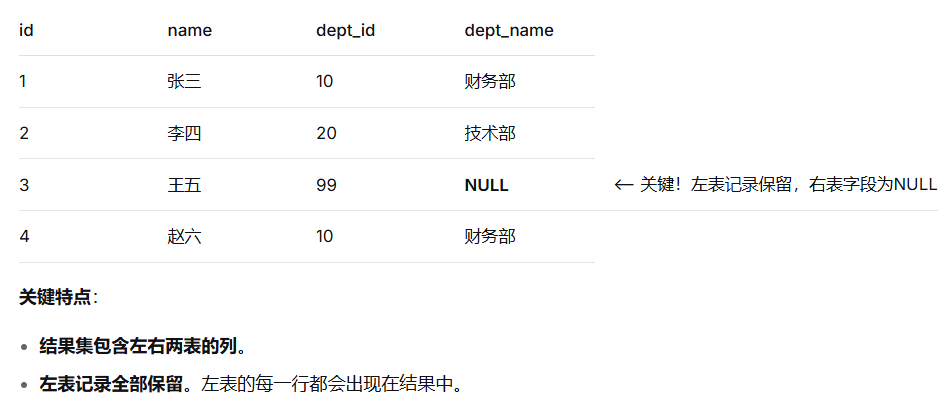
左外连接的查询结果为:
左半开连接的查询结果为:
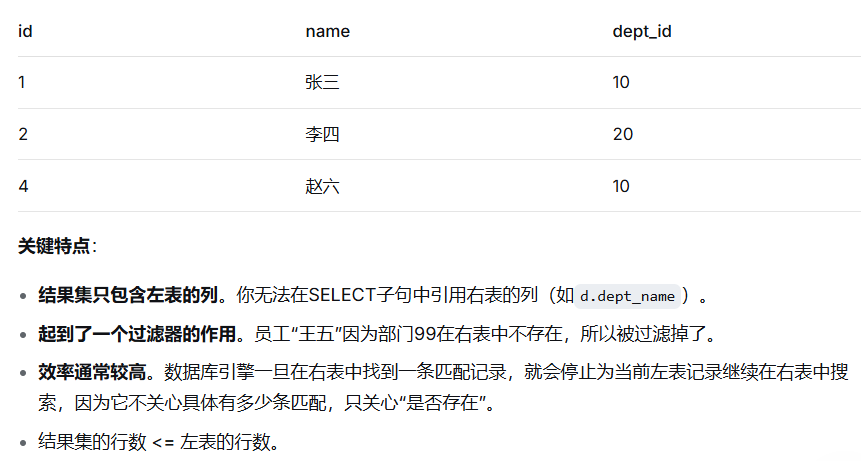
即左外连接会保留左表中的所有字段,对于右表没有的部分则返回Null,而左半开连接则不会返回在右表中不存在的数据。
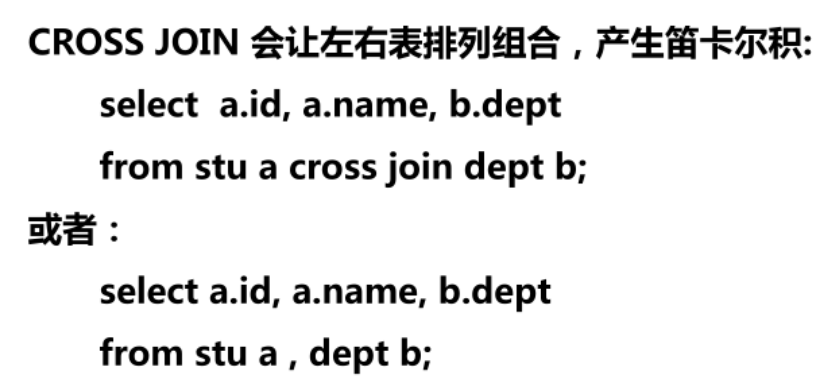
交叉连接
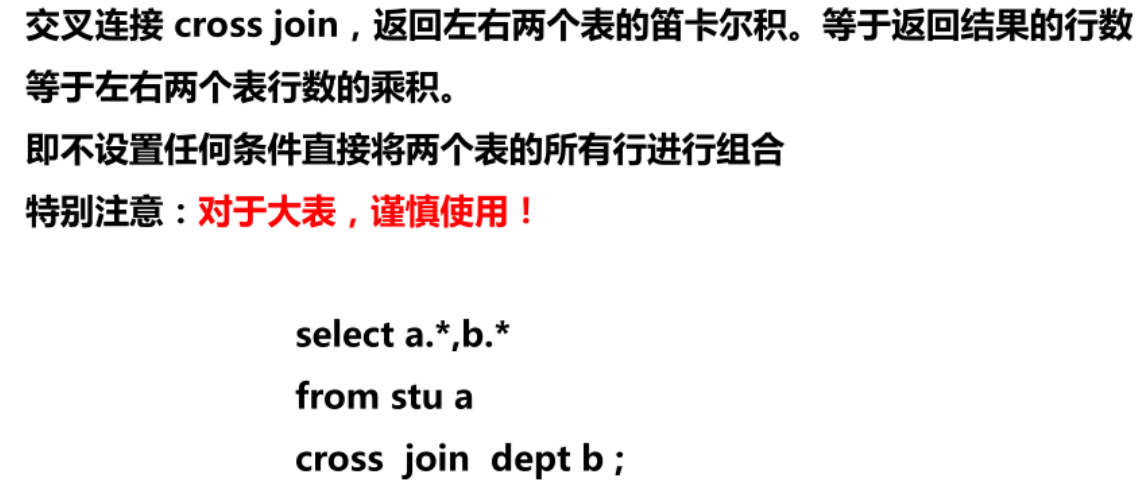
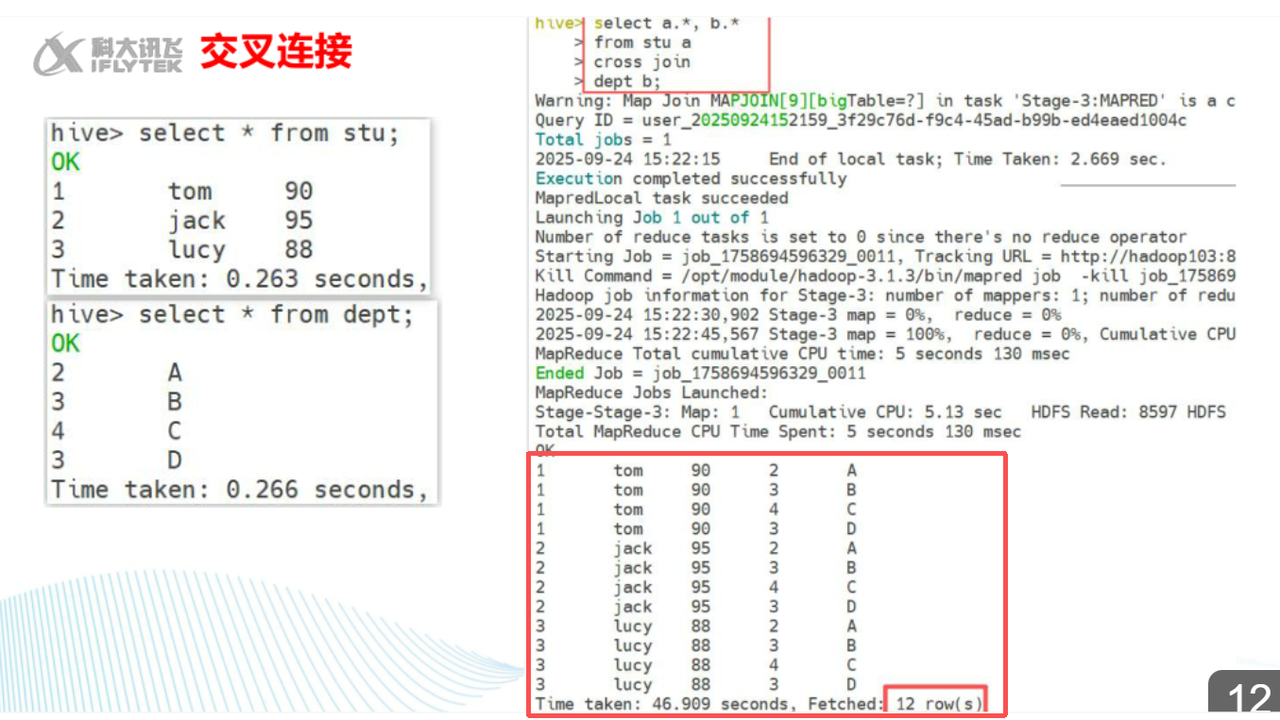
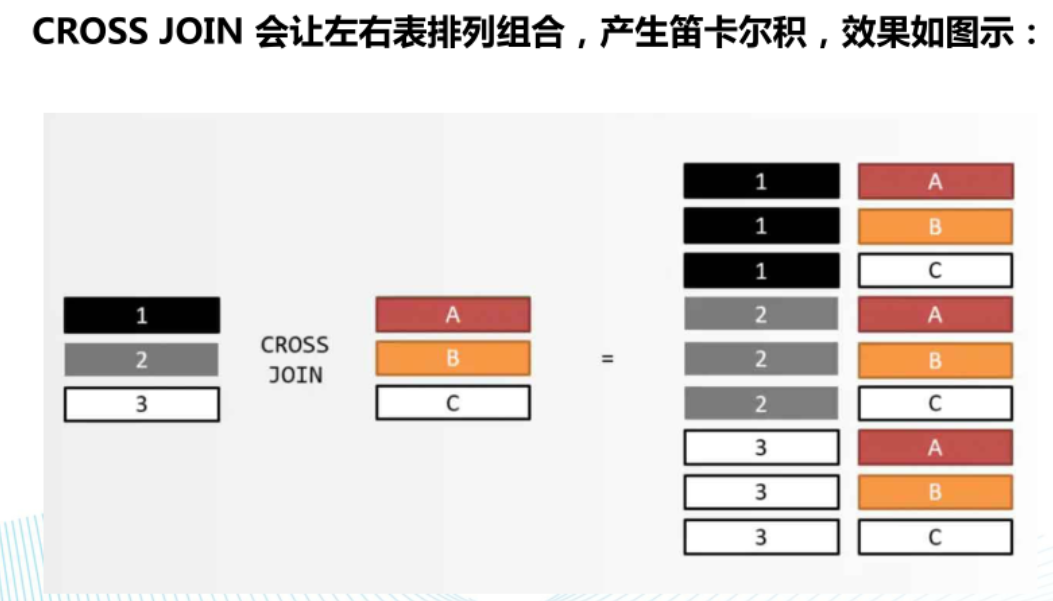
交叉连接在一些情况下还是有用的,例如,假设有一个表为用户偏好,另一个表为新闻文章,同时有一个算法会推测出用户可能会喜欢哪些文章,这个时候就需要交叉连接生成所有用户和所有网页的对应关系集合。
多表连接
例如连接3个表的情况下,至少需要2个连接条件。
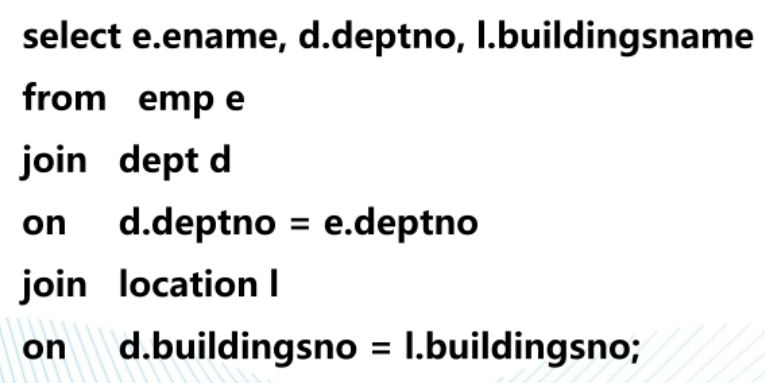
大多数情况下,Hive会对每对Join连接对象启动一个MapReduce任务。本例中首先启动一个MapReduce任务对emp表和dept表进行连接操作,然后再启动一个MapReduce任务,并将第一个MapReduce任务的输出和Location表进行连接。
这里需要注意的是,Hive总是按照从左到右的顺序执行的,不管是左连接还是右连接。
UNION数据拼接
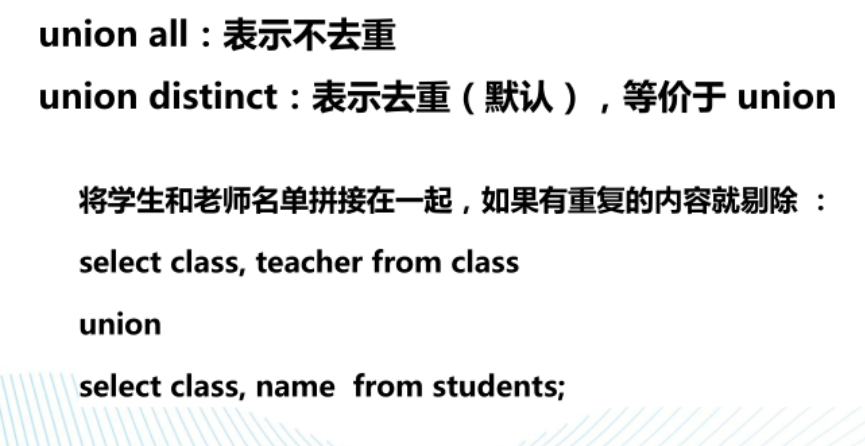
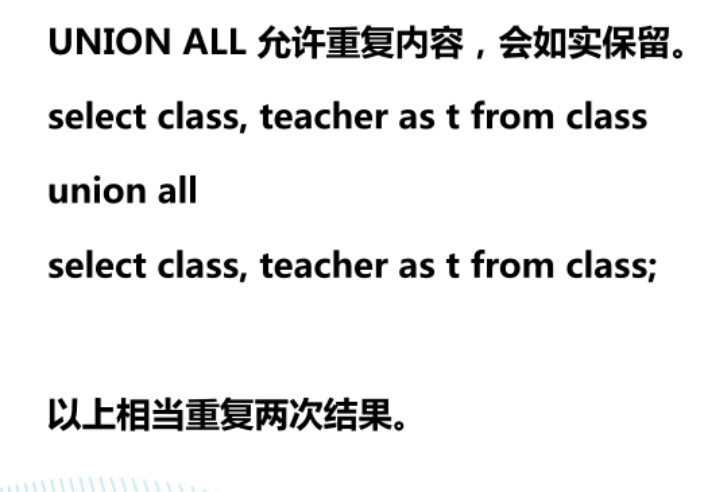
UNOIN运算符允许将两个或多个查询结果合并到单个结果集中。合并时需要满足两个规则:它们的字段个数必须一样,而且字段类型要"相容"(一致)。
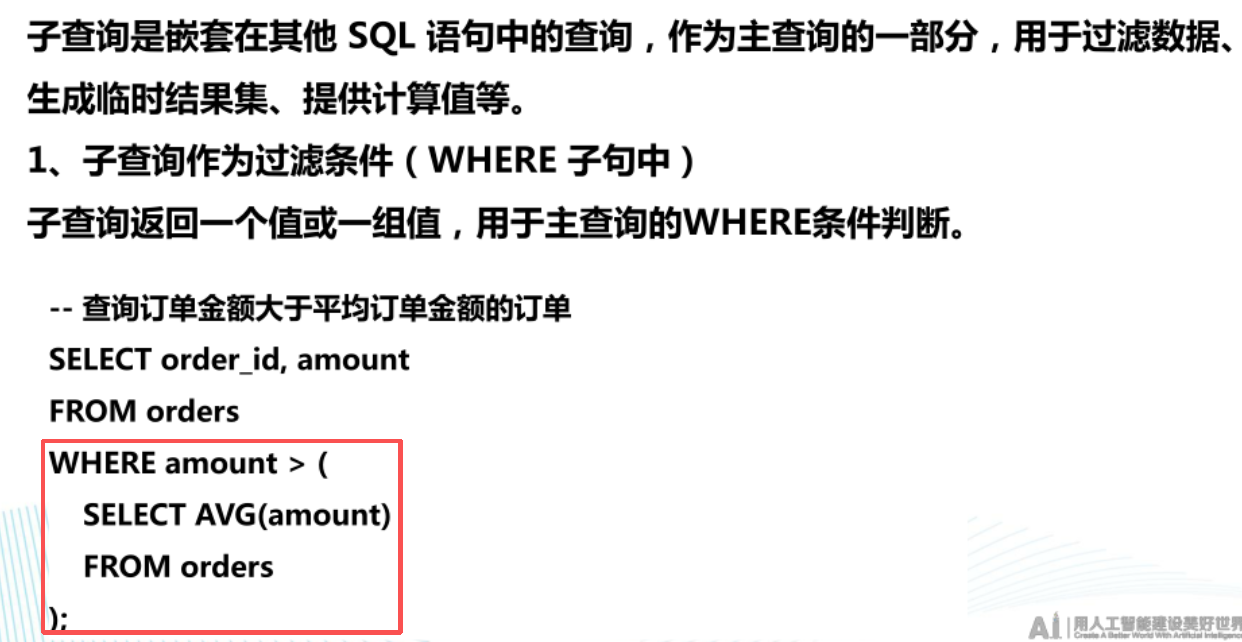
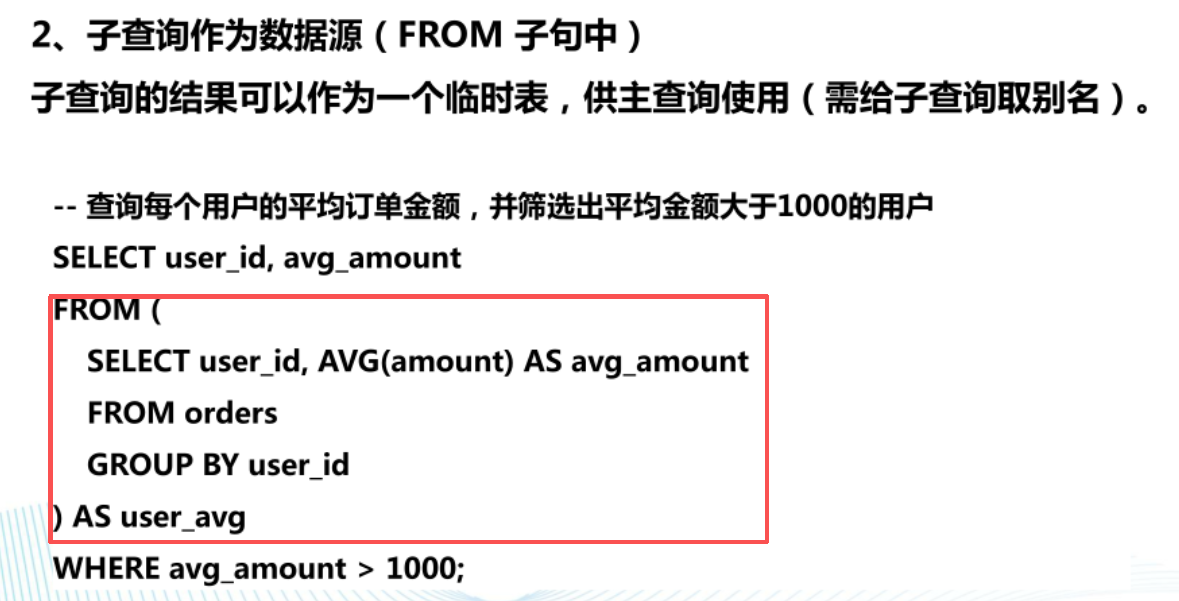
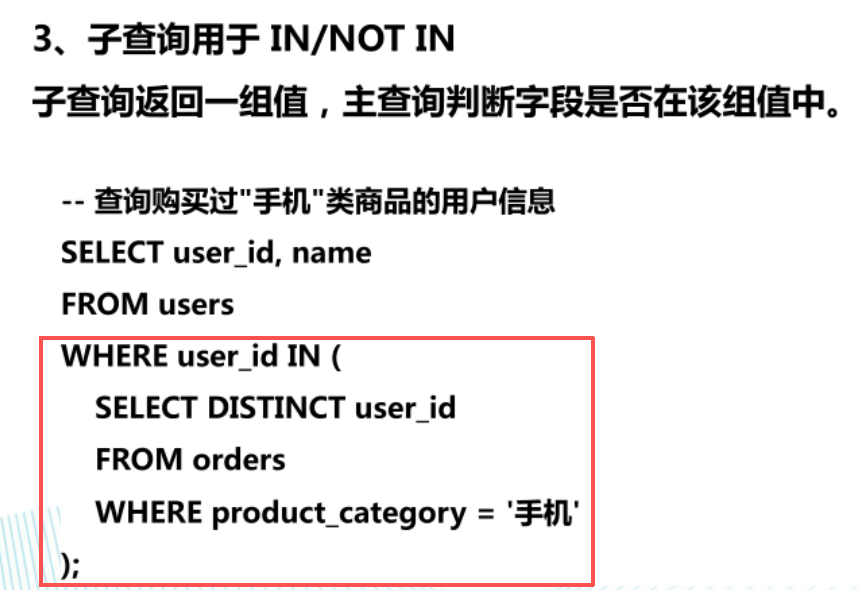
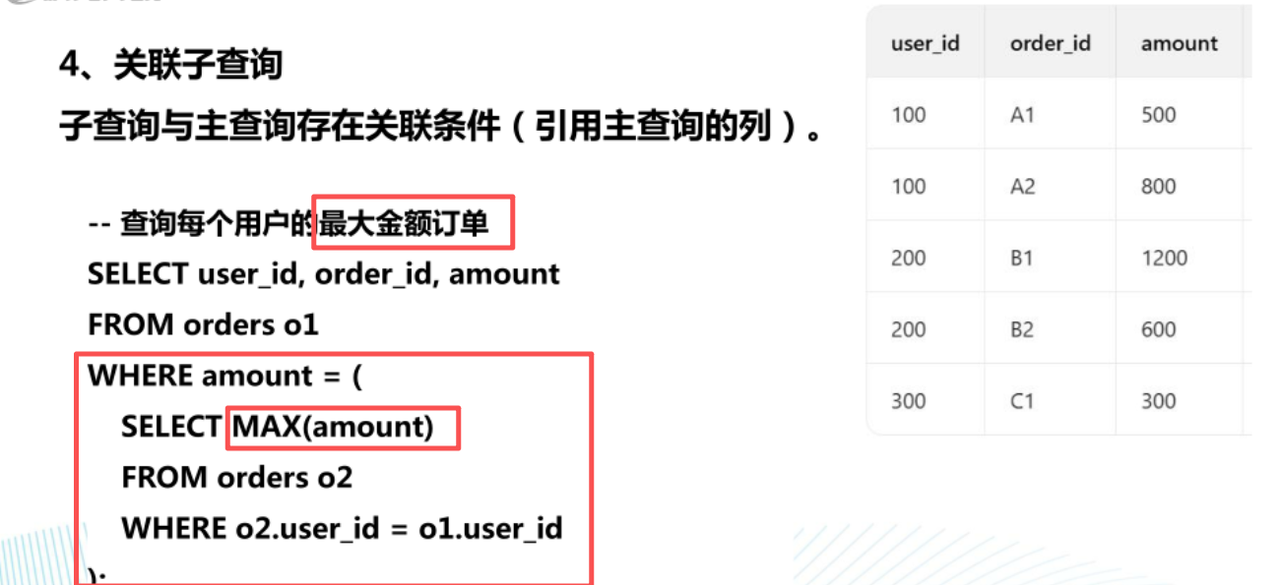
子查询
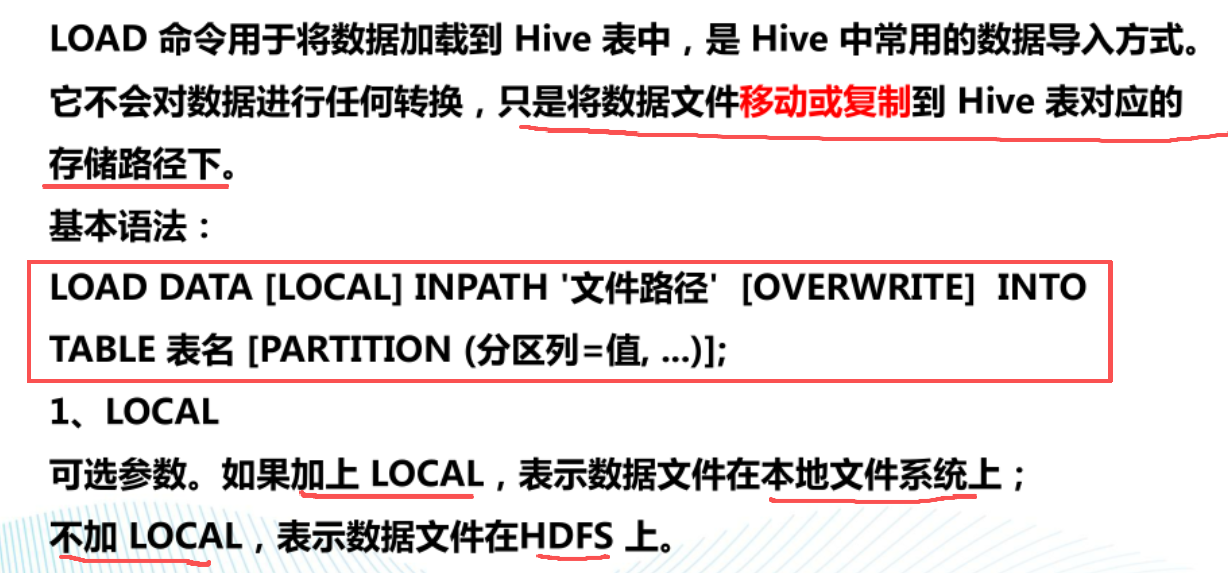
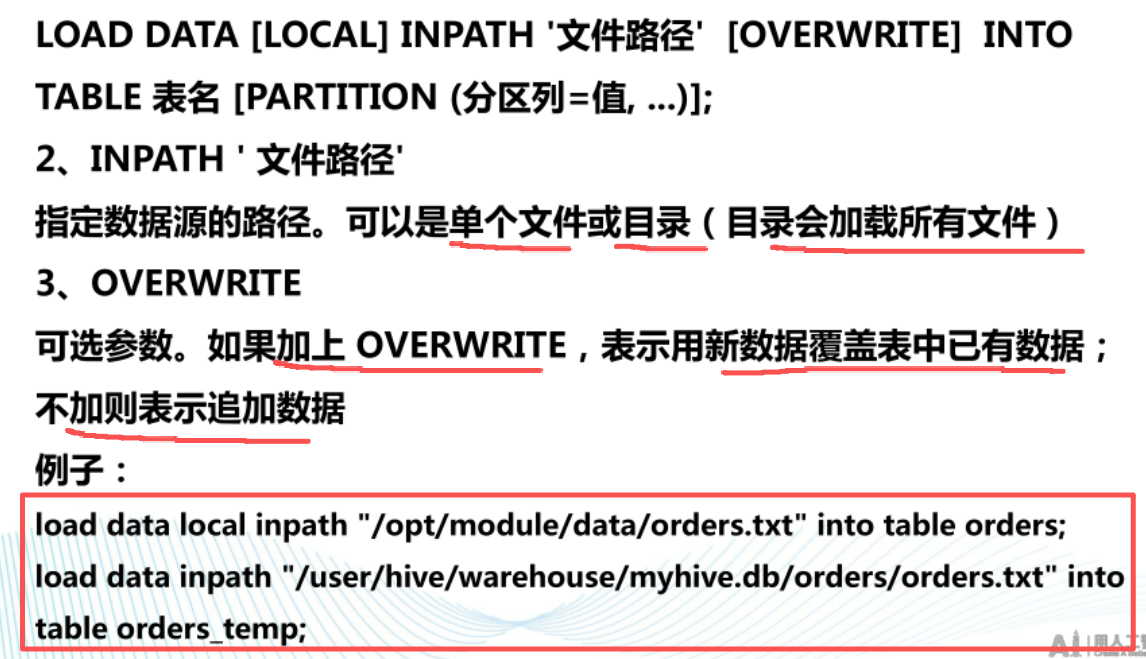
LOAD加载命令
排序
Hive常用的排序方法有ORDER BY、CLUSETER BY、
DISTRIBUTE BY SORT BY。
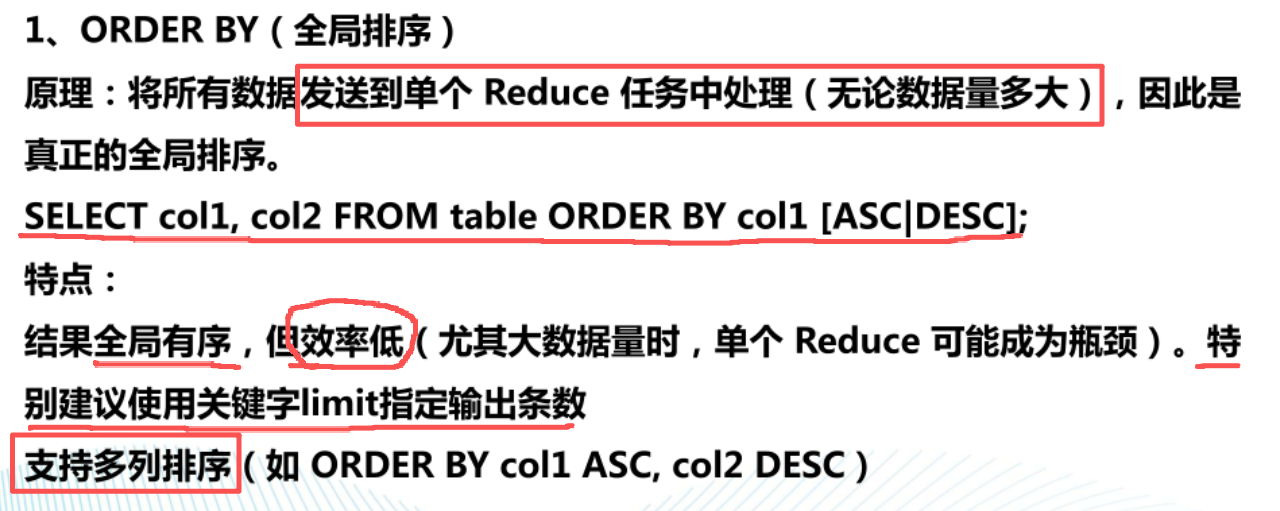
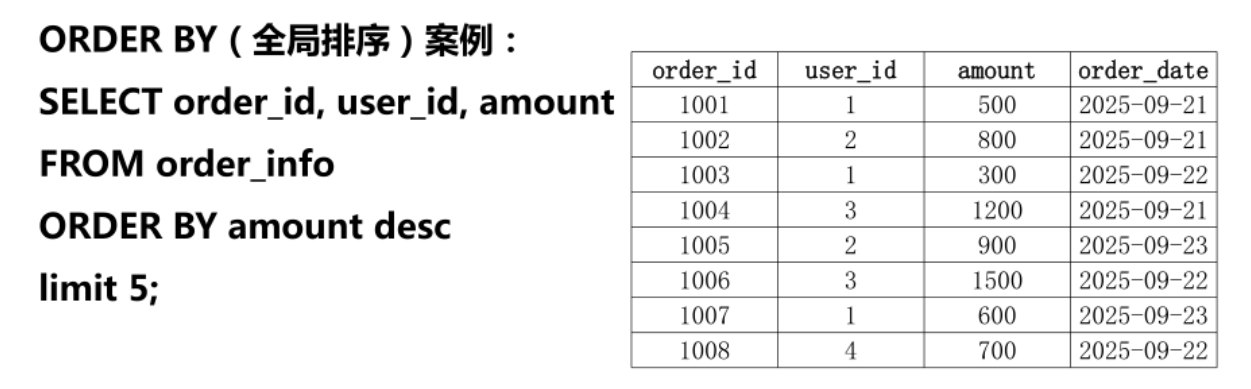
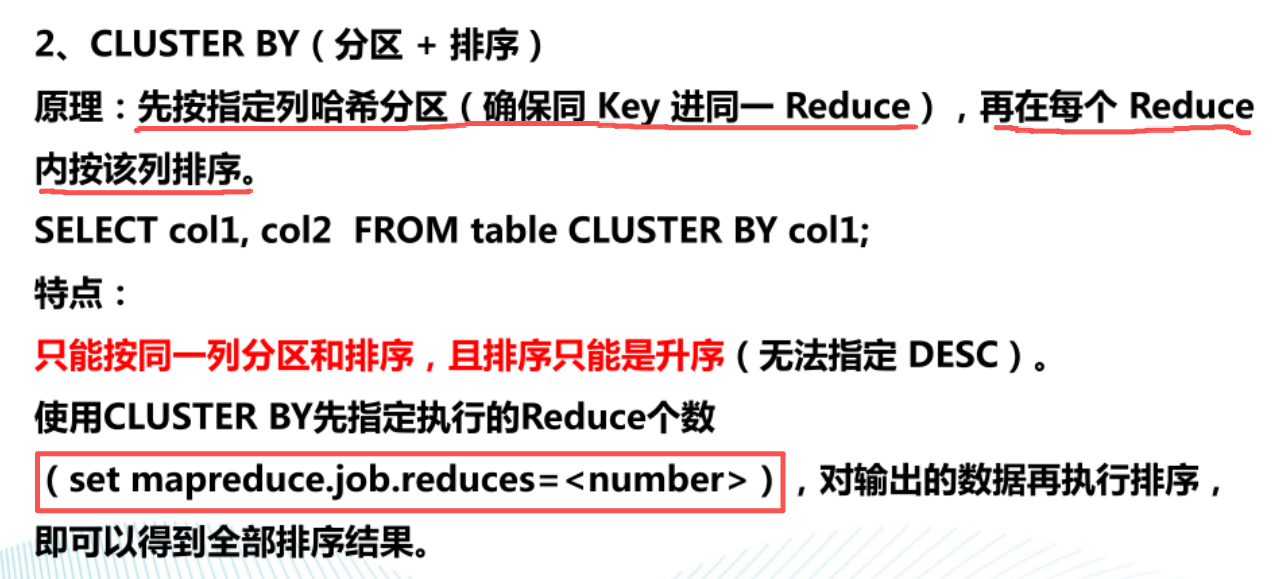
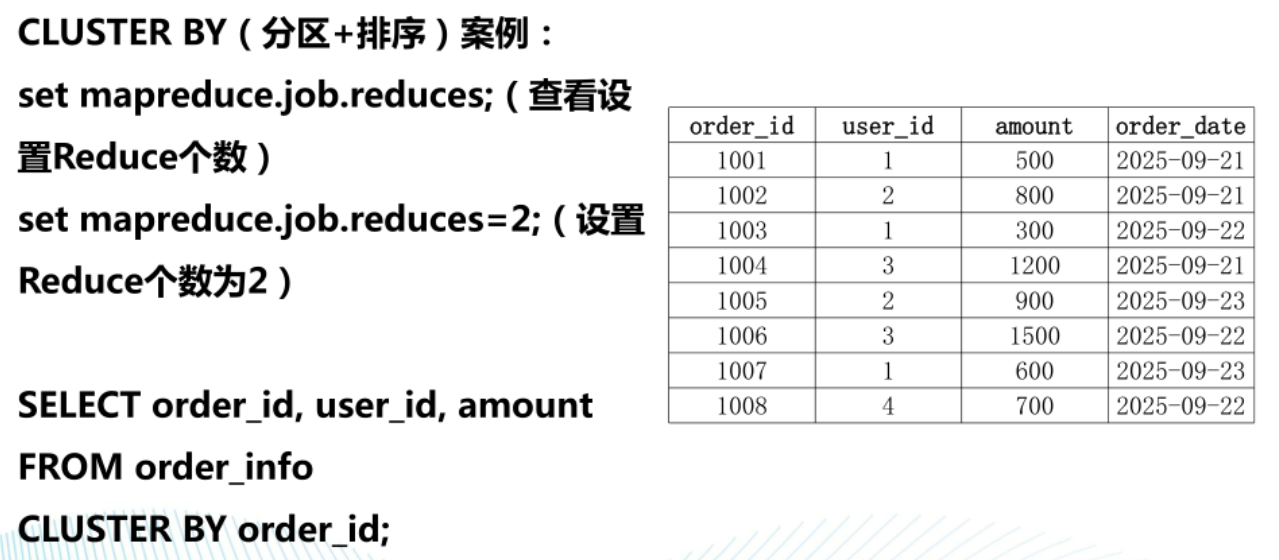
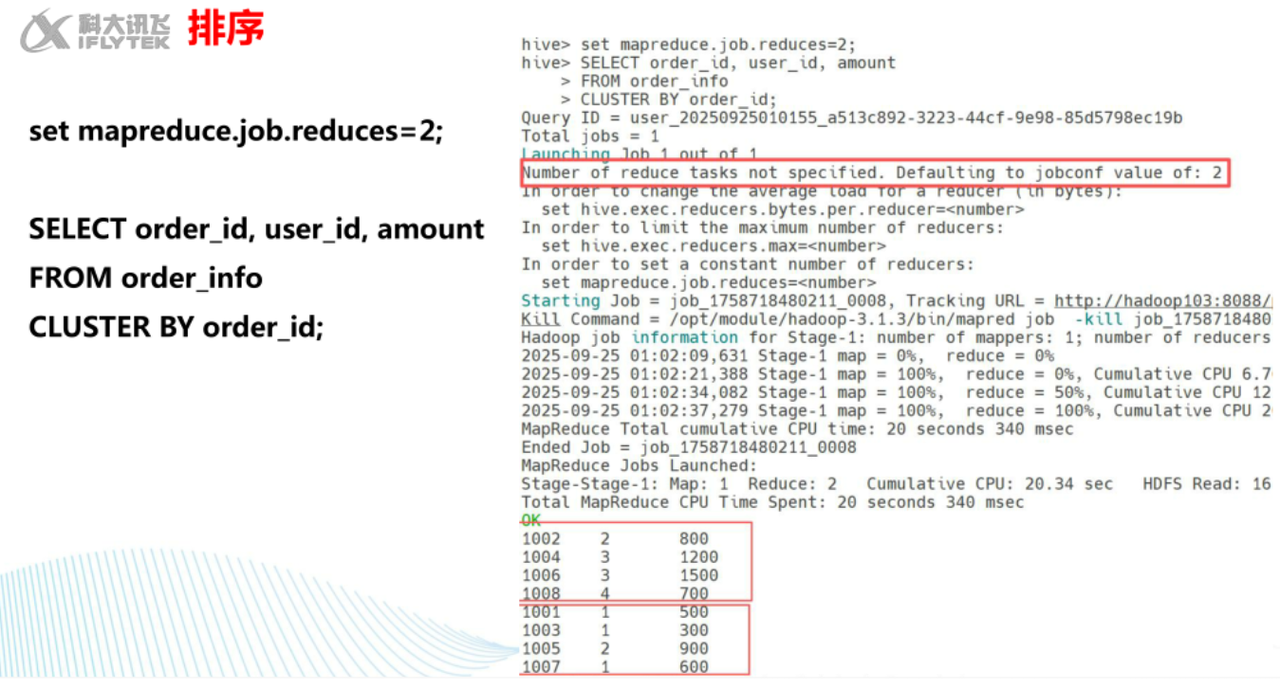
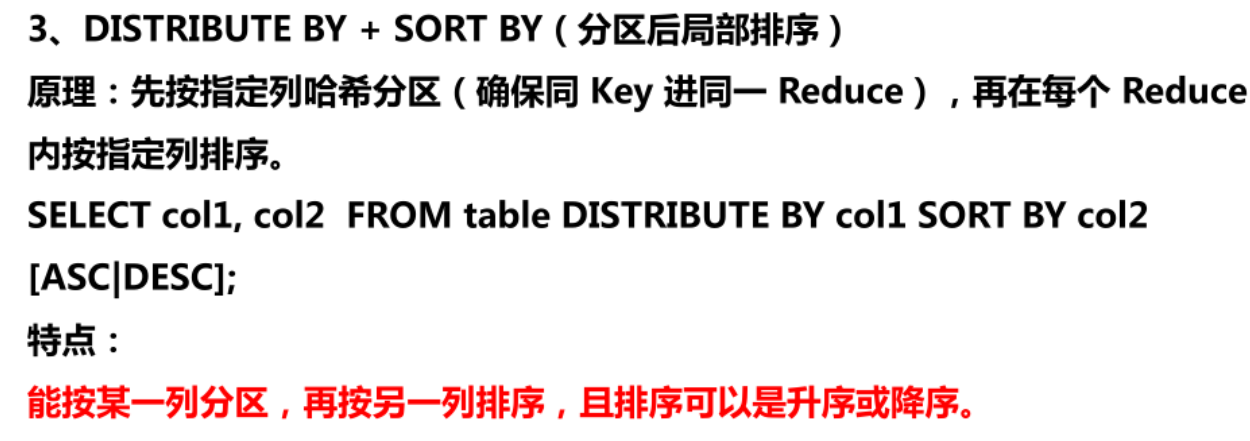
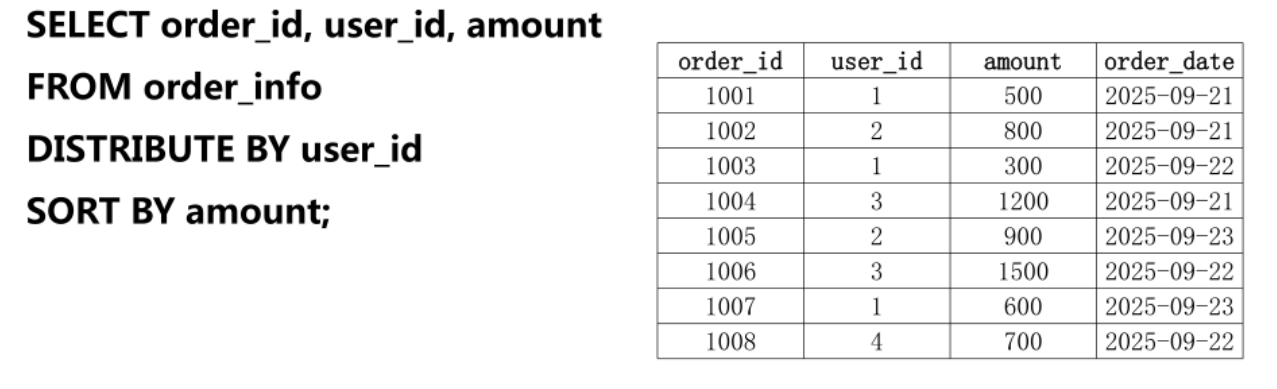
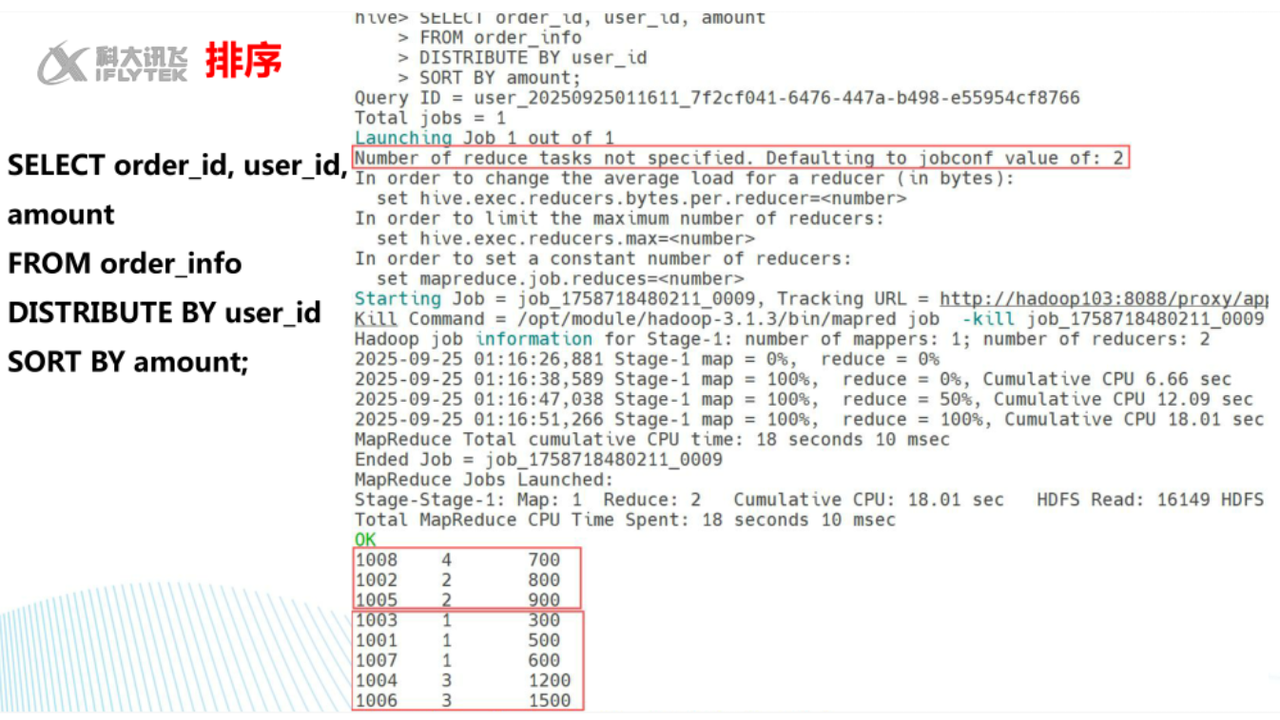
注意:在使用之前,需要先设置Reduce的数量>1,才会做局部排序,如果Reduce的数量是1,作用与order by一样,全局排序。
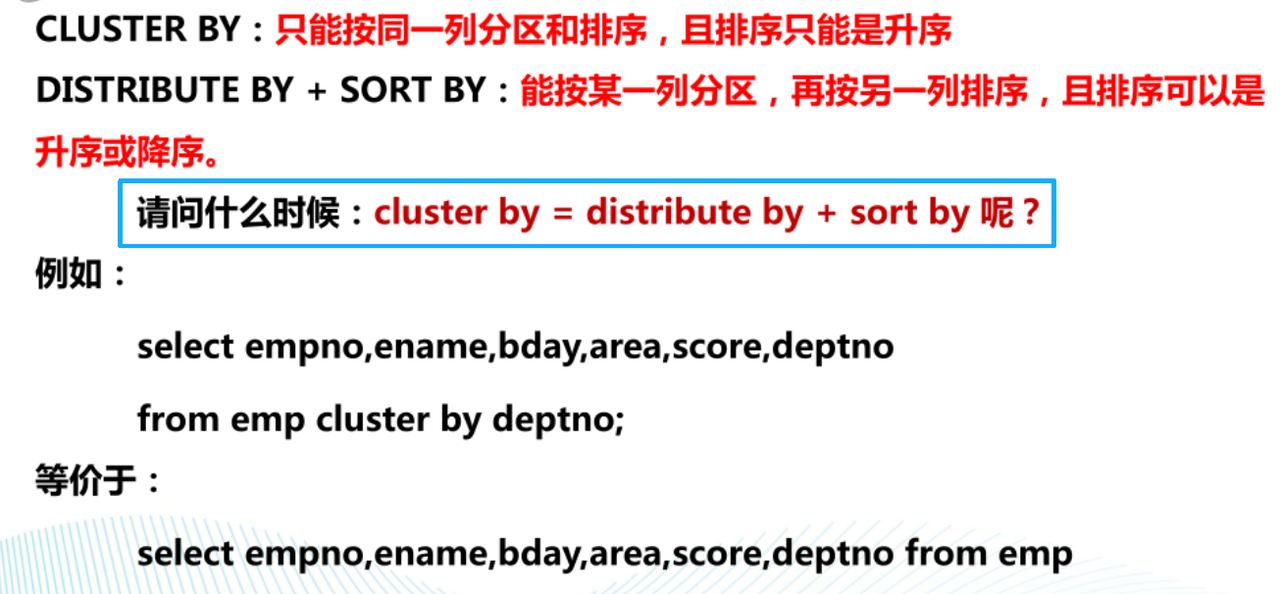
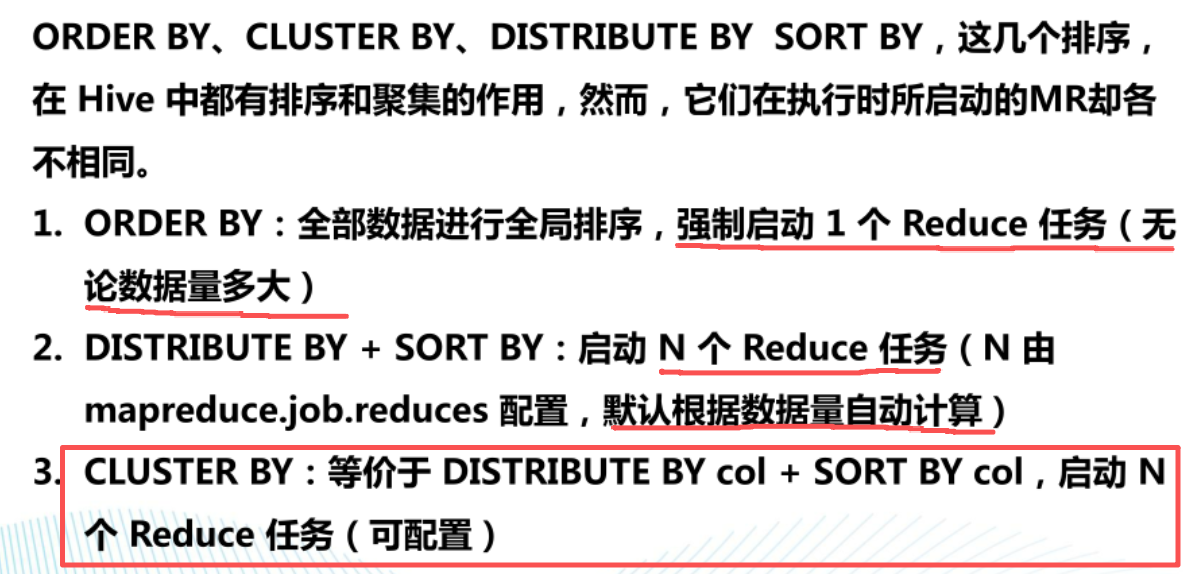
排序区别(重点)
抽样查询
当数据量特别大,对全部数据进行处理存在困难时,抽样查询就显得尤其重要了。抽样可以从被抽取的数据中估计和推断出整体的特性。
Hive支持随机抽样查询、数据块抽样查询、通表抽样查询。
随机抽样查询
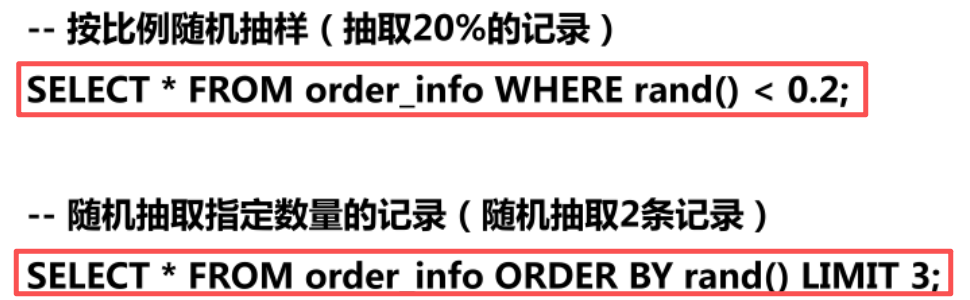
随机抽样通过rand()函数实现,从表中抽取一定比例或一定数量的记录,适用于需要随机样本的场景(如数据分析、测试)。其中,rand()函数前的distribute by和sort by保证数据在Map和Reduce阶段是随机分布的。
数据块抽样查询
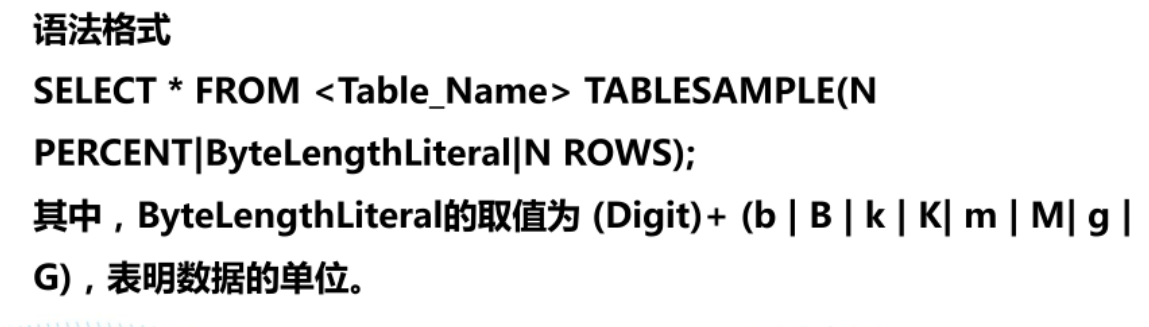
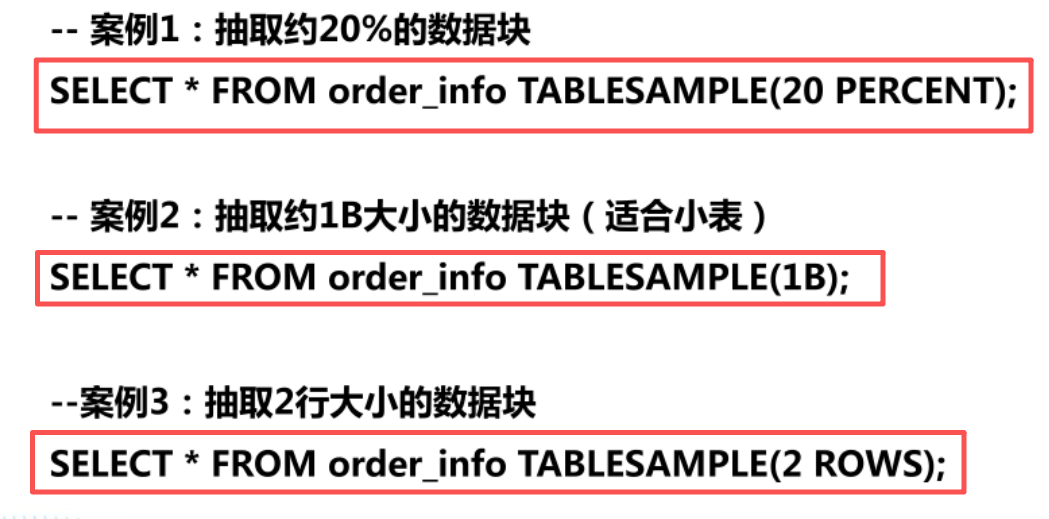
数据块抽样基于HDFS的数据块(Block)进行抽样,按比例抽取连续的数据块,而非随机单条记录,适用于快速获取近似样本(无需精确随机)
该方法允许随机抽取数据总量的百分比或n字节的数据或n行数据。
桶表抽样查询
桶表抽样仅适用于分桶表,通过指定桶编号或比例抽取整个桶的数据,适用于需要稳定样本(每次抽样结果一致)的场景。
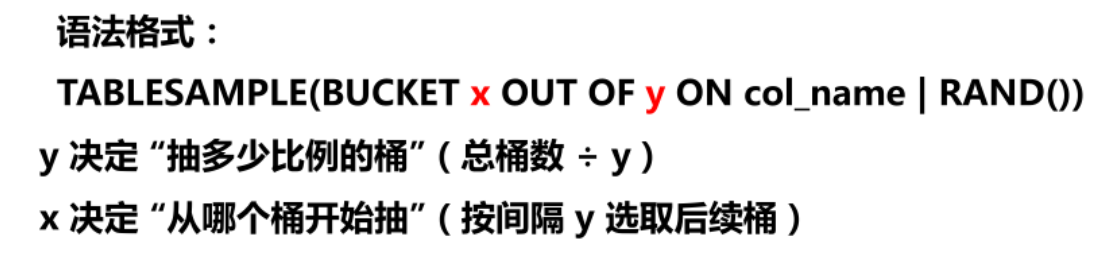
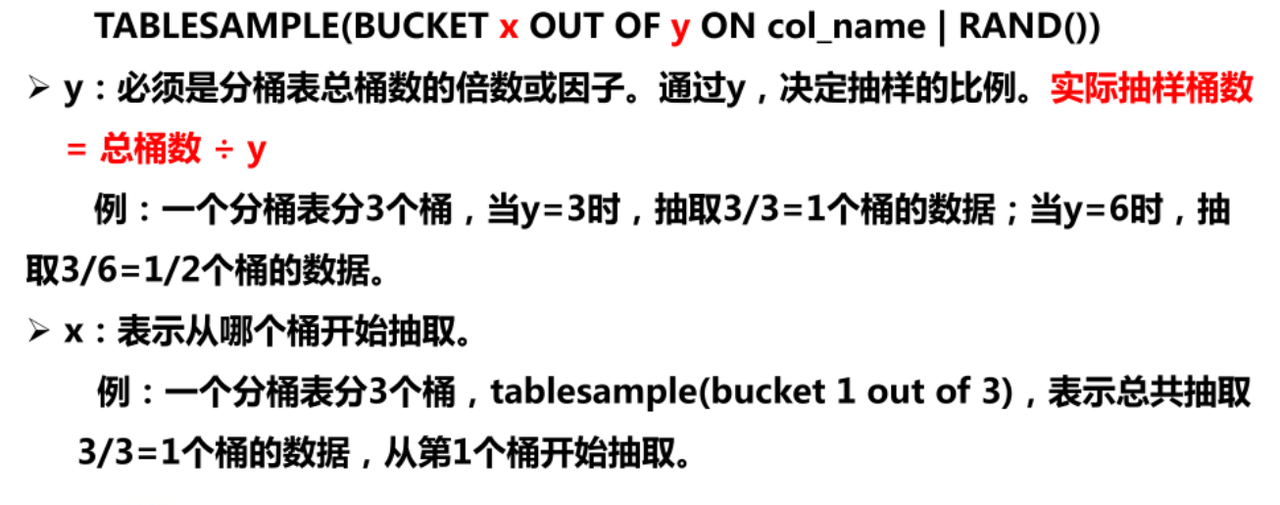
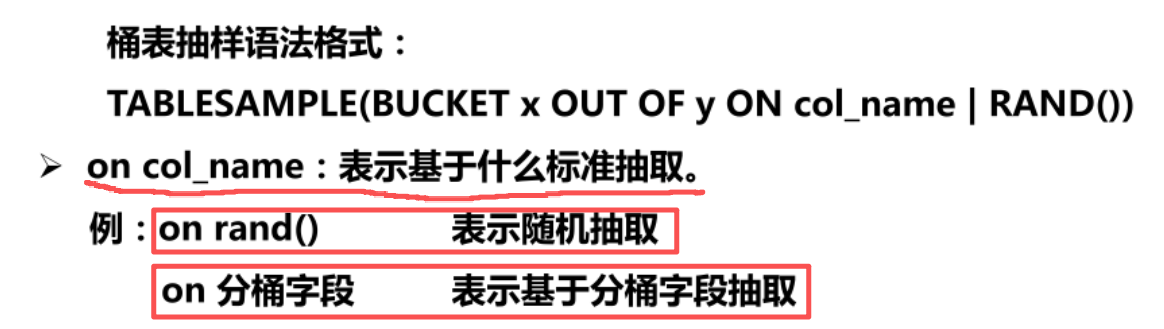
桶表抽样查询案例
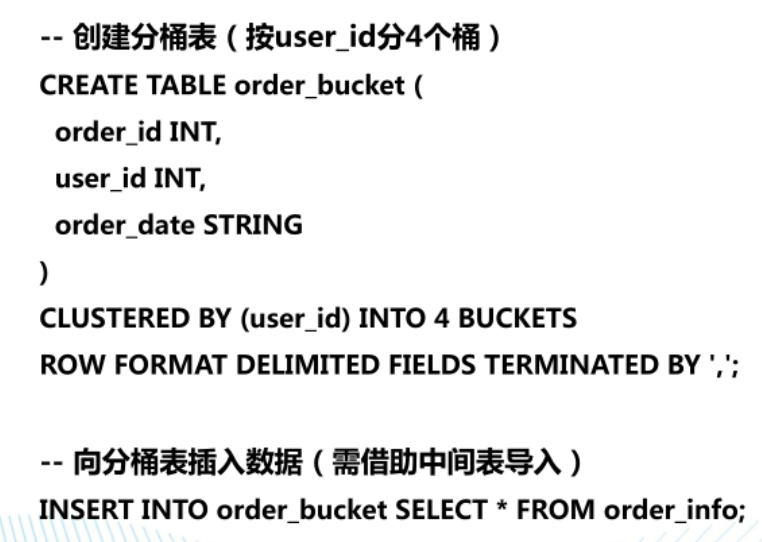
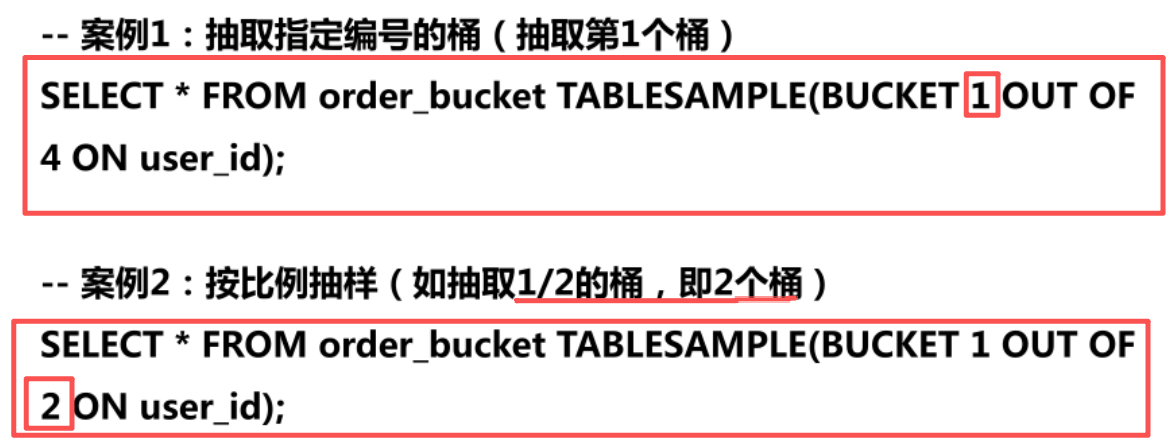
Hive函数
函数概述
Hive提供了丰富的内置函数供用户直接使用来提升SQL编写效率。
从功能上分类内置函数主要包括数值计算函数、聚合函数、日期时间函数、条件函数、字符串处理函数等。
从参数和返回值个数分类,内置函数又分为一进一出、多进一出和一进多出函数。
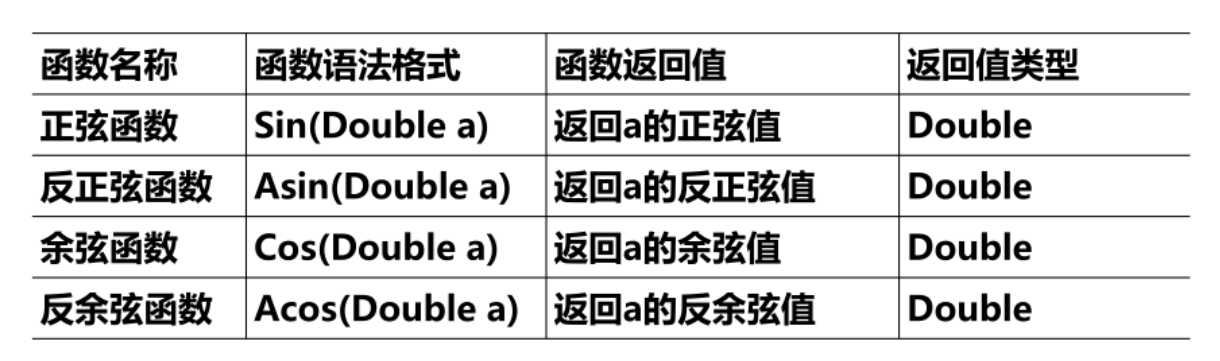
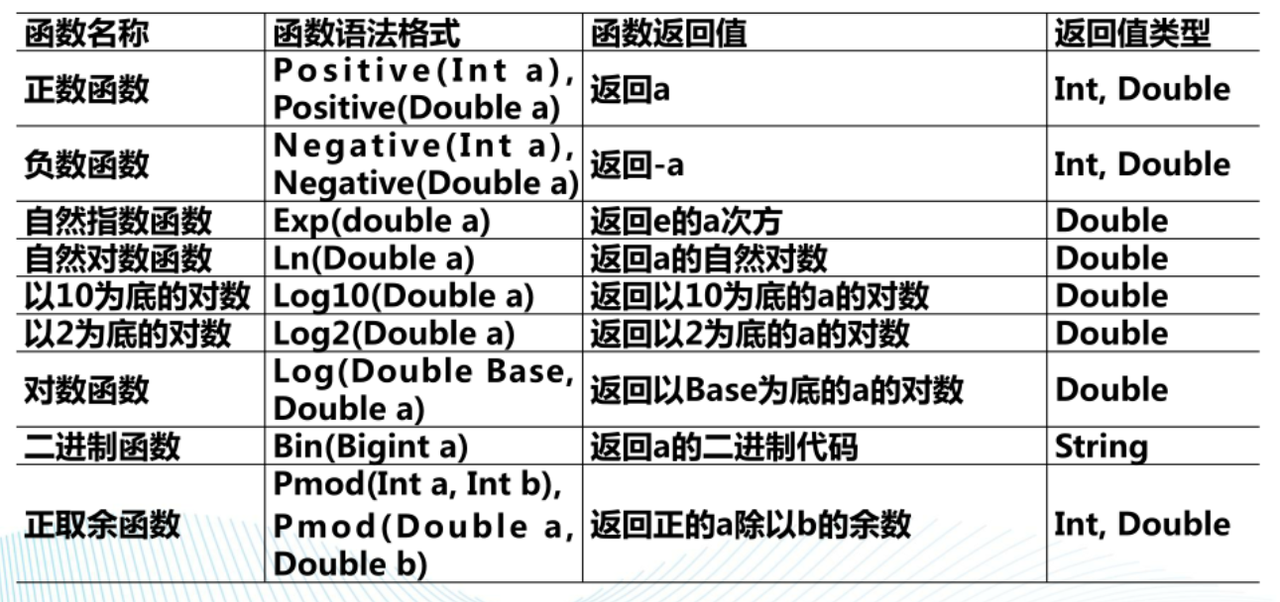
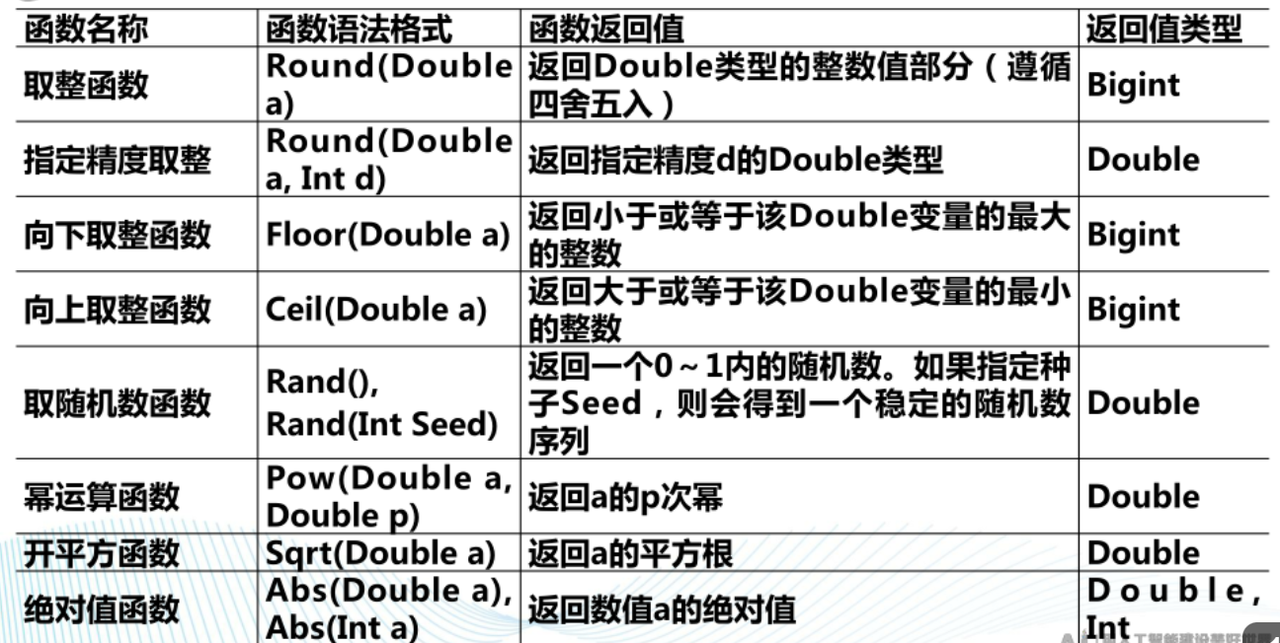
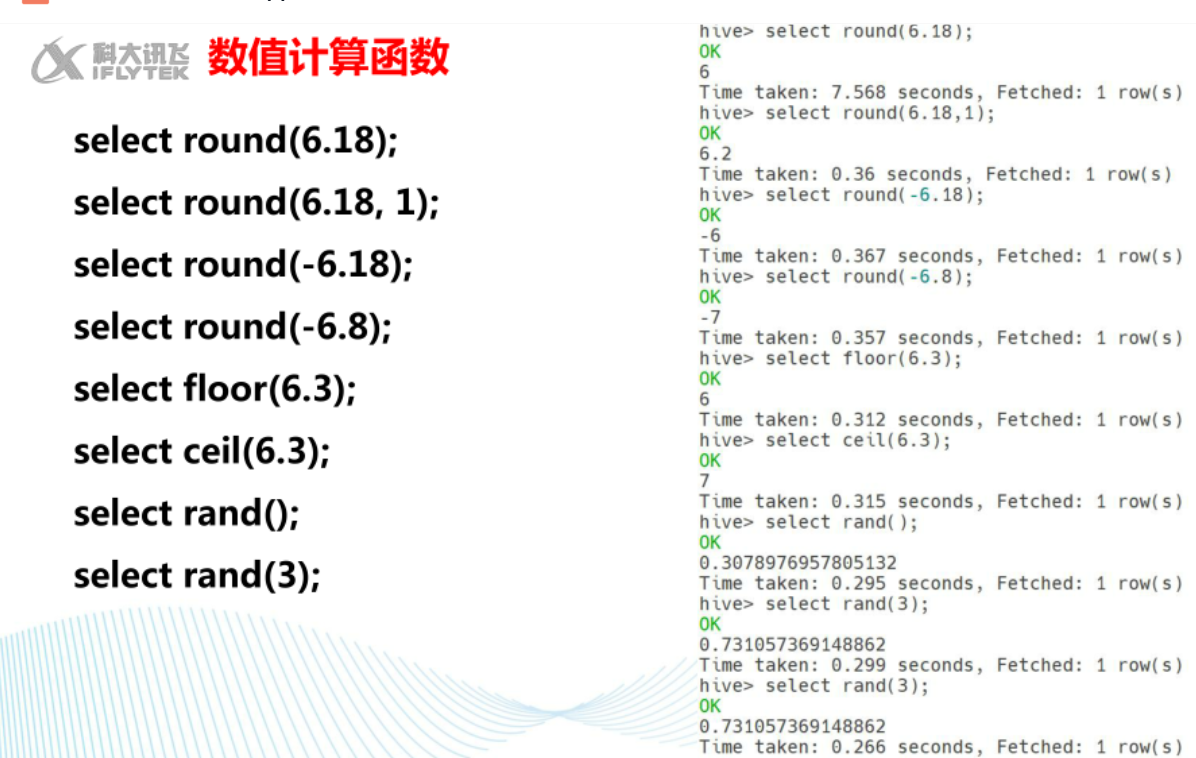
数值计算函数
常用的数值计算函数有:
聚合函数
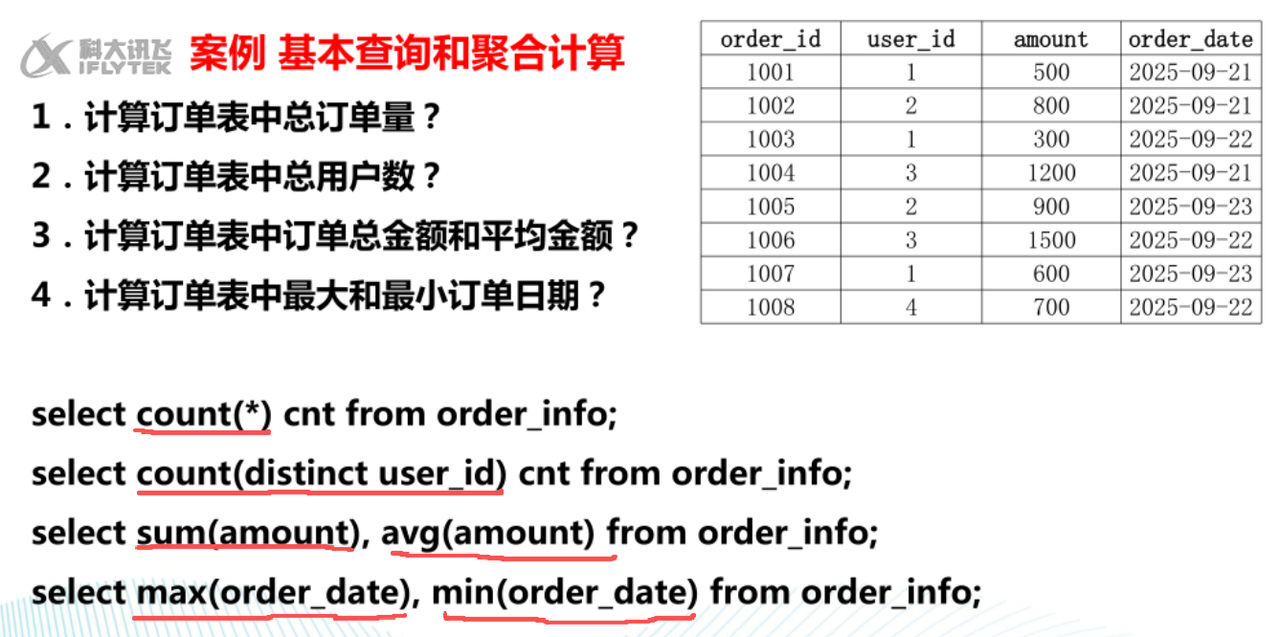
常用的聚合函数有:
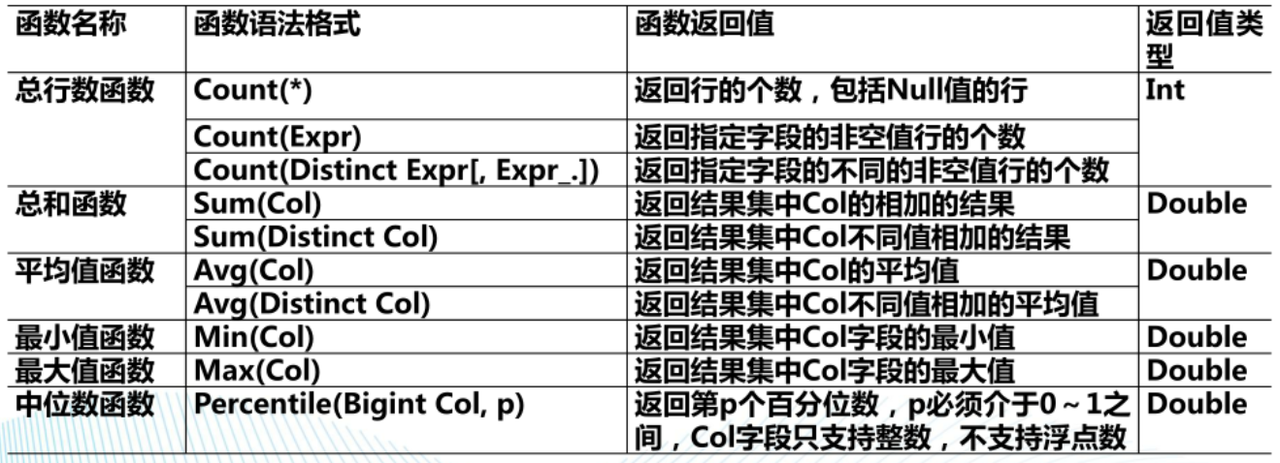
案例 基本查询和聚合计算
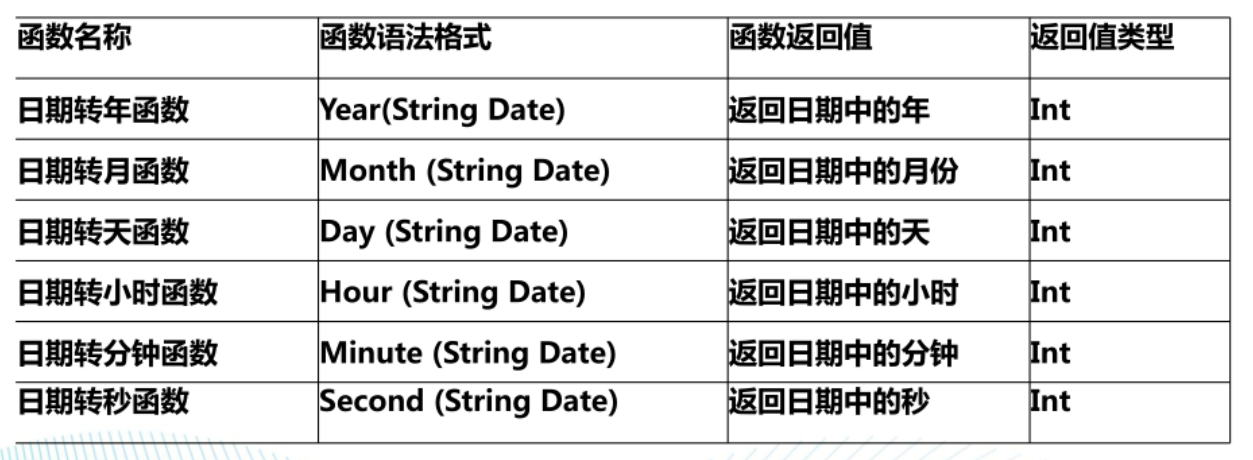
日期时间函数
常用的日期时间函数有:
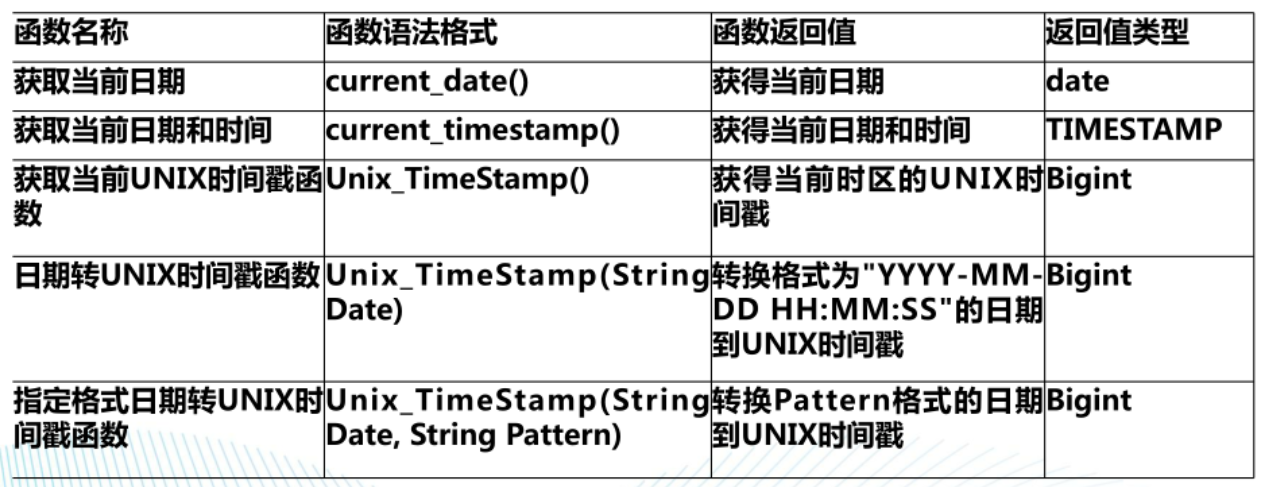
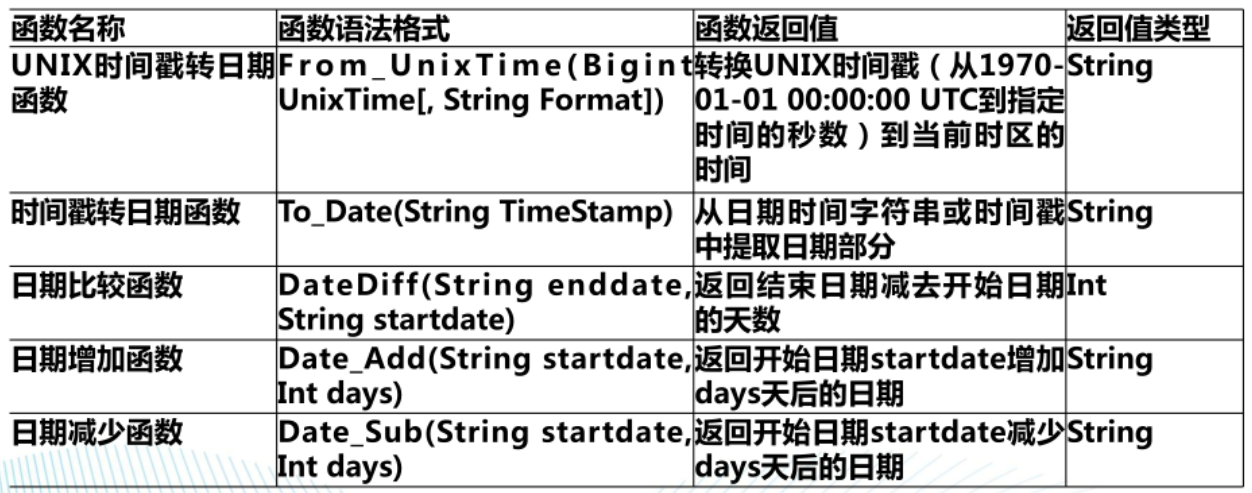
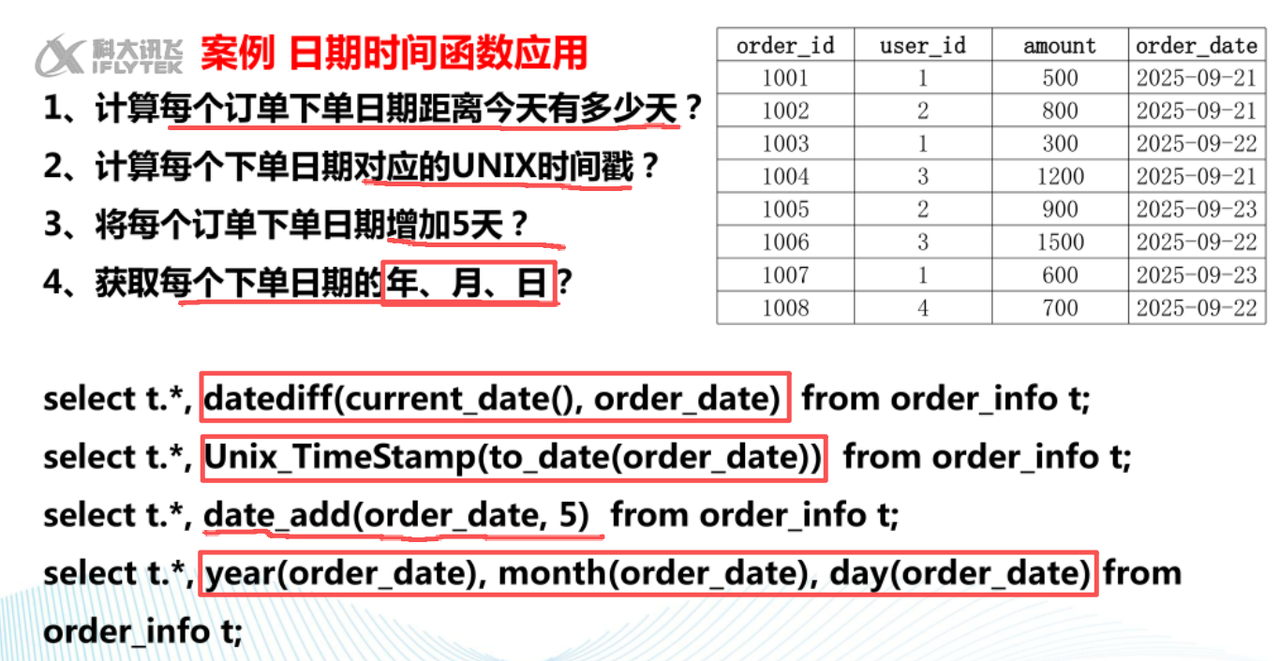
案例 日期时间函数应用
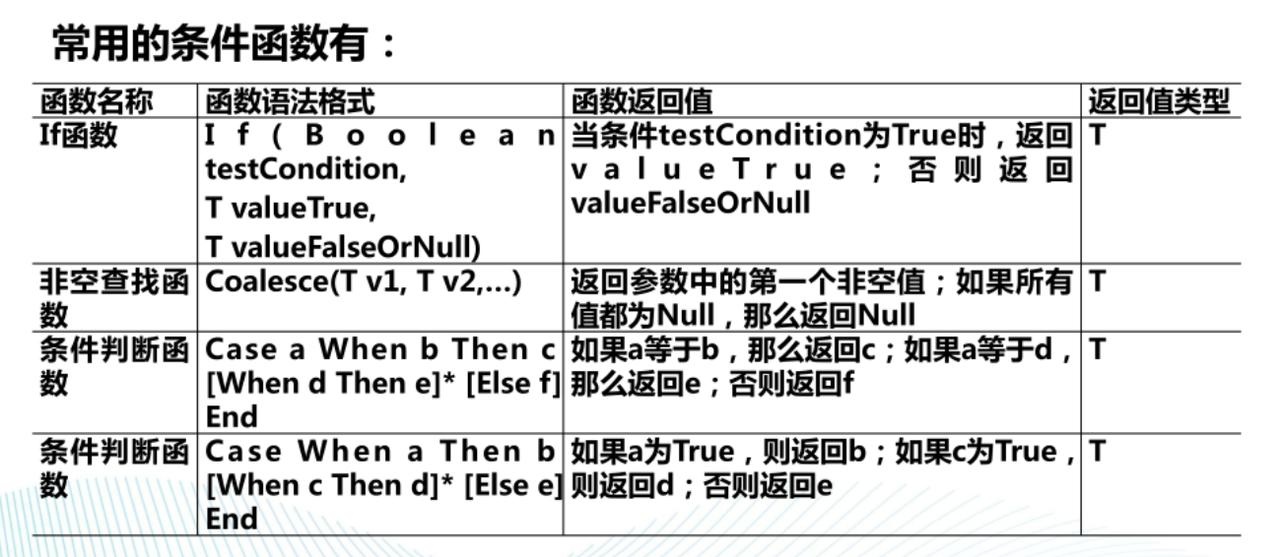
条件函数
常用的条件函数有:
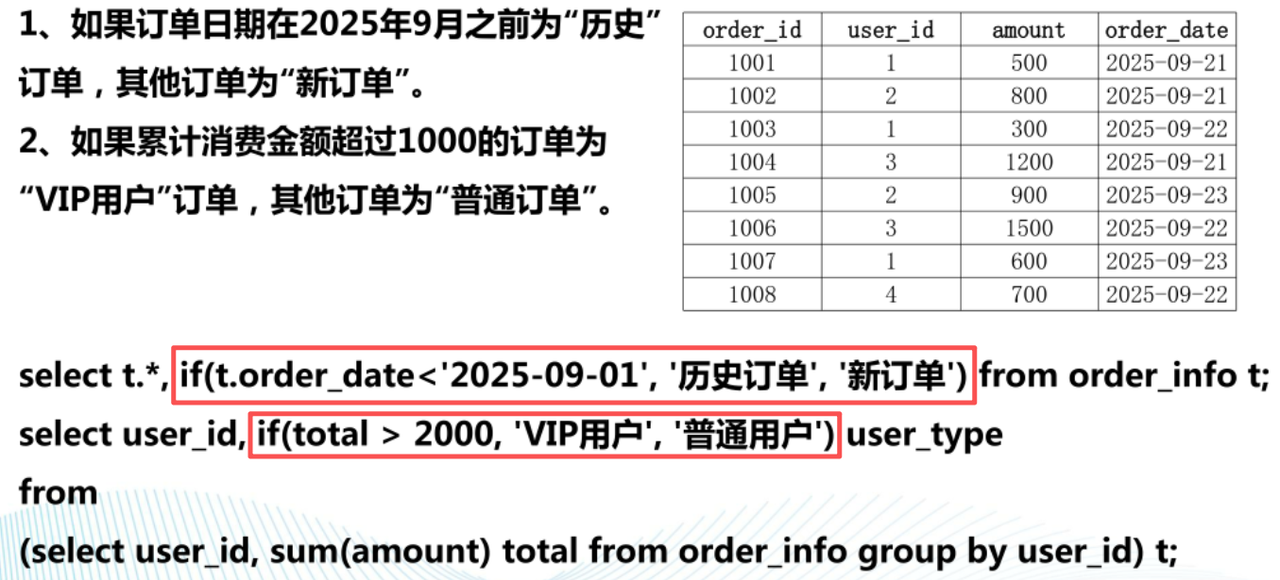
条件函数应用-if
条件函数应用-coalesce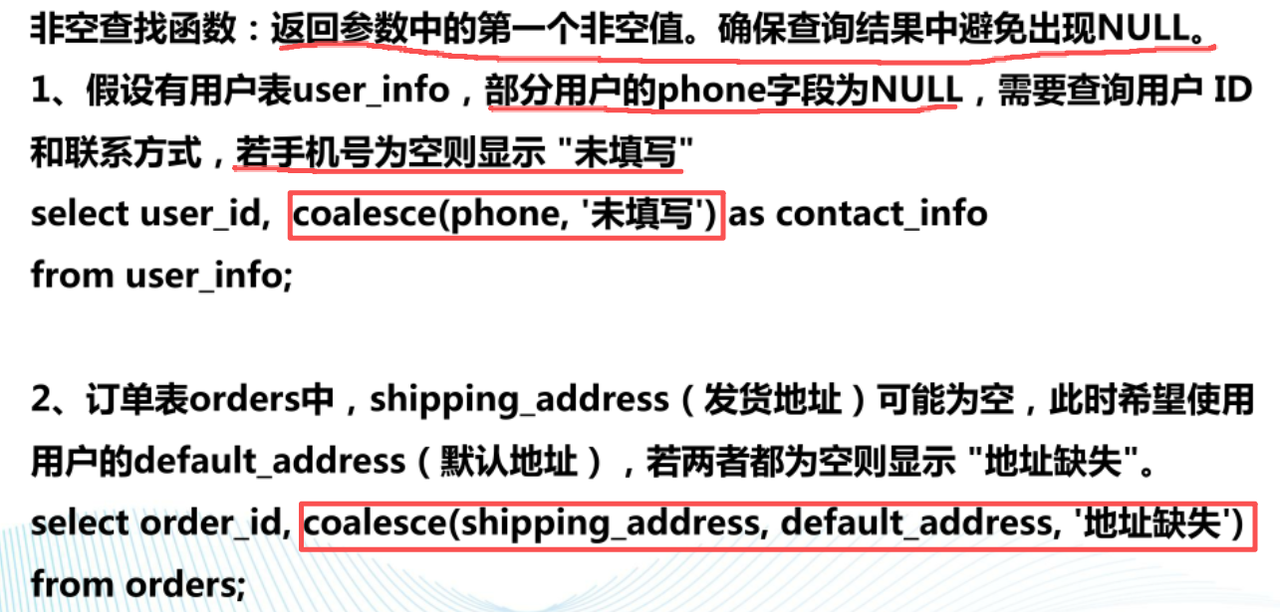
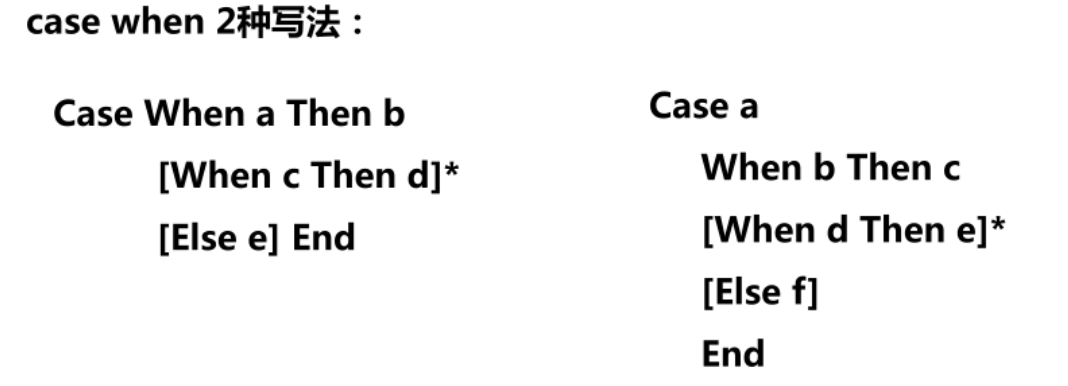
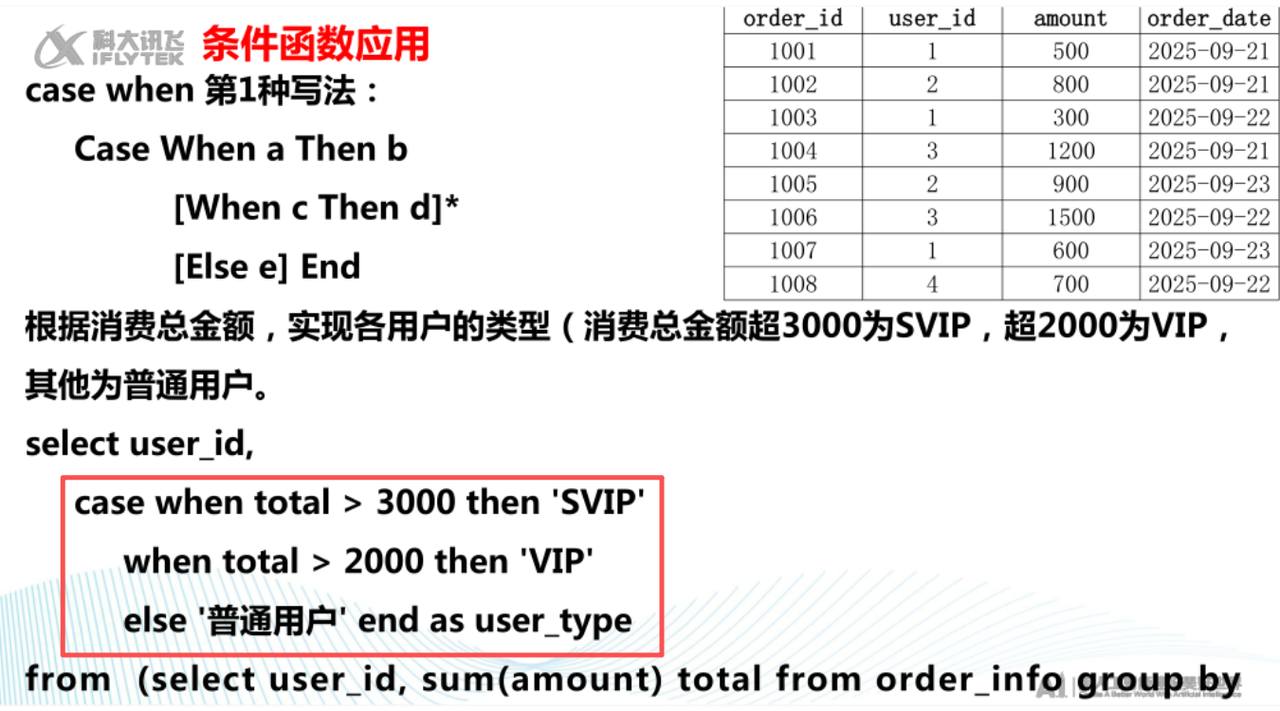
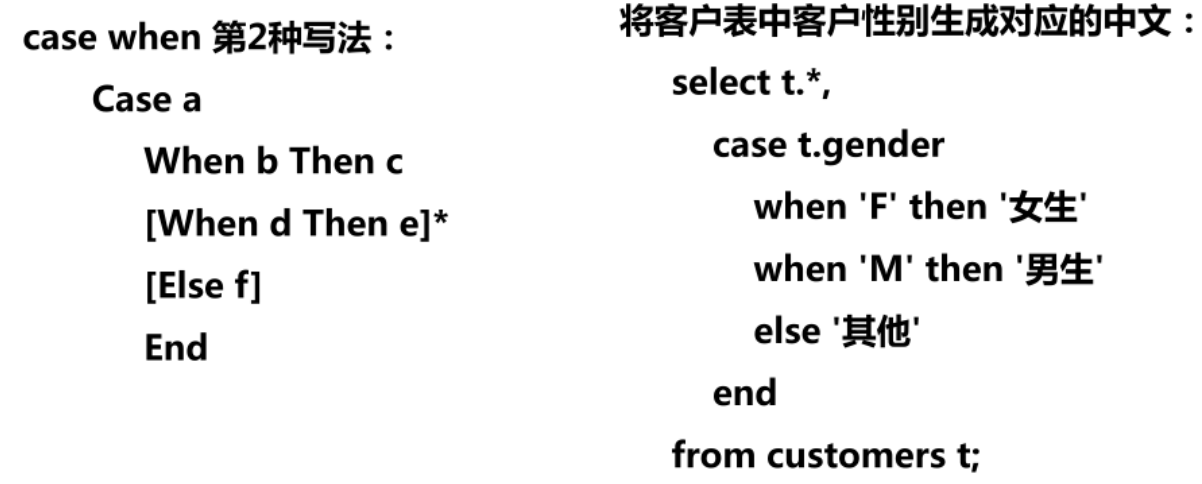
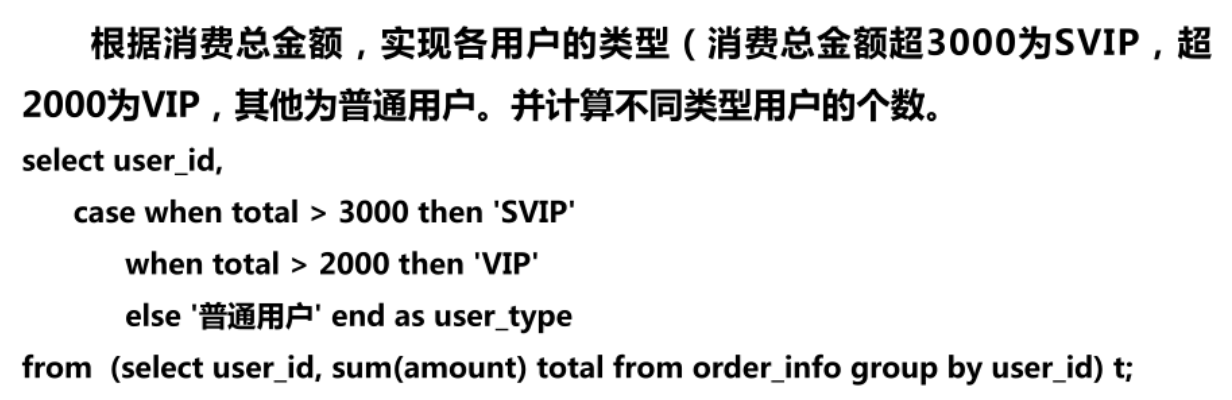
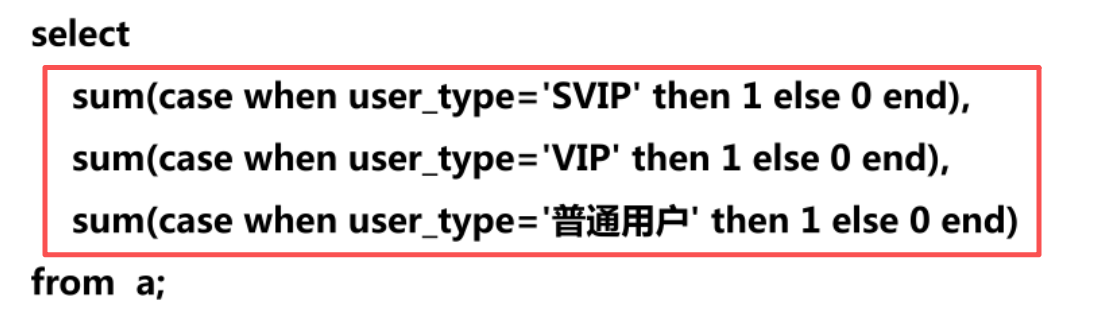
条件函数应用-case when
CTE
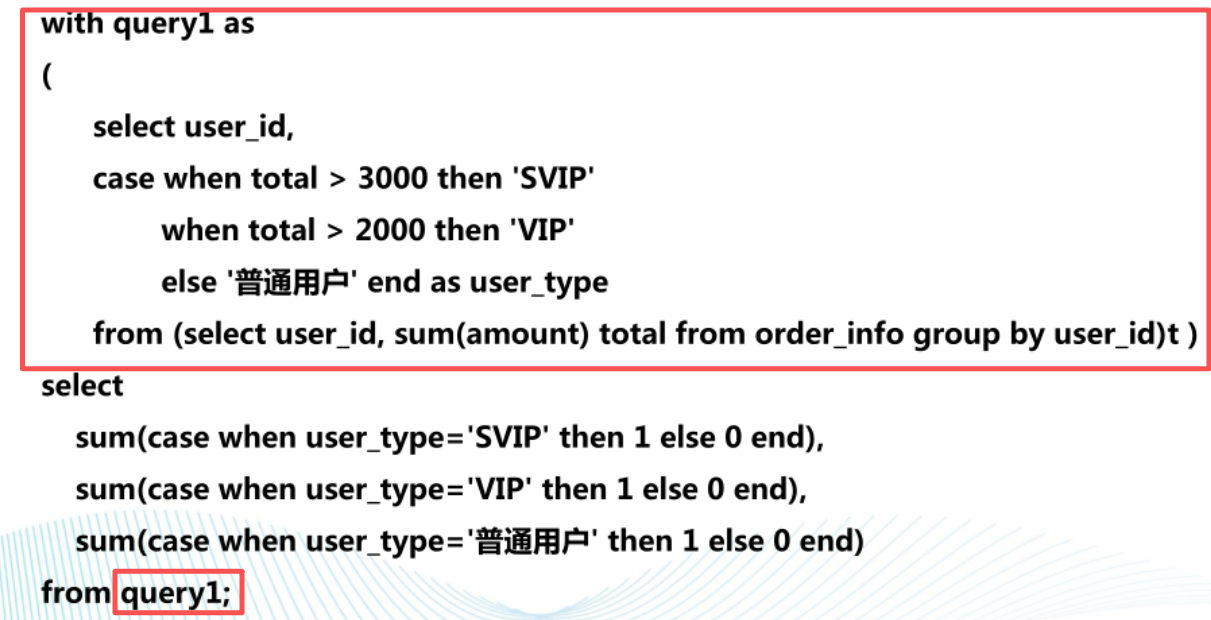
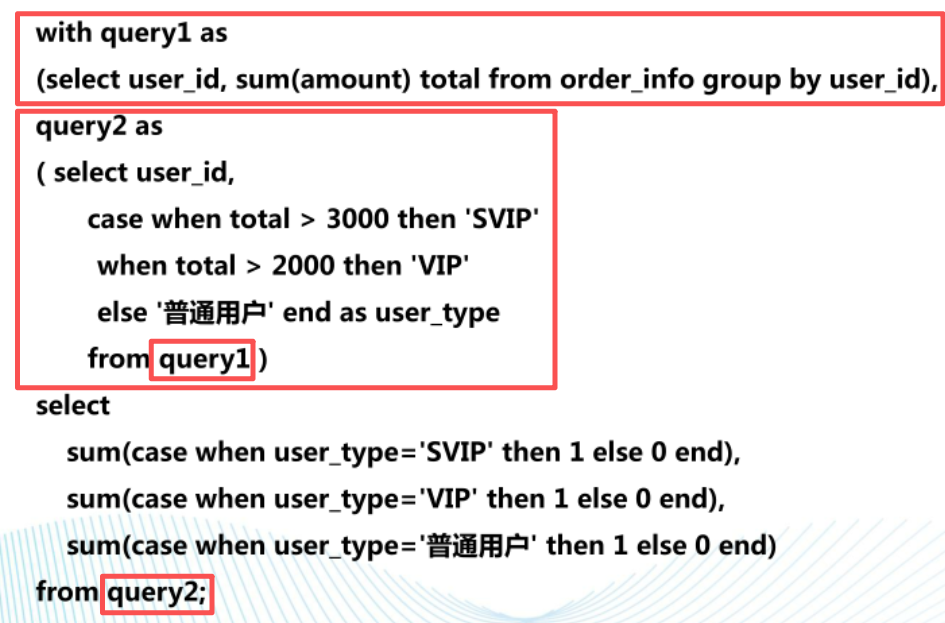
CTE(Common Table Expression,公用表达式)是一种临时结果集,用于简化复杂查询,提高可读性。CTE通过WITH子句定义,可在后续SQL语句中多次引用。
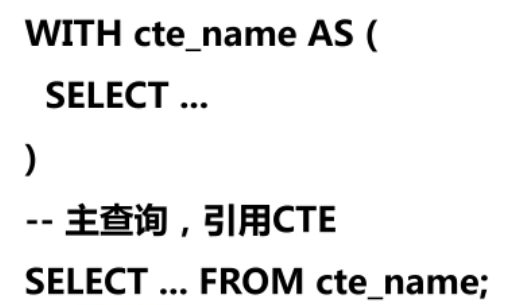
将复杂查询分为多个CTE,逻辑更清晰。
定义一次CTE,可在主查询中多次使用(避免重复编写子查询)。
注意:CTE仅在当前查询中有效,查询结束后自动销毁。
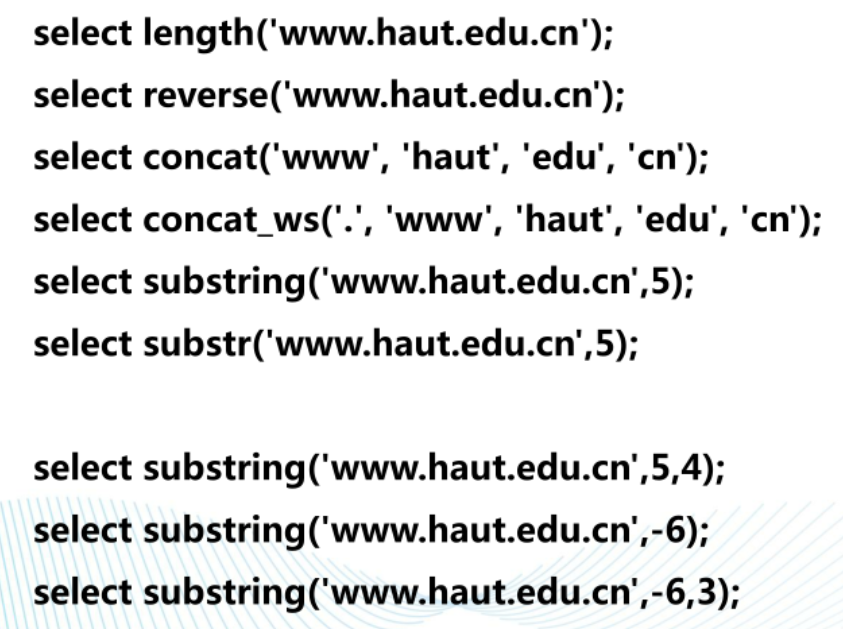
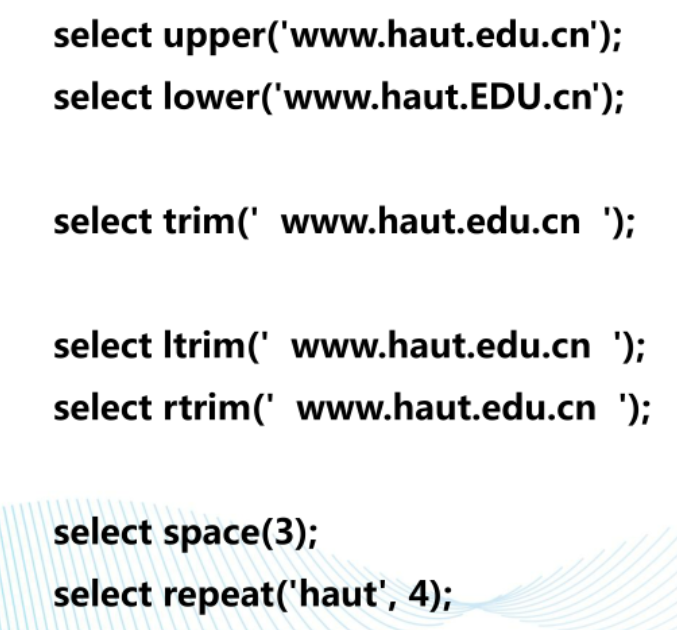
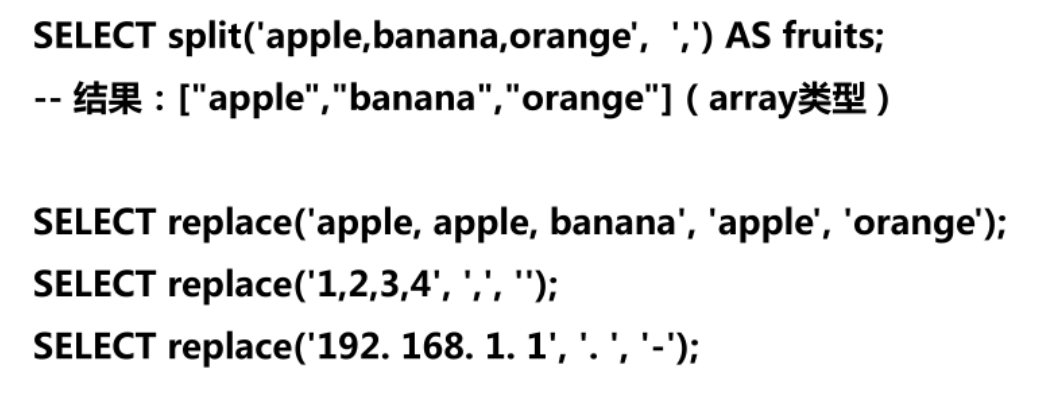
字符串处理函数
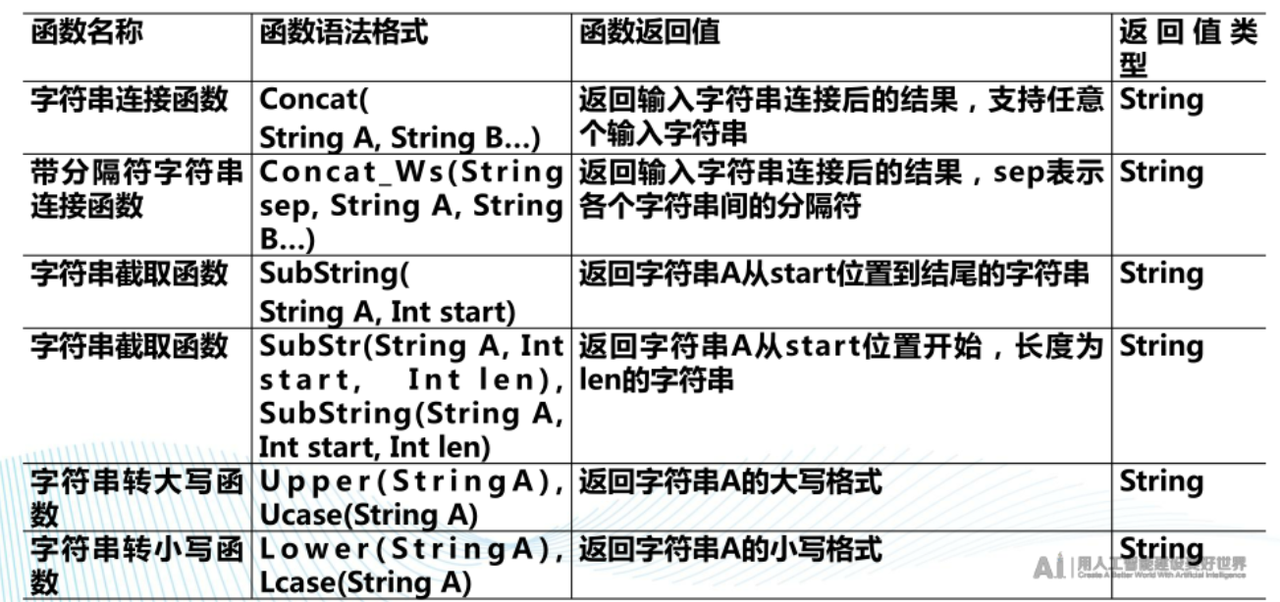
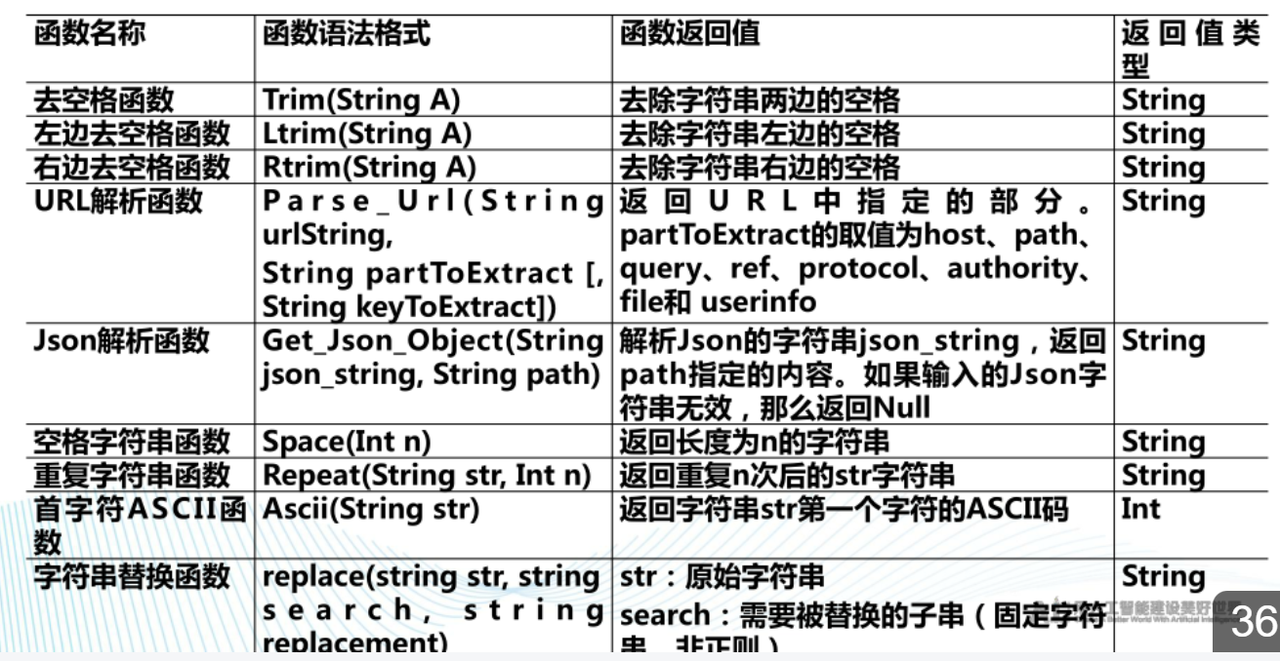
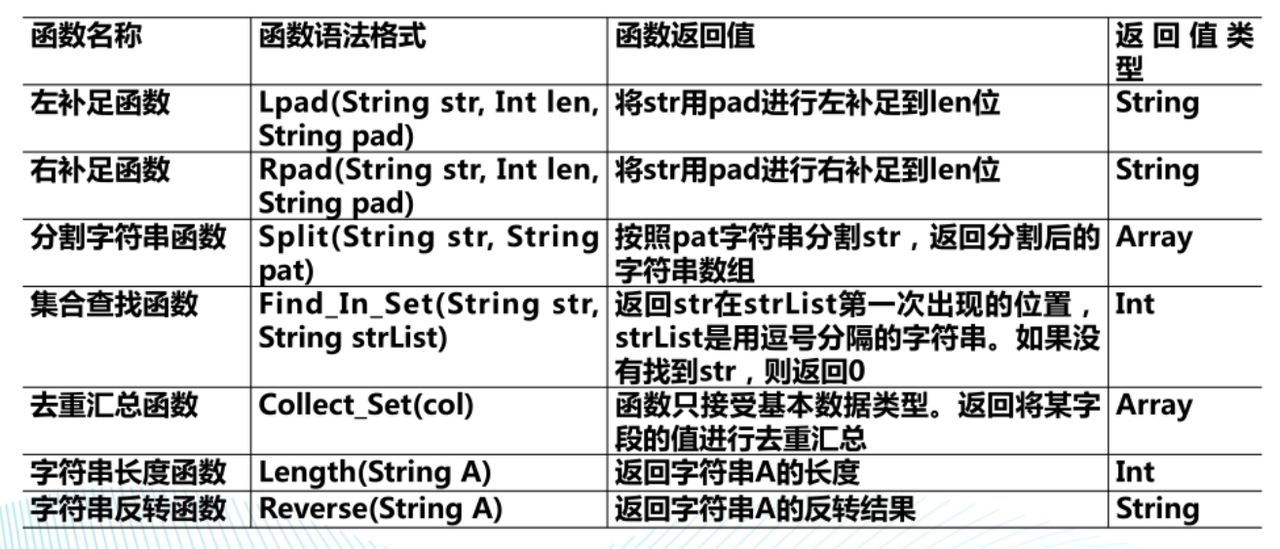
常用的字符串处理函数有:
案例 字符串处理函数应用
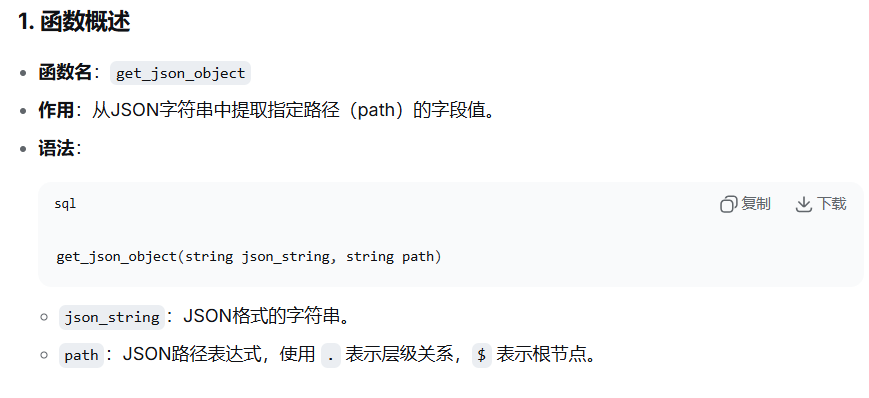
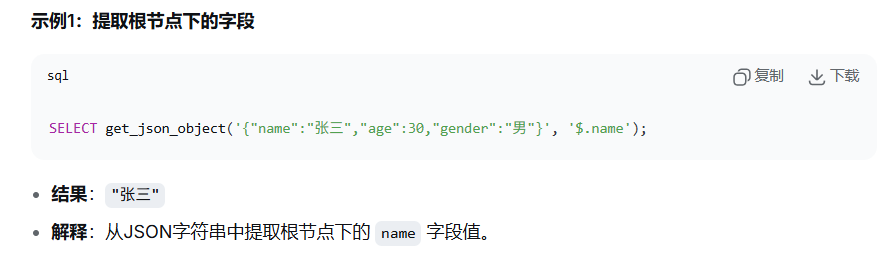
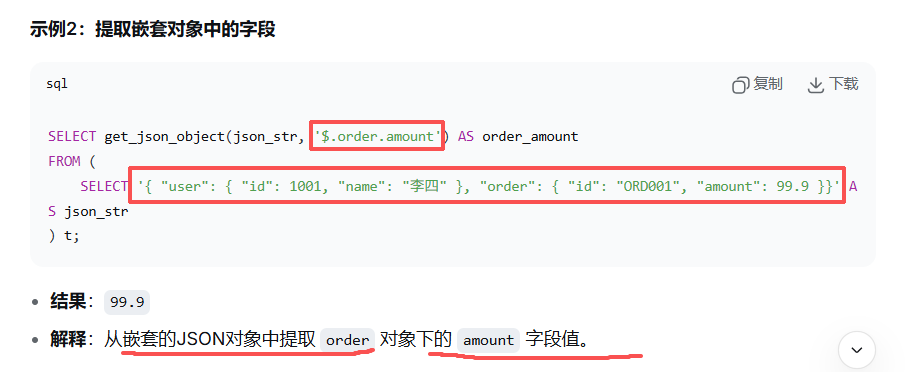
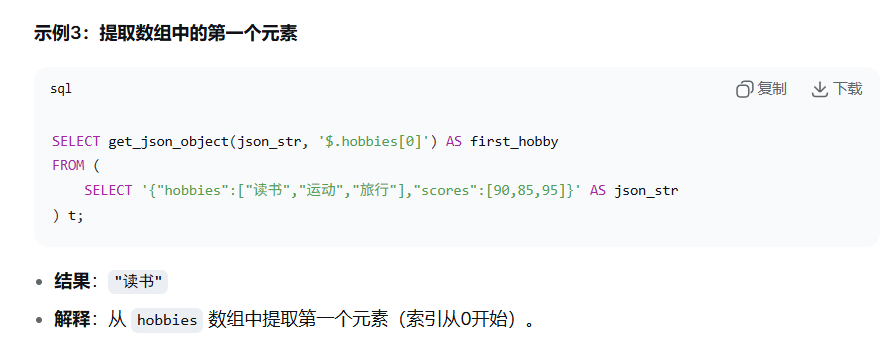
总结:
get_json_object 函数的常见用法:
-
提取简单字段
-
提取嵌套对象字段
-
提取数组元素
其他函数
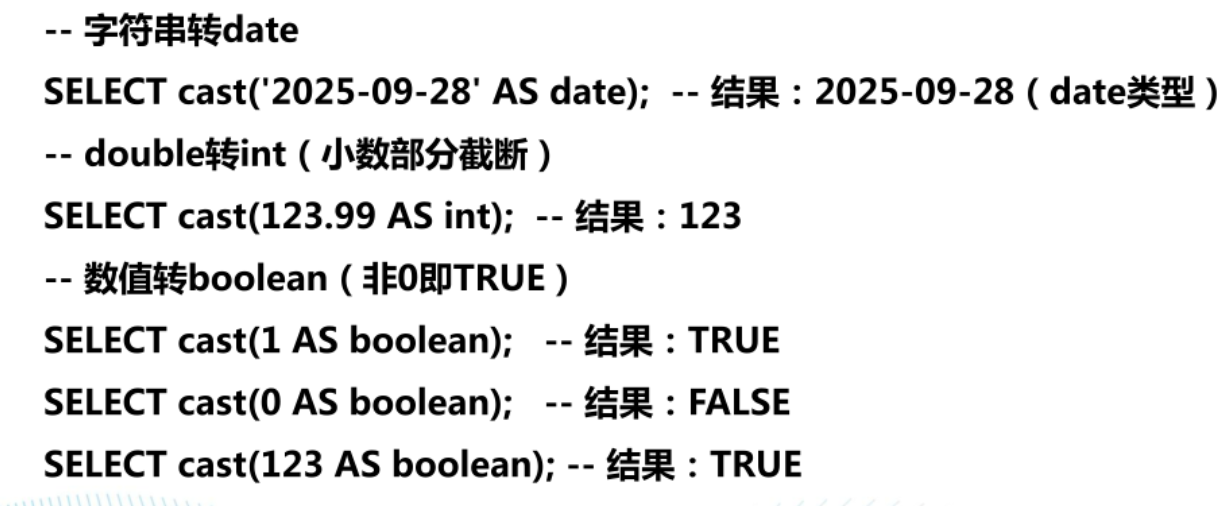
类型转换函数cast()
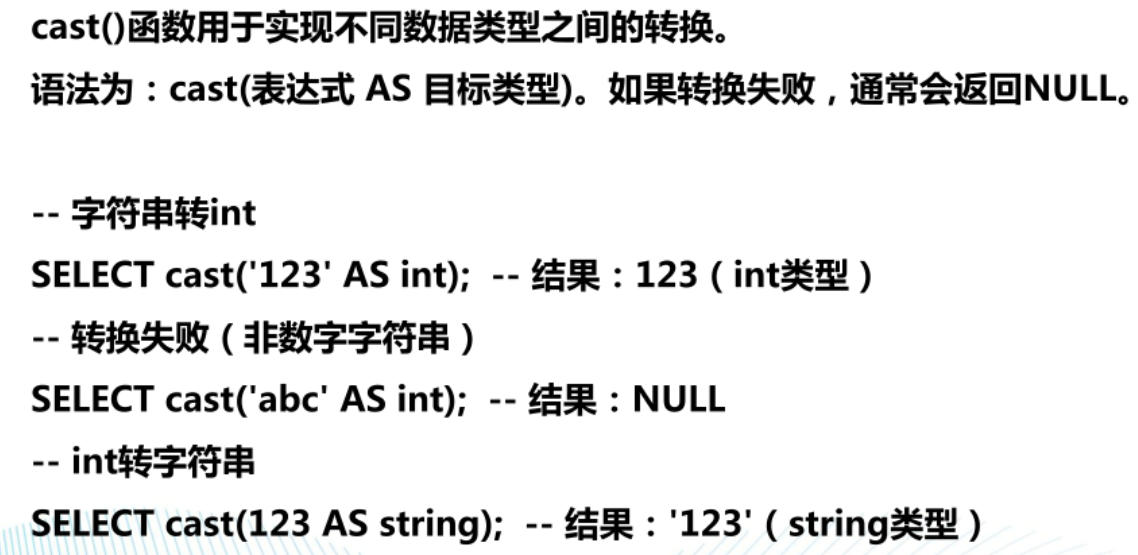
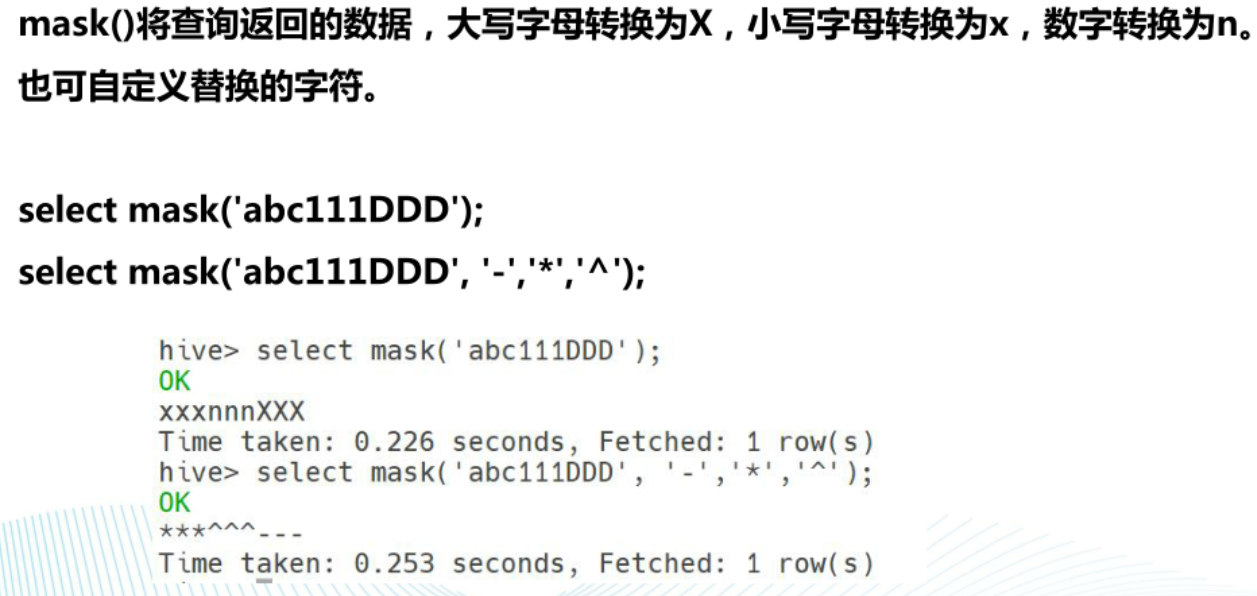
数据脱敏函数mask()
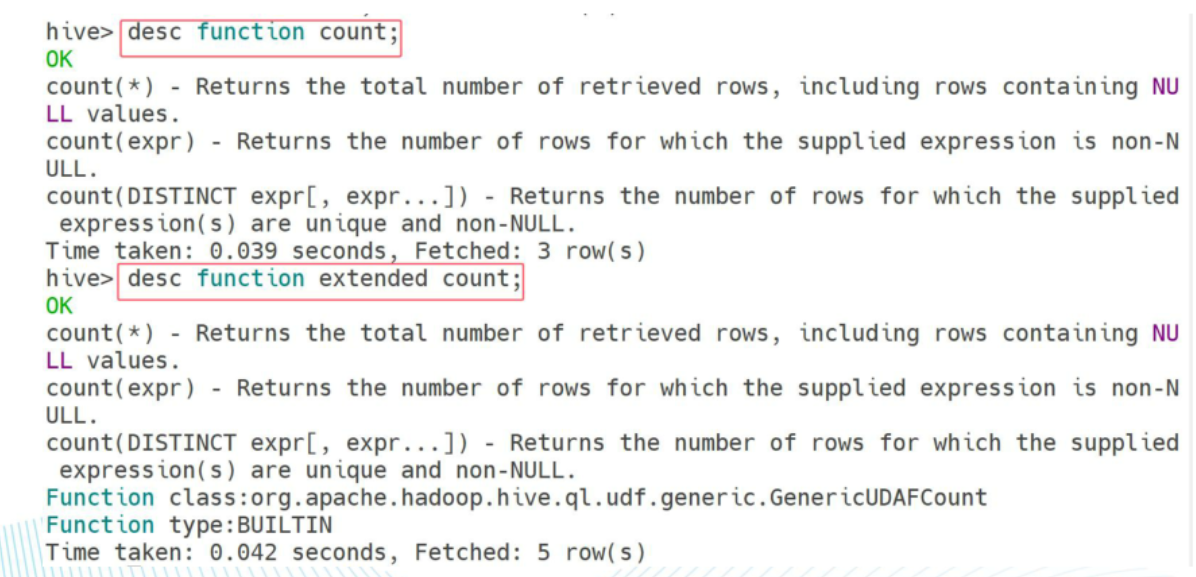
内置函数查看命令
show functions --查看系统内所有内置函数
desc function function _name --查看单个函数用法
desc function extended function_name --详细用法,简单例子
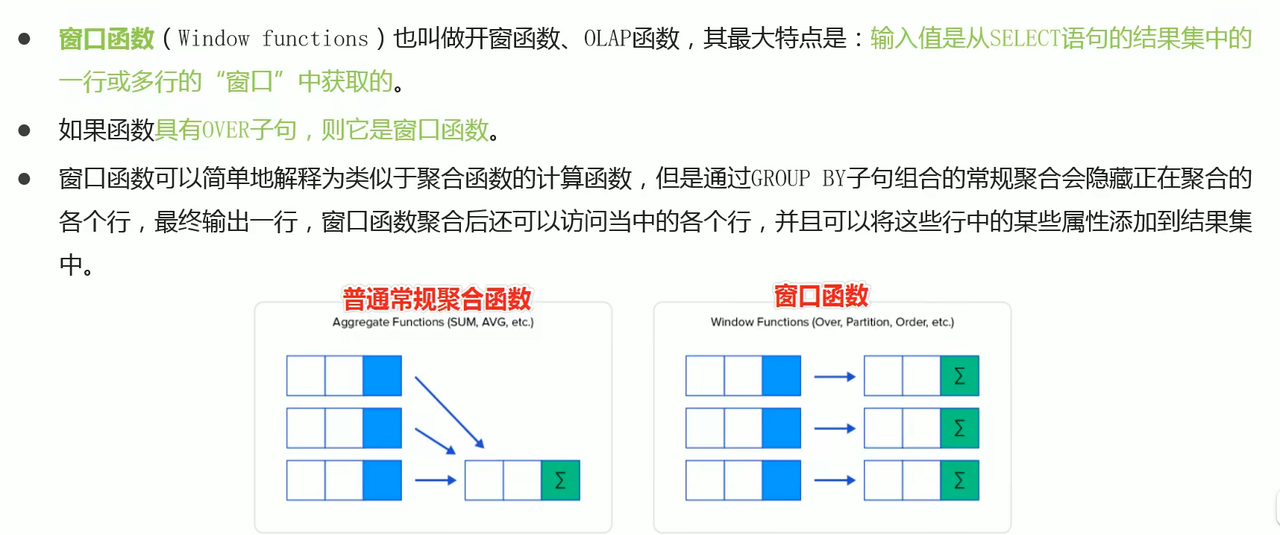
窗口函数
概念与语法规则
概念:
举例说明:
以下是一个employee表
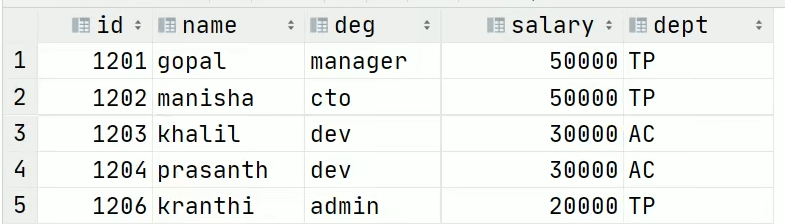
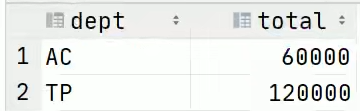
sum+Group By常规聚合操作

结果:
sum+窗口函数聚合操作

结果:
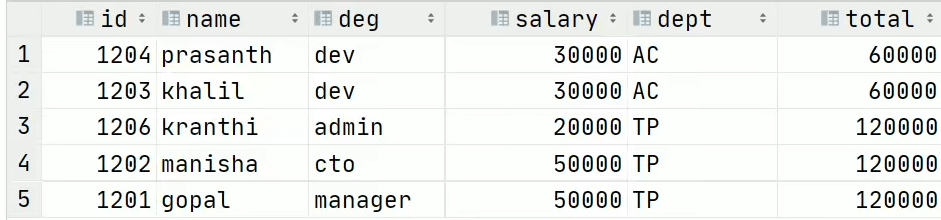
两种不同的操作方式可以使用"森林"来举例,sum+Group By常规聚合操作只能看到"森林",而sum+窗口函数聚合操作既能看到森林又能看到树木。
语法规则:
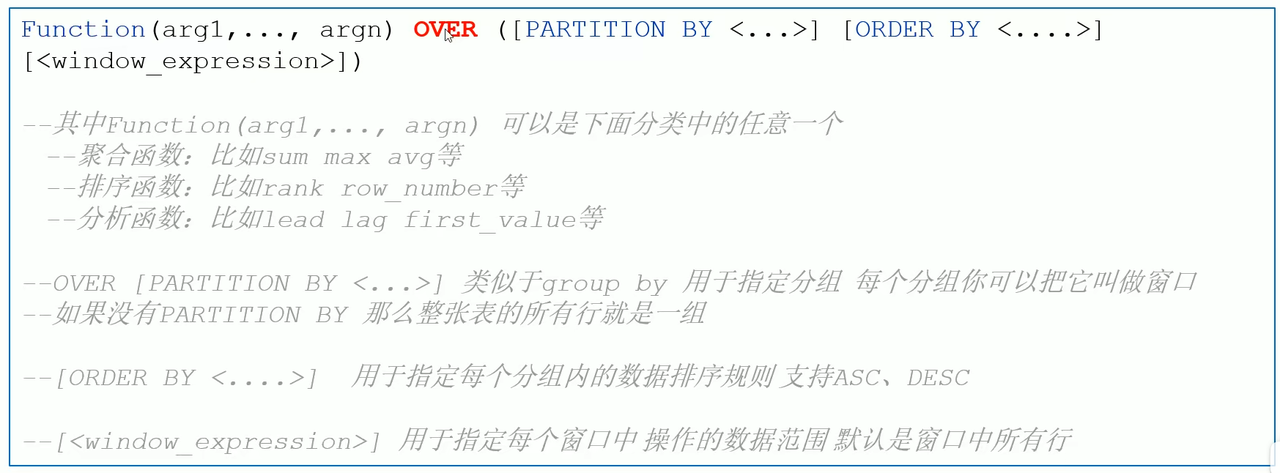
窗口聚合函数
案例讲解:
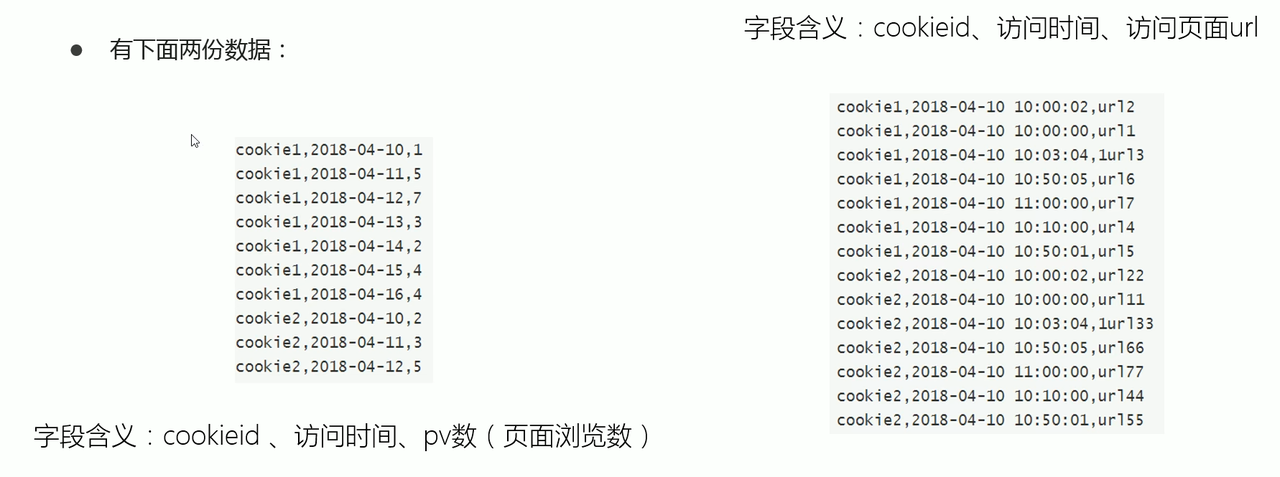
下面以sum()函数为例,其他聚合函数类似。
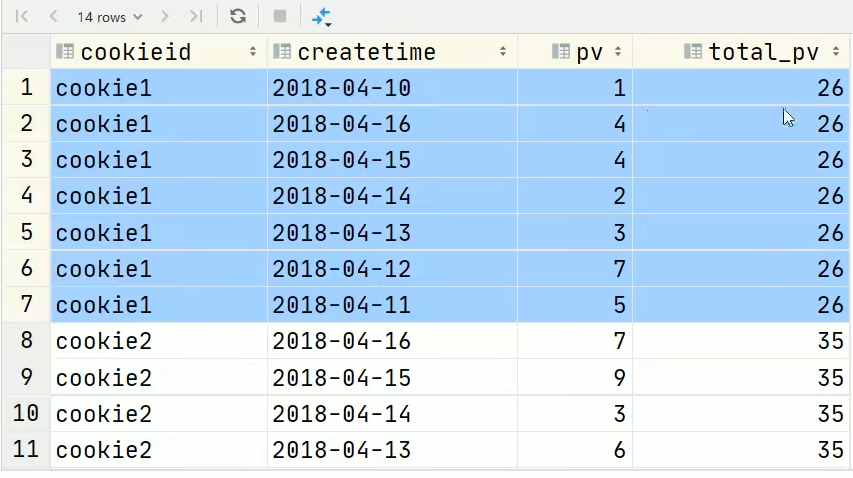
需求:求出每个用户总PV数 sum+Group By普通常规聚合操作

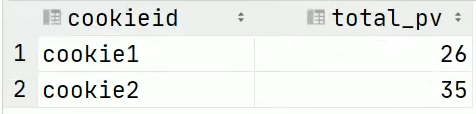
需求:求出每个网站总PV数 所有用户所有访问加起来
sum(...) over()对表所有行求和

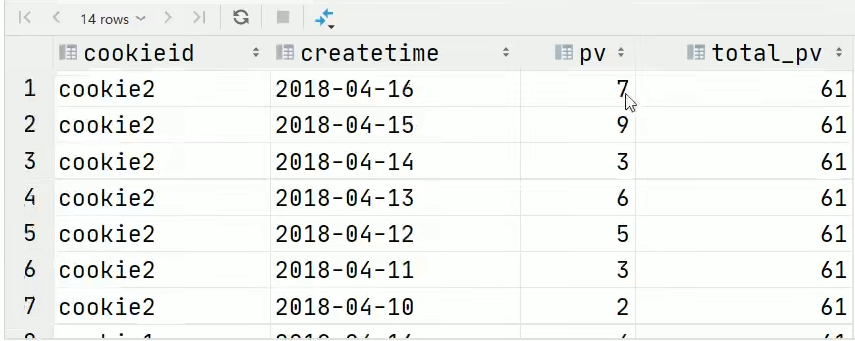
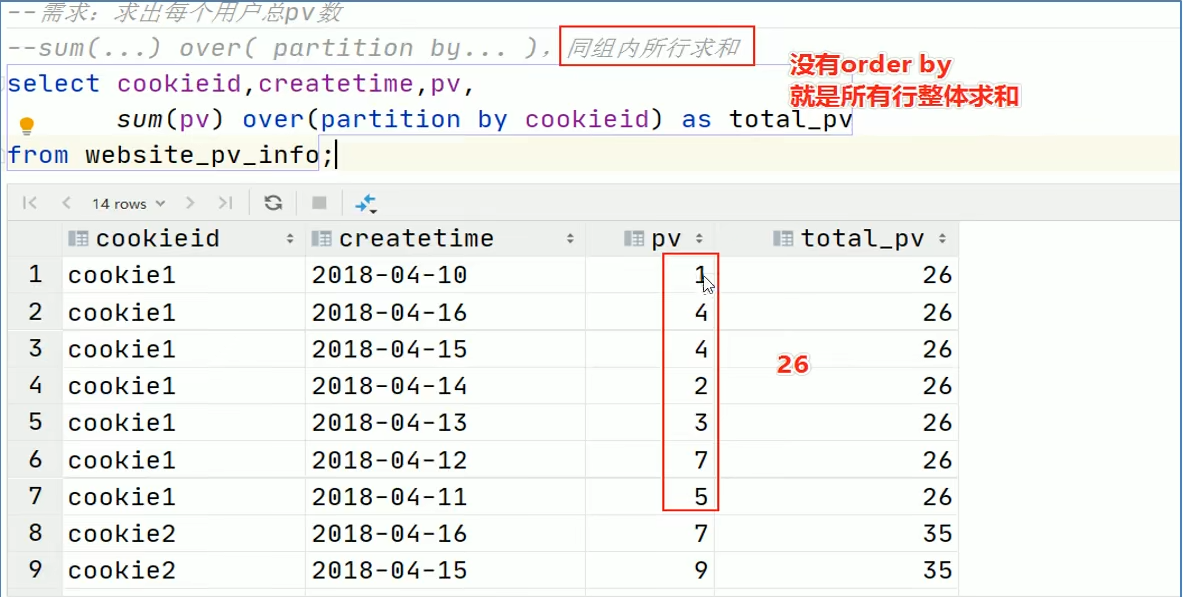
需求:求出每个用户总PV数
sum(...) over(partition by...),同组内所有行求和
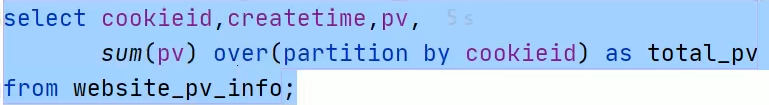
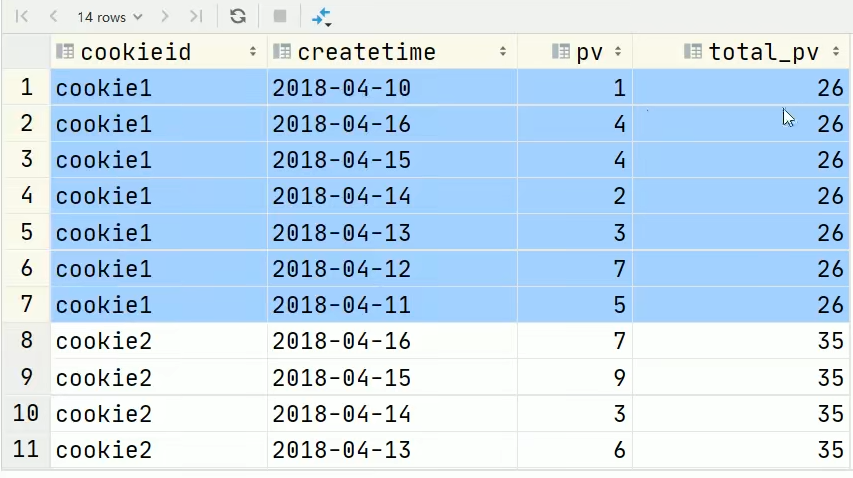
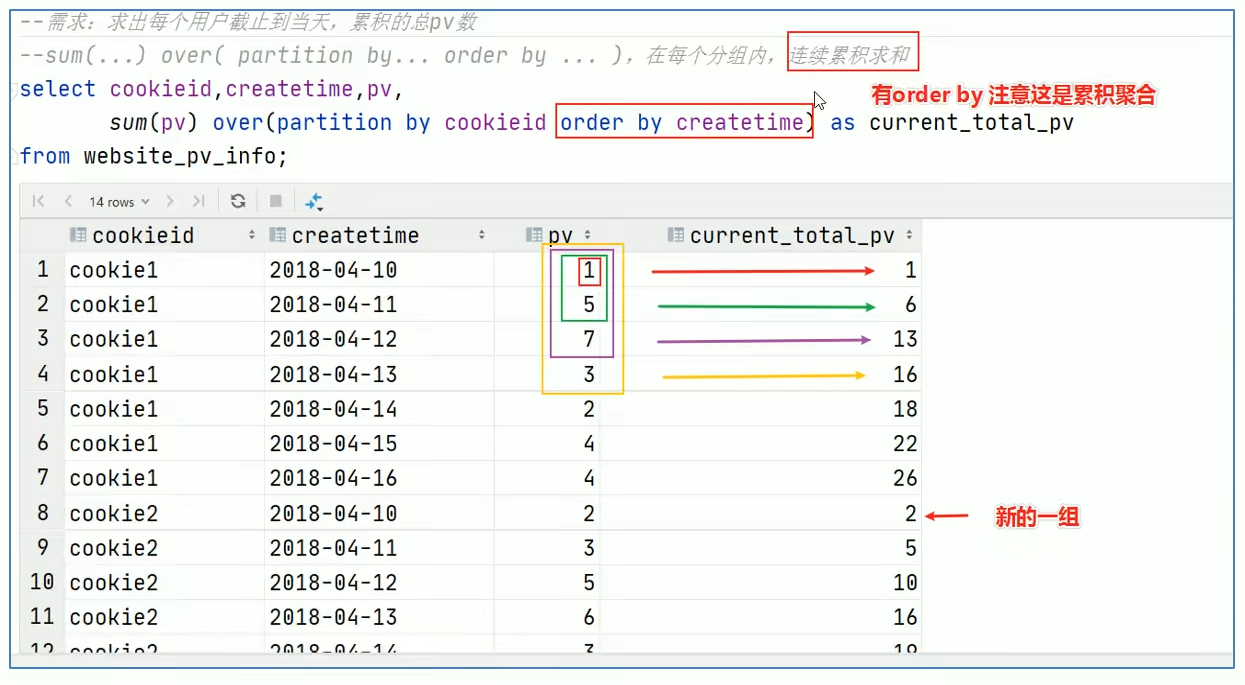
需求:求出每个用户截止到当天,累积的总PV数
sum(...) over(partition by... order by...),在每个分组内连续累积求和
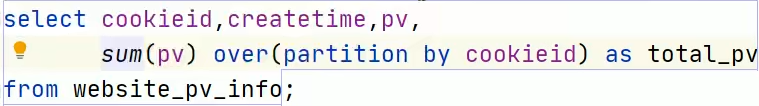
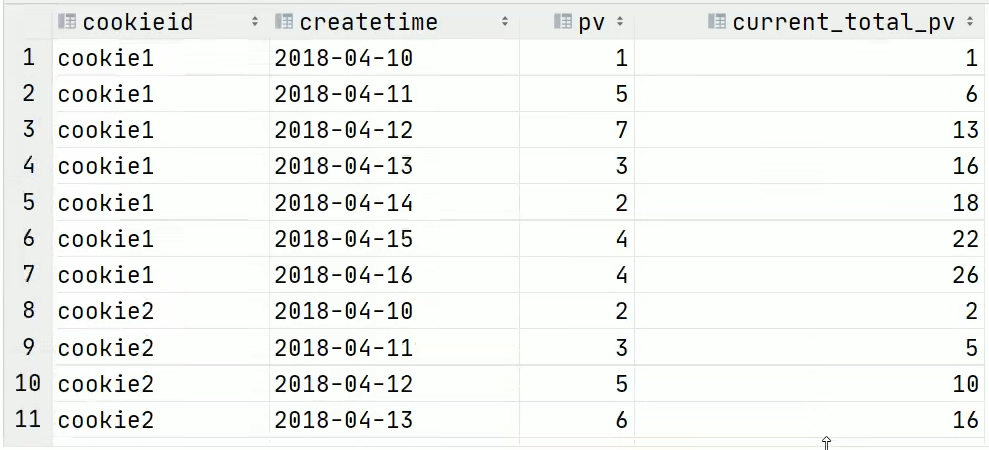
order by是关键,使用了之后就是累积求和
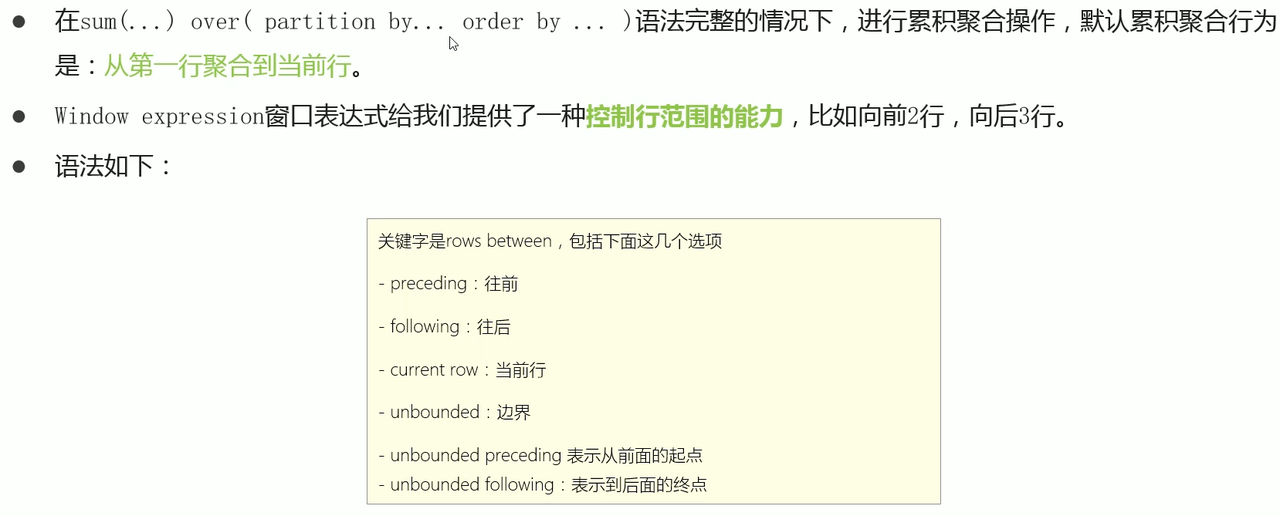
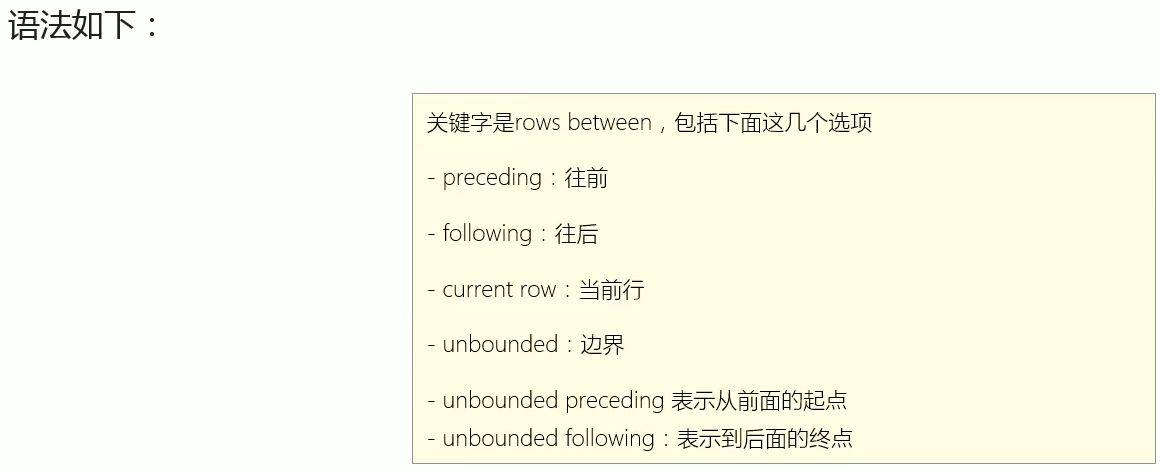
窗口表达式
案例
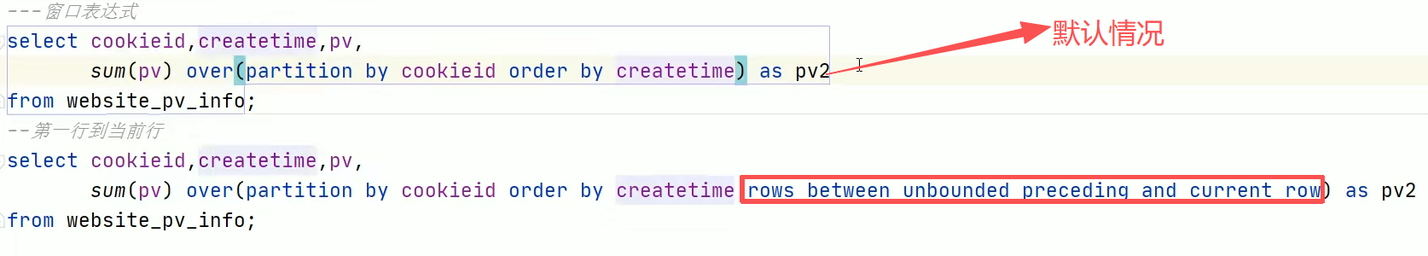
在窗口表达式指定第一行到当前行时与默认情况是一致的
1.向前三行到当前行

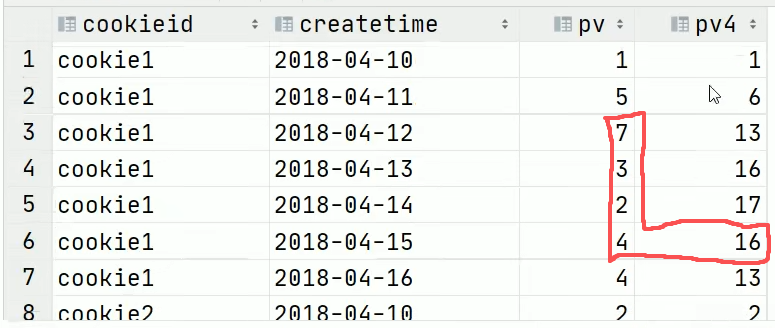
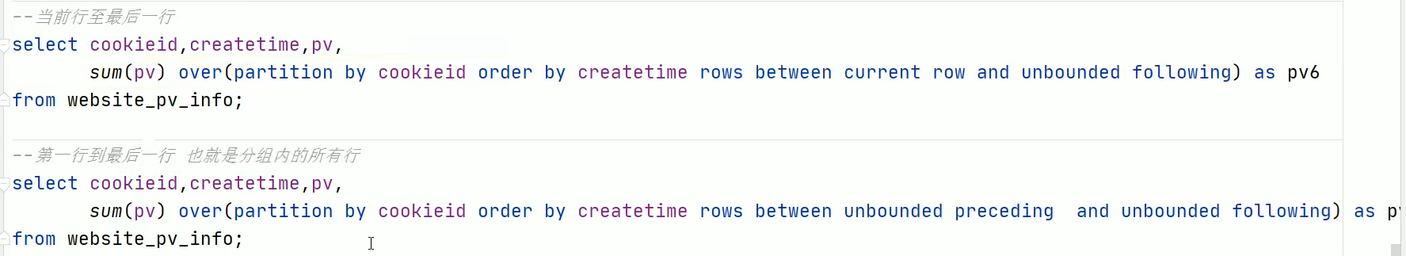
其他情况(图中注释有说明)
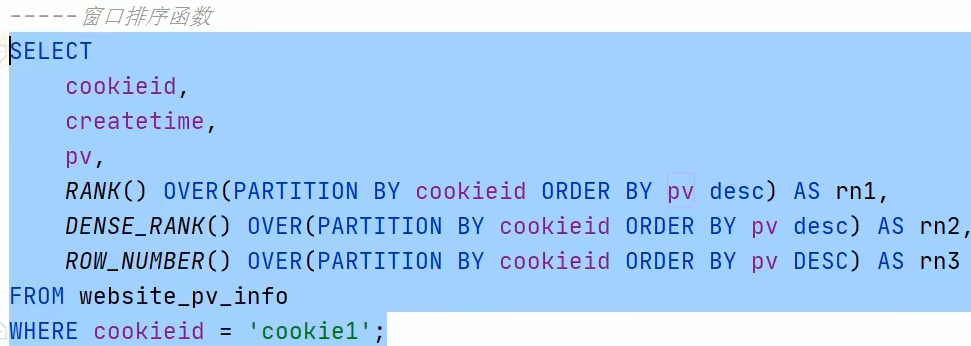
窗口排序函数
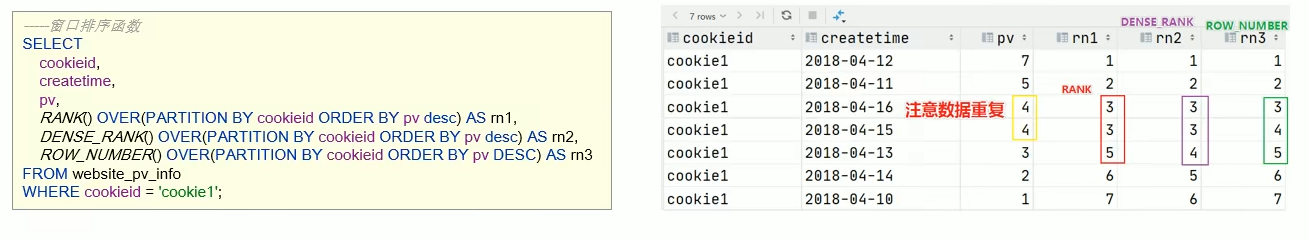
row_number:在每个分组中,为每行分配一个从1开始的唯一序列号,递增,不考虑重复。
rank:在每个分组中,为每行分配一个从1开始的唯一序列号,考虑重复,挤占后续位置。
dense rank:在每个分组中,为每行分配一个从1开始的唯一序列号,考虑重复,不挤占后续位置。
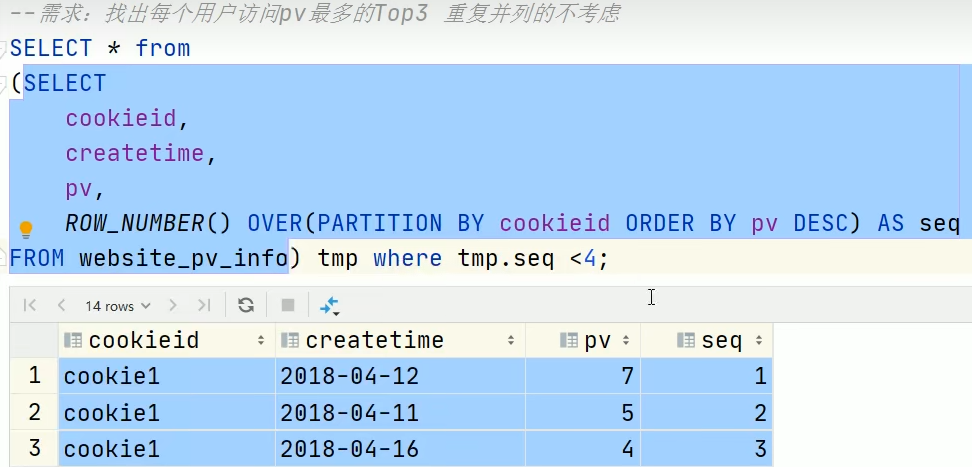
业务案例:找出每个用户访问PV最多的Top3,重复并列的不考虑
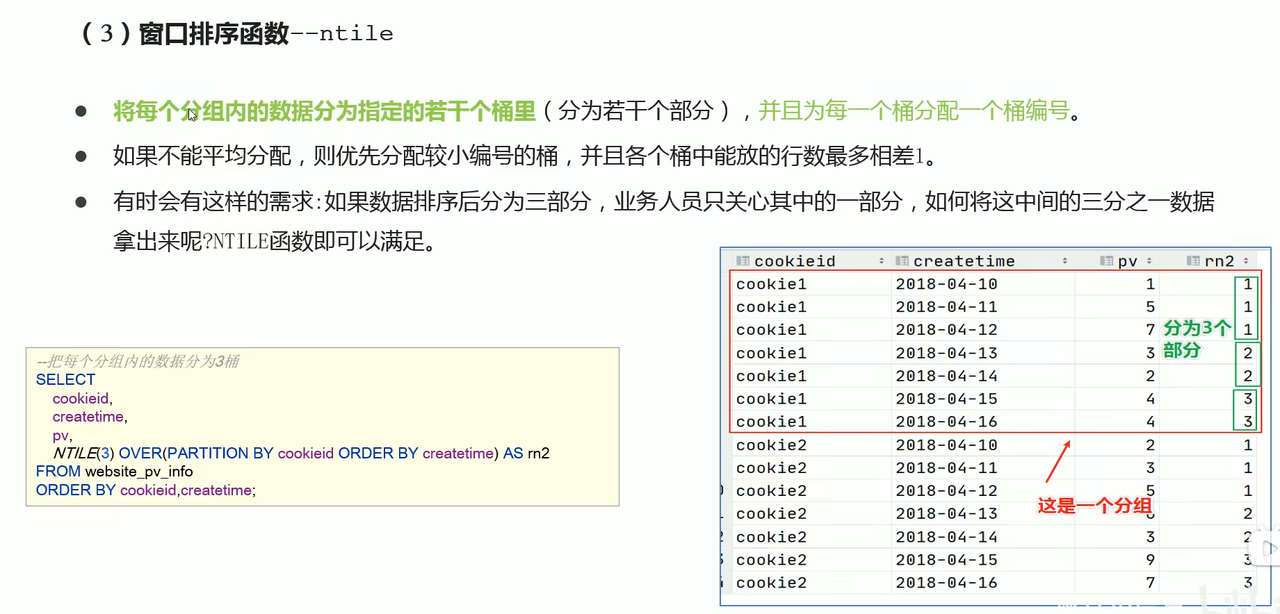
ntile()
窗口分析函数
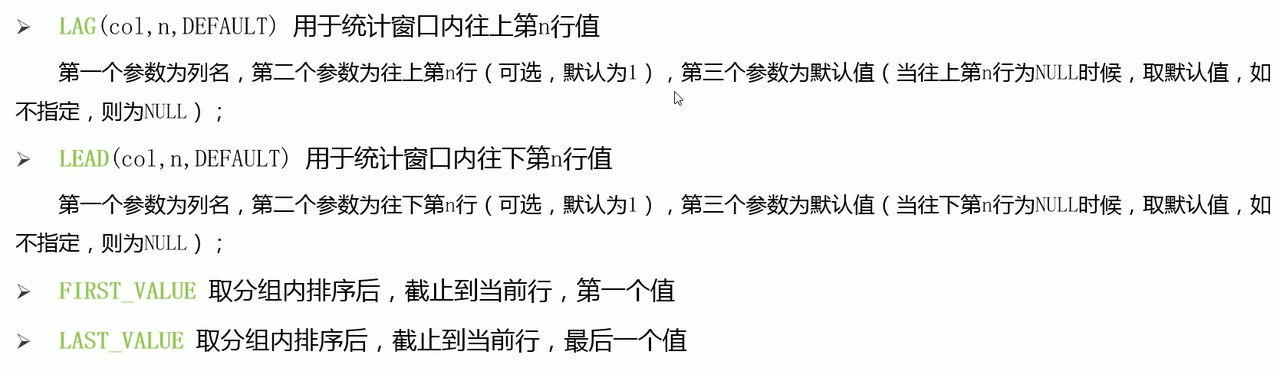
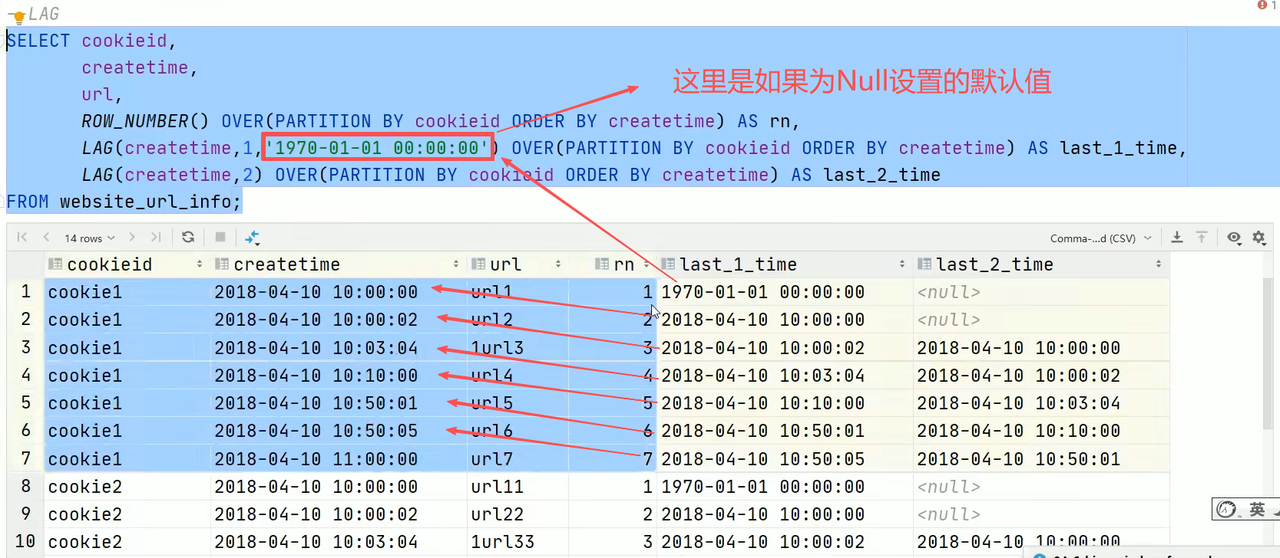
由于LAG是统计窗口内往上第n行值
图示中就是统计窗口往上的第1行
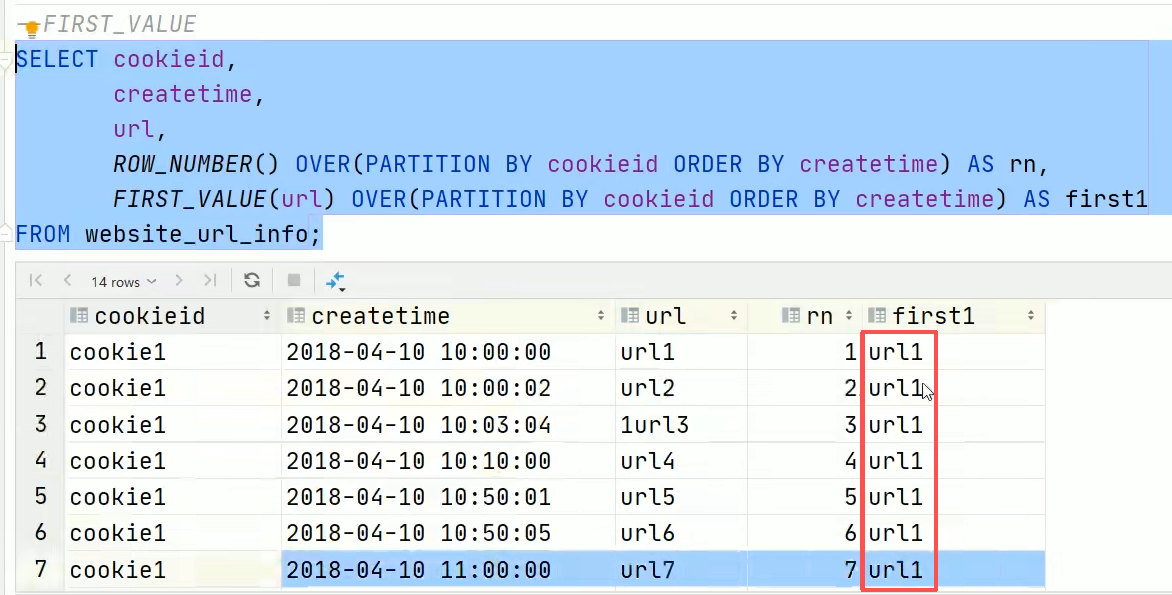
FIRST_VALUE是取分组内排序后截止到当前行的第一个值
所以下图分组内截止到当前行的第一个值永远都是url1
其他常用函数
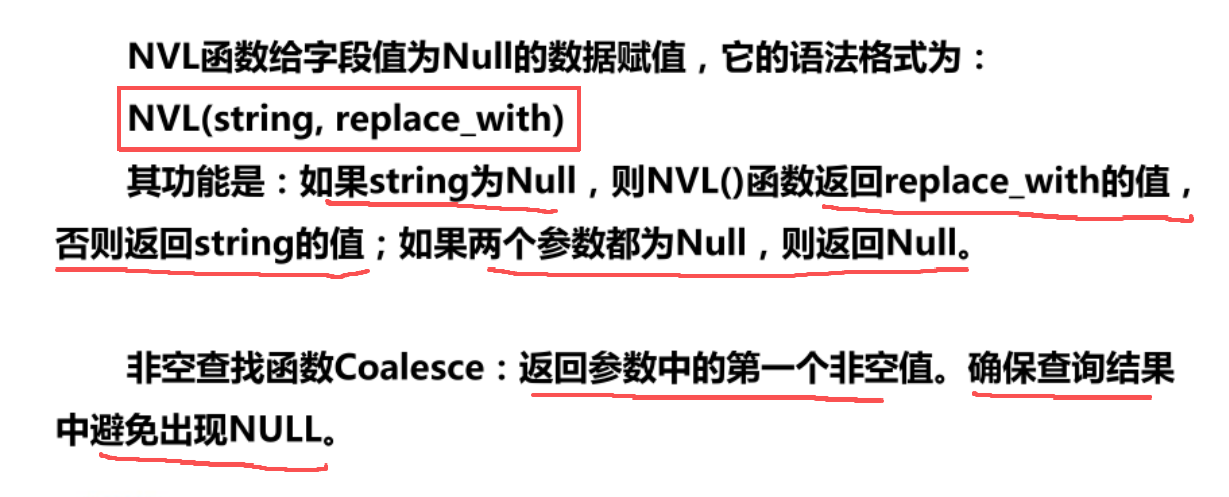
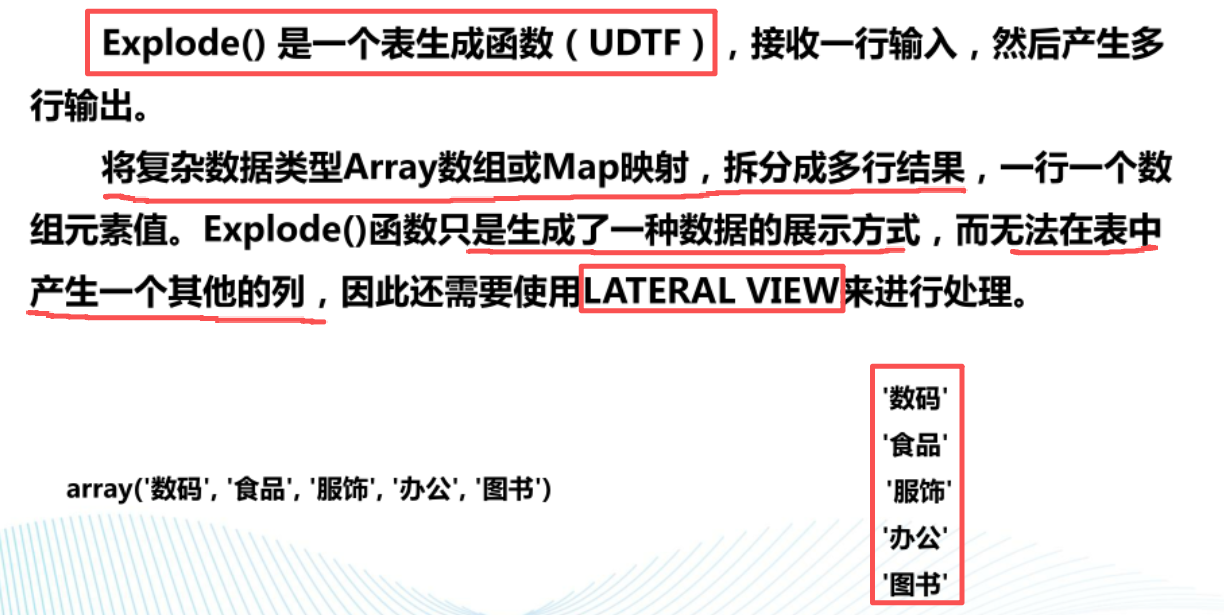
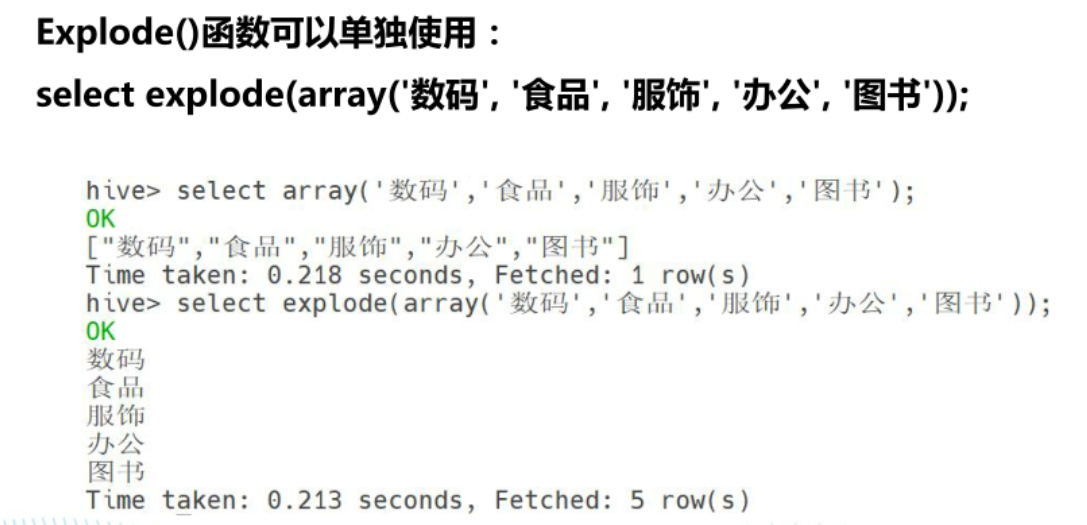
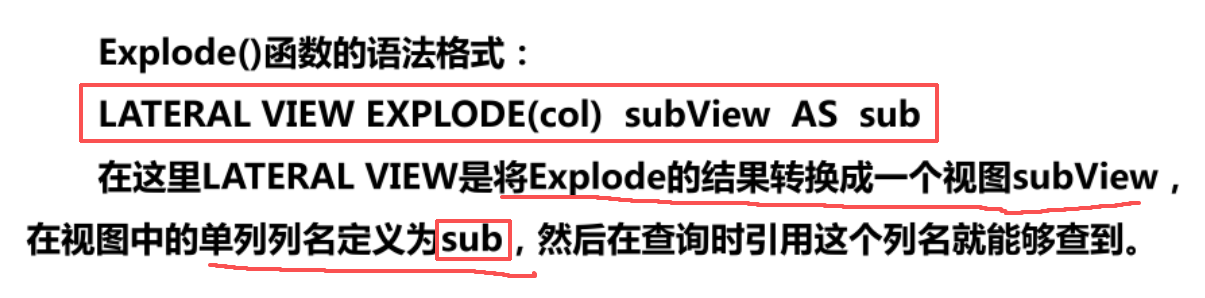
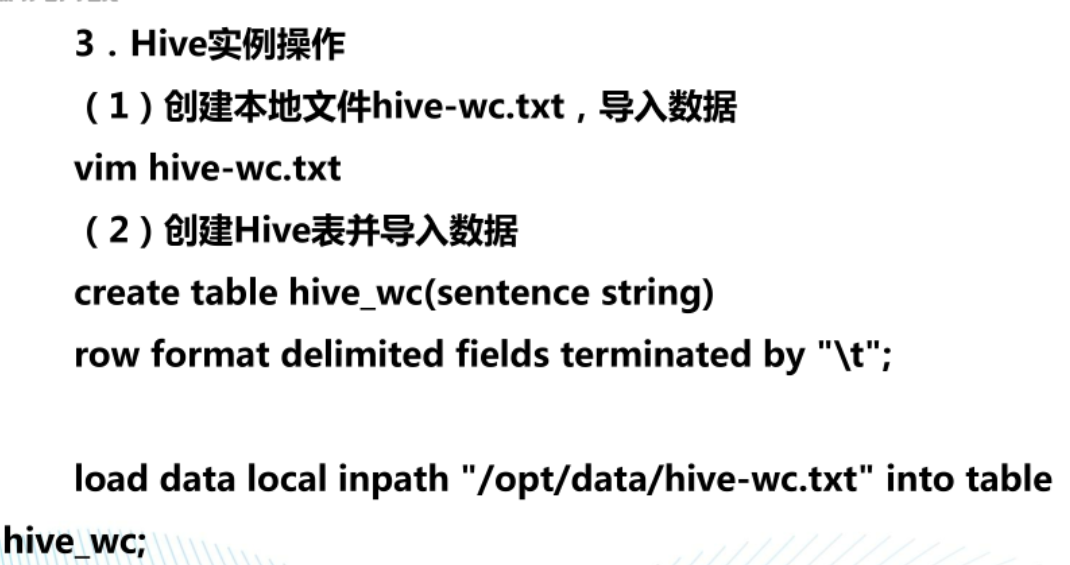
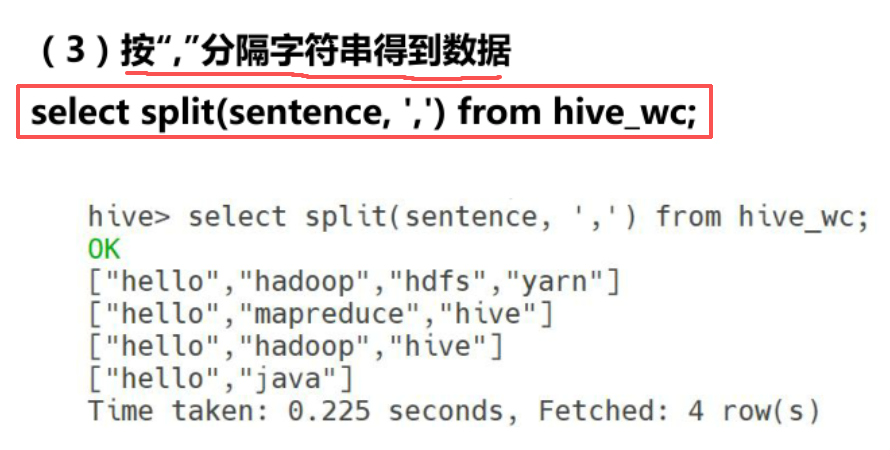
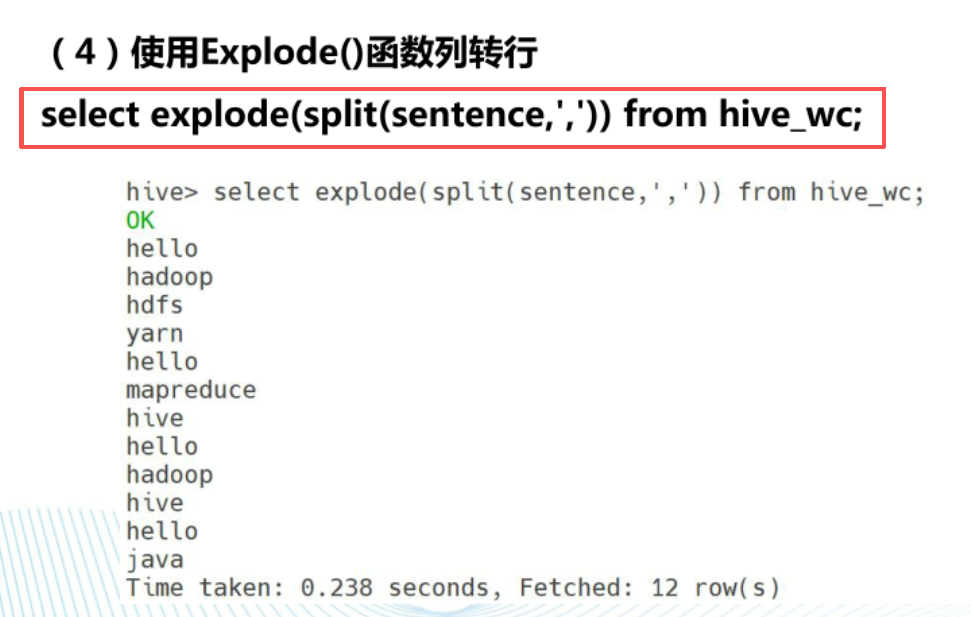
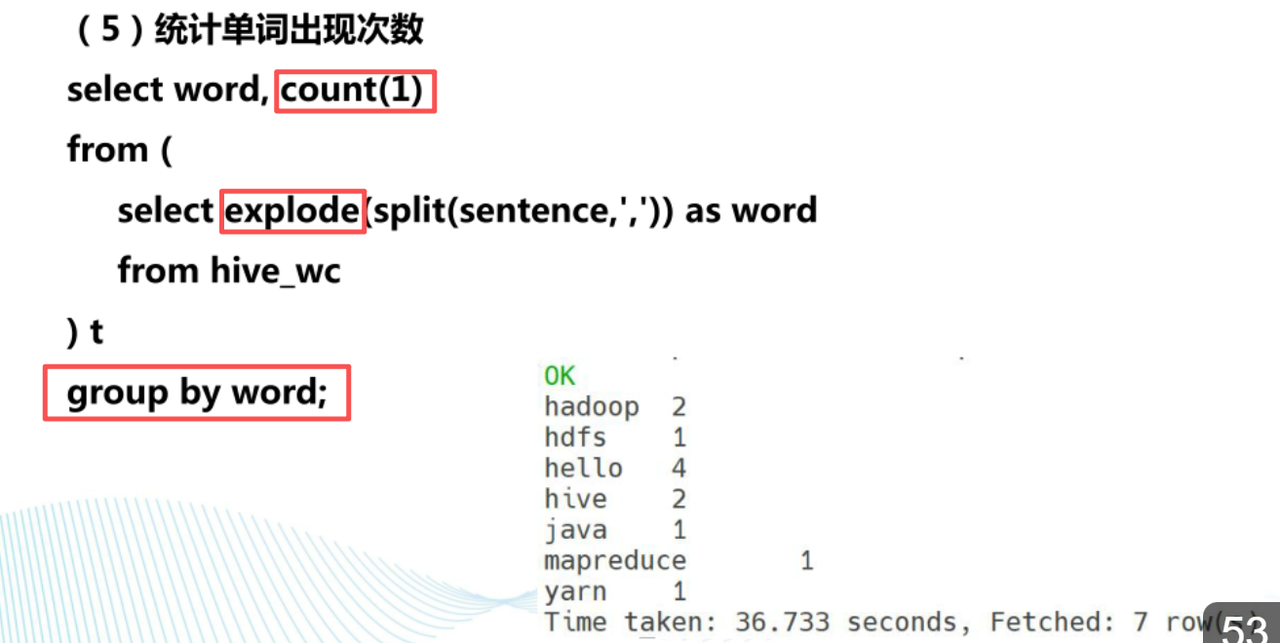
案例 列转行函数的应用
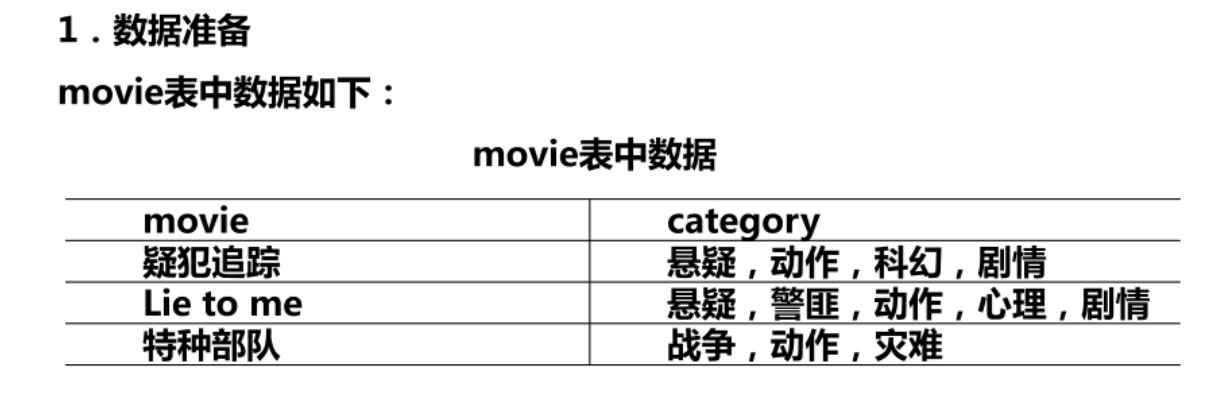
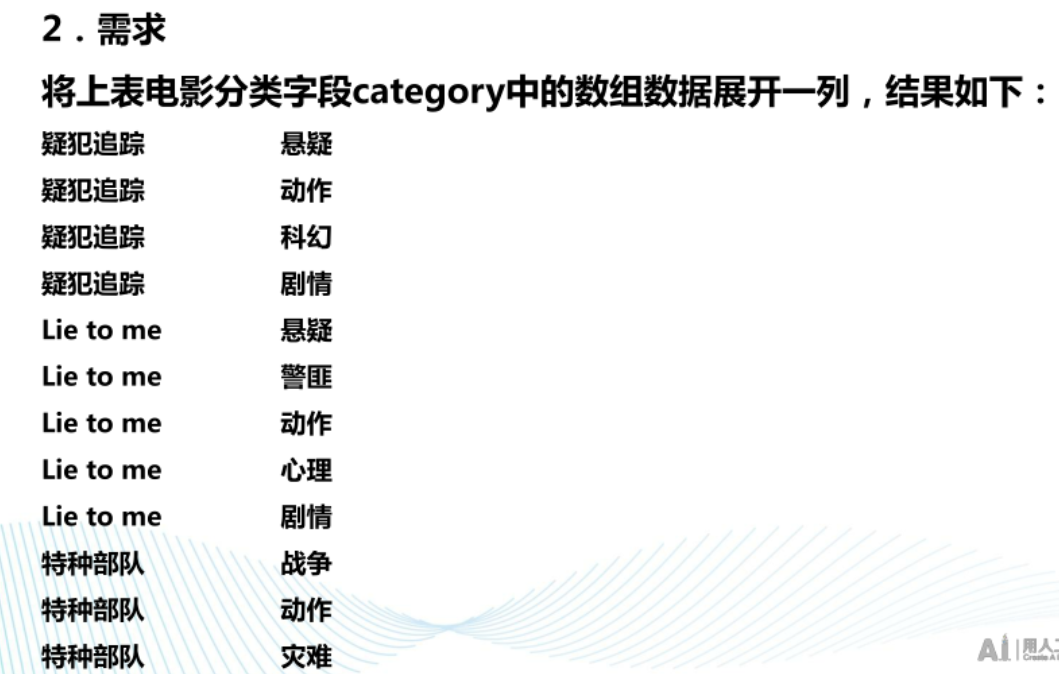
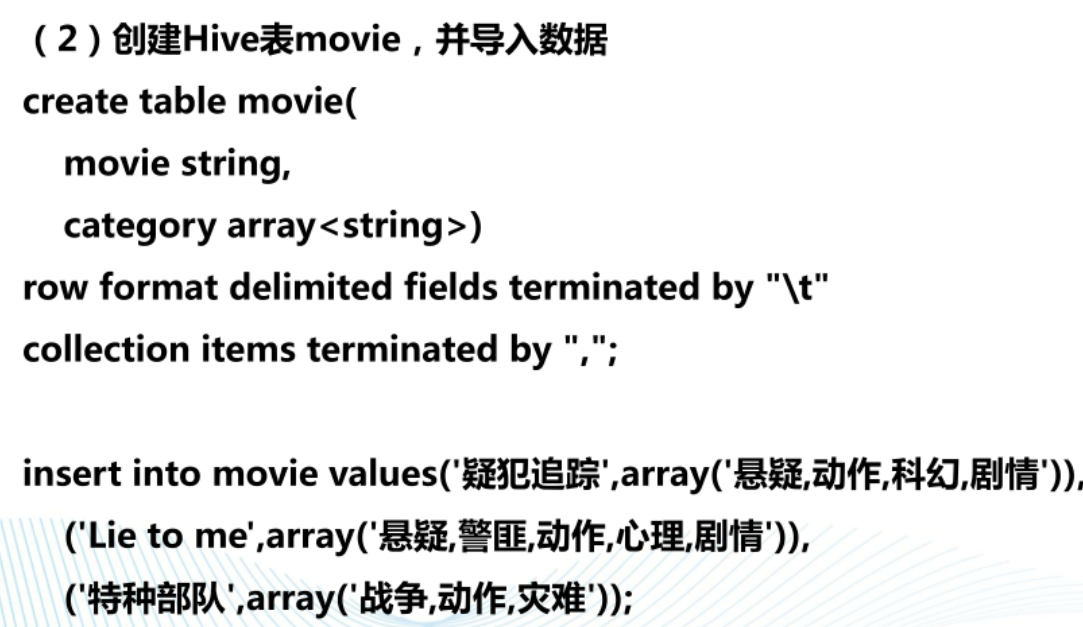
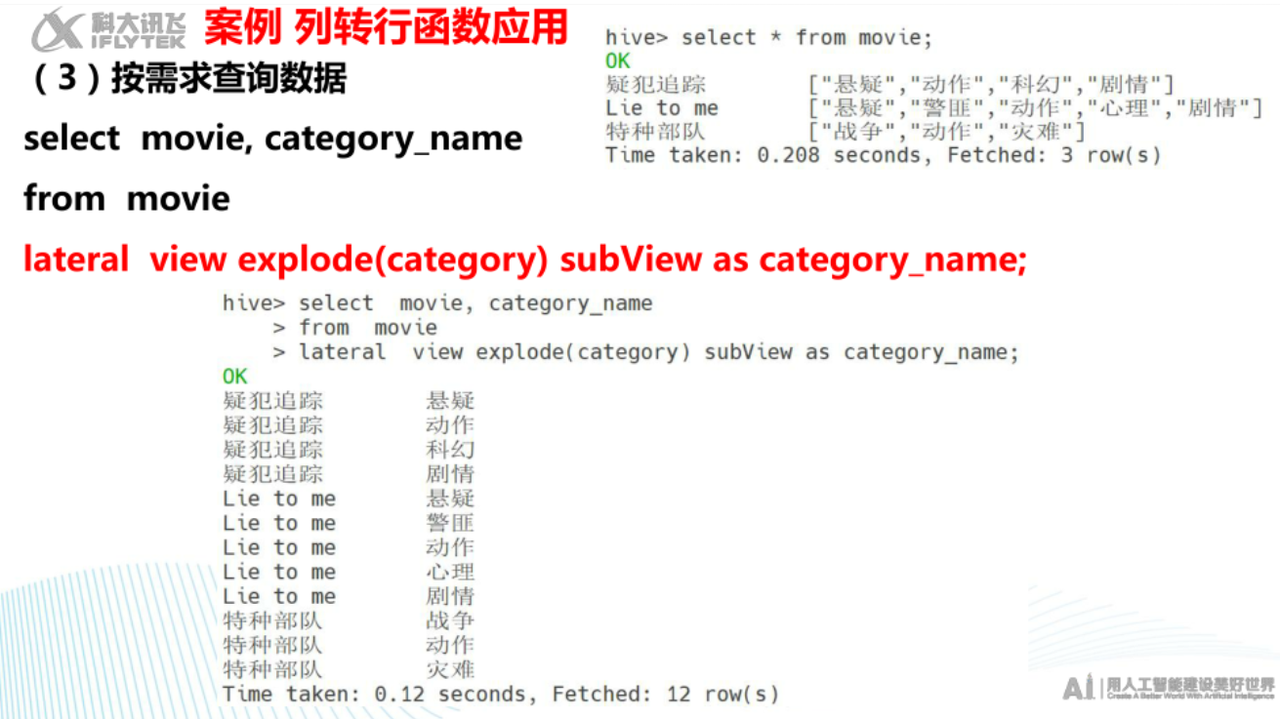
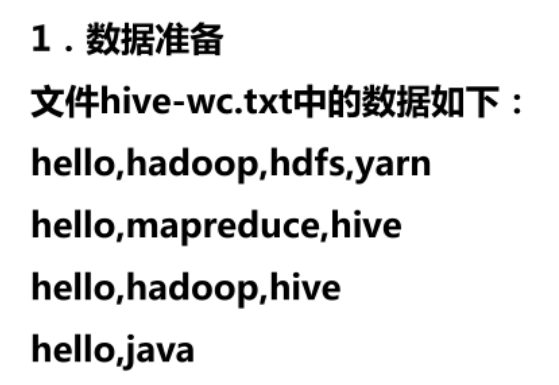
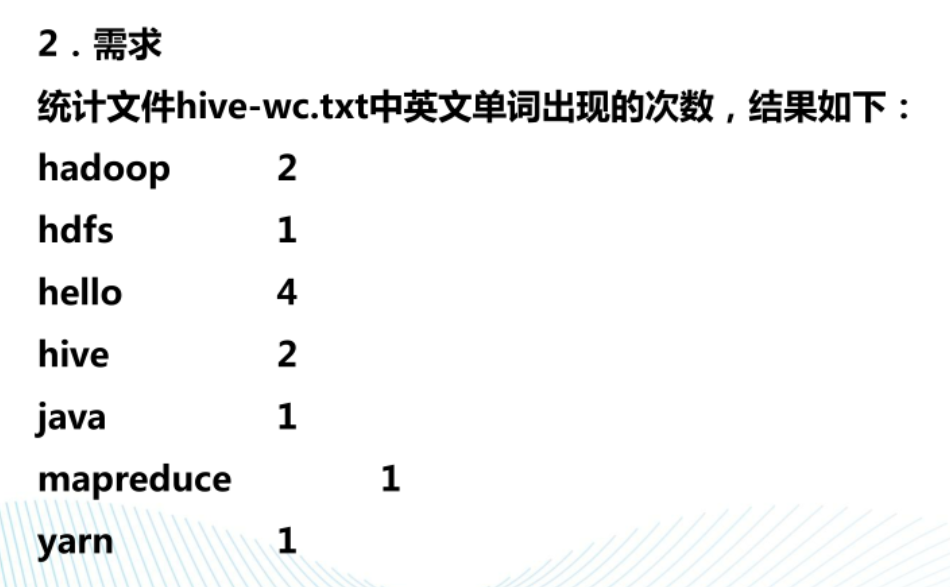
案例 列转行函数统计单词出现次数
自定义函数
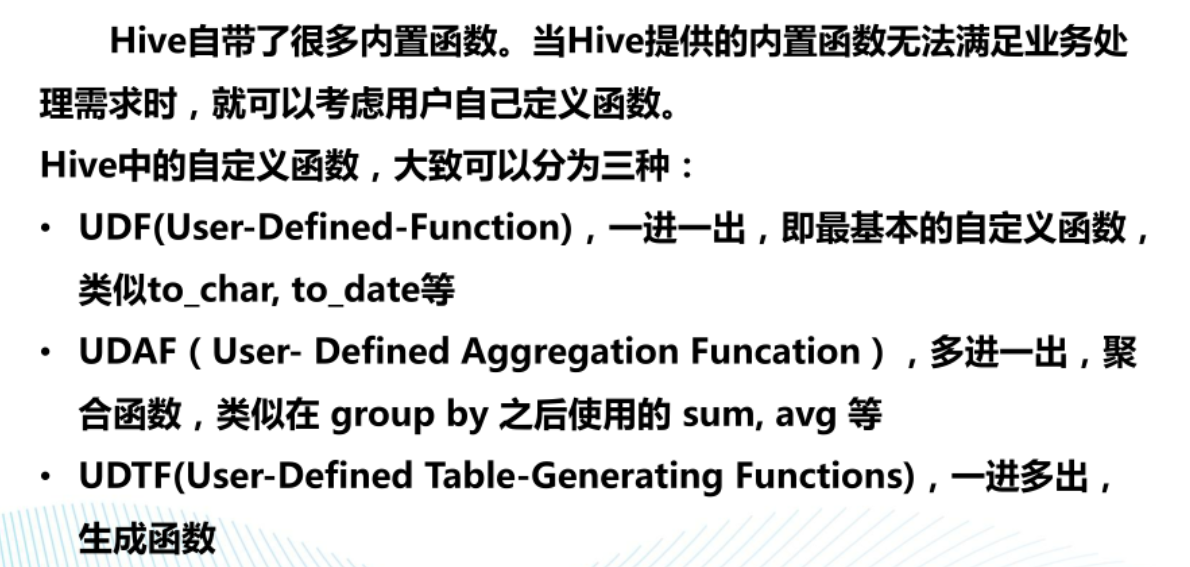
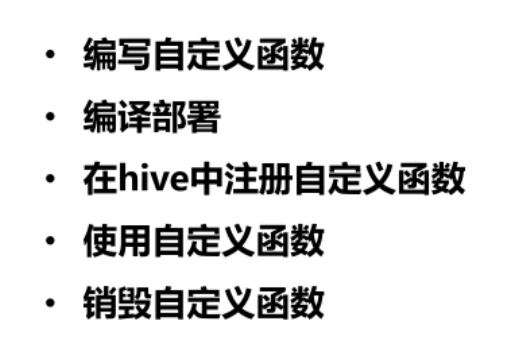
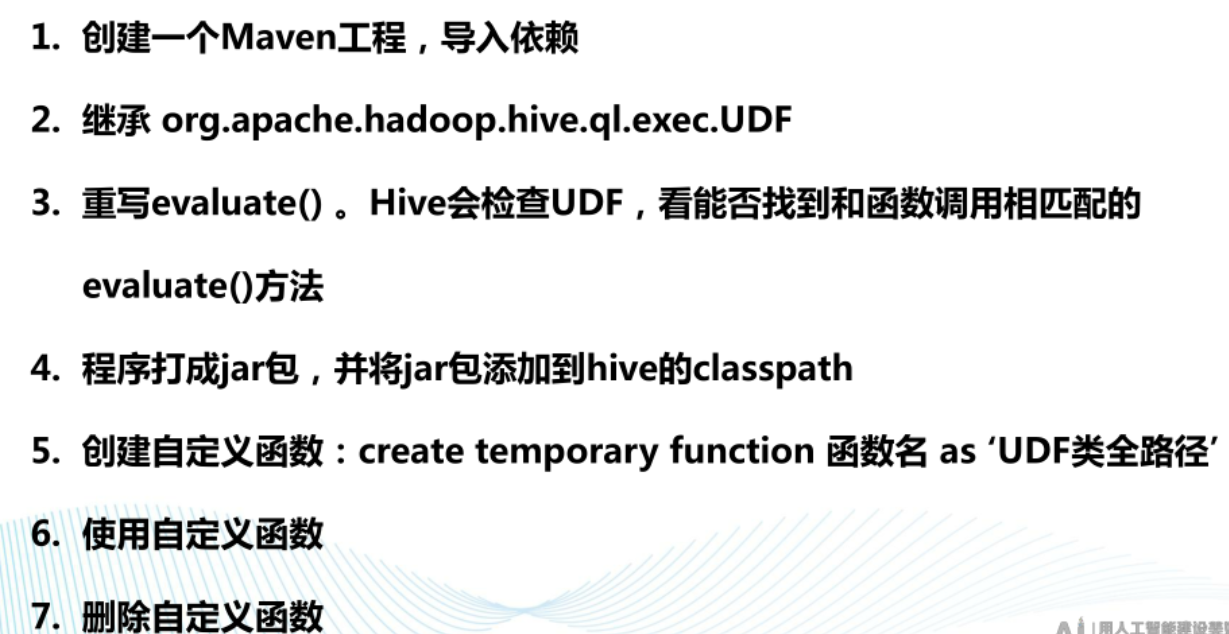
自定义函数创建步骤
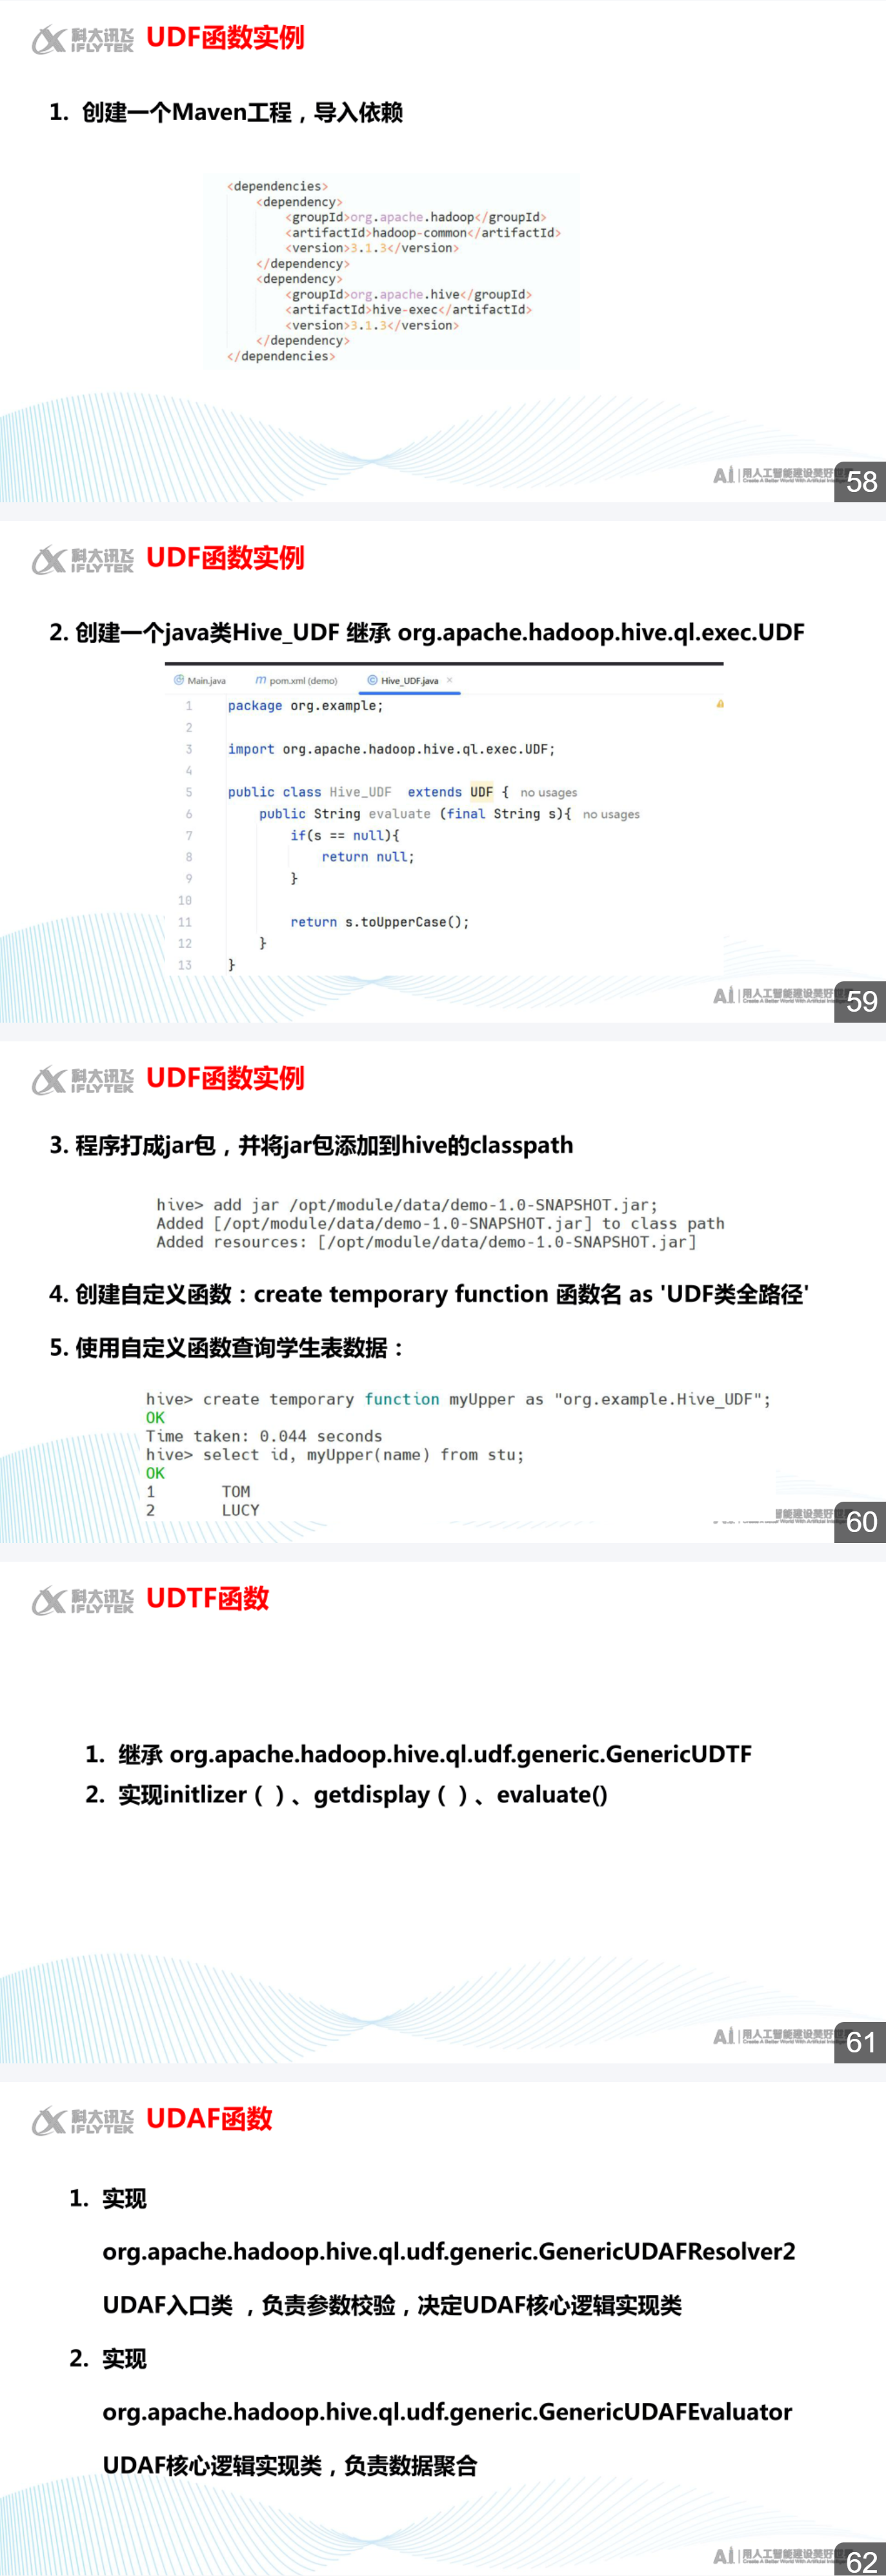
UDF函数
Hive 优化
为什么需要优化
低效的查询语句会造成任务耗时长、浪费集群资源等问题。例如,某任务涉及分区表,但未限制分区,导致任务启动了好几万个 Map,严重拖慢集群性能 。优化的目的在于提升执行效率,节省计算资源。
Hive 参数优化
Hive 参数优化是指在 Hive 配置文件中,对参数的属性值进行重新优化配置。
1. 本地模式 (Local Mode)
Hive 在 Hadoop 集群上查询时,默认是在多台服务器上分布式运行的。但是,当 Hive 查询的数据量比较小时,分布式方式涉及跨网络传输、多节点协调、资源调度分配等,消耗资源反而较大。此时可以通过本地模式在单台服务器上处理所有任务。
相关参数配置:
SQL
-- 1. 设置开启本地模式,默认是 false
set hive.exec.mode.local.auto=true;

-- 2. 设置本地模式的最大输入数据量,默认是 128MB。当输入数据量小于这个值时,采用本地模式。
set hive.exec.mode.local.auto.inputbytes.max=134217728;

-- 3. 设置本地模式的最大输入文件个数,默认是 4 个。当输入文件小于这个值时,采用本地模式。
set hive.exec.mode.local.auto.input.files.max=10;
2. Fetch 抓取
Fetch 抓取是指在 Hive 中对某些情况的查询可以不执行 MapReduce 程序。例如 select * from emp,Hive 可以简单地读取表对应的存储文件并输出到控制台,效率更高。
相关参数配置 (hive.fetch.task.conversion):
-
none (关闭):所有查询都走 MapReduce。(不推荐)
-
minimal (最小化):只有
SELECT *、分区字段过滤等极少数情况不走 MapReduce。 -
more (最大化,推荐):这是最常用、性能最好的设置。对于
SELECT、FILTER、LIMIT等简单查询,都不会触发 MapReduce。
SQL
-- 推荐设置
set hive.fetch.task.conversion=more;
3. 并行执行
Hive 默认一次只执行一个阶段(Stage)。如果某个作业包含多个互不依赖的阶段,开启并行执行可以缩短整个作业的执行时间。
相关参数配置:
SQL
-- 1. 开启并行执行,默认为 false
set hive.exec.parallel=true;

-- 2. 同一个 HQL 允许的最大并行度,即同时最多可以执行多少个任务,默认为 8
set hive.exec.parallel.thread.number=16;
注意:资源充足时能让作业运行更快,如果资源不足,并行执行可能无法运行起来。
4. 严格模式 (Strict Mode)
严格模式可以防止用户执行那些可能意想不到的、消耗巨大的查询。
开启方式:
SQL
set hive.mapred.mode=strict;
开启后禁止的三种查询:
-
带有分区表的查询:除非 Where 语句中含有分区字段过滤条件,否则不允许执行(禁止扫描所有分区)。
-
带有 Order By 的查询:必须使用 Limit 语句。因为 Order By 会将结果分发到一个 Reduce 中处理,不加 Limit 会导致 Reduce 执行时间过长。
-
限制笛卡尔积的查询:进行表连接时,如果关联条件失效或未写关联条件,严格模式下不允许执行。
数据倾斜优化 (配置层面)
Hadoop 框架特性是“不怕数据大,就怕数据倾斜”。解决数据倾斜的根本在于如何将数据均匀分配到各个 Reduce 中。
1. 合理设置 Map 个数
-
问题:如果任务有很多小文件(远小于 128MB),每个小文件启动一个 Map,会导致资源浪费。
-
解决方法(合并小文件):
SQL-- 启动对小文件进行合并的功能 set hive.input.format=org.apache.hadoop.hive.ql.io.CombineHiveFormat; -
问题:如果输入文件很大且逻辑复杂,Map 执行慢。
-
解决方法(增加 Map):调整最大切片大小
SQLmaxSize低于blockSize,即可增加 Map 个数。set mapreduce.input.fileinputformat.split.maxsize=...;
2. 合理设置 Reduce 个数
Reduce 的个数极大影响任务执行效率。
手动设置方法:
SQL
-- 方法 1:设置每个 Reduce 处理的数据量,默认为 256MB(Hive 基于此自动计算)
set hive.exec.reducer.bytes.per.reducer=256000000;

-- 方法 2:直接设置 Reduce 个数
set mapreduce.job.reduces=10;

-- 每个任务最大的 Reduce 个数,默认为 1009
set hive.exec.reducers.max=1009;
注意:Reduce 个数并非越多越好,过多的启动初始化会消耗大量时间。
四、 HQL 语句优化
1. 行/列过滤优化
-
列过滤:只读取查询中需要的列,尽量避免
SELECT *。 -
行过滤:
-
查询分区表时,在
WHERE子句中限制分区范围。 - 使用外关联时,如果副表的过滤条件写在
WHERE后面,会导致先全表关联再过滤;应尽量写在ON子句或子查询中。
-
2. Count 优化
在数据量大的情况下,count(distinct) 会用一个 Reduce 任务完成,容易导致处理瓶颈。
-
优化方案:先进行 Group By 子查询,再进行 Count 计算。
-
原句:
select count(distinct id) from table; - 优化:
select count(id) from (select id from table group by id) t;优点是利用了多个 Reduce 进行 Group By 去重。
-
3. Shuffle 过程优化 (压缩)
开启 Map 输出阶段的压缩,可以减少 Shuffle 过程中的网络传输量。
SQL
-- 开启中间结果压缩
set mapred.compress.map.output=true;
-- 设置中间结果压缩算法(如 LZO)
set mapred.compress.output.compression.codec=com.hadoop.compression.lzo.LzoCodec;
4. Group By 优化 (解决数据倾斜)
默认情况下,Map 阶段同一个 Key 分发给一个 Reduce,容易导致倾斜。
方法一:开启 Map 端聚合
SQL
-- 开启 Map 端聚合,减少 Shuffle 数据量
set hive.map.aggr=true;
方法二:负载均衡
SQL
-- 开启负载均衡
set hive.groupby.skewindata=true;
原理:生成的查询包含两个 MapReduce 作业。
-
第一个作业:Map 的输出结果随机分发到 Reduce 中,进行部分聚合。
- 第二个作业:拿前面聚合过的数据,按 Group By 字段分发,计算最终结果。
5. Join 优化
A. MapJoin (大表 Join 小表) 将小表全量加载到内存,在 Map 阶段直接与大表数据关联,无需 Reduce 阶段,避免了 Shuffle。
SQL
-- 自动识别小表并触发 Map Join(默认开启)
set hive.auto.convert.join=true;
-- 小表阈值(默认 25MB,部分版本不同)
set hive.auto.convert.join.noconditionaltask.size=10485760;
B. Bucket Map Join (大表 Join 大表) 如果两张表都很大,且无法通过 MapJoin 优化,可以使用分桶 Join。
-
条件:两张表必须是分桶表,且桶数成倍数关系;Join 字段必须是分桶字段。
SQL
set hive.optimize.bucketmapjoin=true;
C. Skew Join (倾斜 Join) 专门用于解决 Join 过程中个别 Key 数据倾斜的问题。
SQL
-- 开启 Skew Join 优化
set hive.optimize.skewjoin=true;
-- 定义“倾斜 Key”的阈值(默认 100000 行)
set hive.skewjoin.key=100000;
6. 重写业务逻辑解决倾斜
场景:日志表中存在大量未注册用户(如 user_id = 0 或 NULL),与用户表关联时,这些特定值会导致数据倾斜。
优化方案:
-
方案 1:过滤掉不需要的 Key(如 NULL)。
-
方案 2:给空值 Key 赋一个随机值,使其均匀分散到不同的 Reduce 中(前提是这些空值不影响最终结果或不需要关联)。
SQLselect * from log a left join user b on case when a.user_id is null then concat('hive', rand()) else a.user_id end = b.user_id;
五、 执行计划 (Explain)
使用 Explain 命令可以查看 HQL 的执行计划,帮助分析抽象语法树、依赖关系以及 MapReduce 阶段,从而优化业务逻辑。
基本语法:
SQL
EXPLAIN [EXTENDED] select ...;更多推荐


 20
 0
- 0


 已为社区贡献3条内容

所有评论(0)