
用AI给古诗词“贴标签”:本地小模型与大模型API实战对比
一、前言
前段时间,有位网友开发了一个中国古代诗词网站,界面古风大气,设计得十分精美。他在群里提出了一个问题:该如何给这些古诗词做标签分类?比如按风格划分边塞诗、田园诗、豪放诗、婉约诗;按主题区分写景、写人、写物、叙事、抒情、怀古等。当时我比较忙碌,便随手推荐了huggingface.co网站,让他找找合适的分类模型试试。后来他反馈说自己已经实现了功能,效果还不错。
这个看似简单的分类问题,其实藏着不少趣味。我也萌生了动手实践的想法,今天正好有空,就来实操一番!
这类文本分类问题,用AI模型处理起来并不复杂,主要有两种方案:
本地部署小型模型进行诗词分类,优点是完全免费,缺点是分类效果可能稍逊一筹;
调用主流大模型的API接口分类,优点是效果更优,缺点是会产生一定的调用成本。
我打算把两种方案都测试一遍,看看实际效果差异。
二、本地小模型分类实战
2.1 数据准备
首先得准备诗词数据,GitHub上有很多开源的古诗词仓库,这次我选择了:https://github.com/Werneror/Poetry
这个仓库的格式特别简洁,是CSV文件,只包含题目、朝代、作者和内容,数据干净规整,非常适合用来做分类实验。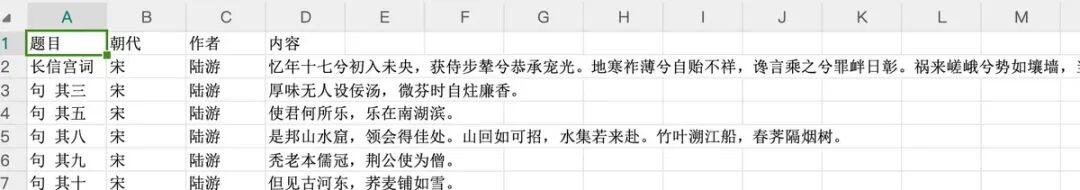
2.2 Ollama环境与模型准备
我之前已经在电脑上安装过Ollama了,这里就不再赘述安装步骤。
Ollama是一款专为大语言模型本地运行设计的开源工具,由Ollama Inc.开发,核心目标是让开发者和普通用户无需复杂配置,就能在个人电脑、服务器甚至边缘设备上快速部署、运行和管理各类大模型(如Llama 3、Qwen、Phi、Gemma等)。它简化了大模型部署的技术门槛,被誉为“大模型领域的Docker”。
这次我选用阿里的通义千问qwen2.5:1.5b模型,选它的原因是体积小、轻量化,而且中文处理能力口碑不错。下载和运行都只需一行命令:
# 下载模型
ollama pull qwen2.5:1.5b
# 运行模型
ollama run qwen2.5:1.5b
下载截图: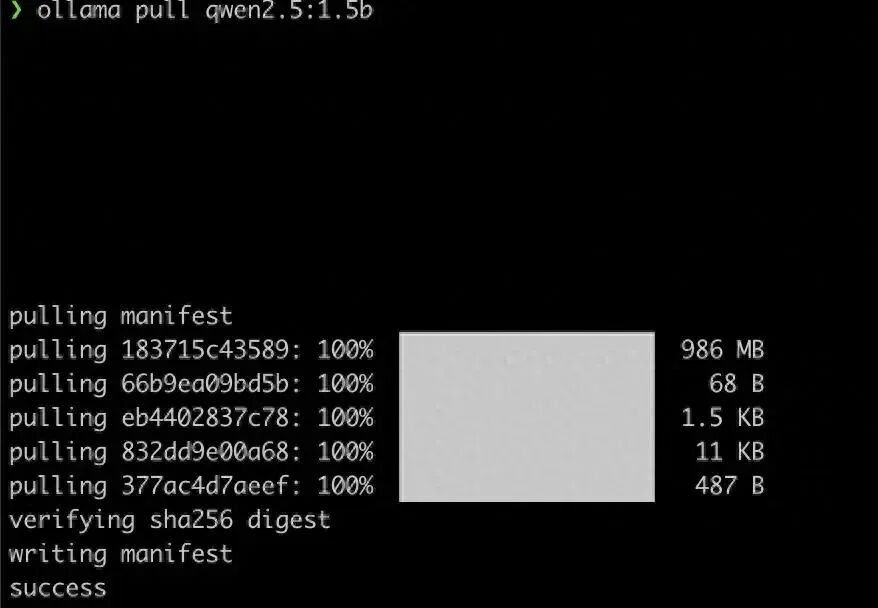
先手动测试下分类效果: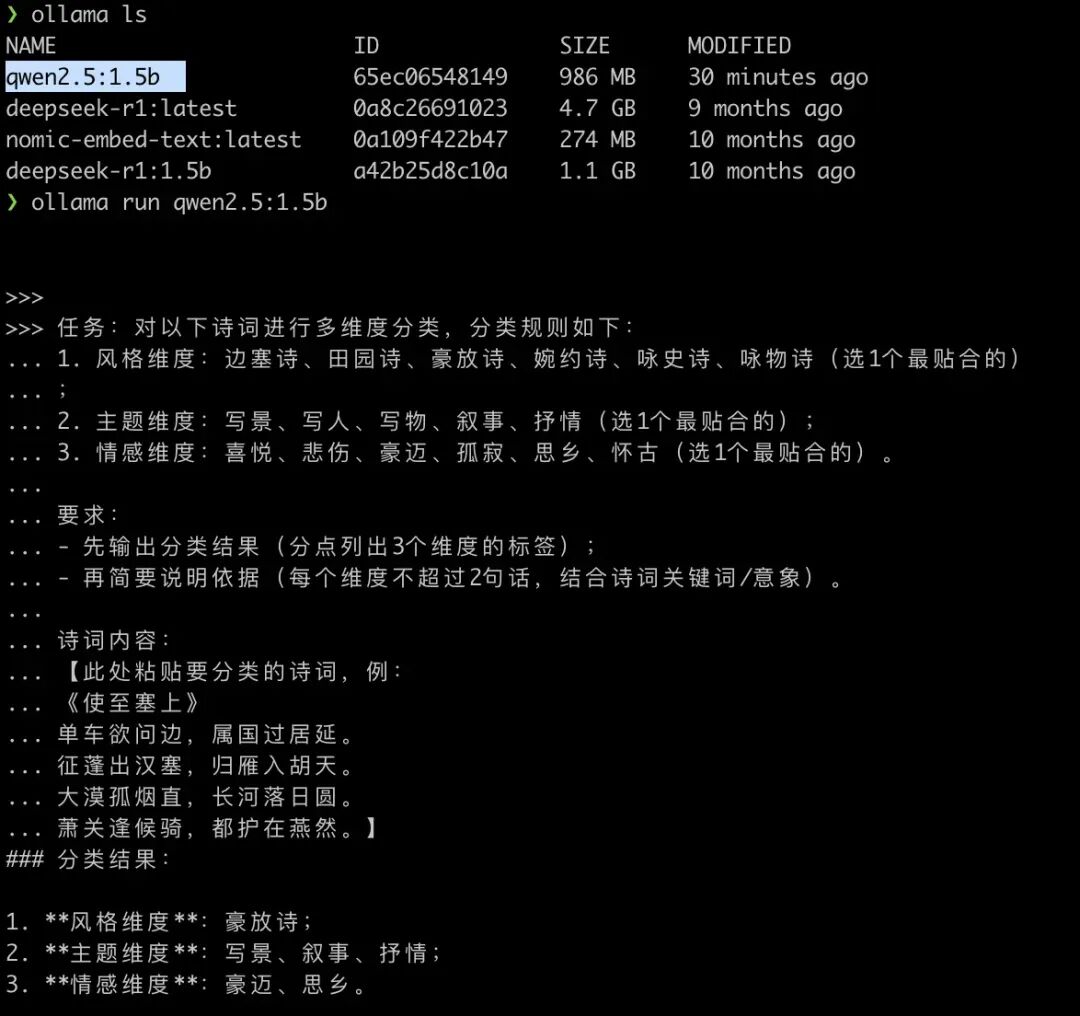
从测试结果来看,分类还算准确,但这种Chat交互方式显然不适合批量处理大量诗词,必须通过API接口来实现自动化分类。
2.3 编程实现批量分类
Ollama提供了RESTful API接口,调用起来很方便,先做个简单的curl测试:
curl http://localhost:11434/api/generate \
  -X POST \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen2.5:1.5b",
    "prompt": "请对以下诗词进行分类,输出风格(边塞诗/田园诗/豪放诗/婉约诗)、主题(写景/抒情/叙事)、情感(豪迈/恬淡/悲伤),用JSON格式返回:\n诗词标题:使至塞上\n诗词内容:单车欲问边,属国过居延。征蓬出汉塞,归雁入胡天。大漠孤烟直,长河落日圆。萧关逢候骑,都护在燕然。",
    "stream": false,
    "temperature": 0.1,
    "format": "json"
  }'
测试结果如下: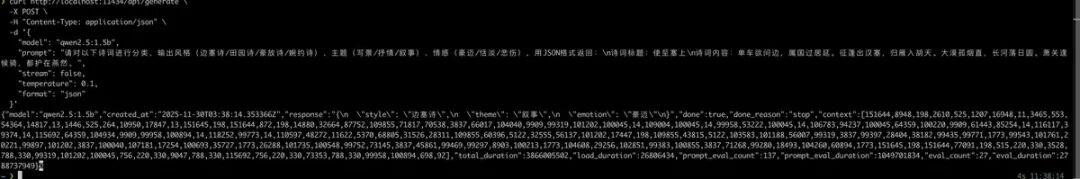
返回结果里的context是上下文对应的token id列表,用来维持会话连贯性,这里暂时用不上。
curl测试没问题后,就可以写代码实现批量处理了。整体思路是:用Python读取CSV里的诗词数据,调用本地模型接口获取分类标签,将结果与原诗词数据关联后,写入新的CSV文件。
代码如下:
import requests
import pandas as pd
import json
from tqdm import tqdm  # 进度条库(可选,需安装:pip install tqdm)

# -------------------------- 配置项 --------------------------
OLLAMA_API_URL = "http://localhost:11434/api/generate"  # Ollama本地接口
MODEL_NAME = "qwen2:1.5b"  # 小尺寸模型(如1.5B/7B,优先选中文优化版)
INPUT_CSV = "poetry_raw.csv"  # 原始诗词CSV路径
OUTPUT_CSV = "poetry_classified.csv"  # 分类结果保存路径

# 分类指令模板(明确标签要求,提升准确性)
CLASSIFY_PROMPT_TEMPLATE = """
请严格按照以下规则对诗词分类,仅返回JSON格式结果(无多余文字):
分类维度及可选标签:
1. 风格:边塞诗/田园诗/豪放诗/婉约诗/咏史诗/咏物诗/山水诗/羁旅诗/咏怀诗
2. 主题:写景/写人/写物/叙事/抒情/怀古/思乡/送别/咏怀
3. 情感:喜悦/悲伤/豪迈/孤寂/愤懑/恬淡/惆怅/闲适/旷达

诗词信息:
标题:{title}
内容:{content}

输出格式:{{"风格":"标签","主题":"标签","情感":"标签"}}
"""

# -------------------------- 核心函数 --------------------------
def classify_poetry(title, content):
    """调用本地小模型对单首诗词分类"""
    # 填充模板生成prompt
    prompt = CLASSIFY_PROMPT_TEMPLATE.format(title=title, content=content)

    try:
        # 调用Ollama API
        response = requests.post(
            OLLAMA_API_URL,
            headers={"Content-Type": "application/json"},
            json={
                "model": MODEL_NAME,
                "prompt": prompt,
                "stream": False,  # 非流式输出
                "temperature": 0.1,  # 低随机性保证分类稳定
                "max_tokens": 100  # 限制返回长度,避免冗余
            },
            timeout=30  # 超时时间
        )

        # 解析响应
        if response.status_code == 200:
            result = json.loads(response.text)
            # 提取模型返回的分类结果(处理可能的格式问题)
            try:
                classify_result = json.loads(result["response"].strip())
                return classify_result
            except json.JSONDecodeError:
                return {"风格": "未知", "主题": "未知", "情感": "未知"}
        else:
            return {"风格": "接口错误", "主题": "接口错误", "情感": "接口错误"}

    except Exception as e:
        print(f"\n分类失败(标题:{title}):{str(e)}")
        return {"风格": "分类失败", "主题": "分类失败", "情感": "分类失败"}

def process_poetry_classification():
    """主流程:读取CSV→批量分类→保存结果"""
    # 1. 读取原始CSV
    try:
        df = pd.read_csv(INPUT_CSV, encoding="utf-8-sig")
        print(f"成功读取CSV,共{len(df)}条诗词数据")
    except FileNotFoundError:
        print(f"错误:未找到文件{INPUT_CSV}")
        return
    except Exception as e:
        print(f"读取CSV失败:{str(e)}")
        return

    # 检查必要字段
    required_fields = ["题目", "内容"]
    if not all(field in df.columns for field in required_fields):
        print(f"错误:CSV需包含字段:{required_fields}")
        return

    # 2. 批量分类(添加进度条)
    classify_results = []
    for _, row in tqdm(df.iterrows(), total=len(df), desc="诗词分类中"):
        title = row["题目"] if pd.notna(row["题目"]) else "无题"
        content = row["内容"] if pd.notna(row["内容"]) else ""

        # 调用分类函数
        result = classify_poetry(title, content)
        classify_results.append(result)

    # 3. 将分类结果合并到原数据
    result_df = pd.DataFrame(classify_results)
    df = pd.concat([df, result_df], axis=1)

    # 4. 保存最终结果
    try:
        df.to_csv(OUTPUT_CSV, index=False, encoding="utf-8-sig")
        print(f"\n分类完成!结果已保存至:{OUTPUT_CSV}")
    except Exception as e:
        print(f"保存CSV失败:{str(e)}")

# -------------------------- 执行入口 --------------------------
if __name__ == "__main__":
    # 前置检查:确认Ollama服务和模型存在
    try:
        # 检查服务连通性
        ping_response = requests.get("http://localhost:11434/api/tags", timeout=5)
        if ping_response.status_code != 200:
            raise ConnectionError("Ollama服务未启动,请先执行:ollama serve")

        # 检查模型是否存在
        models = [m["name"] for m in ping_response.json()["models"]]
        if MODEL_NAME not in models:
            print(f"模型{MODEL_NAME}不存在,正在自动拉取...")
            pull_response = requests.post(
                "http://localhost:11434/api/pull",
                json={"name": MODEL_NAME},
                headers={"Content-Type": "application/json"},
                timeout=300  # 拉取模型超时设为5分钟
            )
            if pull_response.status_code != 200:
                raise Exception(f"模型拉取失败:{pull_response.text}")
    except Exception as e:
        print(f"前置检查失败:{str(e)}")
        exit(1)

    # 执行分类流程
    process_poetry_classification()
运行速度大概是每首诗词2-3秒,整体不算快但胜在免费。
最终生成的CSV文件里,大部分诗词都成功分类,少数未能识别的也标注了“未知”。不得不感慨AI的便捷——如果换成传统机器学习方法,光是标注数据、训练模型就得耗费大量时间。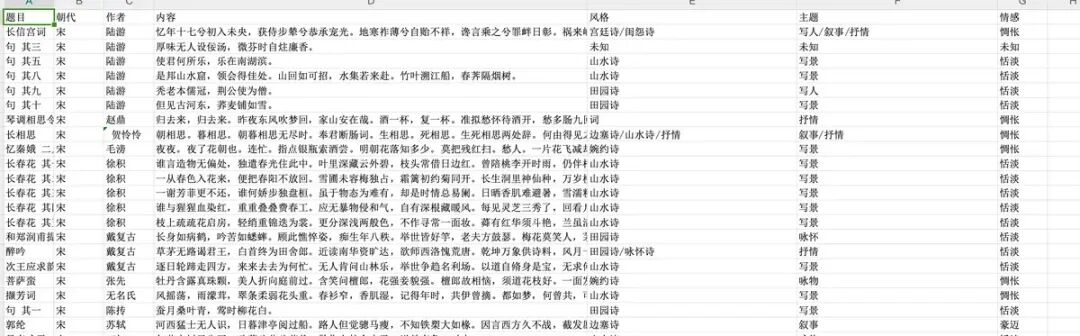
三、DeepSeek API分类测试
接下来试试调用DeepSeek的API来分类,只需修改部分代码即可:
import requests
import pandas as pd
import json
from tqdm import tqdm  # 进度条库(需安装:pip install tqdm)

# -------------------------- 配置项 --------------------------
DEEPSEEK_API_KEY = "你的key"  # 替换为你的DeepSeek API密钥
DEEPSEEK_API_URL = "https://api.deepseek.com/v1/chat/completions"  # DeepSeek API地址
MODEL_NAME = "deepseek-chat"  # DeepSeek模型名称(可选:deepseek-chat/deepseek-coder)
INPUT_CSV = "song1.csv"  # 原始诗词CSV路径
OUTPUT_CSV = "poetry_classified_deepseek.csv"  # 分类结果保存路径

# 分类指令模板(明确标签要求,提升准确性)
CLASSIFY_PROMPT_TEMPLATE = """
请严格按照以下规则对诗词分类,仅返回JSON格式结果(无多余文字):
分类维度及可选标签:
1. 风格:边塞诗/田园诗/豪放诗/婉约诗/咏史诗/咏物诗/山水诗/羁旅诗/咏怀诗
2. 主题:写景/写人/写物/叙事/抒情/怀古/思乡/送别/咏怀
3. 情感:喜悦/悲伤/豪迈/孤寂/愤懑/恬淡/惆怅/闲适/旷达

诗词信息:
标题:{title}
内容:{content}

输出格式示例:{{"风格":"边塞诗","主题":"写景","情感":"豪迈"}}
"""

# -------------------------- 核心函数 --------------------------
def classify_poetry_deepseek(title, content):
    """调用DeepSeek API对单首诗词分类"""
    # 填充模板生成prompt
    prompt = CLASSIFY_PROMPT_TEMPLATE.format(title=title, content=content)

    # 构造DeepSeek API请求体
    messages = [
        {"role": "user", "content": prompt}
    ]

    try:
        response = requests.post(
            DEEPSEEK_API_URL,
            headers={
                "Content-Type": "application/json",
                "Authorization": f"Bearer {DEEPSEEK_API_KEY}"
            },
            json={
                "model": MODEL_NAME,
                "messages": messages,
                "temperature": 0.1,  # 低随机性保证分类稳定
                "max_tokens": 100,  # 限制返回长度
                "stream": False
            },
            timeout=30  # 超时时间
        )

        # 解析响应
        if response.status_code == 200:
            result = response.json()
            classify_text = result["choices"][0]["message"]["content"].strip()
            # 提取JSON结果
            try:
                classify_result = json.loads(classify_text)
                return classify_result
            except json.JSONDecodeError:
                return {"风格": "解析失败", "主题": "解析失败", "情感": "解析失败"}
        else:
            return {"风格": f"API错误({response.status_code})", "主题": "", "情感": ""}

    except Exception as e:
        print(f"\n分类失败(标题:{title}):{str(e)}")
        return {"风格": "分类失败", "主题": "分类失败", "情感": "分类失败"}

def process_poetry_classification():
    """主流程:读取CSV→批量分类→保存结果"""
    # 1. 读取原始CSV
    try:
        df = pd.read_csv(INPUT_CSV, encoding="utf-8-sig")
        print(f"成功读取CSV,共{len(df)}条诗词数据")
    except FileNotFoundError:
        print(f"错误:未找到文件{INPUT_CSV}")
        return
    except Exception as e:
        print(f"读取CSV失败:{str(e)}")
        return

    # 检查必要字段
    required_fields = ["题目", "内容"]
    if not all(field in df.columns for field in required_fields):
        print(f"错误:CSV需包含字段:{required_fields}")
        return

    # 2. 批量分类(添加进度条)
    classify_results = []
    for _, row in tqdm(df.iterrows(), total=len(df), desc="诗词分类中"):
        title = row["题目"] if pd.notna(row["题目"]) else "无题"
        content = row["内容"] if pd.notna(row["内容"]) else ""

        # 调用DeepSeek分类函数
        result = classify_poetry_deepseek(title, content)
        classify_results.append(result)

    # 3. 将分类结果合并到原数据
    result_df = pd.DataFrame(classify_results)
    df = pd.concat([df, result_df], axis=1)

    # 4. 保存最终结果
    try:
        df.to_csv(OUTPUT_CSV, index=False, encoding="utf-8-sig")
        print(f"\n分类完成!结果已保存至:{OUTPUT_CSV}")
    except Exception as e:
        print(f"保存CSV失败:{str(e)}")

# -------------------------- 执行入口 --------------------------
if __name__ == "__main__":
    # 前置检查:确认API密钥已配置
    if DEEPSEEK_API_KEY == "your_deepseek_api_key":
        print("错误:请先替换为你的DeepSeek API密钥(从DeepSeek控制台获取)")
        exit(1)

    # 执行分类流程
    process_poetry_classification()
运行代码:
python3 ./deepseek-fenlei.py经过5分钟左右的运行,分类任务顺利完成:
对比两种方案的结果,DeepSeek的分类准确性整体更优,但本地小模型也有亮点——比如第8行内容,小模型能准确识别出是“词”而非“诗”,DeepSeek则误判为诗。另外,DeepSeek按token计费虽成本不高,但架不住本地模型胜在完全免费、数据隐私可控啊。
四、总结与延伸
这次实践让我真切感受到AI技术的落地便捷性:无需深厚的机器学习功底,只需简单调用模型接口,就能快速解决实际问题。对于诗词分类这类需求,本地小模型适合小规模、低成本的场景,而大模型API则更适合追求高精度、高效率的批量处理。
其实这个思路还能延伸到更多领域:比如给古籍做标签、给现代文本做情感分析、甚至给商品评论做分类。AI工具的普及,让技术落地的门槛越来越低,普通人也能借助这些工具解决工作生活中的实际问题。
如果你也有类似的文本处理需求,不妨试试这两种方案——或许会发现,很多看似复杂的任务,用AI来解决其实很简单。
如果大家喜欢,请大家给我多多点赞,谢谢各位大人!
更多推荐



 8
 0
- 0


 已为社区贡献8条内容

所有评论(0)