
第一部分-机器学习基础-1.2机器学习
一、机器学习的核心定义
-
本质:从有限的观测数据中学习一般性规律,并利用这些规律对未知数据进行预测。
-
定位:是人工智能的一个重要分支,并已成为推动AI发展的关键动力。
二、传统机器学习与“浅层学习”
-
核心任务:关注如何学习一个预测模型。
-
关键前提:需要先将数据表示为特征。特征是人工定义或转换的数据属性,可以是数值、符号等形式。
-
“浅层学习”的特点:
-
模型本身不涉及自动的特征学习。
-
特征的质量高度依赖于人工经验或各种特征转换方法。
-
三、处理多样化数据的挑战
-
现实中的数据(如图像、文本、声音)形式多样,其特征构造方式差异巨大。
-
示例:
-
图像:可以自然地表示为连续向量(如像素值)。
-
文本:由离散符号组成,其计算机编码本身无意义,因此找到合适的特征表示是一大挑战。
-
四、传统机器学习的基本流程
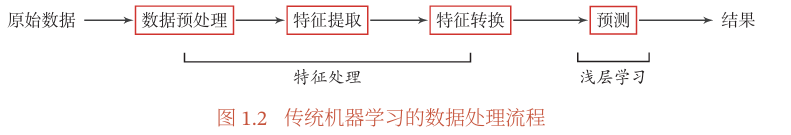
为了解决上述挑战,传统机器学习通常遵循一个多阶段的分离式流程:
-
数据预处理:
-
目的:数据清理与初步加工。
-
操作:处理缺失值、去除冗余、数值归一化等,构建干净的数据集。
-
-
特征提取:
-
目的:从原始数据中人工提炼出对任务有用的高质量特征。
-
示例:图像分类中提取边缘、SIFT特征;文本分类中去除停用词。
-
-
特征转换:
-
目的:对提取的特征进行进一步优化加工。
-
主要方式:降维(如PCA、LDA,旨在减少噪声和冗余)或升维。
-
降维途径:特征抽取(构造新特征)与特征选择(筛选原有特征)。
-
-
预测(模型学习):
-
目的:学习预测函数,这是传统机器学习理论关注的核心。
-
实际情况:不同预测模型的性能往往接近,而前三步的特征处理对最终准确性起决定性作用。
-
五、核心结论:特征工程是关键
-
由于特征处理需要大量人工干预和领域经验,且对结果影响巨大,因此许多机器学习问题在实践中变成了特征工程问题。
-
开发一个传统机器学习系统的主要工作量(甚至超过80%)都消耗在了预处理、特征提取与特征转换上。
总结要点
传统机器学习是一个 “特征工程 + 预测模型” 的范式。其性能瓶颈往往不在于最终的预测算法,而在于前端耗时费力、依赖专家知识的手工特征处理流程。这一局限性正是促使深度学习(能够自动从原始数据中学习特征)兴起并取得突破的重要原因之一。
更多推荐
 4
 0
- 0


 已为社区贡献29条内容

所有评论(0)