
第一部分-机器学习基础-1.4深度学习
深度学习是机器学习的核心进阶,其根本目标是自动从数据中学习到有效的、分层次的特征表示,从而彻底摆脱对人工“特征工程”的依赖。
1. 核心机制:深度与非线性的特征转换
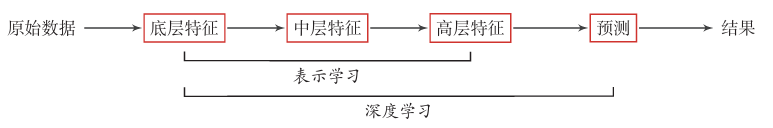
深度学习的“深度”,是指对原始数据进行多次非线性特征转换的层数。它通过一个多层的深度模型,将原始输入(如图像像素、文本字符)逐层抽象和转换,最终形成高层次、具有丰富语义的表示。这个过程如同一个信息提炼管道,每一层都在前一层的基础上构建更复杂的特征。
2. 关键挑战与解决方案:贡献度分配问题
深度学习区别于传统“浅层学习”的关键挑战是贡献度分配问题。在复杂的多层模型中,当最终结果产生时(例如,判断图像中是一只猫),我们难以确定网络中每一层、每一个参数的具体贡献。这就像复盘一盘棋,很难精确量化每一步棋对最终胜负的具体影响。
目前,神经网络模型成为深度学习的主流,主要原因是其可以利用误差反向传播算法,有效地将最终的预测误差(或奖励信号)逐层、逐参数地反向分配,从而指导模型中所有组件的协同学习和优化。
3. 理想范式:端到端学习
深度学习天然地支持并推动了端到端学习范式的发展。在端到端学习中,模型直接学习从原始输入到最终输出的完整映射,无需人为拆解任务为多个独立模块(例如,在语音识别中,无需单独设计声学模型、语言模型等)。
这种方式有两个显著优势:
-
目标一致性:模型的所有部分都围绕同一个总体目标进行优化,避免了子模块目标与最终目标不一致的问题。
-
避免错误累积:消除了传统流水线中错误在模块间传播和放大的风险。
总结与关联
因此,深度学习可以理解为实现高水平表示学习的一种强大方法。它通过构建深度神经网络模型,利用反向传播算法解决贡献度分配问题,以端到端的方式,自动从数据中学习出层次化的分布式表示。这不仅是技术上的革新,更是一种方法论的转变:将开发智能系统的重点,从耗费大量人力设计特征和流程,转向了设计能够自动学习的模型架构和算法。
更多推荐
 6
 0
- 0


 已为社区贡献29条内容

所有评论(0)