
在大模型班学算法的笔记记录-线性回归
·
一、数据集与样本
- 数据集(DataSet):是用于分析/训练的所有样本的集合(比如研究“房屋面积与房价的关系”时,所有房屋的“面积+房价”信息就构成数据集)。
- 样本(Sample):是数据集中的基本单元,由特征(Feature)和标签(Label)组成,形式为
(x, y):- 特征(x):样本的输入信息(比如房屋面积);
- 标签(y):样本的输出目标(比如房屋对应的房价)。
二、模型函数
模型函数f(x)的作用是建立特征与标签之间的关系,这里是一元线性回归模型: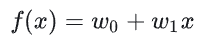
其中:
 :截距项(偏置),表示当特征
 时模型的预测值;
 :特征
 的权重(系数),表示
 每变化1个单位,预测值
 的变化量; 这个函数的核心假设是:特征与标签之间存在线性关联。
三、损失函数
损失函数L(w)用于衡量“模型预测值”与“真实标签值”的差异,样本有多少个,损失函数就包含多少项。这里使用的是均方误差(MSE)损失: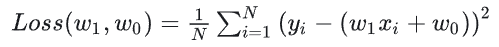
其中:
 :样本总数;
 :第
 个样本的真实标签;
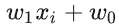 :第
 个样本的模型预测值;
- 平方的作用:保证误差非负(避免正负误差抵消),同时放大较大的误差;
 :对误差取平均,避免样本数量影响损失值的规模。
四、求解方法:梯度下降法
我们的目标是找到合适的 和
 ,让损失函数
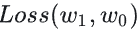 的值最小(此时模型预测误差最小),梯度下降法是实现这一目标的常用优化算法: 它的核心逻辑是:
- 给
 随机初始化一个初始值;
- 计算损失函数对
 的梯度(即偏导数)——梯度方向是损失增大最快的方向;
- 沿着梯度的反方向更新
 (让损失函数减小);
- 重复上述步骤,直到损失函数的变化足够小(或达到迭代次数),此时的
 就是最优参数。
五、线性回归的问题框架
解决线性回归问题的完整流程为:
问题结构数据集模型函数损失函数梯度下降求解推理预测
对应实际步骤:
- 准备数据集:收集“特征+标签”形式的样本;
- 确定模型函数:基于“线性关联”假设,选择一元线性模型;
- 定义损失函数:用均方误差衡量预测误差;
- 梯度下降求解:找到使损失最小的模型参数;
- 推理预测:用训练好的模型,输入新特征得到预测标签。
更多推荐

 7
 0
- 0


 已为社区贡献12条内容

所有评论(0)