
关联式容器set、map—底层结构&实战应用
目录
一、前言
STL容器大体可分为序列式容器和关联式容器两大类,string、vector、list、deque等这些容器为序列式容器,序列式容器在逻辑结构上为线性序列的数据结构,两个位置的元素之间一般没有紧密的关联关系,关联式容器与序列式容器不同在于关联式容器在逻辑结构上通常是非线性结构,两个位置的元素有紧密的关联关系,如果交换这两个位置,那么结构就被破坏了,关联式容器中的元素是按关键字来保存和访问的,常用的关联式容器有set、map,本文将围绕set、map展开介绍,set、map的接口与其他容器如vector、list等接口用法类似,本文将对其常用接口展开介绍,接着分析set、map的相关应用,set、map的应用很广泛,在一些场景下可以大大简化代码实现。
二、set
1、定义
set底层通过红黑树实现,红黑树为平衡二叉搜索树,set对应key搜索场景的平衡二叉搜索树,set的声明如下:
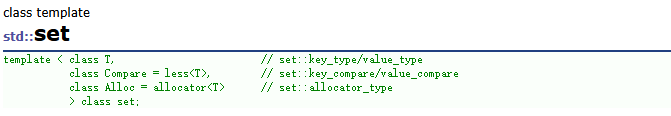
T就是set底层关键字的类型,less<T>默认要求T支持小于比较,set底层为红黑树,增删查的效率为O(logN),迭代器遍历为红黑树的中序遍历,故迭代器遍历set是有序的。
#include<iostream>
#include<set>
using namespace std;
int main()
{
    //去重+升序排序
	set<int> s;
	//去重+降序排序
    set<int, greater<int>> s1;
    return 0;
}
set为key搜索场景的二叉搜索树,不支持插入相等数据,比较逻辑为less<T>,默认支持小于比较,由二叉搜索树的比较实现逻辑可知,set<int> s,为升序排序,若想实现降序排序,可将greater<int>仿函数传给第2个模板参数Compare,如set<int,greater<int>> s1,s1即为降序排序。
2、相关接口
(1)insert
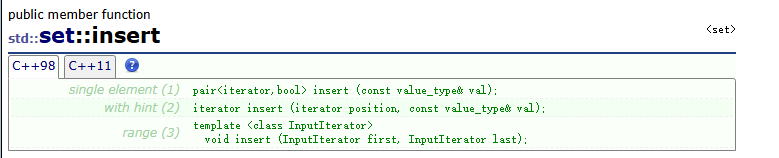
insert支持值val、迭代器、迭代器区间插入,较为常用的是值插入:
#include<iostream>
#include<set>
using namespace std;
int main()
{
	set<int> s;
	s.insert(1);
	s.insert(1);
	s.insert(9);
	s.insert(2);
    return 0;
}
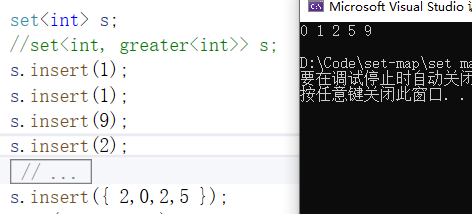
需要注意的是,由于set不支持插入相等数据,当插入多个相同的值时,set会进行去重,如进行两次s.insert(1),s中也只会有一个1。
#include<iostream>
#include<set>
using namespace std;
int main()
{
set<int> s;
s.insert(1);
s.insert(1);
s.insert(9);
s.insert(2);
s.insert({ 2,0,2,5 });
for (auto e : s)
{
cout << e << " ";
}
cout << endl;
return 0;
}
insert也支持插入一段initializer_list初始化列表值,如s.insert({2,0,2,5}),列表中已存在的数据2会插入失败,s中只有一个2。
#include<iostream>
#include<set>
using namespace std;
int main()
{
	set<string> strset = { "insert","add","sort" };
	//set<string> str({ "insert","add","sort" });
	for (auto& str : strset)
	{
		cout << str << " ";
	}
    cout << endl;
	return 0;
}
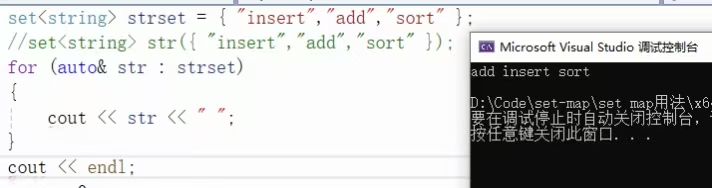
也可插入string,遍历string是通过比较ascII码大小顺序遍历的。
(2)迭代器

set迭代器为双向迭代器,迭代器支持++、--操作。
#include<iostream>
#include<set>
using namespace std;
int main()
{
	set<int> s;
	s.insert(1);
	s.insert(1);
	s.insert(9);
	s.insert(2);
	set<int>::iterator it = s.begin();
	while (it != s.end())
	{
        //不支持修改数据
		//*it = 1;
		cout << *it << " ";
		++it;
	}
	cout << endl;
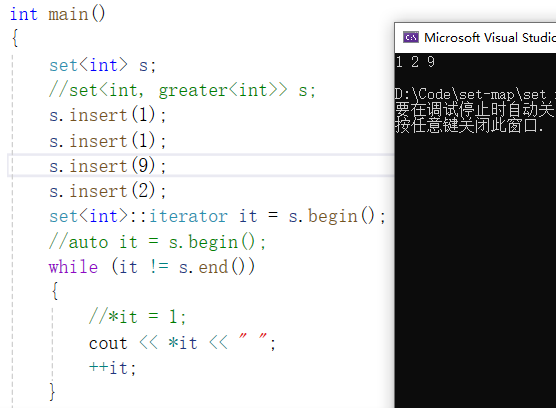
set迭代器的用法可类比其他容器迭代器的使用,即set<int>::iterator it=s.begin(),通过while循环遍历s,当it==s.end()遍历结束,set迭代器遍历方式为二叉搜索树的中序遍历,故遍历结果是有序的。
(3)erase
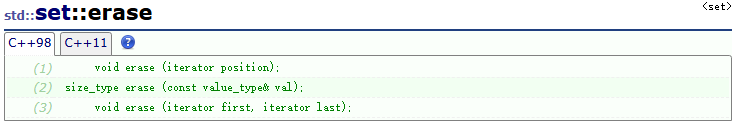
erase支持直接值val删除,同时也支持迭代器、迭代器区间删除。
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
	s.erase(s.begin());
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
    return 0;
}
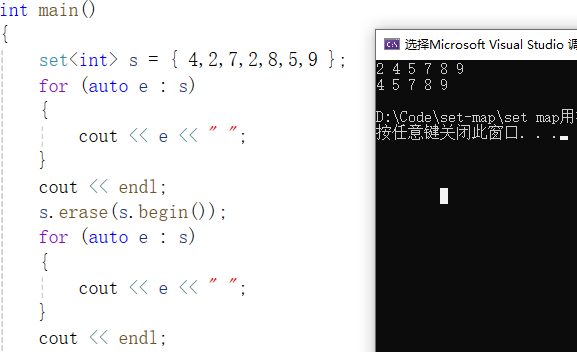
s.erase(s.begin()),即删除s中序遍历的第1个元素2。
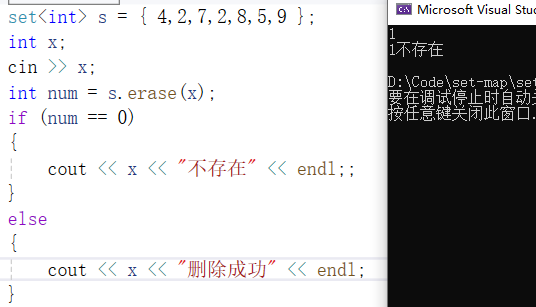
 直接值val删除时,erase返回的是删除的个数。
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	int x;
	cin >> x;
	int num = s.erase(x);
	if (num == 0)
	{
		cout << x << "不存在" << endl;;
	}
	else
	{
		cout << x << "删除成功" << endl;;
	}
	return 0;
}
int num=s.erase(x),则num为删除元素x的数据个数,若num==0,则表示x不在s中,若x在s中,则num为1。
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	int x;
	cin >> x;
	auto pos = s.find(x);
	if (pos != s.end())
	{
		s.erase(pos);
		cout << *pos << endl;
	}
	else
	{
		cout << x << "不存在" << endl;
	}
	return 0;
}
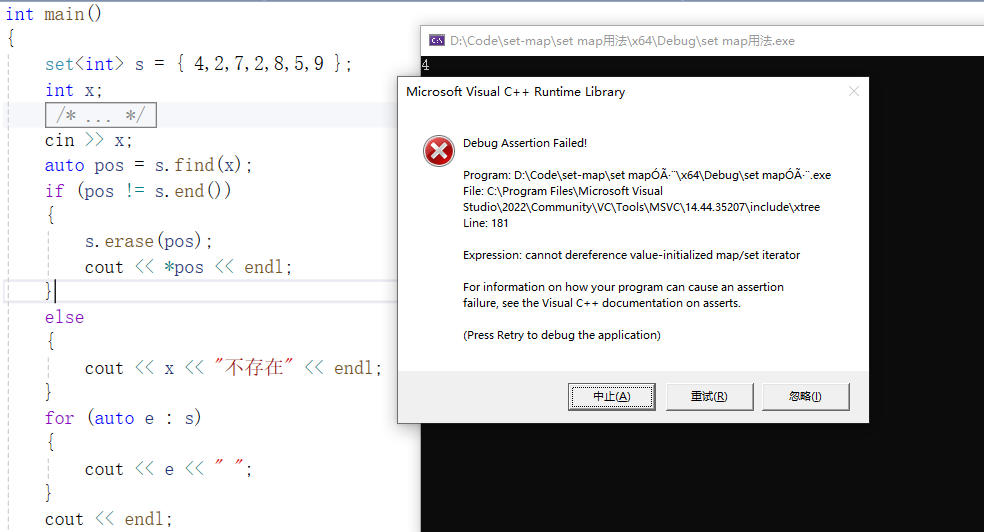
set底层为平衡二叉搜索树,erase删除数据有两种方式,第1种是当删除结点没有孩子结点或者只有1个孩子结点时直接删除该结点,第2种是当删除结点有两个孩子结点时,这时不能直接删除该结点,需要采用替换法才能删除,这两种删除方式都会导致迭代器的失效,第1种删除方式产生了野指针导致迭代器的失效,第2种替换法删除虽然没有产生野指针,但改变了当前结点的实际意义,也认为是迭代器的失效,故erase后迭代器失效,不能直接访问,需要更新迭代器才能访问,如pos=s.erase(pos),VS下直接访问编译会报错。
(4)find
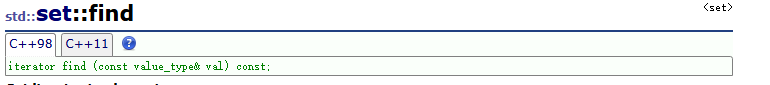
find用于在set中查找数据,find查找走的是平衡二叉搜索树的查找路线,可知查找效率为O(logN),返回查找数据位置的迭代器,若数据不在set对象中,则返回end位置的迭代器。
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	int x;
	cin >> x;
	auto it1 = find(s.begin(), s.end(), x);//O(N)
	auto it2 = s.find(x);//O(logN)
    return 0;
}
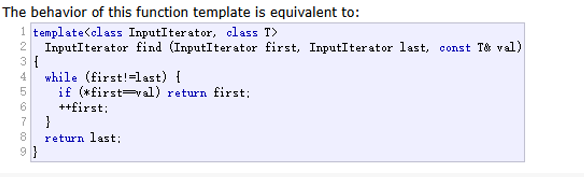
find(s.begin(),s.end(),x),查找走的是元素全部遍历一遍的方式,故查找效率为O(N),s.find(x)查找走的则是二叉搜索树的查找路线,查找效率为O(logN)。
(5)count
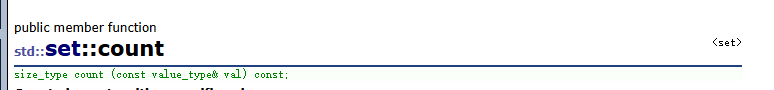
count用于统计数据val在set中的个数,由于set不支持插入相同数据,在set中要么返回0,要么返回1,multiset支持插入相同数据,故可返回大于1的值。
#include<iostream>
#include<set>
using namespace std;
int main()
{
	set<int> s = { 4,2,7,2,8,5,9 };
	int x;
	cin >> x;
	if (s.count(x))
	{
		cout << x << "存在" << endl;;
	}
	else
	{
		cout << x << "不存在"<<endl;
	}
	return 0;
}
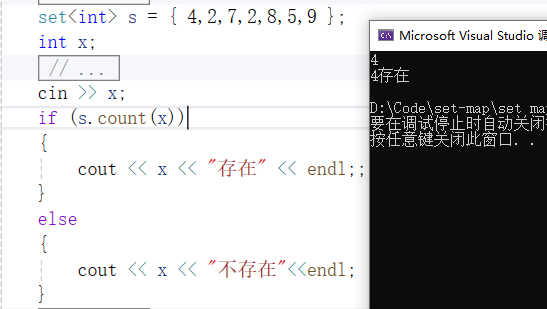
除了find查找数据,也可通过count来实现查找,s.count(x)==0,则表示s中没有x,若存在s.count(x)==1。
(6)lower_bound、upper_bound
lower_bound、upper_bound配合使用可实现查找一段符合条件的数据区间。

lower_bound用于返回第一个不小于val数据的迭代器位置,即第1个>=val数据的迭代器位置。

upper_bound用于返回第一个大于val数据位置的迭代器,即第1个>val数据位置的迭代器。
#include<iostream>
#include<set>
using namespace std;
int main()
{
	std::set<int> myset;
	for (int i = 1;i < 10;i++)
	{
		myset.insert(i * 10);
	}
	for (auto e : myset)
	{
		cout << e << " ";
	}
	cout << endl;
	auto it1 = myset.lower_bound(25);
	auto it2 = myset.upper_bound(55);
	myset.erase(it1, it2);
	for (auto e : myset)
	{
		cout << e << " ";
	}
	cout << endl;
	return 0;
}
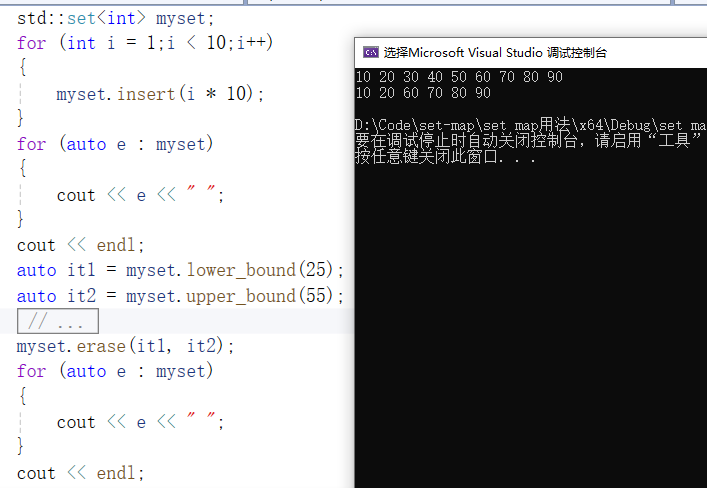
auto it1=myset.lower_bound(25),则it1为myset第1个>=25数据位置的迭代器,auto it2=myset.upper_bound(55),则it2为myset第1个>55数据位置的迭代器,myset.erase(it1,it2),即删除(it1,it2)这一段区间的数据。
3、multiset
(1)定义
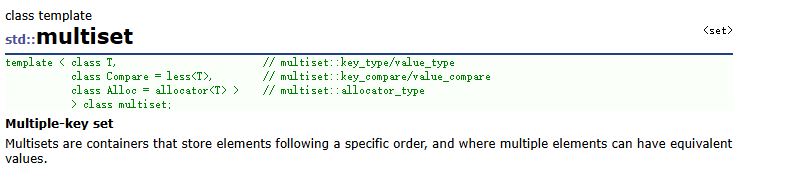
multiset与set类似,都为key搜索场景的平衡二叉搜索树,不同在于set不支持插入相等的value,而multiset支持插入多个相等的value,其他接口用法都可类比set的使用。
(2)迭代器
int main()
{
	multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
	auto it = s.begin();
	while (it != s.end())
	{
		cout << *it << " ";
	    ++it;
	}
	cout << endl;
	return 0;
}
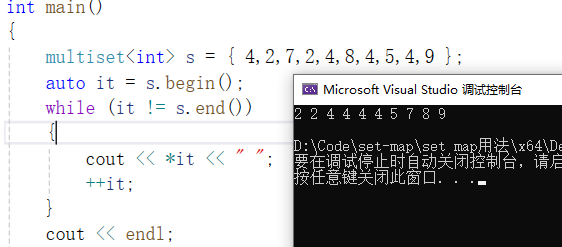
迭代器遍历方式与set一致,multiset支持有多个相等的值,迭代器遍历方式为中序遍历,结果为升序排序。
(3)find
#include<iostream>
#include<set>
using namespace std;
int main()
{
	multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
	int x;
	cin >> x;
	auto ret = s.find(x);
	while (ret != s.end() && (*ret) == x)
	{
		cout << *ret << " ";
		++ret;
	}
	cout << endl;
    return 0;
}
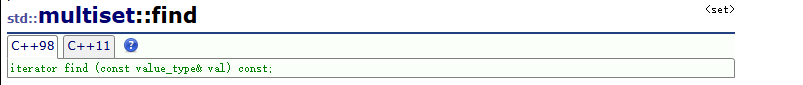
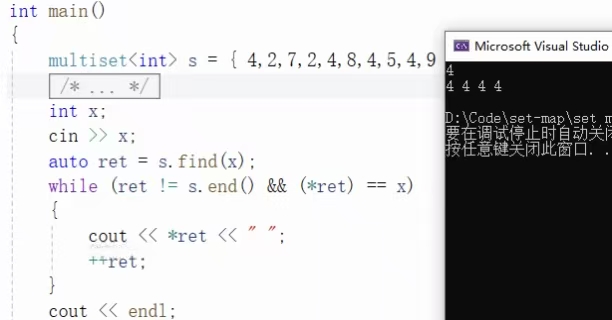
find用于查找数据,与set不同在于multiset中可能有多个相等的值,由于迭代器遍历为中序遍历,结果为升序排序,故可通过while循环及迭代器遍历来找出所有相等的值,例如查找4。
(4)count

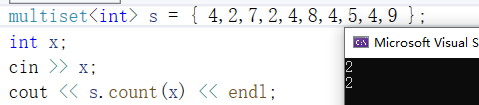
int main()
{
	multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
	int x;
	cin >> x;
	cout << s.count(x) << endl;
    cout << endl;
	return 0;
}
count用于返回数据的个数,如s.count(x)返回的是数据x在s中的个数。
(5)erase
int main()
{
	multiset<int> s = { 4,2,7,2,4,8,4,5,4,9 };
	int x;
	cin >> x;
	cout << s.count(x) << endl;
	auto it = s.find(x);
	while (it != s.end() && *it == x)
	{
		it = s.erase(it);
	}
	cout << endl;
	for (auto e : s)
	{
		cout << e << " ";
	}
	cout << endl;
    return 0;
}
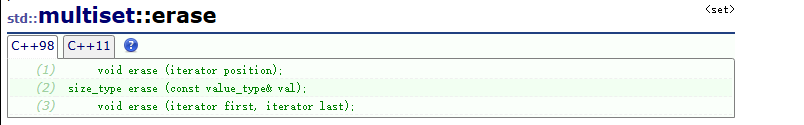
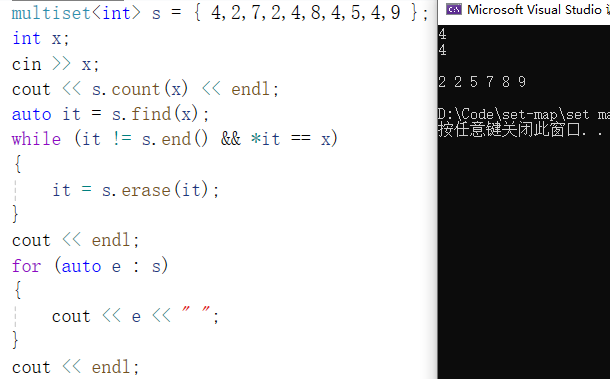
erase用于删除数据,可通过while循环实现删除多个相同的元素,需要注意的是erase会导致迭代器的失效,需要更新后才可继续访问,即it=s.erase(it),如删除数据4:
除了通过迭代器erase来删除,还可以直接erase指定元素,如s.erase(x),此时erase会删除s中所有值为x的元素,就不需要再通过while循环来删除所有值相同的数据。
4、应用
(1)求两数组交集
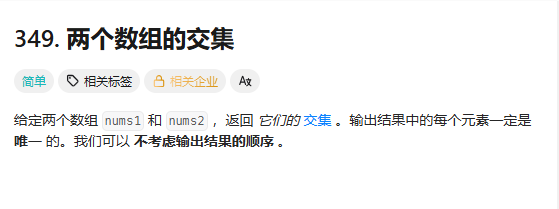
给定两个数组nums1和nums2,返回其交集,若有多个相同的元素,要求返回交集的每个元素是唯一的。
思路:可先将nums1和nums2的数据分别放入set中,set不允许插入相等的数据,故放入set对num1和num2的元素就起到了去重效果。
class Solution
{
public:
	vector<int> insertion(vector<int>& v1, vector<int>& v2)
	{
		set<int> s1(v1.begin(), v1.end());
		set<int> s2(v2.begin(), v2.end());
		vector<int> v;
		auto it1 = s1.begin();
		auto it2 = s2.begin();
		while (it1 != s1.end() && it2 != s2.end())
		{
			if (*it1 < *it2)
			{
				++it1;
			}
			else if(*it1==*it2)
			{
				v.push_back(*it1);
				++it1;
				++it2;
			}
			else
			{
				++it2;
			}
		}
		return v;
	}
};
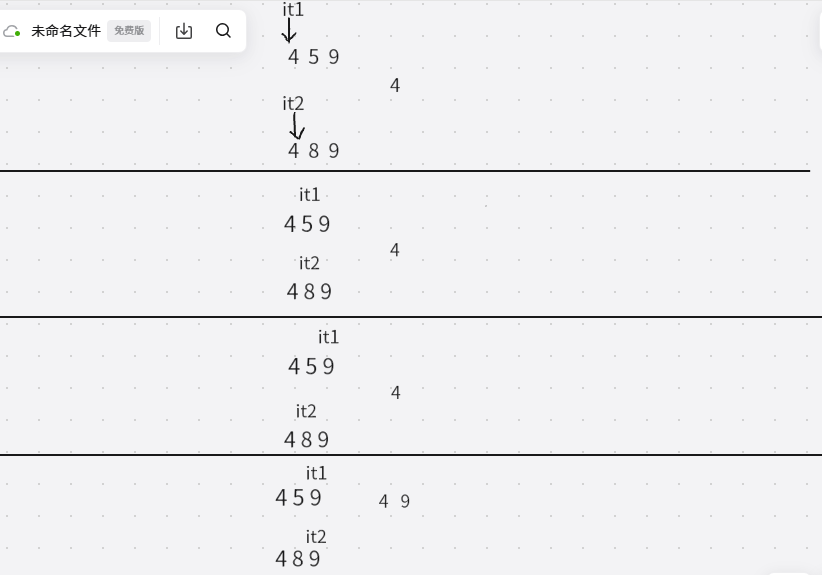
接下来使用迭代器通过while循环对s1、s2进行遍历,迭代器遍历为中序遍历,故it1、it2遍历s1、s2是升序的,当*it1==*it2时,说明该数据是二者的交集,则将数据尾插到v中,即v.push_back(*it1),当*it1<*it2或*it1>*it2时,则对应小的数据的迭代器++,因为小的必然不是二者的交集,故++继续向后遍历,最后v即为二者的交集数组,具体过程可参考下图所示:
(2)求带环链表的环入口点
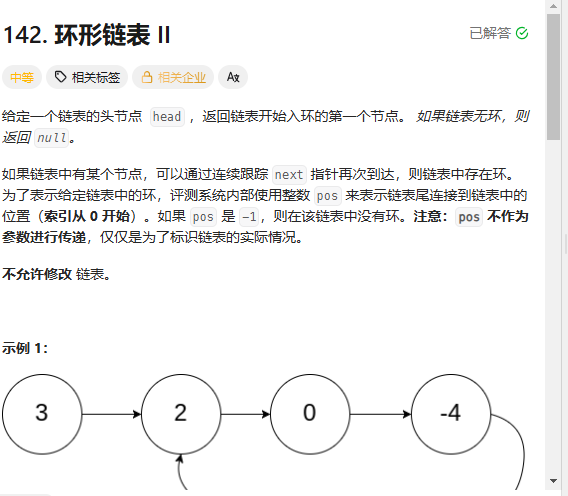
求带环链表的环入口点,在数据结构初阶,通过证明快慢指针的相遇,并求出快慢指针的相遇位置,随后通过双指针法,一个指针从链表的头结点出发,另一个指针从相遇位置同时出发,通过证明两者的相遇位置即为带环链表的环入口点,显然证明过程就显得较为复杂了。
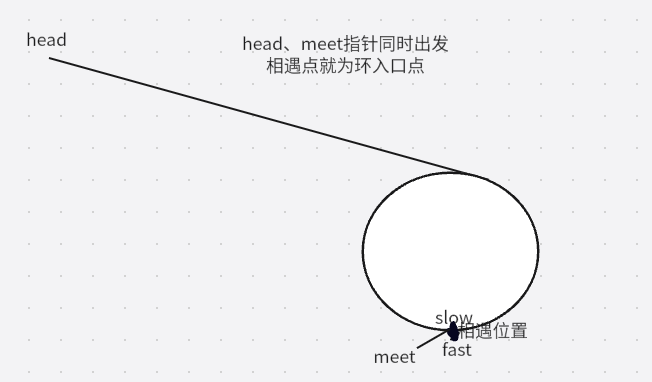
双指针相遇法:
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     struct ListNode *next;
 * };
 */
struct ListNode *detectCycle(struct ListNode *head) {
    struct ListNode*fast=head;
    struct ListNode*slow=head;
    while(fast&&fast->next)
    {
        fast=fast->next->next;
        slow=slow->next;
        if(fast==slow)
        {
            struct ListNode*meet=slow;
            while(meet!=head)
            {
                meet=meet->next;
                head=head->next;
            }
            return meet;
        }
    }
    return NULL;
}
现在可以借助set来简化这个问题,构造一个存放链表指针的set对象s,即set<Listnode*> s。
class solution
{
public:
	Listnode* detectcycle(Listnode* head)
	{
		set<Listnode*> s;
		Listnode* cur = head;
		while (cur)
		{
			if (s.count(cur))
			{
				return cur;
			}
			else
			{
				s.insert(cur);
			}
			cur = cur->next;
		}
		return nullptr;
	}
};
cur初始化为头结点指针head,通过while循环,判断s.count(cur),若s.count(cur)==0,说明s中没有该结点,则s.insert(cur),若s.count(cur)==1,则说明cur已经在s中,显然重复了,说明此时的cur即为该带环链表的环入口点,return cur即可,这样只通过s.count(cur)就求出了带环链表的环入口点,对于双指针相遇求法显然就是降维打击了。
三、map
1、定义
map的声明如下:
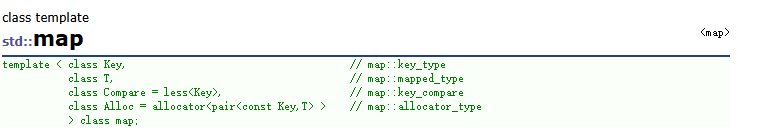
map对应Key_value场景的二叉搜索树,Key就是map底层关键字的类型,T是map底层value的类型,map默认要求Key支持小于比较,map底层通过红黑树实现,增删查改效率为O(logN),迭代器遍历也是走的中序,是按Key升序顺序遍历的。
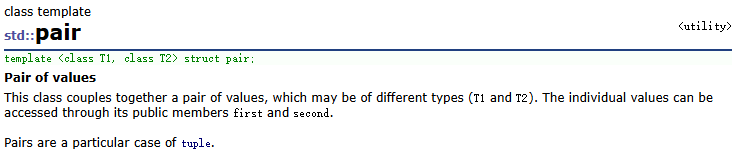
map底层红黑树结点中的数据,使用pair<Key,T>来存储键值对数据,
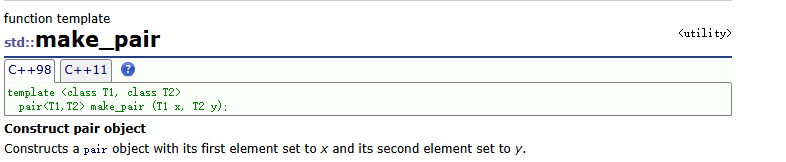
pair可通过make_pair来构造实现。
#include<iostream>
#include<map>
using namespace std;
int main()
{
	map<string, string> dict;
	map<string, string> dict1 = { {"left","左边"},{"right","右边"},{"string","字符串"},{"insert","插入"} };
	pair<string, string> kv1("first", "第一个");
	map<string, string> dict2 = { kv1,pair<string,string>("second","第二个") };
    return 0;
}
可通过初始化列表来初始化dict1,即map<string,string> dict1={ {"left","左边"},{"right","右边"},{"string","字符串"},{"insert","插入"} };也可通过pair来初始化,map<string,string> dict2={kv1,pair<string,string>("second","第二个") };
2、insert
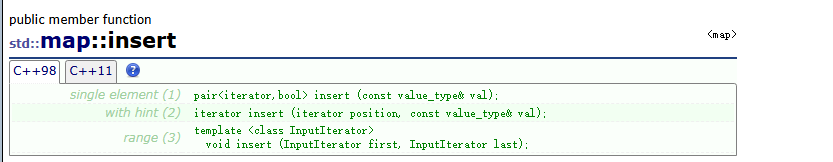
#include<iostream>
#include<map>
using namespace std;
int main()
{
	map<string, string> dict;
	pair<string, string> kv1("first", "第一个");
	dict.insert(kv1);
	dict.insert(pair<string, string>("second", "第二个"));
	dict.insert(make_pair("sort", "排序"));
	dict.insert({ "auto","自动的" });
	dict.insert({ "auto","非自动" });
    return 0;
}
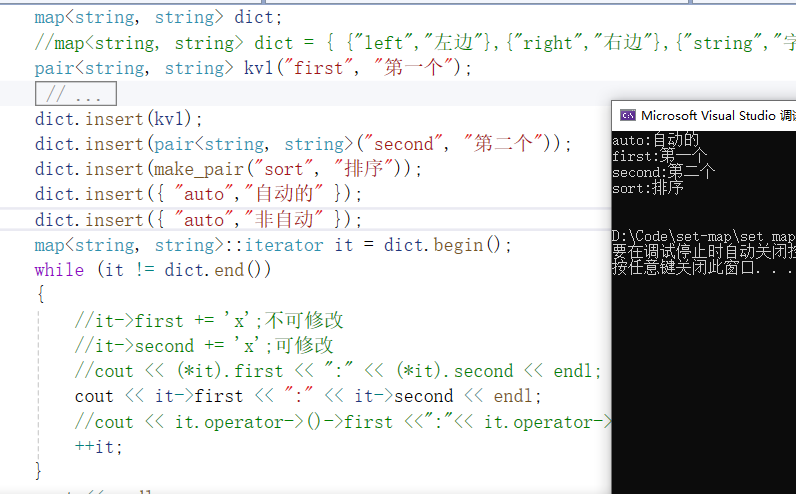
insert支持直接插入pair对象,如pair<string,string>kv1("first","第一个"),dict.insert(kv1),也可以是匿名对象,如dict.insert(pair<string,string>("second","第二个")),通过make_pair构造,dict.insert(make_pair("sort","排序")),以及隐式类型转化成pair,如dict.insert({"auto","自动的"}),需要注意的是,map插入走的是key的比较路线,且不支持插入相同的key,故dict.insert({"auto","非自动"})插入失败。
3、迭代器
map底层红黑树的结点数据,使用pair<Key,T>来存储键值对数据,pair成员变量first对应Key,second对应value。
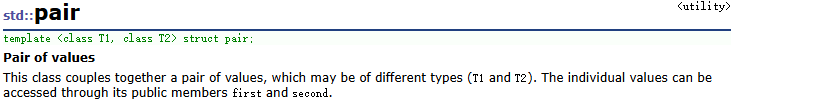
迭代器访问pair时,分开访问first和second,即it->first,it->second,这里是一种省略写法,严格写法是it.operator->()->first,it.operator->()->second,it.operator->()返回的是pair的指针,再通过->即可访问first、second,采取it->first、it->second写法较为简洁方便。
int main()
{
	map<string, string> dict;
	pair<string, string> kv1("first", "第一个");
	dict.insert(kv1);
	dict.insert(pair<string, string>("second", "第二个"));
	dict.insert(make_pair("sort", "排序"));
	dict.insert({ "auto","自动的" });
	dict.insert({ "auto","非自动" });
	map<string, string>::iterator it = dict.begin();
	while (it != dict.end())
	{
		//it->first += 'x';不可修改
		//it->second += 'x';可修改
		//cout << (*it).first << ":" << (*it).second << endl;
		cout << it->first << ":" << it->second << endl;
		//cout << it.operator->()->first <<":"<< it.operator->()->second << endl;
		++it;
	}
	cout << endl;
	return 0;
}
也可对it进行解引用再访问,即(*it).first,(*it).second,也能实现对key、value的访问,first对应key,不支持修改,second对应value,可修改。
4、find
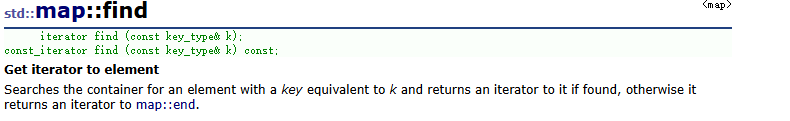
find用于map中key的查找,若key查找成功,则返回该位置的迭代器,查找失败则返回end位置的迭代器。
#include<iostream>
#include<map>
using namespace std;
int main()
{
	string arr[] = { "苹果","梨","香蕉","苹果","梨" };
	map<string, int> dict;
	for (const auto& st : arr)
	{
		auto ret = dict.find(st);
		if (ret == dict.end())
		{
			dict.insert({ st,1 });
		}
		else
		{
			ret->second++;
		}
	}
	for (const auto& e : dict)
	{
		cout << e.first << ":" << e.second << endl;
	}
	cout << endl;
	return 0;
}
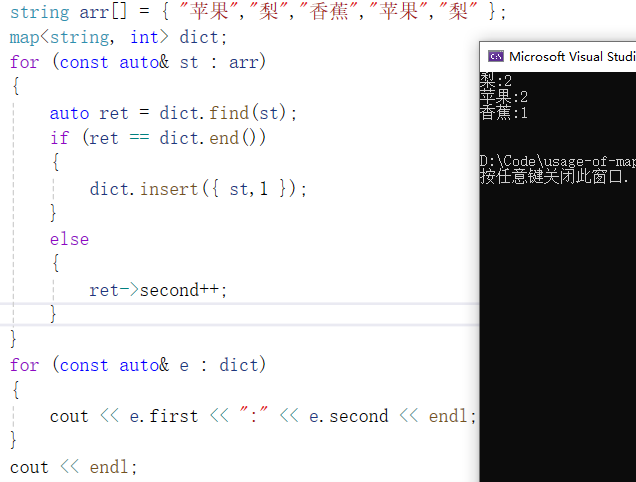
借助map可统计数据出现的次数,ret==dict.end(),说明st不在dict中,则将st插入到dict中,即dict.insert({st,1}),出现次数计为1,ret!=dict.end(),则说明st已经在dict中,ret->second++,统计数据出现的次数。
5、operator[ ]
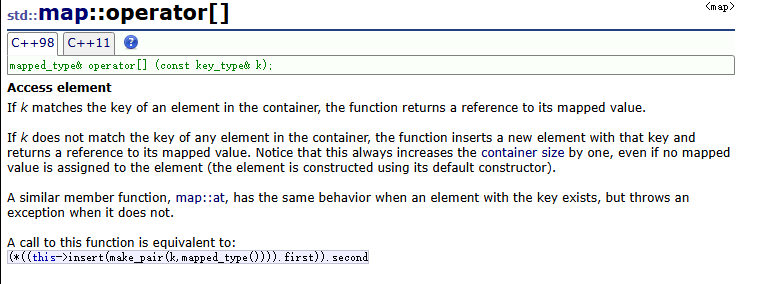
map支持operator[ ]访问,[ ]中的数据类型key_type对应关键字key的数据类型,返回mapped_type数据类型对应value的类型。
#include<iostream>
#include<map>
using namespace std;
int main()
{
	map<string, string> dict;
	dict.insert(make_pair("sort", "排序"));
    dict["insert"];//插入
	dict["left"] = "左边";//插入+修改
	dict["left"] = "zuobian";//查找+修改
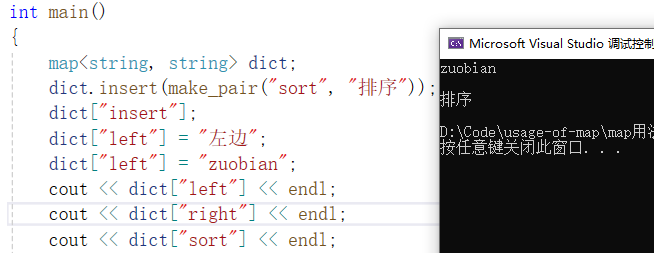
	cout << dict["left"] << endl;//查找
	cout << dict["right"] << endl;//插入
	return 0;
}
map的operator[ ]有三大功能:插入,查找,修改,当key数据不在map中,如dict["insert"]就相当于dict.insert({"insert",""}),可通过监视窗口观察:
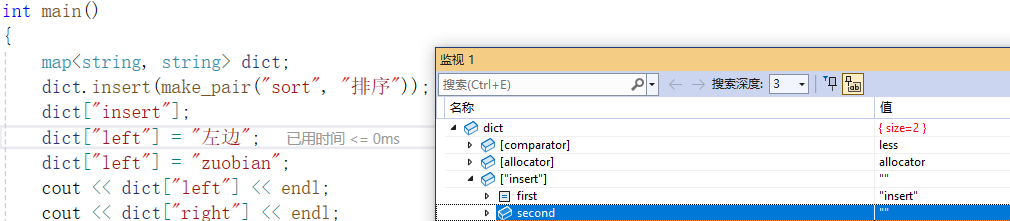
可以看出dict中新增了pair<string,string>对象,pair的first变量对应"insert",second对应"",operator[ ]实现了插入功能。
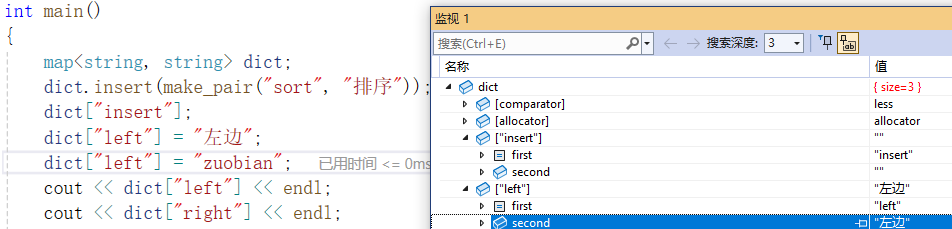
继续调试观察,dict["left"]="左边",可以看出dict["left"]="左边"相当于dict.insert({"left,"左边"}),此时的operator[ ]实现了插入+修改功能。
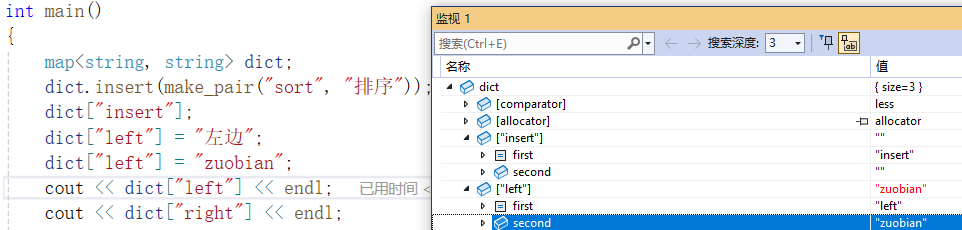
dict["left"]="zuobian",由于dict["left"]="左边",left已经在dict中,left不会重复插入,此时的dict["left"]="zuobian",只会修改second,second修改为zuobian,此时operator[ ]相当于查找+修改功能。
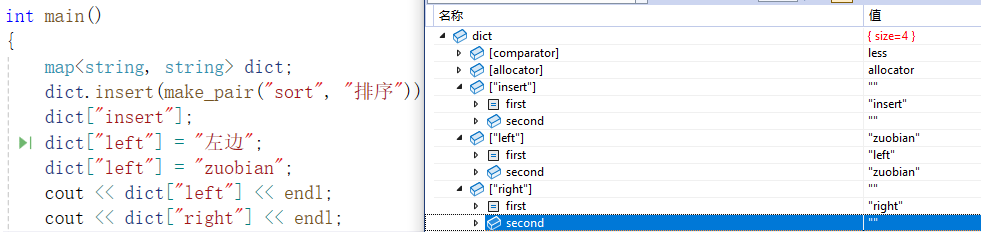
dict["left"],由于left已经在dict中,此时dict["left]相当于查找功能,查找left所对应的value,dict["right"],由于right不在dict中,此时dict["right"]相当于插入功能,通过监视观察结果如上所示,dict["right"]相当于dict.insert({"right",""})。
6、multimap
int main()
{
	multimap<string, string> dict;
	dict.insert({ "sort", "排序" });
	dict.insert({"sort", "排序1"});
	dict.insert({ "sort", "排序2" });
	dict.insert({ "sort", "排序3" });
	dict.insert({ "string", "字符串" });
	dict.erase("sort");
	return 0;
}
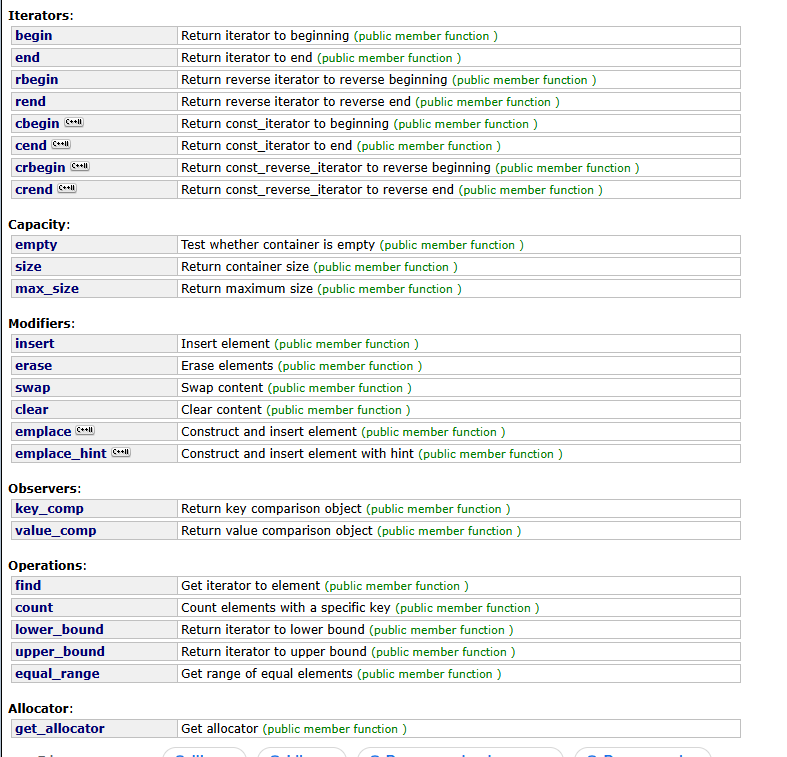
multimap也为key_value场景的平衡二叉搜索树,与map不同在于multimap支持多个相同key的插入,multimap与map接口用法总体类似,还需注意的是erase会删除所有key相同的数据,如dict.erase("sort"),会删除所有key为sort的数据。
7、应用
(1)随机链表的复制
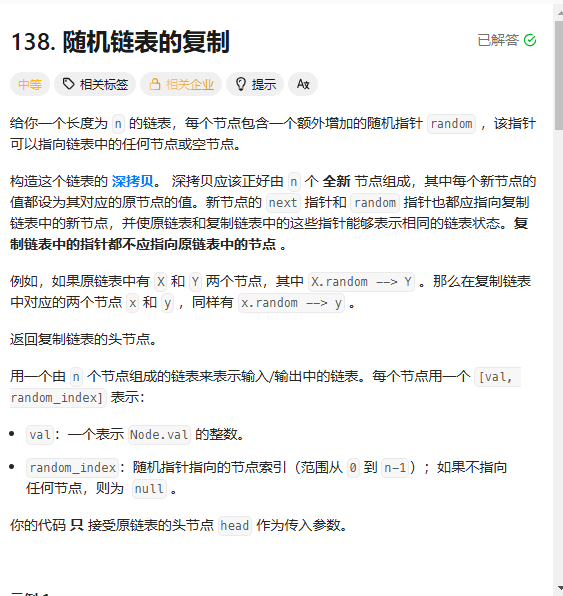
给定一个链表,要求完成该链表的深拷贝,与一般链表相比,不同在于该链表还需处理random指针的连接问题,在数据结构链表初阶部分,这道题可以说是链表模块的试金石,需要先在原链表的每个结点后插入该结点的拷贝结点:
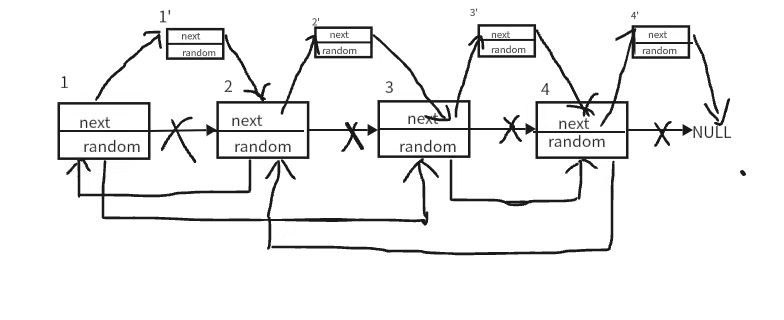
再处理新链表结点random指针的连接问题,设原链表头结点为head1,新链表头结点为head2,可得head2->random=head1->random->next,这一关系正是解这道题的灵魂所在。
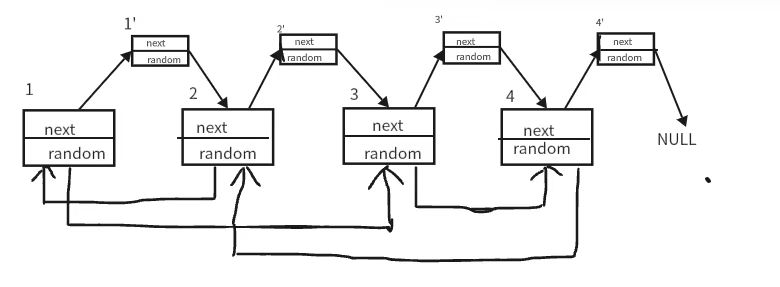
最后将新链表结点尾插,对原链表结点恢复,就完成了随机链表的复制。
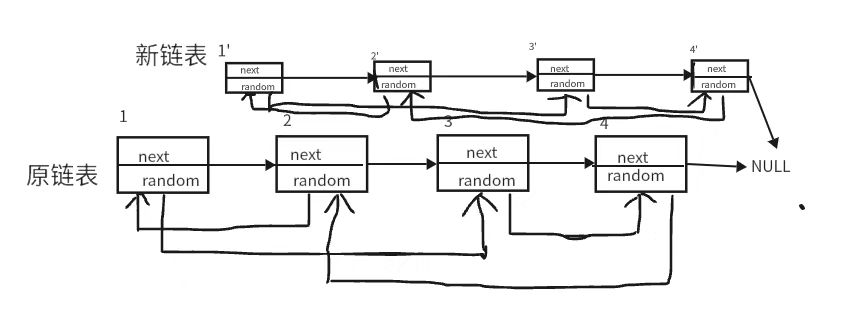
代码实现:
/**
 * Definition for a Node.
 * struct Node {
 *     int val;
 *     struct Node *next;
 *     struct Node *random;
 * };
 */
struct Node* copyRandomList(struct Node* head)
{
    if(head==NULL)
    return NULL;
	struct Node*cur=head;
    while(cur)
    {
        struct Node*newnode=(struct Node*)malloc(sizeof(struct Node));
        newnode->val=cur->val;
        newnode->next=cur->next;
        newnode->random=NULL;
        cur->next=newnode;
        cur=newnode->next;
    }
    cur=head;
    while(cur)
    {
        if(cur->random)
        {
            cur->next->random=cur->random->next;
        }
        cur=cur->next->next;
    }
    cur=head;
    struct Node*newhead=head->next;
    struct Node*newcur=newhead;
    while(cur)
    {
        cur->next=newcur->next;
        cur=cur->next;
        if(cur)
        {
            newcur->next=cur->next;
            newcur=newcur->next;
        }
    }
    return newhead;
}
显然过程就比较复杂了,涉及到链表的拷贝、连接、恢复问题,可借助map的key_value结构来简化这个链表的复制问题。构造一个key为链表结点指针Node*,value也为链表结点指针Node*的map,即map<Node*,Node*> dict,
Node* copylist(Node* head)
{
	if (head == nullptr)
		return nullptr;
	map<Node*, Node*> dict;
	Node* cur = head;
	Node* copyhead = nullptr;
	Node* copytail = nullptr;
	while (cur)
	{
		if (copytail == nullptr)
		{
			copyhead = copytail = new Node(cur->val);
		}
		else
		{
			copytail->next = new Node(cur->val);
			copytail = copytail->next;
		}
		dict[cur] = copytail;
		cur = cur->next;
	}
	cur = head;
	Node* copy = copyhead;
	while (cur)
	{
		if (cur->random == nullptr)
		{
			copy->random = nullptr;
		}
		else
		{
			copy->random = dict[cur->random];
		}
		cur = cur->next;
		copy = copy->next;
	}
	return copyhead;
}
cur初始化为原链表的头结点,通过while循环,完成新链表结点的构造和连接,dict[cur]=copytail,这一步可以说是关键,实现了原链表结点和新链表结点的映射关系,有了映射关系,接下来就可以处理random指针的连接问题了,cur、copy分别从两个链表的头结点开始遍历,copy->random=dict[cur->random],这也是关键的一步,由映射关系可知,dict[cur->random]即为copy的random指针所指向新链表的对应结点,通过while循环即可完成新链表random指针的指向问题,利用map的key_value结构相比于链表的拷贝、连接、恢复操作就简单了不少,原链表和新链表通过map的映射关系就实现了链表的深拷贝。
(2)前K个高频单词
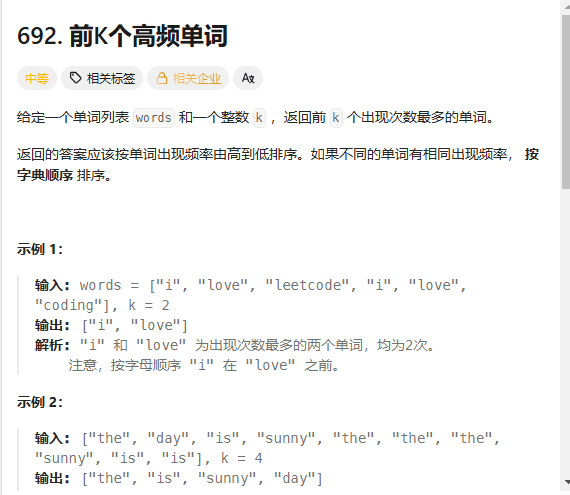
给定一个单词列表words和一个整数k,返回前k个出现次数最多的单词,可以考虑使用map统计出次数后,返回的结果按单词出现频率由高到低排序,如果不同的单词有相同出现频率,按字典顺序排序,即实现一个仿函数,比较pair<string,int>,先比较second,即出现次数,出现次数多,second大,若second相等,再比较first,按字典顺序first小的优先。
class Solution
{
public:
	struct compare
	{
		bool operator()(const pair<string, int>& p1, const pair<string, int>& p2)
		{
			return p1.second > p2.second || (p1.second==p2.second && p1.first<p2.first);
	    }
	};
	vector<string> TopKwords(vector<string>& v,int k)
	{
		map<string, int> dict;
		for (const auto& e : v)
		{
			dict[e]++;
		}
		vector<pair<string, int>> v1(dict.begin(), dict.end());
		sort(v1.begin(), v1.end(), compare());
		vector<string> v2;
		for (int i = 0;i < k;i++)
		{
			v2.push_back(v1[i].first);
		}
		return v2;
	}
};
map<string,int> dict,dict[e]++,dict[e]++用于统计单词出现的次数,再通过迭代器区间构造将dict的数据传给v1,调用sort使用已实现的仿函数比较逻辑compare对v1进行排序,排序完成后,v1数据将按出现次数由多到少排列,出现次数相同的元素按字典顺序排列,则v1前k个数据即为前K个高频单词,再通过for循环将v1的前k个数据尾插给v2,即v2.push_back(v1[i].first),v2即为前K个高频单词。
也可通过优先级队列priority_queue来求解TopK问题:
class solution
{
public:
	struct compare
	{
		bool operator()(const pair<string, int>& p1, const pair<string, int>& p2)
		{
			return p1.second < p2.second || (p1.second == p2.second && p1.first > p2.first);
		}
	};
	vector<string> TopKwords(vector<string>& v, int k)
	{
		map<string, int> dict;
		for (const auto& e : v)
		{
			dict[e]++;
		}
		vector<pair<string, int>> v1(dict.begin(), dict.end());
		priority_queue<pair<string, int>, vector<pair<string, int>>, compare> pq(v1.begin(), v1.end());
		vector<string> v2;
		for (int i = 0;i < k;i++)
		{
			v2.push_back(pq.top().first);
			pq.pop();
		}
		return v2;
	}
};
与map不同的是,此时仿函数compare的比较逻辑与map相反,second小、或者second相等first大的比较逻辑为真,这是由于在堆调整中,比较逻辑为真时向下调整,向下调整说明优先级低,即second小、或者second相等且first大的优先级低,则堆顶即为second大的数据,即出现次数多的单词,其他步骤与map相同,通过迭代器区间构造将v1数据放入堆pq中,最后通过for循环依次取出前K个堆顶数据,即为前K个高频单词,尾插到v2中,v2.push_back(pq.top().first),v2即为所求。
四、结语
关联式容器set、map底层都由平衡二叉搜索树实现,set为key搜索场景的平衡二叉搜索树,不支持插入多个相等的key,multiset支持插入多个相等的key,set和multiset增删查走的都是二叉搜索树key的增删查路线,修改key可能会破坏搜索树的结构,因此不支持修改key,map对应key_value搜索场景的平衡二叉搜索树,增删查走的也是二叉搜索树key的增删查路线,不支持修改key,但可修改value,key与value形成映射关系,通过查找key即可找到对应的value,multimap也为key_value搜索场景的平衡二叉搜索树,支持多个相等key的插入,增删查改方式与map类似,走的也是key_value搜索场景的平衡二叉搜索树路线,正是由于set、map结构的独特性,在实践中应用很广泛,如借助set求解两数组的交集、带环链表的环入口点,map求解链表的复制、TopK问题都比常规解法要简单很多,set、map本身独特的结构就天然实现了自动排序以及唯一性的保证,同时具备了强大的查找能力,在需要有序性、实现查找效率、高效访问的场景下都有着不可替代的地位!
更多推荐


 13
 0
- 0


 已为社区贡献6条内容

所有评论(0)