
第一部分-机器学习基础-2.1基本概念
·
机器学习基本概念(以挑选芒果为例)
通过 “挑选芒果” 的例子,介绍机器学习核心概念及流程:
1. 基础元素
- 特征(属性):芒果的颜色、大小等属性,用特征向量
表示(D为特征维度)。
- 标签:芒果的 “好 / 坏”(离散)或甜度评分(连续),用标量y表示。
- 样本(示例):单个带特征 + 标签的芒果。
- 数据集(语料库):一组样本,分为:
- 训练集:用于训练模型的样本;
- 测试集:用于检验模型的样本。
2. 训练过程
- 训练集
,样本需满足独立同分布(IID)。
- 目标:从函数集合
中,通过 学习算法
找到 “最优函数
”,近似特征
与标签
的映射关系。
3. 预测与评估
- 预测:用
,或标签的条件概率
。
- 评估:用测试集
计算准确率:
为指示函数)
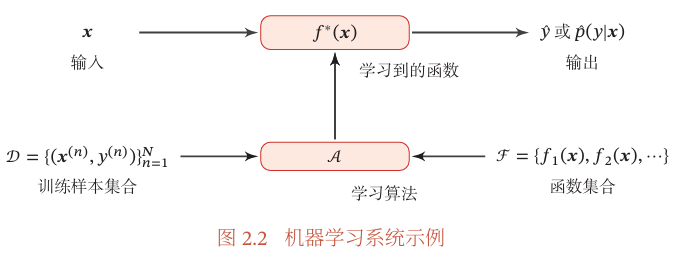
4. 基本流程(图 2.2)
输入特征向量,通过学习算法
从训练集
、函数集合
中学习到
,最终输出预测标签 / 概率。
更多推荐
 9
 0
- 0


 已为社区贡献29条内容

所有评论(0)