
《动手学深度学习》-28BatchNorm回归
·
import torch
from torch import nn
import d2l
import matplotlib.pyplot as plt
# def batch_norm(X,gamma,beta,moving_mean,moving_var,eps,momentum):
#     if not torch.is_grad_enabled():
#         X_hat=(X-moving_mean)/torch.sqrt(moving_var+eps)
#     else:
#         if len(X.shape)==2:
#             mean=X.mean(dim=0)
#             var=((X-mean)**2).mean(dim=0)
#         else:
#             mean=X.mean(dim=(0,2,3),keepdims=True)
#             var=((X-mean)**2).mean(dim=(0,2,3),keepdims=True)
#         X_hat=(X-mean)/torch.sqrt(var+eps)
#         moving_mean=momentum*moving_mean+(1-momentum)*mean
#         moving_var=momentum*moving_var+(1-momentum)*var
#     Y=gamma*X_hat+beta
#     return Y,moving_mean,moving_var
# class BatchNorm(nn.Module):
#     def __init__(self,num_features,num_dims):
#         super().__init__()
#         if num_dims==2:
#             shape=(1,num_features)
#         else:
#             shape=(1,num_features,1,1)
#         self.gamma=nn.Parameter(torch.ones(shape))
#         self.beta=nn.Parameter(torch.ones(shape))
#         self.moving_mean=torch.zeros(shape)
#         self.moving_var=torch.ones(shape)
#     def forward(self, x):
#         if self.moving_mean.device!=x.device:
#             self.moving_mean=self.moving_mean.to(x.device)
#             self.moving_var=self.moving_var.to(x.device)
#         Y,self.moving_mean,self.moving_var=batch_norm(x,self.gamma,self.beta,self.moving_mean,self.moving_var,eps=1e-5,momentum=0.9)
#         return Y
net = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5), nn.BatchNorm2d(6), nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5), nn.BatchNorm2d(16), nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(),
    nn.Linear(16*4*4, 120), nn.BatchNorm1d(120), nn.Sigmoid(),
    nn.Linear(120, 84), nn.BatchNorm1d(84), nn.Sigmoid(),
    nn.Linear(84, 10))
lr, num_epochs, batch_size = 1.0, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
plt.ioff()
plt.show(block=True)
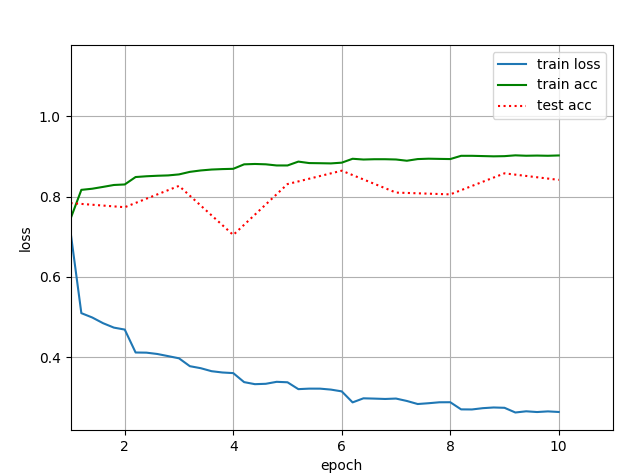
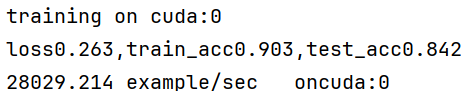
强制把每一层的输入激活拉回到“正常区间”,梯度被稳定缩放(γ/σ) → 防止爆炸与消失,让每一层 “看到” 的输入分布变稳定 → 优化难度降低
更多推荐


 10
 0
- 0


 已为社区贡献40条内容

所有评论(0)