
[从0开始深度学习]模型选择,欠拟合,过拟合,梯度爆炸
1.模型选择
1.1. 一句话
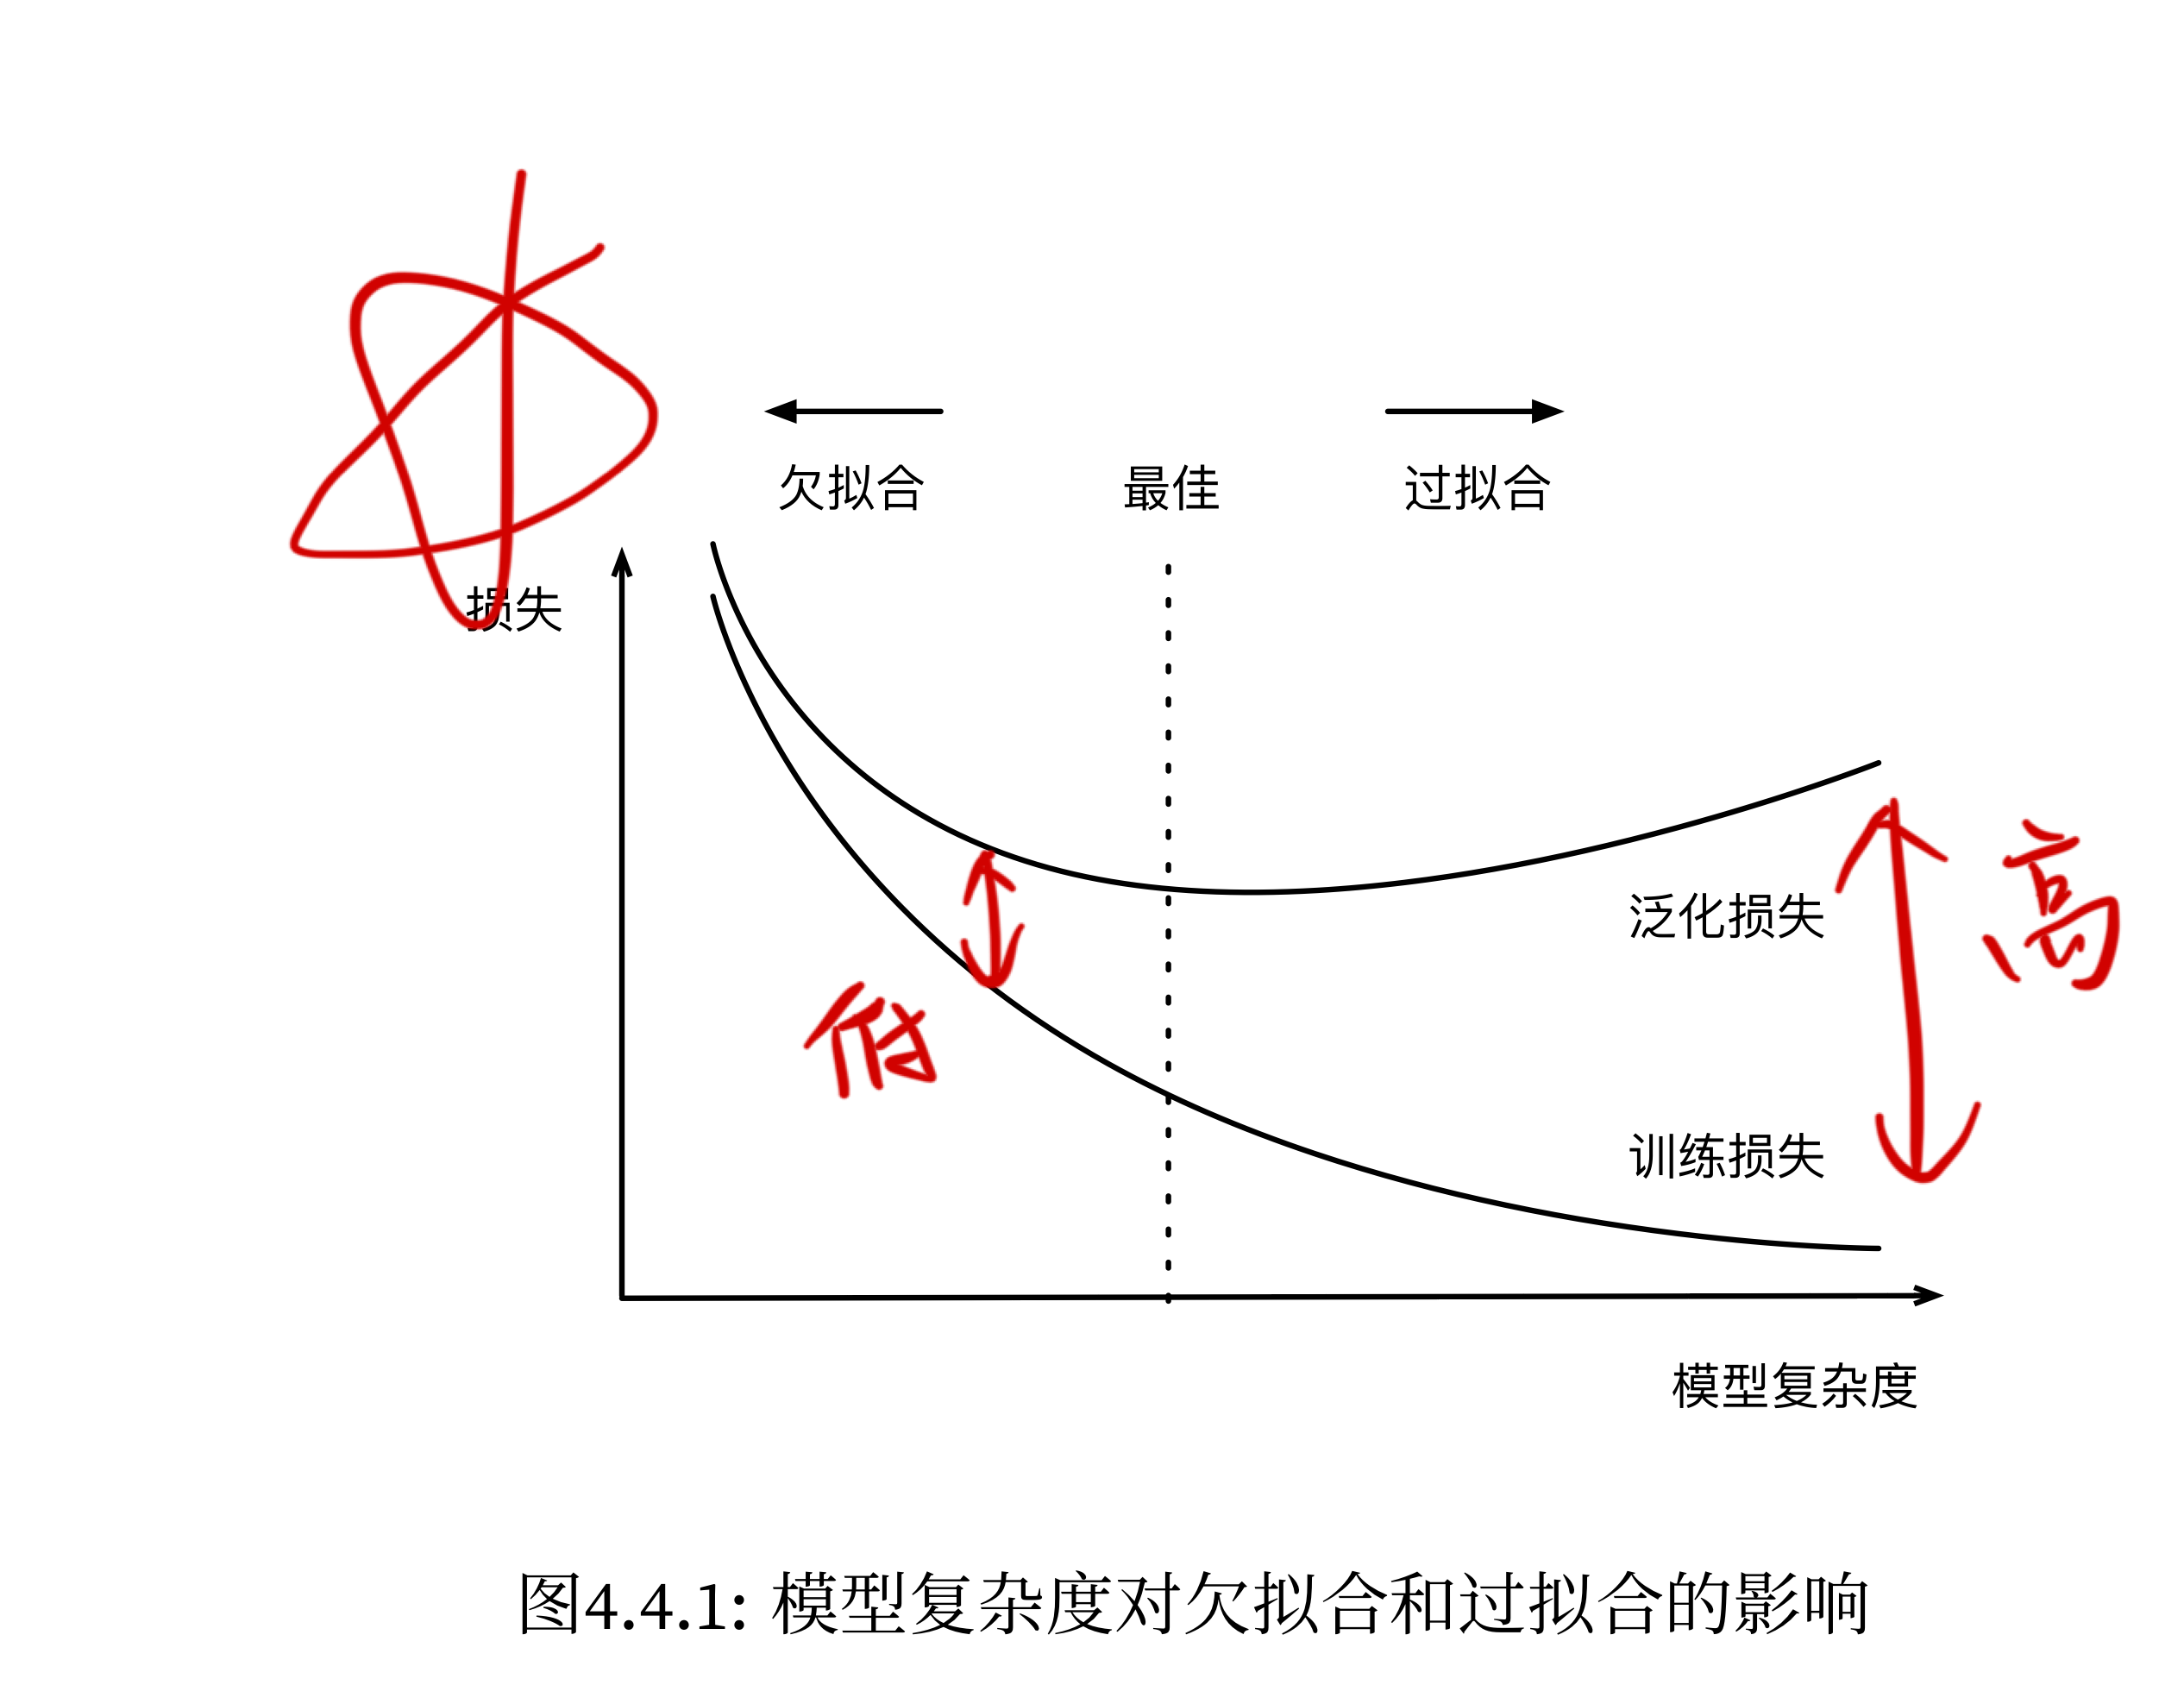
4.4. 模型选择、欠拟合和过拟合 — 动手学深度学习 2.0.0 documentation
那我们的总目标就是:根据数据集大小!!先需要保证模型容量足够大,其次再通过控制容量,使泛化loss降低
1.2. 具体而言
在李宏毅的机器学习课中也有提到:
如何选择model?如何训练?如何判断模型好坏并修改?
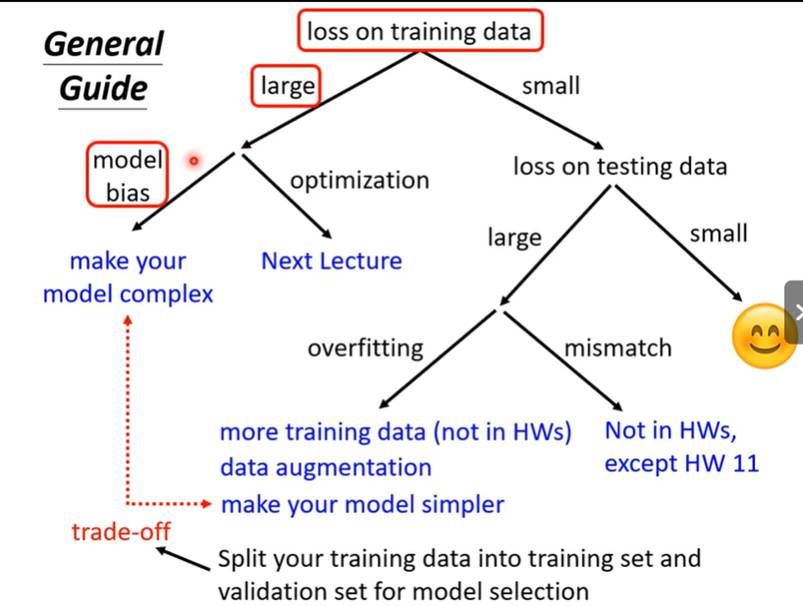
Condition1: training loss太大,不下降
如果你的trainning loss很大,说明你的模型本身有问题,都不需要看test loss
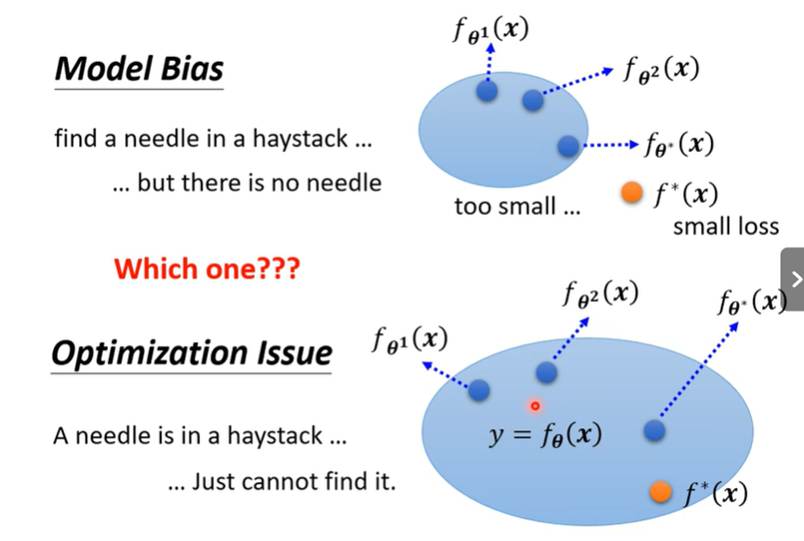
1. Model bias & optimization做的不够好
Model bias 就是你模型的弹性不够大,也就是模型太简单了,也就是前面说的容量不够大,没有办法找到那个最佳的theta。
增加模型复杂度:
根据你数据复杂度来看,1.单隐藏层m,2.多隐藏层m1>m2>m3,但是m>m1的。
因为假设你的数据较为复杂,例如input_dim=128,256…..,但是你的输出,例如分类5类,10类,或者预测,未来5步10步,相当于输入的维度远大于输出,因此压缩的过程应该是逐渐压缩的。当然后面cnn也会有先压缩再append的方法来避免过拟合。
Optimization就是模型在训练过程中未能找到最优解(如梯度下降陷入局部极小值、学习率不当等),导致训练误差和测试误差均较高
可以找一些简单的model, 如果你发现简单的模型得到的比复杂的要好,那就说明你的优化做的有问题,需要尝试一些别的方法:
• 调整优化器(如 Adam、RMSprop 替代 SGD)
• 学习率动态调整(如学习率衰减、预热策略)
• 批量归一化(BatchNorm)缓解梯度问题
• 检查梯度更新(如梯度裁剪防止爆炸)
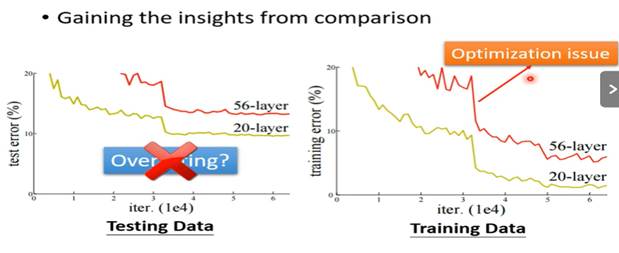
2. 注意overfitting和optimization的区别
- Overfitting(过拟合):模型在训练数据上表现很好,但在测试数据或新数据上表现较差,通常因模型过于复杂或训练数据不足导致。表现为训练误差低、测试误差高。
- Optimization Problem(优化问题):指模型在训练过程中未能找到最优解(如梯度下降陷入局部极小值、学习率不当等),导致训练误差和测试误差均较高。
根本原因
- 过拟合:模型过度记忆训练数据的噪声或细节,缺乏泛化能力。常见原因包括:
- 模型复杂度过高(如神经网络层数过多)。
- 训练数据量过少或噪声过多。
- 未使用正则化(如 L1/L2 正则、Dropout)。
- 优化问题:训练算法未能有效最小化损失函数。常见原因包括:
- 学习率设置不当(过大导致震荡,过小导致收敛慢)。
- 损失函数非凸(如神经网络中的鞍点或局部极小值)。
- 梯度消失/爆炸(常见于深层网络)
Traning loss 没问题了,再看loss on testing data
Condition 2: Small loss on training data, large loss on testing data. Why?
1.overfitting
一个简单的解释:模型使用了一个非常复杂的函数(例如一个高阶多项式,后面会有实验代码),蜿蜒曲折地穿过每一个训练数据点。它在训练数据上的损失非常小(甚至为零),但因为学到的规律不是真实规律,在新测试数据上的损失会非常大。(数学原理在后面)
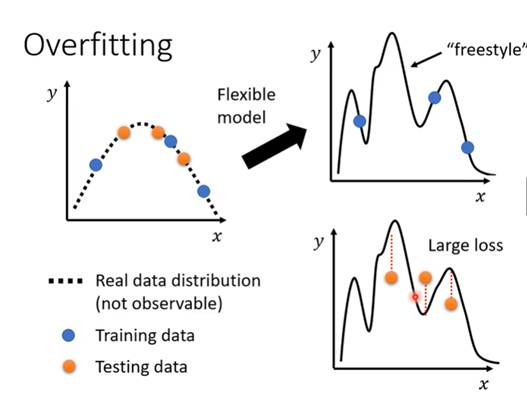
怎么解决overfitting?
- 更多数据
- 数据增强,也得根据任务判断:例如,对影视照片进行处理,可能倒着的照片不常用,那这个数据就没有意义
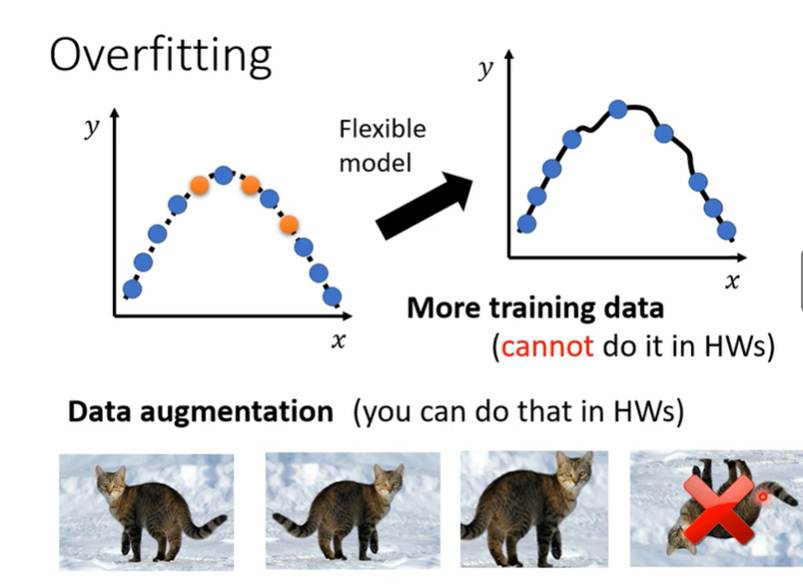
- 3. 根据你的判断,给你的model一些限制
Less parameters, sharing parameters
Less features
Early stoppingRegularization
Dropout
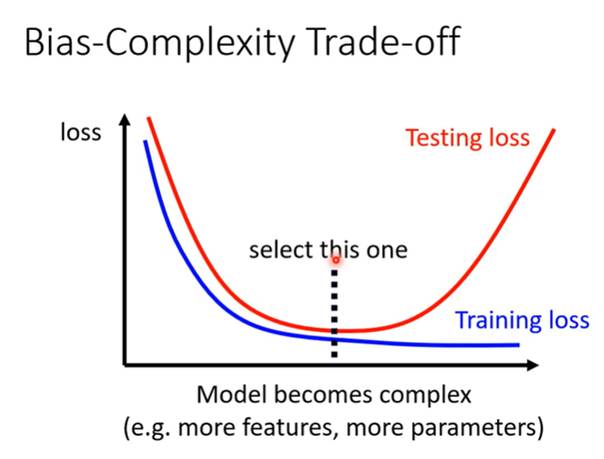
!!!!!如果给了太多constrain, 有可能有model bias,这也就是一开头说的欠拟合,看下图
1.3. 泛化性问题
那如何判断模型的好坏?简单一点来说,根据验证集上的得分来判断模型的好坏
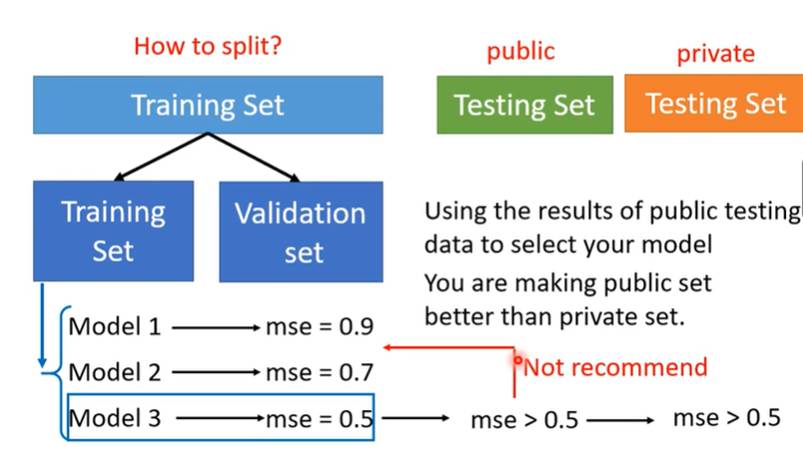
还有一个问题就是,为了泛化性,你划分的验证集的质量很重要
首先,我们要确保训练集和你的验证集的数据分布差不多,也就是我们在使用自己的数据的时候,一般需要先进行数据分析,确保训练集验证集测试集的均值,方差等等差异不是很大
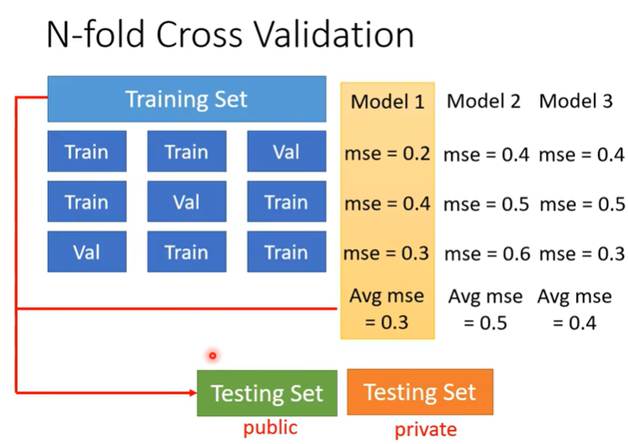
其次,再严谨一点,就是N-fold Cross Validation,又或者k折交叉检验。在论文中,我们经常能看到。
当数据稀缺时,例如几千个,我们甚至可能无法提供足够的数据来构成一个合适的验证集。 这个问题的一个流行的解决方案是采用K折交叉验证。 这里,原始训练数据被分成K个不重叠的子集。 然后执行K次模型训练和验证,每次在K−1个子集上进行训练, 并在剩余的一个子集(在该轮中没有用于训练的子集)上进行验证。 最后,通过对K次实验的结果取平均来估计训练和验证误差。
总结一下,用N-fold Cross Validation/K折交叉验证,划分训练集验证集,然后分别验证你的备选模型,最后根据平均得分,选出最佳模型
2.多项式实验
数据集:
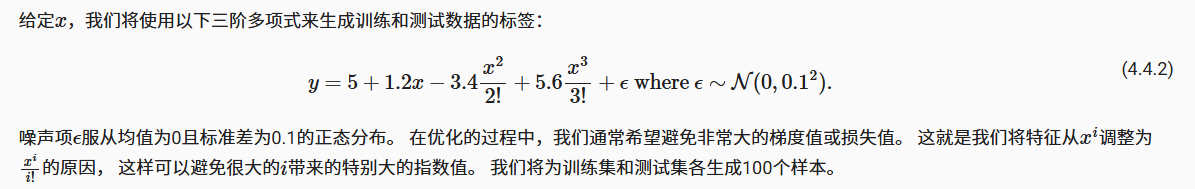
import math
import numpy as np
import torch
from torch import nn
from d2l import torch as d2l

max_degree = 100
n_train, n_test = 100, 100
true_w = np.zeros(max_degree)
true_w[0:4] = np.array([5, 1.2, -3.4, 5.6])

features = np.random.normal(size=(n_train + n_test, 1))
np.random.shuffle(features)
poly_features = np.power(features, np.arange(max_degree).reshape(1, -1))
for i in range(max_degree):
    poly_features[:, i] /= math.gamma(i + 1)
labels = np.dot(poly_features, true_w)
labels += np.random.normal(scale=0.1, size=labels.shape)

# ndarray转化成tensor
true_w, features, poly_features, labels = [torch.tensor(x, dtype=torch.float32) for x in [true_w, features, poly_features, labels]]

def evaluate_loss(net, data_iter, loss):
    """评估模型在给定数据集的损失"""
    metric = d2l.Accumulator(2)
    for X, y in data_iter:
        y_hat = net(X)
        y = y.reshape(y_hat.shape)
        l = loss(y_hat, y)
        metric.add(l.sum(), l.numel())  # l.sum() 返回一个标量
    return metric[0] / metric[1]

def train_epoch(net, train_iter, loss, trainer):
    net.train()
    for X, y in train_iter:
        y_hat = net(X)
        l = loss(y_hat, y)
        trainer.zero_grad()
        l.mean().backward()# 或 l.sum(),确保 l 是标量
        trainer.step()

def train(train_features, test_features, train_labels, test_labels, num_epochs):
    input_shape = train_features.shape[-1]
    net = nn.Sequential(
        nn.Linear(input_shape, 1, bias=False)
    )
    loss = nn.MSELoss(reduction='none')  # 保持 reduction='none',稍后计算均值
    batch_size = min(16, train_labels.shape[0])
    train_iter = d2l.load_array((train_features, train_labels.reshape(-1, 1)), batch_size)
    test_iter = d2l.load_array((test_features, test_labels.reshape(-1, 1)), batch_size, is_train=False)
    trainer = torch.optim.SGD(net.parameters(), lr=0.01)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss', yscale='log',
                           xlim=[1, num_epochs], ylim=[1e-3, 1e2], legend=['train', 'test'])
    for epoch in range(num_epochs):
        train_epoch(net, train_iter, loss, trainer)
        if epoch == 0 or (epoch + 1) % 20 == 0:
            train_loss = evaluate_loss(net, train_iter, loss)
            test_loss = evaluate_loss(net, test_iter, loss)
            animator.add(epoch + 1, (train_loss, test_loss))
    print('w:', net[0].weight.data.numpy())
代码参考:4.4. 模型选择、欠拟合和过拟合 — 动手学深度学习 2.0.0 documentation
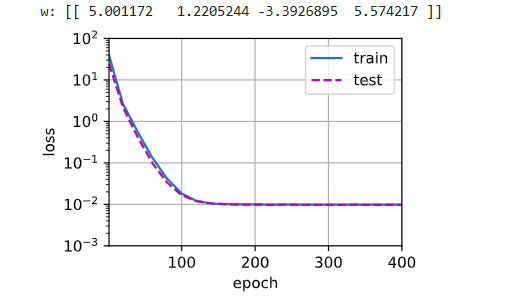
2.1. 三项多项式(正常拟合)
# 训练模型,使用前4个多项式特征,1,x,x^2,x^3
train(poly_features[:n_train, :4], poly_features[n_train:, :4],
      labels[:n_train], labels[n_train:],
      num_epochs=400)
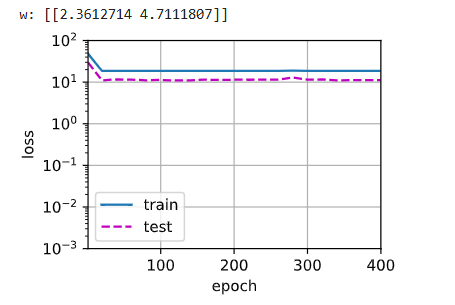
2.2. 线性欠拟合
# 训练模型,线性,1,x
train(poly_features[:n_train,:2],poly_features[n_train:,:2],
      labels[:n_train],labels[n_train:],
      num_epochs = 400
     )
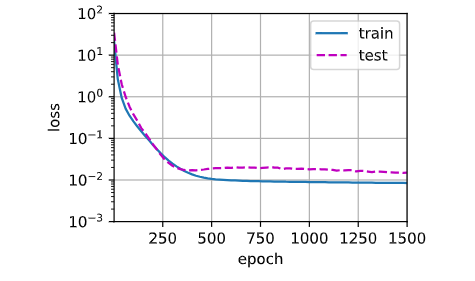
2.3. 高阶过拟合
数据太少,模型太复杂
我这里把max_degres=100才看到了过拟合,也就是x^99
train(poly_features[:n_train,:],poly_features[n_train:,:],
      labels[:n_train],labels[n_train:],
      num_epochs = 1500
     )
2.4. 思考
2.4.1. 如果不对多项式特征进行标准化,会发生什么事情?能用其他方法解决这个问题吗?
如果不进行标准化,那么如果|x|>1,对于与高阶x相乘的wi来说,梯度就会很大。
假设我们的模型是:
损失函数:
梯度计算:
# 假设特征 x 在 [-2, 2] 范围内
x = 1.5
# 多项式特征:
x^0 = 1
x^1 = 1.5
x^2 = 2.25
x^3 = 3.375
x^10 = 57.67
x^11 = 86.50
x^15 = 437.89
# 可以看到,高次项的值会急剧增大,导致梯度爆炸!
梯度爆炸的连锁反应
# 假设:
x = 1.5
error = 0.1
grad_w15 = error * (1.5**15)  # 0.1 * 437.89 ≈ 43.79

# 学习率 lr = 0.01
w15_update = -lr * grad_w15  # -0.01 * 43.79 = -0.4379

# 一次更新就改变了 0.44!这太大了!
# 对比 w1:
grad_w1 = error * 1.5  # 0.15
w1_update = -0.01 * 0.15 = -0.0015
导致的问题:
1. 更新不稳定:高次项权重更新太大,低次项更新太小
2. 权重震荡:权重来回剧烈变化
3. 难以收敛:损失函数值剧烈震荡
4. 数值溢出:可能产生 NaN 或 Inf
2.4.2. 如何解决?
1.特征缩放
标准化到 [-1, 1] 范围(一般必做)
2.权重衰减(L2正则化)
# 在优化器中添加权重衰减
trainer = torch.optim.SGD(net.parameters(), lr=0.01, weight_decay=0.01)
# 这会惩罚大权重,防止梯度爆炸
3.梯度裁剪(Gradient Clipping)
def train_epoch_with_clipping(net, train_iter, loss, trainer, clip_value=1.0):
    net.train()
    for X, y in train_iter:
        y_hat = net(X)
        l = loss(y_hat, y).mean()

        trainer.zero_grad()
        l.backward()

        # 梯度裁剪
        torch.nn.utils.clip_grad_norm_(net.parameters(), clip_value)

trainer.step()4.自适应优化器
# 使用 Adam 等自适应优化器
trainer = torch.optim.Adam(net.parameters(), lr=0.01)
# Adam 会为每个参数自适应调整学习率5.学习率调度
trainer = torch.optim.SGD(net.parameters(), lr=0.1)
scheduler = torch.optim.lr_scheduler.StepLR(trainer, step_size=30, gamma=0.1)

for epoch in range(num_epochs):
    train_epoch(...)
    scheduler.step()  # 逐渐减小学习率
3.报错记录
RuntimeError: grad can be implicitly created only for scalar outputs
原因:损失 l 不是一个标量(scalar),而是一个张量。当调用 l.backward() 时,需要确保 l 是一个标量。你需要对损失进行平均或求和来得到一个标量值。
更多推荐


 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)