
Flink安装与入门
- Flink概述
- Flink的引入
这几年大数据的飞速发展,出现了很多热门的开源社区,其中著名的有Hadoop、Storm,以及后来的Spark,他们都有着各自专注的应用场景。Spark 掀开了内存计算的先河,也以内存为赌注,赢得了内存计算的飞速发展。Spark 的火热或多或少的掩盖了其他分布式计算的系统身影。就像 Flink,也就在这个时候默默的发展着。
在国外一些社区,有很多人将大数据的计算引擎分成了4 代,当然,也有很多人不会认同。我们先姑且这么认为和讨论。
l 第1代——Hadoop MapReduce
首先第一代的计算引擎,无疑就是Hadoop 承载的 MapReduce。它将计算分为两个阶段,分别为 Map 和 Reduce。对于上层应用来说,就不得不想方设法去拆分算法,甚至于不得不在上层应用实现多个 Job 的串联,以完成一个完整的算法
l 第2代——DAG框架(Tez) + MapReduce
由于这样的弊端,催生了支持DAG 框架的产生。因此,支持 DAG 的框架被划分为第二代计算引擎。如 Tez 以及更上层的 Oozie。这里我们不去细究各种 DAG 实现之间的区别,不过对于当时的 Tez 和 Oozie 来说,大多还是批处理的任务
l 第3代——Spark
接下来就是以Spark 为代表的第三代的计算引擎。第三代计算引擎的特点主要是 Job 内部的 DAG 支持(不跨越 Job),以及强调的实时计算。在这里,很多人也会认为第三代计算引擎也能够很好的运行批处理的 Job。
l 第4代——Flink
实时即未来!
随着第三代计算引擎的出现,促进了上层应用快速发展,例如各种迭代计算的性能以及对流计算和SQL 等的支持。Flink 的诞生就被归在了第四代。这应该主要表现在 Flink 对流计算的支持,以及更一步的实时性上面。当然 Flink 也可以支持 Batch 的任务,以及 DAG 的运算。
批处理、流处理、SQL高层API支持自带DAG流式计算性能更高、可靠性更高
-
- Flink发展史
Flink诞生背景
Flink起源于Stratosphere项目,Stratosphere是在2010~2014年由地处柏林的大学和欧洲的一些其他的大学共同进行的研究项目。
2014年4月捐赠给了Apache软件基金会
2014年12月成为Apache软件基金会的顶级项目。
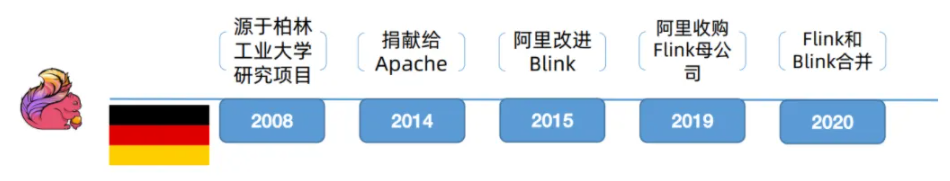
l 2008年,Flink 的前身已经是柏林理工大学一个研究性项目,原名 StratoSphere。
l 2014-04-16,Flink成为 ASF(Apache Software Foundation)的顶级项目之一,从Stratosphere 0.6开始,正式更名为Flink。由Java语言编写;
l 2014-11-04,Flink 0.7.0发布,介绍了最重要的特性:Streaming API
l 2016-03-08,Flink 1.0.0,支持 Scala
l 2019-01-08,阿里巴巴以9000万欧元的价格收购了总部位于柏林的初创公司Data Artisans,也就是Flink的母公司。
LOGO介绍:
在德语中,Flink一词表示快速和灵巧,项目采用松鼠的彩色图案作为logo,Flink的松鼠logo尾巴的颜色与Apache软件基金会的logo颜色相呼应,也就是说,这是一只Apache风格的松鼠。
-
- Flink官方介绍
官网:https://flink.apache.org/zh/
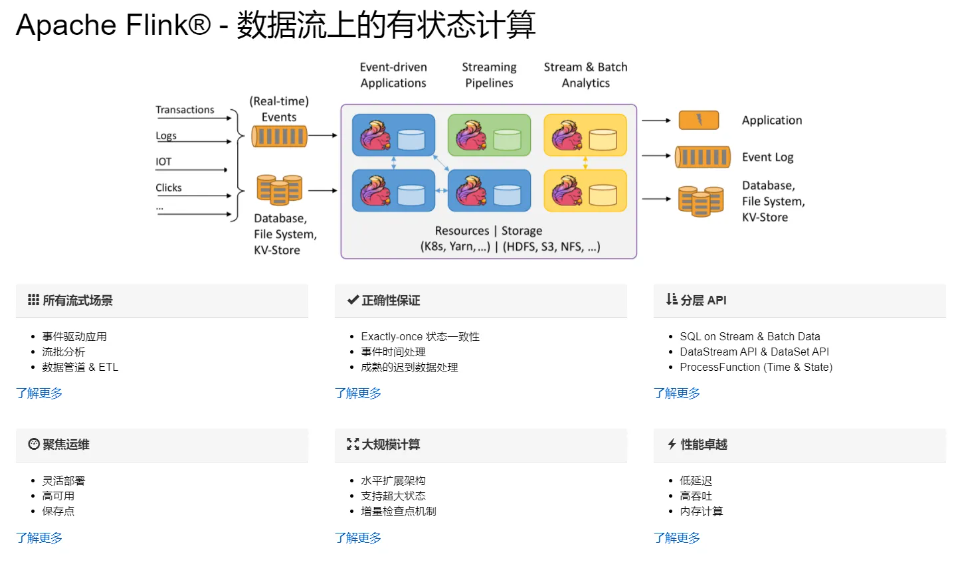
Flink主页在其顶部展示了该项目的理念:“Apache Flink是为分布式、高性能、随时可用以及准确的流处理应用程序打造的开源流处理框架”。
Flink是一款分布式的计算引擎,它可以用来做流处理;也可以用来做批处理。
-
- 编程语言
Flink官方提供了Java、Scala、Python语言接口用以开发Flink应用程序,但是Flink的源码是使用Java语言进行开发的,且Flink被阿里收购后,未来的主要编程语言都一直会是Java(因为阿里是Java重度使用者!),且GitHub上关于Flink的项目,大多数是使用Java语言编写的。
https://nightlies.apache.org/flink/flink-docs-release-1.17/zh/
https://github.com/search?q=Flink
-
- FLink外传
随着人工智能时代的降临,数据量的爆发,在典型的大数据的业务场景下数据业务最通用的做法是:选用批处理的技术处理全量数据,采用流式计算处理实时增量数据。在绝大多数的业务场景之下,用户的业务逻辑在批处理和流处理之中往往是相同的。但是,用户用于批处理和流处理的两套计算引擎是不同的。因此,用户通常需要写两套代码。毫无疑问,这带来了一些额外的负担和成本。阿里巴巴的商品数据处理就经常需要面对增量和全量两套不同的业务流程问题,所以阿里就在想,我们能不能有一套统一的大数据引擎技术,用户只需要根据自己的业务逻辑开发一套代码。这样在各种不同的场景下,不管是全量数据还是增量数据,亦或者实时处理,一套方案即可全部支持,这就是阿里选择 Flink 的背景和初衷。
2015 年阿里巴巴开始使用 Flink 并持续贡献社区(阿里内部还基于Flink做了一套Blink),2019年1月8日,阿里巴巴以 9000 万欧元(7亿元人民币)收购了创业公司 Data Artisans。从此Flink开始了新一轮的乘风破浪!
-
- Flink中的批和流
批处理的特点是有界、持久、大量,非常适合需要访问全部记录才能完成的计算工作,一般用于离线统计。
流处理的特点是无界、实时, 无需针对整个数据集执行操作,而是对通过系统 传输的每个数据项执行操作,一般用于实时统计。
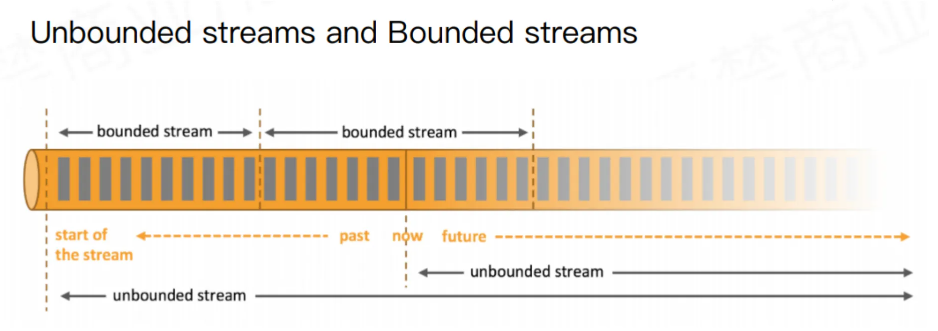
而在Flink中,一切都是由流组成的,Flink认为有界数据集是无界数据流的一种特例,离线数据是有界限的流,实时数据是一个没有界限的流,这就是所谓的有界流和无界流。
无界流:意思很明显,只有开始没有结束。必须连续的处理无界流数据,也即是在事件注入之后立即要对其进行处理。不能等待数据到达了再去全部处理,因为数据是无界的并且永远不会结束数据注入。处理无界流数据往往要求事件注入的时候有一定的顺序性,例如可以以事件产生的顺序注入,这样会使得处理结果完整。
有界流:也即是有明确的开始和结束的定义。有界流可以等待数据全部注入完成了再开始处理。注入的顺序不是必须的了,因为对于一个静态的数据集,我们是可以对其进行排序的。有界流的处理也可以称为批处理。
-
- 性能比较
Spark和Flink全部都运行在Hadoop YARN上,性能为Flink > Spark > Hadoop(MR),迭代次数(数据量)越多越明显,性能上,Flink优于Spark和Hadoop最主要的原因是Flink支持增量迭代,具有对迭代自动优化的功能。
-
- Flink的应用场景
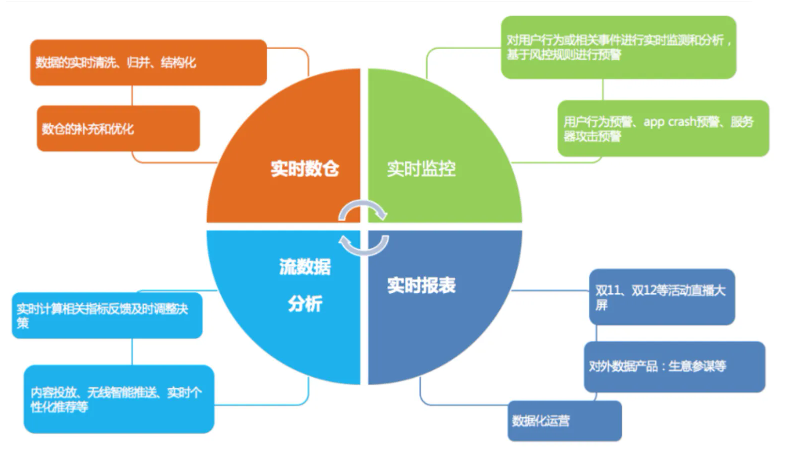
可以看到,各种行业的众多公司都在使用Flink。具体来看,一些行业中的典型应用有:
- 电商和市场营销
举例:实时数据报表、广告投放、实时推荐
- 物联网(IOT)
举例:传感器实时数据采集和显示、实时报警,交通运输业
- 物流配送和服务业
举例:订单状态实时更新、通知信息推送。
- 银行和金融业
举例:实时结算和通知推送,实时检测异常行为。
-
- 其他
Flink 是目前开源社区中唯一一套集高吞吐、低延迟、高性能三者于一身的分布式流式数据处理框架。
Spark 只能兼顾高吞吐和高性能特性,无法做到低延迟保障,因为Spark是用批处理来做流处理。
Storm 只能支持低延时和高性能特性,无法满足高吞吐的要求。
- Flink入门示例
- 集群角色
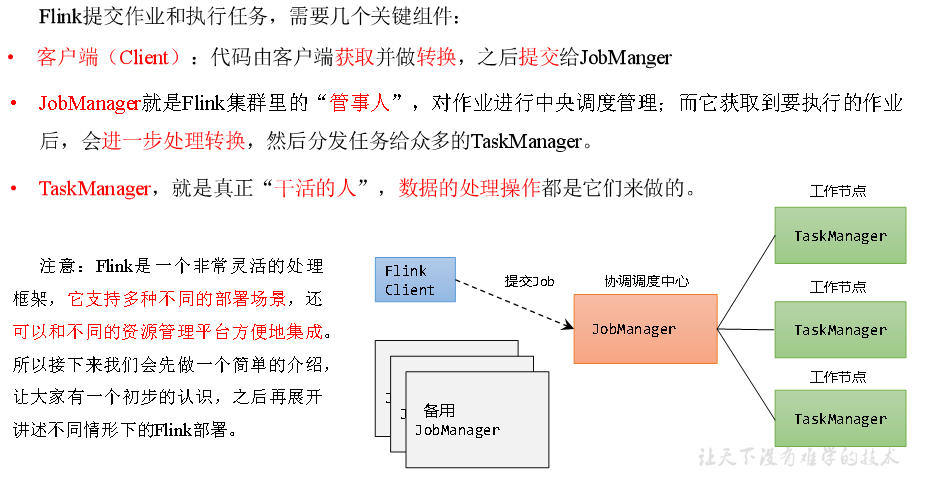
-
- 部署模式
在一些应用场景中,对于集群资源分配和占用的方式,可能会有特定的需求。Flink为各种场景提供了不同的部署模式,主要有以下三种:会话模式(Session Mode)、单作业模式(Per-Job Mode)、应用模式(Application Mode)。
它们的区别主要在于:集群的生命周期以及资源的分配方式;以及应用的main方法到底在哪里执行——客户端(Client)还是JobManager。
-
- 集群安装方式
- Standalone运行模式
- 集群安装方式
独立模式是独立运行的,不依赖任何外部的资源管理平台;当然独立也是有代价的:如果资源不足,或者出现故障,没有自动扩展或重分配资源的保证,必须手动处理。所以独立模式一般只用在开发测试或作业非常少的场景下。
-
-
- YARN运行模式
-
YARN上部署的过程是:客户端把Flink应用提交给Yarn的ResourceManager,Yarn的ResourceManager会向Yarn的NodeManager申请容器。在这些容器上,Flink会部署JobManager和TaskManager的实例,从而启动集群。Flink会根据运行在JobManger上的作业所需要的Slot数量动态分配TaskManager资源。
-
-
- K8S 运行模式
-
容器化部署是如今业界流行的一项技术,基于Docker镜像运行能够让用户更加方便地对应用进行管理和运维。容器管理工具中最为流行的就是Kubernetes(k8s),而Flink也在最近的版本中支持了k8s部署模式。基本原理与YARN是类似的,具体配置可以参见官网说明,这里我们就不做过多讲解了。
-
- Standalone集群安装
https://nightlies.apache.org/flink/flink-docs-release-2.0/zh/docs/try-flink/local_installation/
接着我们以 flink1.17 为例,进行安装:
1.17 版本的安装 jdk 可以使用 jdk1.8 还可以使用 jdk11 ,不要使用 jdk17
| 节点服务器 | bigdata01 | bigdata02 | bigdata03 |
| 角色 | JobManager TaskManager | TaskManager | TaskManager |
具体安装部署步骤如下:
- 下载并解压安装包
- (1)下载安装包flink-1.17.0-bin-scala_2.12.tgz,将该jar包上传到 bigdata01 节点服务器的/opt/modules/ 路径上。
- (2)在/opt/modules路径上解压flink-1.17.0-bin-scala_2.12.tgz到/opt/installs 路径上。
tar -zxvf flink-1.17.0-bin-scala_2.12.tgz -C /opt/installs/
cd /opt/installs/
重命名为flink
mv flink-1.17.0/ flink
- 修改集群配置
- (1)进入conf路径,修改flink-conf.yaml文件,指定bigdata01节点服务器为JobManager
vim flink-conf.yaml
修改如下内容:
# JobManager节点地址.
jobmanager.rpc.address: bigdata01
jobmanager.bind-host: 0.0.0.0
rest.address: bigdata01
rest.bind-address: 0.0.0.0
# TaskManager节点地址.需要配置为当前机器名
taskmanager.bind-host: 0.0.0.0
taskmanager.host: bigdata01
- (2)修改workers文件,指定bigdata01、bigdata02 和bigdata03 为TaskManager
vim workers
修改如下内容:
bigdata01
bigdata02
bigdata03
- (3)修改masters文件
vim masters
修改如下内容:
bigdata01:8081
- (4)另外,在flink-conf.yaml文件中还可以对集群中的JobManager和TaskManager组件进行优化配置,主要配置项如下:
jobmanager.memory.process.size:对JobManager进程可使用到的全部内存进行配置,包括JVM元空间和其他开销,默认为1600M,可以根据集群规模进行适当调整。
taskmanager.memory.process.size:对TaskManager进程可使用到的全部内存进行配置,包括JVM元空间和其他开销,默认为1728M,可以根据集群规模进行适当调整。
taskmanager.numberOfTaskSlots:对每个TaskManager能够分配的Slot数量进行配置,默认为1,可根据TaskManager所在的机器能够提供给Flink的CPU数量决定。所谓Slot就是TaskManager中具体运行一个任务所分配的计算资源。
parallelism.default:Flink任务执行的并行度,默认为1。优先级低于代码中进行的并行度配置和任务提交时使用参数指定的并行度数量。
- 分发安装目录
- (1)配置修改完毕后,将Flink安装目录发给另外两个节点服务器。
- (2)修改 bigdata02 的taskmanager.host
vim flink-conf.yaml
修改如下内容:
# TaskManager节点地址.需要配置为当前机器名
taskmanager.host: bigdata02
- (3)修改bigdata03 的taskmanager.host
vim flink-conf.yaml
修改如下内容:
# TaskManager节点地址.需要配置为当前机器名
taskmanager.host: bigdata03
- (4)配置环境变量
export FLINK_HOME=/opt/installs/flink
export PATH=$PATH:$FLINK_HOME/bin
同步环境变量:
xsync.sh /etc/profile
记得三台刷新环境变量
- 启动集群
- (1)在bigdata01节点服务器上执行start-cluster.sh启动Flink集群:
https://start-cluster.sh
- (2)查看进程情况:jps
=============== bigdata01 ===============
4453 StandaloneSessionClusterEntrypoint
4458 TaskManagerRunner
4533 Jps
=============== bigdata02 ===============
2872 TaskManagerRunner
2941 Jps
=============== bigdata03 ===============
2948 Jps
2876 TaskManagerRunner
-
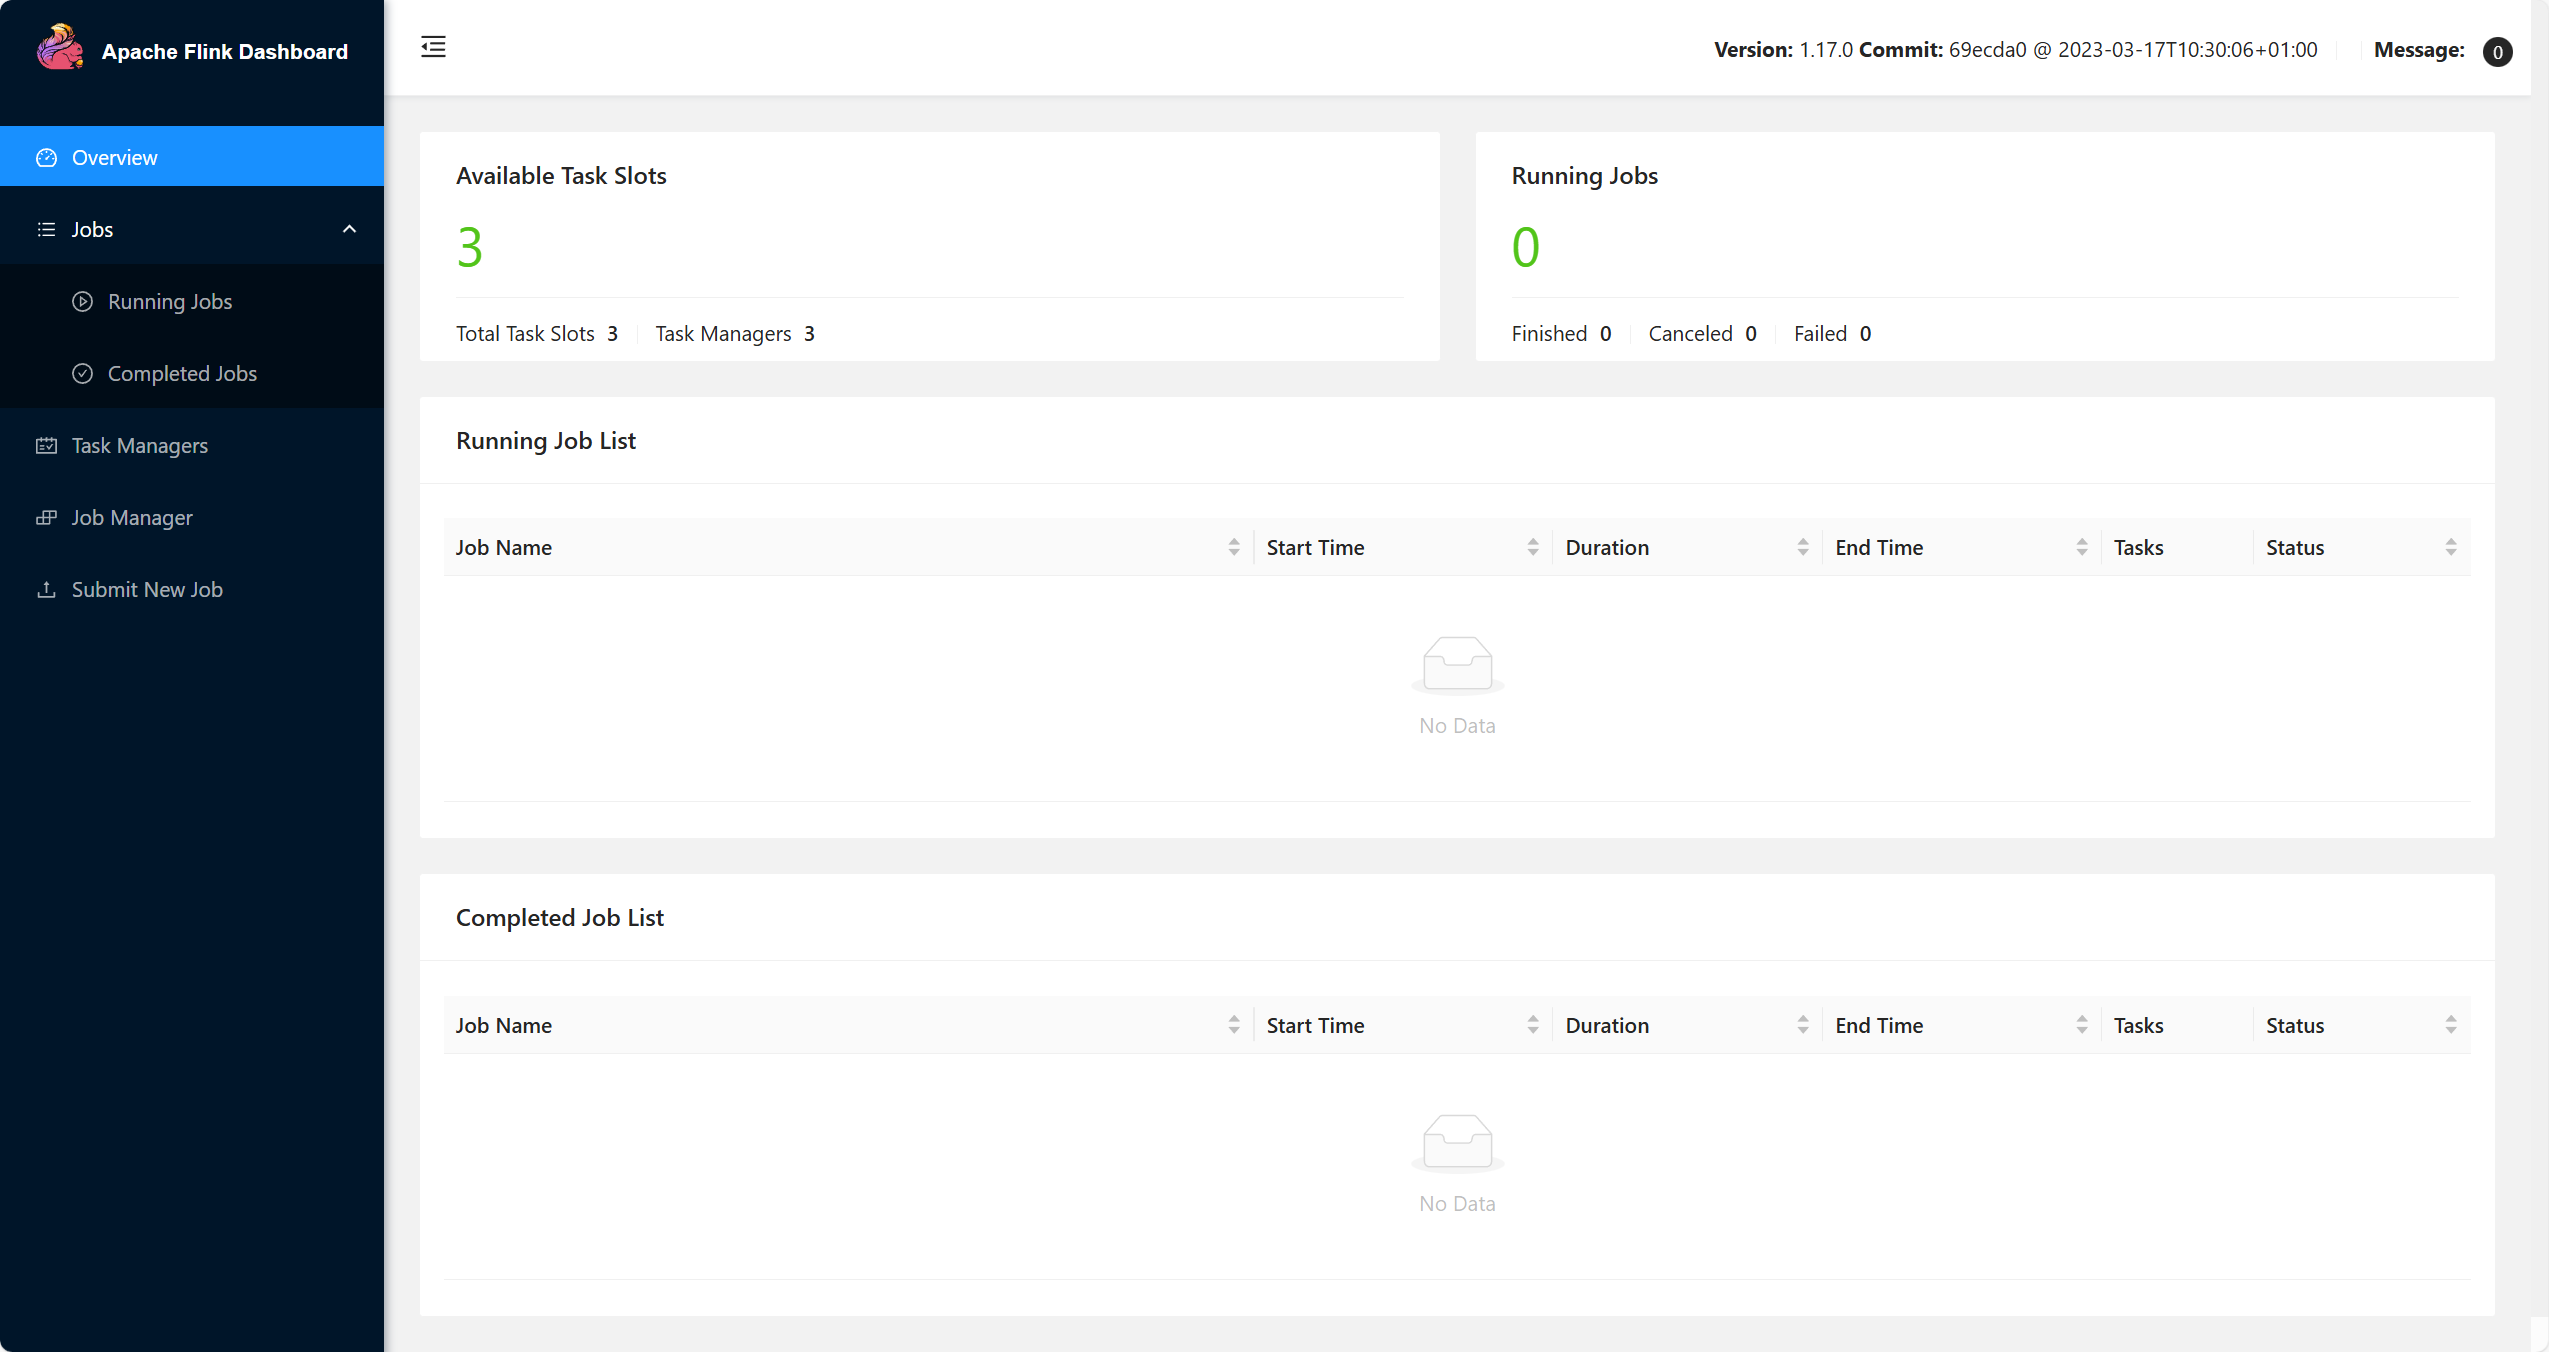
- 观察webUI
http://bigdata01:8081 -- Flink集群管理界面
-
- 提交提交作业
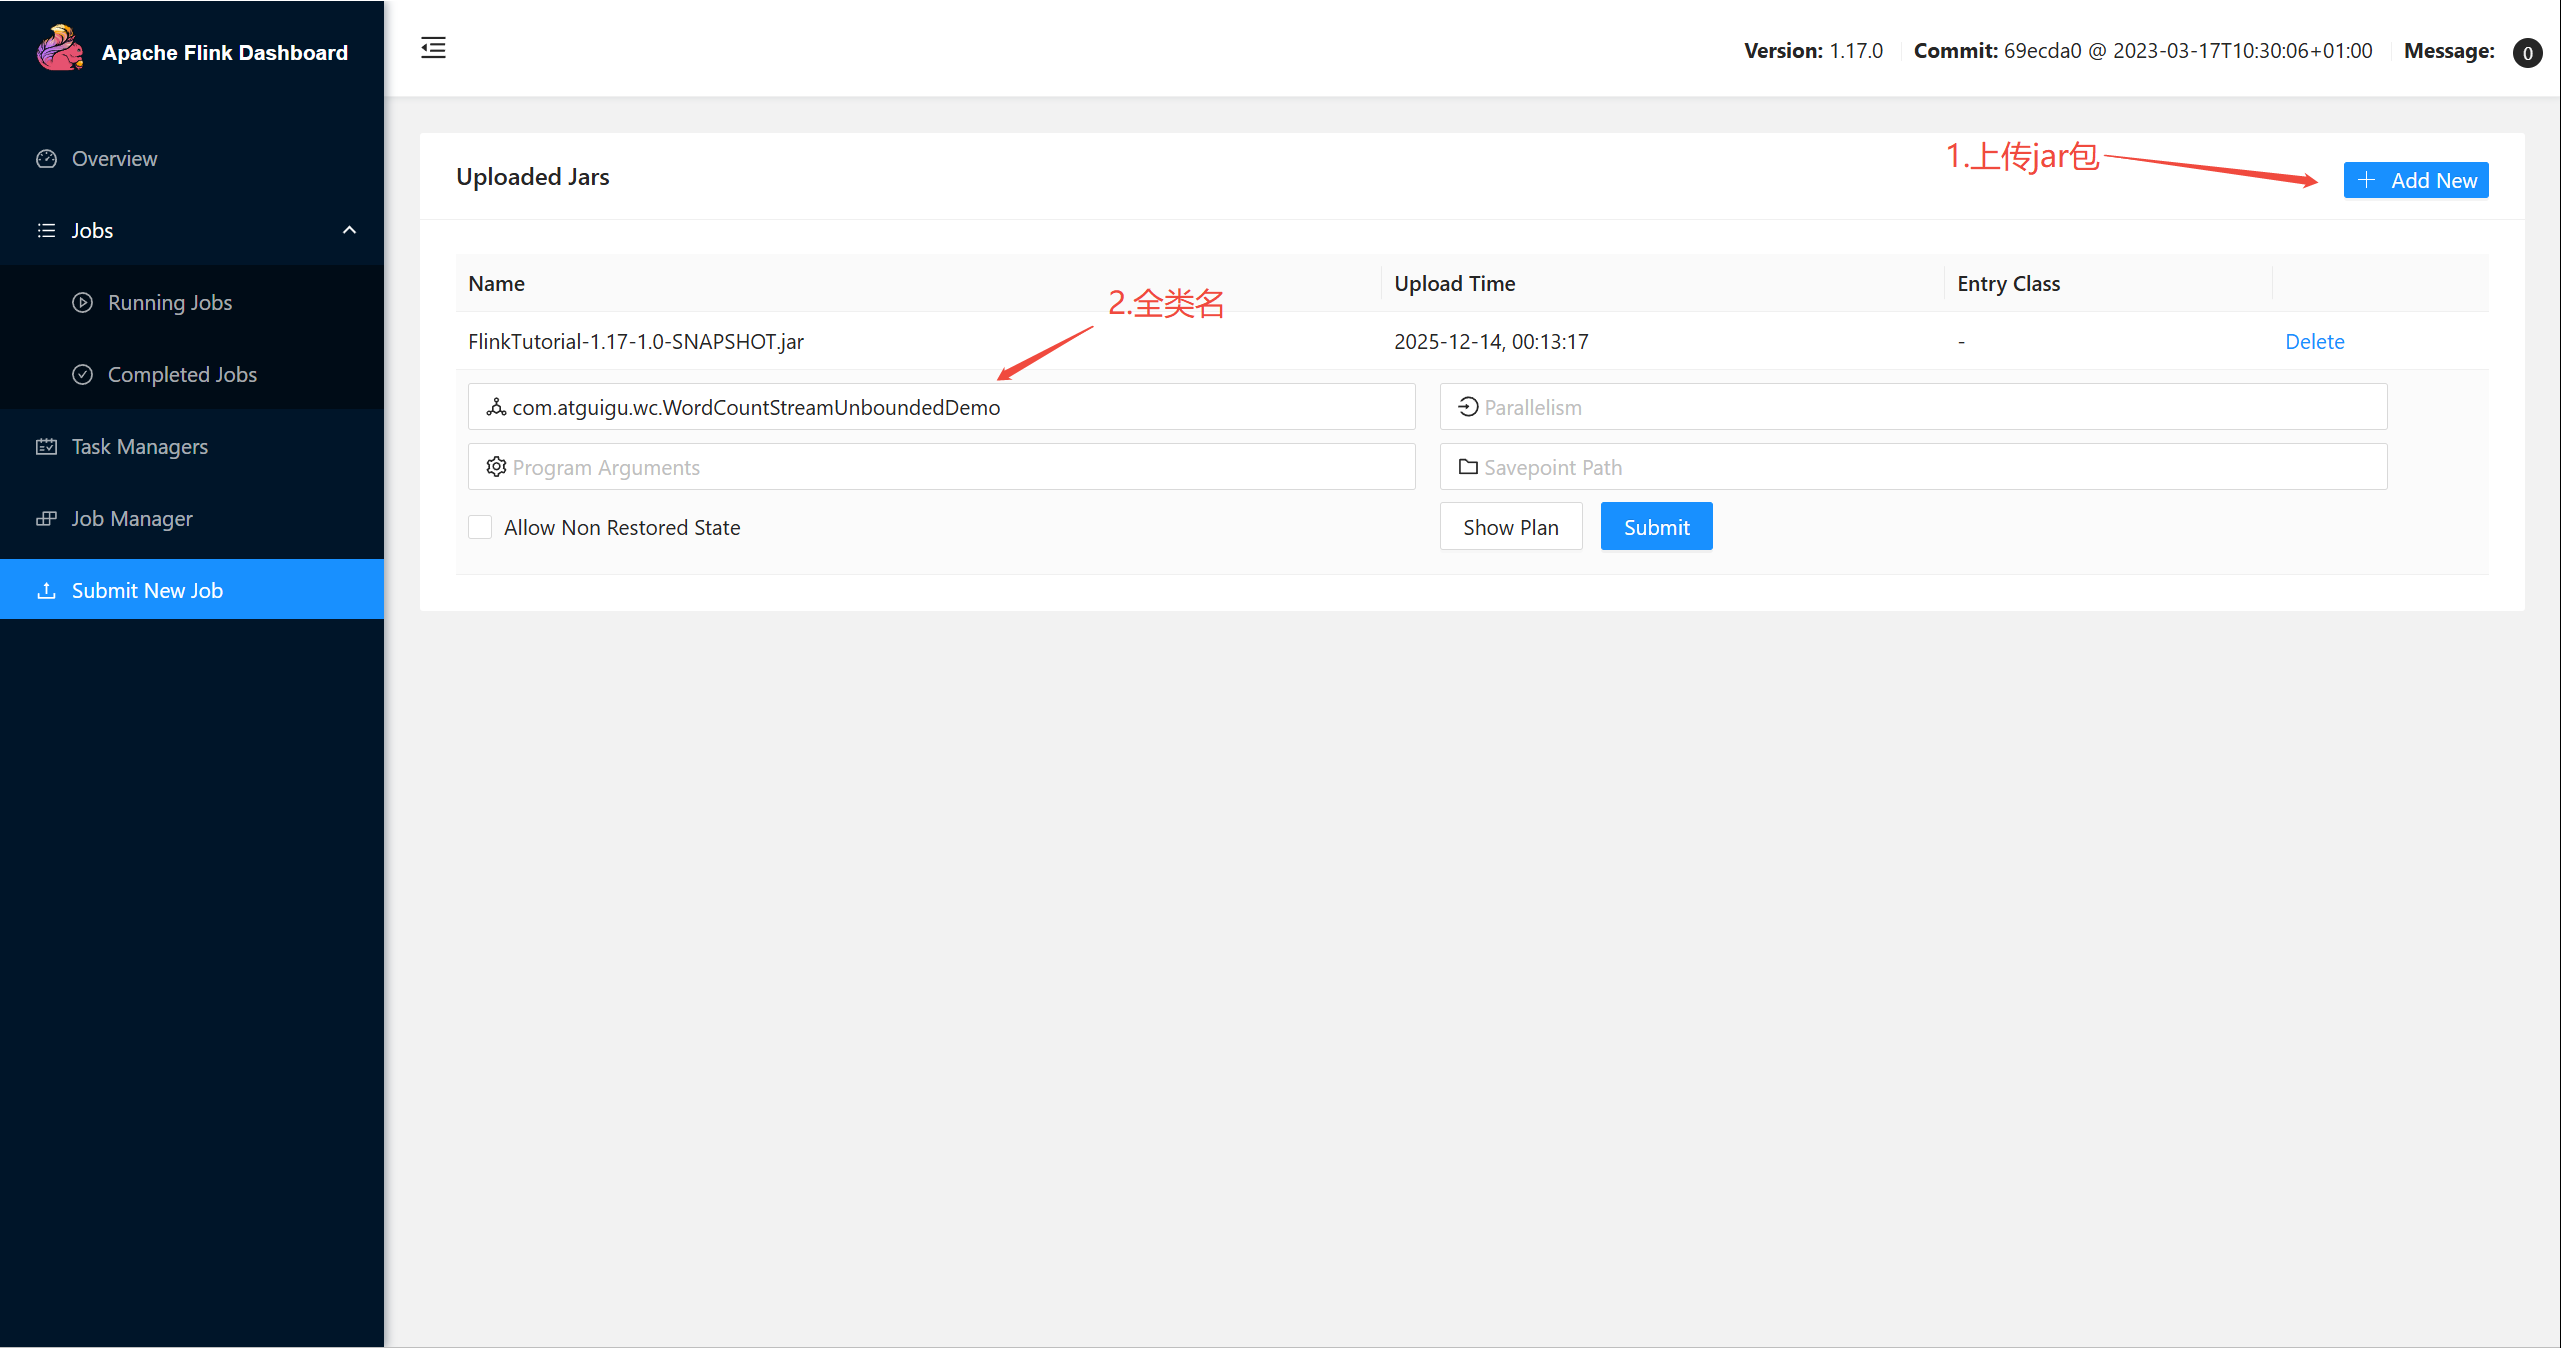
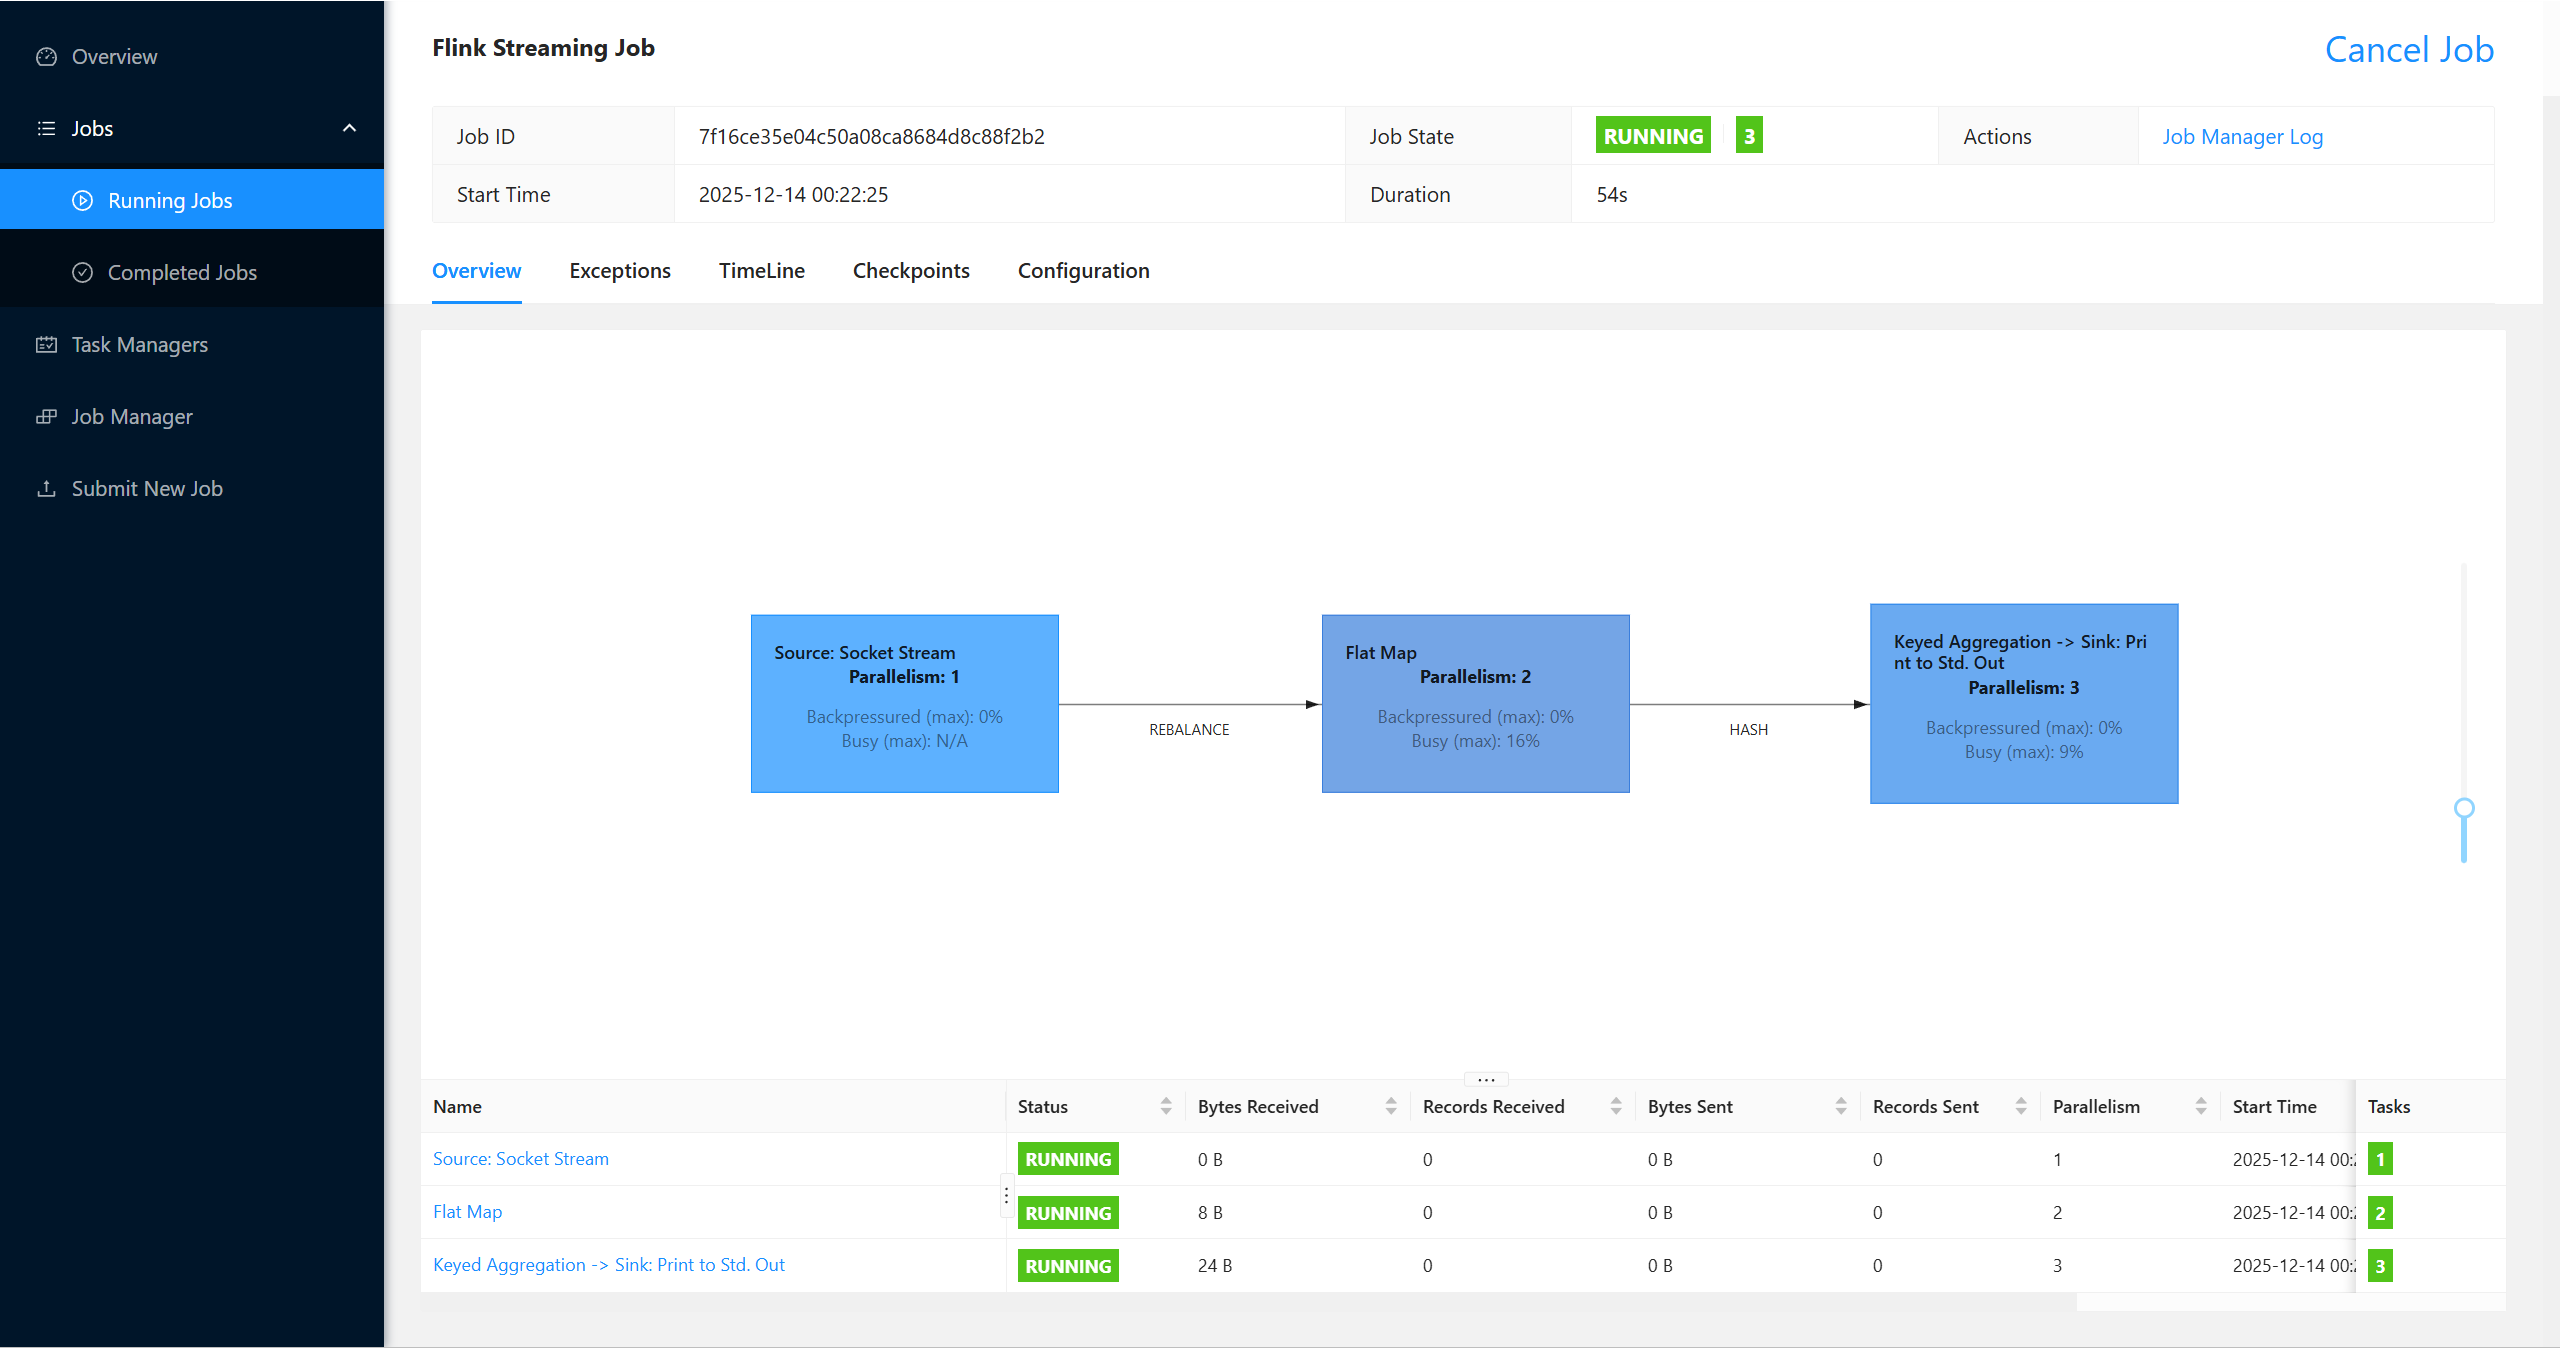
- webUI提交提交作业
- 提交提交作业
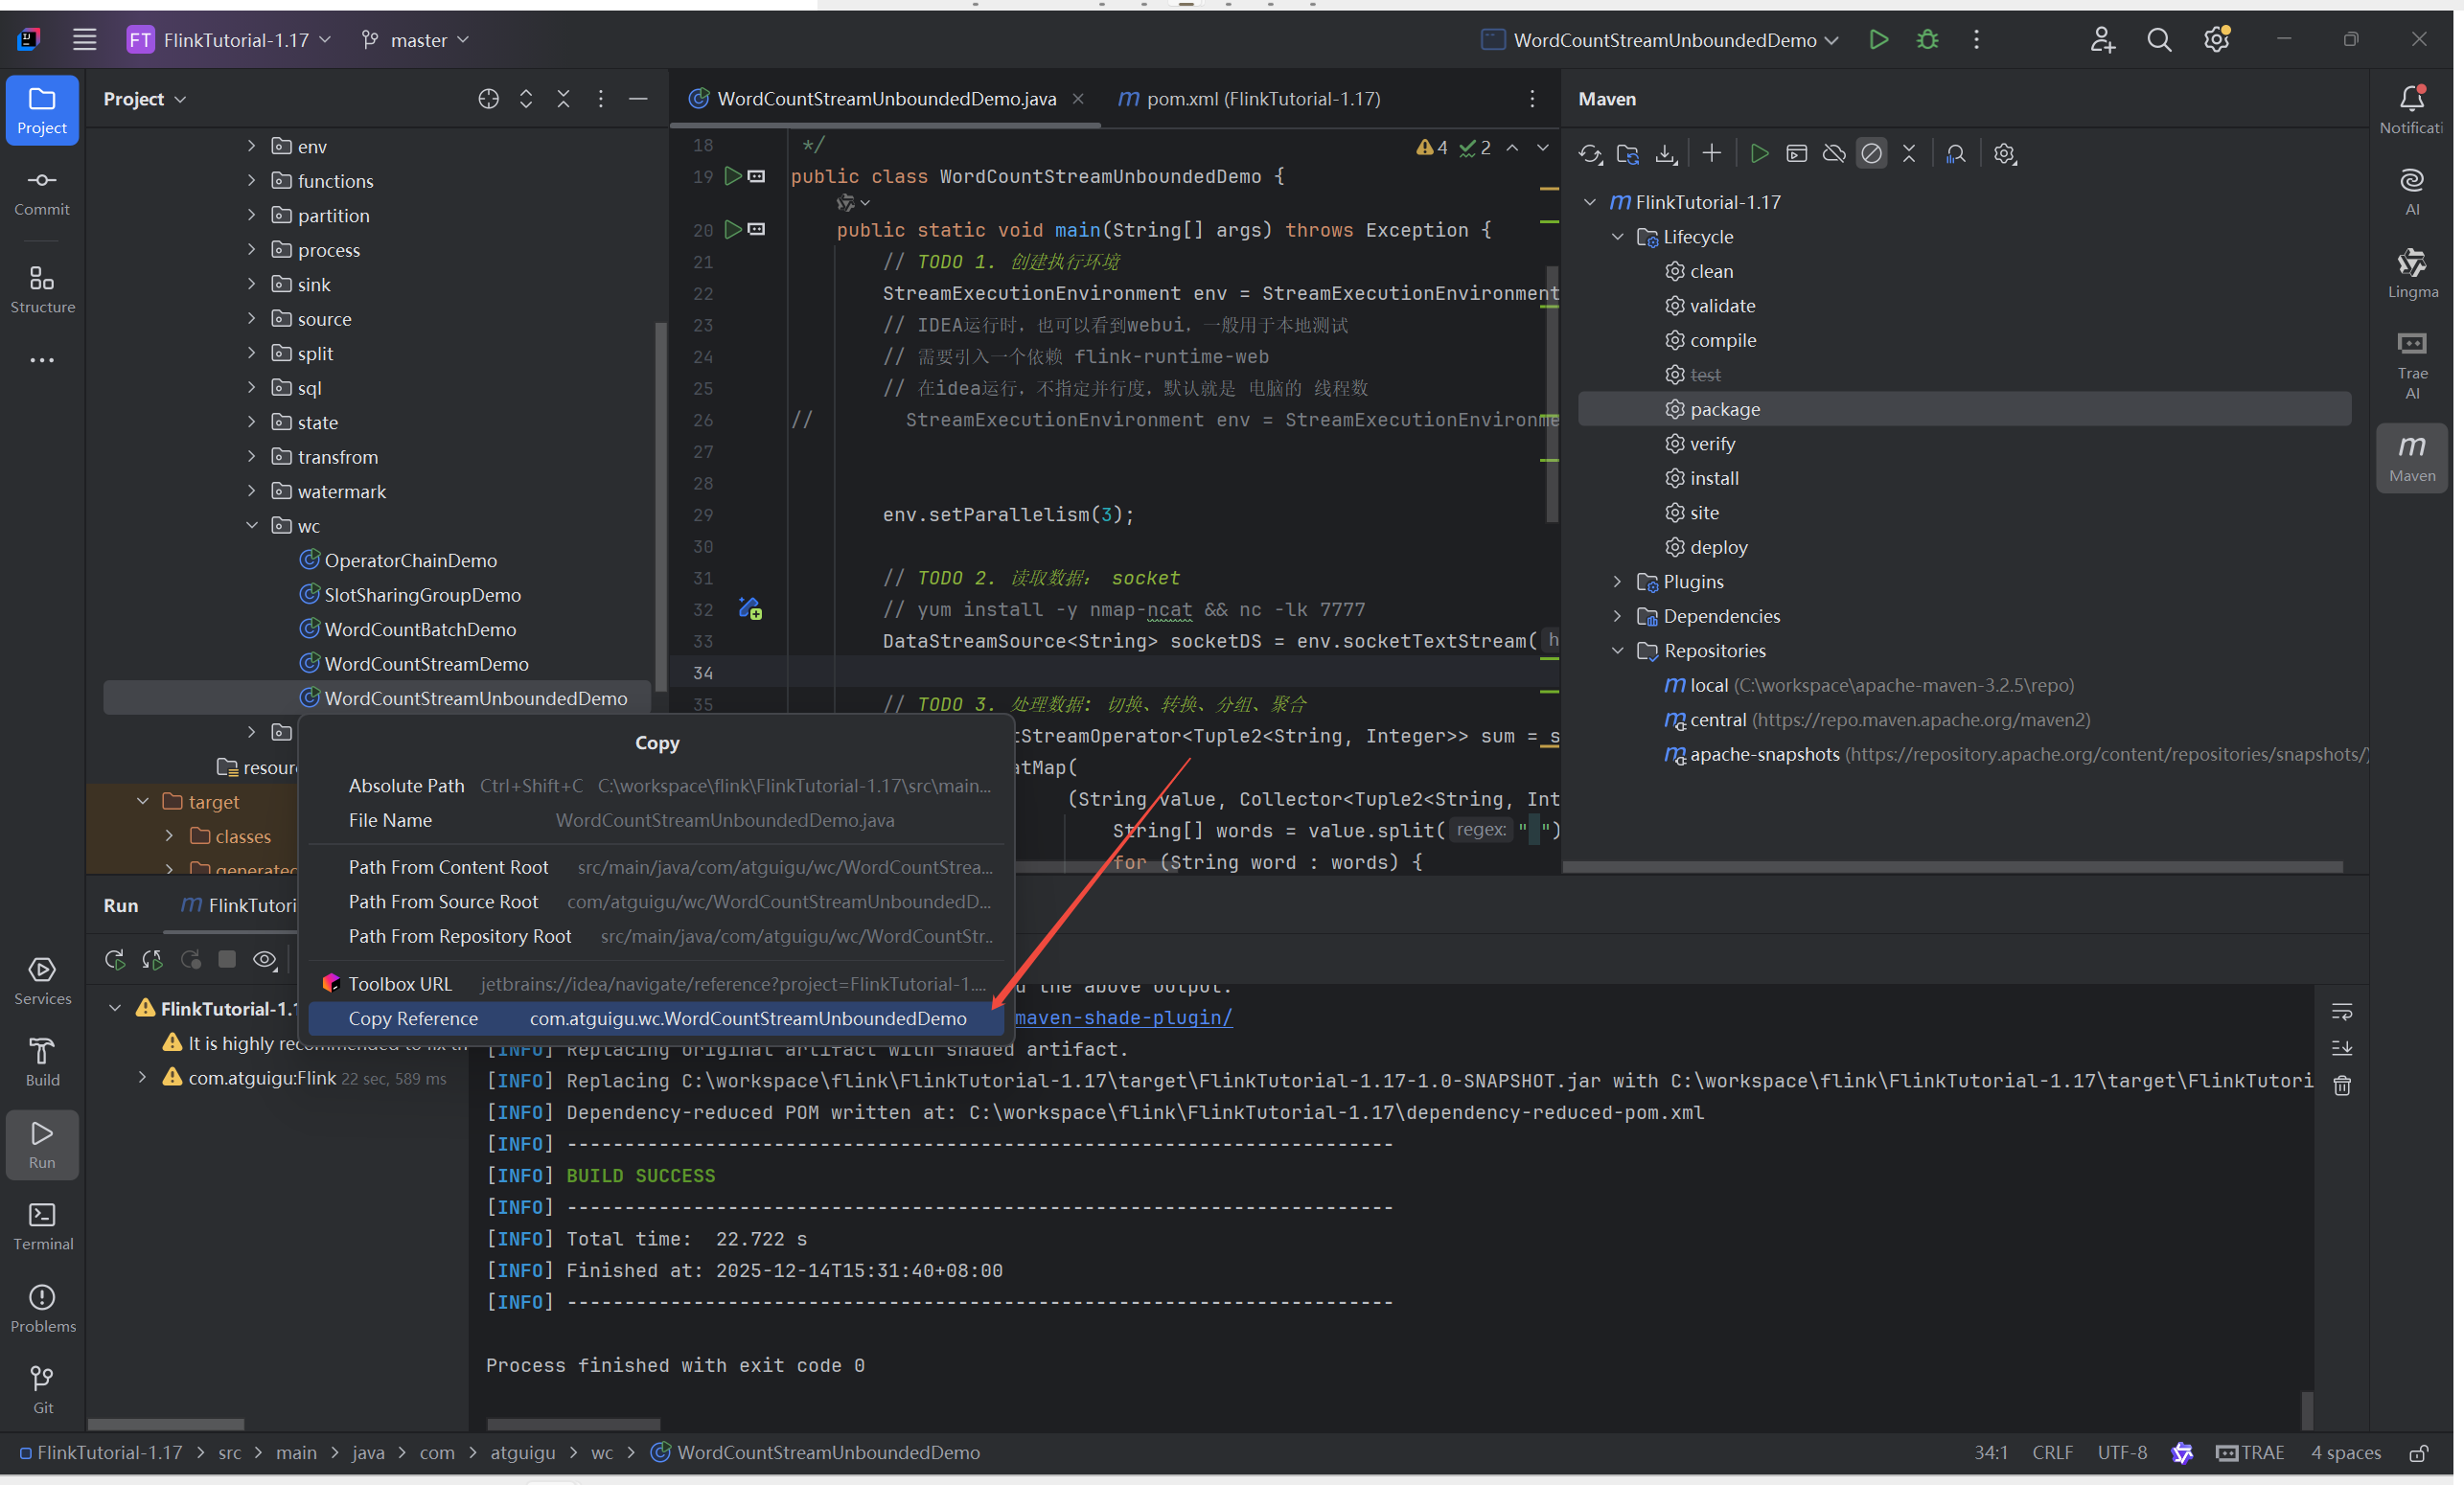
示例代码:
/**
 * TODO DataStream实现Wordcount:读socket(无界流)
 *
 * @author lxy
 * @version 1.0
 */
public class WordCountStreamUnboundedDemo {
    public static void main(String[] args) throws Exception {
        // TODO 1. 创建执行环境
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        // IDEA运行时,也可以看到webui,一般用于本地测试
        // 需要引入一个依赖 flink-runtime-web
        // 在idea运行,不指定并行度,默认就是 电脑的 线程数
        // StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(new Configuration());
        env.setParallelism(3);
        // TODO 2. 读取数据: socket
        // yum install -y nmap-ncat && nc -lk 7777
        DataStreamSource<String> socketDS = env.socketTextStream("192.168.11.31", 7777);
        // TODO 3. 处理数据: 切换、转换、分组、聚合
        SingleOutputStreamOperator<Tuple2<String, Integer>> sum = socketDS
                .flatMap(
                        (String value, Collector<Tuple2<String, Integer>> out) -> {
                            String[] words = value.split(" ");
                            for (String word : words) {
                                out.collect(Tuple2.of(word, 1));
                            }
                        }
                )
                .setParallelism(2)
                .returns(Types.TUPLE(Types.STRING, Types.INT))
                //.returns(new TypeHint<Tuple2<String, Integer>>() {})
                .keyBy(value -> value.f0)
                .sum(1);
        // TODO 4. 输出
        sum.print();
        // TODO 5. 执行
        env.execute();
    }
}
-
-
- 命令行提交作业
-
bin/flink run -m hadoop102:8081 -c com.atguigu.wc.SocketStreamWordCount ./FlinkTutorial-1.0-SNAPSHOT.jar
- Flink运行时架构
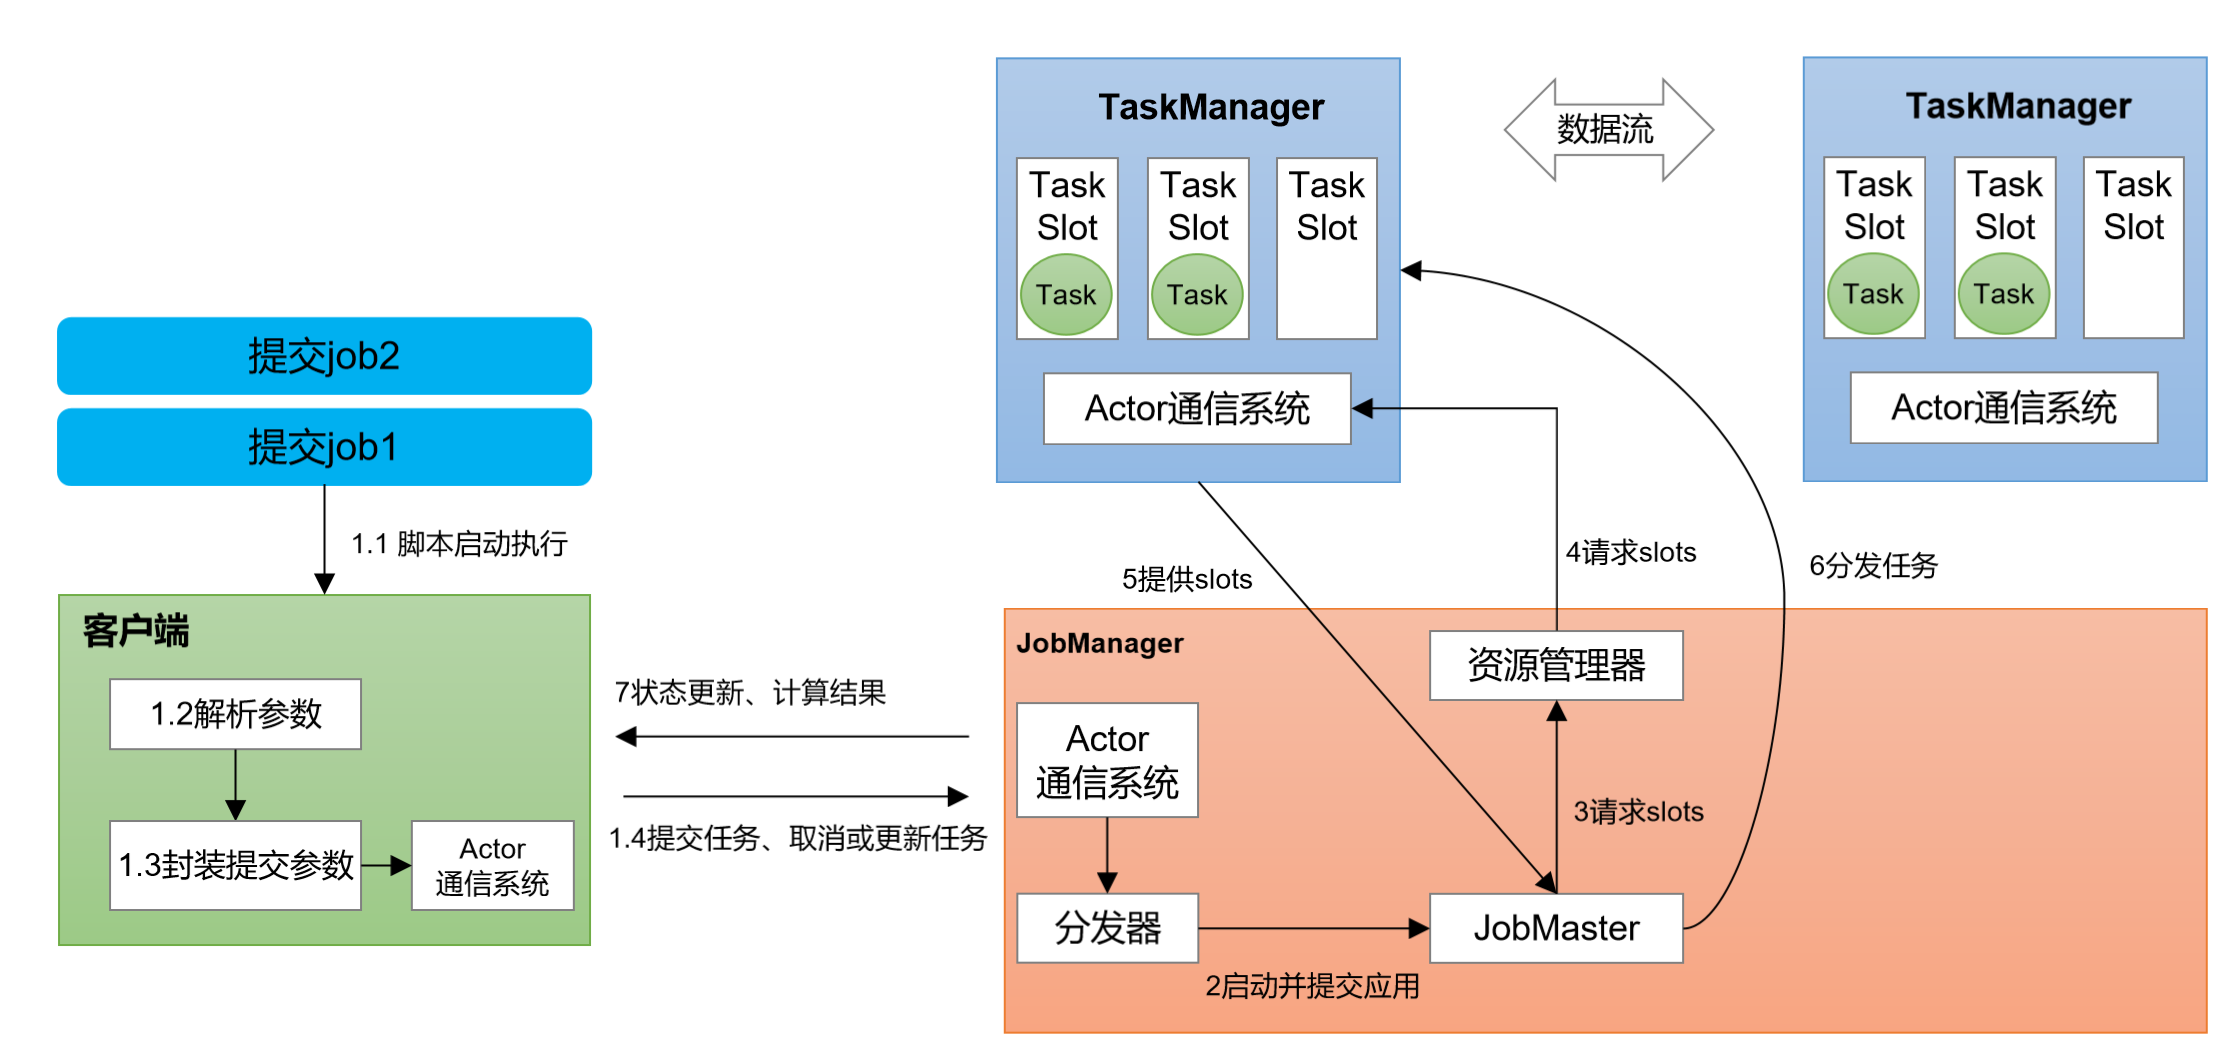
- 系统架构
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)