
深度学习:比较不同计算机视觉任务在卫星图像上的深度学习架构
比较不同计算机视觉任务在卫星图像上的深度学习架构
一个指南,用于选择适用于卫星图像土地利用/土地覆盖制图和变化检测的深度学习架构。
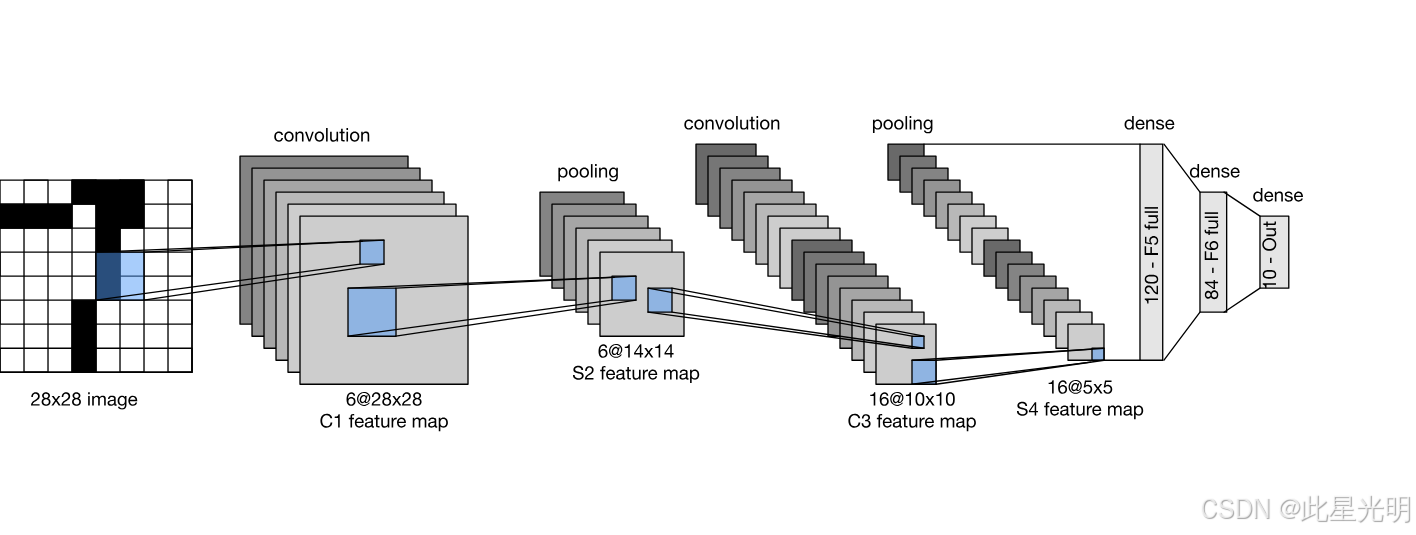
LeNet (LeCun et al. 1998)
1998 年,LeCun 等人引入了第一个卷积神经网络(CNN),称为 LeNet。这标志着卷积层的出现,其是一个包含卷积、池化和非线性激活函数的三步骤过程。LeNet 模型使用了 tanh 激活函数,但后来的网络则用 Rectified Linear Unit(ReLU)来解决梯度消失问题。它也使用平均池化,但后来的研究发现最大池化效果更好。尽管其设计具有创新性,但 LeNet 在其最初推出时并不流行,主要是因为当时缺乏训练大型网络的软件和硬件兼容性。在那个时期,支持向量机(SVM)在检测能力方面仍然与 LeNet 具有竞争力。
AlexNet(Krizhevsky 等人,2012)
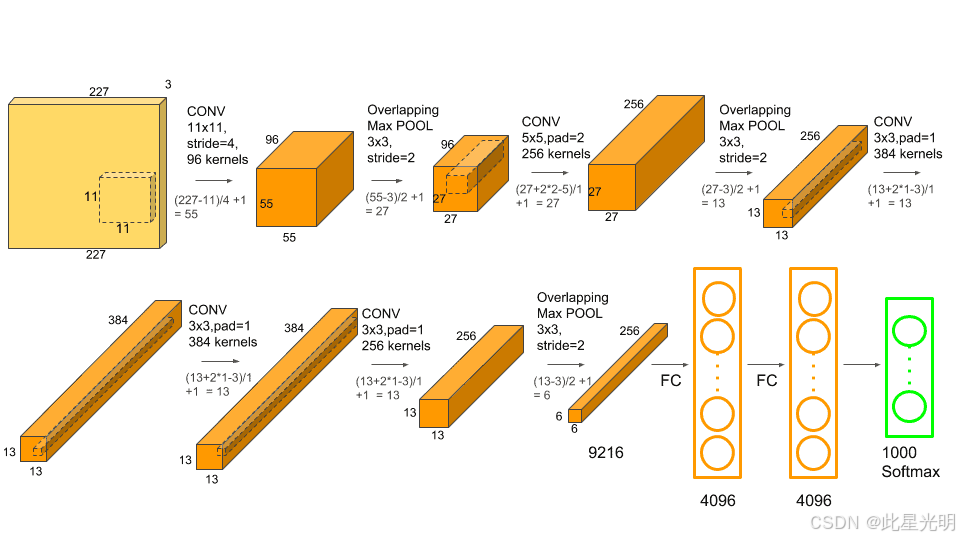
2012 年是 CNNs 爆发的时刻,随着 AlexNet 的引入。它显著优于其竞争对手,在 ImageNet 大规模视觉识别挑战赛中,错误率比第二名低了 10.8 个百分点。从 AlexNet 的表现中得出的一个主要结论是,更深的网络往往能获得更高的性能。AlexNet 的计算需求主要因为 GPU 的出现而变得可行。该网络在 LeNeT 的基础上进行了改进,使用了非饱和的 ReLU 函数,相比 tanh 或 sigmoid 激活函数表现出更好的训练效果,采用了最大池化而不是平均池化,并加入了一个称为 dropout 的正则化层,通过随机将节点设为 0 来减少过拟合。最后,AlexNet 与 LeNet 之间最大的不同在于,AlexNet 是在大量数据上进行训练的,数百万张图像,这得益于 GPU 硬件以及上述架构上的改进:ReLU 用于加快训练,dropout 用于增强正则化。 AlexNet 的影响是毋庸置疑的,据 Google Scholar 上的数据,已有超过 120,000 篇论文引用了它。
ReLU 加速训练的原理
ReLU(Rectified Linear Unit)激活函数定义为 f(x)=max(0,x)f(x) = \max(0, x)f(x)=max(0,x)。其梯度在正区间恒为1,负区间恒为0。相比Sigmoid或Tanh等饱和激活函数,ReLU在正区间避免了梯度消失问题,使得深层网络在反向传播时能更有效地传递梯度。
稀疏激活特性使得部分神经元输出为0,减少了参数更新时的计算量。这种特性还模拟了生物神经元的稀疏响应,提升了网络的表示效率。实验表明,ReLU能使网络在相同迭代次数下更快收敛。
Dropout 增强正则化的机制
Dropout在训练时以概率 ppp 随机将神经元输出置零,测试时通过缩放权重(乘以 ppp)补偿。这种机制强制网络不依赖特定神经元的协同作用,相当于对大量子网络进行集成平均。
每次迭代相当于训练不同的子网络结构,这类似于给权重增加了随机噪声,防止过度依赖局部特征。Dropout降低了神经元之间的复杂共适应关系,使网络更具鲁棒性。实验证明其效果优于L2正则化,尤其在数据量较少时表现突出。
协同作用分析
ReLU和Dropout常联合使用:ReLU的稀疏性会强化Dropout的效果,因为部分神经元本就处于非活跃状态。Dropout的随机失活则进一步防止ReLU神经元形成固定依赖模式。这种组合既能加速收敛,又能提升泛化能力,已成为现代深度网络的标配组件。
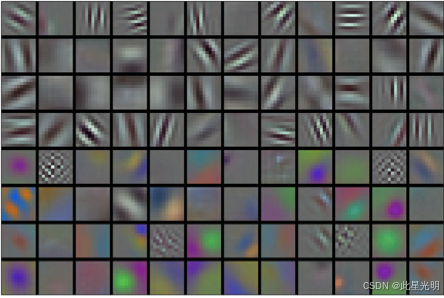
以下是 AlexNet 初始层学习到的特征。请注意一些卷积核学习了纹理信息,比如线条,而另一些则学习颜色。
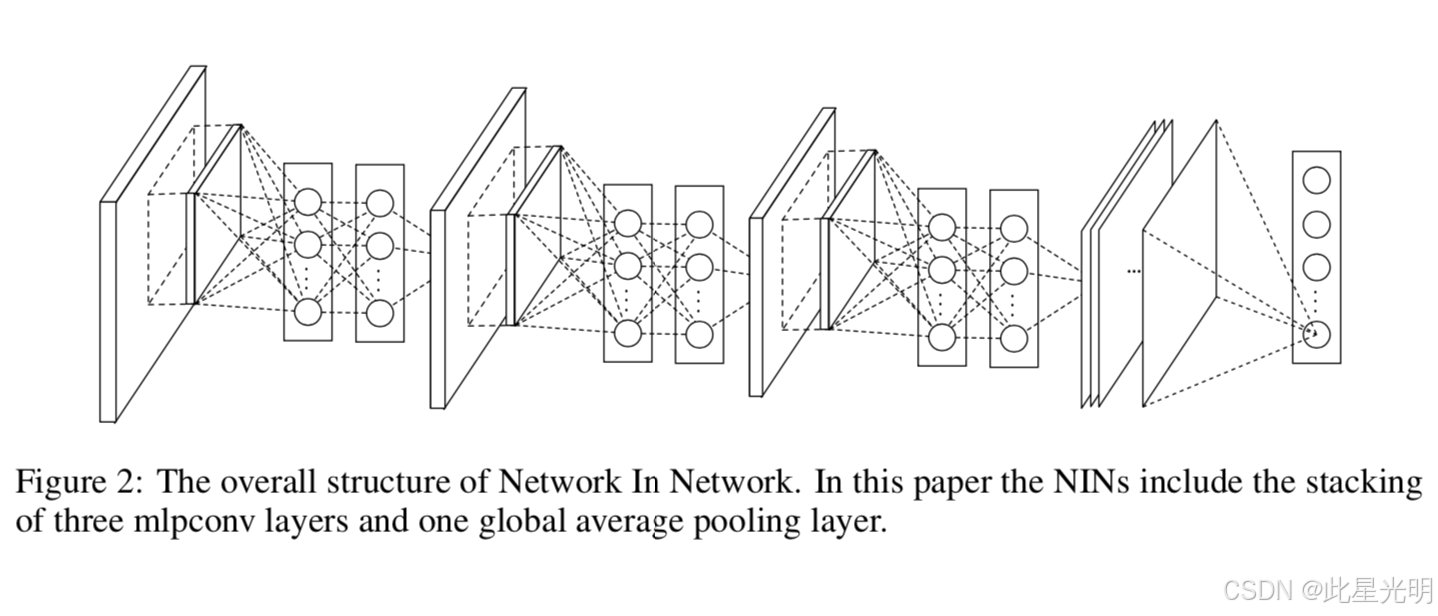
网络内网络(NiN)(Lin 等,2013)
该架构解决了 AlexNet、LeNet 和其他具有全连接层的 CNN 的一个根本性问题:最后的全连接层拥有数亿个参数。NiN 通过将最后的全连接层替换为 1x1 卷积和全局平均池化来解决这个问题。它还用小型多层感知机替代了线性卷积层,这些多层感知机附加在卷积层之后。
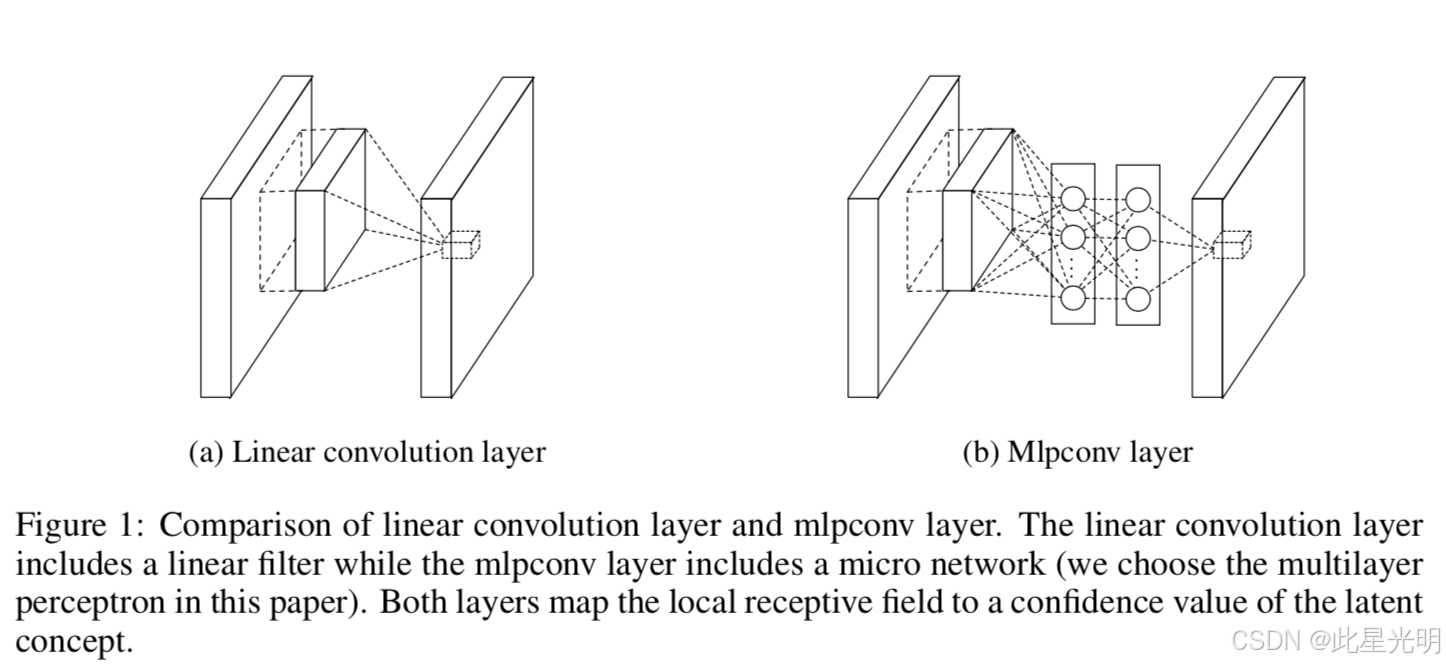
实际上,这在每个像素位置创建了许多较小的全连接层,总体参数数量比 AlexNet 的线性堆叠全连接层要少得多。值得注意的是,NiN 可能会增加网络收敛到最小损失所需的训练时间。
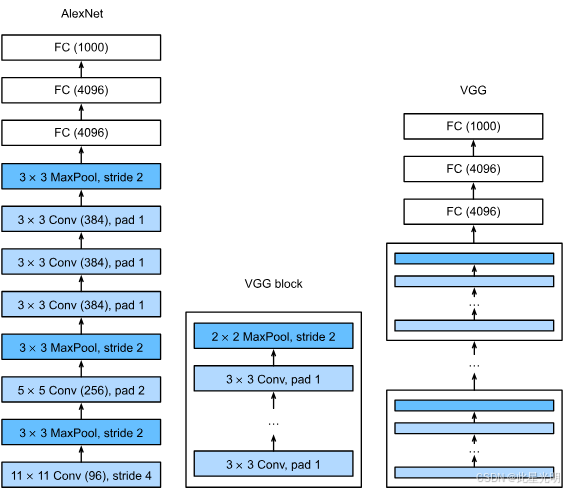
使用模块的网络,VGG(Simonyan 和 Zisserman 2014)[iv]
虽然 VGG 仍然保留了 NiN 所解决的全连接层,但它针对 AlexNet 的一个不同关键限制提出了解决方案:基于卷积神经网络的结构,由多个 Conv > Relu > Max Pooling 模块堆叠而成,其深度受限于输入维度的二次对数。作者引入了 VGG 模块,用多个卷积步骤替代单个卷积步骤。例如,两个堆叠的 3x3 卷积层后接最大池化所产生的计算负担,与单个 5x5 卷积层相似。他们发现,更深但更窄的网络可以训练出更高的性能,同时接受更高的参数数量。
Inception/GoogleNet (Szegedy 等,2014)[v]
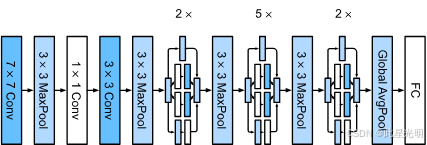
Inception,也被称为 GoogleNet,结合了 VGG 和 NiN 的最佳特性,以减少模型的参数量并更高效地学习特征。它通过采用一种由以下部分组成的 CNN 三部分结构来实现这一目标:
1.一个简单的 stem 网络用于学习低级特征
2.一个主体部分,用于通过更复杂的网络结构学习高级特征
3.一种特定类型的检测(分类、分割、目标检测)的头部网络
这种三部分结构反映了我们今天使用的许多现代网络,并使 GoogleNet 能够在参数更少的情况下学习到更具信息量的特征。GoogleNet 的核心模块——inception 块——出现在主体部分,它使用多个分支来让网络隐式地选择适合特定检测问题的正确卷积滤波器形状。这意味着参数被分配给映射图像不同部分的最重要卷积滤波器。作者的一个值得注意的陈述是,“在大多数实验中,模型的设计旨在保持推理时的计算预算为 15 亿次乘法-加法操作,这样它们就不会仅仅成为纯粹的学术兴趣,而可以在实际应用中,即使在大型数据集上,以合理成本发挥作用。”(Szegedy 等,2014)。
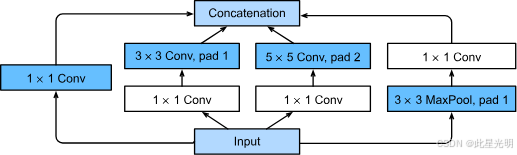
Inception 模型还包括一些其他显著的特性。茎模块类似于 AlexNet 和 LeNet,但在最大池化层之后添加了 1x1 卷积滤波器,也解决了许多最大池化层导致高分辨率空间信息丢失的问题。
这个 Inception 模块解决了深度神经网络中一个普遍存在的问题:参数数量庞大的模型更容易出现过拟合,尤其是在数据集大小固定的情况下。Inception 还应对了深度视觉网络的计算负担问题。当两个卷积滤波器连续使用时,它们的滤波器数量的均匀增加会导致计算量呈二次方增长。相比之下,Inception 模块在计算上更为高效。
Inception 增加了网络的深度和宽度,但做到了参数更少。有趣的是,它所拥有的参数比 AlexNet 还要少,这反映了更广泛的趋势,即创建参数更少但性能依然出色的小型深度神经网络。参数更少的优势包括更快的训练时间、更低的内存消耗以及更高效的特征学习。
批量归一化(Ioffe and Szegedy 2015)[vi]
训练神经网络可能需要很长的时间,即使使用 GPU(几小时、几天,甚至几周!)。拥有上百层的大型网络以前在消费级硬件(1 或 2 块 GPU)上训练和微调是难以处理的。请记住,虽然 VGG 通过更深更窄的网络提高了网络的准确性,但它增加了参数的数量。VGG-11 只有 8 个卷积层和 3 个全连接层,但如今,网络拥有超过 100 个卷积层是很常见的。当网络变得更深时,某一层的权重和偏差可能比另一层的值大几个数量级或小几个数量级,这使得中间层在使用固定学习率和步长的情况下更难以更新参数。这个问题有时被称为“内部协变量偏移”,表明中间层参数之间的关系可能会漂移并引入不准确性。
批量归一化通过针对每个小批量数据减去均值并除以标准差来解决这个问题。对于卷积层,这意味着计算所有像素位置上的通道均值和标准差,并用它们来对每个通道进行归一化。批量归一化可以应用于所有的卷积层,也可以仅应用于部分卷积层。此外,归一化也可以按样本进行,而不是按批次进行,这种方法称为层归一化。
批处理规范化通过正则化和提高训练过程中的数值稳定性,被证明可以改善深度模型的训练。
Resnet(He 等,2015)[vii]
遵循网络复杂性不断增加的趋势,论文《Deep residual learning for image recognition》研究了如何在非常深的网络中提高层的表达能力,而不是简单地增加不会改善模型的参数(数学上已经证明,在其他条件相同的情况下,更大的模型并不一定比更小的模型产生更好的结果)。He 等人试图通过允许一个块的输入直接传递并加到该块输出的激活值上,来改进架构设计。实际上,这意味着一个块学习输入与期望激活值之间的差异(残差)。
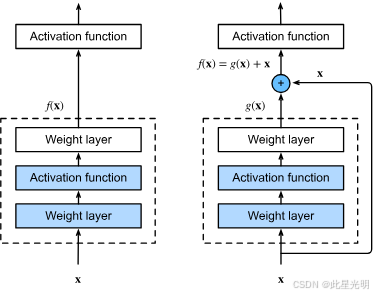
因此,输入可以更快地通过网络,从而允许构建具有数百层的网络(如 Resenet-152)。在这些大型网络中,输入可以经过不需要的层,因为它们实际上可以学习对激活贡献为 0 的权重和偏置,从而实现更快的学习。
残差连接现在已成为非卷积神经网络架构在计算机视觉以外领域的核心组件。
总结
使用经过验证的架构的重要性。
使用经过验证的实现,或理解自己的实现的重要性。
利用流行库和机器学习框架进行实际应用的价值,详见下一课。
更多推荐


 30
 0
- 0


 已为社区贡献15条内容

所有评论(0)