
从 WordCount 开始:Flink 作业的提交流程源码解析
Flink 的作业提交流程,就像一座自动化工厂的运转全景: 从计划处(CLI)下达任务,到厂长(JobManager)组织生产,后勤(ResourceManager)分配资源,车间(TaskManager)开动机器,工位(Slot)全速生产——最终让数据在这座工厂中实时流动、加工、输出。
一、从 WordCount 说起
上一篇文章我们介绍了《从论文到生产:Flink 的诞生、思想与架构哲学》,现在让咱们带着“思想地图”一起来研究下 Flink 源码。编程语言的入门示例是 “Hello World”,而在大数据计算领域,对应的经典例子则是 WordCount。在学习 Flink 的过程中,官网通常会让我们执行以下命令来提交这个最简单的 demo 并在本地试运行:
$ ./bin/start-cluster.sh    //启动集群
$ ./bin/flink run examples/streaming/WordCount.jar  //提交demo
$ ./bin/stop-cluster.sh     //停止集群
同时当我们想要在分布式集群 Yarn/K8s 跑的时候执行的又是诸如这些命令:
// 运行在Yarn,官网参考命令
$ ./bin/flink run-application -t yarn-application ./xx/my-flink-job.jar

// 运行在K8s,官网参考命令
$ ./bin/flink run-application \\
    --target kubernetes-application \\
    -Dkubernetes.cluster-id=my-first-application-cluster \\
    -Dkubernetes.container.image.ref=custom-image-name \\
    local:///opt/flink/usrlib/my-flink-job.jar
在Flink源码工程中,我们可以找到 WordCount 的代码:flink-examples/flink-examples-streaming/src/main/java/org/apache/flink/streaming/examples/wordcount/WordCount.java
主要核心逻辑像这样:
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
DataStream<String> text = env.readTextFile("input.txt");
text.flatMap(...).keyBy(...).sum(...).print();
env.execute("WordCount");
学到这里的时候大家会不会有疑问:执行这些命令后 Flink 内部到底发生了什么?是谁接管了作业?又是如何分发到集群中执行的?带着这些问题,我们一起来看看 Flink 内部到底做了哪些事。
二、运行模式与背景
在 Flink 中,作业可以提交到不同类型的集群(如 Standalone、YARN、K8s),并支持多种运行模式:Session、Per-Job(1.15弃用,2.0移除)、Application。不同模式主要影响的是集群生命周期与资源管理方式,而整体流程的核心逻辑一致,本文将以 Application on K8s 为例,追踪从执行命令到env.execute() 再到作业执行的完整流程。
在 Application on K8s模式 下,Flink 将作业与集群捆绑在一起:一个 Job 有一个专用集群实例,JobManager 与 TaskManager 由 Kubernetes 动态创建,这种模式因资源隔离好、生命周期绑定方便,所以在生产中应用广泛。
注:本文源码解析基于 Flink 1.20 版本
三、宏观全景:一次作业是如何提交的?
我们先从一张图来整体看看一次作业是如何提交的

从图中可以看到,整个提交流程可分为 10 个步骤,和K8s相关的大家忽略,主要关注 Flink 的整体运行逻辑即可:
-
用户执行命令并解析后上传相关所需资源(用的 demo 包含在镜像,所以无需上传)
-
Flink KubeClient 请求集群创建 Flink JM deployment 并启动 JM 的 pod
-
从 K8s 专用 Entrypoint 类进入,创建 JobManager 关键角色:Dispatcher(创建会触发执行用户代码生成 StreamGraph 和 JobGraph)、Resource Manager 和 JobMaster
-
JobMaster 创建会生成 ExecutionGraph,创建 SlotPool 并计算所需资源,向 RM 注册并请求 Slot
-
RM 发现 slot 资源不够会向 K8s 申请新的资源
-
在新申请的 Pod 中通过 KubernetesTaskExecutorRunner 启动 TaskExecutor(即 TaskManager)
-
Task Executor 将自身的 Slot 向 RM 进行注册
-
RM 对已注册的 Slot 进行分配
-
Task Executor 向 JM 提供自身 Slot
-
JM 将 Task 提交部署到 Task Executor 运行
四、微观拆解:提交到执行全流程详解
1. CLI 入口:run-application 命令背后发生了什么?
当我们执行 ./bin/flink run-application --target kubernetes-application -D...... local:///opt/flink/usrlib/my-job.jar 命令时,首先进入的是 Flink 的命令行客户端 CliFrontend。可以把它理解成 Flink 的“前台接待员”——负责解析参数、识别命令、启动正确的执行流程。整个调用链大致如下:
- CliFrontend 入口:flink脚本会进入
CliFrontend.main()方法,解析命令行参数。 - 命令分发:识别到
run-application命令,调用runApplication()方法。 - 参数处理:解析命令行参数,创建
ProgramOptions和Configuration对象。 - 部署器创建:实例化
ApplicationClusterDeployer,用于部署应用集群。 - 资源上传:通过
artifactUploader.uploadAll()判断按需上传本地资源(JAR文件等)到远程存储
此时:Flink 已经把用户命令转译成一个可执行的“集群部署请求”。那这一阶段的核心目标就是“准备运行环境”——CLI 把所有参数和依赖打包成 Flink 可识别的任务描述。
2. 集群创建:K8s 如何拉起 JobManager?
接下来,ApplicationClusterDeployer 会调用KubernetesClusterDescriptor.deployApplicationCluster() ,进入集群创建阶段:
- 验证配置:确保
deployment.target设置为kubernetes-application。 - 应用配置:将应用配置合并到Flink配置中。
- 集群创建:调用
deployClusterInternal()创建集群:- 设置执行模式和入口点类
- 创建
KubernetesJobManagerParameters和FlinkPod模板 - 构建
KubernetesJobManagerSpecification - 调用
client.createJobManagerComponent()创建Deployment、ConfigMap和Service
    private ClusterClientProvider<String> deployClusterInternal(...){
        // ...
		    final KubernetesJobManagerSpecification kubernetesJobManagerSpec =
                KubernetesJobManagerFactory.buildKubernetesJobManagerSpecification(
                  podTemplate, kubernetesJobManagerParameters);

        client.createJobManagerComponent(kubernetesJobManagerSpec);
        // ...
    }
执行到这里,Kubernetes 会启动一个JobManager Pod。容器启动命令会指定入口类为KubernetesApplicationClusterEntrypoint 。
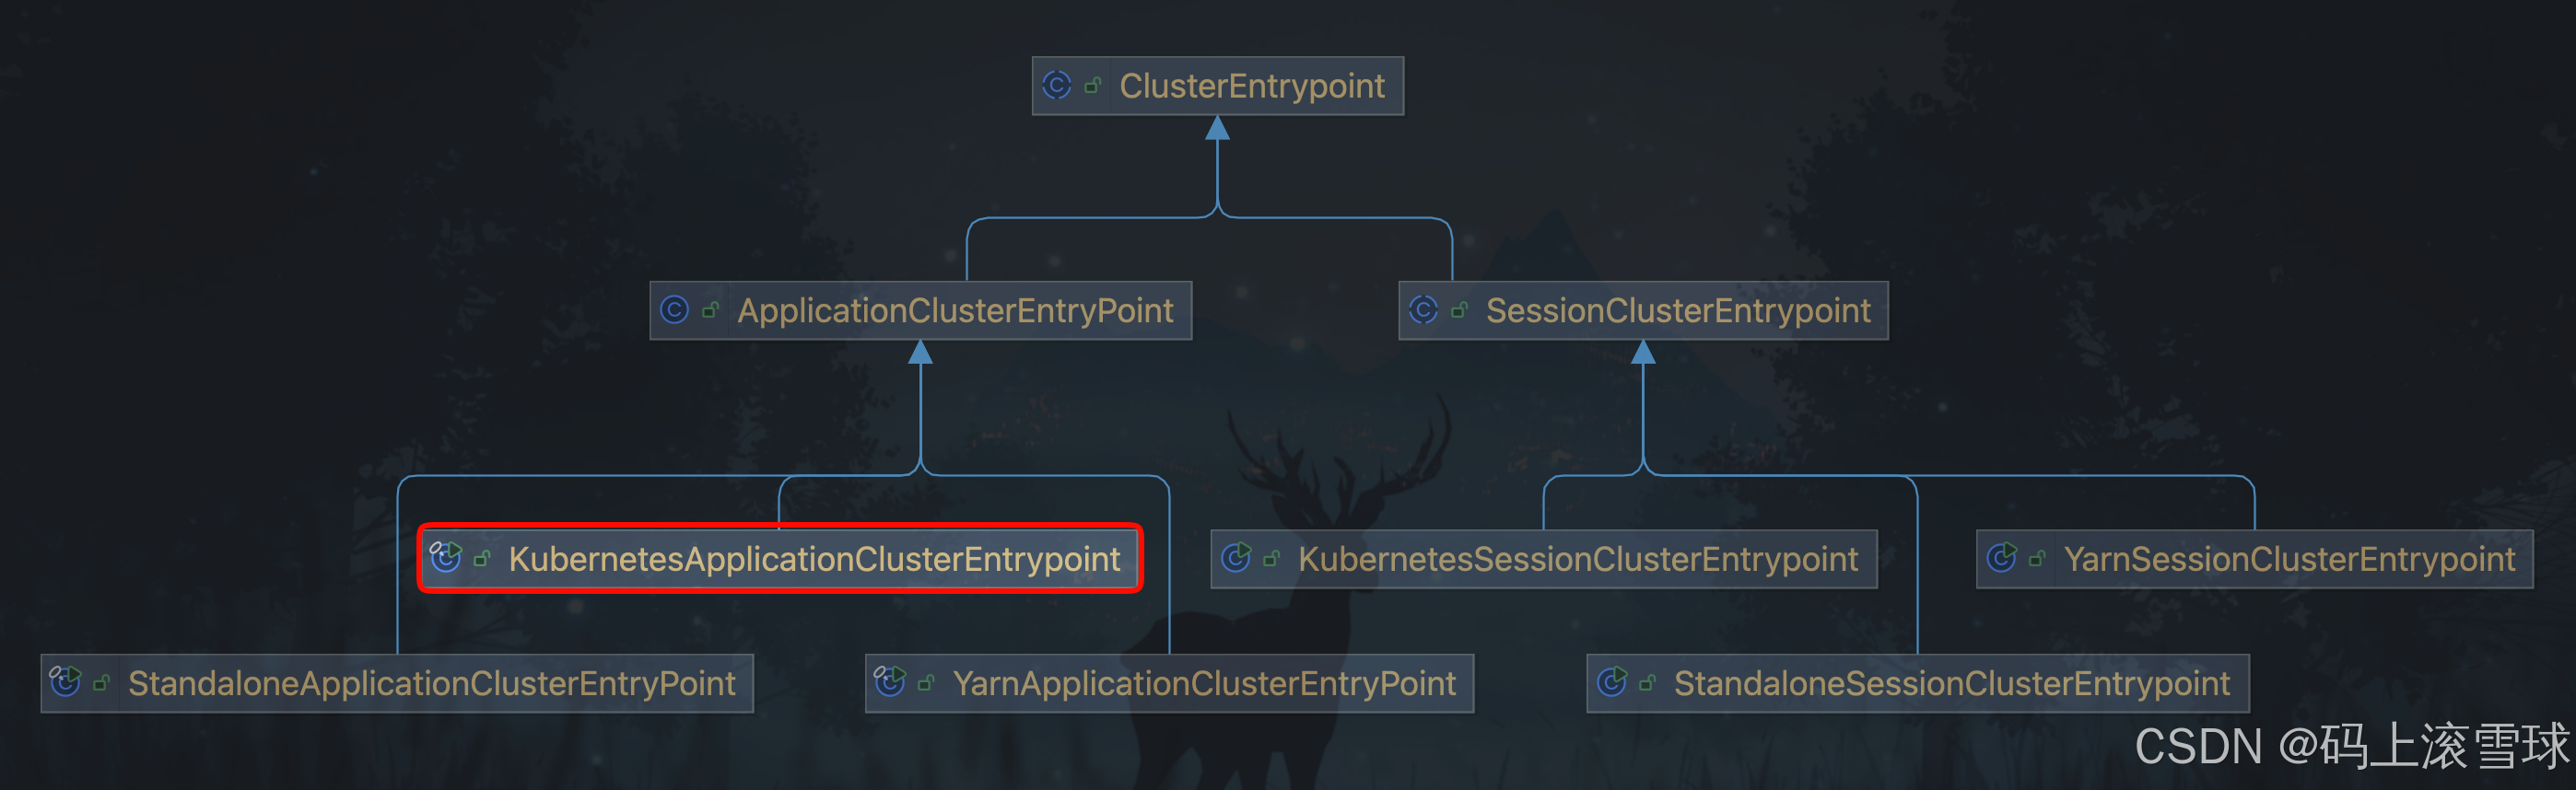
此时:JobManager Pod 已在集群中启动,等待执行用户程序。
3. JobManager 启动:三大核心角色登场
JobManager 是 Flink 集群的“大脑”,它启动后会创建三个关键组件:Dispatcher、ResourceManager和JobMaster,启动大致流程如下:
- JM Pod启动:Kubernetes根据Deployment创建JM Pod,执行
KubernetesApplicationClusterEntrypoint.main()。 - ClusterEntrypoint初始化:初始化配置、日志、安全等。
- 组件工厂创建:调用
createDispatcherResourceManagerComponentFactory()创建DefaultDispatcherResourceManagerComponentFactory。 - Dispatcher创建:
- 使用
ApplicationDispatcherLeaderProcessFactoryFactory创建调度器工厂 - 在
ApplicationDispatcherBootstrap中,通过runApplicationEntryPoint()调用ClientUtils.executeProgram执行用户代码 - 用户代码最后都必须有
env.execute(),执行后会生成StreamGraph - 然后在
EmbeddedExecutor执行器中调用PipelineExecutorUtils.getJobGraph方法,该方法使用FlinkPipelineTranslationUtil.getJobGraph将StreamGraph转换为JobGraph,StreamGraphTranslator通过StreamingJobGraphGenerator完成具体的转换逻辑 - JobGraph包含了实际执行所需的所有信息,如作业配置、并行度、资源需求等
- 使用
- ResourceManager创建:创建KubernetesResourceManager,使用
KubernetesResourceManagerDriver管理资源。 - JobMaster创建:当作业提交后,由Dispatcher创建JobMaster。
此时:Flink 集群的中枢已经准备完毕。Dispatcher 拿到 JobGraph,ResourceManager 准备调度资源,JobMaster 即将开始调度任务。
4.JM 触发生成 ExecutionGraph 并请求资源
JobMaster 是真正掌控作业执行的核心,在 JobMaster 构造函数中创建 SchedulerBase 实例时,会调用 createAndRestoreExecutionGraph 方法触发 JobGraph 转化为 ExecutionGraph —— Flink 的物理执行计划,核心调用链如下:
SchedulerBase.createAndRestoreExecutionGraph()
 → ExecutionGraphFactory.createAndRestoreExecutionGraph()
 → DefaultExecutionGraphBuilder.buildGraph()
- 核心转换逻辑:在
DefaultExecutionGraphBuilder中
// DefaultExecutionGraphBuilder.java
ExecutionGraph executionGraph = DefaultExecutionGraphBuilder.buildGraph(jobGraph, ...);
ExecutionGraph描述了任务的实际执行单元(ExecutionVertex)和依赖关系。
构建完成后,JobMaster 会向 ResourceManager 请求 Slot 资源。
此时:JobMaster 已经画好了调度图纸,等待 ResourceManager 分配资源。
5.RM 申请资源启动 TaskManager
ResourceManager 是 Flink 的资源协调者,在 Kubernetes 模式下,它通过 KubernetesResourceManagerDriver 与 API Server 交互,请求新的 TM Pod:
- 资源请求处理:当ResourceManager需要资源时,调用
requestResource()。 - Pod创建:
- 使用
KubernetesTaskManagerFactory构建TaskManager Pod - 设置Pod名称格式为
{clusterId}-taskmanager-{attemptId}-{podIndex} - 调用
client.createTaskManagerPod()创建Pod
- 使用
- 资源跟踪:维护
requestResourceFutures跟踪资源请求状态。
此时:Kubernetes 开始调度 TaskManager Pod;Flink 正在等待节点启动并注册。
6. Task Executor 启动
KubernetesTaskExecutorRunner 负责启动Task Executor:
- 入口点执行:TaskManager Pod 启动后,执行
/docker-entrypoint.sh taskmanager,最终调用KubernetesTaskExecutorRunner.main()方法。 - 配置加载:从环境变量获取并设置
TASK_MANAGER_NODE_ID。 - TaskManager启动:调用
TaskManagerRunner.runTaskManagerProcessSecurely()启动TaskExecutor。
public static void main(String[] args) {
    EnvironmentInformation.logEnvironmentInfo(LOG, "Kubernetes TaskExecutor runner", args);
    SignalHandler.register(LOG);
    JvmShutdownSafeguard.installAsShutdownHook(LOG);

    runTaskManagerSecurely(args);
}

private static void runTaskManagerSecurely(String[] args) {
    Configuration configuration = null;

    try {
        configuration = TaskManagerRunner.loadConfiguration(args);
        final String nodeId = System.getenv().get(Constants.ENV_FLINK_POD_NODE_ID);
        // ...
        configuration.set(TaskManagerOptionsInternal.TASK_MANAGER_NODE_ID, nodeId);
    } catch (FlinkParseException fpe) {
        // ...
    }

    TaskManagerRunner.runTaskManagerProcessSecurely(checkNotNull(configuration));
}
此时:TaskExecutor 已经启动,准备向集群注册自己。
7. Task Executor 注册到 RM
TaskExecutor 启动后,会主动与 ResourceManager 建立连接并注册。
注册过程相当于 “我是谁、我有几个 Slot、请给我任务”。
- 连接RM:TaskExecutor启动后,在
connectToResourceManager()方法中连接RM - 注册TM:通过远程调用最终会通过RM的
registerTaskExecutor()方法把TM进行注册
注册信息包含TaskExecutor的资源ID、可用slot数量等
// ResourceManager接收TaskExecutor注册请求
public CompletableFuture<RegistrationResponse> registerTaskExecutor(
        final TaskExecutorRegistration taskExecutorRegistration, final Time timeout) {
    // 建立与TaskExecutor的RPC连接
    CompletableFuture<TaskExecutorGateway> taskExecutorGatewayFuture =
            getRpcService().connect(
                    taskExecutorRegistration.getTaskExecutorAddress(),
                    TaskExecutorGateway.class);
    // ...

    return taskExecutorGatewayFuture.handleAsync((gateway, throwable) -> {
        if (throwable != null) {
            return new RegistrationResponse.Failure(throwable);
        } else {
            return registerTaskExecutorInternal(gateway, taskExecutorRegistration);
        } // ...
    }, getMainThreadExecutor());
}
此时:资源池(Slot)已准备就绪。
8. RM 对已注册的 Slot 进行分配
- 需求处理:ResourceManager 通过 SlotManager 接收并处理 JobMaste r的资源需求
- 资源跟踪:更新作业的资源需求信息
- 分配触发:调用
checkResourceRequirementsWithDelay()触发 slot 分配逻辑 - 分配策略:根据作业需求和可用资源进行 slot 匹配和分配
// FineGrainedSlotManager处理作业资源需求
public void processResourceRequirements(ResourceRequirements resourceRequirements) {
    checkInit();
    if (resourceRequirements.getResourceRequirements().isEmpty()
            && resourceTracker.isRequirementEmpty(resourceRequirements.getJobId())) {
        return; // 跳过空需求
    }
    // ...
    // 更新资源需求并触发分配检查
    resourceTracker.notifyResourceRequirements(
            resourceRequirements.getJobId(), resourceRequirements.getResourceRequirements());
    checkResourceRequirementsWithDelay();
}
此时:Flink 内部的资源调度链闭合,准备进入任务部署阶段。
9. Task Executor 向 JM 提供自身 Slot
TaskExecutor 收到分配指令后,会向 JobMaster 提交自身可用的 Slot 信息:
// TaskExecutor向JobMaster提供slot
private void internalOfferSlotsToJobManager(JobTable.Connection jobManagerConnection) {
    final JobID jobId = jobManagerConnection.getJobId();

    if (taskSlotTable.hasAllocatedSlots(jobId)) {
        final JobMasterGateway jobMasterGateway = jobManagerConnection.getJobManagerGateway();
        final JobMasterId jobMasterId = jobManagerConnection.getJobMasterId();

        // 收集已分配的slot
        final Iterator<TaskSlot<Task>> reservedSlotsIterator =
                taskSlotTable.getAllocatedSlots(jobId);
        final Collection<SlotOffer> reservedSlots =
                CollectionUtil.newHashSetWithExpectedSize(2);

        while (reservedSlotsIterator.hasNext()) {
            SlotOffer offer = reservedSlotsIterator.next().generateSlotOffer();
            reservedSlots.add(offer);
        }

        // 发送slot offer
        final UUID slotOfferId = UUID.randomUUID();
        currentSlotOfferPerJob.put(jobId, slotOfferId);

        CompletableFuture<Collection<SlotOffer>> acceptedSlotsFuture =
                jobMasterGateway.offerSlots(
                        getResourceID(),
                        reservedSlots,
                        Time.fromDuration(taskManagerConfiguration.getRpcTimeout()));

		        // 处理接受结果 ...
    }
}
JobMaster 接收后,确认 Slot 有效并将其绑定到对应的任务。
Slot 是 Flink 中“Task运行的容器”,这一过程相当于 TaskExecutor 告诉 JobMaster:‘我有空位,快派任务过来。’
10. JM 将 Task 提交部署到 Task Executor 运行
最后,JobMaster 根据 ExecutionGraph 将具体Task下发到对应的 TaskExecutor:
// TaskExecutor接收任务提交请求
public CompletableFuture<Acknowledge> submitTask(
        TaskDeploymentDescriptor tdd, JobMasterId jobMasterId, Time timeout) {
    final JobID jobId = tdd.getJobId();

    // 验证JobManager连接、JobMaster ID、slot状态 ...

    // 加载任务数据
    try {
        tdd.loadBigData(
                taskExecutorBlobService.getPermanentBlobService(),
                jobInformationCache,
                taskInformationCache,
                shuffleDescriptorsCache);
    } catch (IOException | ClassNotFoundException e) {
        throw new TaskSubmissionException(
                "Could not re-integrate offloaded TaskDeploymentDescriptor data.", e);
    }
    // ...

    // 创建并启动Task实例...
    if (taskAdded) {
        task.startTaskThread();
        // ...
    } else // ...
}
TaskExecutor 收到任务后会创建 Task 实例,加载用户代码并启动执行线程。
至此,一个 Flink 作业在 Kubernetes 上的部署过程正式完成。
✅ 这一刻,WordCount 的算子真正开始在 TaskManager 中运行。
五、源码结构小结—化繁为简
看完前面复杂的源码与组件调用,我们不妨退一步,从更高的视角重新审视整个 Flink 提交流程。
无论是 Local、YARN 还是 Kubernetes 模式,核心主线其实都围绕这五大步骤展开:
CLI → 集群资源管理API → JobManager → ResourceManager → TaskManager
解析命令   →  创建集群   →   构建作业图   →   分配资源   →   部署任务
其中:
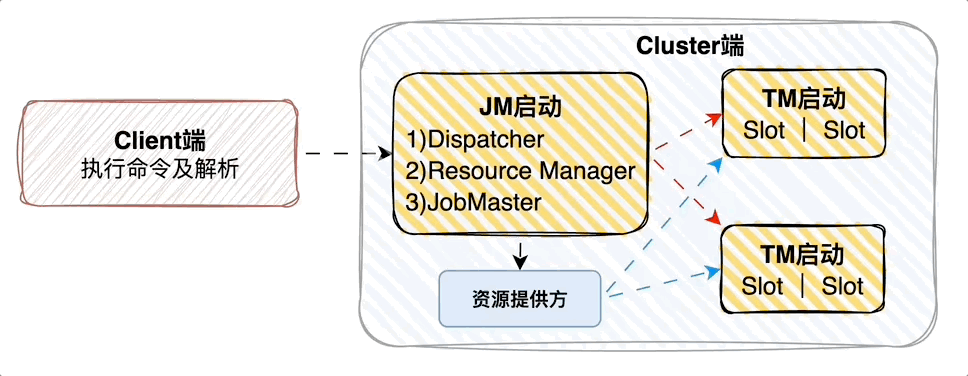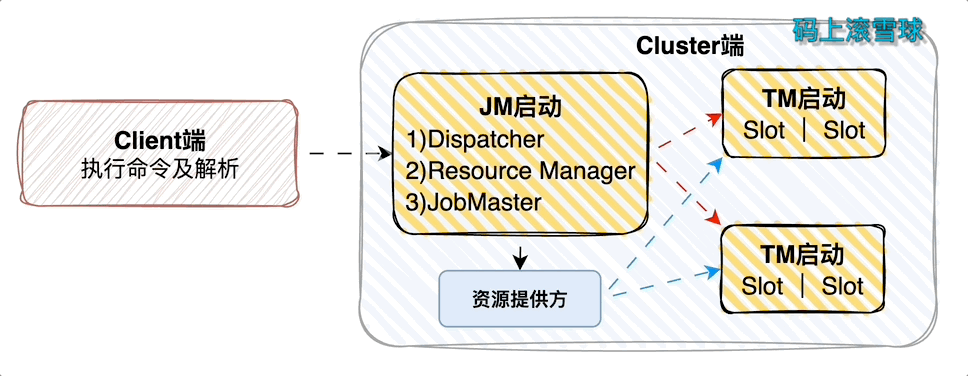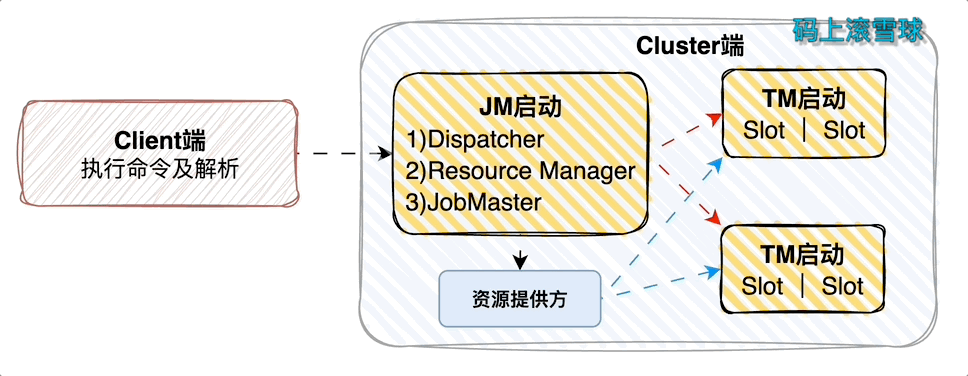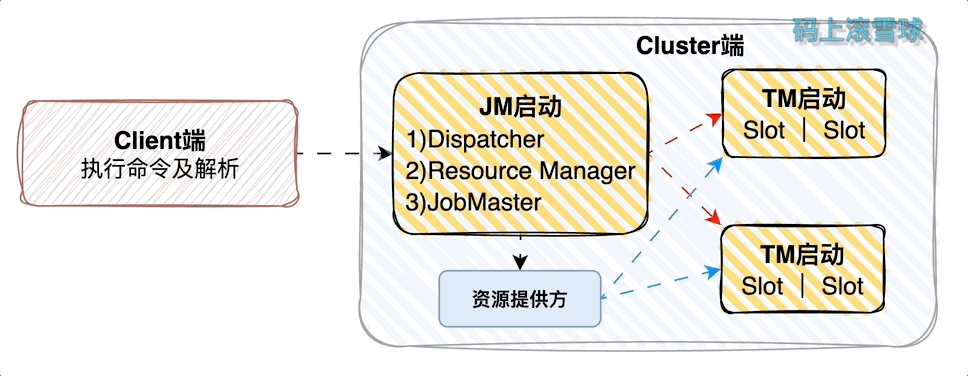
1.资源提供者既可以是 K8s,也可以是 Yarn 等,而源码实现只是对应不同资源提供者,客户端和交互方式有所差异,核心流程基本一致。
2.Session和Per-Job两种模式下 StreamGraph/JobGraph 在Client 生成,Application 则是都在Cluster端的 JM 中生成。
Flink 的作业提交流程,就像一座自动化工厂的运转全景: 从计划处(CLI)下达任务,到厂长(JobManager)组织生产,后勤(ResourceManager)分配资源,车间(TaskManager)开动机器,工位(Slot)全速生产——最终让数据在这座工厂中实时流动、加工、输出。
六、延伸思考
至此,我们从 flink run-application 命令一路追踪到 TaskExecutor 真正执行算子任务。
这一过程揭示了 Flink 在 Kubernetes 上的完整生命周期闭环:提交 → 启动 → 调度 → 执行。
在分布式集群中,Flink 的 JM、TM 都运行在不同的机器上,那他们是如何互相通知、调用和传输数据的呢?
下一篇,我们就来聊聊 Flink 内部组件的通信机制——厂长(JobManager)和车间主任(TaskManager)的“无线对讲机”。
更多推荐


 21
 0
- 0


 已为社区贡献12条内容

所有评论(0)