
入门 Hadoop 大数据开发:从基础到实践的核心指南
在大数据爆发的时代,Hadoop 作为分布式计算与存储的核心框架,已成为大数据开发岗位的必备技能。对于刚踏入大数据领域的新手而言,系统掌握 Hadoop 基础不仅能搭建起核心知识框架,更能为后续深入学习 Spark、Flink 等技术奠定坚实基础。本文结合 Hadoop 大数据开发基础课程的核心内容,梳理入门关键要点,助力新手快速上手。
Hadoop 核心组件架构概览
Hadoop 的核心价值在于解决海量数据的存储与计算难题。传统单机架构无法承载 TB 级甚至 PB 级数据的处理需求,而 Hadoop 基于分布式架构,通过多节点协同工作,实现了数据的并行存储与计算。其核心由三大组件构成,这也是基础课程的重点内容:HDFS(分布式文件系统)、MapReduce(分布式计算框架)和 YARN(资源调度平台)。
配图 1:Hadoop 三大核心组件关系示意图
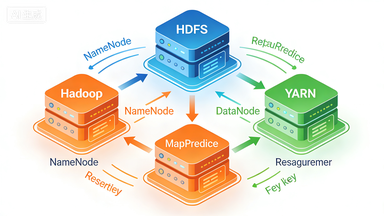
我将为博客添加配套图片,以图文并茂的形式呈现Hadoop核心组件架构与学习要点。 配图1:Hadoop三大核心组件关系示意图 配图2:HDFS读写流程示意图 配图3:MapReduce词频统计执行流程图 配图4:YARN资源调度架构图
在大数据爆发的时代,Hadoop 作为分布式计算与存储的核心框架,已成为大数据开发岗位的必备技能。对于刚踏入大数据领域的新手而言,系统掌握 Hadoop 基础不仅能搭建起核心知识框架,更能为后续深入学习 Spark、Flink 等技术奠定坚实基础。本文结合 Hadoop 大数据开发基础课程的核心内容,梳理入门关键要点,助力新手快速上手。
Hadoop 核心组件架构概览
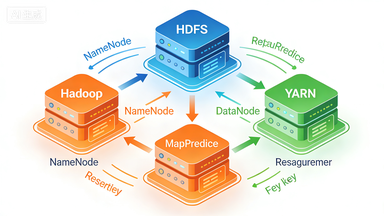
Hadoop 的核心价值在于解决海量数据的存储与计算难题。传统单机架构无法承载 TB 级甚至 PB 级数据的处理需求,而 Hadoop 基于分布式架构,通过多节点协同工作,实现了数据的并行存储与计算。其核心由三大组件构成,这也是基础课程的重点内容:HDFS(分布式文件系统)、MapReduce(分布式计算框架)和 YARN(资源调度平台)。
配图 1:Hadoop 三大核心组件关系示意图
HDFS:分布式存储的基石
HDFS 是 Hadoop 的数据存储核心,采用 “主从架构” 设计。NameNode 作为主节点,负责管理文件系统的命名空间、元数据信息,相当于整个存储系统的 “大脑”;DataNode 作为从节点,负责实际存储数据块,是数据的 “仓库”。课程中会重点讲解 HDFS 的读写流程,比如文件写入时如何拆分数据块、副本如何冗余存储以保证可靠性,文件读取时如何通过元数据定位数据块位置。理解 HDFS 的架构设计,能帮助开发者规避后续数据存储中的常见问题,比如数据副本数量设置、节点故障处理等。
配图 2:HDFS 读写流程示意图

MapReduce:分布式计算的引擎
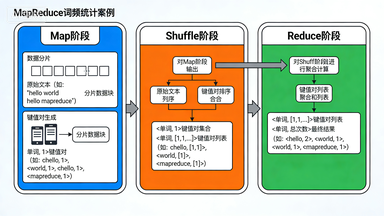
MapReduce 是 Hadoop 的计算核心,其设计思想源于 “分而治之”。它将复杂的计算任务拆分为 Map(映射)和 Reduce(归约)两个阶段:Map 阶段负责将海量数据拆分处理,生成中间结果;Shuffle 阶段负责对中间结果进行排序、合并等预处理;Reduce 阶段则对预处理后的中间结果进行聚合,得到最终结果。基础课程中会通过经典案例(如词频统计)拆解 MapReduce 的执行流程,让学习者理解各阶段的核心作用。需要注意的是,MapReduce 虽然计算能力强大,但存在延迟较高的问题,更适合离线计算场景,这也是后续学习 Spark 等实时计算框架的铺垫。
配图 3:MapReduce 词频统计执行流程图
YARN:资源调度的中枢
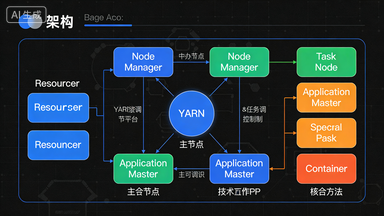
YARN 作为资源调度平台,是 Hadoop 2.0 版本后的核心升级点,负责统一管理集群的计算资源(CPU、内存),并为各类计算任务(包括 MapReduce 任务)分配资源。YARN 的主节点 ResourceManager 负责全局资源调度,从节点 NodeManager 负责单个节点的资源管理与任务监控。学习 YARN 的核心在于理解资源调度机制,这对后续优化任务性能、提高集群资源利用率至关重要。
配图 4:YARN 资源调度架构图
实践学习建议
对于新手而言,Hadoop 基础学习不能仅停留在理论层面,实践是关键。课程中通常会配套集群搭建实验,从单机伪分布式集群到多节点完全分布式集群,逐步熟悉 Hadoop 的配置文件(如 core-site.xml、hdfs-site.xml)、集群启动与管理命令。此外,通过编写简单的 MapReduce 程序(如数据去重、TopN 统计),能更直观地理解计算流程,同时掌握 Hadoop 的编程规范。
需要提醒的是,Hadoop 基础学习要注重知识的关联性。比如 HDFS 的块大小设置会影响 MapReduce 的任务拆分数量,YARN 的资源配置直接决定任务的运行效率。同时,要多关注 Hadoop 的生态系统,Hive、HBase、ZooKeeper 等工具都是基于 Hadoop 发展而来,掌握 Hadoop 基础后,后续学习这些生态工具会更加轻松。
总之,Hadoop 大数据开发基础是进入大数据领域的敲门砖。学习过程中要先夯实三大核心组件的理论基础,再通过大量实践加深理解,同时培养分布式思维。随着学习的深入,你会发现 Hadoop 不仅是一套技术框架,更代表了大数据处理的核心思想。希望本文能为正在学习 Hadoop 基础的你提供帮助,后续可进一步探索更复杂的生态工具与实战场景。
更多推荐

 17
 0
- 0


 已为社区贡献2条内容

所有评论(0)