
Python基础(7):变量数据类型---神秘的“容器”列表和元组(list/tuple)—详解
练习最大的收获就是先进行模仿,在发现问题,解决问题,最后掌握!
上一篇文章题目:Python基础(6): 循环核心技巧---解析 for/while ,代码效率翻倍
链接:https://blog.csdn.net/2501_94250394/article/details/156205477?spm=1001.2014.3001.5501
夹带点私货:首先感谢关注我的粉丝,大家都是我的天使投资人,后续我会更加努力给大家细心分享所有的知识和经验。大家有任何问题都可以发在评论区,我一一为大家解决,如果想换种方式,到时候我争取创建一个群聊,到时候志同道合的小伙伴们可以一起学习,一起讨论各种问题,方便交流。最后,我发现好多粉丝都是用户推荐关注的,特别感谢推荐我的小伙伴,万分荣幸,感谢所有喜欢我博客的小伙伴们。
前言
前天,我们和小伙伴们一起学习了字符串的操作方法,不知道小伙伴们有没有练习,大家一定要熟悉关键字,也不用背格式,因为实际工作之中,我们也会使用AI工具辅助完成代码,但是前提就是大家需要能简单看懂,后面我会给大家分享一些软件,大家可以提前了解一下。接下来,我们来看看“容器”到底有那些神奇的操作方法。
一、列表及其应用场景
1.1 列表有啥用
列表是把信息分条整理的形式,核心是让内容更清晰好上手。
比如,存单个数据用变量就够,但批量同类型数据(比如 100 个学生姓名),用列表能省大功夫,不用重复写一堆变量。不用写 100 个变量,把所有姓名放进[]、用逗号隔开,一个列表就能装下全班姓名,简洁又好管理。
对于同类型批量数据,列表是比多个变量更高效的存储方式
1.2 列表的定义
定义:
列表序列名称 = [列表中的元素1, 列表中的元素2, 列表中的元素3, ...]案例:定义一个列表,用于保存苹果、香蕉以及菠萝
list1 = ['apple', 'banana', 'pineapple']
# list列表类型支持直接打印
print(list1)
# 打印列表的数据类型
print(type(list1)) # <class 'list'>注意:list就是列表,变量名字不一定要写,但是变量=[ ]中的[ ]不能省略。
原因:
- 列表的 “身份标识” 是
[](方括号),不是变量名里的 “list”; - 变量名可以随便起(符合规则就行),不用带 “list” 字样;
[]绝对不能省略 —— 少了它,就不是列表了!
二、列表的相关操作
2.1 列表的相关操作
列表的作用是一次性存储多个数据,程序员可以对这些数据进行的操作有:增、删、改、查。
2.2 查操作
列表在计算机中的底层存储形式,列表和字符串一样,在计算机内存中都占用一段连续的内存地址,我们向访问列表中的每个元素,都可以通过"索引下标"的方式进行获取。
如果我们想获取列表中的某个元素,非常简单,直接使用索引下标,注意格式:
list1 = ['apple', 'banana', 'pineapple']
# 获取列表中的banana
print(list1[1])注意:索引默认从0开始,也就是索引为1的元素就是banana。不太了解的小伙伴可以看我前面的博客内容学习。
查操作的其他方法:
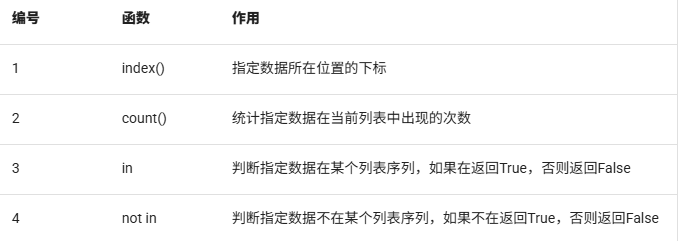
案例:
# 先建一个水果列表(里面有2个香蕉,方便演示)
fruit_list = ['apple', 'banana', 'pineapple', 'banana', 'orange']

# 1. 找元素的位置(index()方法)
# 作用:查某个东西在列表里 第一次出现 的位置编号(位置从0开始算)
target = 'banana'  # 想找“香蕉”的位置
position = fruit_list.index(target)  # 调用index(),传入要找的东西
print(f"1. 香蕉第一次出现的位置编号是:{position}")  # 输出1(因为第2个元素,编号1)

# 2. 数元素出现的次数(count()方法)
# 作用:算某个东西在列表里一共出现了几次
target = 'banana'  # 想数“香蕉”出现几次
times = fruit_list.count(target)  # 调用count(),传入要数的东西
print(f"2. 香蕉在列表里一共出现了:{times}次")  # 格式化,输出2(列表里有2个香蕉)

# 3. 判断元素在不在列表里(in关键字)
# 作用:看某个东西是不是在列表里,结果是“是”(True)或“不是”(False)
check = 'apple'  # 想判断“苹果”在不在
is_there = check in fruit_list  # 用in判断
print(f"3. 苹果在列表里吗?{is_there}")  # 输出True(苹果在列表第一个)

# 4. 判断元素不在列表里(not in关键字)
# 作用:看某个东西是不是不在列表里,结果是“是”(True)或“不是”(False)
check = 'grape'  # 想判断“葡萄”在不在
is_not_there = check not in fruit_list  # 用not in判断
print(f"4. 葡萄不在列表里吗?{is_not_there}")  # 输出True(列表里没有葡萄)
内容有点多,大家记得一定要看注释进行理解,同时自己多加练习,加深印象。变量的命名都比较形象直接,看英语单词也可以猜到它的意思,不熟悉的内容记得看之前的博客进行熟悉。
2.3 增操作
主要有三种方式:
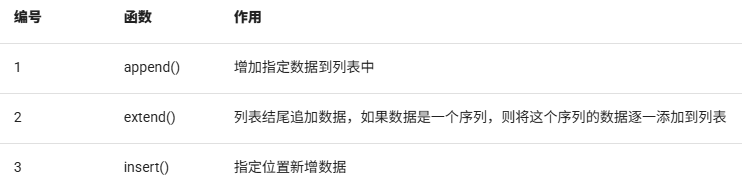
注意:extend方法比较适合于两个列表进行元素的合并操作
2.3.1 append()
append() :在列表的尾部追加元素
names = ['孙悟空', '唐僧', '猪八戒']
# 在列表的尾部追加一个元素"沙僧"
names.append('沙僧')
# 打印列表
print(names)注意:列表追加数据的时候,直接在原列表里面追加了指定数据,即修改了原列表,故列表为可变类型数据(里面的数据支持修改,后面会讲解一些不可变类型数据)。
2.3.2 extend()方法
列表结尾追加数据,如果数据是一个序列,则将这个序列的数据逐一添加到列表。
list1 = ['Tom', 'Rose', 'Jack']
# 1、使用extend方法追加元素"Jennify"
names.extend("Jennify")
print(names)

# 2、建议:使用extend方法两个列表进行合并
list2 = ['Hack', 'Jennify']
list1.extend(list2)

print(list1)

#小伙伴们记得自己练习哦
2.3.3 insert()方法
作用:在指定的位置增加元素
#insert的格式
insert(索引, 元素)
names = ['薛宝钗', '林黛玉']
# 在薛宝钗和林黛玉之间,插入一个新元素"贾宝玉"
names.insert(1, '贾宝玉')
print(names)注意:执行names.insert(1,贾宝玉),就是把 “贾宝玉” 插入到索引 1 的位置,插入后原索引 1 及之后的元素会自动后移。
2.4 删操作
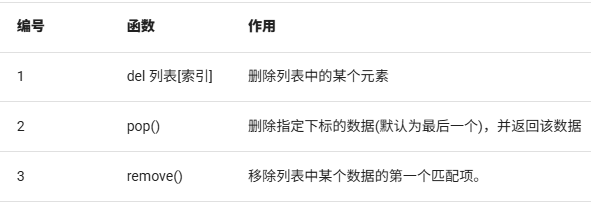
2.4.1 del删除指定的列表元素
基本语法:
names = ['Tom', 'Rose', 'Jack', 'Jennify']
# 删除Rose
del names[1]
# 打印列表
print(names)
2.4.2 pop()方法
作用:删除指定下标的元素,如果不填写下标,默认删除最后一个。其返回结果:就是删除的这个元素。
names = ['貂蝉', '吕布', '董卓']
del_name = names.pop()
# 或
# del_name = names.pop(1)
print(del_name)
print(names)
2.4.3 remove()方法
作用:删除匹配的元素
fruit = ['apple', 'banana', 'pineapple']
#删除banana
fruit.remove('banana')
#打印结果
print(fruit)
2.5 改操作
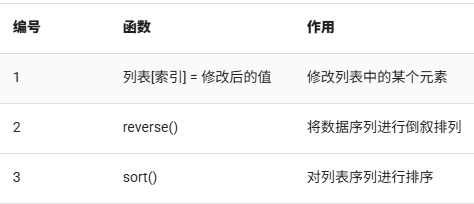
2.5.1 列表[索引] = 修改后的值
# 1. 列表元素的直接修改(通过索引赋值)
# 定义一个包含4个字符串元素的列表,存储人名
list1 = ['貂蝉', '大乔', '小乔', '八戒']
# 列表索引从0开始:索引0=貂蝉,1=大乔,2=小乔,3=八戒
# 通过「索引赋值」修改列表第4个元素(索引3),将"八戒"替换为"周瑜"
list1[3] = '周瑜'
# 打印修改后的list1
print(list1)
2.5.2 reverse()
# 2. 列表反转(reverse()方法)
# 定义一个包含6个整数的有序列表
list2 = [1, 2, 3, 4, 5, 6]
# 调用列表的reverse()方法:将列表元素顺序「原地反转」(直接修改原列表,不创建新列表)
list2.reverse()
# 打印反转后的list2
print(list2)注意:reverse () 就一个简单作用:把列表里的元素 “倒过来排”,不改变元素本身,只换顺序,而且直接改原来的列表。
2.5.3 sort()
# 3. 列表排序(sort()方法)
# 定义一个包含5个整数的无序列表
list3 = [10, 50, 20, 30, 1]
# 调用列表的sort()方法:默认按「升序(从小到大)」排序,同样是原地修改原列表
list3.sort()  # 升序(从小到大)
# 若需降序排序,可取消下一行注释:sort(reverse=True) 表示反转排序结果(即从大到小)
# list3.sort(reverse=True)  # 降序(从大到小)
# 打印排序后的list3
print(list3)
三、列表的循环遍历
循环遍历就是使用while或for循环对列表中的每个数据进行打印输出,相当于有一个背包(容器),里面有很多书(元素),把每本书都拿出来(打印)
3.1 while循环:
list1 = ['貂蝉', '大乔', '小乔']

# 定义计数器
i = 0
# 编写循环条件,len(list1)表示list1的长度(列表里元素的总个数)
while i < len(list1):
    print(list1[i])
    # 更新计数器
    i += 1
3.2 for循环(个人比较推荐):
list1 = ['貂蝉', '大乔', '小乔']
“‘‘
i代表list1里面的元素,也可以写a,b,
因为这里的i不是固定的 “某个元素”,而是循环过程中,当前被选中元素的 “临时名字”。
’’”

for i in list1:
    print(i)
注意: while循环,必须要更新计数器,否则会进入死循环。
四、列表的嵌套
列表的嵌套:列表中又有一个列表,我们把这种情况就称之为列表嵌套,在其他编程语言中,叫做二维数组或多维数组
案例:
# 定义班级名称列表(外层容器:存3个班级)
classes = ['第一个班级','第二个班级','第三个班级']

# 每个班级对应的学员列表(3个独立的内层容器:分别存每个班的学员)
一班学员 = ['张三', '李四']
二班学员 = ['王五', '赵六']
三班学员 = ['田七', '钱八']

# 把班级和学员信息合并成「嵌套列表」(大背包里装3个小背包,每个小背包对应一个班的学员)
# 外层列表students:对应3个班级;内层每个子列表:对应班级里的学员
students = [['张三', '李四'], ['王五', '赵六'], ['田七', '钱八']]

# 示意说明:students本质是「外层列表包含3个内层子列表」
# x 等价于第一个班的学员列表 ['张三', '李四'](对应classes[0])
# y 等价于第二个班的学员列表 ['王五', '赵六'](对应classes[1])
# z 等价于第三个班的学员列表 ['田七', '钱八'](对应classes[2])
students = [x, y, z]  # 这里x/y/z是「子列表的占位符」,实际就是上面3个班级的学员列表

# 验证:外层列表的索引0(第一个元素),就是第一个班的学员子列表
students[0] == ['张三', '李四']  # 结果为True,说明索引0对应一班学员

# 嵌套列表的「二次索引」:先取外层列表的元素(班级),再取内层子列表的元素(学员)
# students[0]:外层索引0 → 取第一个班的学员子列表 ['张三', '李四']
# [1]:内层索引1 → 取这个子列表里的第2个学员(索引从0开始:0=张三,1=李四)
print(students[0][1]) # 输出结果:李四Q:嵌套后的列表,我们应该如何访问呢?
A:可以利用之前学到的列表的查操作和循环遍历查找对应元素。
# 1. 访问并打印指定学员:李四
# students[0]:外层索引0 → 取第一个班级的学员子列表 ['张三', '李四']
# [1]:内层索引1 → 取该子列表的第2个元素(索引从0开始,1对应李四)
print(students[0][1])  # 输出结果:李四

# 2. 遍历嵌套列表,获取每个班级的完整学员信息
# for循环遍历外层列表students:i是临时变量,每次循环指代一个「班级的学员子列表」
# 第一次循环i = ['张三', '李四'](一班学员),第二次i = ['王五', '赵六'](二班),第三次i = ['田七', '钱八'](三班)
for i in students:
    print(i)  # 打印当前班级的所有学员(即整个子列表)
五、元组的定义
5.1 元组有啥用
Q:如果想要存储多个数据,但是这些数据是不能修改的数据,怎么做?
A:元组可以存多个 “不能改、不能动” 的数据,防止不小心误删、误改。一句话:元组 = “锁死的列表”,专门存多个不能动的固定数据。
5.2 定义
元组特点:定义元组使用小括号,且使用逗号隔开各个数据,数据可以是不同的数据类型。
基本语法:
# 多个数据元组
tuple1 = (10, 20, 30)

# 单个数据元组
tuple2 = (10,)注意:就算定义的元组只有一个数据,这个数据后面也要添加逗号,否则是你存的那个 “唯一数据” 本身的类型
比如:a = (10)(没加逗号)唯一数据是 “10”,它本身是整数类型→ 变量 a 的类型就是整数,不是元组
六、元组的相关操作方法
由于元组中的数据不允许直接修改,所以其操作方法大部分为查询方法。
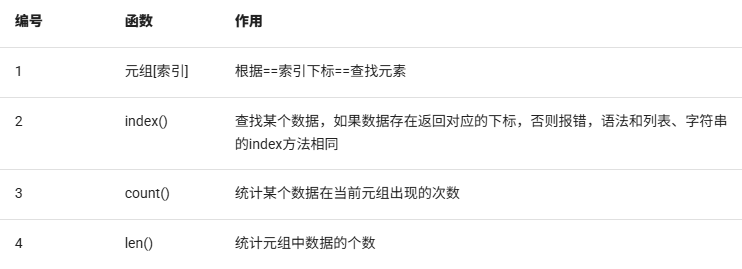
案例1:访问元组中的某个元素
nums = (10, 20, 30)
print(nums[2])
案例2:查找某个元素在元组中出现的位置,存在则返回索引下标,不存在则直接报错
nums = (10, 20, 30)
print(nums.index(20))
案例3:统计某个元素在元组中出现的次数
nums = (10, 20, 30, 50, 30)
print(nums.count(30))
案例4:len()方法主要就是求数据序列的长度,字符串、列表、元组
nums = (10, 20, 30, 50, 30)
print(len(nums))
七、练习案例
小伙伴们,不是小弟pua大家,但是练习真的真重要,首先可以发现错误,其次熟悉函数,最后,希望有时间的小伙伴们练习练习。
下面是一些案例,可以进行练习:
1. 求相邻元素最大值.编写一个程序,求一个正整数数组中每对相邻元素的最大值。 例如, 输入: [7 8 9 5 6 7 2 3] 输出: [8, 9, 9, 6, 7, 7, 3]
2. 编写一个程序来提取嵌套元组中的唯一元素。 例如: 在嵌套元组((1,2,3),(2,4,6),(2,3,5))中, 2重复出现了3次,3重复出现了2次,但我们的输出列表只会包含2、3一次。 即:[1, 2, 3, 4, 5, 6]
八、总结
小伙伴们,今天的内容有点多,大家学习的时候可以分几部分进行学习,开始先慢慢了解,再熟悉掌握,主要还是记住关键字。有一些方法提供了多种操作方式,大家可以选择一种自己喜欢的操作方式,其他进行了解就行。后续会进行剩余两种容器的分享。
有一些地方标注了需要注意的地方,大家记得看一眼,了解一下,看代码的时候记得看一下注释,写的都很清楚。不太了解的内容可以发布在评论区或者问一下大模型,后续我给大家分享一些ai辅助创作代码的工具。
上述内容会根据大家的评论和实际情况进行实时更新和改进。
麻烦小伙伴们动一动发财的小手,给小弟点个赞和收藏,如果能获得小伙伴的关注将是我无上的荣耀和前进的动力。
小伙伴们,我是AI大佬的小弟,希望大家喜欢!!!
晚安,小伙伴们。
更多推荐


 47
 0
- 0


 已为社区贡献36条内容

所有评论(0)