
深度学习实验——Pytorch实现猴痘病识别
·
- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
文章目录
1. 简介 & 数据集介绍
通过图片集识别猴痘病
图片集中有980张猴痘病图片,1162张正常或其他病图片。
2. 环境
- 语言环境:Python 3.12.7
- 编译器:Jupyter Notebook
- 深度学习环境:torch—2.8.0 + cu126 / torchvision—0.23.1+cu126
3. 代码实现
3.1 前期准备
3.1.1 设置GPU & 导入库
import torch
import torch.nn as nn
import torchvision.transforms as transforms
import torchvision
from torchvision import transforms, datasets
import os, PIL, random, pathlib
import torch.nn.functional as F
import matplotlib.pyplot as plt
from PIL import Image

#隐藏警告
import warnings
from datetime import datetime

warnings.filterwarnings("ignore")               #忽略警告信息
plt.rcParams['font.sans-serif']    = ['SimHei'] # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False      # 用来正常显示负号
plt.rcParams['figure.dpi']         = 100        #分辨率

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

device
3.1.2 标签查看
data_dir = './Data/4-data/'
data_dir = pathlib.Path(data_dir)

data_paths = list(data_dir.glob('*'))
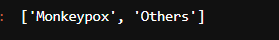
classNames = [str(path).split("\\")[2] for path in data_paths]
classNames
3.2 CNN 模型
3.2.1 图片转换读取
total_dir = './Data/4-data/'

train_transforms = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

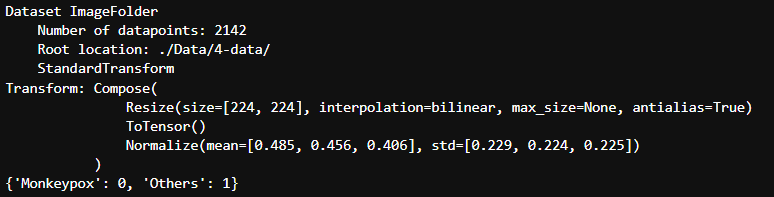
total_data = datasets.ImageFolder(total_dir, transform=train_transforms)
print(total_data)
print(total_data.class_to_idx)
3.2.2 数据集划分
train_size = int(0.8 * len(total_data))
test_size = len(total_data) - train_size
train_dataset, test_dataset = torch.utils.data.random_split(total_data, [train_size, test_size])
train_dataset, test_dataset
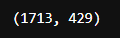
train_size,test_size
batch_size = 32

train_dl = torch.utils.data.DataLoader(train_dataset,batch_size=batch_size, shuffle=True, num_workers=1)
test_dl = torch.utils.data.DataLoader(test_dataset, batch_size=batch_size, shuffle=True, num_workers=1)

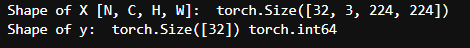
for X, y in test_dl:
    print("Shape of X [N, C, H, W]: ", X.shape)
    print("Shape of y: ", y.shape, y.dtype)
    break
3.2.3 CNN 模型建立
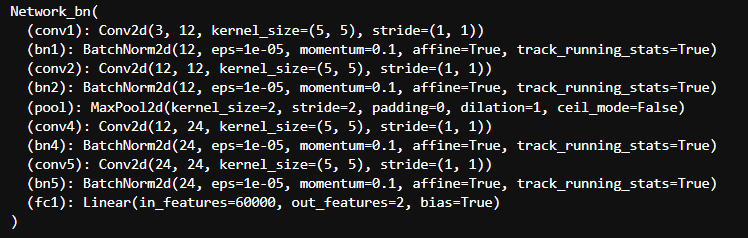
class Network_bn(nn.Module):
    def __init__(self):
        super(Network_bn, self).__init__()
        self.conv1 = nn.Conv2d(in_channels=3, out_channels=12, kernel_size=5, stride=1, padding=0)
        self.bn1 = nn.BatchNorm2d(12)
        self.conv2 = nn.Conv2d(in_channels=12, out_channels=12, kernel_size=5, stride=1, padding=0)
        self.bn2 = nn.BatchNorm2d(12)
        self.pool = nn.MaxPool2d(2, 2)
        self.conv4 = nn.Conv2d(in_channels=12, out_channels=24, kernel_size=5, stride=1, padding=0)
        self.bn4 = nn.BatchNorm2d(24)
        self.conv5 = nn.Conv2d(in_channels=24, out_channels=24, kernel_size=5, stride=1, padding=0)
        self.bn5 = nn.BatchNorm2d(24)
        self.fc1 = nn.Linear(24*50*50, len(classNames))

    def forward(self, x):
        x = F.relu(self.bn1(self.conv1(x)))
        x = F.relu(self.bn2(self.conv2(x)))
        x = self.pool(x)
        x = F.relu(self.bn4(self.conv4(x)))
        x = F.relu(self.bn5(self.conv5(x)))
        x = self.pool(x)
        x = x.view(-1, 24*50*50)
        x = self.fc1(x)
        return x

model = Network_bn().to(device)
model
3.2.4 训练 & 测试函数
# 训练循环
def train(dataloader, model, loss_fn, optimizer):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    train_loss, train_acc = 0, 0
    for X, y in dataloader:
        X, y = X.to(device), y.to(device)

        # 计算预测误差
        pred = model(X)          # 网络输出
        loss = loss_fn(pred, y)  # 计算网络输出和真实值之间的差距,targets为真实值,计算二者差值即为损失

        # 反向传播
        optimizer.zero_grad()  # grad属性归零
        loss.backward()        # 反向传播
        optimizer.step()       # 每一步自动更新
        train_acc += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss += loss.item()

    train_acc  /= size
    train_loss /= num_batches

    return train_acc, train_loss

# 测试循环
def test (dataloader, model, loss_fn):
    size = len(dataloader.dataset)
    num_batches = len(dataloader)
    test_loss, test_acc = 0, 0
    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            # 计算loss
            target_pred = model(imgs)
            loss = loss_fn(target_pred, target)
            test_loss += loss.item()
            test_acc += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc /= size
    test_loss /= num_batches

    return test_acc, test_loss
3.2.5 参数设定 & 正式训练
loss_fn = nn.CrossEntropyLoss()
learn_rate = 1e-4 # 学习率
opt = torch.optim.SGD(model.parameters(),lr=learn_rate)
epochs = 20
train_loss = []
train_acc = []
test_loss = []
test_acc = []

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, opt)
    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)
    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

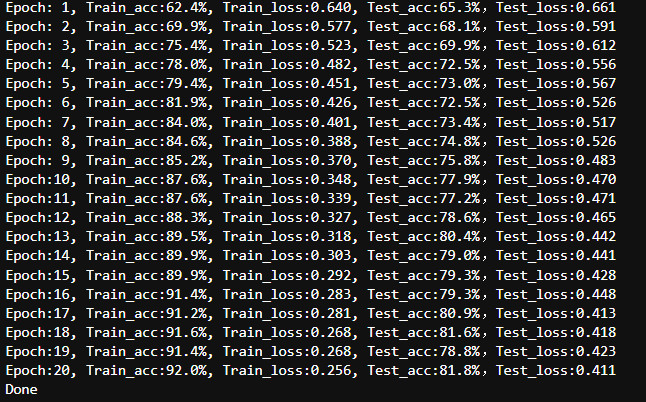
    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%,Test_loss:{:.3f}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss, epoch_test_acc*100, epoch_test_loss))
print('Done')
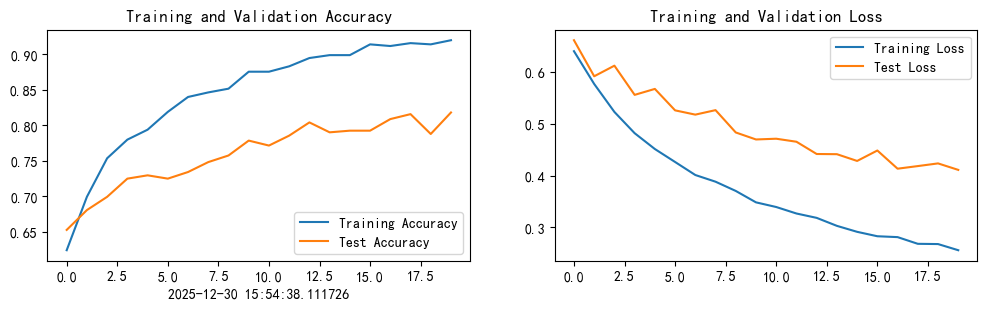
3.2.6 结果可视化
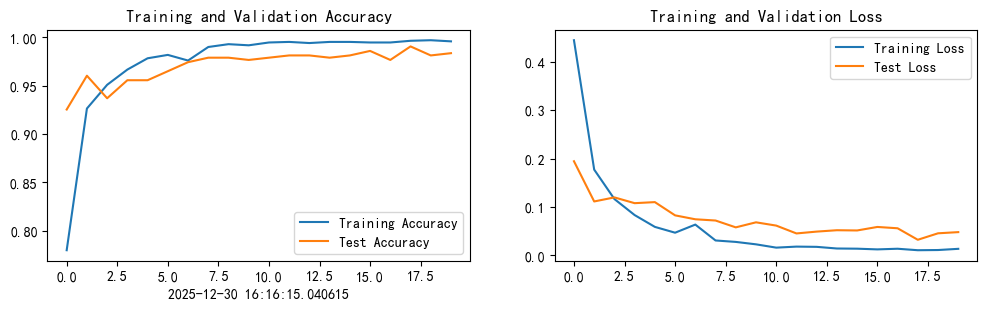
epochs_range = range(epochs)
current_time = datetime.now() # 获取当前时间

plt.figure(figsize=(12, 3))
plt.subplot(1, 2, 1)

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.xlabel(current_time)

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
3.2.7 预测指定本地照片
classes = list(total_data.class_to_idx)

def predict_one_image(image_path, model, transform, classes):

    test_img = Image.open(image_path).convert('RGB')
    test_img = transform(test_img)
    img = test_img.to(device).unsqueeze(0)
    model.eval()
    output = model(img)

    _,pred = torch.max(output,1)
    pred_class = classes[pred]
    print(f'预测结果是:{pred_class}')

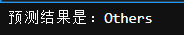
# 预测训练集中的某张照片
predict_one_image(image_path='./Data/4-data/Others/NM01_01_00.jpg',
                  model=model,
                  transform=train_transforms,
                  classes=classes)
3.2.8 模型保存并加载
# 模型保存并加载
PATH = './model.pth'
torch.save(model.state_dict(), PATH)
model.load_state_dict(torch.load(PATH, map_location=device))
4. 代码优化
4.1 问题分析
当前模型存在的两个主要问题:
1.过拟合 (Overfitting): 训练集准确率 (92%) 远高于测试集 (81.8%),且 Loss 差距较大。这意味着模型记住了训练数据,但没学到通用特征。
2.数据量小:训练集只有约 1700 张图片。对于深度卷积神经网络来说,这个数据量太小了。网络还没有学会如何提取复杂的特征(如皮肤病变的纹理),就已经陷入了局部最优解,或者因为模型参数过多而无法收敛。
4.2 解决方案
- 数据增强 (Data Augmentation): 在训练集中加入随机翻转和旋转,让模型“见多识广”,强迫它学习物体的本质特征而不是位置。
train_transforms = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.RandomHorizontalFlip(),  # 随机水平翻转
    transforms.RandomRotation(15),      # 随机旋转 +/- 15度
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])

# 测试集不需要增强,只需要标准化
test_transforms = transforms.Compose([
    transforms.Resize([224, 224]),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
])
- 迁移学习
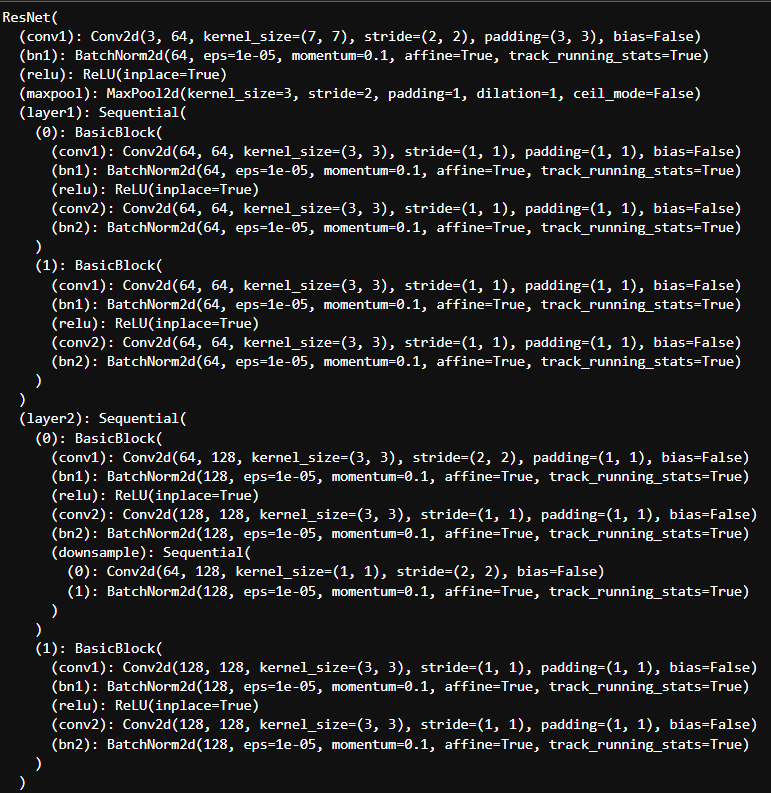
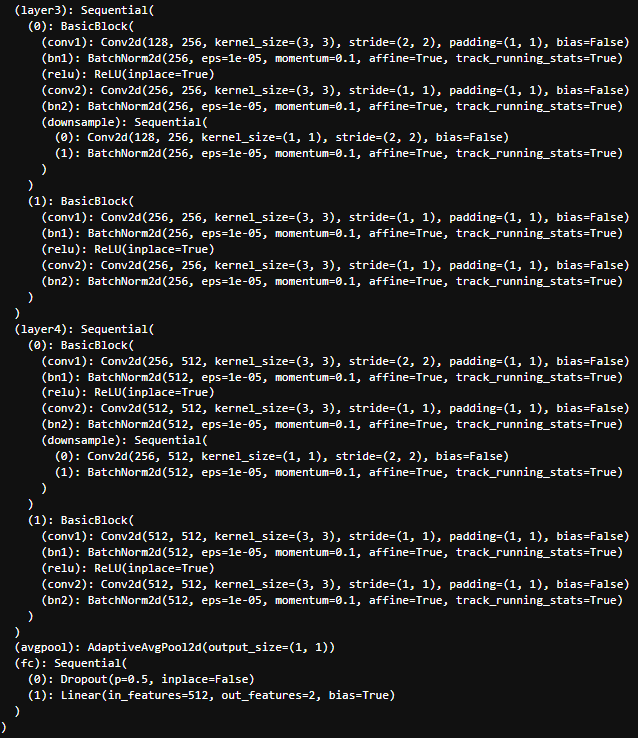
直接使用一个已经在 ImageNet(1400万张图)上训练好的模型(如 ResNet18),保留它强大的“视觉能力”,只重新训练它的“分类头”。
import torchvision.models as models

# --- 核心修改:使用预训练的 ResNet18 ---
def get_pretrained_model(num_classes):
    # 加载预训练模型 (weights='DEFAULT' 相当于 pretrained=True)
    model = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)
    num_ftrs = model.fc.in_features
    model.fc = nn.Sequential(
        nn.Dropout(0.5),  # 加个 Dropout 防止过拟合
        nn.Linear(num_ftrs, num_classes)
    )

    return model

# 初始化模型
model = get_pretrained_model(len(classNames)).to(device)
print(model)

train_loss = []
train_acc = []
test_loss = []
test_acc = []

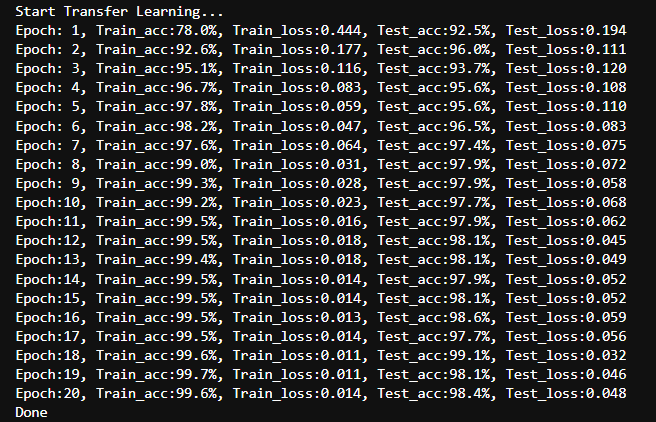
print("Start Transfer Learning...")

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, opt)

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    # 更新学习率
    if 'scheduler' in locals():
        scheduler.step()

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%, Test_loss:{:.3f}')
    print(template.format(epoch+1, epoch_train_acc*100, epoch_train_loss, epoch_test_acc*100, epoch_test_loss))

print('Done')
4.2 训练结果与可视化
更多推荐
 50
 0
- 0


 已为社区贡献29条内容

所有评论(0)