
嵌入向量--大模型的输入
大语言模型是在海量文本数据上进行预训练。然而,文本数据是离散的,无法直接用于执行神经网络训练所需的数学运算。因此,我们需要将文本数据转换为‘嵌入’的数值向量形式。下面我们学习如何为训练大模型准备输入数据。
词嵌入
首先我们了解什么是嵌入。嵌入(embedding)是将数据转换为向量格式的过程。
嵌入的本质是将离散对象(如单词、图像甚至整个文档)映射到连续向量空间中的点,主要目的是将非数值的数据转换为神经网络可以处理的格式。
文本分词
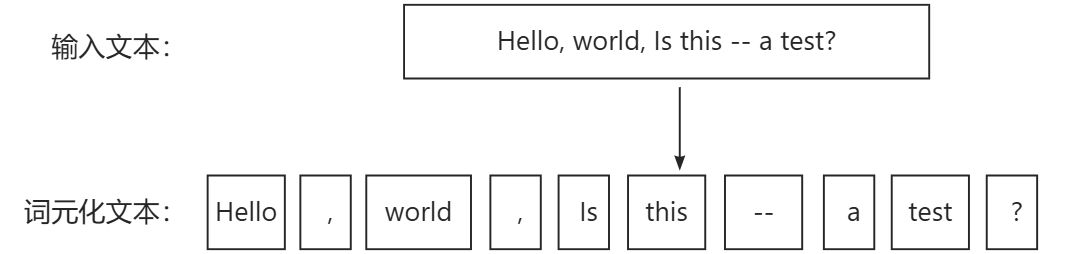
首先,我们将输入文本分割为独立的词元,词元既可以是单个单词,也可以是标点符号等特殊字符。
如下图,把文本分割为单个单词和标点符号。
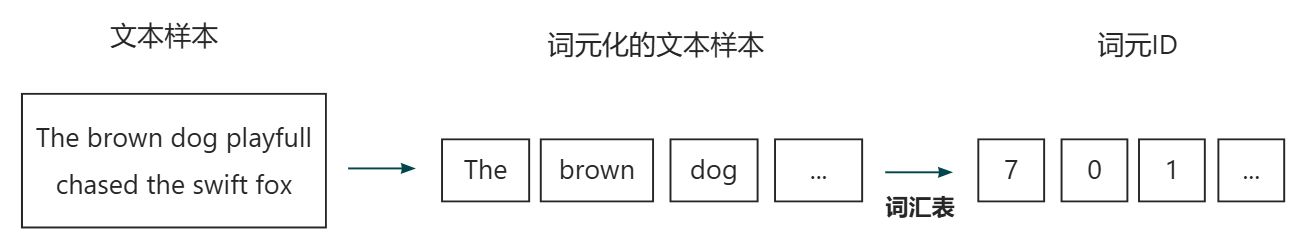
词元ID
把词元从字符串转换为整数表示,以生成词元 ID(token ID)。
词汇表
为了将词元映射到词元 ID,首先需要构建一张词汇表。这张词汇表定义了如何将每个单词和特殊字符映射到唯一的整数。
构建词汇表的过程:首先将训练集中的全部文本分词成独立的词元;然后将这些词元按字母顺序进行排列,并删除重复的词元;最后将唯一的词元聚合到一张词汇表中;该词汇表按顺序定义每个词元到唯一的整数值的映射。
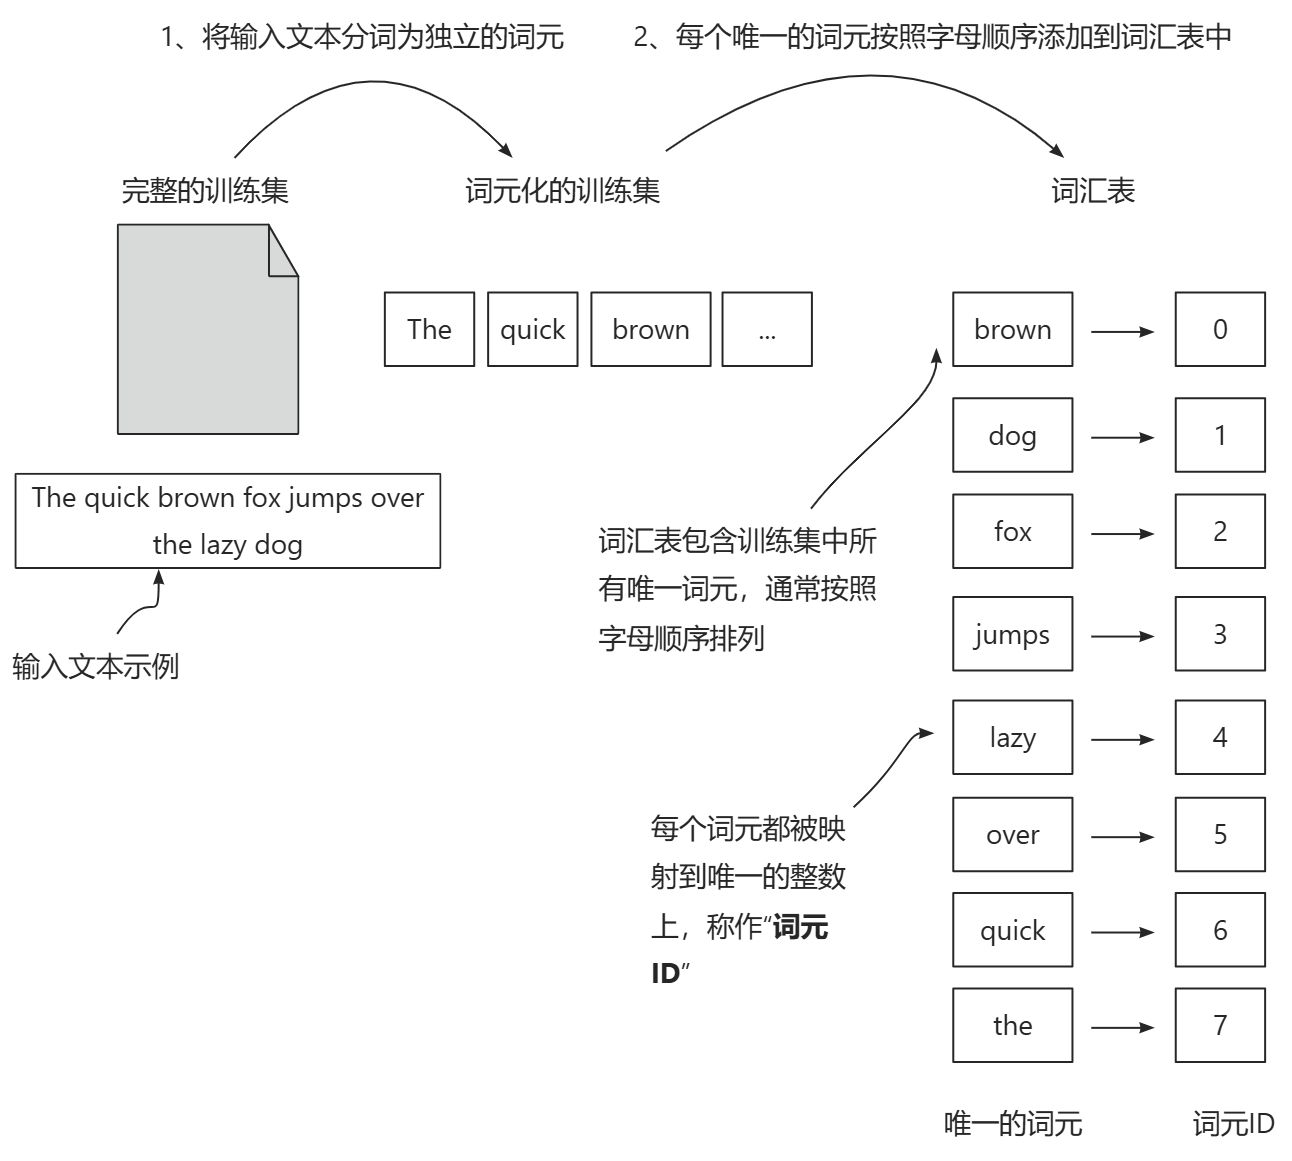
下图,展示获取词元ID过程。
特殊上下文词元
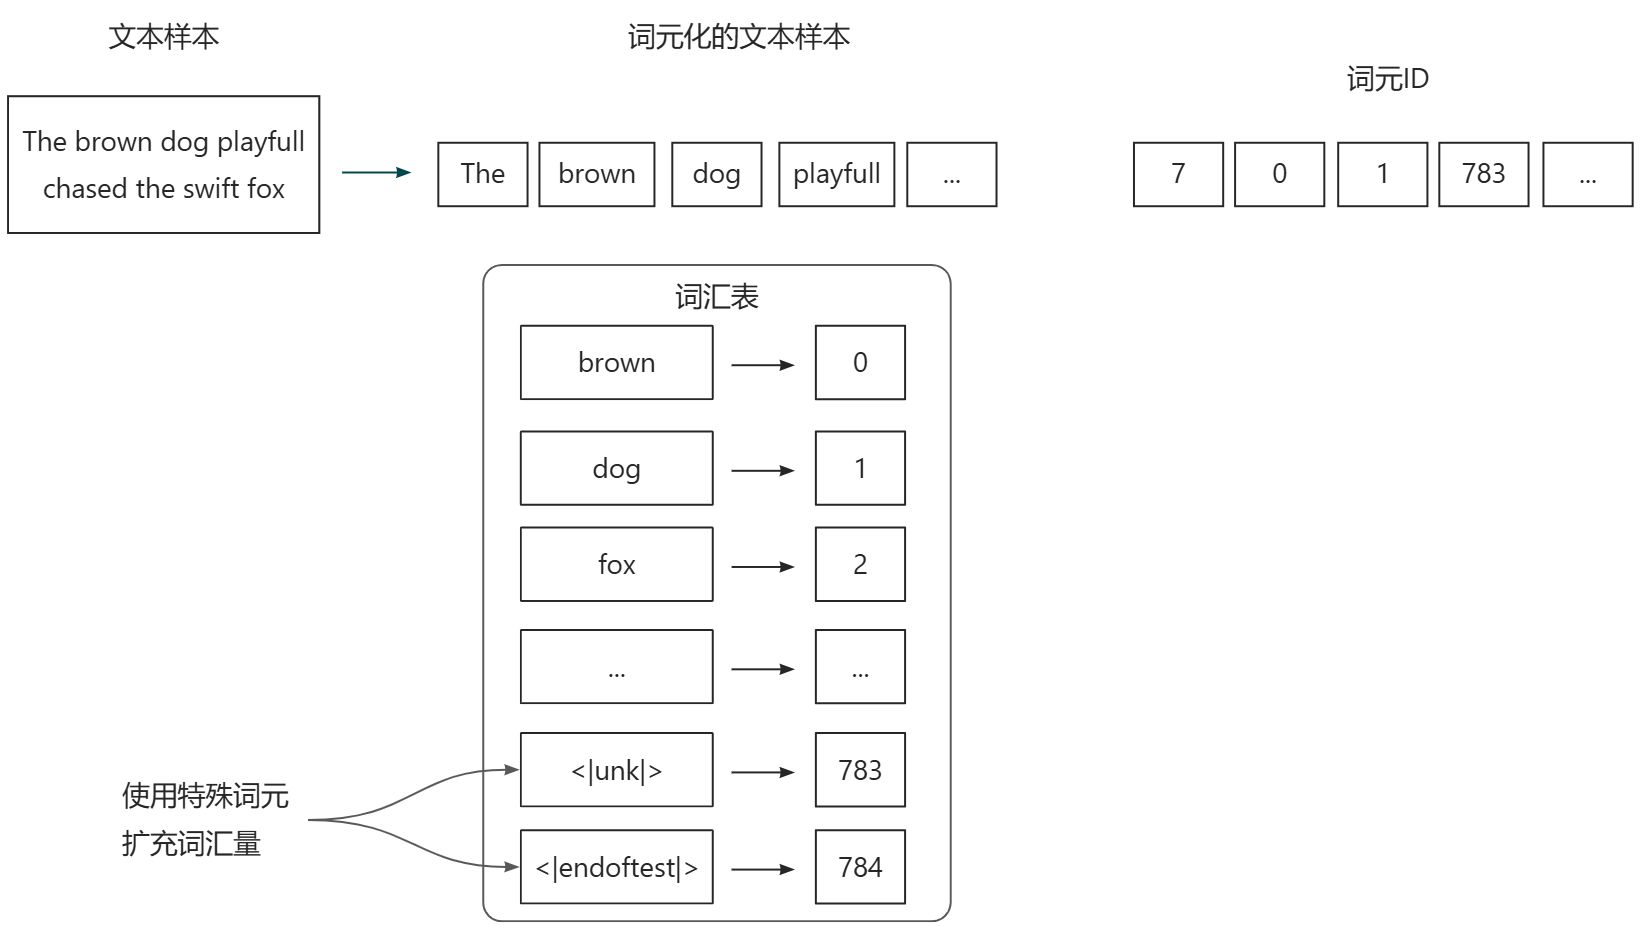
为了处理未知的单词,我们引入特殊上下文词元,来增强模型对上下文和其他相关信息的理解。
另外,文本源在训练时是连接在一起输入的,但它们实际上是相互独立的。因此我们在不相关的文本之间插入特殊词元。这有助于模型理解输入文本源。
BPE分词器
BPE分词器的算法原理是将不在预定义词汇表中的单词分解为更小的子词单元甚至单个字符,从而能够处理词汇表之外的单词。
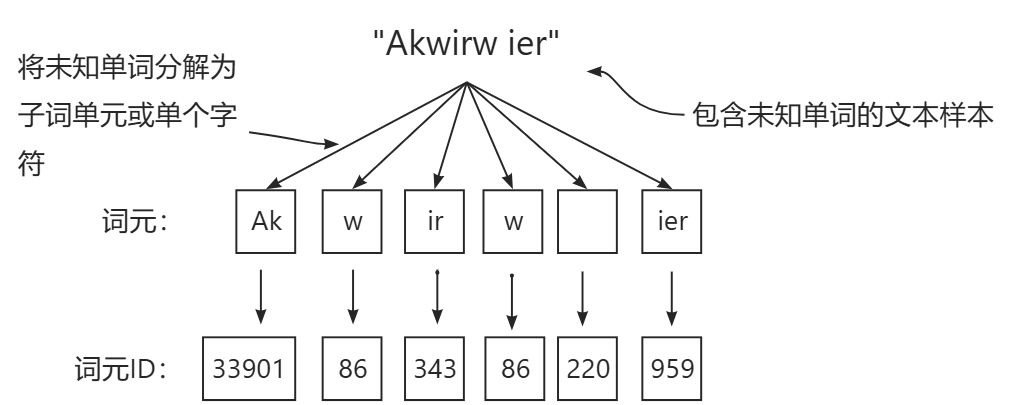
BPE通过将频繁出现的字符合并为子词,再将频繁出现的子词合并为单词,来迭代地构建词汇表。
词元嵌入
词元嵌入是将词元 ID转换为嵌入向量的过程。
由于类 GPT大语言模型使用反向传播算法(backpropagation algorithm)训练深度神经网络,因此需要连续的向量表示或嵌入。
权重矩阵
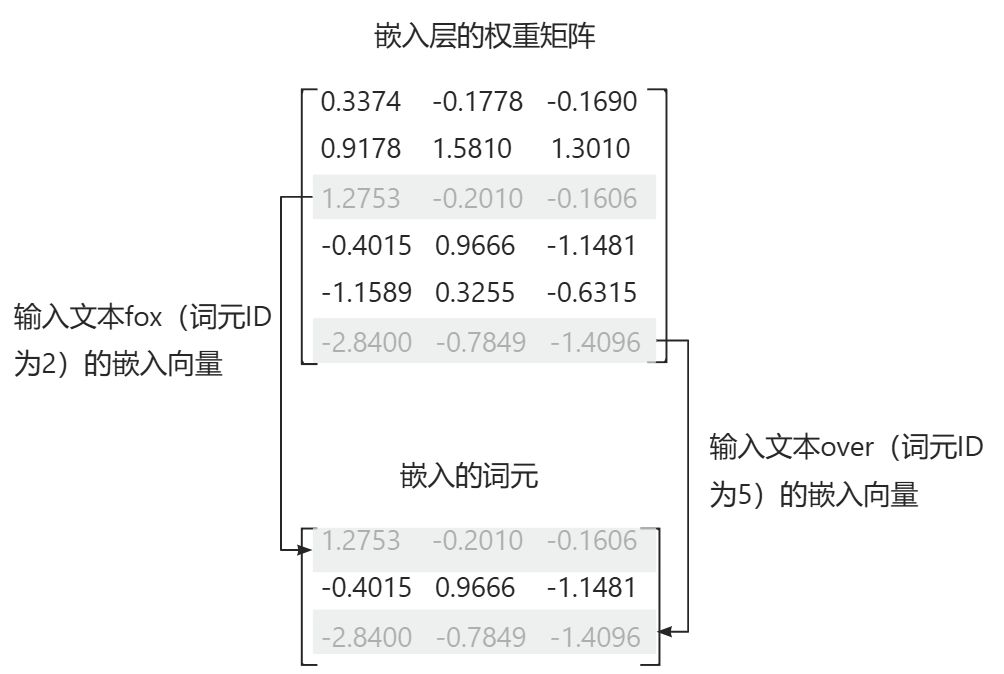
假设有一张只有6个单词的词汇表,并且创建维度为3的嵌入。从而获得一个6行3列的权重矩阵,其每一行对应词汇表中的一个词元,每一列对应一个嵌入维度。在初始阶段,必须用随机值初始化嵌入权重。
嵌入向量
在嵌人层执行查找操作,即从权重矩阵中检索词元id对应的嵌人向量。例如,词元id为5的嵌人向量位于嵌人层权重矩阵的第6行(因为phon的索引从0开始,所以它位于第6行而非第5行)。这就是将嵌入权重应用到词元ID上,从而获得嵌入向量。作为模型优化的一部分,这些值将在训练大语言模型的过程中被优化。
单词位置信息
嵌入层的工作机制导致词元ID无论在输入序列中的如何位置,相同的词元ID始终被映射到相同的向量表示。因此自注意力机制无法感知词元在序列中的位置或顺序。
我们可以采用两种位置信息嵌入策略:绝对位置嵌入和相对位置嵌入,为大模型提供词元在序列中的位置信息。
绝对位置嵌入(absolute positional embedding)直接与序列中的特定位置相关联。对于输入序列的每个位置,该方法都会向对应词元的嵌入向量中添加一个独特的位置嵌入,以明确指示其在序列中的确切位置。
相对位置嵌入(relative positional embedding)关注的是词元之间的相对位置或距离。这意味着模型学习的是词元之间的“距离”关系,而不是它们在序列中的“具体位置”。
以上两种位置嵌入都旨在提升大语言模型对词元顺序及其相互关系的理解能力,从而实现更准确、更具上下文感知力的预测。这些位置嵌入会在训练过程中被优化。
从文本到嵌入向量
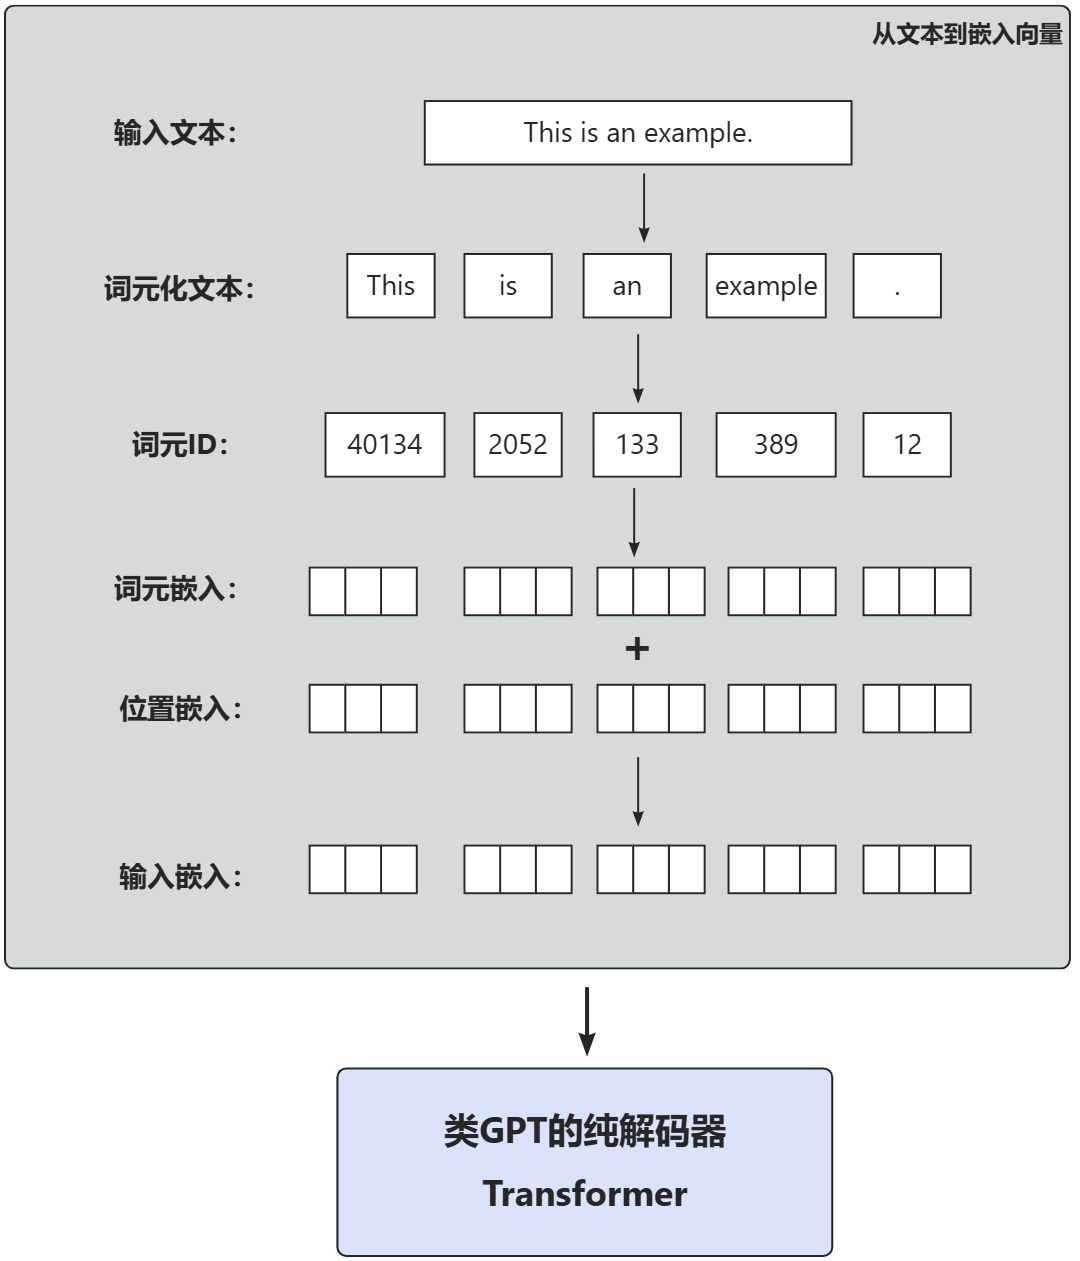
1,文本分割,将输人文本分割为独立的词元。
2,词汇表转换,词元通过查找BPE词汇表转换为词元id。
3,嵌入层查找,词元id通过嵌入层查找嵌入权重获得词元嵌入。
4,位置嵌入,再添加与词元嵌入大小相同的位置嵌人。
5,生成嵌入向量,将词元嵌入和位置嵌入结合,得到最终的嵌入向量。
大模型数据采样
大语言模型通过预测文本序列的下一个单词来进行预训练,如下图。
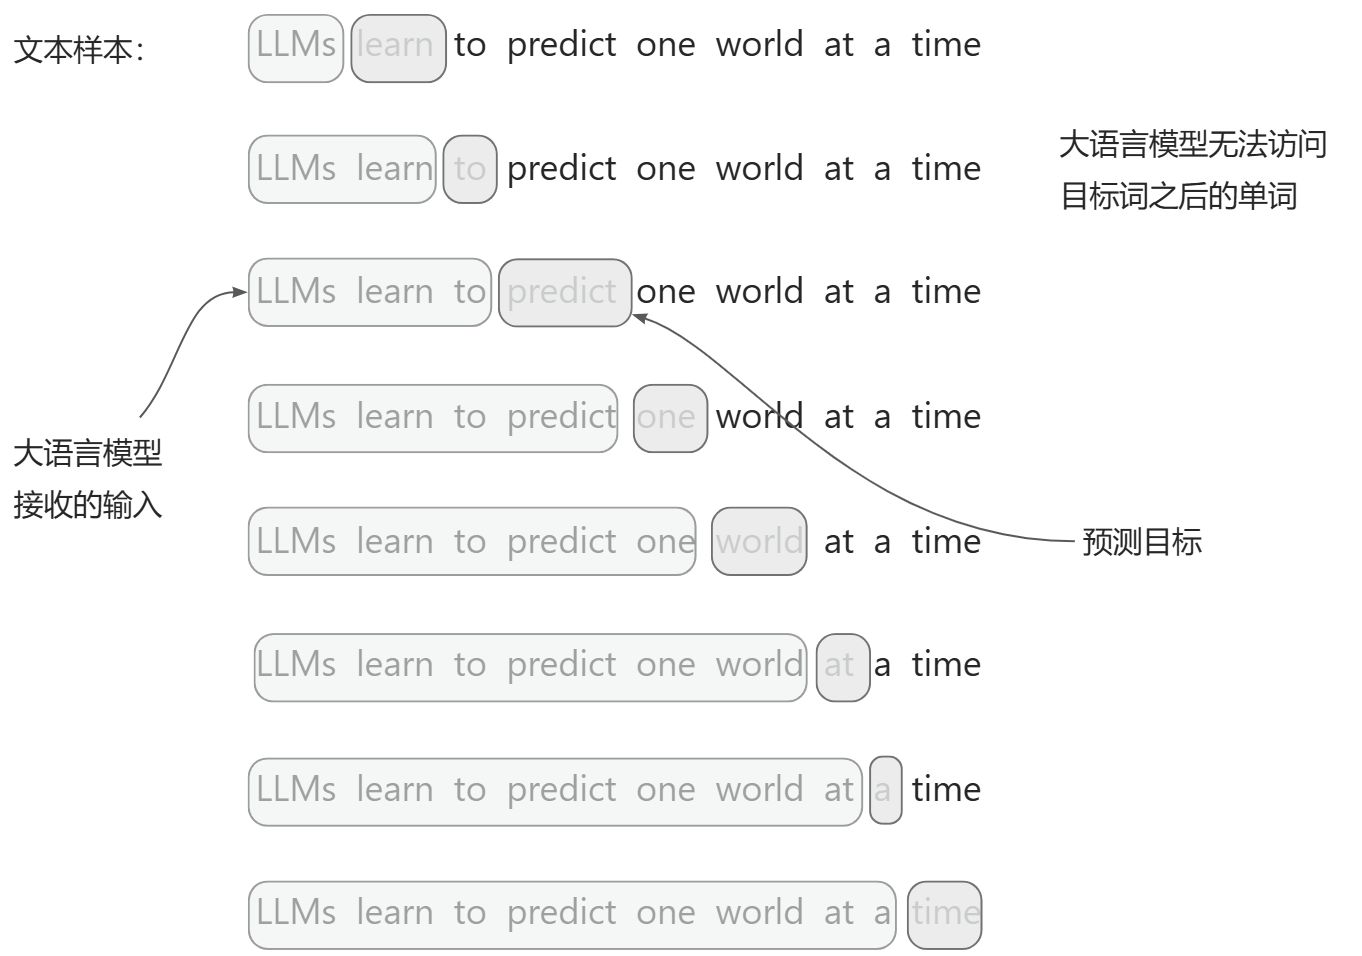
给定一个文本样本,我们从中提取子样本,作为输人块提供给大语言模型。在训练过程中,模型的任务是预测输人块之后的下一个词,我们会屏蔽目标词之后的所有单词。必须说明的是,在大语言模型处理文本之前,文本会经过分词处理,但为了更清晰地说明,这里省略了分词步骤。
我们可以通过滑动窗口进行数据采样。即通过处理输入及其相应的目标(将输入右移一个位置),创建下一单词预测任务。
数据加载器会遍历输入数据集,并将输入和目标以 PyTorch 张量的形式返回,这些PyTorch 张量可以被视为多维数组。
具体来说,我们的目标是返回两个张量:一个是包含大语言模型所见的文本输入的输入张量,另一个是包含大语言模型需要预测的目标词元的目标张量。
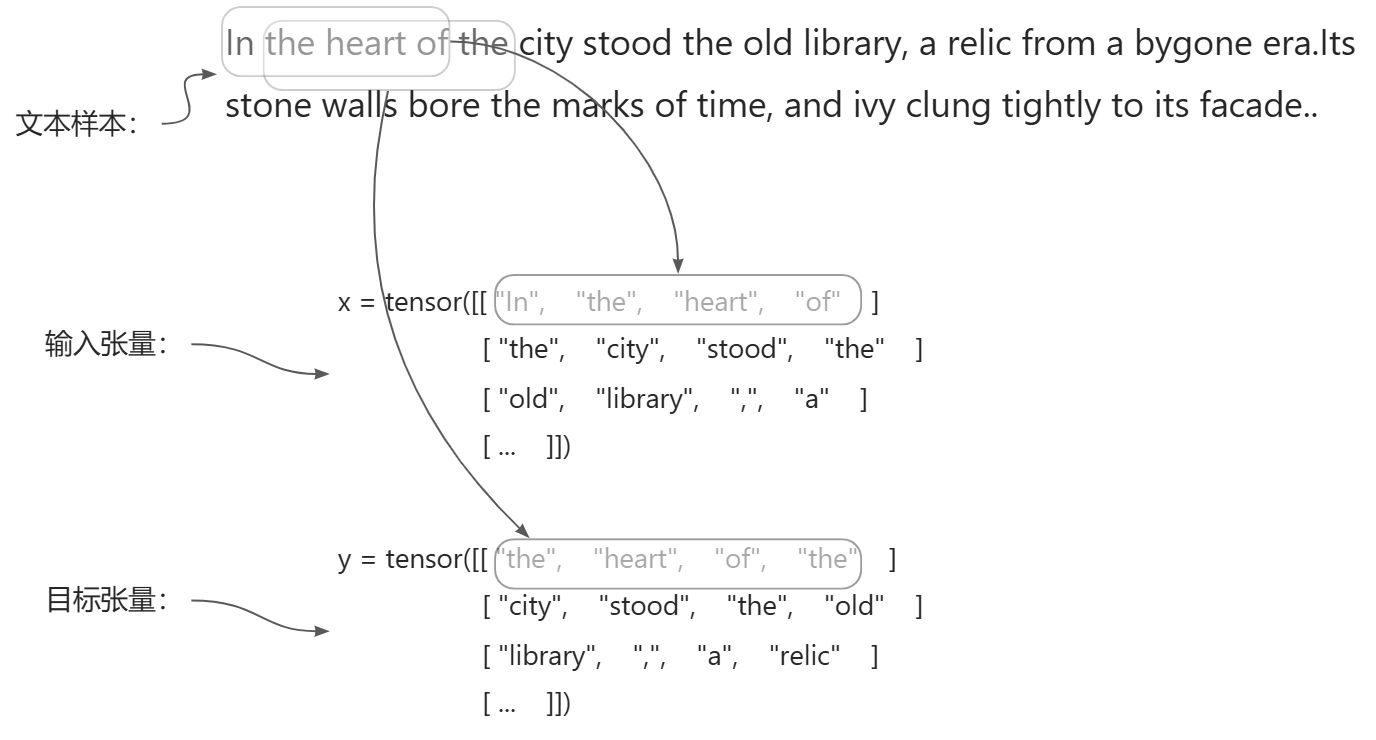
为了实现高效的数据加载器,我们将输人收集到张量x中,其中每行代表一个输人上下文。第二个张量,包含相应的预测目标(下一个词),它们是通过将输人移动一个位置创建的。
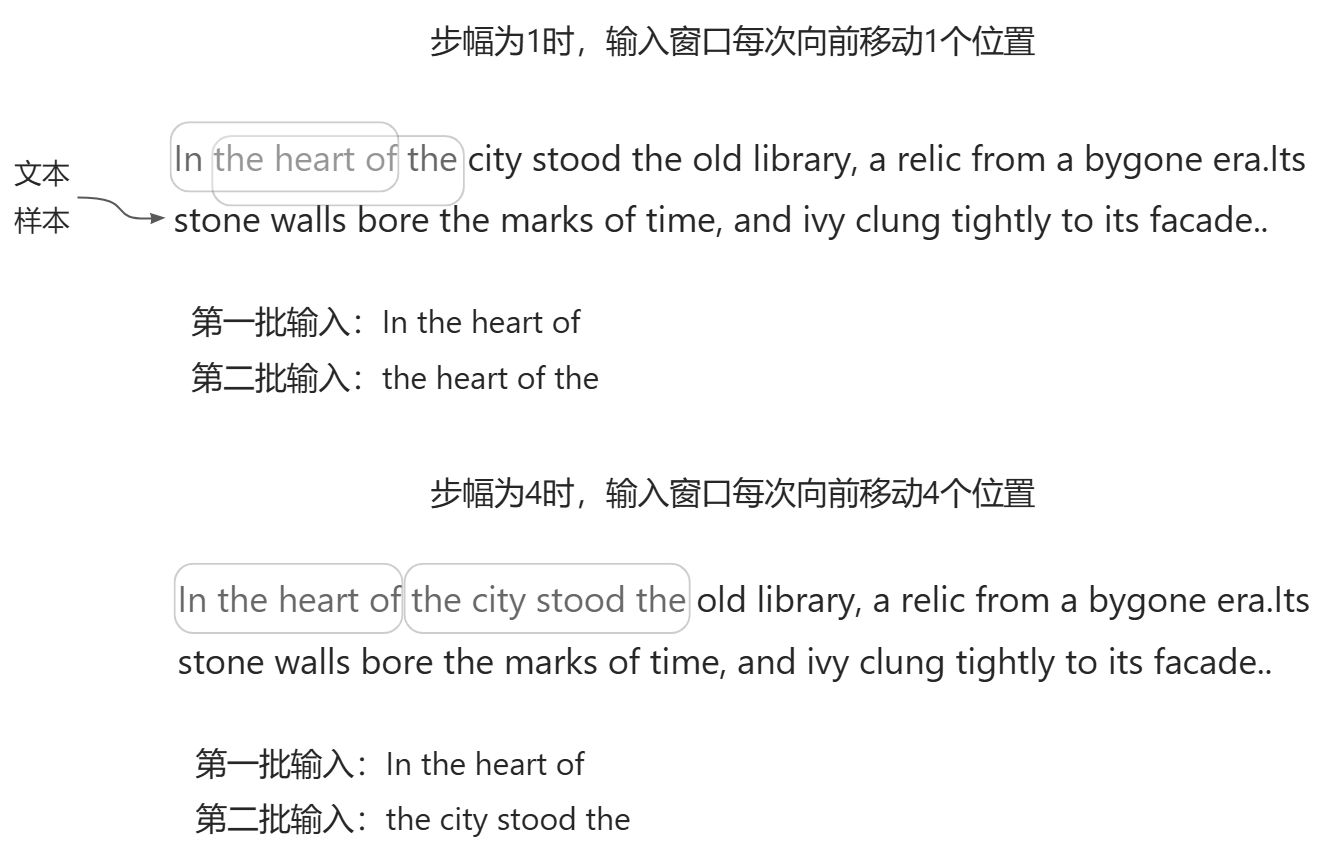
**步幅(**stride)决定批次之间输入的位移量,模拟滑动窗口方法。
通过在文本上滑动输人窗口来从输人数据集中生成多个批次的数据。如果步幅为1,那么在创建下一个批次时,输人窗口向前移动一个位置。如果步幅与输人窗口大小相等,则可以避免批次之间的重叠。
注意,过多的重叠可能会增加模型过拟合。
参考
《从零构建大模型》
更多推荐


 21
 0
- 0


 已为社区贡献7条内容

所有评论(0)