
深度学习:手写第一个线性模型
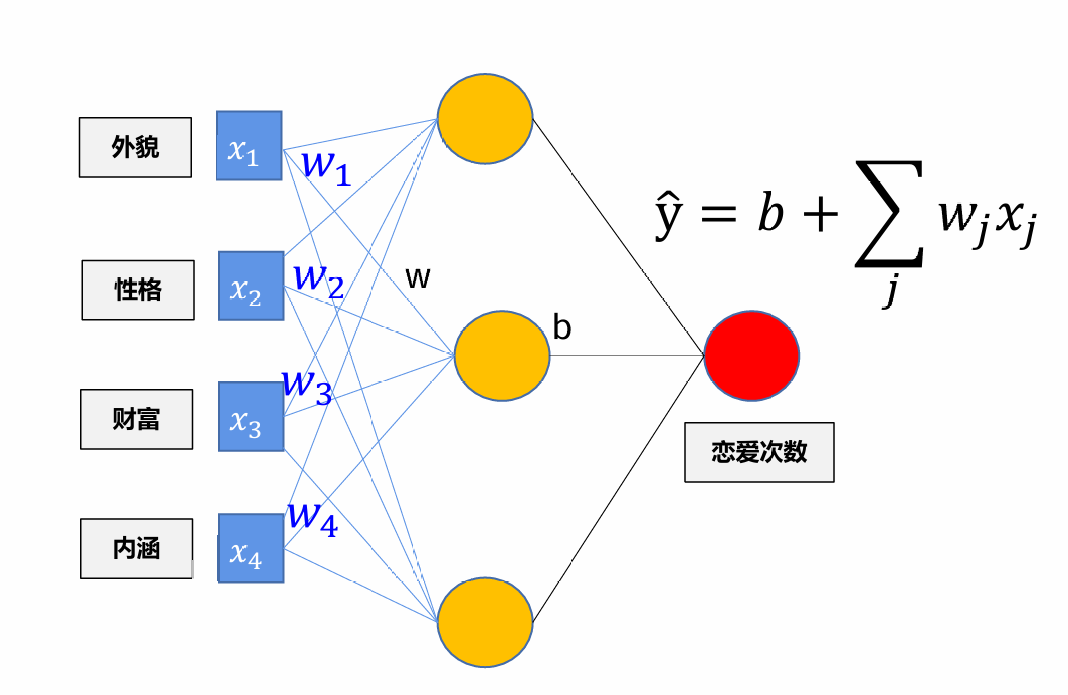
首先,由于我们没有原始数据,所以要先生成原始数据,这里使用使用random库生成随机的数据
def creat_data(w, b, data_num):
    x = torch.normal(0, 1, (data_num, len(w)))
    y = torch.matmul(x, w) + b
    noise = torch.normal(0, 0.01, y.shape)
    y += noise
    return x, y
这里定义了一个类create_data用于生成随机数据
x是特征(feature),y是标签(label)
x = torch.normal(0, 1, (data_num, len(w)))中,0表示平均值为0,1表示方差为1,()中的是x的形状
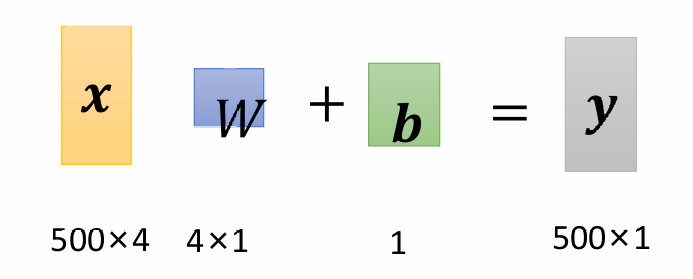
根据矩阵运算,x的行数是数据的个数,列数是权重的个数
利用公式得到y,这里需要注意,这里的x是一个形状为(500,4)的张量,w是一个形状为(4,)的张量,而b是一个零维的标量,这里利用了pytorch的广播规则,使得代码更简洁。
下面我们按照数据量num = 500生成原始数据
num = 500
true_w = torch.tensor([8.1, 2, 2, 4])
true_b = torch.tensor(1.1)
X, Y = creat_data(true_w, true_b, num)
注意这里我们给出了 true_w 和 true_b,这两个参数表示的是真实的权重和偏差,但在实际应用中是根本不存在这两个参数,或者说即使存在也无法确定其唯一性,我们找的是一组“最优的参数”。
而在此处,我们给出这两个参数只是为了生成一组“有明确规律、可控、带噪声”的合成数据(synthetic data)
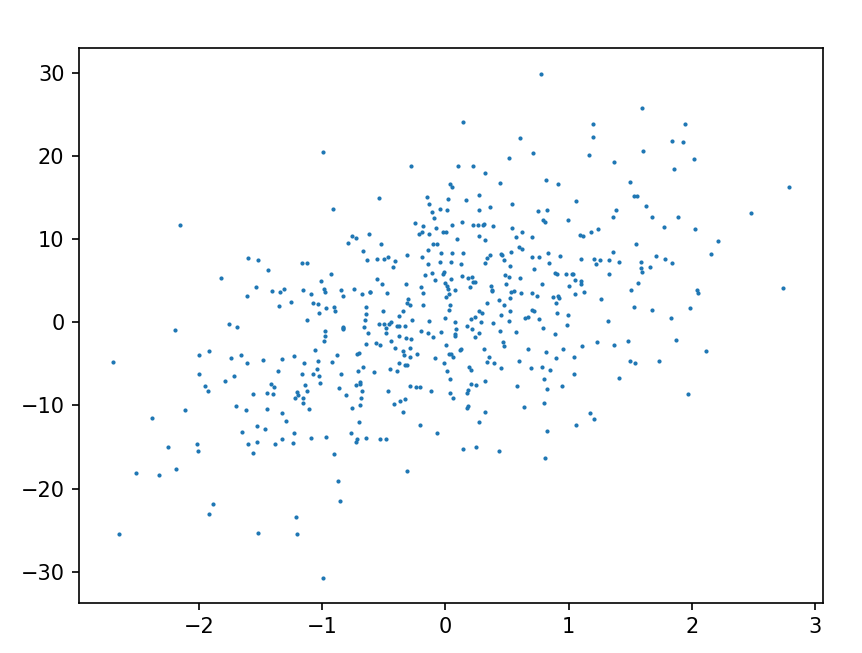
这里我们可以画出我们生成的数据
plt.scatter(X[:, 3], Y, 1)
plt.show()
这里涉及到plt.scatter()的使用,这个函数是画散点图,但是由于x是多维的,我们只能取其中某个维度与y进行比较,最后的1表示点的大小
下面一步,是设计一个数据批量处理生成器,将整个数据集打乱后,按批量提供数据。
def data_provider(data, label, batchsize):  # 每次访问这个函数就能提供一批数据
    length = len(label)  # 求出有多少个样本
    indices = list(range(length))  # indices是一个0-500按顺序存储的列表
    # 为了保证数据的普适性和随机性,要把数据打乱
    random.shuffle(indices)

    for each in range(0, length, batchsize):  # batchsize是这一批数据的数量,每次从0到500这么多数据中取batchsize这么多数据
        get_indices = indices[each: each + batchsize]
        get_data = data[get_indices]
        get_label = label[get_indices]

        yield get_data, get_label  # 有存档点的return
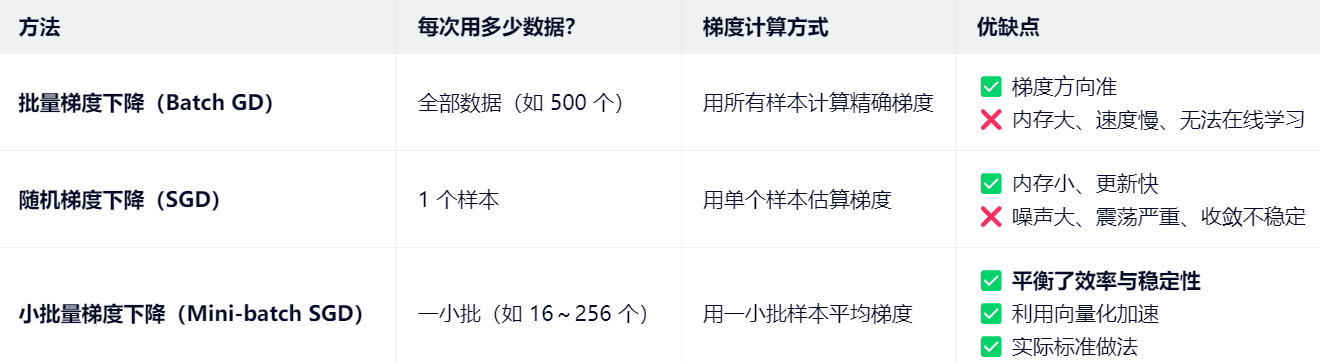
那么为什么要有这样一个数据生成器呢?为什么要分成小批次提供数据呢?而不是一次用全部数据,或一次只用一个样本?
这里涉及到了梯度下降的知识
在这段代码中,我们使用了 yield 函数,而没有使用 return 。这是因为,在普通函数中,用 return 返回结果后,函数就结束并销毁。而在 yield 函数中,函数不会立刻执行完,每次遇到yield 时,就暂停运行,把值吐出来,下次调用时,就从上次暂停的地方继续执行,知道函数自然结束或是再次遇到yield。
含有 yield 的函数,称为 生成器函数(generator function),调用它会返回一个 生成器对象(generator object),这个对象是可迭代的(iterable)
什么意思呢?我们的目的是不断从这批数据中抽出一小批次数据,使用了 yield 之后,就可以满足这一要求,按需提供。就像一个“自助售货机”,我们需要多少就拿多少,机器会保存内部状态。等我们下次调用这个函数时,他会在上次调用的状态下运行。
前面的步骤都是在对数据的处理,下面我们就要开始涉及我们的模型函数了
首先是线性模型的前向计算函数,得到预测值pred_y
def fun(x, w, b):
    pred_y = torch.matmul(x, w) + b
    return pred_y
、
然后我们设计损失函数,这里使用的是平均绝对损失
def maeLoss(pre_y, y):
    return torch.sum(abs(pre_y - y)) / len(y)
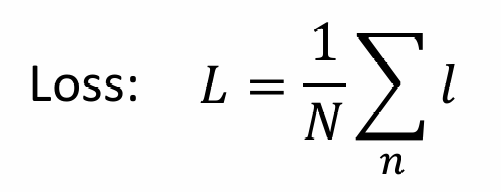
下面开始编写梯度下降优化器,这是深度学习循环中参数更新的核心步骤
def sgd(paras, lr):  # 梯度下降
    with torch.no_grad():  # 属于这句代码的部分,不计算梯度
        for para in paras:
            para -= para.grad * lr
            para.grad.zero_()  # 使用过的梯度,归0
paras:一个包含可学习参数的列表
lr:学习率(learning rate),控制每次更新的步长
在 Python 中,with 是一个上下文管理协议(Context Management Protocol) 的关键字,它的核心作用是:安全、自动地管理资源的获取与释放,确保即使发生异常,资源也能被正确清理。
这里 torch.no_grad() 是一个上下文管理器,它的作用是:
进入with块时 (__enter__) | 临时禁用 PyTorch 的自动求导(autograd) |
|---|---|
退出 with 块时 (__exit__) | 自动恢复之前的梯度计算状态 |
由于torch具有自动求导机制,在前向计算的过程中,torch会自动记录计算过程
但是这里梯度下降的过程是在更新参数,而并非计算过程,所以我们用
with torch.no_grad(): 这句代码表示下面的过程不需要计算梯度,也就无需记录过程
这就相当于一个餐馆的学徒在学习大厨做菜的过程中,大厨做菜就是前向过程,学徒会记录这个前向过程(盐放多少,糖放多少等等),但是最后做出来的味道存在偏差,需要调整配方,而这个调整的过程是不需要记录的,需要记录的只是最后的配方。
这里需要注意,torch的自动求导机制并不是说在前向过程中完成了求导,它只是记录了过程,当我们调用 .backward() 时它才会根据记录的过程实现求导。
梯度下降的更新公式如下
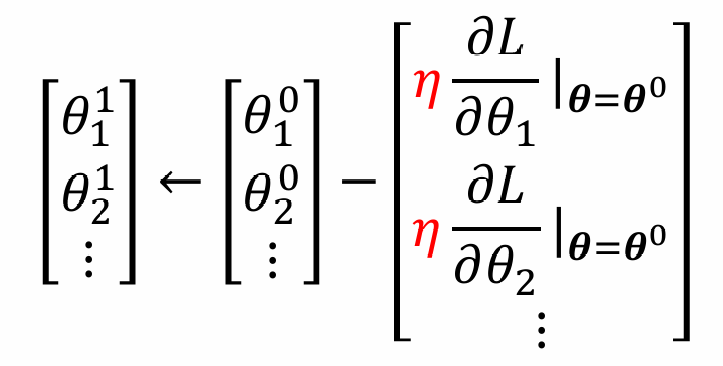
新参数 = 旧参数 - 学习率 * 梯度
para.grad.zero_() 的作用是“擦掉旧笔记,准备记新建议
因为pytorch会默认累计梯度,如果不清零,下次 .backward() 会把新梯度 + 旧梯度加在一起,导致错误的更新。
那么为什么会有累计梯度的存在呢?这是为了支持“小批量合成大批次”的训练技巧,有时候我们的显存不够,但是想要使用更大的 batchsize(例如batchsize = 64),那么就可以在前向过程中用batchsize = 16,连续进行4次不更新参数、不清零梯度,最后将这4次的梯度累计起来,再更新参数,也就相当于实现了batchsize = 64
至此,我们就写完了函数的部分
下面我们设置一下学习率lr = 0.03,并设置一个初始的参数(w_0、b_0)
w_0 = torch.normal(0, 0.01, true_w.shape, requires_grad=True)
这句代码是从正态分布中随机采样一组数,作为模型的初始权重(weights),均值为0,标准差为0,形状与true_w一致,注意这里关键的参数 requires_grad=True,这是在告诉PyTorch,这个张量是我模型的可训练参数。后续计算中,只要用到 w_0,PyTorch 就会记录操作,并在 .backward() 时自动计算它的梯度,训练时你就能用 w_0.grad 来更新它
后面同理设置偏差
true_b = torch.tensor(1.1)
整体就搭建了一个可训练的线性模型
最后,终于开始了模型的训练
epochs = 50  # 训练的轮数

for epoch in range(epochs):
    data_loss = 0
    for batch_x, batch_y in data_provider(X, Y, batchsize):
        pred_y = fun(batch_x, w_0, b_0)
        loss = maeLoss(pred_y, batch_y)
        loss.backward()  # 梯度回传
        sgd([w_0, b_0], lr)  # 更新模型
        data_loss += loss

    print("epoch %03d: loss: %.6f" % (epoch, data_loss.detach()))
两层循环,外层大循环是训练的轮数,每一轮都完整过一遍数据,首先初始化本轮的损失为0,然后开始本轮的训练,每次利用 data_provider() 提供一批数据 batch_x ,进行前向过程计算预测值 pred_y,计算损失,反向传播计算梯度,更新模型,最后把这一小批数据的损失加入这一轮的总损失当中。
需要注意的是,PyTorch会隐式地把梯度“附着”在参数张量上,具体来说,PyTorch 在调用 loss.backward() 时,自动把梯度存到了每个 requires_grad=True 的张量的 .grad 属性里。
所以更新模型的函数无需输入这批数据的梯度。
到此为止,我们整个模型就已经书写完毕了,我们通过画图看一下模型的拟合效果
这里选取idx = 0,也就是特征0与标签绘制图形
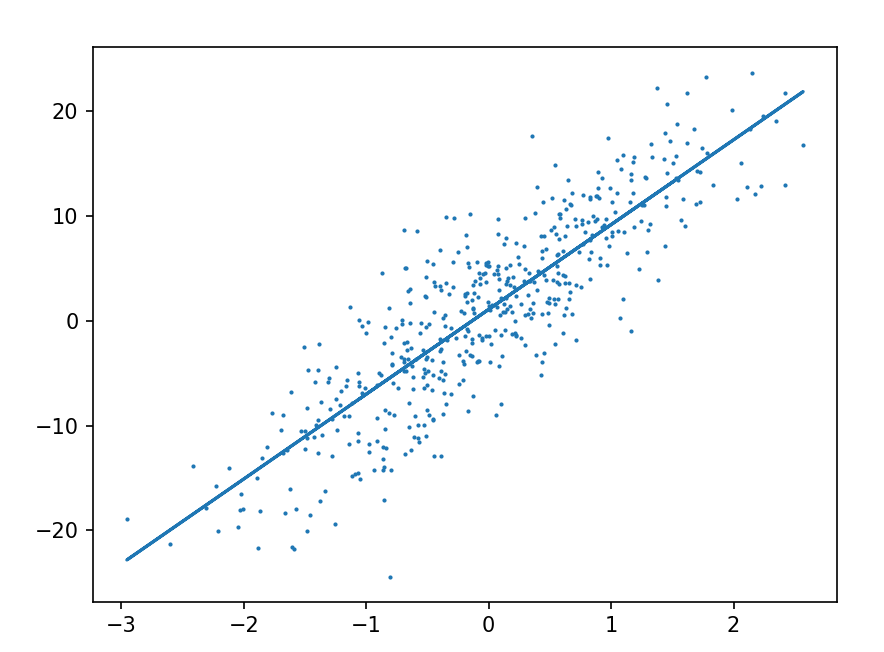
可以看到模型的拟合效果还不错

完整模型如下
import torch
import matplotlib
matplotlib.use('Qt5Agg')
import matplotlib.pyplot as plt  # 画图

import random  # 随机


def creat_data(w, b, data_num):  # 随机生成数据
    x = torch.normal(0, 1, (data_num, len(w)))  # 根据矩阵乘法,这个数据张量的行数就是数据的数量,列数是权重的数量
    y = torch.matmul(x, w) + b  # matmul矩阵相乘

    noise = torch.normal(0, 0.01, y.shape)  # 生成噪声,噪声是加在y上的,所以噪声的维度应该与y一致
    y += noise
    return x, y


num = 500

true_w = torch.tensor([8.1, 2, 2, 4])
true_b = torch.tensor(1.1)

X, Y = creat_data(true_w, true_b, num)

plt.scatter(X[:, 3], Y, 1)  # 画散点图,点的大小是1,取X的某一列与Y做对比,
plt.show()

def data_provider(data, label, batchsize):  # 每次访问这个函数就能提供一批数据
    length = len(label)  # 求出有多少个样本
    indices = list(range(length))  # indices是一个0-500按顺序存储的列表
    # 为了保证数据的普适性和随机性,要把数据打乱
    random.shuffle(indices)

    for each in range(0, length, batchsize):  # batchsize是这一批数据的数量,每次从0到500这么多数据中取batchsize这么多数据
        get_indices = indices[each: each + batchsize]
        get_data = data[get_indices]
        get_label = label[get_indices]

        yield get_data, get_label  # 有存档点的return

batchsize = 16


# for batch_x, batch_y in data_provider(X, Y, batchsize):
#     print(batch_x, batch_y)
#     break

def fun(x, w, b):
    pred_y = torch.matmul(x, w) + b
    return pred_y


def maeLoss(pre_y, y):  # 损失函数
    return torch.sum(abs(pre_y - y)) / len(y)


def sgd(paras, lr):  # 梯度下降
    with torch.no_grad():  # 属于这句代码的部分,不计算梯度
        for para in paras:
            para -= para.grad * lr
            para.grad.zero_()  # 使用过的梯度,归0


lr = 0.03
w_0 = torch.normal(0, 0.01, true_w.shape, requires_grad=True)
b_0 = torch.tensor(0.01, requires_grad=True)
print(w_0, b_0)

epochs = 50  # 训练的轮数

for epoch in range(epochs):
    data_loss = 0
    for batch_x, batch_y in data_provider(X, Y, batchsize):
        pred_y = fun(batch_x, w_0, b_0)
        loss = maeLoss(pred_y, batch_y)
        loss.backward()  # 梯度回传
        sgd([w_0, b_0], lr)  # 更新模型
        data_loss += loss

    print("epoch %03d: loss: %.6f" % (epoch, data_loss.detach()))

print("真实的函数值是", true_w, true_b)
print("训练得到的参数值是", w_0, b_0)

idx = 0
plt.plot(X[:, idx].detach().numpy(), X[:, idx].detach().numpy() * w_0[idx].detach().numpy() + b_0.detach().numpy())
plt.scatter(X[:, idx].detach().numpy(), Y, 1)
plt.show()
总结一下,这个模型实现了:
- 数据生成(含噪声)
- 模型定义(线性函数)
- 损失函数(MAE)
- 优化算法(SGD)
- 训练循环(mini-batch + epoch)
- 结果评估(参数对比 + 可视化)
更多推荐


 8
 0
- 0


 已为社区贡献7条内容

所有评论(0)