
有关大模型的本质思考
昨天和朋友讨论生成式大模型的机理时,谈到了一个之前没注意过的问题:
神经网络的输入输出往往是固定的,为什么大模型能处理不同长度文本?比如给GPT输入不同的提示词,它都能继续不断预测下一个词。
这个问题涉及到语言大模型的本质思考:一段文本输入到GPT模型中,模型是如何输出下一个Token的?
这个问题一下子没有答案,于是我在讨论之后,决定从源码的角度,重新来梳理一下GPT的生成过程。
代码下载
网上有不少GPT的代码实现,大多考虑不少工程实现的问题,导致代码变得复杂理解。
为了更容易理解代码,我下载了GPT-1[1]这个仓库的代码实现,它是一个基于GPT-1论文内容,非官方的Pytorch实现。
由于这个仓库的tokenizer等相关依赖不是很全,因此我让AI写了一段推理脚本,使用 GPT-2 的tokenizer,脚本内容如下:
import torch
from transformers import GPT2TokenizerFast
from model.model import GPT


def main():
    device = (
        "mps" if torch.backends.mps.is_available()
        else "cuda" if torch.cuda.is_available()
        else "cpu"
    )

    # 直接下载 GPT-2 tokenizer(自动缓存)
    tokenizer = GPT2TokenizerFast.from_pretrained("gpt2")
    tokenizer.pad_token = tokenizer.eos_token

    vocab_size = tokenizer.vocab_size
    seq_len = 128

    # GPT 模型
    model = GPT(
        vocab=vocab_size,
        seq=seq_len,
        n_layers=4,
        n_heads=8,
        dim=256,
        hidden=1024,
        dropout=0.1,
        device=device
    ).to(device)

    model.eval()

    # 原始文本
    texts = [
        "Hello world!",
        "GPT predicts next token."
    ]

    # tokenizer → ids
    enc = tokenizer(
        texts,
        padding="max_length",
        truncation=True,
        max_length=seq_len,
        return_tensors="pt"
    )

    x = enc["input_ids"].to(device)              # [B, T]
    ignore = enc["attention_mask"].to(device)    # 1=valid, 0=pad

    # forward
    with torch.no_grad():
        logits = model(x, ignore)

    print("Logits shape:", logits.shape)

    # next token demo
    for i, text in enumerate(texts):
        last = ignore[i].sum().item() - 1
        next_id = logits[i, last].argmax().item()
        next_token = tokenizer.decode([next_id])

        print(f"\nSample {i}")
        print("Input:", text)
        print("Next token:", repr(next_token))


if __name__ == "__main__":
    main()
首次运行,会下载以下文件,这些文件在开源的模型库中也往往出现。
tokenizer_config.json: 100%|████████████████████████████████████████████████████████████████████████████████████████████████| 26.0/26.0 [00:00<00:00, 20.2kB/s]
vocab.json: 100%|█████████████████████████████████████████████████████████████████████████████████████████████████████████| 1.04M/1.04M [00:00<00:00, 4.68MB/s]
merges.txt: 100%|███████████████████████████████████████████████████████████████████████████████████████████████████████████| 456k/456k [00:00<00:00, 2.17MB/s]
tokenizer.json: 100%|█████████████████████████████████████████████████████████████████████████████████████████████████████| 1.36M/1.36M [00:00<00:00, 3.09MB/s]
config.json: 100%|████████████████████████████████████████████████████████████████████████████████████████████████████████████| 665/665 [00:00<00:00, 1.36MB/s]
这几个文件的作用分别如下表所示:
| 文件名 | 所属范畴 | 主要作用 |
|---|---|---|
| tokenizer_config.json | 分词器配置 | 分词器的初始化参数和特殊标记定义。 |
| vocab.json | 分词器数据 | Token 到数字 ID 的映射字典。 |
| merges.txt | 分词器数据 | BPE 等算法的子词合并规则。 |
| tokenizer.json | 分词器 (现代格式) | 整合所有分词逻辑和数据的完整文件。 |
| config.json | 模型配置 | 模型架构(网络结构)的超参数和配置。 |
分词器基本原理
为什么要下载这几个文件?主要目的是要下载分词器。
大模型的输入和输出是以Token作为计量单位,那么大模型如何知道,哪些词是作为一个Token,这就需要通过分词器来界定。
比如,看DeepSeek-V3.2-Exp的开源仓库[2],也有tokenizer.json这个文件。
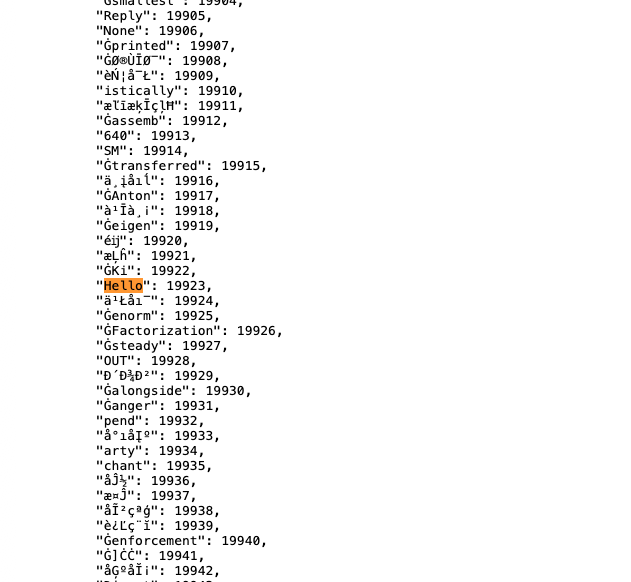
在里面搜索Hello这个单词,发现它的id是19923。
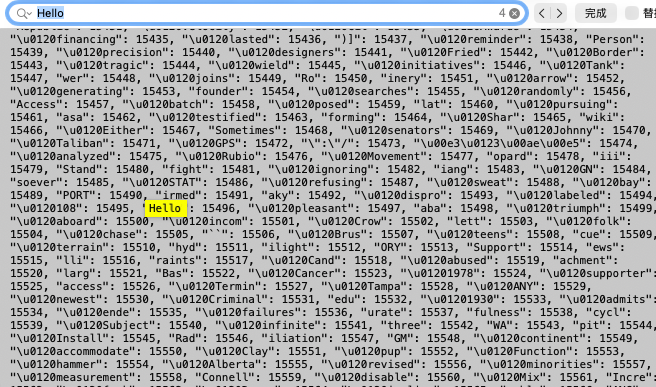
而打开 GPT-2 的 tokenizer.json,再搜索Hello这个单词,它的id是15496。
分词器就像一个词典,如果词典里词很多,那么模型的表示空间也很大。
换言之,如果某个小国家的语言没有被编码,纳入这个词典,就意味着模型是无法输出相关的语言的。
另外,对于中文,直接在这个词典里搜,是搜索不到的。
GPT-2的分词器对中文是这么操作的:先把文本转成 UTF-8 字节序列,再把字节映射到 256 个可见符号。
比如,把你这个字,变成 UTF-8 字节。
"你".encode("utf-8")
结果如下:
E4 BD A0 (十六进制)
转换成十进制就是:
| 字节 | 十进制 |
|---|---|
| 0xE4 | 228 |
| 0xBD | 189 |
| 0xA0 | 160 |
把 0–255 的 byte 映射到一组 可见 Unicode 字符,结果就是:
byte 228 → "ä"
byte 189 → "½"
byte 160 → "ł"
在这种映射规则下,你这个字就被映射为:
你 → [228,189,160] → "ä½ ł"
对此,我们可以做一个实验论证,用这个分词器,输出你的Token表示:
from transformers import GPT2TokenizerFast

tokenizer = GPT2TokenizerFast.from_pretrained("gpt2")
tokens = tokenizer("你", add_special_tokens=False)
print(tokens)
结果如下:
{'input_ids': [19526, 254], 'attention_mask': [1, 1]}
再通过ID反推出token表示:
from transformers import GPT2TokenizerFast

tokenizer = GPT2TokenizerFast.from_pretrained("gpt2")

print(tokenizer.convert_ids_to_tokens([19526, 254]))
输出结果如下:
['ä½', 'ł']
在 tokenizer.json 中,可以找到ä½和ł单独的Token表示。
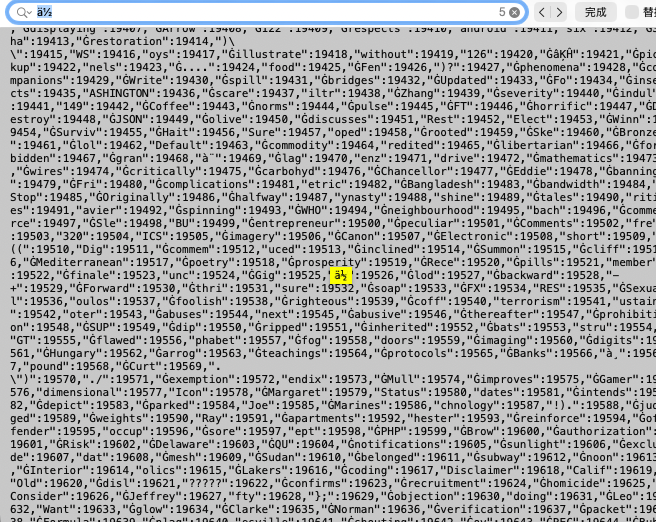
所以,我们可以得到结论:对于汉字你,GPT-2的分词器会把它拆成两个Token,这显然不是很合理。
因为对于英文you,却是一个Token。
为什么会出现这种情况呢?
原因是GPT-2刚出来的时候,没有针对中文进行优化,它底层采用的是BPE(Byte Pair Encoding)压缩算法,核心目标是是在固定符号表大小的前提下,最小化序列长度。
它会重复以下步骤:
- 统计当前语料中所有相邻符号对(pair)的出现频率
- 找到出现次数最多的 pair
- 把这个 pair 合并成一个新符号
- 把新符号加入 vocab(符号表)
- 更新整个语料的表示
比如,you这个单词先拆解为y、o、u,然后发现语料中,这种组合很多,于是,you就自然被算法优化成一个Token。
而它们的语料中,中文内容很少,因此,汉字就会被自然拆解,而不是合并。
后面的一系列模型(LLaMA / Qwen / DeepSeek)都放弃 byte-BPE,而使用 SentencePiece / Unigram。这部分研究起来,可挖掘的东西还很多,这里就不作深入展开。
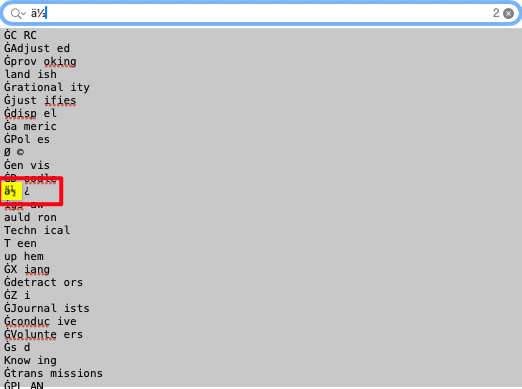
当然,也不是所有的汉字都会被拆成多个Token,merges.txt 这个文件就是专门用BPE算法计算Token的合并。
比如,在里面可以找到ä½ ¿这条规则,翻译成中文就是汉字使,它可以用一个Token来表征。
总之,为什么GPT-2要把所有非英文语言都用 byte 来表示呢?
主要原因是语言模型必须有固定大小的字典,这个字典(vocab)的大小必须在训练前确定。
UTF-8 byte 的范围是 [0, 255],数量固定,所有文本都能表示,它解决的是覆盖性问题,不会因为输入是词汇表里没有的新字符,而导致无法推理。
这样做显然会把语言本身固有的一些分词特征给破坏掉,并且会增加token表示,这是一种工程妥协。
但英文却没有再用 UTF-8 转换,因为英文的字符集本身就能百分百覆盖(a–z, A–Z,0–9,常见标点,
不到 100 个字符)。
而且,英文语法有个天然的优势是,单词之间用空格间隔,这和分词的逻辑天然适配。
这就是为什么即便大模型发展到现在,主流方式仍然会采用英文去写复杂的提示词。
模型处理过程
了解完分词器,下面进入到模型的处理过程。
模型初始化
首先初始化模型,传入以下参数:
vocab_size = tokenizer.vocab_size
seq_len = 128

# GPT 模型
model = GPT(
    vocab=vocab_size,
    seq=seq_len,
    n_layers=4,
    n_heads=8,
    dim=256,
    hidden=1024,
    dropout=0.1,
    device=device
).to(device)
这里有两个参数很关键,第一个参数是vocab_size,这个上一节已经提过,是字典的大小。
第二个参数seq_len就是输入的上下文长度,在官方的GPT-1论文中,上下文长度是512,这里代码作者可能做了简化,固定成了128。
模型的上下文长度意味着什么?下面深入到模型代码中,进行分析。
在模型的实现代码中,上下文长度就干了一件事:对每个位置进行查表嵌入。
self.pos_embed = Embedding(seq, dim)
self.pos = LongTensor([i for i in range(128)])
pe = self.pos_embed(self.pos)
Embedding就是查表的过程,根据位置的index,去一张表里,查询dim维的特征向量,表的长度,就是上下文长度。
index 0   → 向量 p₀ ∈ R^dim
index 1   → 向量 p₁ ∈ R^dim
index 2   → 向量 p₂ ∈ R^dim
...
index 127 → 向量 p₁₂₇ ∈ R^dim
文本输入大模型之前,先通过分词器进行分词,然后将Token序列输入到模型中,同样通过查表Embedding的方式去变成dim维的特征向量。
self.bpe_embed = Embedding(vocab, dim).to(device)
be = self.bpe_embed(x)
模型真正输入进去的,实际上就是dim维的特征向量的累加值:token的向量结果和位置编码的向量结果相加。
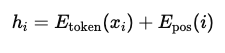
因此,本文开头的那个问题就已经得到解决,为什么不同长度的文本,模型都能处理呢?
因为不管有多长,只要不超出上下文范围,都会被映射成维度固定的特征向量,这样模型就能够统一处理。
所以,这个维度的选取就很关键,如果维度选取的很小,那么长文本反而被压缩成低维,语义信息丢失就很大,所以这个dim值至少要比上下文长度大,越大越有利于进行不同文本的抽象表征。
那么,如果输入超出上下文范围怎么办?从模型角度来说:无法处理。
有些大模型平台能处理超长文本,不过是在后台做了工程优化,进行文本截取或压缩,而ChatGPT这方面的处理不多,这就是为什么输入很长的信息时,它会提示“文本过长,无法输入”。
有了这个洞察之后,下面再思考一个更深入的问题:高维的特征向量如何进行语义表示?
答案是:完全靠训练获得,大力出奇迹。
一开始,这两个表中的特征向量都是随机噪声,然后通过模型的训练,逐渐去贴合训练样本。
normal_(self.bpe_embed.weight, mean=0.0, std=0.02)
normal_(self.pos_embed.weight, mean=0.0, std=0.02)
到底用多少维的特征向量表示合适,初始化如何利用先验知识?这方面的可解释性太差了,所以GPT模型的本质就是“复读机”:给它看过什么内容,它就倾向于输出什么内容。
之后,模型就更加“暴力”了,堆叠多个输入和输出相同的transformer block,来不断做scaling,最后算出下一个token的概率。
理解完大模型输出的机理后,对KV-Cache的理解也会更加深刻。
为什么要用KV-Cache呢,原因是模型的输入是个顺序累加过程。
之前对话的历史记录,会被拼接到后续对话的头部,进行计算。
之前的token之间的attention已经在对话中计算过,这部分就可以缓存下来,后面不用再算,只需要再额外计算之前的token和最新输入token之间的attention就可以了,如此,便是空间换时间。
总结
搞清楚大模型输出的原理后,会发现一件很“滑稽”的事:不管输入的是长是短,每个token在向量空间中的维度是固定的,长短只是影响并行计算之间Attention计算的效率。
换言之,对于一段相同长度的问题来说,困难问题和简单问题所带来的计算量是一样的。这合理吗?显然不合理。
之前看到智谱清言CEO张鹏的一期访谈,其中就谈到,对于GPT的架构来说,它没法实现AGI,因为从根上来说,“它不知道自己不知道”,以至于经常“一本正经的胡说八道”。
另外,分词器并不是一个语言公平的工具,它和大模型之间是完全割裂的。
这就让我想起 DeepSeek-OCR 发布时,就看到有人抨击:分词器实在是“丑陋”的设计,也许用图像作为token输入能完全取代它。
总之,GPT把人类带到了一条堆算力的路线上,虽然它很暴力,不优雅,但如果没有它的帮助,想必我也无法在短短的一晚上想清楚这些问题。
参考
[1] https://github.com/akshat0123/GPT-1
[2] https://huggingface.co/deepseek-ai/DeepSeek-V3.2-Exp/raw/main/tokenizer.json
[3] https://www.bilibili.com/video/BV1awiDBDEWS
更多推荐

 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)