
AI大模型学习效率提升实战:从数据预处理到分布式训练优化
快速体验
在开始今天关于 AI大模型学习效率提升实战:从数据预处理到分布式训练优化 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
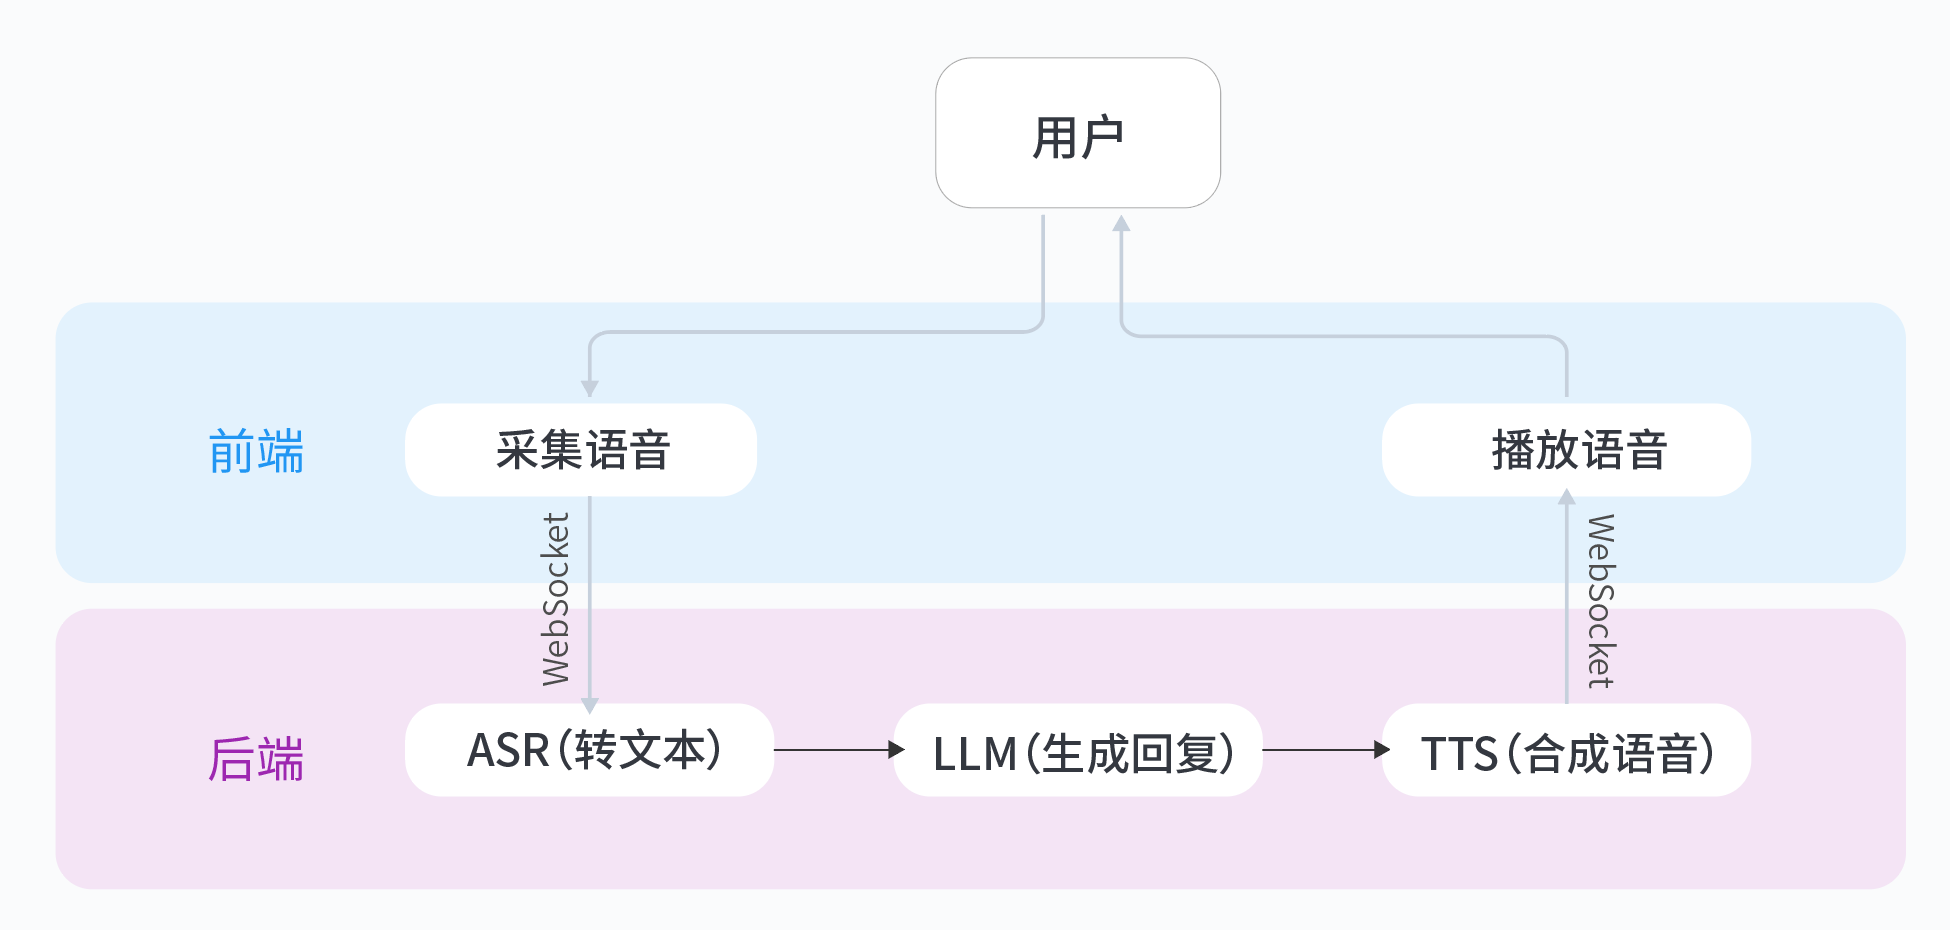
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型学习效率提升实战:从数据预处理到分布式训练优化
在训练大规模AI模型时,效率问题往往成为制约开发进度的关键瓶颈。本文将分享一套经过实战验证的效率优化方案,帮助开发者从数据加载到分布式训练实现全流程加速。
数据加载瓶颈分析与优化
数据管道是训练流程中容易被忽视的性能瓶颈点。当GPU计算单元等待数据加载时,会造成严重的资源闲置。通过NVIDIA DCGM监控工具可以看到,未经优化的数据管道会导致GPU-Util指标频繁跌至30%以下。
DataLoader参数调优对比
PyTorch的DataLoader提供多个关键参数用于优化数据加载:
- num_workers:控制子进程数量。建议设置为CPU物理核心数的2-4倍,超过此值会因进程切换开销导致性能下降
- prefetch_factor:每个worker预取的batch数量。通常设置为2-4,与显存容量正相关
- pin_memory:启用锁页内存,加速CPU到GPU的数据传输
# 优化后的DataLoader配置示例
train_loader = DataLoader(
    dataset,
    batch_size=256,
    num_workers=8,       # 匹配CPU核心数
    prefetch_factor=3,   # 平衡内存占用与吞吐
    pin_memory=True,     # 必须与GPU训练配合使用
    persistent_workers=True  # 避免重复创建worker
)
混合精度训练实践
混合精度训练可显著减少显存占用并提升计算速度,但需要正确处理精度转换和梯度缩放。
AMP与FP16实现对比
- NVIDIA AMP:自动管理精度转换和梯度缩放,推荐大多数场景使用
- 手动FP16:需要显式处理master weights和loss scaling,适合特定优化需求
# 带梯度裁剪的AMP训练代码
scaler = torch.cuda.amp.GradScaler()

for inputs, targets in train_loader:
    with torch.cuda.amp.autocast():
        outputs = model(inputs)
        loss = criterion(outputs, targets)

    scaler.scale(loss).backward()
    scaler.unscale_(optimizer)
    torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
    scaler.step(optimizer)
    scaler.update()
分布式训练优化策略
多GPU训练时,通信开销可能成为新的性能瓶颈。通过NCCL后端和通信优化可显著提升扩展效率。
all_reduce通信优化
- 使用
torch.distributed.all_reduce替代默认的parameter server模式 - 调整
bucket_cap_mb参数优化通信分组(建议25-100MB) - 启用
find_unused_parameters减少不必要的梯度同步
# 分布式训练初始化
torch.distributed.init_process_group(
    backend='nccl',
    init_method='env://'
)
model = DDP(model, device_ids=[local_rank])

# 自定义all_reduce分组策略
os.environ['NCCL_ALGO'] = 'Tree'  # 树状通信拓扑
性能监控与调优验证
使用DCGM工具监控关键指标:
- GPU-Util:应保持在70%以上
- 显存占用:混合精度下应降低30-50%
- SM Efficiency:反映计算单元实际利用率
典型优化效果:
- 数据加载优化:GPU-Util提升40%
- AMP训练:迭代速度提升2.1倍
- 通信优化:多卡扩展效率达85%+
常见问题与解决方案
多卡训练参数调整
- batch_size缩放:线性缩放规则(如8卡时batch_size×8)
- 学习率调整:使用sqrt规则
lr = base_lr * sqrt(n_gpu) - warmup策略:前5%训练步数逐步提高学习率
内存泄漏排查
梯度累积时容易出现的内存问题:
- 检查
.backward()后是否及时zero_grad() - 验证AMP模式下loss tensor的生命周期
- 使用
torch.cuda.memory_summary()定位泄漏点
延伸思考
数据增广强度与训练效率的平衡需要考虑:
- 计算密集型增广(如MixUp)适合提前预处理
- 在线增广应评估CPU负载影响
- 可考虑在训练后期逐步减弱增广强度
想亲自体验AI大模型开发的完整流程?推荐尝试从0打造个人豆包实时通话AI动手实验,该实验涵盖了从语音识别到对话生成的完整AI应用开发链路,特别适合想要快速上手的开发者。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 9
 0
- 0


 已为社区贡献6条内容

所有评论(0)