
AI大模型教学视频推荐:基于内容理解的智能推荐系统实践
快速体验
在开始今天关于 AI大模型教学视频推荐:基于内容理解的智能推荐系统实践 的探讨之前,我想先分享一个最近让我觉得很有意思的全栈技术挑战。
我们常说 AI 是未来,但作为开发者,如何将大模型(LLM)真正落地为一个低延迟、可交互的实时系统,而不仅仅是调个 API?
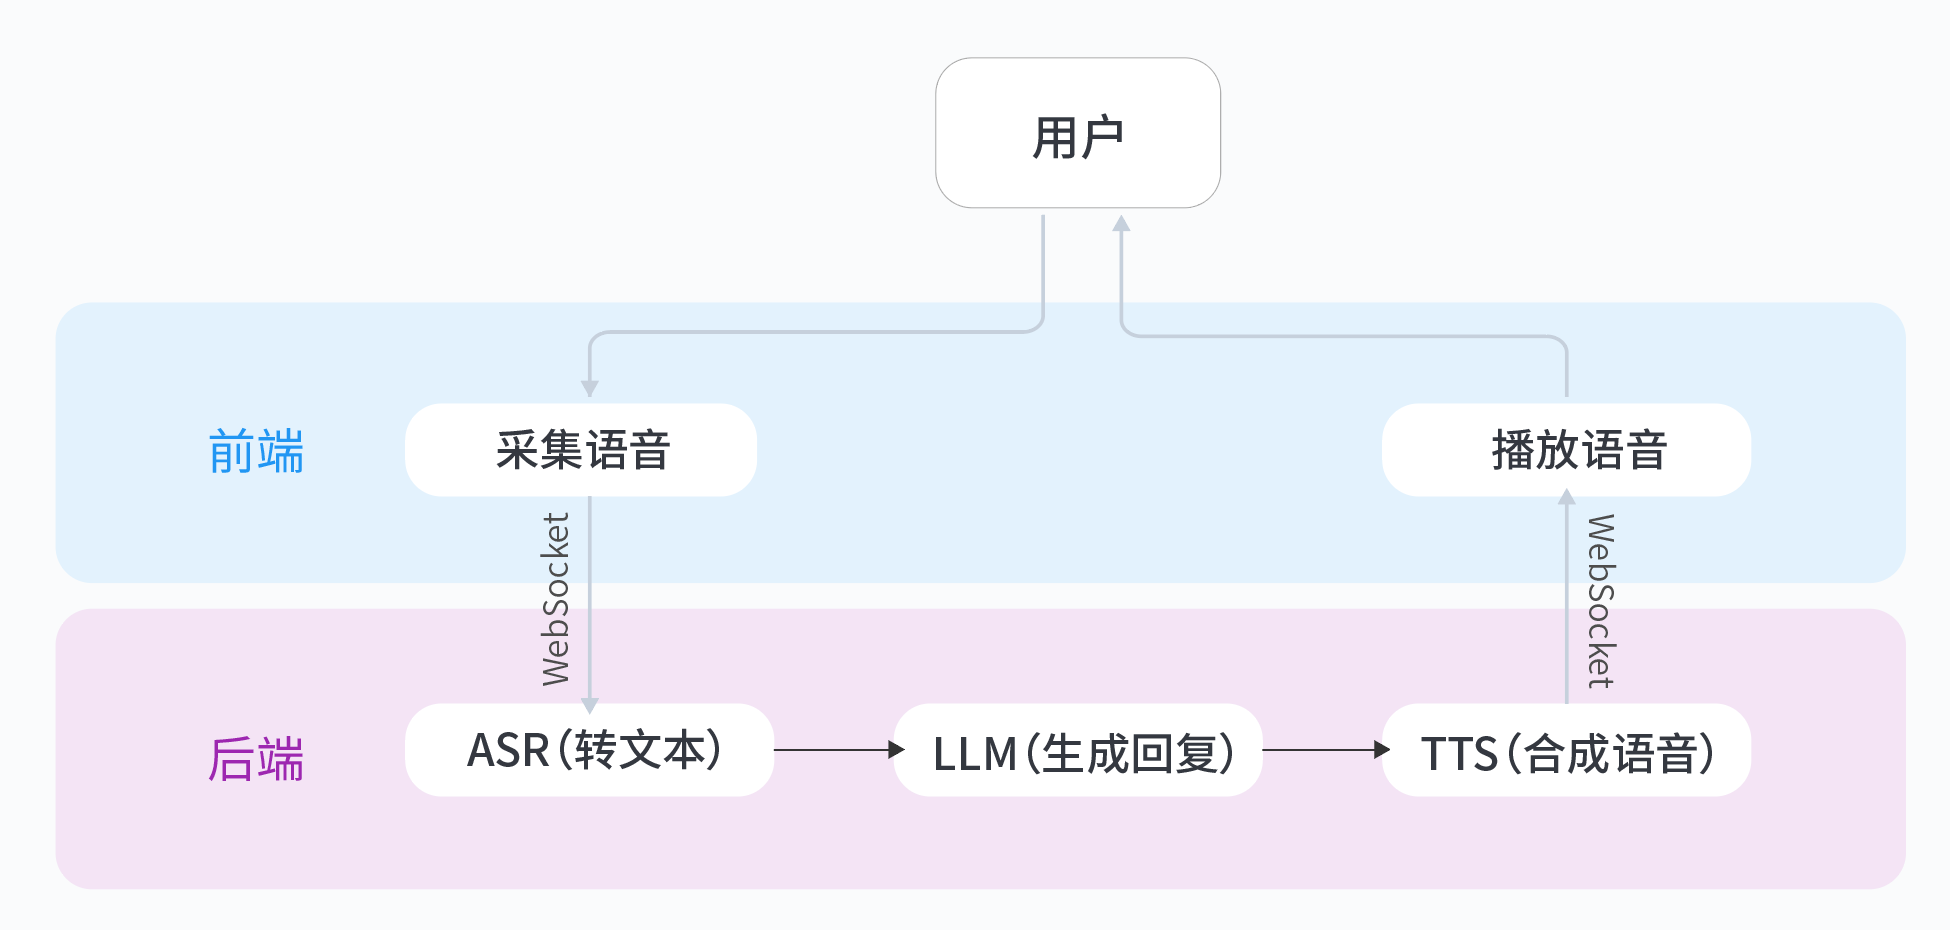
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
AI大模型教学视频推荐:基于内容理解的智能推荐系统实践
背景痛点:AI学习者的资源筛选困境
在AI技术快速发展的今天,各类教学视频呈爆炸式增长。开发者面临三个核心挑战:
- 信息过载:平台上的AI教学视频数量庞大,质量参差不齐,手动筛选耗时耗力
- 冷启动问题:新用户缺乏历史行为数据,传统推荐系统难以提供个性化建议
- 内容理解不足:单纯基于点击率的推荐无法识别视频的实际技术深度和教学价值
技术选型:推荐算法对比分析
构建推荐系统时,我们需要权衡不同算法的适用场景:
-
基于内容的推荐
- 优点:解决冷启动问题,推荐结果可解释性强
- 缺点:容易陷入内容单一化,难以发现用户潜在兴趣
-
协同过滤
- 优点:能发现用户潜在兴趣,推荐多样性好
- 缺点:依赖大量用户行为数据,存在冷启动问题
-
深度学习模型
- 优点:能捕捉非线性特征关系,处理高维稀疏数据
- 缺点:模型复杂度高,需要大量计算资源
核心实现:四阶段推荐流水线
1. 视频内容理解
使用BERT等预训练模型提取视频元数据和字幕文本的特征:
from transformers import BertTokenizer, BertModel
import torch

tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
model = BertModel.from_pretrained('bert-base-uncased')

def get_video_embedding(text):
    inputs = tokenizer(text, return_tensors="pt", truncation=True, max_length=512)
    with torch.no_grad():
        outputs = model(**inputs)
    return outputs.last_hidden_state.mean(dim=1)  # 获取句向量
2. 用户画像构建
结合显式反馈(评分/收藏)和隐式反馈(观看时长/搜索记录)构建用户特征:
import pandas as pd
from sklearn.preprocessing import MinMaxScaler

def build_user_profile(user_history):
    # 计算观看时长权重
    watch_weights = MinMaxScaler().fit_transform(
        user_history[['watch_duration']].values
    )

    # 结合显式和隐式反馈
    user_embedding = np.average(
        video_embeddings[user_history['video_id']],
        weights=watch_weights,
        axis=0
    )
    return user_embedding
3. 混合推荐算法
融合内容相似度和协同过滤结果:
from sklearn.metrics.pairwise import cosine_similarity

def hybrid_recommend(user_embedding, video_embeddings, cf_scores, alpha=0.7):
    # 内容相似度计算
    content_sim = cosine_similarity(
        [user_embedding],
        video_embeddings
    )[0]

    # 混合推荐得分
    hybrid_scores = alpha * content_sim + (1-alpha) * cf_scores
    return np.argsort(hybrid_scores)[::-1]  # 降序排列
4. 实时服务部署
使用FastAPI构建推荐服务:
from fastapi import FastAPI
import numpy as np

app = FastAPI()

@app.post("/recommend")
async def recommend(user_id: str, top_k: int = 5):
    user_embedding = user_profiles[user_id]
    rec_indices = hybrid_recommend(user_embedding, video_embeddings, cf_scores)
    return {"recommendations": video_metadata.iloc[rec_indices[:top_k]].to_dict()}
性能优化关键策略
-
实时性保障
- 使用Redis缓存热门视频和用户最近行为
- 实现异步特征更新机制
-
可扩展性设计
- 采用微服务架构分离特征计算和推荐逻辑
- 使用Kubernetes实现自动扩缩容
-
隐私保护措施
- 实现差分隐私保护的用户行为收集
- 提供用户数据删除接口满足GDPR要求
避坑指南:实战经验分享
-
数据稀疏性问题
- 解决方案:引入知识图谱补充视频间关系
- 代码示例:使用Neo4j构建视频-概念图谱
-
冷启动优化
- 新视频处理:结合发布者信誉度和内容质量预测
- 新用户处理:设计引导问卷收集初始兴趣
-
评估指标选择
- 避免仅依赖准确率,应综合考量:
- 多样性:推荐列表的覆盖度
- 新颖性:推荐长尾内容比例
- 用户满意度:CTR和观看时长
与AI开发工具链的集成思路
-
与开发环境整合
- 为VS Code等IDE开发插件,根据当前编辑的代码推荐相关教学视频
-
持续学习支持
- 基于用户项目历史,推荐进阶学习路径
- 示例:检测用户TensorFlow使用频率,推荐PyTorch对比教程
-
智能问答增强
- 结合推荐视频构建QA知识库
- 实现"这个视频讲的内容如何应用?"等场景问答
想要体验更完整的AI应用开发流程?可以参考这个从0打造个人豆包实时通话AI动手实验,它将带你完整实现一个智能对话系统的开发全流程。我在实际操作中发现,这种端到端的项目实践能帮助开发者快速掌握AI应用的架构设计和技术集成。
实验介绍
这里有一个非常硬核的动手实验:基于火山引擎豆包大模型,从零搭建一个实时语音通话应用。它不是简单的问答,而是需要你亲手打通 ASR(语音识别)→ LLM(大脑思考)→ TTS(语音合成)的完整 WebSocket 链路。对于想要掌握 AI 原生应用架构的同学来说,这是个绝佳的练手项目。
你将收获:
- 架构理解:掌握实时语音应用的完整技术链路(ASR→LLM→TTS)
- 技能提升:学会申请、配置与调用火山引擎AI服务
- 定制能力:通过代码修改自定义角色性格与音色,实现“从使用到创造”
从0到1构建生产级别应用,脱离Demo,点击打开 从0打造个人豆包实时通话AI动手实验
更多推荐

 10
 0
- 0


 已为社区贡献9条内容

所有评论(0)