
2026年国产时序数据库观察:云原生、多模态与工业落地
文章目录
前言
摘要:进入2026年,在“数字中国”与工业物联网浪潮的强劲推动下,国产时序数据库市场持续繁荣,竞争格局日趋清晰。本文将对当前主流的国产时序数据库进行梳理盘点,并特别聚焦于金仓数据库(Kingbase),深入剖析其以融合多模架构为核心的差异化竞争实力,为企业在数字化转型中的时序数据底座选型提供参考。
一、主流国产时序数据库概览 (2026)]()
国产时序数据库已形成多元产品矩阵,根据其核心技术路线、商业模式和市场定位,主要代表性产品如下:
| 数据库名称 | 核心厂商/社区 | 主要特点与定位 |
|---|---|---|
| TDengine | 涛思数据 | 高性能、分布式,定位为AI驱动的工业大数据平台,在写入吞吐和存储成本方面优势显著,集群开源、生态开放。 |
| KaiwuDB | 浪潮云弈 | 强调分布式多模融合架构,支持时序、关系、文档等多种数据模型的统一处理,原生集成AI算法。 |
| Apache IoTDB | 清华大学 (Apache基金会) | 专为物联网设计,采用“端-边-云”协同原生架构,数据模型常采用树形结构贴合物理设备层级。 |
| DolphinDB | 浙江智臾科技 | 将数据库与强大的编程语言、流计算引擎融合,在金融量化交易、高频数据分析领域表现突出。 |
| openGemini | 华为云 | 开源的多模态时序数据库,兼容InfluxDB生态,强调高性能与云原生特性。 |
| CnosDB | 诺司时空 | 云原生时序数据库,支持分布式与集中式部署,在监控和物联网场景有应用。 |
| GreptimeDB | 格睿科技 | 云原生分布式时序数据库,主打实时分析能力。 |
| YMatrix, RealHistorian, GoldenData等 | 四维纵横、紫金桥、庚顿数据等 | 在特定工业或监控领域拥有深厚的行业积累和定制化解决方案。 |
| 金仓时序数据库 | 中电科金仓(原人大金仓) | 基于成熟稳定的金仓数据库管理系统(KES)内核打造的时序能力增强插件,最大特点是继承了KES的融合多模架构,支持时序数据与关系型、空间(GIS)等数据的统一存储、处理与关联分析 。 |
二、焦点解析:金仓时序数据库的融合多模架构
在众多专注于时序场景极致优化的产品中,金仓数据库的时序组件选择了一条独特的路径:不追求做一个孤立的专用时序引擎,而是作为其强大的融合数据库体系(KES)中的一个版块。这种架构选择带来了以下显著优势:
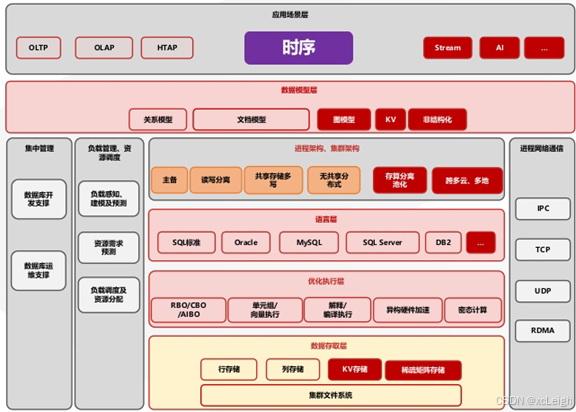
1. 内核级多模态融合,打破数据孤岛
-
统一底座: 金仓时序组件并非独立产品,而是基于成熟的KingbaseES关系型数据库内核进行融合。这意味着企业无需为时序数据单独搭建和维护一套新的数据基础设施。
-
无缝关联查询: 时序数据(如传感器读数)与业务关系数据(如设备台账、生产工单)天然存储在同一数据库中。用户可以使用标准的SQL(支持Oracle/PostgreSQL兼容模式)直接进行跨时序表和关系表的复杂JOIN查询,无需繁琐的数据同步与导出,极大简化了数据分析链路。
-
支持丰富数据类型: 得益于KES内核,它不仅支持时序数据常用的数值、时间戳类型,还原生支持JSON、GIS空间数据、数组等复杂类型,能够满足更广泛的工业数字化场景需求。
2. 复用并强化企业级核心能力
-
极致的事务(ACID)保证: 在金仓的时序表上,数据写入同样享有完整的关系型数据库事务支持,这在要求数据强一致性的金融、电力调度等关键业务场景中是独特优势。
-
企业级高可用与安全: 时序数据可直接受益于KES已构建成熟的读写分离、共享存储、分布式集群等高可用架构,以及行列级权限控制、数据加密等企业级安全特性。
-
成熟的生态与工具链: 可直接复用KES的备份恢复、监控运维、数据迁移(KDTS)等整套运维管理工具,以及与各类BI、ETL工具的连接生态,降低学习与运维成本。
3. 面向复杂场景的综合性能表现
从金仓官方披露的测试报告(如使用TSBS工具对比InfluxDB)来看,其时序组件在特定场景下展现出竞争力:
-
写入性能: 通过优化分区策略、并行插入等手段,在特定配置下可实现单机百万级、集群千万级数据点/秒的写入能力。
-
查询性能: 在涉及多维度聚合、跨表关联等复杂查询场景中,凭借成熟的SQL优化器与执行引擎,性能表现显著优于部分原生时序数据库,尤其适合需要将时序数据与业务数据进行深度整合分析的场景。
三、行业应用与实践
金仓时序组件的融合架构使其在那些既需要处理海量时序数据流,又需要与核心业务系统紧密集成的场景中找到了用武之地,公开案例包括:
-
福建省船舶安全综合管理平台: 处理沿海数十万船舶终端的GPS定位时序数据,基于KES分片(Sharding)方案实现日峰值亿级写入与百亿级历史数据的毫秒级地理空间查询。
-
国家电网智能电网调度系统: 在国产化迁移项目中,支撑高频、可靠的电力数据录入,并实现与大量既有关系型业务数据的混合处理与分析。
-
智慧港口(如厦门港)、智能制造厂区: 记录设备轨迹、工况时序数据,并与生产管理系统、设备管理系统进行实时关联分析。
四、2026年国产时序数据库选型思考
企业在2026年进行时序数据库选型时,应超越对单一峰值性能指标的过度关注,从更宏观的视角评估:
-
数据架构复杂性: 如果业务中时序数据与关系数据、空间数据等紧密耦合,需要频繁关联分析,金仓的融合多模架构将提供极大的便利性和整体性价比。
-
长期运维与总拥有成本(TCO): 考虑引入新产品带来的学习成本、运维复杂度以及生态整合成本。复用现有关系型数据库团队的技能栈和工具链,是金仓方案的另一大隐性优势。
五、金仓时序数据库操作与分析
为了更好地理解金仓时序数据库的优势,以下是一个简单的代码示例,展示如何在金仓时序数据库中操作时序数据,并结合关系数据进行分析。
假设我们有一个涉及传感器数据的业务场景,传感器数据包括温度和湿度,而设备信息存储在关系型表中,我们想要分析某些设备的温度、湿度数据,并根据设备的状态来进行综合查询。
1. 创建时序数据表和关系型数据表
-- 创建时序数据表
CREATE TABLE sensor_data (
    sensor_id INT,
    timestamp TIMESTAMP,
    temperature DOUBLE PRECISION,
    humidity DOUBLE PRECISION
);

-- 创建设备信息表
CREATE TABLE device_info (
    device_id INT PRIMARY KEY,
    device_name VARCHAR(255),
    location VARCHAR(255),
    status VARCHAR(50)
);
2. 插入时序数据
-- 插入时序数据
INSERT INTO sensor_data (sensor_id, timestamp, temperature, humidity)
VALUES
(1, '2026-01-18 10:00:00', 22.5, 60),
(2, '2026-01-18 10:00:00', 24.1, 55),
(1, '2026-01-18 11:00:00', 23.0, 59);

-- 插入设备信息数据
INSERT INTO device_info (device_id, device_name, location, status)
VALUES
(1, 'Temperature Sensor 1', 'Room 101', 'active'),
(2, 'Humidity Sensor 1', 'Room 102', 'inactive');
3. 执行时序数据与关系数据的联合查询
在这个查询中,我们将时序数据与设备信息表进行联合,找出所有"active"状态的设备,查看它们的温度和湿度数据。
SELECT
    di.device_name,
    di.location,
    sd.timestamp,
    sd.temperature,
    sd.humidity
FROM
    sensor_data sd
JOIN
    device_info di ON sd.sensor_id = di.device_id
WHERE
    di.status = 'active'
ORDER BY
    sd.timestamp;
4. 查询性能优化(基于分区和索引)
为了优化大规模时序数据的查询性能,我们可以使用分区表和索引。
-- 创建分区表,按时间戳进行分区
CREATE TABLE sensor_data (
    sensor_id INT,
    timestamp TIMESTAMP,
    temperature DOUBLE PRECISION,
    humidity DOUBLE PRECISION
) PARTITION BY RANGE (timestamp);

-- 创建分区
CREATE TABLE sensor_data_2026_01_18 PARTITION OF sensor_data FOR VALUES FROM ('2026-01-18 00:00:00') TO ('2026-01-19 00:00:00');

-- 在timestamp列上创建索引
CREATE INDEX idx_sensor_data_timestamp ON sensor_data(timestamp);
5. 执行时序数据的聚合查询
我们可以进行复杂的聚合查询,例如查看某一设备的日平均温度和湿度:
SELECT
    di.device_name,
    DATE(sd.timestamp) AS day,
    AVG(sd.temperature) AS avg_temperature,
    AVG(sd.humidity) AS avg_humidity
FROM
    sensor_data sd
JOIN
    device_info di ON sd.sensor_id = di.device_id
WHERE
    di.status = 'active'
GROUP BY
    di.device_name, DATE(sd.timestamp)
ORDER BY
    day;
六、总结与展望
通过上述代码示例,我们可以看到金仓时序数据库在处理时序数据和关系数据结合的优势。基于金仓数据库的融合多模架构,企业无需为时序数据单独建立新的数据基础设施,而是可以利用现有的关系型数据库技术进行无缝集成,简化了系统的维护与管理,同时提高了数据处理效率。
随着数字化转型和AI技术的进步,时序数据的智能化处理将越来越重要,金仓数据库凭借其多模融合架构,为企业在应对复杂的数据分析任务时提供了强有力的支持。
更多推荐


 25
 0
- 0


 已为社区贡献5条内容

所有评论(0)